{count, plural, one {Corso} other {Corsi}}
Introduzione a Python per la finanza
{hours} ore
107.9K
La maggior parte dei confronti tra API di borsa parte dal presupposto sbagliato.
Confrontano i livelli di prezzo, il numero di endpoint, le pagine di documentazione e i limiti del piano gratuito. Questi dettagli contano, ma non ti dicono se l'API può supportare il sistema che stai costruendo.
Un backtest non fallisce perché il fornitore ha meno endpoint di un concorrente. Fallisce perché i prezzi storici non sono aggiustati correttamente, la storia dei dati è troppo breve o le azioni societarie sono gestite male.
Una dashboard ha una modalità di fallimento diversa. Si rompe quando le risposte delle quotazioni sono lente, i campi cambiano inaspettatamente o i limiti di rate diventano un problema quando gli utenti iniziano ad aggiornare la pagina.
Ecco perché considero le liste generiche dei “migliori stock API” come punti di partenza, non risposte. La vera domanda è: "Questa API funzionerà ancora quando il mio progetto smetterà di essere un prototipo?"
Quando un'API alimenta un workflow reale, diventa infrastruttura dati:
Cambiare in seguito è doloroso perché non stai solo modificando un URL di richiesta. Potresti dover riscrivere pipeline, job di refresh, aggiornare la logica di storage, adattare gli input dei modelli e rivedere parti dell'interfaccia utente.
La chiusura di IEX Cloud nel 2024 è un promemoria utile. Molti sviluppatori e aziende avevano costruito dashboard, app e strumenti interni attorno alla sua API. Una volta interrotto il servizio, migrare ha significato ripensare endpoint, campi, prezzi, licenze e assunzioni sui dati.
Prima di confrontare i fornitori, identifica il workflow che l'API dovrà supportare. Un backtester e una dashboard possono entrambi usare i prezzi azionari, ma non dipendono dagli stessi requisiti di dati.
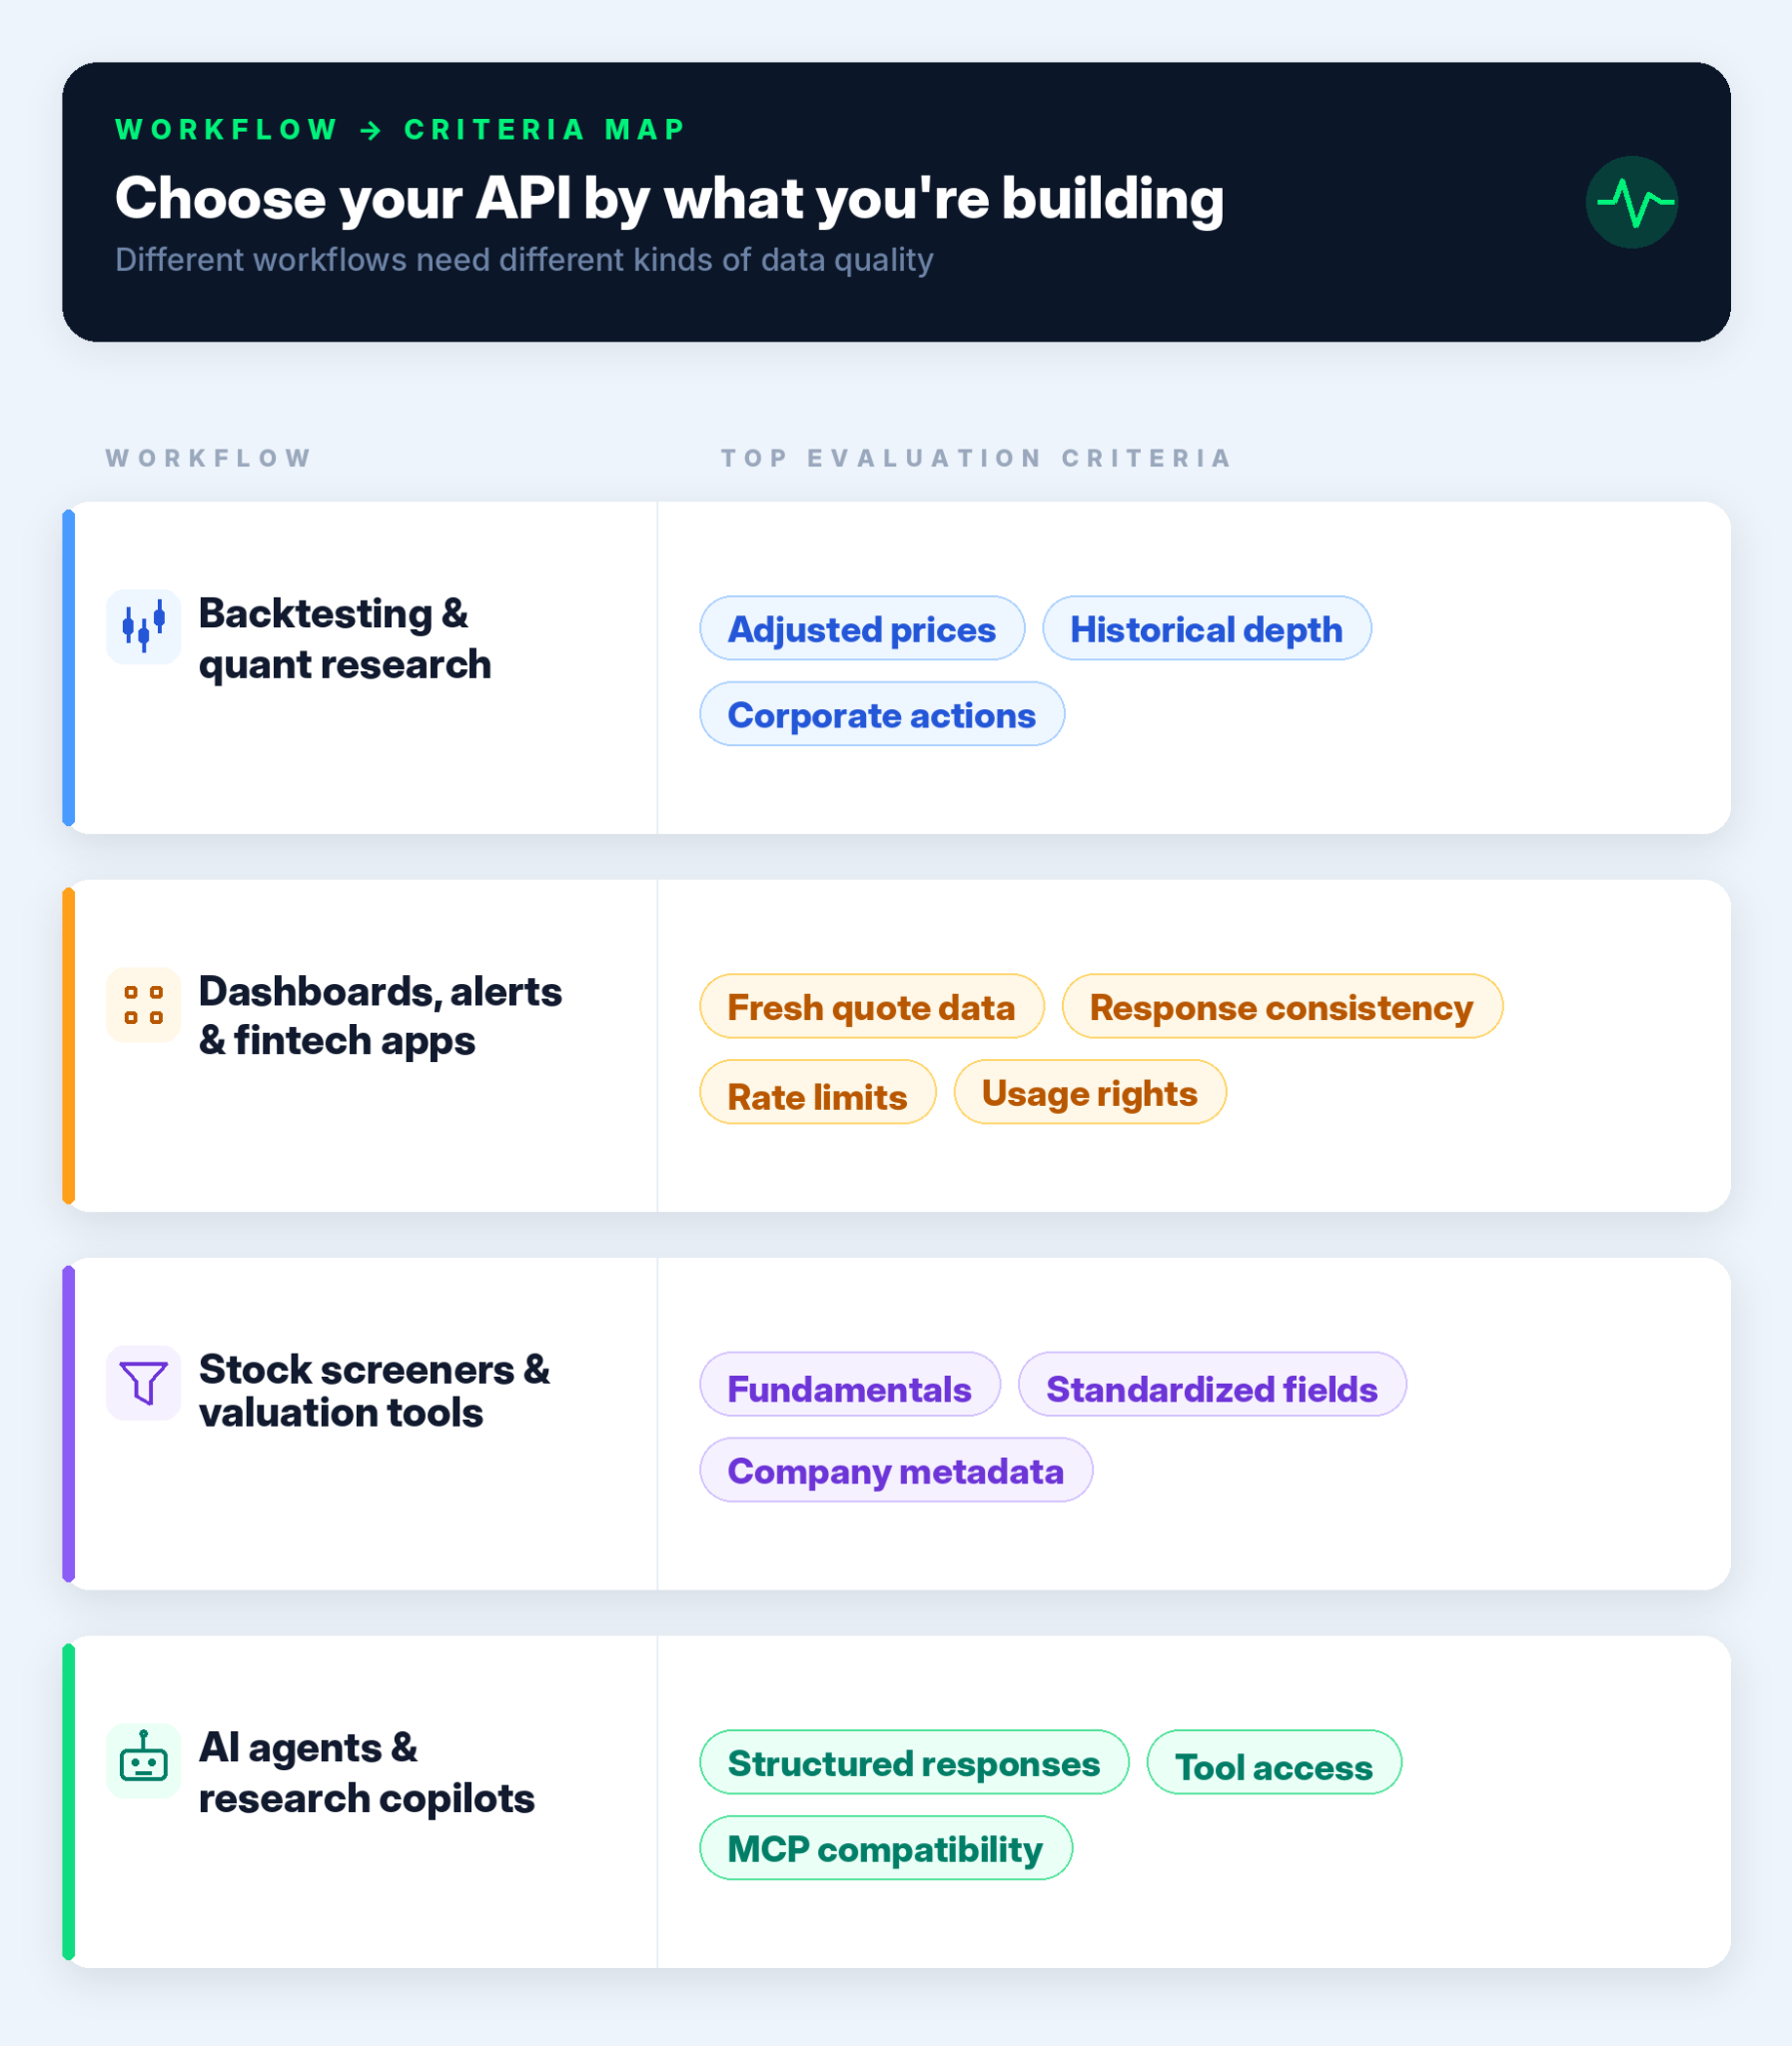
Per il backtesting, i dati storici puliti in genere contano più dei dati live.
Criteri chiave da verificare:
Per approfondire l'implementazione e il test di strategie di trading in Python, il nostro tutorial Algorithmic Trading in Python illustra in dettaglio concetti e insidie del backtesting.
Dashboard e sistemi di alert danno priorità a freschezza, affidabilità e coerenza. Un notebook privato può tollerare una richiesta fallita o un nome campo disordinato. Un prodotto rivolto agli utenti no.
Criteri chiave da verificare:
Gli screener e gli strumenti di valutazione hanno bisogno di dati di business, non solo di prezzo. La sfida principale è il confronto, perché di solito filtri o classifichi molte aziende in una volta.
Criteri chiave da verificare:
I workflow AI hanno bisogno di API che restituiscano dati strutturati e prevedibili. Un LLM può riassumere testo, ma non dovrebbe indovinare dati finanziari.
Criteri chiave da verificare:
Per passare dai dati API a un agente funzionante, la guida al Model Context Protocol (MCP) spiega come MCP collega i modelli AI a strumenti esterni, mentre i tutorial Building LangChain Agents e OpenAI Agents SDK mostrano come metterlo in pratica con Python.
Una volta chiarito il workflow, confrontare le API diventa più semplice. Non stai più chiedendo: “Quale fornitore ha più funzionalità?” Stai chiedendo, “Quale fornitore può supportare il livello dati di cui questo progetto ha bisogno?”
|
Criterio |
Cosa verificare |
Perché conta |
|
Copertura dei dati |
Classi di asset, mercati, simboli e geografia |
L'API dovrebbe coprire l'universo di cui il tuo progetto ha davvero bisogno |
|
Profondità storica |
Lunghezza della storia, accesso alla storia completa, dati aggiustati e non aggiustati |
Backtest e strumenti di ricerca hanno bisogno di più dei soli dati recenti |
|
Qualità dei dati e azioni societarie |
Split, dividendi, cambi di ticker, righe mancanti e simboli obsoleti |
Aggiustamenti errati possono distorcere grafici, rendimenti e output dei modelli |
|
Supporto ai fondamentali |
Bilanci, utili, ratio, profili aziendali e metadati |
Screener e strumenti di valutazione richiedono contesto di business, non solo prezzi |
|
Licenze e redistribuzione |
Diritti di visualizzazione, diritti di archiviazione, uso commerciale e regole delle borse |
Un caso d'uso in notebook è diverso da un prodotto pubblico o a pagamento |
|
Esperienza sviluppatore |
Documentazione, formato delle risposte, errori, limiti di rate e usabilità in Python |
API pulite fanno risparmiare tempo dopo la prima richiesta |
|
Prontezza per AI e agenti |
Risposte strutturate, accesso agli strumenti, supporto MCP e schemi prevedibili |
Gli assistenti AI hanno bisogno di dati che possano recuperare, analizzare e su cui ragionare |
La copertura deve corrispondere al progetto, non alla pagina marketing.
Verifica:
L'errore è scegliere il fornitore con l'affermazione di copertura più ampia invece di quello che copre davvero il tuo universo di query.
La profondità storica conta quando il progetto deve testare idee in diverse condizioni di mercato.
Verifica:
C'è differenza tra “forniamo prezzi storici” e “questo dataset è abbastanza profondo per test seri”.
Qui è dove i dati azionari diventano noiosi.
Verifica:
Per gestire il lato più disordinato dei dati finanziari (pensa a valori mancanti, campi incoerenti e problemi di formato), il percorso Importing & Cleaning Data in Python copre le tecniche base di cui avrai bisogno una volta che le chiamate API funzionano.
I fondamentali contano quando il progetto richiede contesto di business, non solo movimenti di prezzo.
Verifica:
La parola chiave è coerenza. Se confronti aziende, i campi dovrebbero funzionare in tutto l'universo senza logiche ad hoc per ogni ticker.
Le licenze sono noiose finché non bloccano il prodotto.
Verifica:
Preferisco trovare questi limiti prima di scrivere la pipeline che dopo aver costruito il frontend.
Un'API pulita fa risparmiare tempo dopo la prima richiesta.
Verifica:
La prima chiamata riuscita non è il vero test. Il vero test è se l'API resta pulita dopo aver aggiunto job di refresh, gestione errori e join con altri dataset.
I workflow AI hanno bisogno di accesso ai dati prevedibile.
Verifica:
L'API non deve essere “AI-native” per ogni caso d'uso. Ma se stai costruendo un assistente di ricerca finanziaria, il livello dati dovrebbe essere facile da usare sia per il codice Python che per gli strumenti AI.
Il nostro tutorial Codex CLI MCP mostra un esempio concreto in ambito finance, costruendo un agente di dashboard di portafoglio live usando dati di Alpha Vantage tramite un workflow MCP.
I criteri sopra sono utili, ma non sceglierei un fornitore solo con una checklist. Testerei l'API contro le modalità di fallimento che contano per il progetto.
Negli esempioi sotto userò Alpha Vantage perché ci offre prezzi storici, quotazioni live, fondamentali, indicatori tecnici e opzioni per workflow AI in un unico posto. L'obiettivo è verificare se l'API può soddisfare i requisiti reali del progetto senza creare lavoro eccessivo di pulizia.
Per un backtester, questo è uno dei primi controlli che farei. Se una serie di prezzi non gestisce bene gli split, ogni calcolo di rendimento costruito sopra diventa discutibile.
Il codice qui sotto scarica i prezzi giornalieri aggiustati di Tesla attorno allo stock split del 2022 e confronta i rendimenti grezzi con quelli aggiustati.
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
Ecco l'output:
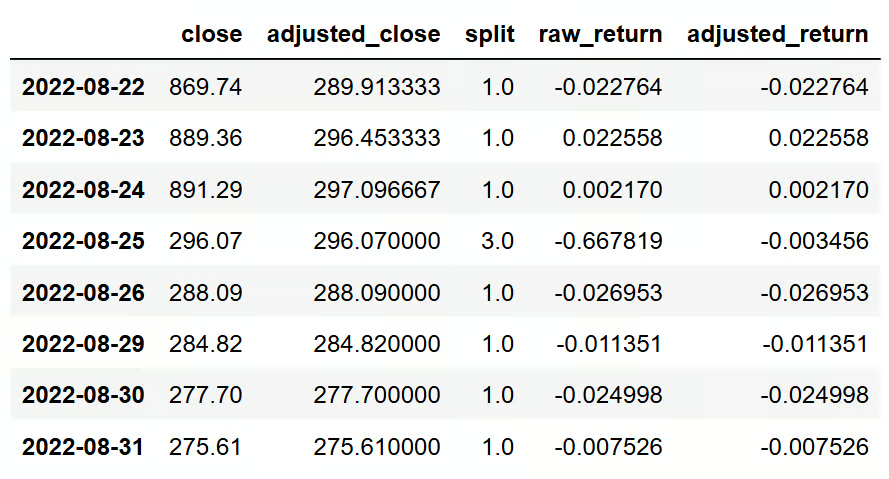
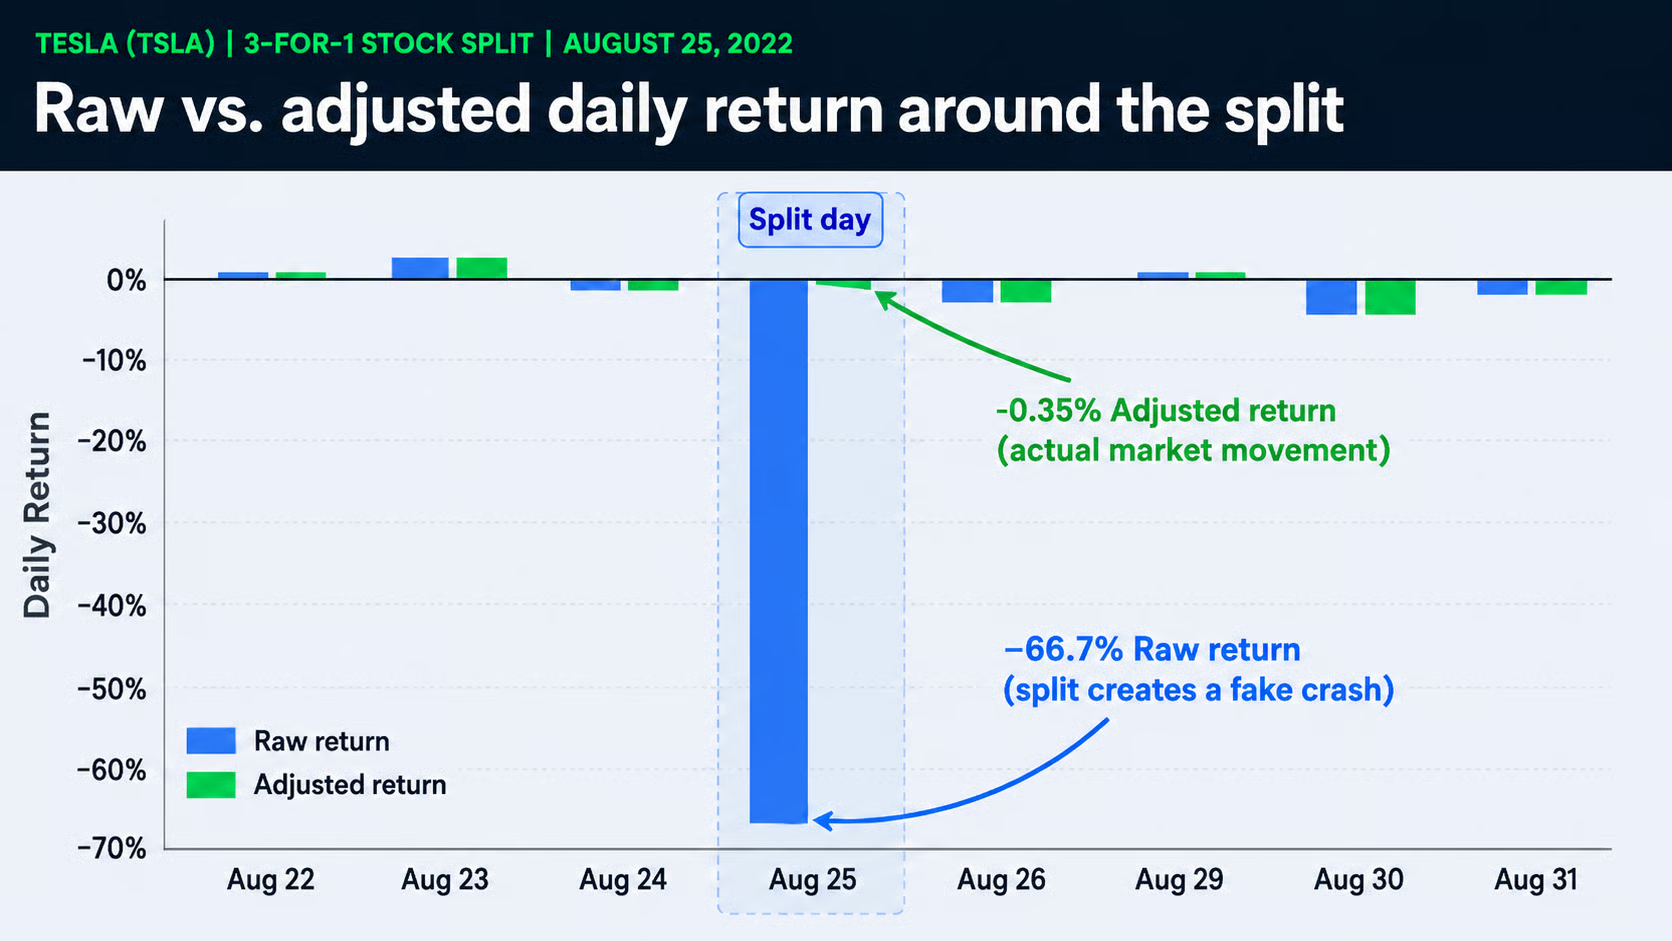
Ecco perché i dati aggiustati sono importanti.
La chiusura grezza suggerisce un -66,7% il 25 agosto 2022. Non è stato un crollo reale. Era lo split 3-per-1 di Tesla che appariva nella serie dei prezzi grezzi.
Il rendimento aggiustato per lo stesso giorno è solo intorno a -0,35%, molto più vicino al movimento reale del mercato dopo aver considerato lo split.
Questo piccolo controllo ti dice se l'API fornisce i campi necessari per intercettare un problema comune nel backtesting. Un elenco ricco di funzionalità non può dirtelo.
Una dashboard o un sistema di alert non ha solo bisogno di dati. Ha bisogno di richieste che falliscano in modo chiaro.
Questo helper aggiunge un semplice pattern di retry e controlla problemi comuni nelle risposte dell'API. Non è infrastruttura di produzione, ma basta a testare se un'API si comporta in modo prevedibile quando qualcosa va storto.
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
Questo è il tipo di controllo che aggiungerei prima di fidarmi di un'API in una dashboard o in un job schedulato.
La parte importante non è il numero di retry. È se il tuo codice riesce a distinguere un simbolo errato, una risposta vuota, un messaggio di rate limit e un errore temporaneo di richiesta. Se ogni errore sembra uguale, il debugging diventa doloroso quando il progetto ha utenti.
Per screener, strumenti di valutazione e assistenti AI, testerei se l'API può produrre un oggetto di ricerca pulito da più endpoint.
L'esempio sotto scarica una quotazione e una panoramica aziendale per Apple, quindi trasforma il risultato in un dizionario compatto. Questo è più vicino a ciò di cui avrebbe bisogno una scheda di dashboard, una riga di screener o la risposta di uno strumento AI.
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
L'output appare così:
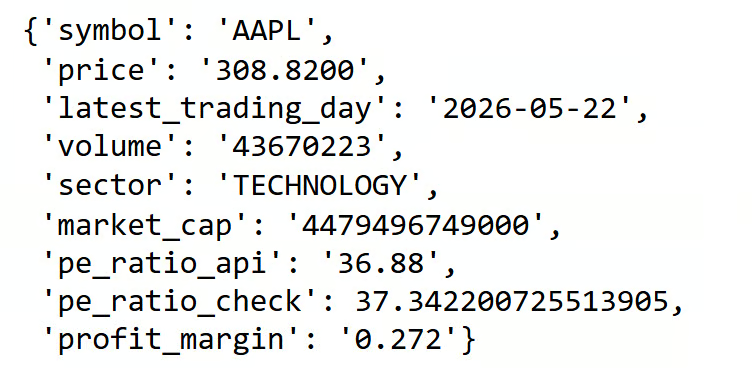
Il P/E riportato dall'API e il nostro semplice calcolo prezzo/EPS non sono identici, il che è normale perché i fornitori possono usare convenzioni temporali o input aggiustati diversi. Ma il confronto è comunque utile perché ci dice se i campi sono utilizzabili in modo direzionale.
Questo test non è utile solo per il backtesting:
Questo ultimo punto conta. MCP o il tool calling non sistemano magicamente dati disordinati. L'API deve comunque restituire campi che possano essere trasformati in un oggetto prevedibile. Se ogni endpoint richiede pulizia personalizzata, il workflow dell'agente diventerà rapidamente fragile.
Il test pratico è semplice: puoi scaricare i dati, validarli, calcolare una metrica di base e restituire qualcosa che un'altra parte del sistema possa usare? Se sì, l'API è molto più vicina a essere utile oltre il primo notebook.
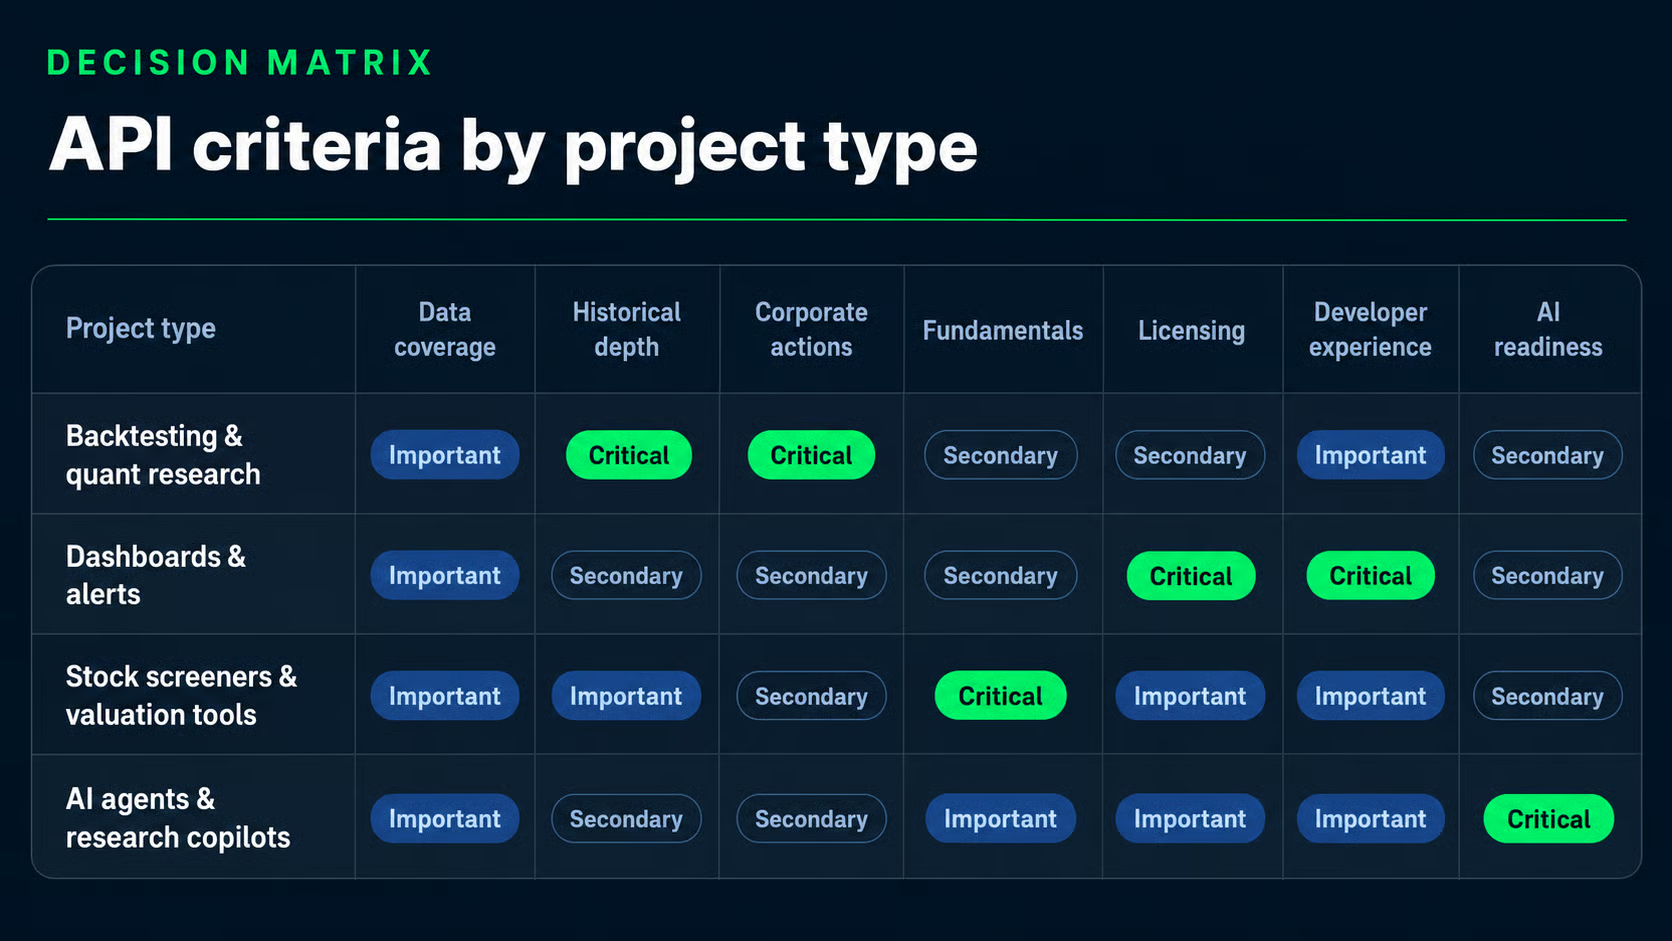
Ora possiamo mettere insieme workflow e criteri di valutazione.
Lo scopo di questa matrice non è classificare i fornitori. È aiutarti a decidere quali criteri meritano la maggiore attenzione per il progetto che stai costruendo.
|
Tipo di progetto |
Criteri più importanti |
Criteri secondari |
Fornitori da considerare |
|
Backtesting e ricerca quant |
Profondità storica, prezzi aggiustati e azioni societarie |
Prontezza AI, licenze |
Alpha Vantage per workflow storici e indicatori ampi; EODHD per ricerche EOD globali |
|
Dashboard e alert |
Licenze, esperienza sviluppatore sulle risposte, limiti di rate |
Profondità storica, fondamentali |
QuoteMedia per dashboard developer-friendly; Xignite per app finanziarie enterprise |
|
Stock screener e strumenti di valutazione |
Fondamentali, metadati aziendali, ratio e bilanci |
Profondità storica, copertura simboli |
Alpha Vantage per workflow ampi su fondamentali e prezzi; Intrinio per strumenti incentrati sui fondamentali USA |
|
Agenti AI e copiloti di ricerca |
Risposte strutturate, accesso agli strumenti e prontezza MCP |
Fondamentali, indicatori, licenze |
Alpha Vantage per MCP e copertura API ampia |
Questa tabella è volutamente imperfetta. I progetti reali raramente rientrano in una sola riga e i prodotti seri combinano più di un workflow.
Per un backtester, inizierei da profondità storica e azioni societarie prima di preoccuparmi delle quotazioni live.
La domanda chiave non è: “Posso recuperare la storia dei prezzi?” È: “Posso fidarmi di questa storia dei prezzi tra split, dividendi, date mancanti e lunghi regimi di mercato?”
Per questo workflow, verifica:
I dati in tempo reale possono contare più avanti se ti muovi verso monitoraggio live o esecuzione. Per la ricerca storica, non dovrebbero essere la prima priorità.
Per un assistente AI, l'API deve essere facile da usare sia per il codice sia per il modello.
Uno sviluppatore umano può ispezionare una risposta JSON disordinata e sistemare il parsing. Un workflow di agente è meno tollerante. Se lo schema è imprevedibile, il modello può chiamare lo strumento giusto ma faticare comunque a usare il risultato.
Per questo workflow, verifica:
Il punto più ampio è semplice: scegli l'API in base alla modalità di fallimento che puoi permetterti di meno. Un backtester fallisce quando la storia è sbagliata. Una dashboard fallisce quando gli utenti non riescono a ottenere risposte aggiornate. Un assistente AI fallisce quando il livello di accesso ai dati è troppo disordinato per essere usato.
Non esiste una singola API di borsa migliore per ogni progetto. La scelta giusta dipende da ciò che il tuo sistema deve fare: profondità storica per il backtesting, freschezza per le dashboard, fondamentali per gli screener e risposte strutturate per i workflow AI.
È anche per questo che Alpha Vantage è stata un'API versatile da usare in tutti gli esempi di questo articolo. Copre diversi livelli di cui abbiamo parlato, inclusi dati di mercato, fondamentali, indicatori tecnici e workflow AI basati su MCP, consentendoci di testare più di un fattore decisionale senza cambiare fornitore.
Tratterei un'API di borsa come parte dell'infrastruttura dati del progetto, non solo come un insieme di endpoint. Influisce sul tuo codice, sul database, sui job di refresh, sugli input del modello, sull'esperienza utente e persino su ciò che puoi mostrare nel prodotto finale.
Se vuoi costruire workflow finanziari più solidi in Python, ti consiglio di iniziare con il nostro corso Python for Finance.
Impara l'analisi finanziaria in Python con DataCamp!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min