{count, plural, one {Kurs} other {Kurse}}
Einführung in Python für den Finanzbereich
{hours} Std.
107.9K
Die meisten Vergleiche von Stock-APIs setzen am falschen Punkt an.
Sie stellen Preismodelle, Anzahl der Endpoints, Doku-Seiten und Freikontingente gegenüber. Das ist relevant, sagt dir aber nicht, ob die API das System unterstützen kann, das du baust.
Ein Backtest scheitert nicht, weil ein Anbieter weniger Endpoints hat als die Konkurrenz. Er scheitert, weil historische Kurse nicht korrekt bereinigt sind, die Historie zu kurz ist oder Corporate Actions schlecht abgebildet werden.
Ein Dashboard hat einen anderen Fehlermodus. Es bricht, wenn Quotes langsam ankommen, Felder sich unerwartet ändern oder Rate Limits zum Problem werden, sobald Nutzer die Seite aktualisieren.
Darum sind generische „Best Stock API“-Listen für mich ein Startpunkt, keine Antwort. Die eigentliche Frage lautet: „Funktioniert diese API noch, wenn mein Projekt kein Prototyp mehr ist?“
Sobald eine API einen echten Workflow versorgt, wird sie zu Dateninfrastruktur:
Ein späterer Wechsel ist schmerzhaft, denn du änderst nicht nur eine Request-URL. Du musst möglicherweise Pipelines umschreiben, Refresh-Jobs anpassen, Speicherkonzepte aktualisieren, Model-Inputs ändern und Teile der Benutzeroberfläche überarbeiten.
Die IEX Cloud-Abschaltung im Jahr 2024 ist eine hilfreiche Erinnerung. Viele Entwickler und Unternehmen hatten Dashboards, Apps und interne Tools rund um diese API gebaut. Nach der Einstellung des Dienstes bedeutete die Migration, Endpoints, Felder, Preise, Lizenzen und Datenannahmen neu zu denken.
Bevor du Anbieter vergleichst, identifiziere den Workflow, den die API unterstützen soll. Ein Backtester und ein Dashboard nutzen zwar beide Aktienkurse, hängen aber nicht von denselben Datenanforderungen ab.
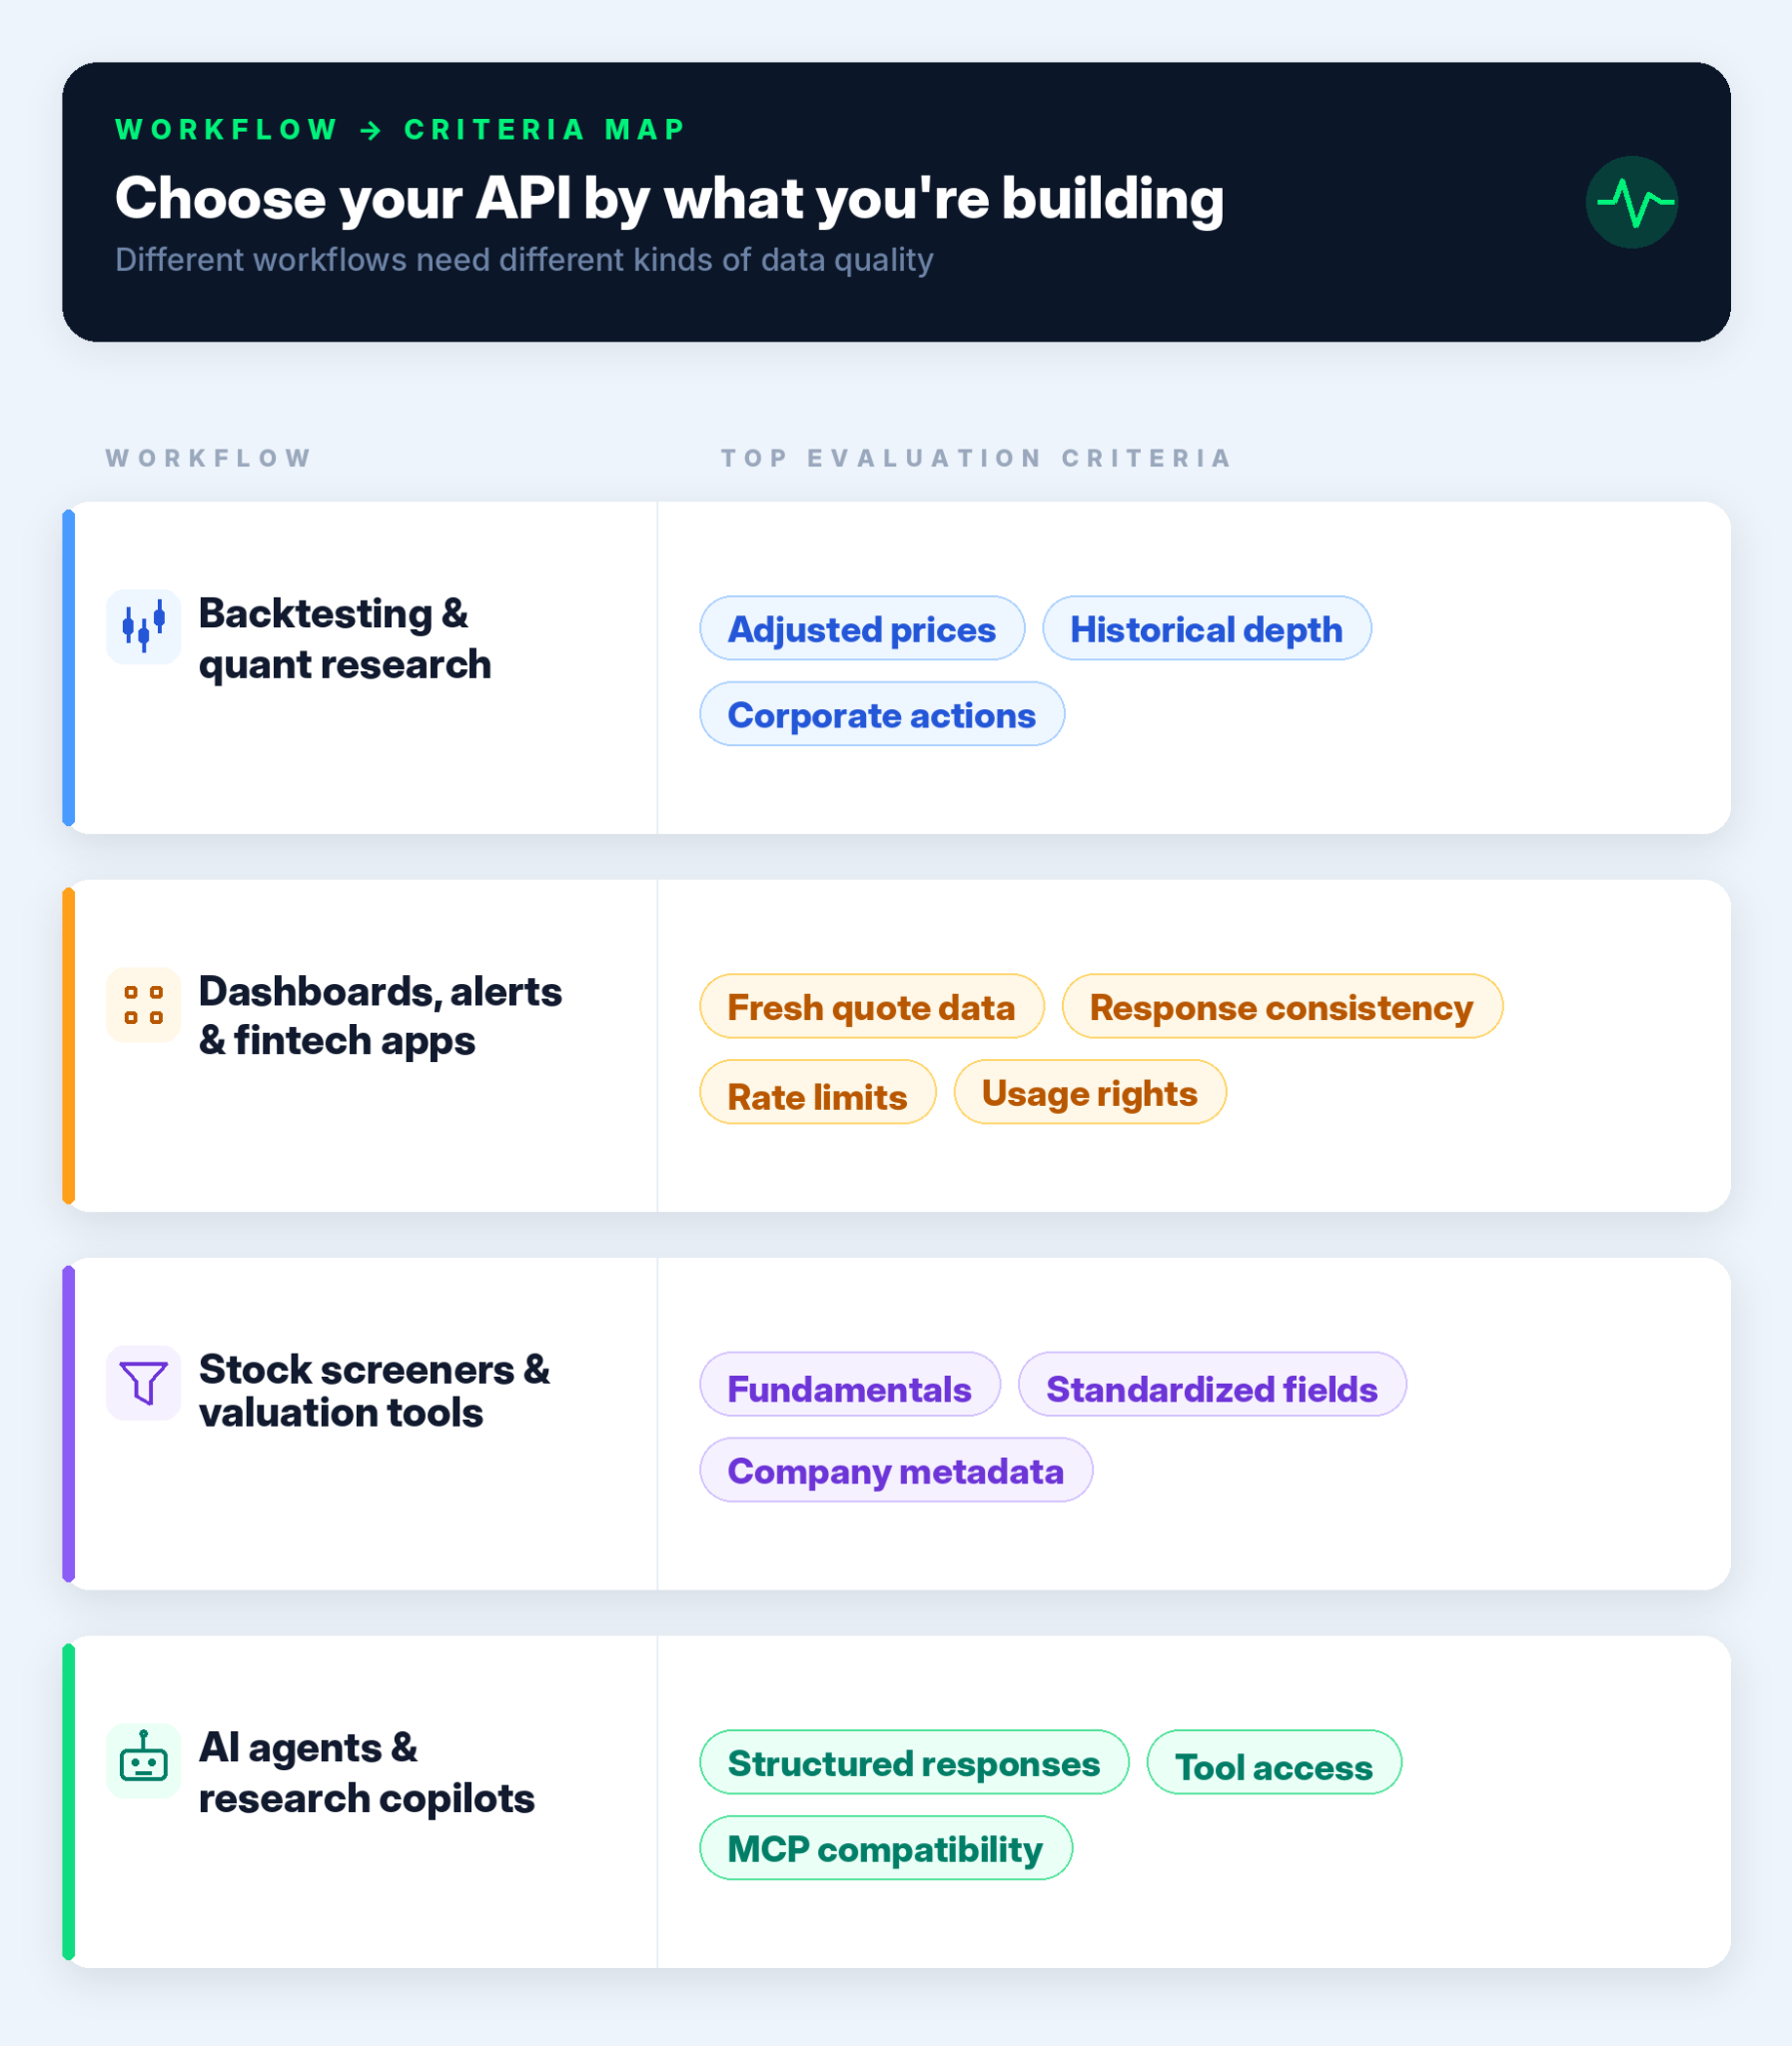
Für Backtesting sind saubere historische Daten meist wichtiger als Live-Daten.
Wichtige Prüfpunkte:
Für einen tieferen Einstieg in Implementierung und Tests von Handelsstrategien in Python führt unser Tutorial Algorithmic Trading in Python ausführlicher durch Backtesting-Konzepte und Fallstricke.
Dashboards und Alarmsysteme priorisieren Aktualität, Zuverlässigkeit und Konsistenz. Ein privates Notebook kann eine fehlgeschlagene Anfrage oder ein krummes Feld verkraften. Ein nutzerseitiges Produkt nicht.
Wichtige Prüfpunkte:
Screeners und Bewertungstools brauchen Unternehmensdaten, nicht nur Preisdaten. Die Hauptaufgabe ist der Vergleich, denn meist filterst oder rankst du viele Firmen gleichzeitig.
Wichtige Prüfpunkte:
KI-Workflows brauchen APIs, die strukturierte, vorhersagbare Daten liefern. Ein LLM kann Texte zusammenfassen, sollte Finanzdaten aber nicht raten müssen.
Wichtige Prüfpunkte:
Um von API-Daten zu einem funktionierenden Agenten zu kommen, erklärt der Model Context Protocol (MCP) Guide, wie MCP KI-Modelle mit externen Tools verbindet. Die Tutorials Building LangChain Agents und OpenAI Agents SDK zeigen die Umsetzung in Python.
Sobald der Workflow klar ist, wird der API-Vergleich leichter. Du fragst nicht mehr: „Welcher Anbieter hat die meisten Features?“ Sondern: „Welcher Anbieter kann die Datenebene tragen, die dieses Projekt braucht?“
|
Kriterium |
Was prüfen |
Warum es zählt |
|
Datenabdeckung |
Assetklassen, Märkte, Symbole, Geografien |
Die API sollte das Universum abdecken, das dein Projekt wirklich braucht |
|
Historische Tiefe |
Länge der Historie, Zugriff auf die volle Historie, bereinigte und unbereinigte Daten |
Backtests und Research-Tools brauchen mehr als nur jüngste Daten |
|
Datenqualität und Corporate Actions |
Splits, Dividenden, Tickerwechsel, fehlende Zeilen und veraltete Symbole |
Schlechte Bereinigungen verzerren Charts, Renditen und Modellergebnisse |
|
Fundamentaldaten-Support |
Abschlüsse, Earnings, Kennzahlen, Unternehmensprofile und Metadaten |
Screeners und Bewertungstools brauchen Kontext, nicht nur Preise |
|
Lizenzierung und Weitergabe |
Anzeigerechte, Speicherrechte, kommerzielle Nutzung, Börsenregeln |
Ein Notebook-Use-Case ist anders als ein öffentliches oder bezahltes Produkt |
|
Developer Experience |
Dokumentation, Response-Format, Fehler, Rate Limits und Python-Nutzbarkeit |
Saubere APIs sparen nach dem ersten Request Zeit |
|
KI- und Agent-Readiness |
Strukturierte Antworten, Toolzugriff, MCP-Support und vorhersagbare Schemata |
KI-Assistenten brauchen Daten, die sie abrufen, parsen und verarbeiten können |
Die Abdeckung sollte zum Projekt passen, nicht zur Marketingseite.
Prüfe:
Der Fehler ist, den Anbieter mit der größten Abdeckungs-Behauptung zu wählen statt den, der dein tatsächliches Query-Universum abdeckt.
Historische Tiefe zählt, wenn das Projekt Ideen über unterschiedliche Marktbedingungen testen muss.
Prüfe:
Ein Unterschied besteht zwischen „Wir liefern historische Kurse“ und „Dieses Dataset ist tief genug für ernsthafte Tests.“
Hier wird es bei Börsendaten lästig.
Prüfe:
Für den unordentlicheren Teil von Finanzdaten (fehlende Werte, inkonsistente Felder, Formatprobleme) deckt der Importing & Cleaning Data in Python-Lernpfad die Kerntechniken ab, die du nach den ersten API-Calls brauchst.
Fundamentaldaten zählen, wenn das Projekt Geschäftskontext braucht – nicht nur Kursbewegungen.
Prüfe:
Der Schlüsselbegriff ist Konsistenz. Wenn du Unternehmen vergleichst, sollten Felder universumsweit funktionieren – ohne Custom-Logik pro Ticker.
Lizenzen sind langweilig, bis sie das Produkt ausbremsen.
Prüfe:
Ich entdecke diese Grenzen lieber vor dem Pipeline-Bau als nach dem Frontend.
Eine saubere API spart nach dem ersten Request Zeit.
Prüfe:
Der erste erfolgreiche Call ist nicht der echte Test. Entscheidend ist, ob sich die API noch sauber anfühlt, wenn du Refresh-Jobs, Error Handling und Joins mit anderen Datasets ergänzt.
KI-Workflows brauchen verlässlichen Datenzugriff.
Prüfe:
Die API muss nicht für jeden Use Case „AI-native“ sein. Aber wenn du einen Financial-Research-Assistenten baust, sollte die Datenebene für Python-Code und KI-Tools gleichermaßen gut nutzbar sein.
Unser Codex CLI MCP-Tutorial zeigt ein konkretes Beispiel im Finance-Kontext: einen Live-Portfolio-Dashboard-Agenten mit Alpha Vantage-Daten über einen MCP-Workflow.
Die obigen Kriterien sind nützlich, aber ich würde nie nur per Checkliste entscheiden. Ich würde die API gegen die relevanten Fehlermodi deines Projekts testen.
Für die folgenden Beispiele nutze ich Alpha Vantage, weil es historische Kurse, Live-Quotes, Fundamentaldaten, technische Indikatoren und KI-Workflow-Optionen an einem Ort bietet. Ziel ist zu prüfen, ob die API echte Projektanforderungen erfüllt, ohne übermäßigen Cleanup zu verursachen.
Für einen Backtester ist das einer der ersten Checks. Wenn eine Kursreihe Splits nicht sauber behandelt, werden alle darauf basierenden Renditeberechnungen fragwürdig.
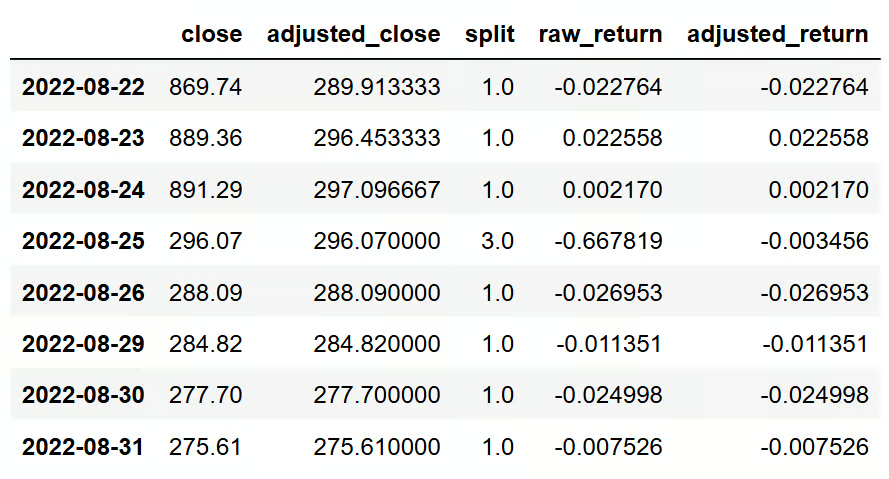
Der folgende Code zieht Teslas tägliche bereinigte Kurse rund um den Aktiensplit 2022 und vergleicht Roh- mit bereinigten Renditen.
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
So sieht die Ausgabe aus:
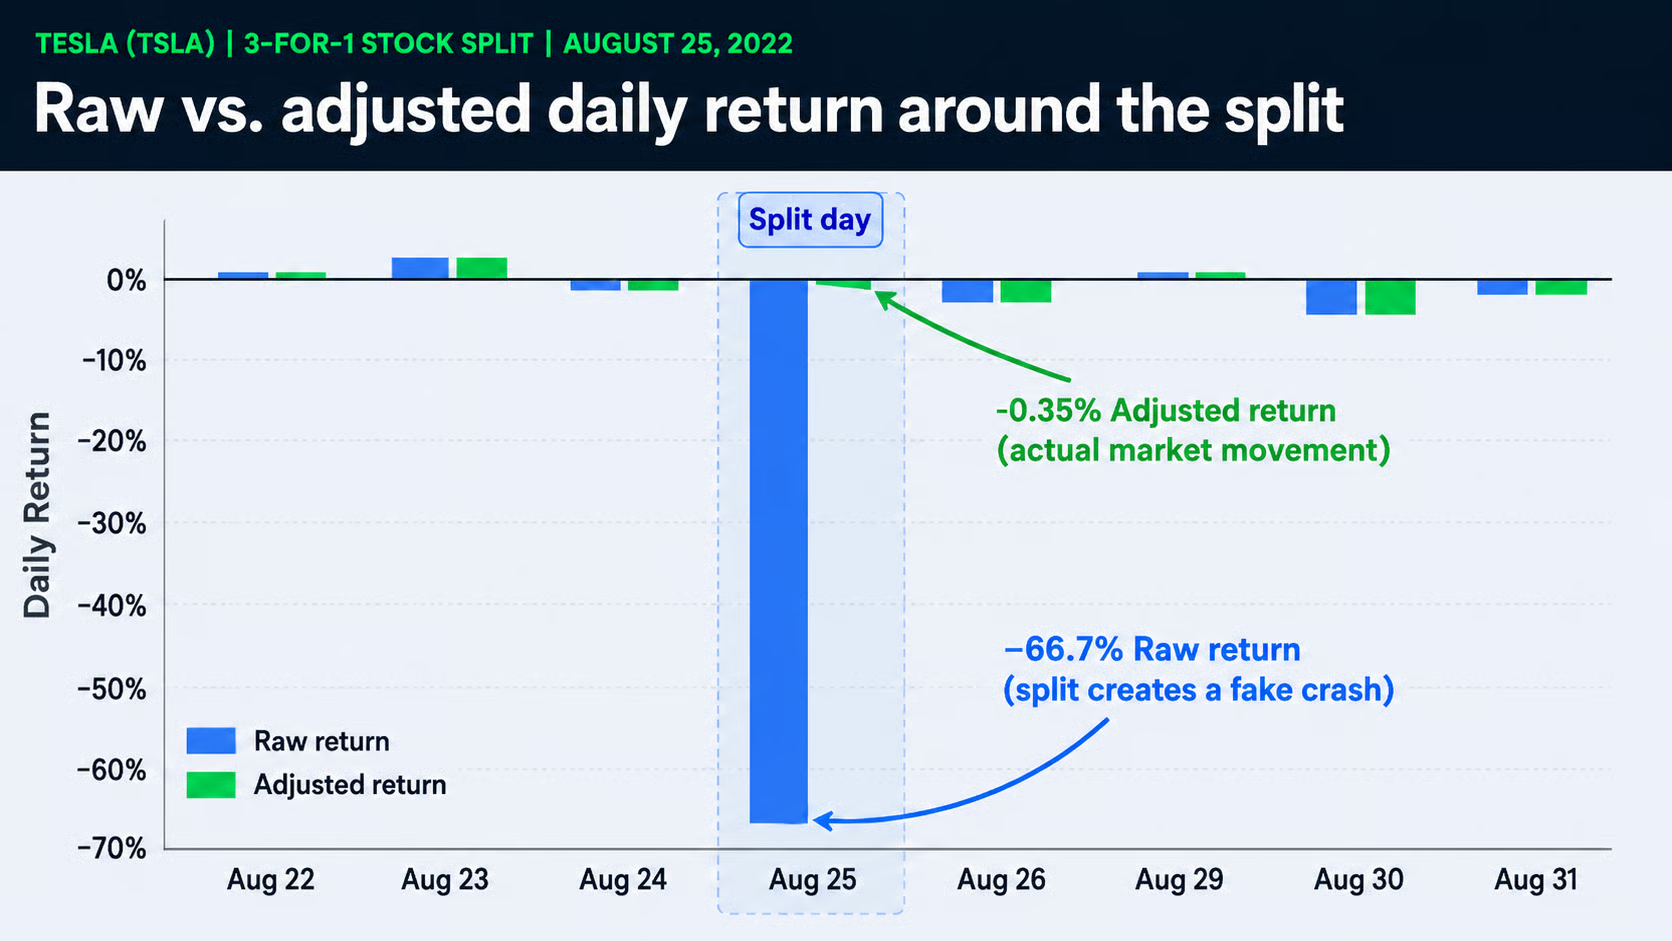
Genau deshalb sind bereinigte Daten wichtig.
Der Rohschlusskurs suggeriert am 25. August 2022 einen Einbruch von 66,7%. Das war kein echter Crash. Es war Teslas 3-zu-1-Split, der in der Rohpreisreihe sichtbar wird.
Die bereinigte Rendite am selben Tag liegt nur bei rund -0,35% und spiegelt die tatsächliche Marktbewegung nach Berücksichtigung des Splits deutlich besser wider.
Dieser kleine Check zeigt, ob die API die nötigen Felder liefert, um ein häufiges Backtesting-Problem zu erkennen. Eine lange Feature-Liste kann das nicht leisten.
Ein Dashboard oder Alarmsystem braucht nicht nur Daten. Es braucht Anfragen, die eindeutig fehlschlagen.
Dieser Helper fügt ein simples Retry-Muster hinzu und prüft gängige API-Response-Probleme. Es ist keine Produktiv-Infrastruktur, reicht aber, um zu testen, ob sich eine API bei Fehlern vorhersagbar verhält.
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
Das ist die Art Check, die ich ergänzen würde, bevor ich einer API in einem Dashboard oder Cron-Job vertraue.
Wichtig ist nicht die Retry-Anzahl. Wichtig ist, ob dein Code ein schlechtes Symbol, eine leere Antwort, eine Rate-Limit-Meldung und einen temporären Ausfall unterscheiden kann. Wenn jeder Fehler gleich aussieht, wird Debugging mit echten Nutzern zur Qual.
Für Screeners, Bewertungstools und KI-Assistenten würde ich testen, ob die API aus mehreren Endpoints ein sauberes Research-Objekt erzeugen kann.
Im Beispiel unten holen wir eine Quote und die Firmenübersicht für Apple und formen das Ergebnis zu einem kompakten Dictionary. Das liegt näher an dem, was eine Dashboard-Kachel, eine Screener-Zeile oder ein KI-Tool zurückgeben würde.
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
Die Ausgabe sieht so aus:
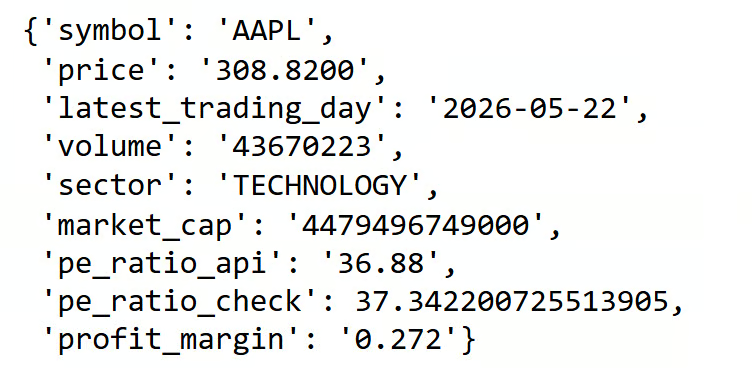
Das von der API gemeldete KGV und unsere einfache Price-zu-EPS-Rechnung sind nicht identisch, was normal ist, weil Anbieter unterschiedliche Timing-Konventionen oder bereinigte Inputs nutzen. Der Vergleich ist trotzdem hilfreich, weil er zeigt, ob die Felder grundsätzlich verwendbar sind.
Der Test ist nicht nur fürs Backtesting nützlich:
Dieser letzte Punkt zählt. MCP oder Tool Calling behebt keine unordentlichen Daten. Die API muss Felder liefern, die sich in ein vorhersagbares Objekt überführen lassen. Wenn jeder Endpoint Spezial-Cleanup braucht, wird der Agent-Workflow schnell fragil.
Der Praxistest ist simpel: Kannst du die Daten ziehen, validieren, eine Basiskennzahl berechnen und etwas zurückgeben, das ein anderer Systemteil direkt nutzt? Wenn ja, ist die API weit näher an „nützlich über das erste Notebook hinaus“.
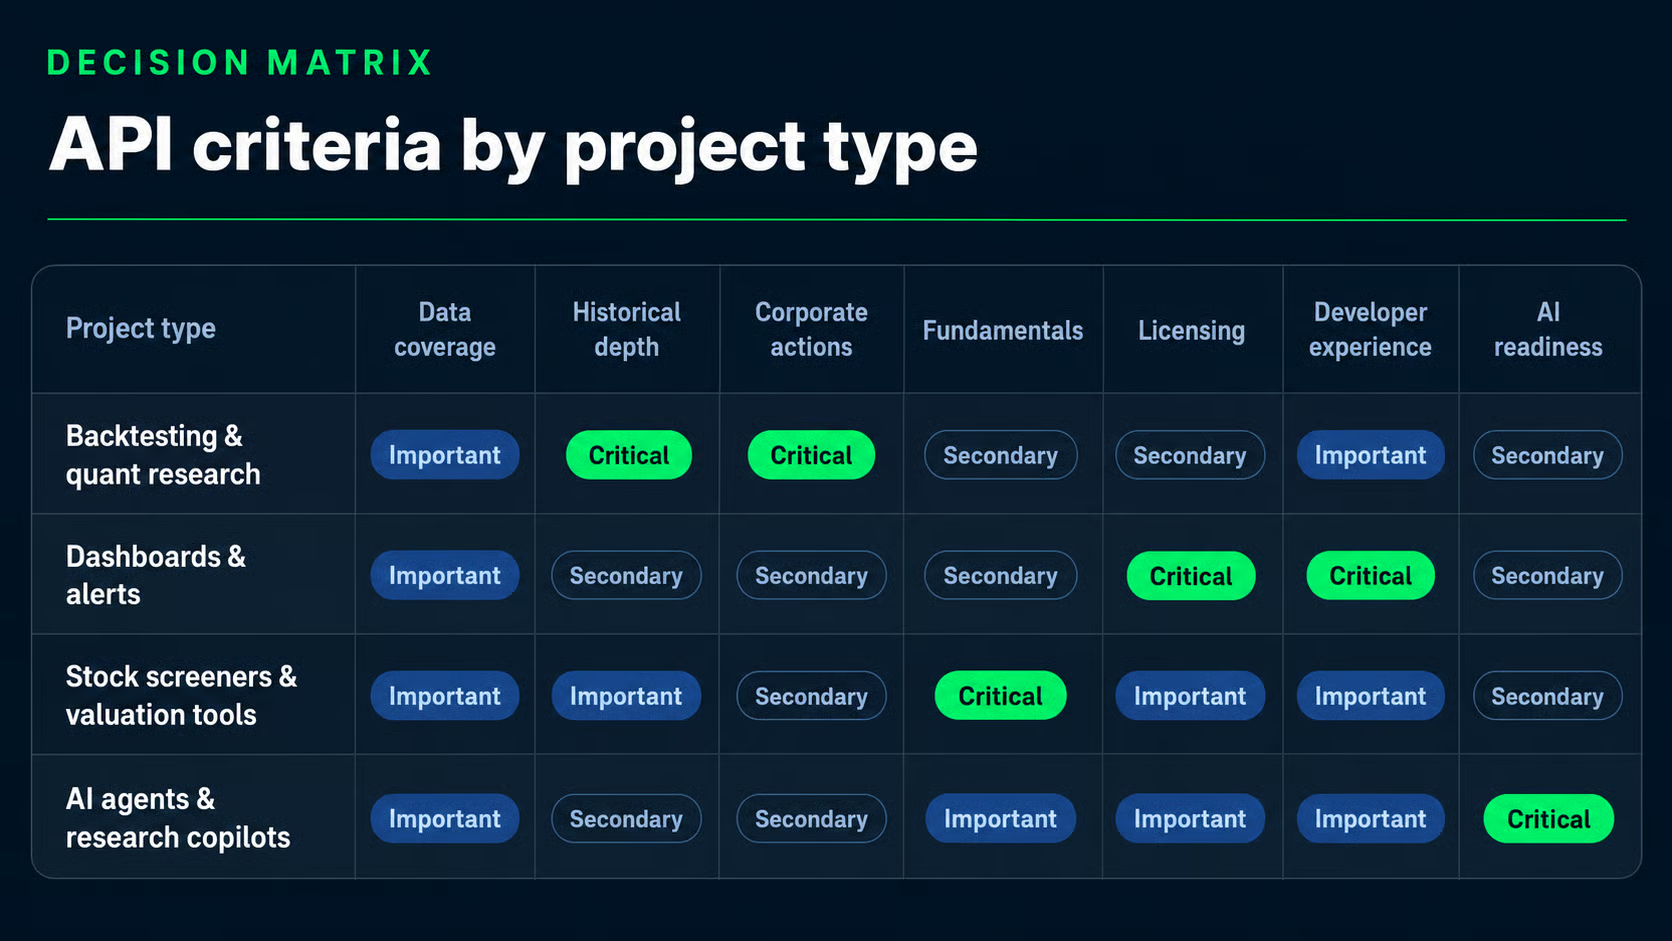
Jetzt bringen wir Workflow und Bewertungskriterien zusammen.
Der Zweck dieser Matrix ist nicht, Anbieter zu ranken. Sie soll dir helfen zu entscheiden, welche Kriterien in deinem Projekt am wichtigsten sind.
|
Projekttyp |
Wichtigste Kriterien |
Sekundäre Kriterien |
Anbieter, die passen könnten |
|
Backtesting und Quant-Research |
Historische Tiefe, bereinigte Kurse, Corporate Actions |
KI-Readiness, Lizenzierung |
Alpha Vantage für breite Historien- und Indikator-Workflows; EODHD für globales EOD-Research |
|
Dashboards und Alerts |
Lizenzierung, Response-Developer-Experience, Rate Limits |
Historische Tiefe, Fundamentaldaten |
QuoteMedia für entwicklerfreundliche Dashboards; Xignite für Enterprise-Finanzapps |
|
Stock Screeners und Bewertungstools |
Fundamentaldaten, Unternehmensmetadaten, Kennzahlen und Abschlüsse |
Historische Tiefe, Symbolabdeckung |
Alpha Vantage für breite Fundamentals- und Preis-Workflows; Intrinio für US-lastige Fundamentals-Tools |
|
KI-Agenten und Research-Copiloten |
Strukturierte Antworten, Toolzugriff, MCP-Readiness |
Fundamentaldaten, Indikatoren, Lizenzierung |
Alpha Vantage für MCP und breite API-Abdeckung |
Diese Tafel ist bewusst unvollkommen. Echte Projekte passen selten in eine Zeile, und ernsthafte Produkte kombinieren oft mehrere Workflows.
Für einen Backtester würde ich mit historischer Tiefe und Corporate Actions starten, bevor ich mir um Live-Quotes Gedanken mache.
Die Schlüsselfrage ist nicht „Kann ich Kurs-Historien ziehen?“, sondern „Kann ich dieser Historie über Splits, Dividenden, fehlende Tage und lange Marktregime hinweg trauen?“
Für diesen Workflow prüfe:
Echtzeitdaten können später wichtig werden, wenn du Richtung Live-Monitoring oder Ausführung gehst. Für historisches Research sind sie nicht die erste Priorität.
Für einen KI-Assistenten muss die API sowohl für Code als auch fürs Modell leicht nutzbar sein.
Ein menschlicher Entwickler kann eine unordentliche JSON-Response inspizieren und das Parsing fixen. Ein Agent-Workflow ist weniger verzeihend. Wenn das Schema unvorhersehbar ist, ruft das Modell zwar das richtige Tool auf, hat aber Mühe mit dem Ergebnis.
Für diesen Workflow prüfe:
Der übergeordnete Punkt ist simpel: Wähle die API nach dem Ausfallmodus, den du dir am wenigsten leisten kannst. Ein Backtester scheitert bei falscher Historie. Ein Dashboard scheitert ohne frische Antworten. Ein KI-Assistent scheitert, wenn die Datenzugriffsschicht zu chaotisch ist.
Es gibt nicht die eine beste Stock-API für jedes Projekt. Die richtige Wahl hängt davon ab, was dein System leisten muss: historische Tiefe fürs Backtesting, Aktualität für Dashboards, Fundamentaldaten für Screeners und strukturierte Antworten für KI-Workflows.
Darum war Alpha Vantage in diesem Artikel eine vielseitige API. Sie deckt mehrere der genannten Ebenen ab – Marktpreise, Fundamentaldaten, technische Indikatoren und MCP-basierte KI-Workflows – und erlaubt so, mehr als einen Entscheidungsfaktor zu testen, ohne den Anbieter zu wechseln.
Ich würde eine Stock-API als Teil der Dateninfrastruktur des Projekts behandeln, nicht nur als Sammlung von Endpoints. Sie beeinflusst deinen Code, die Datenbank, Refresh-Jobs, Model-Inputs, das Nutzererlebnis und sogar, was du im finalen Produkt zeigen darfst.
Wenn du stärkere Finance-Workflows in Python aufbauen willst, starte am besten mit unserem Kurs Python for Finance.
Lerne Finanzanalyse in Python mit DataCamp!
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Tutorial} other {Tutorials}}
Allan Ouko
11 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Matt Crabtree
5 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Moez Ali
6 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Laiba Siddiqui
6 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Kurtis Pykes
15 Min.
{count, plural, one {Tutorial} other {Tutorials}}
DataCamp Team
3 Min.