{count, plural, one {Cursus} other {Cursussen}}
Introductie tot Python voor Finance
{hours} uur
107.9K
De meeste stock-API-vergelijkingen beginnen op de verkeerde plek.
Ze vergelijken prijstiers, aantallen endpoints, documentatiepagina’s en limieten van gratis plannen. Die details zijn relevant, maar ze vertellen je niet of de API het systeem kan ondersteunen dat je bouwt.
Een backtest faalt niet omdat de provider minder endpoints heeft dan een concurrent. Hij faalt omdat historische prijzen niet correct zijn aangepast, de historie te kort is of corporate actions slecht zijn afgehandeld.
Een dashboard heeft een andere faalmodus. Het breekt wanneer quoteresponses traag zijn, velden onverwacht veranderen of rate limits een probleem worden zodra gebruikers de pagina beginnen te verversen.
Daarom zie ik generieke lijsten met “beste stock-API” als vertrekpunt, niet als antwoord. De echte vraag is: "Werkt deze API nog steeds wanneer mijn project geen prototype meer is?"
Zodra een API een echte workflow aandrijft, wordt het datainfrastructuur:
Later overstappen is pijnlijk, want je verandert niet alleen een request-URL. Je moet mogelijk pipelines herschrijven, refresh-jobs aanpassen, opslaglogica updaten, modelinputs bijstellen en delen van de user interface herzien.
De IEX Cloud-shutdown in 2024 is een nuttige herinnering. Veel ontwikkelaars en bedrijven hadden dashboards, apps en interne tools rond die API gebouwd. Toen de dienst werd stopgezet, betekende migreren opnieuw nadenken over endpoints, velden, prijzen, licenties en data-aannames.
Identificeer eerst de workflow die de API gaat ondersteunen. Een backtester en een dashboard gebruiken misschien allebei koersen, maar leunen niet op dezelfde data-eisen.
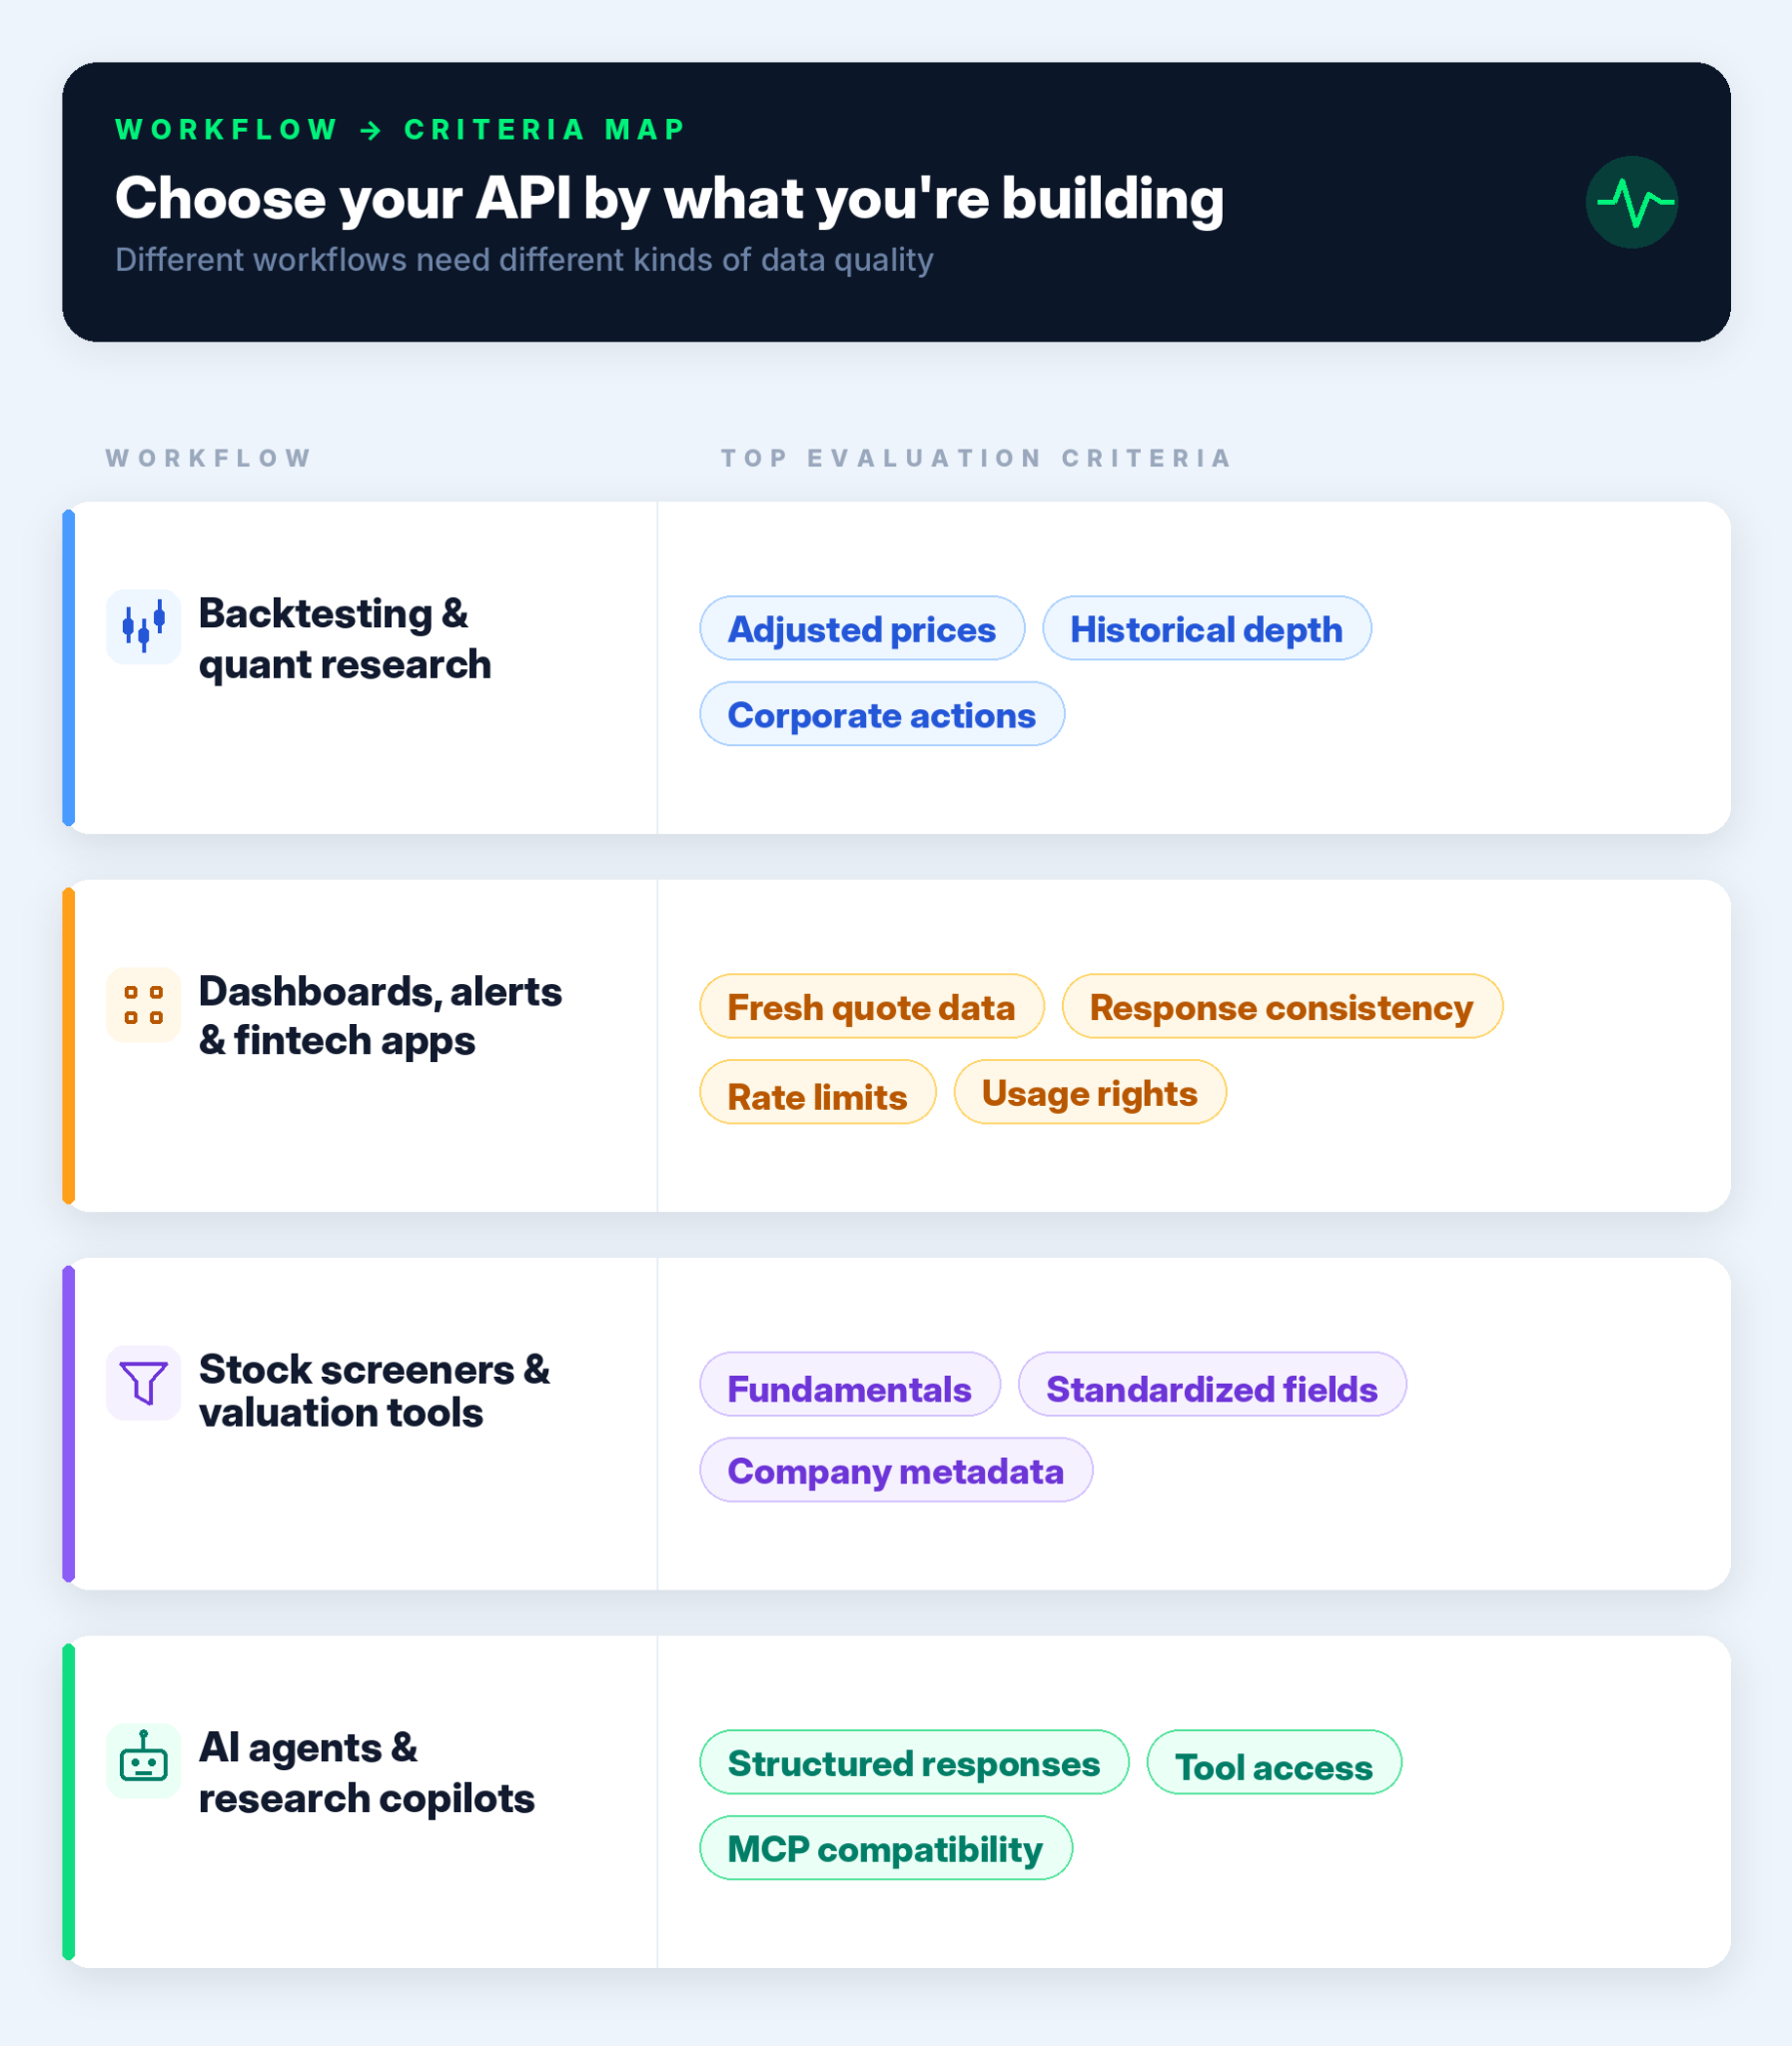
Voor backtesting is schone historische data meestal belangrijker dan live data.
Belangrijke criteria om te checken:
Voor een diepere duik in het implementeren en testen van handelsstrategieën in Python behandelt onze tutorial Algorithmic Trading in Python backtesting-concepten en valkuilen in meer detail.
Dashboards en alertsystemen geven prioriteit aan versheid, betrouwbaarheid en consistentie. Een privé-notebook kan een mislukte request of een rommelige veldnaam verdragen. Een product voor gebruikers niet.
Belangrijke criteria om te checken:
Screeners en waarderingstools hebben bedrijfsdata nodig, niet alleen prijsdata. De hoofduitdaging is vergelijking, omdat je meestal veel bedrijven tegelijk filtert of rangschikt.
Belangrijke criteria om te checken:
AI-workflows hebben API’s nodig die gestructureerde, voorspelbare data retourneren. Een LLM kan tekst samenvatten, maar mag financiële data niet raden.
Belangrijke criteria om te checken:
Om van API-data naar een werkende agent te gaan, laat de Model Context Protocol (MCP)-gids zien hoe MCP AI-modellen aan externe tools koppelt, terwijl de tutorials Building LangChain Agents en OpenAI Agents SDK tonen hoe je dat in de praktijk brengt met Python.
Zodra je de workflow kent, wordt API’s vergelijken makkelijker. Je vraagt niet langer: “Welke provider heeft de meeste features?” maar: “Welke provider kan de datalaag ondersteunen die dit project nodig heeft?”
|
Criteria |
Wat te checken |
Waarom het telt |
|
Datadekking |
Asset classes, markten, symbolen en geografie |
De API moet het universum dekken dat je project echt nodig heeft |
|
Historische diepte |
Lengte van de historie, toegang tot volledige historie, aangepaste en onaangepaste data |
Backtests en researchtools hebben meer nodig dan recente data |
|
Datakwaliteit en corporate actions |
Splits, dividenden, tickerwijzigingen, ontbrekende rijen en verouderde symbolen |
Slechte aanpassingen kunnen grafieken, rendementen en modeloutputs vervormen |
|
Fundamentals-ondersteuning |
Statements, earnings, ratio’s, bedrijfsprofielen en metadata |
Screeners en waarderingstools hebben bedrijfscontext nodig, niet alleen prijzen |
|
Licenties en redistributie |
Weergaverechten, opslagrechten, commercieel gebruik en beursregels |
Een notebook-usecase is anders dan een publiek of betaald product |
|
Developer experience |
Documentatie, responseformaat, errors, rate limits en bruikbaarheid in Python |
Schone API’s besparen tijd na de eerste request |
|
AI- en agentgereedheid |
Gestructureerde responses, tooltoegang, MCP-ondersteuning en voorspelbare schema’s |
AI-assistenten hebben data nodig die ze kunnen ophalen, parsen en erover redeneren |
Dekking moet passen bij het project, niet bij de marketingpagina.
Check:
De fout is de provider kiezen met de grootste dekkingsclaim in plaats van degene die je daadwerkelijke query-universum dekt.
Historische diepte telt wanneer het project ideeën over verschillende marktomstandigheden moet testen.
Check:
Er is een verschil tussen “we bieden historische prijzen” en “deze dataset is diep genoeg voor serieuze tests”.
Hier wordt aandelendata irritant.
Check:
Voor het omgaan met de rommeligere kant van financiële data (denk aan missende waarden, inconsistente velden en formaatproblemen) behandelt de track Importing & Cleaning Data in Python de kerntechnieken die je nodig hebt zodra de API-calls werken.
Fundamentals tellen wanneer het project bedrijfscontext nodig heeft, niet alleen koersbeweging.
Check:
Het sleutelwoord is consistentie. Als je bedrijven vergelijkt, moeten velden universeel werken zonder custom logica per ticker.
Licenties zijn saai totdat ze het product blokkeren.
Check:
Ik ontdek deze grenzen liever vóór het schrijven van de pipeline dan na het bouwen van de frontend.
Een schone API bespaart tijd na de eerste request.
Check:
De eerste geslaagde call is niet de echte test. De echte test is of de API nog steeds schoon aanvoelt nadat je refresh-jobs, errorafhandeling en joins met andere datasets hebt toegevoegd.
AI-workflows hebben voorspelbare data-access nodig.
Check:
De API hoeft niet voor elke usecase “AI-native” te zijn. Maar als je een financiële researchassistent bouwt, moet de datalaag makkelijk te gebruiken zijn voor zowel Pythoncode als AI-tools.
Onze Codex CLI MCP-tutorial laat hiervan een concreet voorbeeld zien in een financiële context: een live portfoliodashboard-agent met Alpha Vantage-data via een MCP-workflow.
De bovenstaande criteria zijn nuttig, maar ik zou niet alleen op een checklist een provider kiezen. Ik zou de API testen op de faalmodi die voor het project belangrijk zijn.
Voor de voorbeelden hieronder gebruik ik Alpha Vantage omdat we er historische prijzen, live quotedata, fundamentals, technische indicatoren en AI-workflowopties op één plek uit kunnen halen. Het doel is te checken of de API aan echte projectvereisten kan voldoen zonder buitensporig opschoonwerk te veroorzaken.
Voor een backtester is dit één van de eerste checks die ik zou draaien. Als een prijsreeks splits niet netjes afhandelt, wordt elke rendementscalculatie die erop rust twijfelachtig.
De code hieronder haalt Tesla’s dagelijks aangepaste prijzen op rond de aandelensplits van 2022 en vergelijkt ruwe rendementen met aangepaste rendementen.
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
Hier is de output:
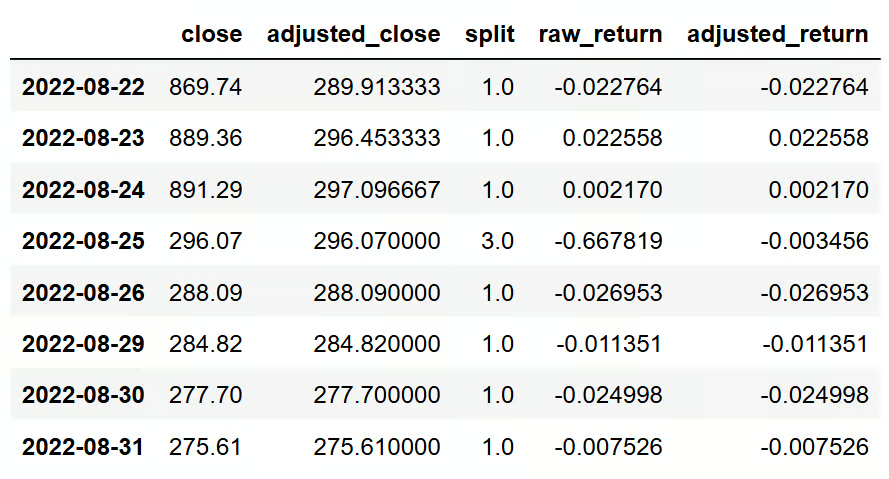
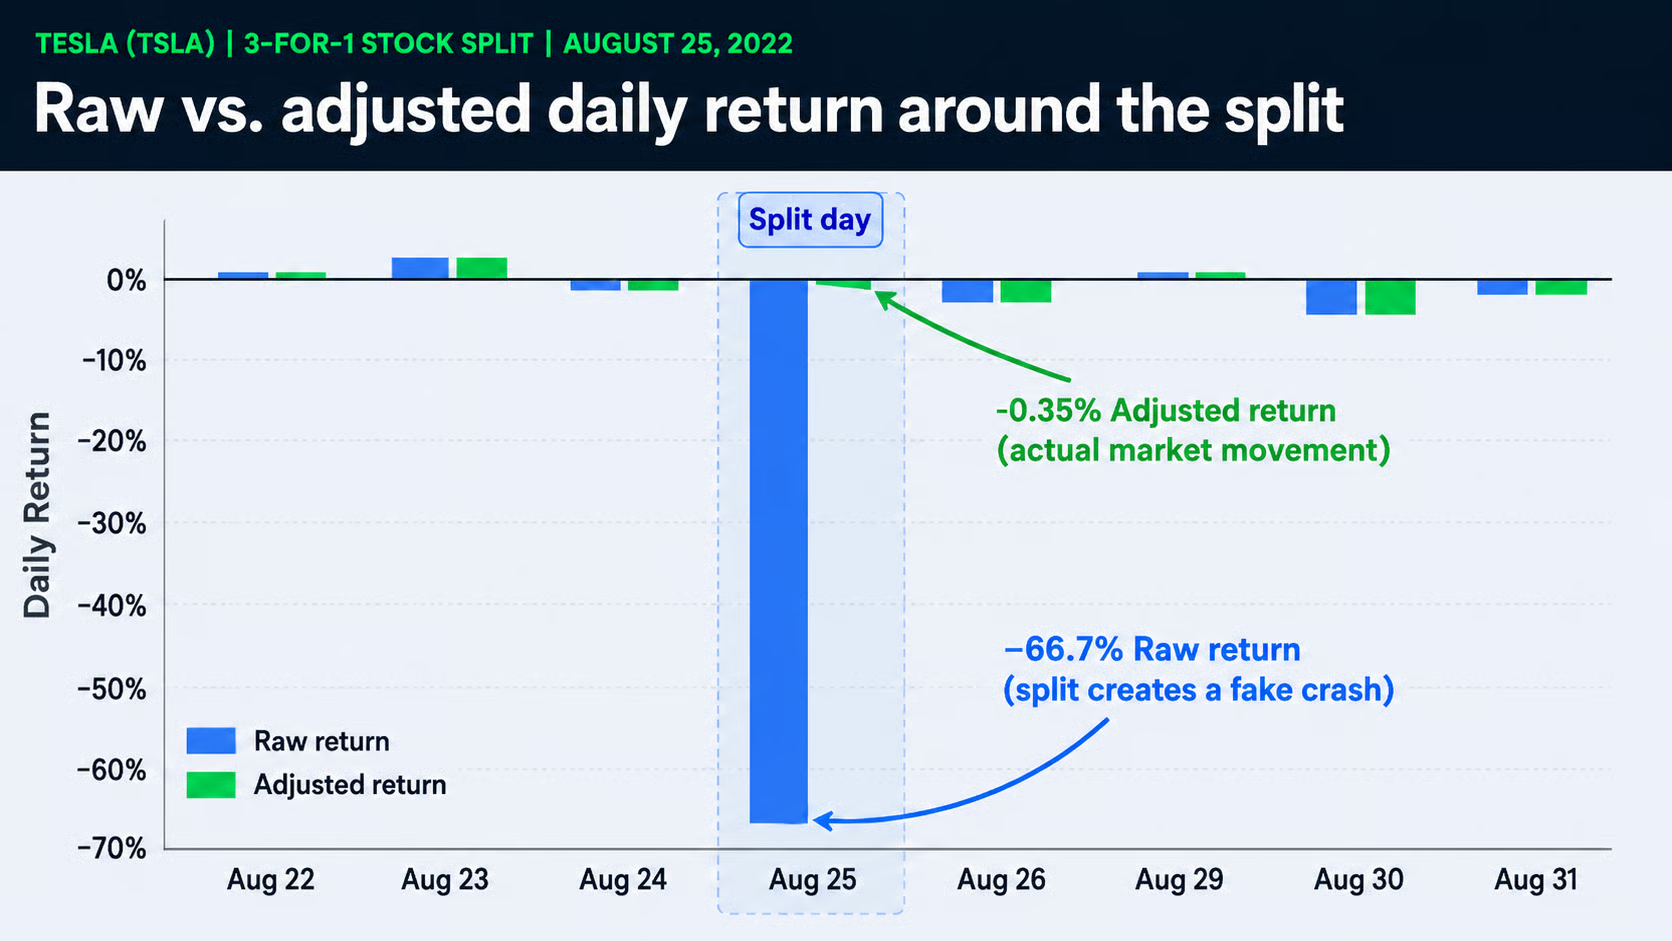
Dit is precies waarom aangepaste data belangrijk is.
De ruwe slotkoers suggereert een daling van 66,7% op 25 augustus 2022. Dat was geen echte crash. Het was Tesla’s 3-op-1 aandelensplits die zichtbaar werd in de ruwe prijsreeks.
Het aangepaste rendement voor dezelfde dag is slechts rond de -0,35%, wat veel dichter bij de daadwerkelijke marktbeweging ligt na correctie voor de splits.
Deze kleine check vertelt je of de API je de velden geeft die nodig zijn om een veelvoorkomend backtestingprobleem te vangen. Een lange featurelijst kan je dat niet vertellen.
Een dashboard of alertsysteem heeft niet alleen data nodig. Het heeft requests nodig die duidelijk falen.
Deze helper voegt een eenvoudige retry-patroon toe en checkt op veelvoorkomende API-responseproblemen. Het is geen productie-infrastructuur, maar genoeg om te testen of een API zich voorspelbaar gedraagt wanneer iets misgaat.
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
Dit is het soort check dat ik zou toevoegen voordat ik een API vertrouw binnen een dashboard of geplande job.
Het belangrijkste is niet het aantal retries. Het is of je code een slecht symbool, een lege response, een rate-limit-bericht en een tijdelijke requestfout kan onderscheiden. Als elke fout hetzelfde lijkt, wordt debuggen pijnlijk zodra het project gebruikers heeft.
Voor screeners, waarderingstools en AI-assistenten zou ik testen of de API een schoon researchobject kan opleveren uit meerdere endpoints.
Het voorbeeld hieronder haalt een quote en bedrijfsprofiel voor Apple op en zet het resultaat om in een compact dictionary. Dit ligt dichter bij wat een dashboardkaart, screener-rij of AI-toolresponse nodig zou hebben.
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
De output ziet er zo uit:
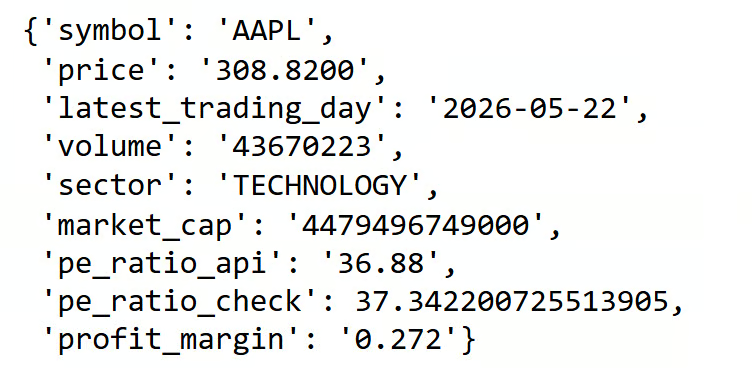
De door de API gerapporteerde K/W-ratio en onze simpele prijs-tot-wpa-berekening zijn niet identiek, wat normaal is omdat providers verschillende timingconventies of aangepaste inputs kunnen gebruiken. Maar de vergelijking is toch nuttig, omdat ze aangeeft of de velden richtinggevend bruikbaar zijn.
Deze test is niet alleen nuttig voor backtesting:
Dat laatste punt telt. MCP of tool calling repareert rommelige data niet magisch. De API moet nog steeds velden retourneren die je kunt omzetten in een voorspelbaar object. Als elk endpoint custom opschonen vereist, wordt de agentworkflow snel fragiel.
De praktische test is simpel: kun je de data ophalen, valideren, een basismetric berekenen en iets teruggeven dat een ander deel van het systeem kan gebruiken? Zo ja, dan is de API veel dichter bij bruikbaar voorbij het eerste notebook.
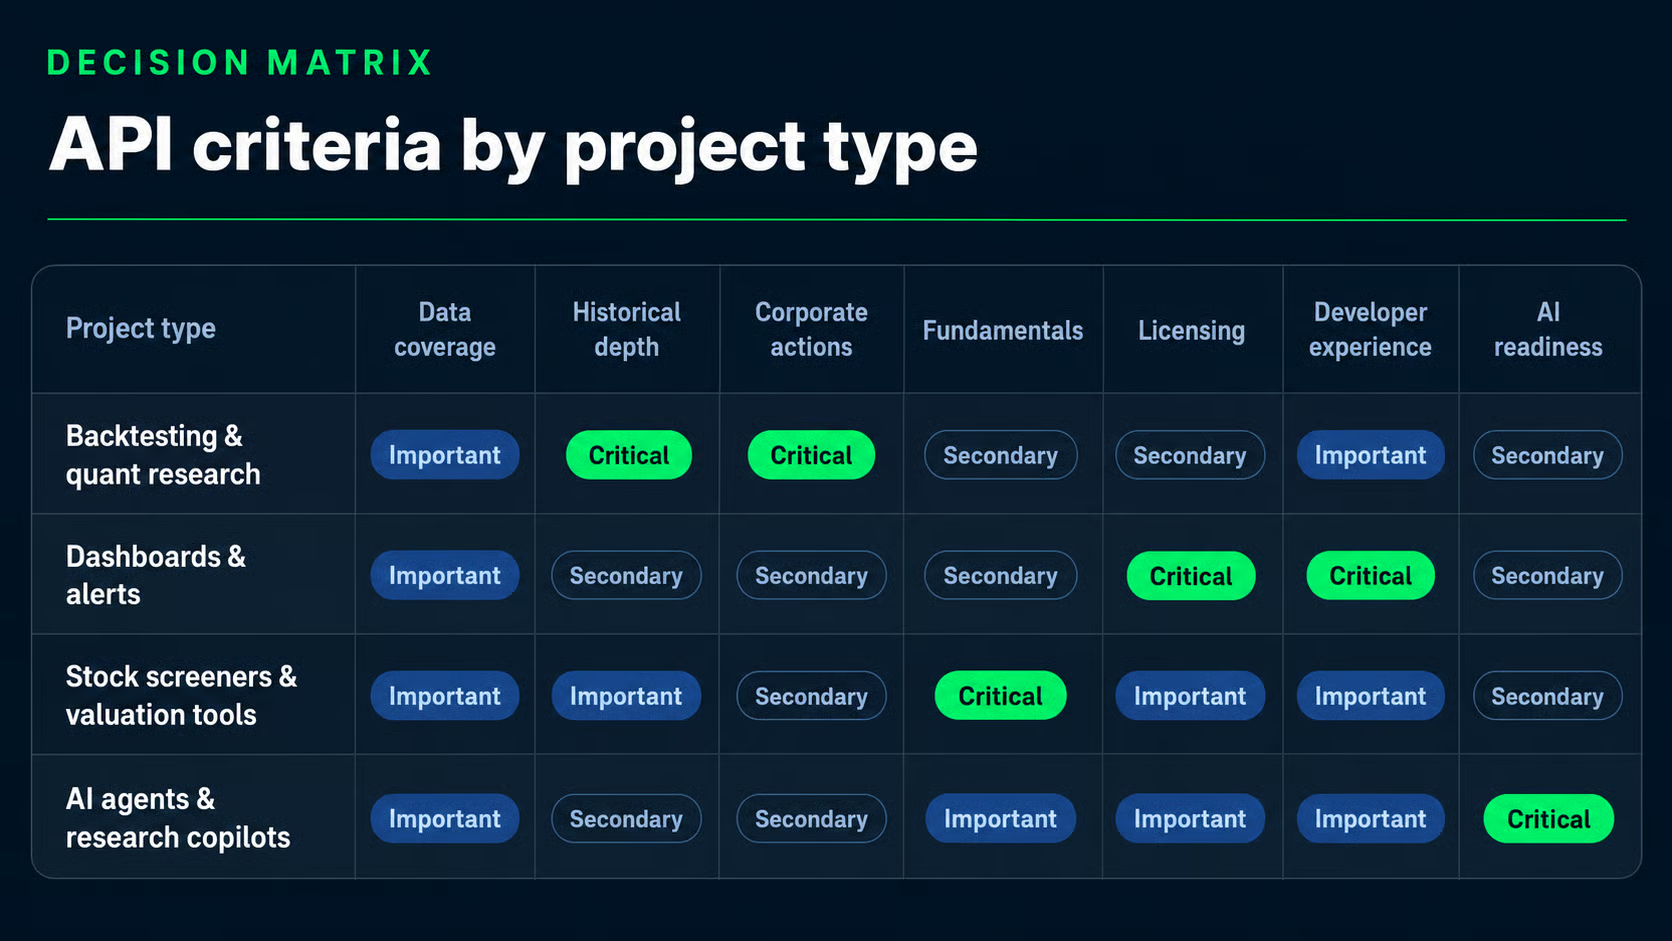
Nu kunnen we de workflow en evaluatiecriteria samenbrengen.
Het doel van deze matrix is niet om providers te rangschikken. Ze helpt je te beslissen welke criteria de meeste aandacht verdienen voor het project dat je bouwt.
|
Projecttype |
Belangrijkste criteria |
Secundaire criteria |
Providerfit om te overwegen |
|
Backtesting en quant-onderzoek |
Historische diepte, aangepaste prijzen en corporate actions |
AI-gereedheid, licenties |
Alpha Vantage voor brede historische en indicatorworkflows; EODHD voor wereldwijd EOD-onderzoek |
|
Dashboards en alerts |
Licenties, developer experience van responses, rate limits |
Historische diepte, fundamentals |
QuoteMedia voor developer-vriendelijke dashboards; Xignite voor enterprise-financiële apps |
|
Aandelen-screeners en waarderingstools |
Fundamentals, bedrijfsmetadata, ratio’s en financiële overzichten |
Historische diepte, symbooldekking |
Alpha Vantage voor brede fundamentals- en prijsworkflows; Intrinio voor fundamentals-zware tools in de VS |
|
AI-agents en research-copilots |
Gestructureerde responses, tooltoegang en MCP-gereedheid |
Fundamentals, indicatoren, licenties |
Alpha Vantage voor MCP en brede API-dekking |
Deze tabel is bewust niet perfect. Echte projecten passen zelden in één rij, en serieuze producten combineren meestal meer dan één workflow.
Voor een backtester zou ik beginnen met historische diepte en corporate actions, vóór ik me druk maak om live quotes.
De kernvraag is niet: “Kan ik koershistorie ophalen?” maar: “Kan ik deze koershistorie vertrouwen over splits, dividenden, ontbrekende datums en lange marktregimes heen?”
Voor deze workflow, check:
Realtime data kan later relevant worden als je richting live monitoring of executie gaat. Voor historisch onderzoek is het niet de eerste prioriteit.
Voor een AI-assistent moet de API voor zowel code als model makkelijk werkbaar zijn.
Een menselijke ontwikkelaar kan een rommelige JSON-response inspecteren en de parse-logica fixen. Een agentworkflow is minder vergevingsgezind. Als het schema onvoorspelbaar is, kan het model de juiste tool aanroepen maar alsnog moeite hebben met het resultaat.
Voor deze workflow, check:
Het bredere punt is simpel: kies de API op basis van de faalmodus die je je het minst kunt permitteren. Een backtester faalt wanneer de historie niet klopt. Een dashboard faalt wanneer gebruikers geen verse responses krijgen. Een AI-assistent faalt wanneer de data-accesslaag te rommelig is om te gebruiken.
Er is geen enkele beste stock-API voor elk project. De juiste keuze hangt af van wat je systeem moet doen: historische diepte voor backtesting, versheid voor dashboards, fundamentals voor screeners en gestructureerde responses voor AI-workflows.
Dit is ook waarom Alpha Vantage een veelzijdige API was in de voorbeelden in dit artikel. Het dekt meerdere lagen die we bespraken, waaronder marktdata, fundamentals, technische indicatoren en MCP-gebaseerde AI-workflows, zodat we meer dan één beslisfactor kunnen testen zonder van provider te wisselen.
Ik zou een stock-API behandelen als onderdeel van de datainfrastructuur van het project, niet alleen als een verzameling endpoints. Het beïnvloedt je code, database, refresh-jobs, modelinputs, gebruikerservaring en zelfs wat je in het eindproduct mag tonen.
Als je graag sterkere finance-workflows in Python wilt bouwen, raad ik aan te beginnen met onze cursus Python for Finance.
Leer financiële analyse in Python met DataCamp!
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min