{count, plural, one {कोर्स} other {कोर्स}}
Finance के लिए Python परिचय
{hours} घंटा
107.9K
ज़्यादातर स्टॉक API तुलना गलत जगह से शुरू होती हैं।
वे प्राइसिंग टियर, एंडपॉइंट काउंट्स, डॉक्यूमेंटेशन पेज, और फ्री-प्लान लिमिट्स की तुलना करती हैं। ये बातें मायने रखती हैं, लेकिन यह नहीं बतातीं कि API उस सिस्टम को सपोर्ट कर पाएगी जिसे आप बना रहे हैं।
बैकटेस्ट इसलिए फेल नहीं होता कि प्रदाता के पास किसी प्रतिस्पर्धी से कम एंडपॉइंट हैं। वह इसलिए फेल होता है क्योंकि ऐतिहासिक कीमतें सही तरह से समायोजित नहीं हैं, डेटा इतिहास बहुत छोटा है, या कॉरपोरेट एक्शंस को ठीक से हैंडल नहीं किया गया है।
डैशबोर्ड की विफलता अलग होती है। यह तब टूटता है जब कोट रिस्पॉन्स धीमे हों, फ़ील्ड्स अप्रत्याशित रूप से बदलें, या यूज़र्स के पेज रिफ्रेश करना शुरू करने पर रेट लिमिट्स समस्या बन जाएँ।
इसीलिए मैं सामान्य “सर्वश्रेष्ठ स्टॉक API” सूचियों को उत्तर नहीं बल्कि शुरुआती बिंदु मानता हूँ। असली सवाल है: "क्या यह API तब भी काम करेगी जब मेरा प्रोजेक्ट प्रोटोटाइप होना बंद कर दे?"
एक बार जब कोई API वास्तविक वर्कफ़्लो चलाती है, तो वह डेटा इन्फ्रास्ट्रक्चर बन जाती है:
बाद में स्विच करना दर्दनाक होता है क्योंकि आप सिर्फ़ एक रिक्वेस्ट URL नहीं बदल रहे होते। आपको पाइपलाइन्स, रिफ्रेश जॉब्स, स्टोरेज लॉजिक, मॉडल इनपुट्स को फिर से लिखना, और यूज़र इंटरफ़ेस के हिस्से अपडेट करने पड़ सकते हैं।
2024 में IEX Cloud का शटडाउन एक उपयोगी याद दिलाता है। कई डेवलपर्स और कंपनियों ने इसके API पर डैशबोर्ड, ऐप्स और आंतरिक टूल्स बनाए थे। सेवा बंद होने के बाद, माइग्रेशन का मतलब एंडपॉइंट्स, फ़ील्ड्स, प्राइसिंग, लाइसेंसिंग और डेटा अनुमानों पर फिर से विचार करना था।
प्रदाताओं की तुलना करने से पहले, वह वर्कफ़्लो पहचानें जिसे API सपोर्ट करेगी। बैकटेस्टर और डैशबोर्ड दोनों स्टॉक कीमतें उपयोग कर सकते हैं, लेकिन उनकी डेटा आवश्यकताएँ एक जैसी नहीं होतीं।
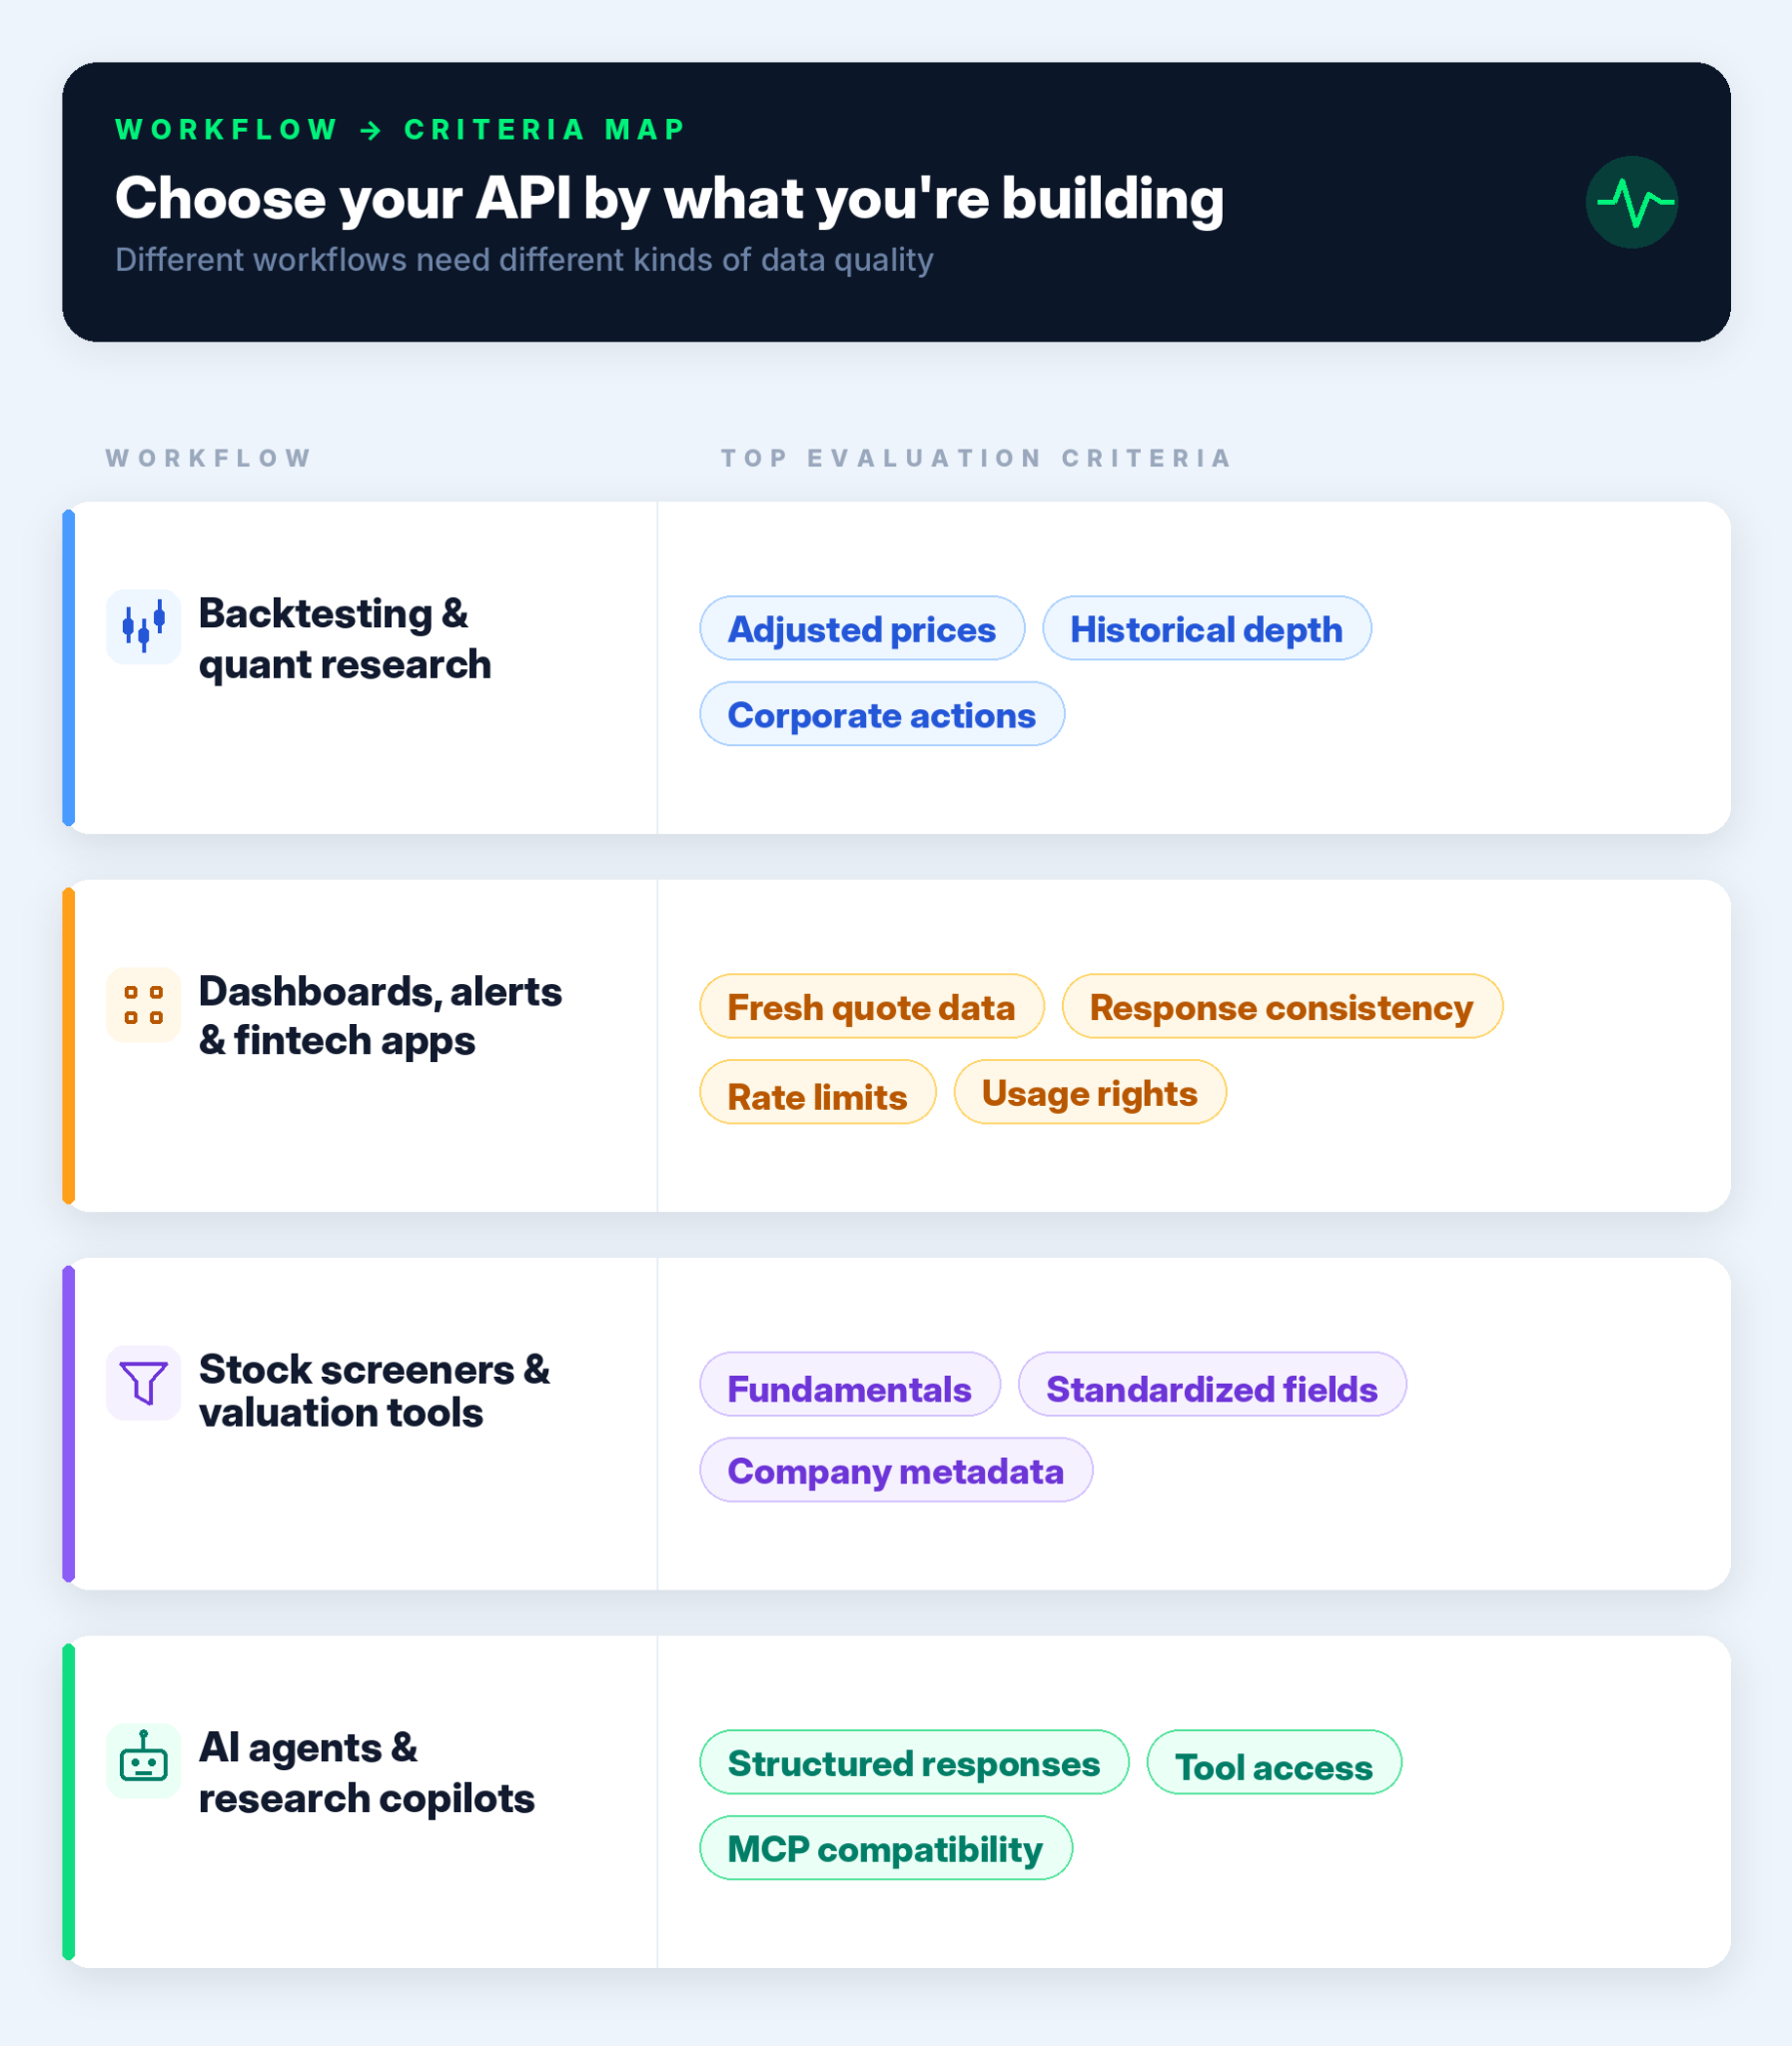
बैकटेस्टिंग के लिए, आमतौर पर स्वच्छ ऐतिहासिक डेटा लाइव डेटा से अधिक मायने रखता है।
जाँचने के मुख्य मानदंड:
Python में ट्रेडिंग स्ट्रैटेजीज़ को लागू करने और टेस्ट करने की गहराई से समझ के लिए, हमारा Algorithmic Trading in Python ट्यूटोरियल बैकटेस्टिंग की अवधारणाओं और कमियों को विस्तार से समझाता है।
डैशबोर्ड और अलर्ट सिस्टम ताज़गी, विश्वसनीयता और सुसंगतता को प्राथमिकता देते हैं। एक निजी नोटबुक असफल रिक्वेस्ट या उलझे फ़ील्ड नाम को बर्दाश्त कर सकती है। यूज़र-फेसिंग उत्पाद नहीं।
जाँचने के मुख्य मानदंड:
स्क्रीनर्स और वैल्यूएशन टूल्स को केवल प्राइस डेटा नहीं, बिज़नेस डेटा चाहिए। मुख्य चुनौती तुलना है क्योंकि आप अक्सर एक साथ कई कंपनियों को फ़िल्टर या रैंक कर रहे होते हैं।
जाँचने के मुख्य मानदंड:
AI वर्कफ़्लोज़ को ऐसे APIs चाहिए जो स्ट्रक्चर्ड, पूर्वानुमेय डेटा लौटाएँ। एक LLM टेक्स्ट का सारांश निकाल सकता है, लेकिन उसे वित्तीय डेटा का अनुमान नहीं लगाना चाहिए।
जाँचने के मुख्य मानदंड:
API डेटा से काम करने वाले एजेंट तक जाने के लिए, Model Context Protocol (MCP) गाइड बताता है कि MCP कैसे AI मॉडल्स को बाहरी टूल्स से जोड़ता है, जबकि Building LangChain Agents और OpenAI Agents SDK ट्यूटोरियल दिखाते हैं कि इसे Python में व्यवहार में कैसे लाएँ।
एक बार जब आपको वर्कफ़्लो पता चल जाए, तो APIs की तुलना आसान हो जाती है। अब आप यह नहीं पूछ रहे, “किस प्रदाता के पास सबसे ज़्यादा फ़ीचर्स हैं?” आप पूछ रहे हैं, “कौन-सा प्रदाता वह डेटा लेयर सपोर्ट कर सकता है जिसकी इस प्रोजेक्ट को ज़रूरत है?”
|
मानदंड |
क्या जाँचना है |
क्यों मायने रखता है |
|
डेटा कवरेज |
एसेट क्लासेस, मार्केट्स, सिंबल्स और भूगोल |
API को वही यूनिवर्स कवर करना चाहिए जिसकी आपके प्रोजेक्ट को वास्तव में ज़रूरत है |
|
ऐतिहासिक गहराई |
इतिहास की लंबाई, फुल-हिस्ट्री एक्सेस, समायोजित और असमायोजित डेटा |
बैकटेस्ट और रिसर्च टूल्स को हालिया डेटा से अधिक चाहिए |
|
डेटा गुणवत्ता और कॉरपोरेट एक्शंस |
स्प्लिट्स, डिविडेंड्स, टिकर बदलाव, गुम पंक्तियाँ, और स्टेल सिंबल्स |
खराब समायोजन चार्ट्स, रिटर्न्स और मॉडल आउटपुट को विकृत कर सकते हैं |
|
फ़ंडामेंटल्स सपोर्ट |
स्टेटमेंट्स, अर्निंग्स, रेशियो, कंपनी प्रोफाइल्स और मेटाडेटा |
स्क्रीनर्स और वैल्यूएशन टूल्स को केवल कीमतें नहीं, बिज़नेस संदर्भ चाहिए |
|
लाइसेंसिंग और रीडिस्ट्रिब्यूशन |
डिस्प्ले अधिकार, स्टोरेज अधिकार, कमर्शियल उपयोग, और एक्सचेंज नियम |
नोटबुक का उपयोग पब्लिक या पेड प्रोडक्ट से अलग होता है |
|
डेवलपर अनुभव |
डॉक्यूमेंटेशन, रिस्पॉन्स फ़ॉर्मैट, एरर्स, रेट लिमिट्स, और Python उपयोगिता |
क्लीन APIs पहली रिक्वेस्ट के बाद समय बचाती हैं |
|
AI और एजेंट तैयारी |
स्ट्रक्चर्ड रिस्पॉन्स, टूल एक्सेस, MCP सपोर्ट, और पूर्वानुमेय स्कीमा |
AI असिस्टेंट्स को ऐसा डेटा चाहिए जिसे वे रिट्रीव, पार्स और रीज़न कर सकें |
कवरेज मार्केटिंग पेज नहीं, प्रोजेक्ट से मैच होना चाहिए।
जाँचें:
गलती यह है कि सबसे बड़े कवरेज दावे वाले प्रदाता को चुन लिया जाए, न कि उस प्रदाता को जो आपके वास्तविक क्वेरी यूनिवर्स को कवर करता है।
जब प्रोजेक्ट को अलग-अलग मार्केट कंडीशन्स में आइडियाज़ टेस्ट करने की ज़रूरत हो, तब ऐतिहासिक गहराई मायने रखती है।
जाँचें:
“हम ऐतिहासिक कीमतें देते हैं” और “यह डेटासेट गंभीर परीक्षण के लिए पर्याप्त गहरा है” में फ़र्क है।
यहीं स्टॉक डेटा परेशान करने लगता है।
जाँचें:
वित्तीय डेटा के पेचीदा हिस्सों (जैसे गुम मान, असंगत फ़ील्ड्स और फ़ॉर्मैट समस्याएँ) को संभालने के लिए, Importing & Cleaning Data in Python ट्रैक उन कोर तकनीकों को कवर करता है जिनकी ज़रूरत API कॉल्स के काम करने के बाद पड़ती है।
जब प्रोजेक्ट को सिर्फ़ प्राइस मूवमेंट नहीं, बिज़नेस संदर्भ चाहिए, तब फ़ंडामेंटल्स मायने रखते हैं।
जाँचें:
मुख्य शब्द है सुसंगतता। यदि आप कंपनियों की तुलना कर रहे हैं, तो फ़ील्ड्स पूरे यूनिवर्स में बिना हर टिकर के लिए कस्टम लॉजिक के काम करने चाहिए।
लाइसेंसिंग उबाऊ लगती है—जब तक कि वह प्रोडक्ट को ब्लॉक न कर दे।
जाँचें:
मैं इन सीमाओं को पाइपलाइन लिखने से पहले ढूँढ़ना पसंद करूँगा, फ्रंटएंड बनने के बाद नहीं।
एक क्लीन API पहली रिक्वेस्ट के बाद समय बचाती है।
जाँचें:
पहली सफल कॉल असली टेस्ट नहीं है। असली टेस्ट यह है कि रिफ्रेश जॉब्स, एरर हैंडलिंग और अन्य डेटासेट्स के साथ जॉइन्स जोड़ने के बाद भी API क्लीन महसूस होती है या नहीं।
AI वर्कफ़्लोज़ को पूर्वानुमेय डेटा एक्सेस चाहिए।
जाँचें:
हर उपयोग केस के लिए API का “AI-नेटिव” होना ज़रूरी नहीं है। लेकिन यदि आप एक फ़ाइनेंशियल रिसर्च असिस्टेंट बना रहे हैं, तो डेटा लेयर Python कोड और AI टूल्स—दोनों के लिए आसान होनी चाहिए।
हमारा Codex CLI MCP ट्यूटोरियल फ़ाइनेंस संदर्भ में इसका ठोस उदाहरण दिखाता है—MCP वर्कफ़्लो के ज़रिए Alpha Vantage डेटा का उपयोग करते हुए लाइव पोर्टफ़ोलियो डैशबोर्ड एजेंट बनाना।
ऊपर दिए मानदंड उपयोगी हैं, लेकिन मैं केवल चेकलिस्ट से प्रदाता नहीं चुनूँगा। मैं API को उन फ़ेल्योर मोड्स के विरुद्ध टेस्ट करूँगा जो प्रोजेक्ट के लिए मायने रखते हैं।
नीचे दिए गए उदाहरणों के लिए, मैं Alpha Vantage का उपयोग करूँगा क्योंकि यह हमें एक ही जगह पर ऐतिहासिक कीमतें, लाइव कोट डेटा, फ़ंडामेंटल्स, तकनीकी इंडिकेटर्स और AI वर्कफ़्लो विकल्प देता है। मक़सद यह जाँचना है कि API वास्तविक प्रोजेक्ट आवश्यकताओं को बिना अत्यधिक क्लीनअप के पूरा कर सकती है या नहीं।
बैकटेस्टर के लिए, यह उन पहली जाँचों में से एक है जो मैं करूँगा। यदि कोई प्राइस सीरीज़ स्प्लिट्स को साफ़-सुथरे तरीके से हैंडल नहीं करती, तो उस पर आधारित हर रिटर्न कैलकुलेशन संदिग्ध हो जाता है।
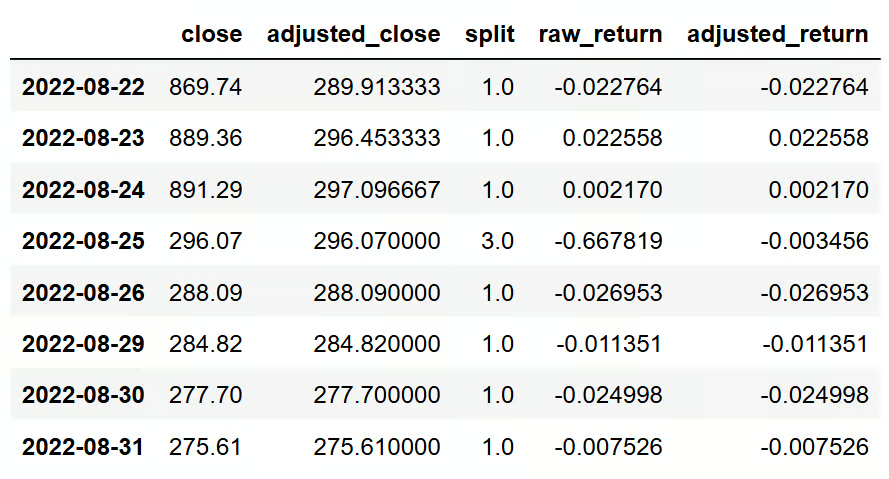
नीचे दिया कोड Tesla के 2022 स्टॉक स्प्लिट के आसपास इसकी डेली एडजस्टेड कीमतें खींचता है और रॉ रिटर्न्स की तुलना एडजस्टेड रिटर्न्स से करता है।
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
यह रहा आउटपुट:
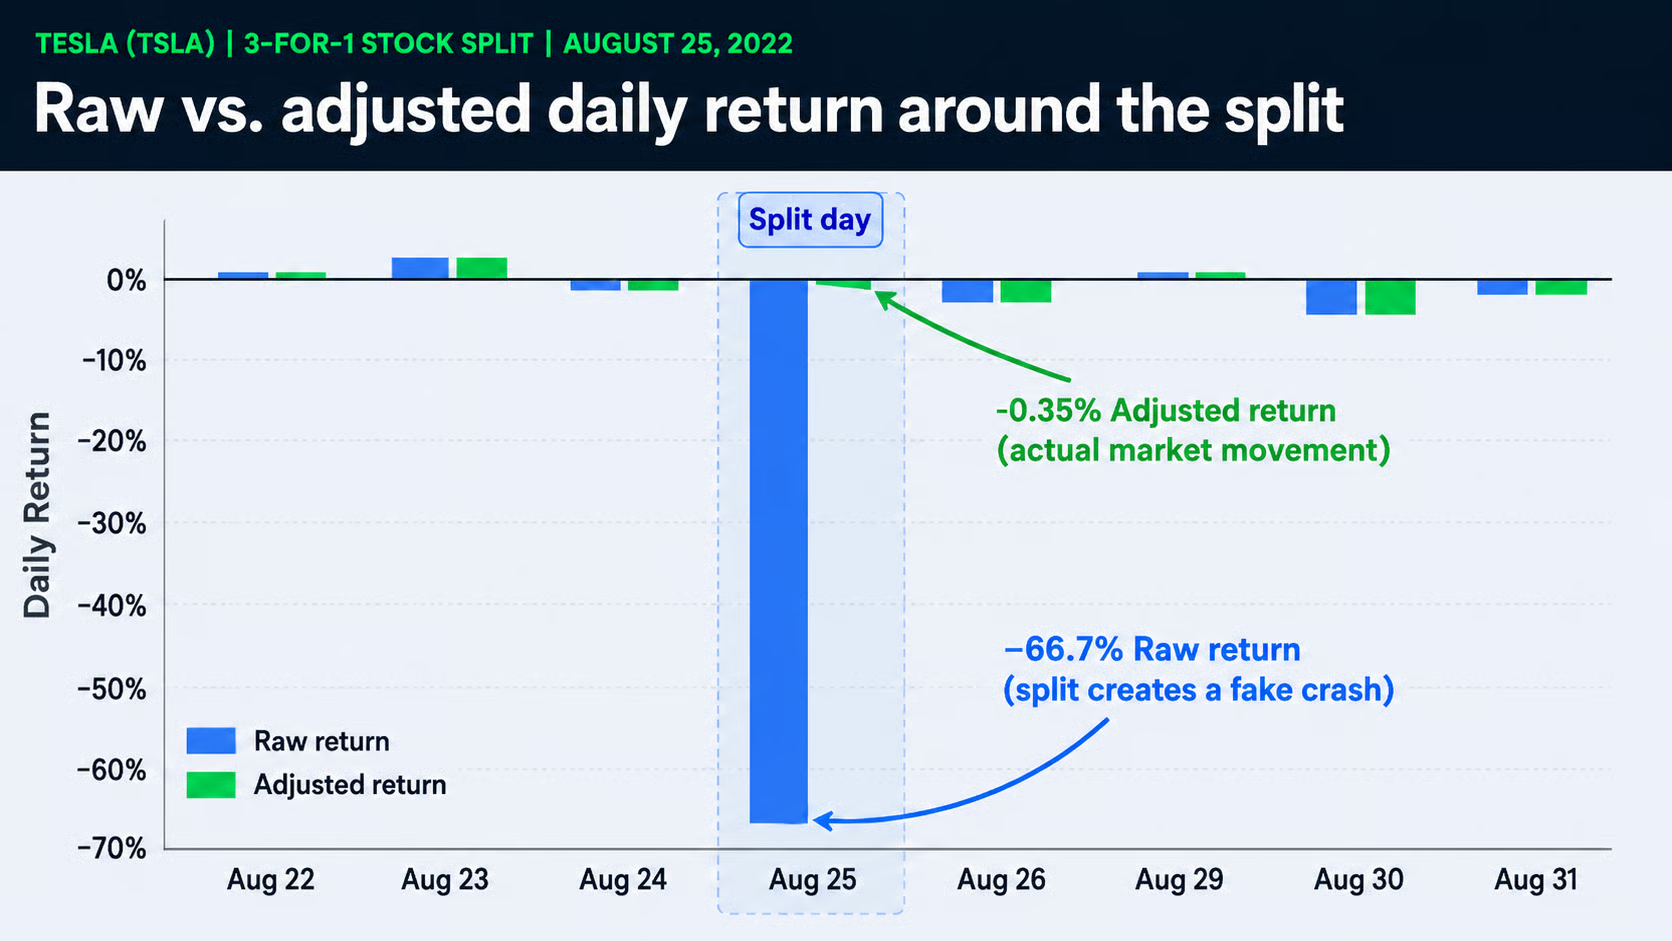
यही वजह है कि समायोजित डेटा मायने रखता है।
रॉ क्लोज़ 25 अगस्त 2022 को 66.7% की गिरावट सुझाता है। यह वास्तविक क्रैश नहीं था। यह Tesla का 3-फॉर-1 स्टॉक स्प्लिट था जो रॉ प्राइस सीरीज़ में दिख रहा था।
उसी दिन का एडजस्टेड रिटर्न लगभग -0.35% है, जो स्प्लिट का हिसाब लगाने के बाद असल मार्केट मूवमेंट के कहीं करीब है।
यह छोटा-सा चेक बताता है कि क्या API आपको एक आम बैकटेस्टिंग समस्या पकड़ने के लिए ज़रूरी फ़ील्ड्स देती है। लंबी फ़ीचर सूची यह नहीं बता सकती।
डैशबोर्ड या अलर्ट सिस्टम को केवल डेटा नहीं चाहिए। उसे स्पष्ट रूप से असफल होने वाली रिक्वेस्ट्स चाहिए।
यह हेल्पर एक साधारण रिट्राई पैटर्न जोड़ता है और सामान्य API रिस्पॉन्स समस्याओं की जाँच करता है। यह प्रोडक्शन इन्फ्रास्ट्रक्चर नहीं है, लेकिन यह परखने के लिए काफ़ी है कि जब कुछ गलत होता है तो API पूर्वानुमेय ढंग से बर्ताव करती है या नहीं।
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
यह वही तरह की जाँच है जिसे मैं डैशबोर्ड या शेड्यूल्ड जॉब के अंदर किसी API पर भरोसा करने से पहले जोड़ूँगा।
महत्वपूर्ण हिस्सा रिट्राई काउंट नहीं है। यह है कि क्या आपका कोड खराब सिंबल, खाली रिस्पॉन्स, रेट-लिमिट संदेश और अस्थायी रिक्वेस्ट विफलता को अलग कर सकता है। यदि हर विफलता एक जैसी दिखती है, तो प्रोजेक्ट में यूज़र्स आने के बाद डीबगिंग कष्टकर हो जाती है।
स्क्रीनर्स, वैल्यूएशन टूल्स और AI असिस्टेंट्स के लिए, मैं परखूँगा कि क्या API कई एंडपॉइंट्स से एक क्लीन रिसर्च ऑब्जेक्ट बना सकती है।
नीचे दिया उदाहरण Apple के लिए एक कोट और कंपनी ओवरव्यू खींचता है, फिर नतीजे को एक कॉम्पैक्ट डिक्शनरी में बदल देता है। यह उस चीज़ के करीब है जिसकी ज़रूरत किसी डैशबोर्ड कार्ड, स्क्रीनेर रो, या AI टूल रिस्पॉन्स को होगी।
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
आउटपुट इस तरह दिखता है:
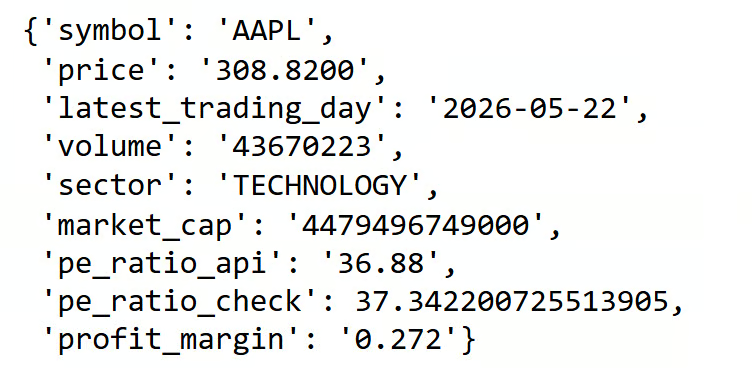
API द्वारा रिपोर्ट किया गया PE रेशियो और हमारा साधारण प्राइस-टू-EPS कैलकुलेशन एकदम समान नहीं हैं, जो सामान्य है क्योंकि प्रदाता अलग टाइमिंग कन्वेंशंस या समायोजित इनपुट्स उपयोग कर सकते हैं। लेकिन तुलना फिर भी उपयोगी है क्योंकि यह बताती है कि फ़ील्ड्स दिशात्मक रूप से उपयोगी हैं या नहीं।
यह टेस्ट केवल बैकटेस्टिंग के लिए ही उपयोगी नहीं है:
वह अंतिम बिंदु मायने रखता है। MCP या टूल कॉलिंग गंदे डेटा को जादुई रूप से ठीक नहीं करती। API को फिर भी ऐसे फ़ील्ड्स लौटाने चाहिए जिन्हें एक पूर्वानुमेय ऑब्जेक्ट में बदला जा सके। यदि हर एंडपॉइंट को कस्टम क्लीनअप चाहिए, तो एजेंट वर्कफ़्लो जल्दी ही नाज़ुक हो जाएगा।
व्यावहारिक टेस्ट सरल है: क्या आप डेटा खींच सकते हैं, उसे वैलिडेट कर सकते हैं, एक बेसिक मेट्रिक की गणना कर सकते हैं, और कुछ ऐसा लौट सकते हैं जिसे सिस्टम का कोई और हिस्सा उपयोग कर सके? यदि हाँ, तो API पहले नोटबुक से आगे उपयोगी होने के कहीं करीब है।
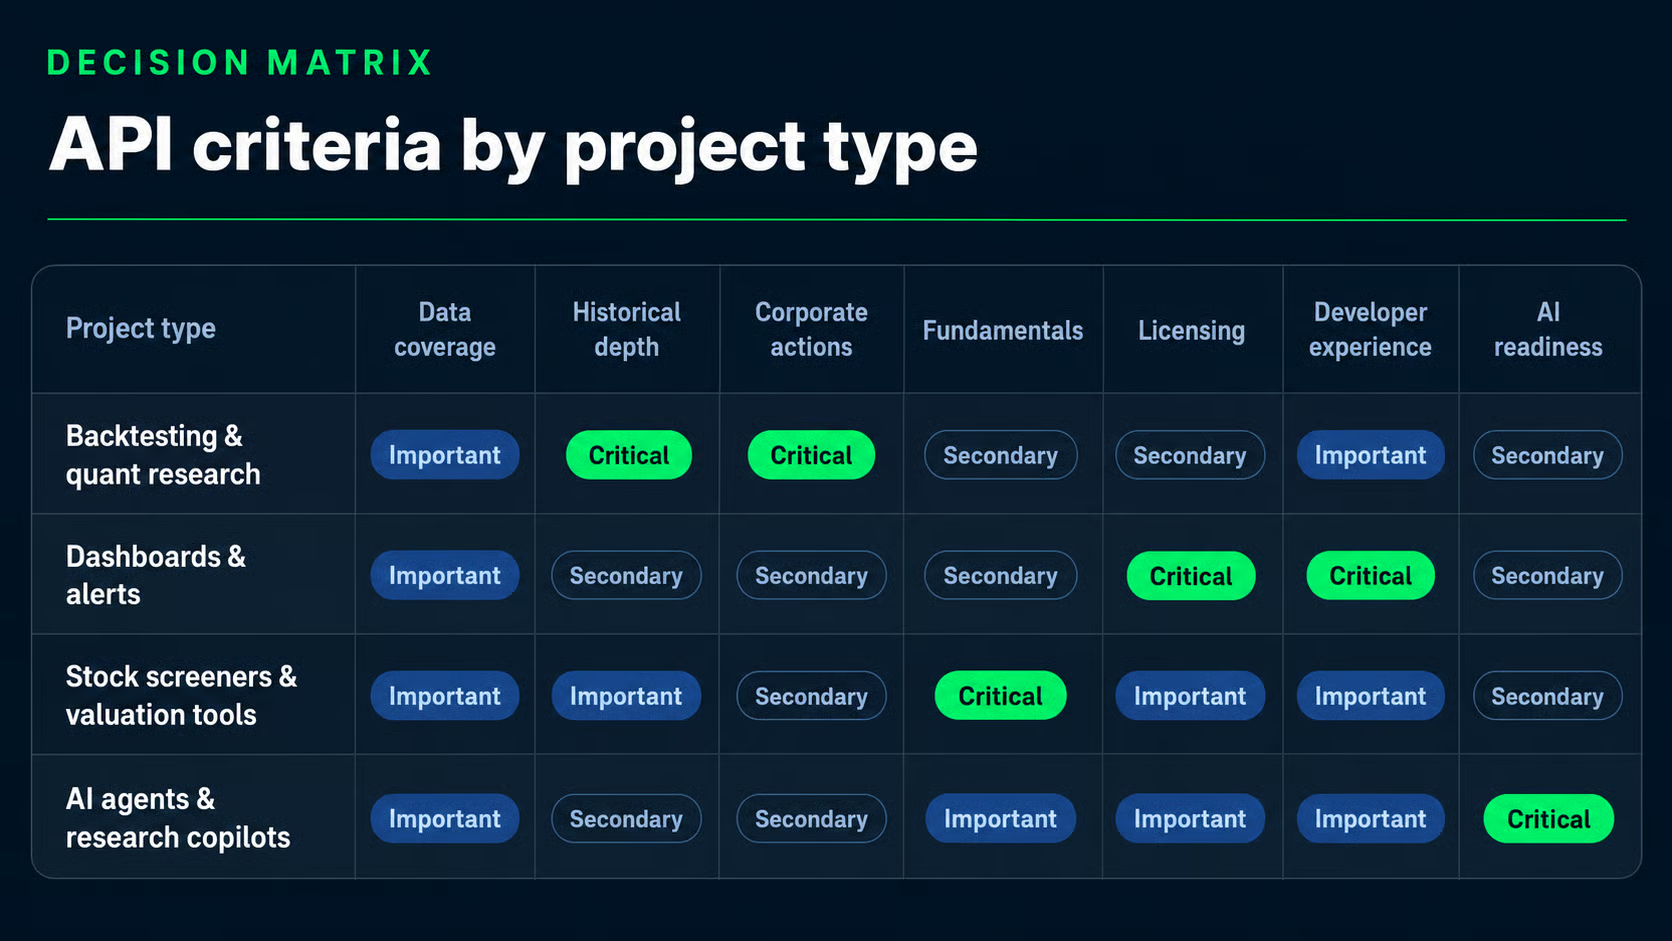
अब हम वर्कफ़्लो और मूल्यांकन मानदंडों को एक साथ रख सकते हैं।
इस मैट्रिक्स का मक़सद प्रदाताओं की रैंकिंग करना नहीं है। यह आपको यह तय करने में मदद करना है कि आपके प्रोजेक्ट के लिए किन मानदंडों पर सबसे ज़्यादा ध्यान देना चाहिए।
|
प्रोजेक्ट प्रकार |
सबसे महत्वपूर्ण मानदंड |
द्वितीयक मानदंड |
विचार करने योग्य प्रदाता फिट |
|
बैकटेस्टिंग और क्वांट रिसर्च |
ऐतिहासिक गहराई, समायोजित कीमतें, और कॉरपोरेट एक्शंस |
AI तैयारी, लाइसेंसिंग |
विस्तृत ऐतिहासिक और इंडिकेटर वर्कफ़्लोज़ के लिए Alpha Vantage; ग्लोबल EOD रिसर्च के लिए EODHD |
|
डैशबोर्ड और अलर्ट्स |
लाइसेंसिंग, रिस्पॉन्स डेवलपर अनुभव, रेट लिमिट्स |
ऐतिहासिक गहराई, फ़ंडामेंटल्स |
डेवलपर-फ्रेंडली डैशबोर्ड्स के लिए QuoteMedia; एंटरप्राइज़ फ़ाइनेंशियल ऐप्स के लिए Xignite |
|
स्टॉक स्क्रीनर्स और वैल्यूएशन टूल्स |
फ़ंडामेंटल्स, कंपनी मेटाडेटा, रेशियो, और फ़ाइनेंशियल स्टेटमेंट्स |
ऐतिहासिक गहराई, सिंबल कवरेज |
विस्तृत फ़ंडामेंटल्स और प्राइस वर्कफ़्लोज़ के लिए Alpha Vantage; US फ़ंडामेंटल्स-हैवी टूल्स के लिए Intrinio |
|
AI एजेंट्स और रिसर्च कोपायलट्स |
स्ट्रक्चर्ड रिस्पॉन्स, टूल एक्सेस, और MCP तैयारी |
फ़ंडामेंटल्स, इंडिकेटर्स, लाइसेंसिंग |
MCP और व्यापक API कवरेज के लिए Alpha Vantage |
यह टेबल जानबूझकर अपूर्ण है। वास्तविक प्रोजेक्ट्स शायद ही एक पंक्ति में फिट होते हैं, और अधिकांश गंभीर प्रोडक्ट्स एक से अधिक वर्कफ़्लो को जोड़ते हैं।
बैकटेस्टर के लिए, मैं लाइव कोट्स की चिंता करने से पहले ऐतिहासिक गहराई और कॉरपोरेट एक्शंस से शुरुआत करूँगा।
मुख्य सवाल “क्या मैं प्राइस हिस्ट्री फ़ेच कर सकता हूँ?” नहीं है। यह है, “क्या मैं स्प्लिट्स, डिविडेंड्स, गुम तारीखों और लंबे मार्केट रेजीम्स में इस प्राइस हिस्ट्री पर भरोसा कर सकता हूँ?”
इस वर्कफ़्लो के लिए, जाँचें:
यदि आप लाइव मॉनिटरिंग या एक्ज़ीक्यूशन की ओर बढ़ते हैं तो रीयल-टाइम डेटा बाद में मायने रख सकता है। ऐतिहासिक रिसर्च के लिए यह पहली प्राथमिकता नहीं होनी चाहिए।
AI असिस्टेंट के लिए, API को कोड और मॉडल—दोनों के लिए काम करना आसान होना चाहिए।
मानव डेवलपर उलझे JSON रिस्पॉन्स का निरीक्षण करके पार्सिंग लॉजिक ठीक कर सकता है। एजेंट वर्कफ़्लो कम क्षमाशील होता है। यदि स्कीमा अप्रत्याशित है, तो मॉडल सही टूल कॉल कर सकता है लेकिन फिर भी नतीजे का उपयोग करने में जूझ सकता है।
इस वर्कफ़्लो के लिए, जाँचें:
विस्तृत बात सरल है: API उस फ़ेल्योर मोड के आधार पर चुनें जिसे आप सबसे कम बर्दाश्त कर सकते हैं। बैकटेस्टर तब फेल होता है जब हिस्ट्री गलत हो। डैशबोर्ड तब फेल होता है जब यूज़र्स को ताज़ा रिस्पॉन्स नहीं मिलते। AI असिस्टेंट तब फेल होता है जब डेटा एक्सेस लेयर उपयोग के लिए बहुत गंदी हो।
हर प्रोजेक्ट के लिए कोई एक “सर्वश्रेष्ठ” स्टॉक API नहीं है। सही विकल्प इस पर निर्भर करता है कि आपका सिस्टम क्या करना चाहता है: बैकटेस्टिंग के लिए ऐतिहासिक गहराई, डैशबोर्ड के लिए ताज़गी, स्क्रीनर्स के लिए फ़ंडामेंटल्स, और AI वर्कफ़्लोज़ के लिए स्ट्रक्चर्ड रिस्पॉन्स।
इसीलिए इस लेख के उदाहरणों में Alpha Vantage एक बहुमुखी API रहा। यह उन कई लेयर्स को कवर करता है जिन पर हमने चर्चा की—मार्केट डेटा, फ़ंडामेंटल्स, तकनीकी इंडिकेटर्स और MCP-आधारित AI वर्कफ़्लोज़—इसलिए हम बिना प्रदाता बदले एक से अधिक निर्णय कारकों का परीक्षण कर सके।
मैं स्टॉक API को प्रोजेक्ट की डेटा इन्फ्रास्ट्रक्चर का हिस्सा मानूँगा, सिर्फ़ एंडपॉइंट्स का संग्रह नहीं। यह आपके कोड, डेटाबेस, रिफ्रेश जॉब्स, मॉडल इनपुट्स, यूज़र अनुभव, और यहाँ तक कि अंतिम प्रोडक्ट में आप क्या दिखा सकते हैं—इन सबको प्रभावित करती है।
यदि आप Python में और मज़बूत फ़ाइनेंस वर्कफ़्लोज़ बनाना चाहते हैं, तो मैं हमारे Python for Finance कोर्स से शुरुआत करने की सलाह देता हूँ।
DataCamp के साथ Python में फ़ाइनेंशियल एनालिसिस सीखें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}