{count, plural, one {Curso} other {Cursos}}
Introducción a Python para finanzas
{hours} h
107.9K
La mayoría de comparativas de APIs de bolsa empiezan por el sitio equivocado.
Comparan precios por niveles, número de endpoints, páginas de documentación y límites del plan gratuito. Todo eso importa, pero no te dice si la API puede sostener el sistema que estás construyendo.
Un backtest no falla porque el proveedor tenga menos endpoints que un competidor. Falla porque los precios históricos no están bien ajustados, la historia es demasiado corta o las acciones corporativas están mal tratadas.
Un panel tiene un modo de fallo distinto. Se rompe cuando las respuestas de cotización van lentas, los campos cambian sin avisar o los límites de tasa se vuelven un problema cuando los usuarios empiezan a refrescar la página.
Por eso tomo las listas genéricas de "mejor API bursátil" como punto de partida, no como respuesta. La pregunta real es: "¿Esta API seguirá funcionando cuando mi proyecto deje de ser un prototipo?"
Cuando una API impulsa un flujo de trabajo real, se convierte en infraestructura de datos:
Cambiar luego es doloroso porque no solo cambias una URL de solicitud. Puede que tengas que reescribir pipelines, jobs de refresco, lógica de almacenamiento, ajustar inputs de modelos y revisar partes de la interfaz.
El cierre de IEX Cloud en 2024 es un buen recordatorio. Muchos desarrolladores y empresas habían construido paneles, apps y herramientas internas alrededor de su API. Cuando el servicio se discontinuó, migrar implicó replantear endpoints, campos, precios, licencias y supuestos de datos.
Antes de comparar proveedores, identifica el flujo de trabajo que la API va a soportar. Un backtester y un panel pueden usar precios bursátiles, pero no dependen de los mismos requisitos de datos.
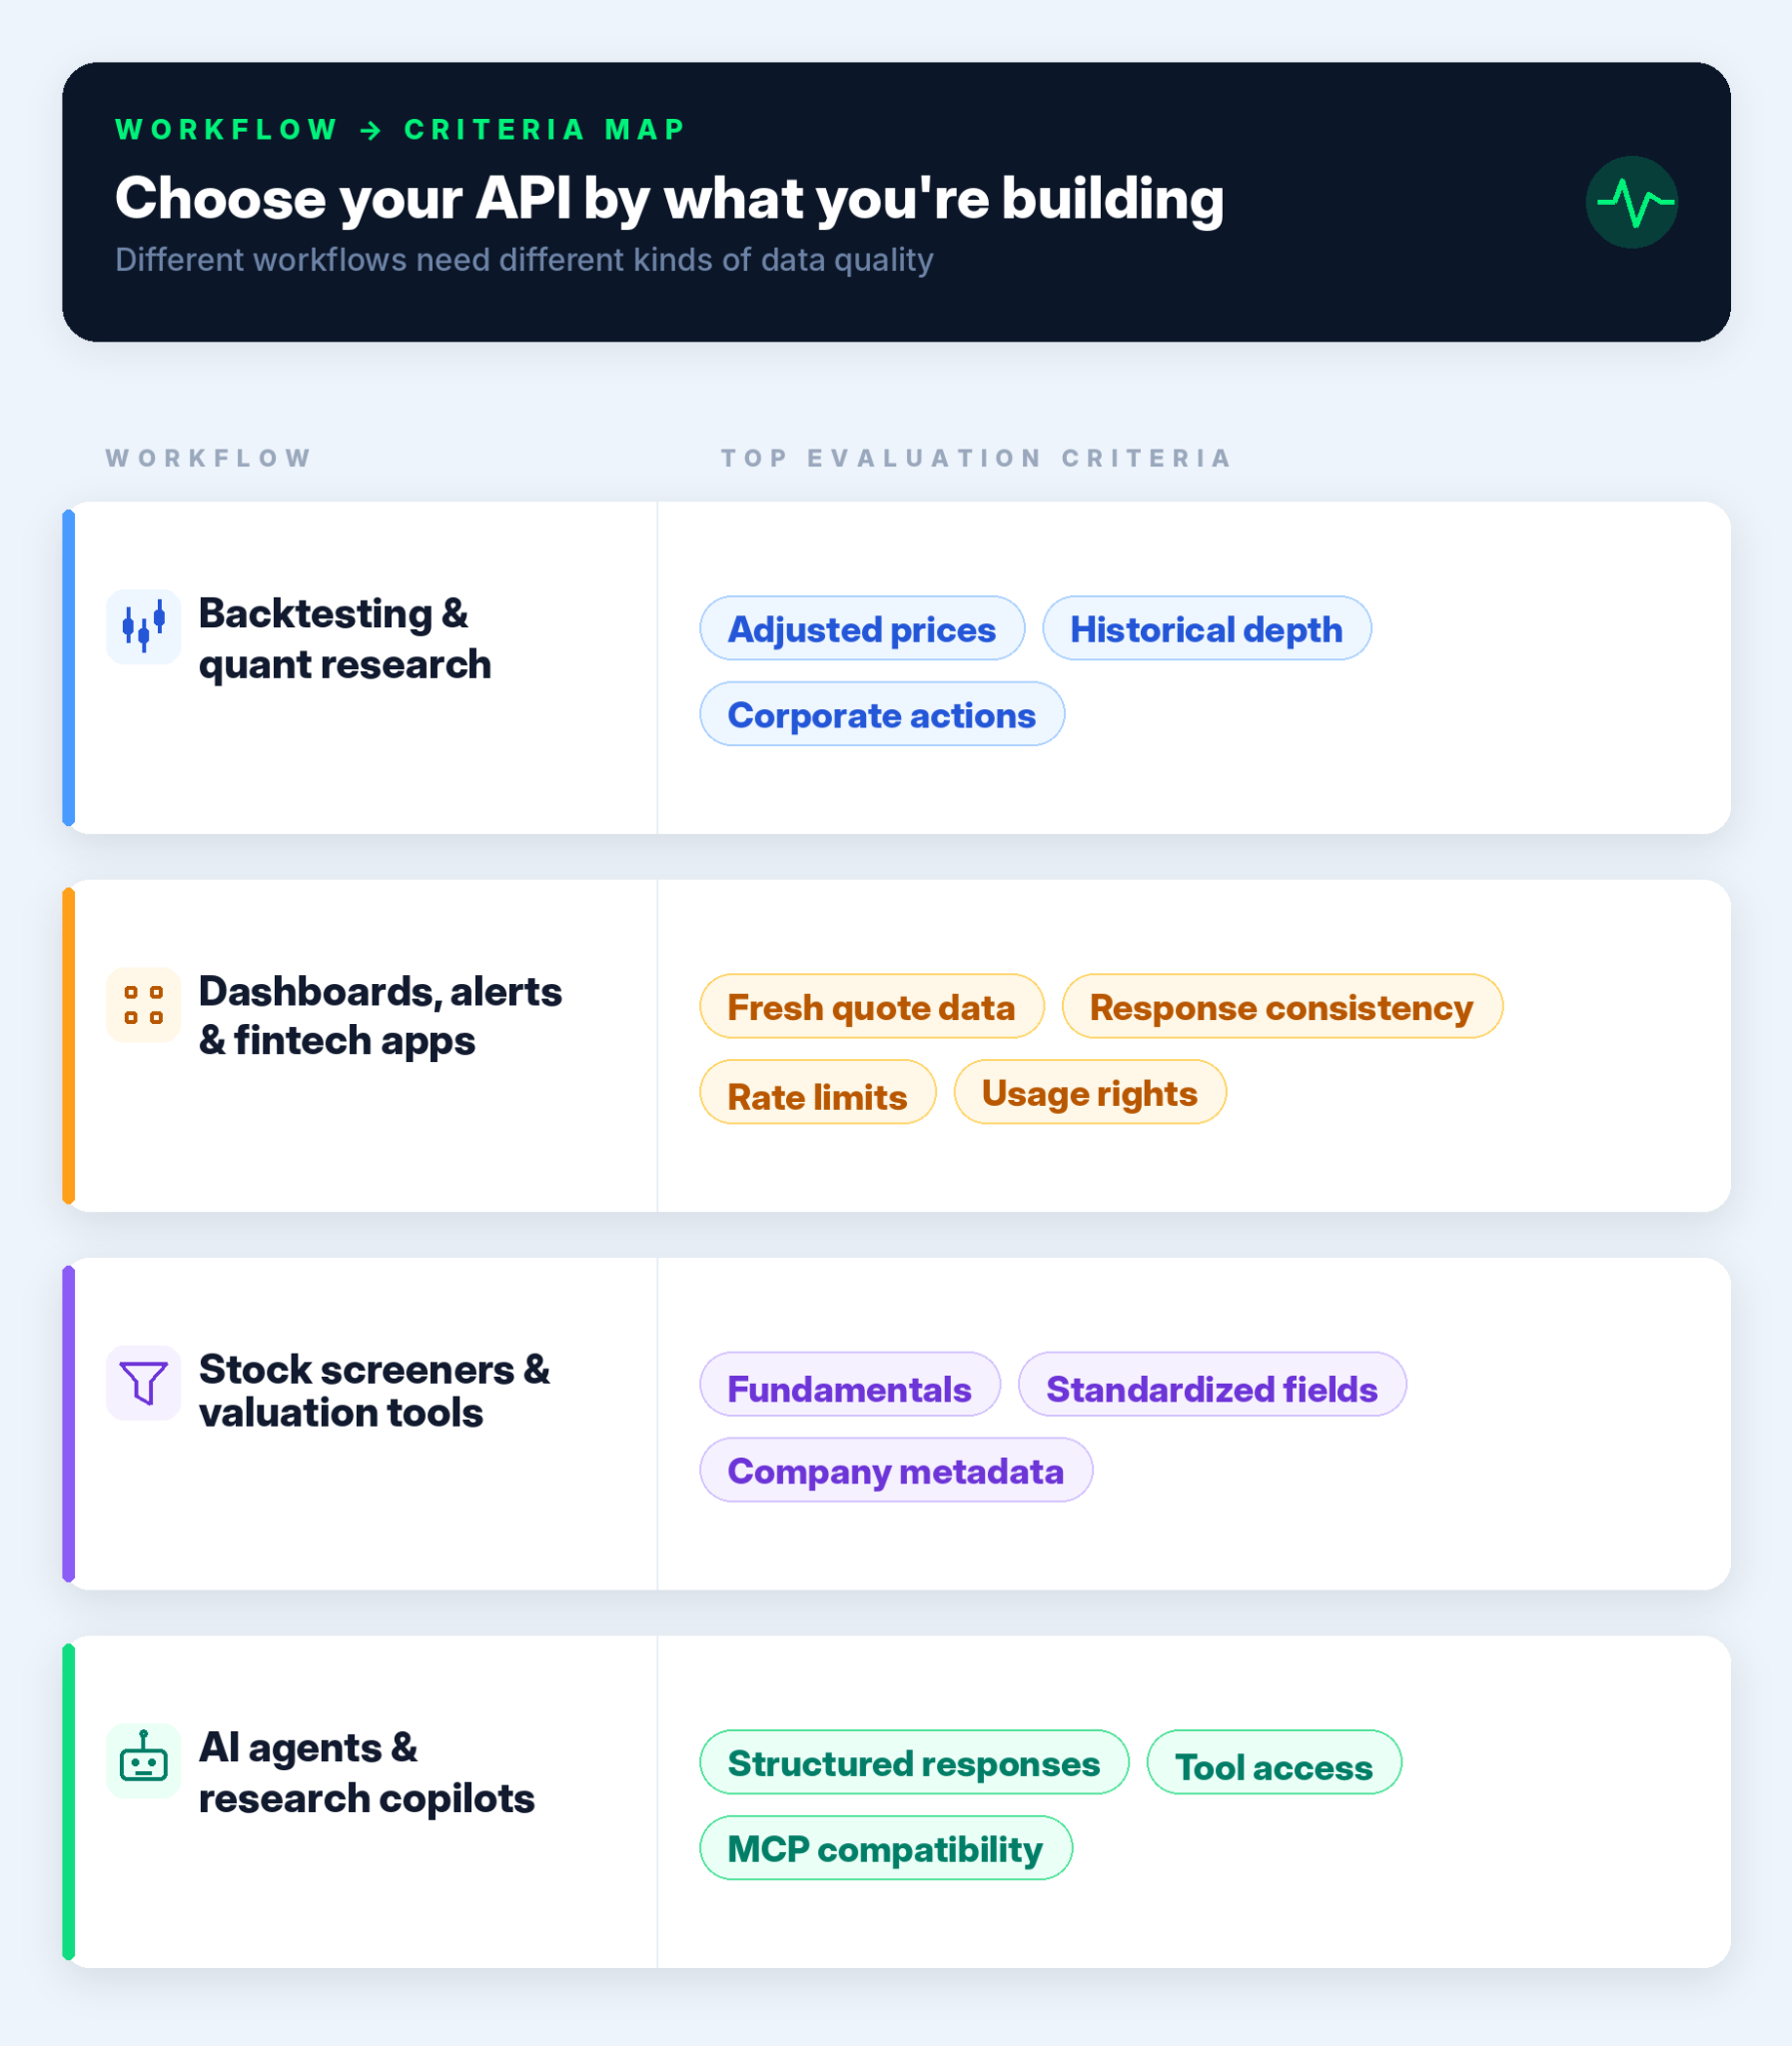
Para backtesting, los datos históricos limpios suelen importar más que los datos en vivo.
Criterios clave a comprobar:
Para profundizar en cómo implementar y probar estrategias de trading en Python, nuestro tutorial Algorithmic Trading in Python repasa con más detalle conceptos y trampas del backtesting.
Los paneles y sistemas de alertas priorizan frescura, fiabilidad y consistencia. Un cuaderno privado puede tolerar una solicitud fallida o un nombre de campo feo. Un producto de cara al usuario, no.
Criterios clave a comprobar:
Los screeners y las herramientas de valoración necesitan datos de negocio, no solo precio. El reto principal es la comparación porque sueles filtrar o clasificar muchas empresas a la vez.
Criterios clave a comprobar:
Los flujos de IA necesitan APIs que devuelvan datos estructurados y predecibles. Un LLM puede resumir texto, pero no debería inventar datos financieros.
Criterios clave a comprobar:
Para pasar de datos de API a un agente funcional, la guía de Model Context Protocol (MCP) explica cómo MCP conecta modelos de IA con herramientas externas, mientras que los tutoriales Building LangChain Agents y OpenAI Agents SDK muestran cómo llevarlo a la práctica con Python.
Una vez definido el flujo, comparar APIs es más fácil. Ya no preguntas "¿Qué proveedor tiene más funciones?" sino "¿Qué proveedor puede sostener la capa de datos que este proyecto necesita?"
|
Criterio |
Qué revisar |
Por qué importa |
|
Cobertura de datos |
Clases de activos, mercados, símbolos y geografía |
La API debe cubrir el universo que tu proyecto realmente necesita |
|
Profundidad histórica |
Longitud de la historia, acceso a historia completa, datos ajustados y sin ajustar |
Los backtests y las herramientas de investigación necesitan más que datos recientes |
|
Calidad de datos y acciones corporativas |
Splits, dividendos, cambios de ticker, filas ausentes y símbolos obsoletos |
Malos ajustes distorsionan gráficos, rentabilidades y salidas de modelos |
|
Soporte de fundamentales |
Estados financieros, resultados, ratios, perfiles y metadatos |
Screeners y valoración necesitan contexto de negocio, no solo precios |
|
Licencias y redistribución |
Derechos de visualización, de almacenamiento, uso comercial y normas de mercado |
Un cuaderno no es lo mismo que un producto público o de pago |
|
Experiencia de desarrollador |
Documentación, formato de respuesta, errores, límites de tasa y uso en Python |
Las APIs limpias ahorran tiempo después de la primera petición |
|
Preparación para IA y agentes |
Respuestas estructuradas, acceso a herramientas, soporte MCP y esquemas predecibles |
Los asistentes de IA necesitan datos que puedan recuperar, parsear y razonar |
La cobertura debe ajustarse al proyecto, no a la página de marketing.
Revisa:
El error es elegir el proveedor con la mayor promesa de cobertura en lugar del que cubre tu universo real de consultas.
La profundidad histórica importa cuando el proyecto necesita probar ideas en distintos entornos de mercado.
Revisa:
No es lo mismo "ofrecemos precios históricos" que "este dataset es lo bastante profundo para pruebas serias".
Aquí es donde los datos bursátiles se vuelven pesados.
Revisa:
Para lidiar con el lado más sucio de los datos financieros (valores ausentes, campos inconsistentes y problemas de formato), el itinerario Importing & Cleaning Data in Python cubre las técnicas clave que necesitarás cuando las llamadas a la API ya funcionen.
Los fundamentales importan cuando el proyecto necesita contexto de negocio, no solo movimiento de precio.
Revisa:
La palabra clave es consistencia. Si comparas empresas, los campos deben funcionar en todo el universo sin lógica a medida por ticker.
Las licencias son aburridas hasta que bloquean el producto.
Revisa:
Prefiero descubrir estos límites antes de escribir el pipeline que después de construir el frontend.
Una API limpia ahorra tiempo después de la primera petición.
Revisa:
La primera llamada exitosa no es la prueba real. La prueba real es si la API sigue siendo limpia cuando añades jobs de refresco, manejo de errores y joins con otros datasets.
Los flujos de IA necesitan acceso a datos predecible.
Revisa:
La API no tiene que ser "nativa de IA" para todo. Pero si construyes un asistente de investigación financiera, la capa de datos debe ser fácil tanto para código Python como para herramientas de IA.
Nuestro tutorial Codex CLI MCP muestra un ejemplo concreto en finanzas, creando un agente de panel de cartera en vivo con datos de Alpha Vantage a través de un flujo MCP.
Los criterios anteriores son útiles, pero no elegiría un proveedor solo con una checklist. Probaría la API contra los modos de fallo que importan para el proyecto.
En los ejemplos siguientes usaré Alpha Vantage porque ofrece precios históricos, cotizaciones en vivo, fundamentales, indicadores técnicos y opciones para flujos de IA en un mismo lugar. El objetivo es comprobar si la API puede cubrir requisitos reales sin crear un exceso de trabajo de limpieza.
Para un backtester, este sería uno de los primeros checks. Si una serie de precios no gestiona bien los splits, cualquier cálculo de rentabilidad por encima queda en entredicho.
El código siguiente descarga los precios diarios ajustados de Tesla alrededor de su split de 2022 y compara rentabilidades brutas con rentabilidades ajustadas.
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
Aquí tienes la salida:
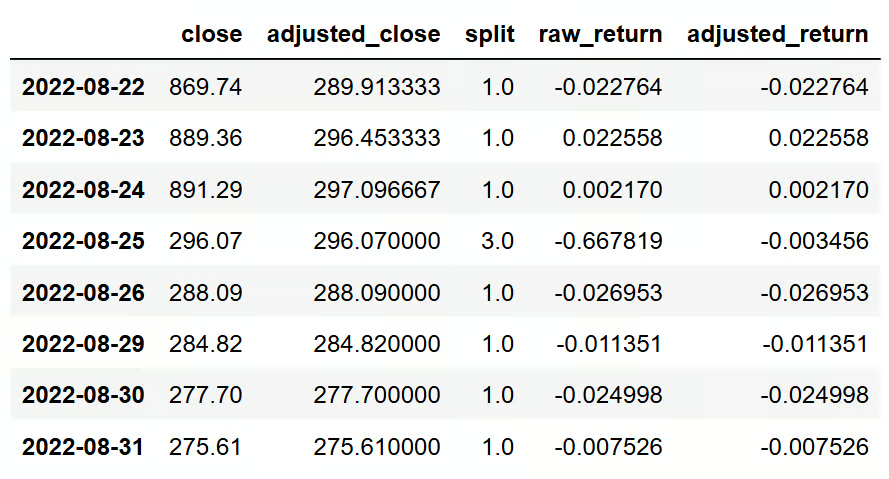
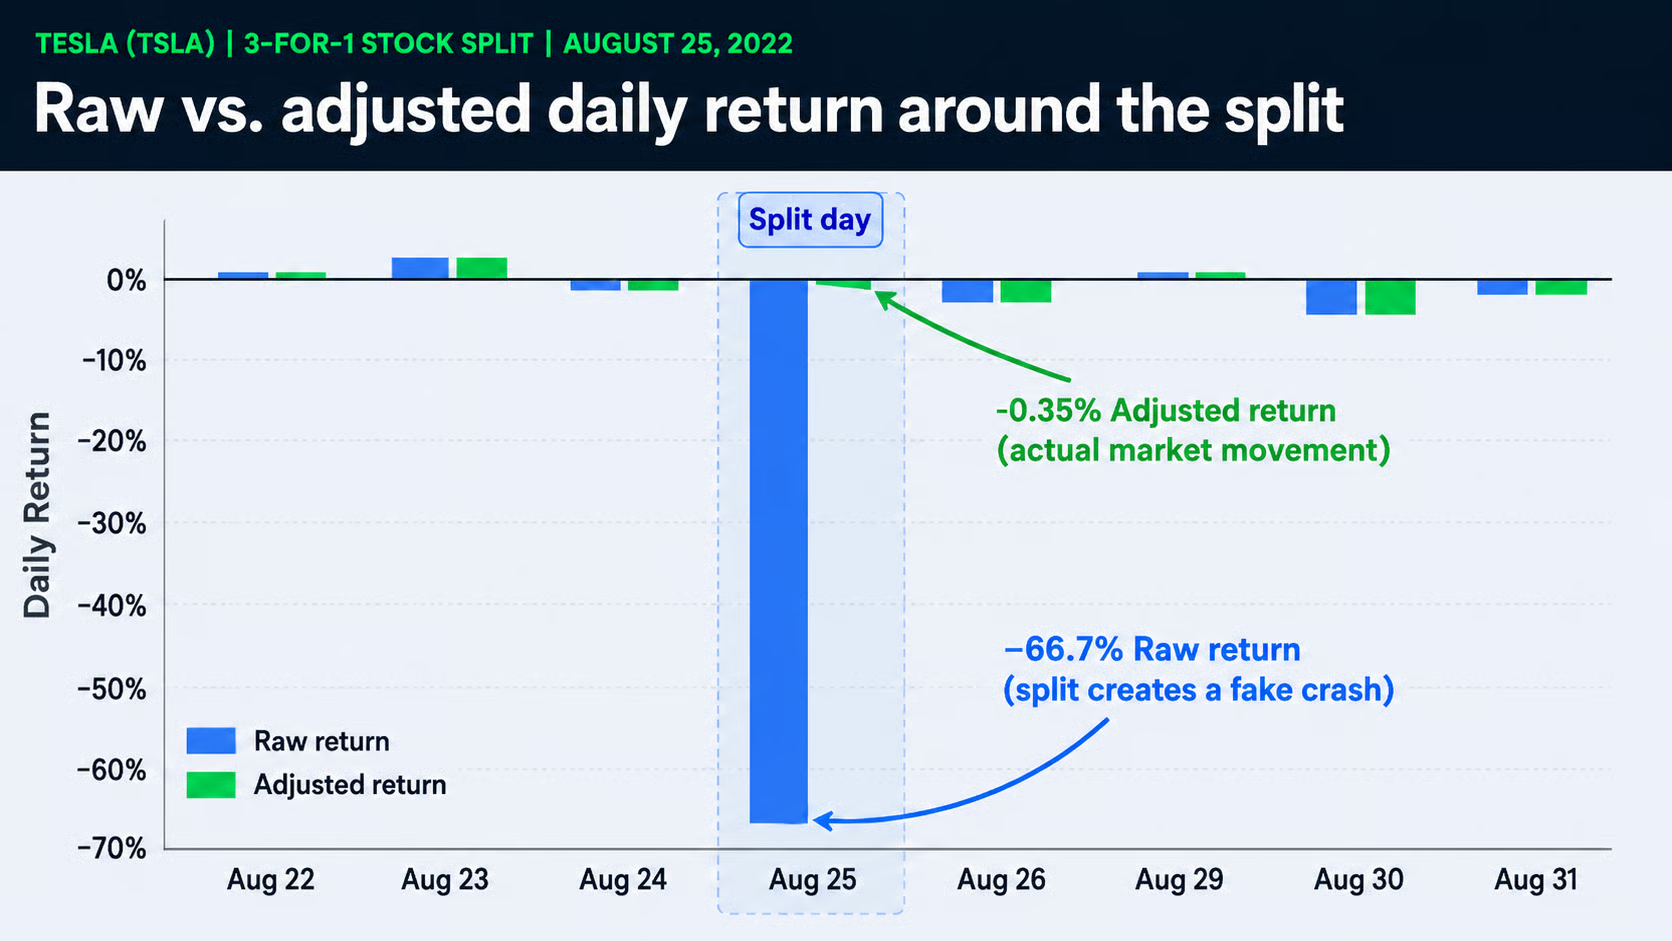
Esto demuestra por qué los datos ajustados importan.
El cierre bruto sugiere una caída del 66,7% el 25 de agosto de 2022. No fue un crash real. Fue el split 3 por 1 de Tesla reflejado en la serie de precios bruta.
La rentabilidad ajustada de ese mismo día ronda el -0,35%, mucho más cercana al movimiento real del mercado tras ajustar el split.
Este pequeño check te dice si la API te da los campos necesarios para detectar un problema común de backtesting. Una lista larga de funciones no te lo dirá.
Un panel o sistema de alertas no solo necesita datos. Necesita solicitudes que fallen de forma clara.
Este helper añade un patrón simple de reintentos y verifica problemas comunes en respuestas de APIs. No es infraestructura de producción, pero basta para probar si una API se comporta de forma predecible cuando algo va mal.
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
Es el tipo de verificación que añadiría antes de confiar en una API dentro de un panel o un job programado.
Lo importante no es el número de reintentos. Es si tu código puede diferenciar un símbolo erróneo, una respuesta vacía, un mensaje de límite de tasa y un fallo temporal. Si todos los fallos se ven iguales, depurar duele cuando ya tienes usuarios.
Para screeners, herramientas de valoración y asistentes de IA, probaría si la API puede producir un objeto de investigación limpio a partir de múltiples endpoints.
El ejemplo siguiente descarga una cotización y el overview de Apple, y convierte el resultado en un diccionario compacto. Esto se acerca a lo que necesitaría una tarjeta de panel, una fila de screener o la respuesta de una herramienta de IA.
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
La salida es algo así:
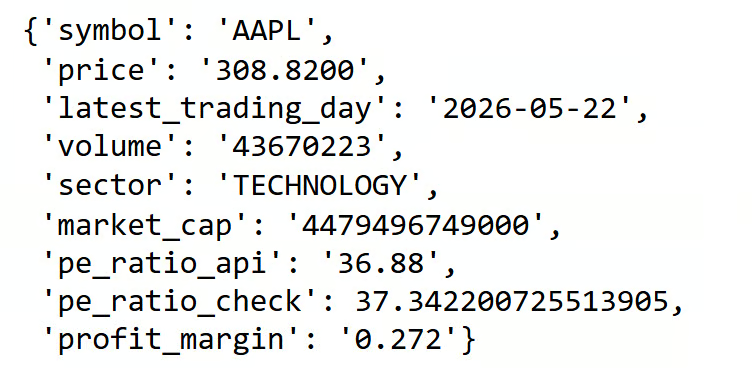
El PER que informa la API y nuestro cálculo simple precio/EPS no coinciden exactamente, algo normal porque los proveedores pueden usar convenciones temporales o inputs ajustados distintos. Aun así, la comparación es útil porque nos indica si los campos son utilizables a nivel direccional.
Esta prueba no solo es útil para backtesting:
Esto último importa. MCP o el tool calling no arreglan mágicamente datos desordenados. La API debe devolver campos que puedan convertirse en un objeto predecible. Si cada endpoint requiere limpieza a medida, el flujo con agentes se vuelve frágil enseguida.
La prueba práctica es simple: ¿puedes extraer los datos, validarlos, calcular una métrica básica y devolver algo que otra parte del sistema pueda usar? Si sí, la API está mucho más cerca de ser útil más allá del primer cuaderno.
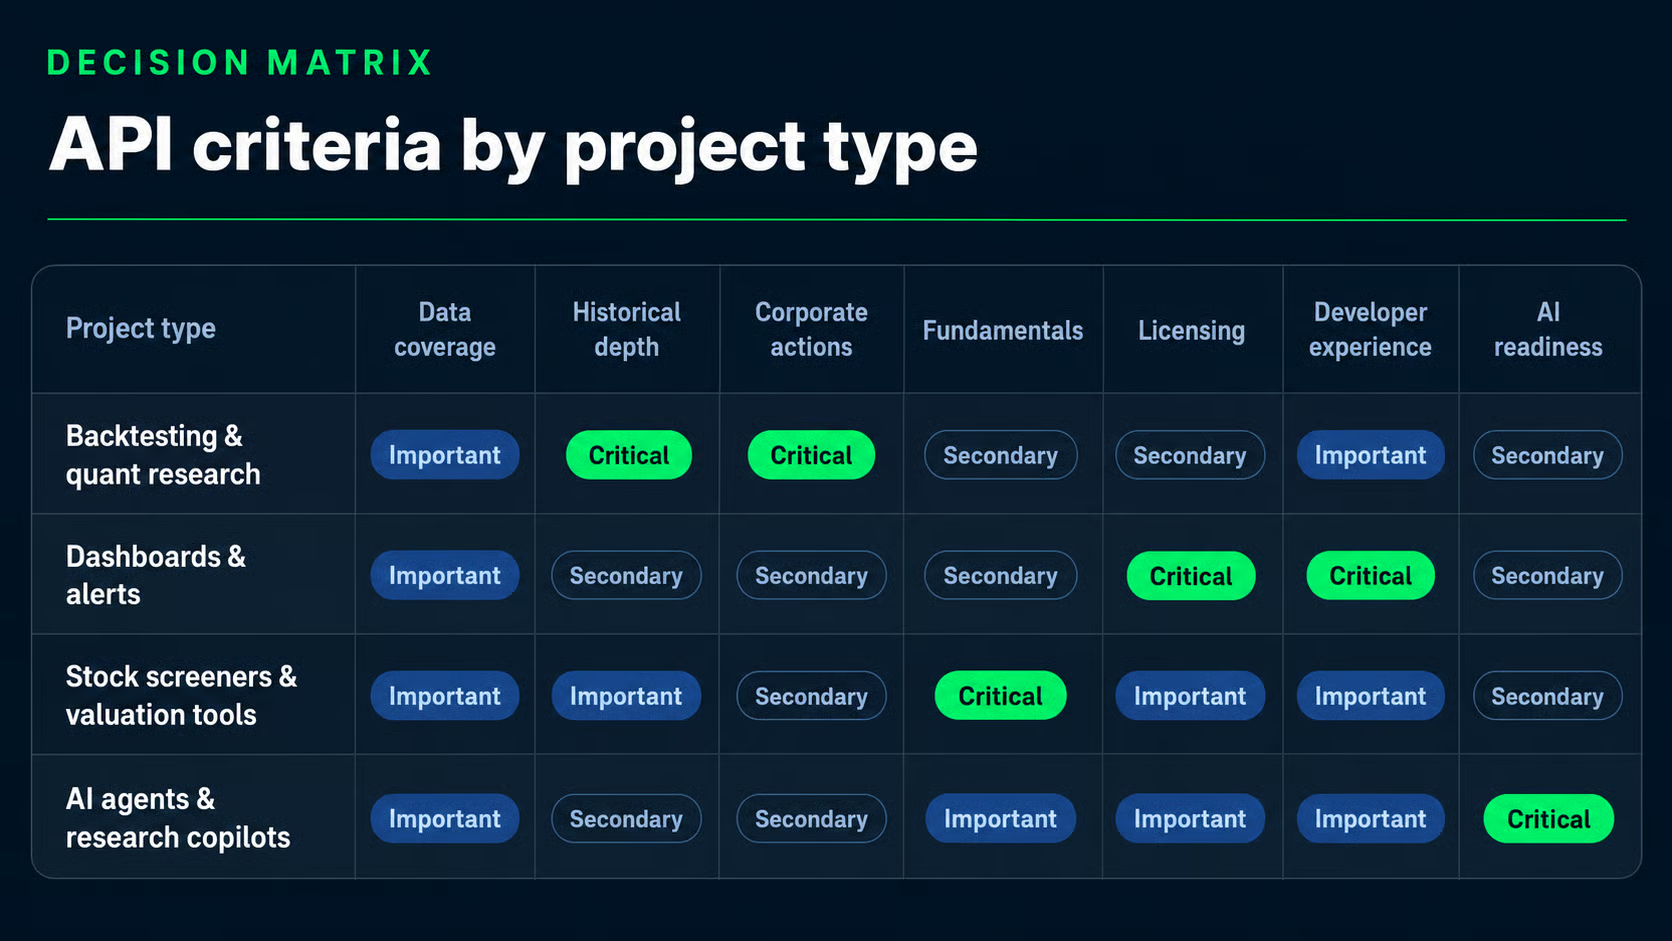
Ahora podemos combinar flujo de trabajo y criterios de evaluación.
El objetivo de esta matriz no es clasificar proveedores. Es ayudarte a decidir qué criterios merecen más atención para el proyecto que estás construyendo.
|
Tipo de proyecto |
Criterios más importantes |
Criterios secundarios |
Proveedores a considerar |
|
Backtesting e investigación cuantitativa |
Profundidad histórica, precios ajustados y acciones corporativas |
Preparación para IA, licencias |
Alpha Vantage para flujos amplios de históricos e indicadores; EODHD para investigación EOD global |
|
Paneles y alertas |
Licencias, experiencia de desarrollador en respuestas, límites de tasa |
Profundidad histórica, fundamentales |
QuoteMedia para paneles developer‑friendly; Xignite para apps financieras enterprise |
|
Screeners bursátiles y herramientas de valoración |
Fundamentales, metadatos de empresa, ratios y estados financieros |
Profundidad histórica, cobertura de símbolos |
Alpha Vantage para flujos amplios de fundamentales y precios; Intrinio para herramientas con fuertes fundamentales en EE. UU. |
|
Agentes de IA y copilotos de investigación |
Respuestas estructuradas, acceso a herramientas y preparación MCP |
Fundamentales, indicadores, licencias |
Alpha Vantage para MCP y amplia cobertura de API |
Esta tabla es deliberadamente imperfecta. Los proyectos reales rara vez encajan en una sola fila y la mayoría de productos serios combinan más de un flujo.
Para un backtester, empezaría por profundidad histórica y acciones corporativas antes que por cotizaciones en vivo.
La pregunta clave no es "¿Puedo descargar el histórico?" sino "¿Puedo confiar en este histórico a través de splits, dividendos, fechas ausentes y regímenes largos?"
Para este flujo, comprueba:
Los datos en tiempo real pueden importar después si te acercas a monitorización o ejecución en vivo. Para investigación histórica, no deberían ser la primera prioridad.
Para un asistente de IA, la API debe ser fácil tanto para el código como para el modelo.
Una persona puede inspeccionar un JSON desordenado y corregir el parseo. Un flujo con agentes es menos tolerante. Si el esquema es impredecible, el modelo puede llamar a la herramienta correcta pero aún así no saber usar el resultado.
Para este flujo, comprueba:
La idea general es simple: elige la API según el modo de fallo que menos puedas permitirte. Un backtester falla si la historia es errónea. Un panel falla si los usuarios no obtienen respuestas frescas. Un asistente de IA falla si la capa de acceso a datos es demasiado desordenada.
No existe una API bursátil única que sea la mejor para todos los proyectos. La elección correcta depende de lo que tu sistema necesite: profundidad histórica para backtesting, frescura para paneles, fundamentales para screeners y respuestas estructuradas para flujos de IA.
Por eso también Alpha Vantage ha sido una API versátil en los ejemplos del artículo. Cubre varias de las capas que hemos comentado, incluidos datos de mercado, fundamentales, indicadores técnicos y flujos de IA basados en MCP, lo que permite probar más de un factor de decisión sin cambiar de proveedor.
Yo trataría una API bursátil como parte de la infraestructura de datos del proyecto, no solo como un conjunto de endpoints. Afecta a tu código, base de datos, jobs de refresco, inputs de modelos, experiencia de usuario e incluso a lo que puedes mostrar en el producto final.
Si te apetece reforzar tus flujos financieros en Python, te recomiendo empezar por nuestro curso Python for Finance.
¡Aprende análisis financiero en Python con DataCamp!
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Tutorial} other {Tutoriales}}
Abid Ali Awan
6 min
{count, plural, one {Tutorial} other {Tutoriales}}
Thushan Ganegedara
15 min
{count, plural, one {Tutorial} other {Tutoriales}}
Joleen Bothma
9 min
{count, plural, one {Tutorial} other {Tutoriales}}
Adel Nehme
9 min
{count, plural, one {Tutorial} other {Tutoriales}}
Zoumana Keita
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Kurtis Pykes
7 min