当气象分析师预测一场强烈风暴时,他们并不仅仅分别预报大雨或强风——而是在评估两种天气状况将会同时发生的概率。这个情景体现了联合概率——两个事件同时发生的可能性。
在本文中,我们将探讨联合概率的工作原理,查看适用于相互独立与相互依赖事件的公式,通过实际示例加深理解,并了解该概念在数据科学和机器学习中的应用。要快速回顾基本的概率定义与规则,请查看 DataCamp 的《概率规则入门速查表》。
什么是联合概率?
联合概率表示两个(或更多)事件同时发生的可能性。数学上记为 P(A∩B),读作“事件 A 与 B 的交集的概率”,或简作“ A 和 B 的概率”。
要理解联合概率,首先需要建立一些背景概念:
- 样本空间:一次试验所有可能结果的集合。
- 事件:样本空间中结果的一个子集。
- 边缘概率:单个事件发生的概率,不考虑其他事件。
- 条件概率:某事件已发生的前提下,另一个事件发生的概率。
对于相互独立与相互依赖事件,联合概率有显著差异:
- 独立事件:一个事件的发生不影响另一个事件的概率。例如掷两次硬币——第一次的结果不影响第二次。
- 依赖事件:一个事件的发生会影响另一个事件的概率。例如不放回地抽牌——移走一张牌会改变余下牌堆的组成。
我们可以用维恩图来可视化联合概率,重叠区域表示事件的交集——即两个事件同时发生的情形:
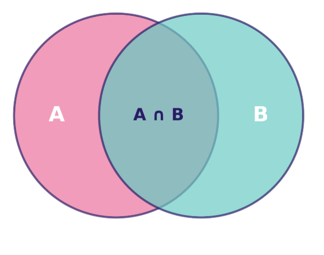
维恩图展示集合 A 与 B 的关系,突出显示其交集 A ∩ B。图片作者自制。
这一重叠区域相对于整个样本空间的面积,即为 P(A∩B)——我们要计算的联合概率。
联合概率公式与关键性质
计算联合概率的方法取决于事件是否独立或依赖。我们分别考察两种情形,并梳理相关规则。
独立事件的联合概率
当两个事件相互独立时,计算其联合概率非常直接。由于彼此不影响,我们可以直接相乘各自的概率:
P(A∩B) = P(A) × P(B)
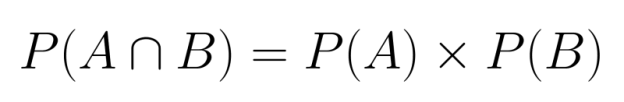
之所以适用乘法法则,是因为独立意味着已知一个事件发生,并不会提供关于另一个事件发生可能性的任何信息。
示例:掷两枚公平硬币。第一次正面的概率为 1/2,第二次正面的概率也为 1/2。由于两次独立(第一次不影响第二次),两次都为正面的概率为:

这意味着连续掷出两个正面的概率为 25%。
依赖事件的联合概率
当事件相互依赖时,必须考虑第一个事件如何影响第二个事件的概率。这需要在计算中使用条件概率:
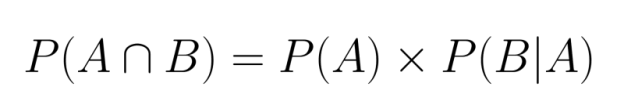
其中,P(B|A) 表示已知事件 A 发生的前提下,事件 B 发生的概率。
示例:从一副标准扑克牌中不放回地抽两张。抽到两张 A 的概率是多少?
- 第一次抽到 A 的概率 P(Ace₁) = 4/52 = 1/13
- 抽出一张 A 后,剩余 51 张中还有 3 张 A,因此 P(Ace₂|Ace₁) = 3/51 = 1/17
- 因此:
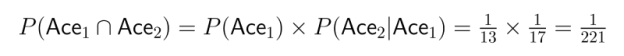
这表明依赖关系会显著影响联合概率的计算。
乘法法则与链式法则
以上计算体现了概率的乘法法则。该法则可扩展到两个以上的事件,使我们能用一连串条件概率来计算多个事件的联合概率:
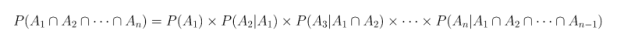
这被称为链式法则,它为分解复杂的联合概率提供了系统方法。
示例:从一副标准扑克牌中不放回地连续抽到三张红桃的概率:
- P(Heart₁) = 13/52 = 1/4
- P(Heart₂|Heart₁) = 12/51
- P(Heart₃|Heart₁ ∩ Heart₂) = 11/50
- P(Heart₁ ∩ Heart₂ ∩ Heart₃) = 1/4 × 12/51 × 11/50 = 11/850
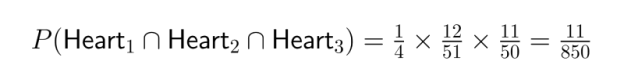
在数据科学中,链式法则在对事件序列建模或处理多阶段过程时尤为有用。
用于说明联合概率的示例
为巩固理解,我们来做一些经典示例,并探索在不同情境下这些概念如何发挥作用的实际应用。
经典示例
掷骰子
设想掷两枚六面骰。第一枚掷出 4,第二枚掷出 6 的概率是多少?
由于第一枚的结果不影响第二枚,这是独立事件:
- P(第一枚=4) = 1/6
- P(第二枚=6) = 1/6
- P(第一枚=4 ∩ 第二枚=6) = 1/6 × 1/6 = 1/36
也就是说该特定组合出现的概率约为 2.78%。
抽牌
计算从标准 52 张牌中不放回地抽到一张红牌后,再抽到一张 A 的概率。
由于是不放回抽取,这些事件相互依赖:
- P(第一次红牌) = 26/52 = 1/2
- P(第二次为 A | 第一次为红牌) = 若第一张是红 A 则为 3/51,否则为 4/51
要妥善处理,需要分别考虑两种情形:
- P(红但非 A 然后 A) = P(红非 A) × P(A | 红非 A) = 24/52 × 4/51 = 24/663
- P(红 A 然后再一张 A) = P(红 A) × P(A | 红 A) = 2/52 × 3/51 = 1/442
因此,总的联合概率为:P(第一次红牌 ∩ 第二次为 A) = 24/663 + 1/442 = (24×2 + 3)/1326 = 51/1326 = 1/26
概率约为 3.85%。
袋中弹珠
一个袋子里有 5 颗蓝色弹珠和 3 颗绿色弹珠。分别在两种情形下计算连续抽到两颗蓝色弹珠的概率。
有放回:
- P(第一次蓝) = 5/8
- P(第二次蓝) = 5/8(不变,因为放回了第一颗)
- P(蓝 ∩ 蓝) = 5/8 × 5/8 = 25/64 ≈ 39.06%
无放回:
- P(第一次蓝) = 5/8
- P(第二次蓝 | 第一次蓝) = 4/7
- P(蓝 ∩ 蓝) = 5/8 × 4/7 = 20/56 = 5/14 ≈ 35.71%
这一对比凸显了不放回所产生的依赖性如何降低联合概率。
现实应用
医学诊断
在评估多个症状或检测结果时,联合概率在医学领域至关重要。设想一个诊断场景,医生需要评估同时具有症状 A 和 B 的患者患某种疾病的情况。
基于历史数据:
- P(症状 A) = 0.30(30% 的人群表现出症状 A)
- P(症状 B) = 0.25(25% 的人群表现出症状 B)
- P(症状 A ∩ 症状 B) = 0.12(12% 同时出现两种症状)
这一联合概率有助于医生评估不同疾病的可能性。值得注意的是,P(A ∩ B) 不等于 P(A) × P(B) = 0.30 × 0.25 = 0.075,这表明症状并非独立——已知患者有一种症状会提高其出现另一种症状的可能性。
金融风险建模
投资分析师常需评估多个市场状况同时发生的联合概率。设某分析师评估下季度股市下跌与利率上升同时发生的风险。
若模型给出:
- P(股市下跌) = 0.35
- P(利率上升) = 0.60
- P(股市下跌 | 利率上升) = 0.45
则联合概率为:P(股市下跌 ∩ 利率上升) = 0.60 × 0.45 = 0.27
这 27% 的概率有助于量化投资组合风险,并指导对冲策略以防范该情景。
这些示例展示了联合概率如何在不同领域中量化不确定性,无论是分析博弈小例,还是在医学与金融中做出复杂决策。
联合概率与条件概率
联合概率与条件概率密切相关,它们使我们能够分析涉及多个事件的复杂情境。理解二者的关系,为概率推理提供了有力工具。
基本关系
联合概率与条件概率之间的关系由公式给出:
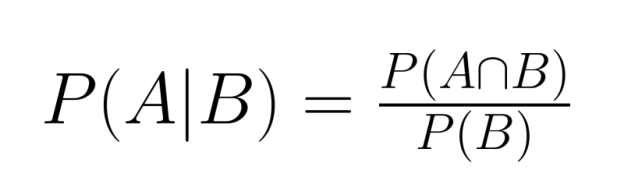
对该等式进行变形,我们可以用条件概率来表示联合概率:
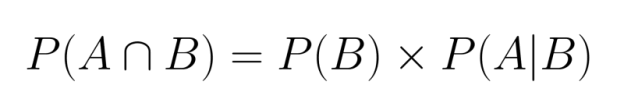
这表明,只要知道一个事件的边缘概率以及在该事件已发生前提下另一个事件的条件概率,我们就能计算联合概率。
类似地,还可以写成:
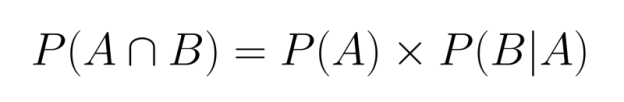
两种形式都有效且等价,体现了联合概率的对称性。
与贝叶斯定理的关联
联合概率与条件概率的关系是贝叶斯定理这一概率推断基础工具的核心:
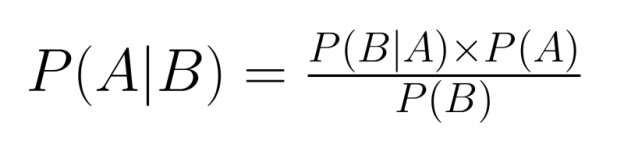
贝叶斯定理使我们能够“反转”条件概率——已知 P(B|A),即可计算 P(A|B)。当我们掌握一个方向的条件关系、却需要推断反方向关系时,这一点尤为关键。
例如,医学检测通常给出 P(阳性|患病),而医生需要判断 P(患病|阳性)。贝叶斯定理通过纳入联合概率来弥合这一差距:
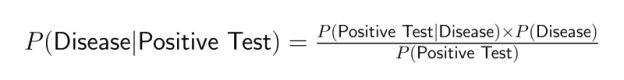
数据科学中的应用
联合概率是众多数据科学技术与应用的基石。理解多个事件的相互作用,有助于数据科学家构建更准确的模型,并在各领域做出更优预测。
预测建模
联合概率是许多分类算法(尤其是朴素贝叶斯分类器)的基础。这类流行的机器学习模型基于多个特征的存在来计算不同结果的概率。
朴素贝叶斯方法在应用贝叶斯定理时作出“朴素”的条件独立假设,从而简化联合概率的计算:

尽管有这一简化假设,朴素贝叶斯在以下场景中仍表现出色:
- 文本分类与垃圾邮件过滤
- 情感分析
- 医学诊断
- 客户细分
该方法计算效率高,即便独立性假设并不完全成立,往往也能取得令人惊喜的效果。
风险评估
在需要综合评估多个风险因素的欺诈检测系统中,联合概率起着关键作用。现代欺诈检测算法会分析可疑行为的组合,以识别潜在的欺诈交易。
以某在线支付系统为例,它会监控多种信号:
- 交易金额
- 地理位置
- 交易时间
- 设备信息
- 用户行为模式
单一信号或许不足以说明欺诈,但某些特定组合(即其联合发生)会显著提升可疑程度。例如,大额交易、来自新设备、位于海外、且发生在异常时段,这一联合事件可能具有较高的欺诈概率。
这种联合概率评估比单独评估各因素更为精细,可同时降低误报与漏报。
机器学习
联合概率概念是许多高级机器学习模型的核心,包括:
贝叶斯网络:这类图模型表示变量及其概率关系。它们通过将复杂的联合分布分解为更简单的条件概率,实现对复杂分布的推理。应用广泛于:
隐马尔可夫模型(HMM):这类序列模型用联合概率来刻画“隐藏状态—可观测输出”的系统。应用包括:
- 语音识别
- 自然语言处理
- 生物序列分析
- 金融时间序列建模
概率图模型:这是使用图结构编码复杂联合分布的一类更广泛模型。它们是以下任务的关键工具:
借助这些应用,联合概率使数据科学家能够构建刻画现实数据中复杂相互依赖关系的模型,从而获得更准确的预测,并在不确定性下做出更好的决策。
人们如何误解联合概率
尽管联合概率很有用,但也常被误解或误用。我们来看看一些常见误区及其避免方法。
将联合概率与条件概率混淆
最常见的错误之一是把 P(A∩B) 混同于 P(A|B)。二者虽有关联,但含义不同:
- 联合概率 P(A∩B) 回答的是:“A 与 B 同时发生的概率是多少?”
- 条件概率 P(A|B) 回答的是:“在 B 已发生的前提下,A 发生的概率是多少?”
例如,一个人既患糖尿病又超过 65 岁(联合)的概率,与在已知一个人超过 65 岁的条件下其患糖尿病(条件)的概率是不同的。
这一区别在诸多分析场景中至关重要。比如,当数据科学家报告“5% 的用户同时点击了广告并完成购买”时,这是一个联合概率;而“点击广告的用户中有 40% 完成了购买”则是一个条件概率,二者截然不同。
错误地假设独立
另一个常见错误是在未验证事件是否独立的情况下,武断地假设 P(A∩B) = P(A) × P(B)。当事件实际存在依赖时,这会带来显著误差。
例如在市场分析中,若假设购买产品 A 与产品 B 相互独立,则可能在产品互补(如打印机与墨水)或替代(如不同品牌同类商品)时导致错误的库存规划。
检验独立性至关重要——若 P(A∩B) ≠ P(A) × P(B),则事件相关,需要更谨慎地计算联合概率。
忽视边缘概率
在处理联合概率时,有时分析者只关注交集,而忽略各事件的整体发生频率。这可能导致对关系强度的误判。
例如,发现“购买了产品 A 和 B 的顾客中有 90% 也购买了产品 C”似乎很惊人。然而,如果无论是否购买 A、B,整体上就有 89% 的顾客都会买 C,那么该关联远没有看上去那么强。
务必将联合概率与相关的边缘概率进行比较,避免夸大事件之间的联系。提升度(lift)——即联合概率与边缘概率乘积之比——能更准确地衡量关联强度:
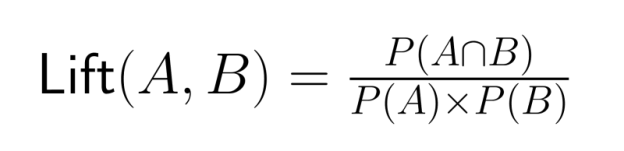
当提升度大于 1 时,表示事件共同发生的频率高于独立情形下的期望。
理解这些常见陷阱,有助于数据科学家正确应用联合概率,并从概率分析中获得有意义的洞见。
进阶主题与更多思考
随着职业发展,数据科学家将遇到更复杂的联合概率应用。下面探讨一些建立在基础之上的进阶概念。
高维空间中的联合概率
在现代机器学习问题中,数据科学家常需同时处理数十甚至上百个变量。在这些高维空间中,计算与表示联合概率变得具有挑战性。
用于刻画联合分布的参数数量会随变量个数呈指数级增长——这就是所谓“维度灾难”。例如,10 个二元变量的联合分布,完全刻画需 2¹⁰ - 1 = 1,023 个参数。
为应对复杂性,数据科学家会采用如下技术:
- 降维
- 变量选择
- 条件独立假设
- 因子化表示(如贝叶斯网络)
这些方法使高维联合概率的计算在计算机视觉、基因组学与自然语言处理等应用中变得可行。
联合概率分布
到目前为止,我们的示例多为离散事件,但联合概率可以自然地扩展到连续变量,通过联合概率分布来表述。
对于离散变量,我们使用联合概率质量函数(PMF),它给出各随机变量取特定值的组合所对应的概率:
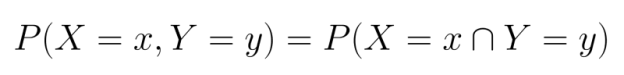
对于连续变量,我们使用联合概率密度函数(PDF)。与 PMF 不同,PDF 并不直接给出概率,而是需要对区域进行积分以得到变量落入该区域的概率:
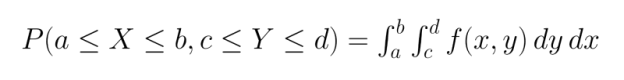
常见的联合分布包括:
- 多元正态分布
- 多元 t 分布
- 狄利克雷分布(Dirichlet)
- 多项分布
掌握这些分布,有助于在经济学、生物信息学与环境科学等领域中,更加成熟地建模连续变量之间的关系。
计算联合概率的实用工具
多种软件与编程语言提供了处理联合概率的函数与库:
Python:
R:
-
R 基础包包含众多多元分布函数
-
如 copula 等包可建模复杂依赖结构
-
bnlearn 支持贝叶斯网络分析
SQL:
这些工具让联合概率概念在大数据集上的应用成为可能,使数据科学家能为复杂问题构建精细的概率模型。
若您希望进一步深入联合概率及其在贝叶斯分析中的应用,DataCamp 提供多门优质课程:
这些课程将帮助您在本文概念的基础上,更好地将联合概率技术应用于真实的数据科学问题。
结论
正如本文所示,联合概率是一个基础的统计概念,在众多数据科学领域都有广泛应用。DataCamp 的资源(例如40+ Python 统计学与数据科学资源)为深化理解提供了优质路径。该合集包含了学习概率论、贝叶斯思维以及其他建立在联合概率之上的统计概念的具体推荐。
对于正在准备数据科学岗位的读者,我们的35 道统计学面试题与答案指南提供了包括联合概率在内的练习题,覆盖其他重要统计概念。我也认为我们的Probability Puzzles in R 课程是一个有趣的选择。


当气象分析师预测一场强烈风暴时,他们并不仅仅分别预报大雨或强风——而是在评估两种天气状况将会同时发生的概率。这个情景体现了联合概率——两个事件同时发生的可能性。
在本文中,我们将探讨联合概率的工作原理,查看适用于相互独立与相互依赖事件的公式,通过实际示例加深理解,并了解该概念在数据科学和机器学习中的应用。要快速回顾基本的概率定义与规则,请查看 DataCamp 的《概率规则入门速查表》。
什么是联合概率?
联合概率表示两个(或更多)事件同时发生的可能性。数学上记为 P(A∩B),读作“事件 A 与 B 的交集的概率”,或简作“ A 和 B 的概率”。
要理解联合概率,首先需要建立一些背景概念:
对于相互独立与相互依赖事件,联合概率有显著差异:
我们可以用维恩图来可视化联合概率,重叠区域表示事件的交集——即两个事件同时发生的情形:
维恩图展示集合 A 与 B 的关系,突出显示其交集 A ∩ B。图片作者自制。
这一重叠区域相对于整个样本空间的面积,即为 P(A∩B)——我们要计算的联合概率。
联合概率公式与关键性质
计算联合概率的方法取决于事件是否独立或依赖。我们分别考察两种情形,并梳理相关规则。
独立事件的联合概率
当两个事件相互独立时,计算其联合概率非常直接。由于彼此不影响,我们可以直接相乘各自的概率:
P(A∩B) = P(A) × P(B)
之所以适用乘法法则,是因为独立意味着已知一个事件发生,并不会提供关于另一个事件发生可能性的任何信息。
示例:掷两枚公平硬币。第一次正面的概率为 1/2,第二次正面的概率也为 1/2。由于两次独立(第一次不影响第二次),两次都为正面的概率为:
这意味着连续掷出两个正面的概率为 25%。
依赖事件的联合概率
当事件相互依赖时,必须考虑第一个事件如何影响第二个事件的概率。这需要在计算中使用条件概率:
其中,P(B|A) 表示已知事件 A 发生的前提下,事件 B 发生的概率。
示例:从一副标准扑克牌中不放回地抽两张。抽到两张 A 的概率是多少?
这表明依赖关系会显著影响联合概率的计算。
乘法法则与链式法则
以上计算体现了概率的乘法法则。该法则可扩展到两个以上的事件,使我们能用一连串条件概率来计算多个事件的联合概率:
这被称为链式法则,它为分解复杂的联合概率提供了系统方法。
示例:从一副标准扑克牌中不放回地连续抽到三张红桃的概率:
在数据科学中,链式法则在对事件序列建模或处理多阶段过程时尤为有用。
用于说明联合概率的示例
为巩固理解,我们来做一些经典示例,并探索在不同情境下这些概念如何发挥作用的实际应用。
经典示例
掷骰子
设想掷两枚六面骰。第一枚掷出 4,第二枚掷出 6 的概率是多少?
由于第一枚的结果不影响第二枚,这是独立事件:
也就是说该特定组合出现的概率约为 2.78%。
抽牌
计算从标准 52 张牌中不放回地抽到一张红牌后,再抽到一张 A 的概率。
由于是不放回抽取,这些事件相互依赖:
要妥善处理,需要分别考虑两种情形:
因此,总的联合概率为:P(第一次红牌 ∩ 第二次为 A) = 24/663 + 1/442 = (24×2 + 3)/1326 = 51/1326 = 1/26
概率约为 3.85%。
袋中弹珠
一个袋子里有 5 颗蓝色弹珠和 3 颗绿色弹珠。分别在两种情形下计算连续抽到两颗蓝色弹珠的概率。
有放回:
无放回:
这一对比凸显了不放回所产生的依赖性如何降低联合概率。
现实应用
医学诊断
在评估多个症状或检测结果时,联合概率在医学领域至关重要。设想一个诊断场景,医生需要评估同时具有症状 A 和 B 的患者患某种疾病的情况。
基于历史数据:
这一联合概率有助于医生评估不同疾病的可能性。值得注意的是,P(A ∩ B) 不等于 P(A) × P(B) = 0.30 × 0.25 = 0.075,这表明症状并非独立——已知患者有一种症状会提高其出现另一种症状的可能性。
金融风险建模
投资分析师常需评估多个市场状况同时发生的联合概率。设某分析师评估下季度股市下跌与利率上升同时发生的风险。
若模型给出:
则联合概率为:P(股市下跌 ∩ 利率上升) = 0.60 × 0.45 = 0.27
这 27% 的概率有助于量化投资组合风险,并指导对冲策略以防范该情景。
这些示例展示了联合概率如何在不同领域中量化不确定性,无论是分析博弈小例,还是在医学与金融中做出复杂决策。
联合概率与条件概率
联合概率与条件概率密切相关,它们使我们能够分析涉及多个事件的复杂情境。理解二者的关系,为概率推理提供了有力工具。
基本关系
联合概率与条件概率之间的关系由公式给出:
对该等式进行变形,我们可以用条件概率来表示联合概率:
这表明,只要知道一个事件的边缘概率以及在该事件已发生前提下另一个事件的条件概率,我们就能计算联合概率。
类似地,还可以写成:
两种形式都有效且等价,体现了联合概率的对称性。
与贝叶斯定理的关联
联合概率与条件概率的关系是贝叶斯定理这一概率推断基础工具的核心:
贝叶斯定理使我们能够“反转”条件概率——已知 P(B|A),即可计算 P(A|B)。当我们掌握一个方向的条件关系、却需要推断反方向关系时,这一点尤为关键。
例如,医学检测通常给出 P(阳性|患病),而医生需要判断 P(患病|阳性)。贝叶斯定理通过纳入联合概率来弥合这一差距:
数据科学中的应用
联合概率是众多数据科学技术与应用的基石。理解多个事件的相互作用,有助于数据科学家构建更准确的模型,并在各领域做出更优预测。
预测建模
联合概率是许多分类算法(尤其是朴素贝叶斯分类器)的基础。这类流行的机器学习模型基于多个特征的存在来计算不同结果的概率。
朴素贝叶斯方法在应用贝叶斯定理时作出“朴素”的条件独立假设,从而简化联合概率的计算:
尽管有这一简化假设,朴素贝叶斯在以下场景中仍表现出色:
该方法计算效率高,即便独立性假设并不完全成立,往往也能取得令人惊喜的效果。
风险评估
在需要综合评估多个风险因素的欺诈检测系统中,联合概率起着关键作用。现代欺诈检测算法会分析可疑行为的组合,以识别潜在的欺诈交易。
以某在线支付系统为例,它会监控多种信号:
单一信号或许不足以说明欺诈,但某些特定组合(即其联合发生)会显著提升可疑程度。例如,大额交易、来自新设备、位于海外、且发生在异常时段,这一联合事件可能具有较高的欺诈概率。
这种联合概率评估比单独评估各因素更为精细,可同时降低误报与漏报。
机器学习
联合概率概念是许多高级机器学习模型的核心,包括:
贝叶斯网络:这类图模型表示变量及其概率关系。它们通过将复杂的联合分布分解为更简单的条件概率,实现对复杂分布的推理。应用广泛于:
隐马尔可夫模型(HMM):这类序列模型用联合概率来刻画“隐藏状态—可观测输出”的系统。应用包括:
概率图模型:这是使用图结构编码复杂联合分布的一类更广泛模型。它们是以下任务的关键工具:
借助这些应用,联合概率使数据科学家能够构建刻画现实数据中复杂相互依赖关系的模型,从而获得更准确的预测,并在不确定性下做出更好的决策。
人们如何误解联合概率
尽管联合概率很有用,但也常被误解或误用。我们来看看一些常见误区及其避免方法。
将联合概率与条件概率混淆
最常见的错误之一是把 P(A∩B) 混同于 P(A|B)。二者虽有关联,但含义不同:
例如,一个人既患糖尿病又超过 65 岁(联合)的概率,与在已知一个人超过 65 岁的条件下其患糖尿病(条件)的概率是不同的。
这一区别在诸多分析场景中至关重要。比如,当数据科学家报告“5% 的用户同时点击了广告并完成购买”时,这是一个联合概率;而“点击广告的用户中有 40% 完成了购买”则是一个条件概率,二者截然不同。
错误地假设独立
另一个常见错误是在未验证事件是否独立的情况下,武断地假设 P(A∩B) = P(A) × P(B)。当事件实际存在依赖时,这会带来显著误差。
例如在市场分析中,若假设购买产品 A 与产品 B 相互独立,则可能在产品互补(如打印机与墨水)或替代(如不同品牌同类商品)时导致错误的库存规划。
检验独立性至关重要——若 P(A∩B) ≠ P(A) × P(B),则事件相关,需要更谨慎地计算联合概率。
忽视边缘概率
在处理联合概率时,有时分析者只关注交集,而忽略各事件的整体发生频率。这可能导致对关系强度的误判。
例如,发现“购买了产品 A 和 B 的顾客中有 90% 也购买了产品 C”似乎很惊人。然而,如果无论是否购买 A、B,整体上就有 89% 的顾客都会买 C,那么该关联远没有看上去那么强。
务必将联合概率与相关的边缘概率进行比较,避免夸大事件之间的联系。提升度(lift)——即联合概率与边缘概率乘积之比——能更准确地衡量关联强度:
当提升度大于 1 时,表示事件共同发生的频率高于独立情形下的期望。
理解这些常见陷阱,有助于数据科学家正确应用联合概率,并从概率分析中获得有意义的洞见。
进阶主题与更多思考
随着职业发展,数据科学家将遇到更复杂的联合概率应用。下面探讨一些建立在基础之上的进阶概念。
高维空间中的联合概率
在现代机器学习问题中,数据科学家常需同时处理数十甚至上百个变量。在这些高维空间中,计算与表示联合概率变得具有挑战性。
用于刻画联合分布的参数数量会随变量个数呈指数级增长——这就是所谓“维度灾难”。例如,10 个二元变量的联合分布,完全刻画需 2¹⁰ - 1 = 1,023 个参数。
为应对复杂性,数据科学家会采用如下技术:
这些方法使高维联合概率的计算在计算机视觉、基因组学与自然语言处理等应用中变得可行。
联合概率分布
到目前为止,我们的示例多为离散事件,但联合概率可以自然地扩展到连续变量,通过联合概率分布来表述。
对于离散变量,我们使用联合概率质量函数(PMF),它给出各随机变量取特定值的组合所对应的概率:
对于连续变量,我们使用联合概率密度函数(PDF)。与 PMF 不同,PDF 并不直接给出概率,而是需要对区域进行积分以得到变量落入该区域的概率:
常见的联合分布包括:
掌握这些分布,有助于在经济学、生物信息学与环境科学等领域中,更加成熟地建模连续变量之间的关系。
计算联合概率的实用工具
多种软件与编程语言提供了处理联合概率的函数与库:
Python:
NumPy与SciPy提供多元概率分布函数Pandas 提供强大的经验联合概率计算工具
如
PyMC3与PyStan等库实现了带联合分布的贝叶斯建模R:
R 基础包包含众多多元分布函数
如
copula等包可建模复杂依赖结构bnlearn支持贝叶斯网络分析SQL:
GROUP BY与COUNT可计算经验联合概率窗口函数支持更复杂的概率分析
现代数据库支持概率计算的统计函数
这些工具让联合概率概念在大数据集上的应用成为可能,使数据科学家能为复杂问题构建精细的概率模型。
若您希望进一步深入联合概率及其在贝叶斯分析中的应用,DataCamp 提供多门优质课程:
这些课程将帮助您在本文概念的基础上,更好地将联合概率技术应用于真实的数据科学问题。
结论
正如本文所示,联合概率是一个基础的统计概念,在众多数据科学领域都有广泛应用。DataCamp 的资源(例如40+ Python 统计学与数据科学资源)为深化理解提供了优质路径。该合集包含了学习概率论、贝叶斯思维以及其他建立在联合概率之上的统计概念的具体推荐。
对于正在准备数据科学岗位的读者,我们的35 道统计学面试题与答案指南提供了包括联合概率在内的练习题,覆盖其他重要统计概念。我也认为我们的Probability Puzzles in R 课程是一个有趣的选择。