只掌握数据分析工具而不理解其背后的理念,就像手里有一盒螺丝刀却不知道何时、如何用各个型号。学习统计学至关重要,因为随着 AI 生成和 AI 辅助分析工具的兴起,单纯的技术能力将不再是核心竞争力,取而代之的是对知识的理解与批判性思维。
请不要被统计学的复杂性吓倒。本文通过 35 道统计学面试题与答案,为数据分析师和数据科学家系统梳理最重要的统计学概念。无论您是否在准备面试,我相信这些问题都会对您有所启发。
最后,在开始之前,建议您先学习我们的 Introduction to Statistics in R 课程,掌握基础知识,包括如何进行统计分析与解读结果。如果您正在为需要统计学理解的面试做准备,以下两门 DataCamp 课程涵盖最常被考查的统计主题:Practicing Statistics Interview Questions in Python 和 Practicing Statistics Interview Questions in R。
基础统计学面试题
大多数(如果不是全部)数据分析岗位都要求具备统计学基础,包括描述性统计、推断统计和概率。如果您在面试前想快速复习描述性统计,可下载我们的 Descriptive Statistics Cheat Sheet 以便随时参考。此外,如果您想练习一些计算与方法,欢迎阅读以下 DataCamp 教程,更深入地理解相关概念:
1. 标准差与方差是什么?
方差和标准差都用于衡量数据集的离散程度或分散程度。方差是各个数据与其均值之差的平方的平均值,反映数据与均值的偏离程度。但由于采用了平方差,方差的单位也被平方,相比标准差不太直观。 标准差是方差的平方根,使量纲回到与原始数据相同,更便于解释。例如,若某数据集的方差为 25,则标准差为 √25 = 5。
2. 偏度(Skewness)是什么?
偏度衡量数据集围绕其均值的偏斜程度,可能为正、负或零。正偏(右偏)数据右侧尾部更长,均值大于中位数;负偏(左偏)数据左侧尾部更长,均值小于中位数。偏度为零表示分布对称,例如正态分布,此时均值、中位数与众数相等。
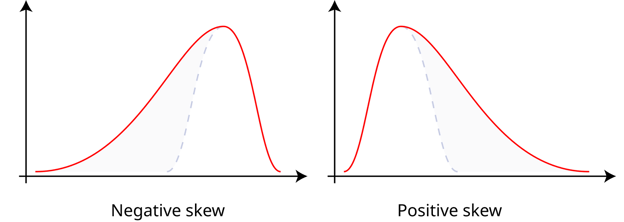
正偏与负偏。来源:Wikiversity。
3. 什么是直方图?
直方图是用于展示数据集分布的图形方法。它将数据划分为若干箱(区间),显示落入每个箱内的数据点频数(或计数)。直方图用于理解连续型数据的底层频数分布(形状),有助于识别偏度、模态(峰的个数)以及是否存在离群值。
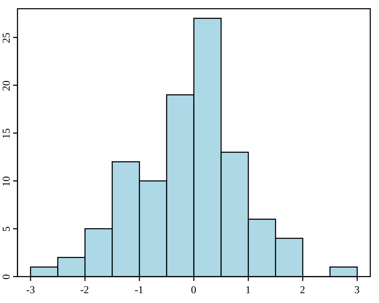
直方图示例。来源:Wikipedia。
4. 描述性统计与推断统计有何区别?
推断统计是基于来自总体的随机样本,对总体进行预测或推断。它使用多种方法估计总体参数、检验假设并进行预测。 描述性统计用于汇总和描述数据集特征,而推断统计利用样本数据对更大总体进行概括并得出结论。
5. 常见抽样方法有哪些?
不同的抽样方法用于确保样本具有代表性且具随机性。简单随机抽样使总体中每个个体被抽中的概率相等。系统抽样是在随机起点后每隔 k 个单位抽取一个。分层抽样把总体划分为层(子群),并在每一层内进行随机抽样。整群抽样将总体划分为若干群集,随机抽取部分群集并对其中所有个体进行调查。
6. 什么是中心极限定理?
中心极限定理指出,只要样本相互独立且同分布,随着样本量增大,样本均值的抽样分布将趋近于正态分布,而不论总体分布为何。
7. 什么是联合、边缘与条件概率?
边缘概率指单一事件发生的概率,不考虑其他事件,事件 A 的边缘概率记为 P(A)。联合概率指两个事件同时发生的概率,事件 A 与 B 的联合概率记为 P(A∩B)。条件概率指在另一事件已发生条件下某事件发生的概率,记为 P(A|B)。
8. 什么是概率分布?
概率分布描述随机变量取值的分布情况,它提供一个函数,将随机变量的各个结果映射为相应的概率。概率分布主要分为两类:一是离散型随机变量的离散分布,如二项分布、泊松分布;二是连续型随机变量的连续分布,如正态分布、指数分布。
9. 什么是正态分布?
正态分布(高斯分布)是一种连续概率分布,其曲线呈钟形,关于均值对称。对于正态分布,均值等于中位数。此外,约 68% 的数据落在均值的 1 个标准差内,95% 落在 2 个标准差内,99.7% 落在 3 个标准差内,这称为 68-95-99.7 规则。
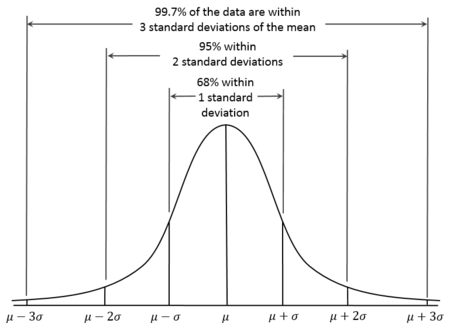
正态分布曲线。来源:Wikiversity。
10. 什么是二项分布?
二项分布是一种离散概率分布,用于刻画在若干次相互独立且成功概率相同的伯努利试验中,成功发生的次数。适用于每次试验只有两种可能结果(成功与失败)的情形。例如,可用于建模一系列抛硬币中出现正面的次数。
11. 什么是泊松分布?
泊松分布是一种离散概率分布,用于刻画在固定时间或空间区间内发生事件的次数,且事件独立发生并具有恒定的平均发生率。适合用于稀有事件计数的建模,例如一小时内收到的邮件数或一年中的地震次数。
中级统计学面试题
针对中级统计岗位,重点关注假设检验、区间估计与回归建模。若在阅读这些问题时对某些概念不太自信,可以借助 DataCamp 资源。您可以通过 Hypothesis Testing in Python 和 Hypothesis Testing in R 课程学习假设检验。您还可以通过以下课程与教程掌握回归技术:
12. 什么是 p 值?
p 值是在原假设为真时,得到至少与观测到的检验统计量同等极端结果的概率。它用于假设检验以判断检验结果的显著性。如果 p 值小于或等于选定的显著性水平(α),我们拒绝原假设;若 p 值大于 α,则不拒绝原假设。
13. I 类错误与 II 类错误是什么?
在假设检验中,I 类错误指原假设为真却被误拒(假阳性),其发生概率等于显著性水平。II 类错误指原假设为假却未被拒绝(假阴性)。
14. 参数检验与非参数检验有何区别?
参数检验假定数据服从特定分布(如正态)并需要满足某些总体参数条件,若假设成立则更理想。常见的参数检验包括 t 检验、Z 检验和 ANOVA。非参数检验不假定特定分布,当数据不满足参数检验的假设、尤其是样本量较小时使用。很多人熟悉这些检验,但未必知道它们属于非参数检验,比如卡方检验、Mann-Whitney U 检验、Wilcoxon 符号秩检验、Kruskal-Wallis 检验等。
15. 什么是回归?
回归分析是一种统计方法,用于研究一个因变量与一个或多个自变量之间的关系。它帮助我们理解当某一自变量变化时,在其他自变量保持不变的情况下,因变量如何随之变化。
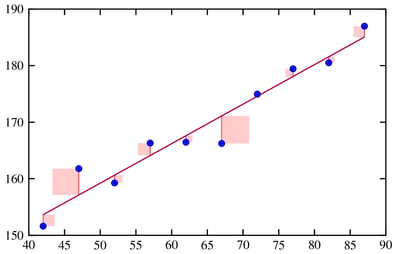
拟合回归直线。来源:Risk Engineering。
16. 什么是残差?
残差是观测值与回归模型预测值之间的差异。分析残差有助于检查模型假设是否成立,以及评估模型整体拟合效果。
17. 线性回归模型的系数如何解读?
在线性回归模型中,每个系数表示当对应自变量增加一个单位、且其他变量保持不变时,因变量的期望变化量。例如,若自变量 𝑥𝑖 的系数为 2,意味着在其他变量不变的条件下,𝑥𝑖 每增加 1 个单位,因变量 y 期望增加 2 个单位。
18. 什么是置信区间?
95% 置信区间的含义是:如果我们反复抽样并为每个样本计算置信区间,大约有 95% 的区间会包含真实的总体参数。也可以说,我们有 95% 的把握认为参数值位于所估计的区间内。
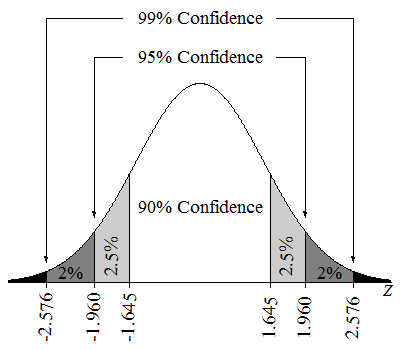
Z 分布上的置信区间。来源:Lumen Learning。
19. 什么是多重共线性?
多重共线性是指多元回归模型中两个或以上自变量高度相关。它会导致系数估计不稳定、难以解释;还可能增大系数的标准误,从而降低统计检验的可靠性。
20. 什么是正则化?
正则化技术是处理回归模型多重共线性的有力方法,同时通过对较大的系数加以惩罚来防止过拟合,从而提升模型的泛化能力。常见的正则化方法包括 Lasso 与 Ridge 回归。
高级统计学面试题
如果我要准备一场需要高级统计学理解的面试,我会重点学习贝叶斯统计与机器学习。
关于贝叶斯统计,您可以学习这些课程:Bayesian Data Analysis in Python 和 Fundamentals of Bayesian Data Analysis in R。关于机器学习,请查看 DataCamp 的职业路径或课程,包括 Machine Learning Scientist with Python 职业路径和 Understanding Machine Learning 课程。
21. 什么是贝叶斯统计?
贝叶斯统计使用贝叶斯定理,随着新证据或信息的获得,更新某一假设为真的概率。它将先验信念与新数据相结合,形成后验概率。
22. 什么是马尔可夫链蒙特卡罗(MCMC)?
马尔可夫链蒙特卡罗是一类用于从概率分布中采样的算法,当直接采样困难时尤为重要。在贝叶斯统计中,它可用于估计后验分布,尤其是在解析解不可行的复杂模型中。
23. 什么是偏差-方差权衡?
机器学习中的偏差-方差权衡是在两种误差来源之间取得平衡。偏差是源于模型假设过于简单而产生的误差,导致欠拟合、遗漏实际模式;方差是模型对训练数据波动过于敏感而产生的误差,导致过拟合、将噪声当作模式来学习。
24. 什么是因果推断?
因果推断是一个备受关注的重要理念,旨在判定一个变量(原因)是否以及如何直接影响另一个变量(结果),这与单纯的相关性有本质区别。因果推断是一组方法,目标是建立因果关系,以判断某种干预或治疗是否有效。例如,研究者需要了解某药物是否有效时,因果推断可以帮助作出回答。
25. 什么是结构方程模型(SEM)?
结构方程模型是一种分析显变量与潜变量之间关系的技术,某种程度上结合了多元回归与因子分析。结构方程模型通常包含多个步骤,如模型设定、参数估计与模型评估。SEM 以其灵活著称,但需要较大的样本量,并且在应用之前需要坚实的理论基础。
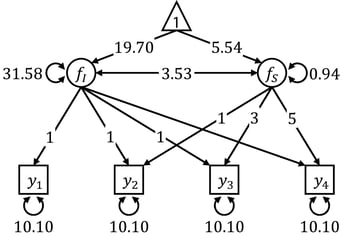
路径图常用于可视化 SEM。来源:Frontiers。
数据科学统计学面试题
如果您申请的岗位更偏向数据科学与统计学的交叉领域,下面的问题将很有帮助。主题包括数据预处理与清洗、A/B 测试与实验设计、时间序列预测以及高级统计技术。
如果您对这些概念把握不稳,且希望认真提升面试表现,可学习 DataCamp 的 A/B 测试资源:A/B Testing in Python 课程或 A/B Testing in R 课程。随后,为掌握时间序列分析,可选择 Time Series with R 或 Time Series with Python 技能路径进行实践。
26. 为什么要进行训练集/测试集划分?
将数据划分为训练集和测试集有助于评估模型在未见过的数据上的表现。训练集用于训练模型,测试集用于评估模型对新数据的泛化能力。这一做法有助于发现过拟合,并确保模型能在真实世界数据上良好运行。
27. 能解释一下过拟合与欠拟合吗?
过拟合是指模型不仅学到了数据中的真实模式,也学到了噪声,导致在训练数据上表现出色,但在新数据上表现较差。欠拟合是指模型过于简单,无法捕捉数据的潜在模式,导致在训练数据与新数据上表现都不佳。
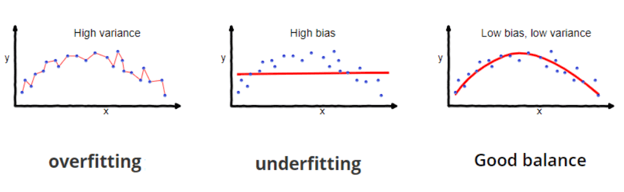
过拟合与欠拟合。来源:Wikipedia。
28. 数据缺失的类型有哪些?
理解缺失机制(MCAR、MAR、MNAR)至关重要,它能指导我们选择合适的缺失数据处理方法。不当方法会引入偏差、降低结果有效性并导致错误结论。例如,简单插补可能适用于 MCAR,而对于 MAR 或 MNAR,为获得无偏估计可能需要更复杂的方法,如多重插补或基于模型的方法。
29. 何时适合删除缺失值?
当缺失比例非常小(通常低于 5%)时,删除缺失值可能是合适的;当缺失是 MCAR(完全随机缺失)时也较为合理,因为不会引入偏差。最后,如果数据集足够大,删除少量行不会对分析产生显著影响,我也会考虑删除缺失值。
30. 不同插补方法的优劣是什么?
各类插补方法各有利弊。例如,均值/中位数/众数插补实现简单,但可能引入偏差并扭曲变量间关系。K 近邻(KNN)插补会考虑变量间关系,往往更准确,但计算开销较大。
31. 什么是 A/B 测试?
A/B 测试是实验设计中用于比较某变量两个版本(如网页、应用功能或营销活动)表现孰优的方法。它高度相关,且常出现在许多岗位描述的“必备”项中。
32. 如何检测时间序列中的季节性?
季节性是时间序列的组成部分之一,此外还有趋势与残差(噪声)。检测季节性可先通过折线图进行可视化检查;若怀疑存在季节性,可对时间序列进行分解,以估计季节效应的大小。
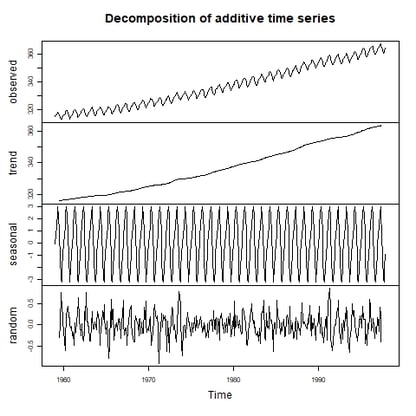
时间序列的可视化分解。来源:Lab of Environmental Informatics。
33. 指数平滑与 ARIMA 模型有何区别?
指数平滑模型通过对历史观测赋予加权平均来进行简单的短期预测。ARIMA 模型结合自回归、差分与移动平均成分,更为复杂,既适用于短期也适用于长期预测,尤其适合存在复杂模式和显著自相关的情形。
34. 什么是交叉验证?
交叉验证是一种评估机器学习模型对独立数据集泛化能力的技术。它将数据划分为若干折(fold),并进行多轮训练与验证。
行为与软技能面试题
仅仅把统计与分析结果做正确还不够,还要能将结论传达给业务相关方。因此,软技能对数据岗位的雇主同样重要,尤其是因为将统计洞见清晰传达并不容易。
35. 您如何向非技术相关方传达统计洞见?
为了与不同相关方有效沟通,我会根据他们的背景与关注点调整表达方式。例如,对高管我会优先强调业务影响,使用业务语言与可视化,便于快速决策;而面对开发人员,我会提供技术细节。 无论对象是谁,我都会确保相关概念表述清晰易懂,并鼓励提问与反馈。这样可以让不同群体都以契合其需求的方式获取信息。
结语
为数据分析岗位学习统计学可能具有挑战性。许多人来自并不强调统计知识的不同背景。线上资源中也有不少只强调工具、忽略统计学关键作用的倾向。
为进一步提升您的知识与职业机会,欢迎探索更多资源与课程。关于如何成为统计学家的详细指南,请查看我们的博文 How to Become a Statistician,其中提供了宝贵见解。您还可以学习我们的 Statistician with R 职业路径。抽空用 Probability Puzzles in R 课程检验一下自己的直觉。如果您更偏好 Python,我们的 Statistics Fundamentals with Python 技能路径也是不错的选择。
预祝您面试顺利!


只掌握数据分析工具而不理解其背后的理念,就像手里有一盒螺丝刀却不知道何时、如何用各个型号。学习统计学至关重要,因为随着 AI 生成和 AI 辅助分析工具的兴起,单纯的技术能力将不再是核心竞争力,取而代之的是对知识的理解与批判性思维。
请不要被统计学的复杂性吓倒。本文通过 35 道统计学面试题与答案,为数据分析师和数据科学家系统梳理最重要的统计学概念。无论您是否在准备面试,我相信这些问题都会对您有所启发。
最后,在开始之前,建议您先学习我们的 Introduction to Statistics in R 课程,掌握基础知识,包括如何进行统计分析与解读结果。如果您正在为需要统计学理解的面试做准备,以下两门 DataCamp 课程涵盖最常被考查的统计主题:Practicing Statistics Interview Questions in Python 和 Practicing Statistics Interview Questions in R。
基础统计学面试题
大多数(如果不是全部)数据分析岗位都要求具备统计学基础,包括描述性统计、推断统计和概率。如果您在面试前想快速复习描述性统计,可下载我们的 Descriptive Statistics Cheat Sheet 以便随时参考。此外,如果您想练习一些计算与方法,欢迎阅读以下 DataCamp 教程,更深入地理解相关概念:
1. 标准差与方差是什么?
方差和标准差都用于衡量数据集的离散程度或分散程度。方差是各个数据与其均值之差的平方的平均值,反映数据与均值的偏离程度。但由于采用了平方差,方差的单位也被平方,相比标准差不太直观。 标准差是方差的平方根,使量纲回到与原始数据相同,更便于解释。例如,若某数据集的方差为 25,则标准差为 √25 = 5。
2. 偏度(Skewness)是什么?
偏度衡量数据集围绕其均值的偏斜程度,可能为正、负或零。正偏(右偏)数据右侧尾部更长,均值大于中位数;负偏(左偏)数据左侧尾部更长,均值小于中位数。偏度为零表示分布对称,例如正态分布,此时均值、中位数与众数相等。
正偏与负偏。来源:Wikiversity。
3. 什么是直方图?
直方图是用于展示数据集分布的图形方法。它将数据划分为若干箱(区间),显示落入每个箱内的数据点频数(或计数)。直方图用于理解连续型数据的底层频数分布(形状),有助于识别偏度、模态(峰的个数)以及是否存在离群值。
直方图示例。来源:Wikipedia。
4. 描述性统计与推断统计有何区别?
推断统计是基于来自总体的随机样本,对总体进行预测或推断。它使用多种方法估计总体参数、检验假设并进行预测。 描述性统计用于汇总和描述数据集特征,而推断统计利用样本数据对更大总体进行概括并得出结论。
5. 常见抽样方法有哪些?
不同的抽样方法用于确保样本具有代表性且具随机性。简单随机抽样使总体中每个个体被抽中的概率相等。系统抽样是在随机起点后每隔 k 个单位抽取一个。分层抽样把总体划分为层(子群),并在每一层内进行随机抽样。整群抽样将总体划分为若干群集,随机抽取部分群集并对其中所有个体进行调查。
6. 什么是中心极限定理?
中心极限定理指出,只要样本相互独立且同分布,随着样本量增大,样本均值的抽样分布将趋近于正态分布,而不论总体分布为何。
7. 什么是联合、边缘与条件概率?
边缘概率指单一事件发生的概率,不考虑其他事件,事件 A 的边缘概率记为 P(A)。联合概率指两个事件同时发生的概率,事件 A 与 B 的联合概率记为 P(A∩B)。条件概率指在另一事件已发生条件下某事件发生的概率,记为 P(A|B)。
8. 什么是概率分布?
概率分布描述随机变量取值的分布情况,它提供一个函数,将随机变量的各个结果映射为相应的概率。概率分布主要分为两类:一是离散型随机变量的离散分布,如二项分布、泊松分布;二是连续型随机变量的连续分布,如正态分布、指数分布。
9. 什么是正态分布?
正态分布(高斯分布)是一种连续概率分布,其曲线呈钟形,关于均值对称。对于正态分布,均值等于中位数。此外,约 68% 的数据落在均值的 1 个标准差内,95% 落在 2 个标准差内,99.7% 落在 3 个标准差内,这称为 68-95-99.7 规则。
正态分布曲线。来源:Wikiversity。
10. 什么是二项分布?
二项分布是一种离散概率分布,用于刻画在若干次相互独立且成功概率相同的伯努利试验中,成功发生的次数。适用于每次试验只有两种可能结果(成功与失败)的情形。例如,可用于建模一系列抛硬币中出现正面的次数。
11. 什么是泊松分布?
泊松分布是一种离散概率分布,用于刻画在固定时间或空间区间内发生事件的次数,且事件独立发生并具有恒定的平均发生率。适合用于稀有事件计数的建模,例如一小时内收到的邮件数或一年中的地震次数。
中级统计学面试题
针对中级统计岗位,重点关注假设检验、区间估计与回归建模。若在阅读这些问题时对某些概念不太自信,可以借助 DataCamp 资源。您可以通过 Hypothesis Testing in Python 和 Hypothesis Testing in R 课程学习假设检验。您还可以通过以下课程与教程掌握回归技术:
12. 什么是 p 值?
p 值是在原假设为真时,得到至少与观测到的检验统计量同等极端结果的概率。它用于假设检验以判断检验结果的显著性。如果 p 值小于或等于选定的显著性水平(α),我们拒绝原假设;若 p 值大于 α,则不拒绝原假设。
13. I 类错误与 II 类错误是什么?
在假设检验中,I 类错误指原假设为真却被误拒(假阳性),其发生概率等于显著性水平。II 类错误指原假设为假却未被拒绝(假阴性)。
14. 参数检验与非参数检验有何区别?
参数检验假定数据服从特定分布(如正态)并需要满足某些总体参数条件,若假设成立则更理想。常见的参数检验包括 t 检验、Z 检验和 ANOVA。非参数检验不假定特定分布,当数据不满足参数检验的假设、尤其是样本量较小时使用。很多人熟悉这些检验,但未必知道它们属于非参数检验,比如卡方检验、Mann-Whitney U 检验、Wilcoxon 符号秩检验、Kruskal-Wallis 检验等。
15. 什么是回归?
回归分析是一种统计方法,用于研究一个因变量与一个或多个自变量之间的关系。它帮助我们理解当某一自变量变化时,在其他自变量保持不变的情况下,因变量如何随之变化。
拟合回归直线。来源:Risk Engineering。
16. 什么是残差?
残差是观测值与回归模型预测值之间的差异。分析残差有助于检查模型假设是否成立,以及评估模型整体拟合效果。
17. 线性回归模型的系数如何解读?
在线性回归模型中,每个系数表示当对应自变量增加一个单位、且其他变量保持不变时,因变量的期望变化量。例如,若自变量 𝑥𝑖 的系数为 2,意味着在其他变量不变的条件下,𝑥𝑖 每增加 1 个单位,因变量 y 期望增加 2 个单位。
18. 什么是置信区间?
95% 置信区间的含义是:如果我们反复抽样并为每个样本计算置信区间,大约有 95% 的区间会包含真实的总体参数。也可以说,我们有 95% 的把握认为参数值位于所估计的区间内。
Z 分布上的置信区间。来源:Lumen Learning。
19. 什么是多重共线性?
多重共线性是指多元回归模型中两个或以上自变量高度相关。它会导致系数估计不稳定、难以解释;还可能增大系数的标准误,从而降低统计检验的可靠性。
20. 什么是正则化?
正则化技术是处理回归模型多重共线性的有力方法,同时通过对较大的系数加以惩罚来防止过拟合,从而提升模型的泛化能力。常见的正则化方法包括 Lasso 与 Ridge 回归。
高级统计学面试题
如果我要准备一场需要高级统计学理解的面试,我会重点学习贝叶斯统计与机器学习。
关于贝叶斯统计,您可以学习这些课程:Bayesian Data Analysis in Python 和 Fundamentals of Bayesian Data Analysis in R。关于机器学习,请查看 DataCamp 的职业路径或课程,包括 Machine Learning Scientist with Python 职业路径和 Understanding Machine Learning 课程。
21. 什么是贝叶斯统计?
贝叶斯统计使用贝叶斯定理,随着新证据或信息的获得,更新某一假设为真的概率。它将先验信念与新数据相结合,形成后验概率。
22. 什么是马尔可夫链蒙特卡罗(MCMC)?
马尔可夫链蒙特卡罗是一类用于从概率分布中采样的算法,当直接采样困难时尤为重要。在贝叶斯统计中,它可用于估计后验分布,尤其是在解析解不可行的复杂模型中。
23. 什么是偏差-方差权衡?
机器学习中的偏差-方差权衡是在两种误差来源之间取得平衡。偏差是源于模型假设过于简单而产生的误差,导致欠拟合、遗漏实际模式;方差是模型对训练数据波动过于敏感而产生的误差,导致过拟合、将噪声当作模式来学习。
24. 什么是因果推断?
因果推断是一个备受关注的重要理念,旨在判定一个变量(原因)是否以及如何直接影响另一个变量(结果),这与单纯的相关性有本质区别。因果推断是一组方法,目标是建立因果关系,以判断某种干预或治疗是否有效。例如,研究者需要了解某药物是否有效时,因果推断可以帮助作出回答。
25. 什么是结构方程模型(SEM)?
结构方程模型是一种分析显变量与潜变量之间关系的技术,某种程度上结合了多元回归与因子分析。结构方程模型通常包含多个步骤,如模型设定、参数估计与模型评估。SEM 以其灵活著称,但需要较大的样本量,并且在应用之前需要坚实的理论基础。
路径图常用于可视化 SEM。来源:Frontiers。
数据科学统计学面试题
如果您申请的岗位更偏向数据科学与统计学的交叉领域,下面的问题将很有帮助。主题包括数据预处理与清洗、A/B 测试与实验设计、时间序列预测以及高级统计技术。
如果您对这些概念把握不稳,且希望认真提升面试表现,可学习 DataCamp 的 A/B 测试资源:A/B Testing in Python 课程或 A/B Testing in R 课程。随后,为掌握时间序列分析,可选择 Time Series with R 或 Time Series with Python 技能路径进行实践。
26. 为什么要进行训练集/测试集划分?
将数据划分为训练集和测试集有助于评估模型在未见过的数据上的表现。训练集用于训练模型,测试集用于评估模型对新数据的泛化能力。这一做法有助于发现过拟合,并确保模型能在真实世界数据上良好运行。
27. 能解释一下过拟合与欠拟合吗?
过拟合是指模型不仅学到了数据中的真实模式,也学到了噪声,导致在训练数据上表现出色,但在新数据上表现较差。欠拟合是指模型过于简单,无法捕捉数据的潜在模式,导致在训练数据与新数据上表现都不佳。
过拟合与欠拟合。来源:Wikipedia。
28. 数据缺失的类型有哪些?
理解缺失机制(MCAR、MAR、MNAR)至关重要,它能指导我们选择合适的缺失数据处理方法。不当方法会引入偏差、降低结果有效性并导致错误结论。例如,简单插补可能适用于 MCAR,而对于 MAR 或 MNAR,为获得无偏估计可能需要更复杂的方法,如多重插补或基于模型的方法。
29. 何时适合删除缺失值?
当缺失比例非常小(通常低于 5%)时,删除缺失值可能是合适的;当缺失是 MCAR(完全随机缺失)时也较为合理,因为不会引入偏差。最后,如果数据集足够大,删除少量行不会对分析产生显著影响,我也会考虑删除缺失值。
30. 不同插补方法的优劣是什么?
各类插补方法各有利弊。例如,均值/中位数/众数插补实现简单,但可能引入偏差并扭曲变量间关系。K 近邻(KNN)插补会考虑变量间关系,往往更准确,但计算开销较大。
31. 什么是 A/B 测试?
A/B 测试是实验设计中用于比较某变量两个版本(如网页、应用功能或营销活动)表现孰优的方法。它高度相关,且常出现在许多岗位描述的“必备”项中。
32. 如何检测时间序列中的季节性?
季节性是时间序列的组成部分之一,此外还有趋势与残差(噪声)。检测季节性可先通过折线图进行可视化检查;若怀疑存在季节性,可对时间序列进行分解,以估计季节效应的大小。
时间序列的可视化分解。来源:Lab of Environmental Informatics。
33. 指数平滑与 ARIMA 模型有何区别?
指数平滑模型通过对历史观测赋予加权平均来进行简单的短期预测。ARIMA 模型结合自回归、差分与移动平均成分,更为复杂,既适用于短期也适用于长期预测,尤其适合存在复杂模式和显著自相关的情形。
34. 什么是交叉验证?
交叉验证是一种评估机器学习模型对独立数据集泛化能力的技术。它将数据划分为若干折(fold),并进行多轮训练与验证。
行为与软技能面试题
仅仅把统计与分析结果做正确还不够,还要能将结论传达给业务相关方。因此,软技能对数据岗位的雇主同样重要,尤其是因为将统计洞见清晰传达并不容易。
35. 您如何向非技术相关方传达统计洞见?
为了与不同相关方有效沟通,我会根据他们的背景与关注点调整表达方式。例如,对高管我会优先强调业务影响,使用业务语言与可视化,便于快速决策;而面对开发人员,我会提供技术细节。 无论对象是谁,我都会确保相关概念表述清晰易懂,并鼓励提问与反馈。这样可以让不同群体都以契合其需求的方式获取信息。
结语
为数据分析岗位学习统计学可能具有挑战性。许多人来自并不强调统计知识的不同背景。线上资源中也有不少只强调工具、忽略统计学关键作用的倾向。
为进一步提升您的知识与职业机会,欢迎探索更多资源与课程。关于如何成为统计学家的详细指南,请查看我们的博文 How to Become a Statistician,其中提供了宝贵见解。您还可以学习我们的 Statistician with R 职业路径。抽空用 Probability Puzzles in R 课程检验一下自己的直觉。如果您更偏好 Python,我们的 Statistics Fundamentals with Python 技能路径也是不错的选择。
预祝您面试顺利!