
Corso
Fondamenti di probabilità in R
4 ore
42.8K
Quando un meteorologo prevede una forte tempesta, non sta semplicemente stimando pioggia intensa o venti forti separatamente – sta valutando la probabilità che entrambi i fenomeni meteorologici si verifichino insieme. Questo scenario illustra la probabilità congiunta – la probabilità che due eventi si verifichino simultaneamente.
In questo articolo vedremo come funziona la probabilità congiunta, analizzeremo le formule per eventi dipendenti e indipendenti, svolgeremo esempi pratici e capiremo come questo concetto si applica in data science e machine learning. Per un comodo riferimento alle definizioni e regole di base della probabilità, dai un'occhiata alla cheat sheet Introduction to Probability Rules di DataCamp.
La probabilità congiunta rappresenta la probabilità che due (o più) eventi si verifichino nello stesso momento. Matematicamente si indica come P(A∩B), che si legge "probabilità di A intersezione B" o semplicemente "probabilità di A e B".
Per capire la probabilità congiunta, serve prima stabilire qualche contesto:
La probabilità congiunta differisce sensibilmente tra eventi indipendenti e dipendenti:
Possiamo visualizzare la probabilità congiunta con un diagramma di Venn, dove la regione di sovrapposizione rappresenta l'intersezione degli eventi — gli scenari in cui entrambi gli eventi si verificano simultaneamente:
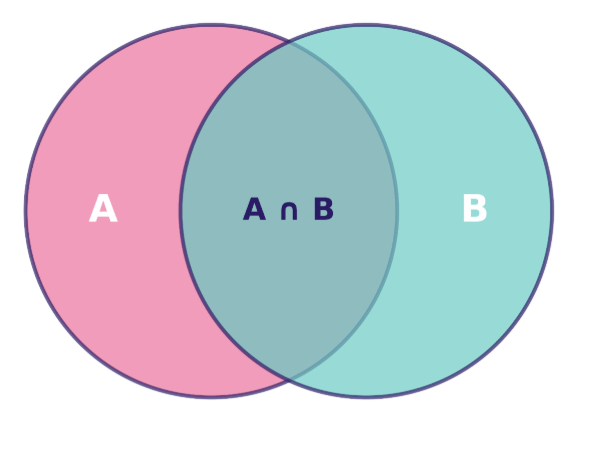
Diagramma di Venn che mostra la relazione tra gli insiemi A e B, con la loro intersezione A ∩ B evidenziata. Immagine dell'autore.
L'area di questa regione di sovrapposizione, rispetto all'intero spazio campionario, ci dà P(A∩B) — la probabilità congiunta che vogliamo calcolare.
Per calcolare la probabilità congiunta servono approcci diversi a seconda che gli eventi siano indipendenti o dipendenti. Vediamo entrambi gli scenari ed esploriamo le regole che governano questi calcoli.
Quando due eventi sono indipendenti, calcolare la loro probabilità congiunta è semplice. Poiché nessuno dei due influisce sull'altro, basta moltiplicare le loro probabilità individuali:
P(A∩B) = P(A) × P(B)
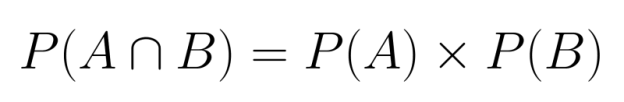
Questa regola di moltiplicazione vale perché l'indipendenza implica che sapere che un evento è avvenuto non fornisce informazioni sulla probabilità dell'altro evento.
Esempio: Considera il lancio di due monete eque. La probabilità di ottenere testa sulla prima moneta è 1/2, e la probabilità di ottenere testa sulla seconda moneta è anch'essa 1/2. Poiché questi eventi sono indipendenti (il primo lancio non influisce sul secondo), la probabilità di ottenere testa su entrambe le monete è:

Questo significa che c'è il 25% di probabilità di ottenere due teste di seguito.
Quando gli eventi sono dipendenti, dobbiamo considerare come il primo evento influenza la probabilità del secondo. Serve quindi usare la probabilità condizionata nel calcolo:
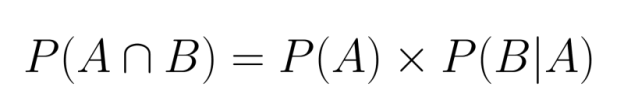
Qui, P(B|A) rappresenta la probabilità che l'evento B si verifichi dato che l'evento A si è già verificato.
Esempio: Immagina di pescare due carte da un mazzo standard senza reinserimento. Qual è la probabilità di pescare due assi?
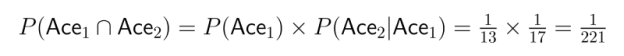
Questo illustra come la dipendenza influisca in modo significativo sul calcolo della probabilità congiunta.
I calcoli sopra dimostrano la regola di moltiplicazione della probabilità. Questa regola si estende a più di due eventi, permettendo di calcolare probabilità congiunte per eventi multipli usando una catena di probabilità condizionate:
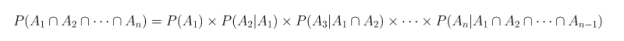
Questa è nota come chain rule, che fornisce un modo sistematico per scomporre probabilità congiunte complesse in parti gestibili.
Esempio: Considera la probabilità di pescare tre cuori di seguito da un mazzo standard senza reinserimento:
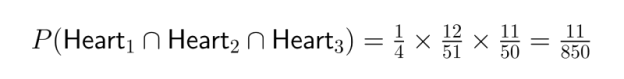
La chain rule diventa particolarmente utile in data science quando si modellano sequenze di eventi o processi a più stadi.
Per consolidare la comprensione della probabilità congiunta, svolgiamo alcuni esempi classici ed esploriamo applicazioni pratiche che mostrano come questi concetti operano in contesti diversi.
Immagina di lanciare due dadi a sei facce. Qual è la probabilità di ottenere un 4 sul primo dado e un 6 sul secondo?
Poiché l'esito del primo dado non influisce sul secondo, questi eventi sono indipendenti:
Questo ci dice che c'è circa il 2,78% di probabilità che si verifichi questa combinazione specifica.
Calcoliamo la probabilità di estrarre una carta rossa seguita da un Asso da un mazzo standard da 52 carte senza reinserimento.
Poiché si estrae senza reinserimento, questi eventi sono dipendenti:
Per gestire correttamente il calcolo, dobbiamo considerare entrambi gli scenari:
Quindi, la probabilità congiunta totale è: P(Carta rossa ∩ Asso alla seconda estrazione) = 24/663 + 1/442 = (24×2 + 3)/1326 = 51/1326 = 1/26
La probabilità è circa il 3,85%.
Considera un sacchetto con 5 biglie blu e 3 verdi. Calcoliamo la probabilità di estrarre due biglie blu in due scenari diversi.
Con reinserimento:
Senza reinserimento:
Questo confronto evidenzia come la dipendenza creata dal non reinserire le biglie riduca la probabilità congiunta.
La probabilità congiunta è fondamentale in ambito medico quando si valutano più sintomi o risultati di test. Considera uno scenario diagnostico in cui i medici devono valutare i pazienti con sintomi A e B per una specifica condizione.
In base ai dati storici:
Questa probabilità congiunta aiuta i medici a valutare la probabilità delle diverse condizioni. Vale la pena notare che P(A ∩ B) non è uguale a P(A) × P(B) = 0,30 × 0,25 = 0,075, il che indica che questi sintomi non sono indipendenti — sapere che un paziente ha un sintomo aumenta la probabilità che abbia anche l'altro.
Gli analisti d'investimento spesso devono valutare la probabilità congiunta che si verifichino insieme più condizioni di mercato. Considera un analista che valuta il rischio sia di un calo del mercato azionario sia dell'aumento dei tassi d'interesse nel prossimo trimestre.
Se i loro modelli suggeriscono:
Il calcolo della probabilità congiunta sarebbe: P(Calo del mercato azionario ∩ Aumento dei tassi) = 0,60 × 0,45 = 0,27
Questa probabilità del 27% aiuta a quantificare il rischio di portafoglio e guida le strategie di copertura per proteggersi da questo scenario.
Questi esempi mostrano come la probabilità congiunta sia uno strumento potente per quantificare l'incertezza in campi diversi, sia che si analizzino semplici giochi di sorte sia che si prendano decisioni complesse in medicina e finanza.
Le probabilità congiunta e condizionata sono concetti strettamente intrecciati che permettono di analizzare scenari complessi con più eventi. Comprendere la loro relazione fornisce strumenti potenti per il ragionamento probabilistico.
La relazione tra probabilità congiunta e condizionata è espressa dalla formula:
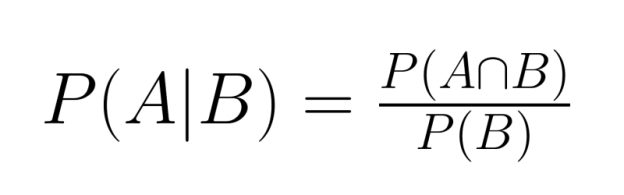
Riorganizzando questa equazione, possiamo esprimere la probabilità congiunta in termini di probabilità condizionata:
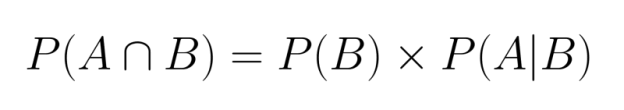
Questa relazione mostra che possiamo calcolare la probabilità congiunta se conosciamo la probabilità marginale di un evento e la probabilità condizionata dell'altro dato il primo.
Analogamente, possiamo anche scrivere:
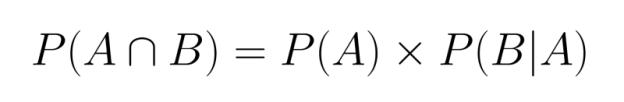
Entrambe le formulazioni sono valide ed equivalenti, a dimostrazione della natura simmetrica della probabilità congiunta.
La relazione tra probabilità congiunta e condizionata è centrale nel teorema di Bayes, uno strumento fondamentale nell'inferenza probabilistica:
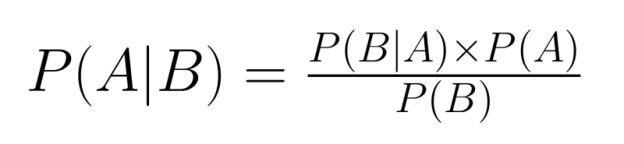
Il teorema di Bayes ci permette di "invertire" le probabilità condizionate — se conosciamo P(B|A), possiamo calcolare P(A|B). Questo è prezioso quando abbiamo informazioni su una relazione condizionata ma dobbiamo ragionare sull'inversa.
Per esempio, i test medici spesso forniscono informazioni su P(Test positivo|Malattia), ma i medici devono determinare P(Malattia|Test positivo). Il teorema di Bayes colma questo divario incorporando la probabilità congiunta:
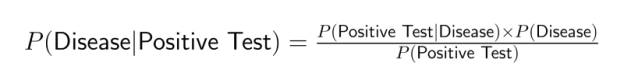
La probabilità congiunta è alla base di numerose tecniche e applicazioni di data science. Capire come interagiscono più eventi aiuta i data scientist a costruire modelli più accurati e a fare previsioni migliori in vari domini.
La probabilità congiunta è fondamentale per molti algoritmi di classificazione, in particolare i classificatori Naive Bayes. Questi popolari modelli di machine learning calcolano la probabilità di diversi esiti sulla base della presenza di più feature.
L'approccio Naive Bayes applica il teorema di Bayes con l'assunzione "ingenua" che le feature siano condizionalmente indipendenti. Questo semplifica i calcoli di probabilità congiunta:

Nonostante questa assunzione semplificativa, i classificatori Naive Bayes funzionano sorprendentemente bene per:
Questo approccio è computazionalmente efficiente e spesso performa bene anche quando l'assunzione di indipendenza non vale strettamente.
La probabilità congiunta gioca un ruolo cruciale nei sistemi di rilevamento delle frodi, dove occorre valutare insieme molteplici fattori di rischio. I moderni algoritmi di rilevamento analizzano combinazioni di comportamenti sospetti per identificare transazioni potenzialmente fraudolente.
Considera un sistema di pagamento online che monitora vari segnali:
Sebbene ciascun segnale da solo possa non indicare frode, specifiche combinazioni (la loro occorrenza congiunta) possono aumentare notevolmente il sospetto. Per esempio, una transazione elevata, da un nuovo dispositivo, in un paese estero, in un orario insolito rappresenta un evento congiunto con potenziale alta probabilità di frode.
Questa valutazione della probabilità congiunta consente un punteggio di rischio più sofisticato rispetto a valutare ciascun fattore isolatamente, riducendo sia i falsi positivi sia i falsi negativi.
I concetti di probabilità congiunta sono centrali in molti modelli avanzati di machine learning, tra cui:
Reti Bayesiane: questi modelli grafici rappresentano variabili e le loro relazioni probabilistiche. Consentono di ragionare su distribuzioni di probabilità congiunte complesse scomponendole in probabilità condizionate più semplici. Le reti bayesiane sono ampiamente usate in:
Hidden Markov Models (HMM): questi modelli sequenziali usano probabilità congiunte per modellare sistemi in cui lo stato sottostante è nascosto ma produce output osservabili. Applicazioni includono:
Modelli grafici probabilistici: comprendono una classe più ampia di modelli che usano strutture a grafo per codificare distribuzioni di probabilità congiunte complesse. Sono strumenti essenziali per:
Attraverso queste applicazioni, la probabilità congiunta consente ai data scientist di costruire modelli che catturano le complesse interdipendenze nei dati reali, portando a previsioni più accurate e decisioni migliori sotto incertezza.
Nonostante la sua utilità, la probabilità congiunta è spesso fraintesa o applicata in modo improprio. Vediamo alcuni errori comuni e come evitarli.
Uno degli errori più frequenti è confondere P(A∩B) con P(A|B). Pur essendo correlate, rappresentano concetti diversi:
Per esempio, la probabilità che una persona abbia sia il diabete sia più di 65 anni (congiunta) è diversa dalla probabilità che una persona abbia il diabete dato che ha più di 65 anni (condizionata).
Questa distinzione è importante in molti contesti analitici. Per esempio, quando un data scientist riporta che "il 5% degli utenti ha sia cliccato su un annuncio sia effettuato un acquisto", questa è una probabilità congiunta molto diversa da "il 40% degli utenti che ha cliccato su un annuncio ha effettuato un acquisto", che è una probabilità condizionata.
Un altro errore comune è assumere automaticamente che P(A∩B) = P(A) × P(B) senza verificare che gli eventi siano davvero indipendenti. Questa assunzione può portare a errori significativi quando gli eventi sono in realtà dipendenti.
Per esempio, nell'analisi di mercato, assumere l'indipendenza tra l'acquisto del prodotto A e quello del prodotto B può portare a una pianificazione dell'inventario errata se questi prodotti sono complementari (come stampanti e inchiostro) o sostituti (come marchi diversi dello stesso articolo).
Verificare l'indipendenza è cruciale — se P(A∩B) ≠ P(A) × P(B), gli eventi sono dipendenti e servono calcoli più accurati della probabilità congiunta.
Quando si lavora con probabilità congiunte, a volte ci si concentra esclusivamente sull'intersezione ignorando la frequenza complessiva dei singoli eventi. Questo può portare a conclusioni fuorvianti sulla forza delle relazioni.
Per esempio, scoprire che il 90% dei clienti che ha acquistato i prodotti A e B ha acquistato anche il prodotto C può sembrare impressionante. Tuttavia, se l'89% di tutti i clienti acquista C a prescindere, la relazione apparente è molto più debole di quanto sembri inizialmente.
Confronta sempre le probabilità congiunte con le probabilità marginali rilevanti per evitare di sovrastimare le relazioni tra eventi. Il lift — il rapporto tra la probabilità congiunta e il prodotto delle probabilità marginali — offre una misura più accurata dell'associazione:
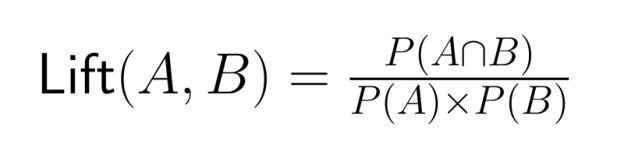
Un valore di lift maggiore di 1 indica che gli eventi si verificano insieme più spesso di quanto ci si aspetterebbe se fossero indipendenti.
Comprendere queste insidie comuni aiuta i data scientist ad applicare correttamente la probabilità congiunta e a trarre insight significativi dall'analisi probabilistica.
Con l'avanzare della carriera, i data scientist incontreranno applicazioni più sofisticate della probabilità congiunta. Esploriamo alcuni concetti avanzati che si basano sulle fondamenta viste finora.
Nei problemi moderni di machine learning, i data scientist lavorano spesso con decine o centinaia di variabili contemporaneamente. In questi spazi ad alta dimensionalità, calcolare e rappresentare le probabilità congiunte diventa impegnativo.
Il numero di parametri necessari per specificare una distribuzione congiunta cresce esponenzialmente con il numero di variabili — un fenomeno noto come "maledizione della dimensionalità". Per esempio, una distribuzione congiunta di 10 variabili binarie richiede 2¹⁰ - 1 = 1.023 parametri per essere completamente specificata.
Per gestire questa complessità, i data scientist impiegano tecniche come:
Questi approcci rendono gestibili i calcoli di probabilità congiunta ad alta dimensionalità per applicazioni pratiche in ambiti come computer vision, genomica ed elaborazione del linguaggio naturale.
Finora abbiamo trattato soprattutto eventi discreti, ma la probabilità congiunta si estende naturalmente alle variabili continue tramite le distribuzioni di probabilità congiunta.
Per variabili discrete, usiamo le funzioni di massa di probabilità congiunta (PMF), che specificano la probabilità che ogni combinazione di variabili aleatorie assuma valori specifici:
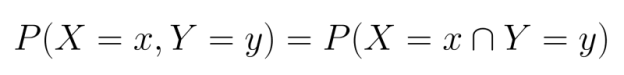
Per variabili continue, usiamo le funzioni di densità di probabilità congiunta (PDF). A differenza delle PMF, le PDF non forniscono direttamente probabilità ma vanno integrate su regioni per trovare la probabilità che le variabili cadano in tali regioni:
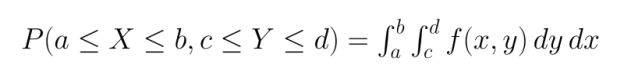
Distribuzioni congiunte comuni includono:
Comprendere queste distribuzioni consente una modellazione più sofisticata delle relazioni tra variabili continue in campi come economia, bioinformatica e scienze ambientali.
Diversi software e linguaggi di programmazione offrono funzioni e librerie per lavorare con le probabilità congiunte:
Python:
NumPy e SciPy forniscono funzioni per distribuzioni di probabilità multivariate
Pandas offre potenti strumenti per calcoli empirici di probabilità congiunta
Librerie come PyMC3 e PyStan implementano la modellazione bayesiana con distribuzioni congiunte
R:
R base include molte funzioni per distribuzioni multivariate
Pacchetti come copula permettono di modellare strutture di dipendenza complesse
bnlearn supporta l'analisi di reti bayesiane
SQL:
GROUP BY con funzioni COUNT può calcolare probabilità congiunte empiriche
Le window function abilitano analisi probabilistiche più complesse
I database moderni supportano funzioni statistiche per calcoli di probabilità
Questi strumenti rendono pratico applicare i concetti di probabilità congiunta a grandi dataset, permettendo ai data scientist di costruire modelli probabilistici sofisticati per problemi complessi.
Per approfondire la probabilità congiunta e le sue applicazioni nell'analisi bayesiana, DataCamp offre diversi ottimi corsi:
Questi corsi ti aiuteranno a sviluppare i concetti trattati in questo articolo e ad applicare tecniche di probabilità congiunta per risolvere problemi reali di data science.
Come abbiamo visto in questo articolo, la probabilità congiunta è un concetto statistico fondamentale con applicazioni vastissime in numerosi ambiti della data science. Le risorse di DataCamp, come quelle condivise in 40+ Python Statistics for Data Science Resources, offrono ottimi percorsi per rafforzare la tua comprensione. Questa raccolta completa include consigli specifici per imparare la teoria della probabilità, il pensiero bayesiano e altri concetti statistici che si basano sulla probabilità congiunta.
Per chi si sta preparando a ruoli in data science, la nostra guida Top 35 Statistics Interview Questions and Answers offre un'utile pratica con domande sulla probabilità congiunta insieme ad altri concetti statistici importanti. Ti segnalo anche il nostro corso Probability Puzzles in R, che è un'opzione divertente.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



