जब कोई मौसम विश्लेषक एक भीषण तूफ़ान की भविष्यवाणी करता है, तो वह केवल भारी बारिश या तेज़ हवाओं का अलग-अलग पूर्वानुमान नहीं करता – वह इस संभावना का आकलन करता है कि दोनों मौसम स्थितियाँ एक साथ घटित होंगी। यह परिदृश्य संयुक्त प्रायिकता को दर्शाता है – दो घटनाओं के एक साथ होने की संभावना।
इस लेख में, हम समझेंगे कि संयुक्त प्रायिकता कैसे काम करती है, आश्रित और स्वतंत्र घटनाओं के लिए सूत्रों की जाँच करेंगे, व्यावहारिक उदाहरणों पर कार्य करेंगे, और देखेंगे कि डेटा साइंस और मशीन लर्निंग में इस अवधारणा को कैसे लागू किया जाता है। बुनियादी प्रायिकता परिभाषाओं और नियमों के एक सुविधाजनक संदर्भ के लिए, DataCamp की Introduction to Probability Rules Cheat Sheet देखें।
संयुक्त प्रायिकता क्या है?
संयुक्त प्रायिकता का अर्थ है दो (या अधिक) घटनाओं के एक ही समय पर घटित होने की संभावना। गणितीय रूप से, हम इसे P(A∩B) से निरूपित करते हैं, जिसे "A इंटरसेक्शन B की प्रायिकता" या सरल रूप से "A और B की प्रायिकता" पढ़ा जाता है।
संयुक्त प्रायिकता को समझने के लिए, पहले कुछ संदर्भ स्थापित करना आवश्यक है:
- नमूना स्थान (Sample space): किसी प्रयोग में सभी संभावित परिणामों का समुच्चय।
- घटना (Event): नमूना स्थान से परिणामों का एक उपसमुच्चय।
- सीमांत प्रायिकता (Marginal probability): किसी एकल घटना के होने की संभावना, अन्य घटनाओं की परवाह किए बिना।
- शर्तीय प्रायिकता (Conditional probability): किसी घटना के होने की संभावना, यह जानते हुए कि कोई अन्य घटना पहले ही हो चुकी है।
स्वतंत्र और आश्रित घटनाओं के बीच संयुक्त प्रायिकता में उल्लेखनीय अंतर होता है:
- स्वतंत्र घटनाएँ: ऐसी घटनाएँ जिनमें एक के घटित होने से दूसरी की संभावना पर कोई प्रभाव नहीं पड़ता। उदाहरण के लिए, दो सिक्के उछालना — पहली उछाल का परिणाम दूसरी उछाल को प्रभावित नहीं करता।
- आश्रित घटनाएँ: ऐसी घटनाएँ जिनमें एक के घटित होने से दूसरी की संभावना प्रभावित होती है। उदाहरण के लिए, बिना प्रतिस्थापन के पत्ते निकालना — एक पत्ता हटाने से शेष डेक की संरचना बदल जाती है।
हम संयुक्त प्रायिकता को वेन आरेख का उपयोग करके देख सकते हैं, जहाँ ओवरलैपिंग क्षेत्र घटनाओं के प्रतिच्छेद का प्रतिनिधित्व करता है — वे स्थितियाँ जहाँ दोनों घटनाएँ एक साथ घटित होती हैं:
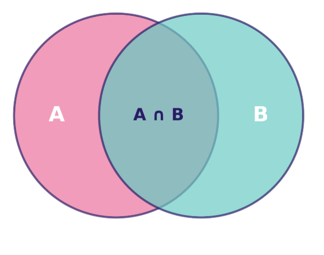
सेट A और B के बीच संबंध दर्शाने वाला वेन आरेख, जिसमें उनका प्रतिच्छेद A ∩ B हाइलाइट किया गया है। छवि: लेखक द्वारा।
इस ओवरलैपिंग क्षेत्र का क्षेत्रफल, कुल नमूना स्थान के सापेक्ष, हमें P(A∩B) देता है — वह संयुक्त प्रायिकता जिसे हमें गणना करनी है।
संयुक्त प्रायिकता का सूत्र और प्रमुख गुण
संयुक्त प्रायिकता की गणना इस पर निर्भर करती है कि घटनाएँ स्वतंत्र हैं या आश्रित, और इसके अनुसार अलग-अलग दृष्टिकोण अपनाने पड़ते हैं। आइए दोनों परिस्थितियों की जाँच करें और उन नियमों को समझें जो इन गणनाओं को संचालित करते हैं।
स्वतंत्र घटनाओं के लिए संयुक्त प्रायिकता
जब दो घटनाएँ स्वतंत्र हों, तो उनकी संयुक्त प्रायिकता की गणना सीधी हो जाती है। चूँकि कोई भी घटना दूसरी को प्रभावित नहीं करती, हम उनकी व्यक्तिगत प्रायिकताओं को बस गुणा कर सकते हैं:
P(A∩B) = P(A) × P(B)
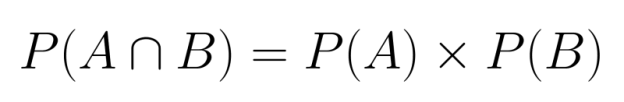
यह गुणन नियम इसलिए लागू होता है क्योंकि स्वतंत्रता का अर्थ है कि किसी एक घटना का घटित होना दूसरी घटना की संभावना के बारे में कोई जानकारी नहीं देता।
उदाहरण: दो निष्पक्ष सिक्के उछालने पर विचार करें। पहले सिक्के पर चित्त आने की प्रायिकता 1/2 है, और दूसरे सिक्के पर चित्त आने की प्रायिकता भी 1/2 है। चूँकि ये घटनाएँ स्वतंत्र हैं (पहली उछाल दूसरी को प्रभावित नहीं करती), दोनों पर चित्त आने की प्रायिकता होगी:

अर्थात लगातार दो चित्त आने की 25% संभावना है।
आश्रित घटनाओं के लिए संयुक्त प्रायिकता
जब घटनाएँ आश्रित हों, तो हमें यह ध्यान में रखना पड़ता है कि पहली घटना दूसरी की प्रायिकता को कैसे प्रभावित करती है। इसके लिए गणना में शर्तीय प्रायिकता का उपयोग करना पड़ता है:
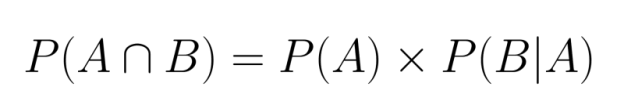
यहाँ, P(B|A) का अर्थ है घटना B के होने की प्रायिकता, यह जानते हुए कि घटना A पहले ही घटित हो चुकी है।
उदाहरण: मान लें कि बिना प्रतिस्थापन के एक मानक डेक से दो पत्ते निकाले जाते हैं। दो इक्के निकालने की प्रायिकता क्या है?
- पहले ड्रॉ में इक्का आने की प्रायिकता P(Ace₁) = 4/52 = 1/13
- एक इक्का निकल जाने के बाद 51 कार्डों में 3 इक्के बचते हैं, अतः P(Ace₂|Ace₁) = 3/51 = 1/17
- अतः:
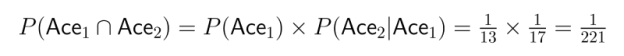
यह दर्शाता है कि आश्रय (dependence) संयुक्त प्रायिकता की गणना को कितनी महत्वपूर्ण रूप से प्रभावित करता है।
गुणन नियम और श्रृंखला नियम (Chain rule)
उपरोक्त गणनाएँ प्रायिकता के गुणन नियम को दर्शाती हैं। यह नियम दो से अधिक घटनाओं तक विस्तृत होता है, जिससे हम अनेक घटनाओं की संयुक्त प्रायिकता को शर्तीय प्रायिकताओं की श्रृंखला के माध्यम से निकाल सकते हैं:
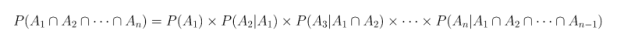
इसे श्रृंखला नियम कहा जाता है, जो जटिल संयुक्त प्रायिकताओं को छोटे, प्रबंधनीय भागों में विभाजित करने का एक व्यवस्थित तरीका देता है।
उदाहरण: बिना प्रतिस्थापन के एक मानक डेक से लगातार तीन दिल (hearts) निकालने की प्रायिकता पर विचार करें:
- P(Heart₁) = 13/52 = 1/4
- P(Heart₂|Heart₁) = 12/51
- P(Heart₃|Heart₁ ∩ Heart₂) = 11/50
- P(Heart₁ ∩ Heart₂ ∩ Heart₃) = 1/4 × 12/51 × 11/50 = 11/850
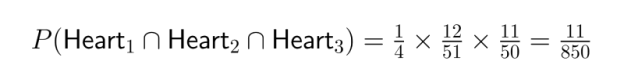
श्रृंखला नियम डेटा साइंस में विशेष रूप से मूल्यवान हो जाता है जब हम घटनाओं के अनुक्रमों को मॉडल करते हैं या बहु-चरण प्रक्रियाओं पर कार्य करते हैं।
संयुक्त प्रायिकता को समझाने वाले उदाहरण
हमारी समझ को पुख्ता करने के लिए, आइए कुछ शास्त्रीय उदाहरणों और व्यावहारिक उपयोगों पर कार्य करें जो दिखाते हैं कि विभिन्न संदर्भों में ये अवधारणाएँ कैसे काम करती हैं।
शास्त्रीय उदाहरण
पासा फेंकना
मान लें कि दो छः-पक्षीय पासे फेंके जाते हैं। पहले पासे पर 4 और दूसरे पासे पर 6 आने की प्रायिकता क्या है?
चूँकि पहले पासे का परिणाम दूसरे पासे को प्रभावित नहीं करता, ये घटनाएँ स्वतंत्र हैं:
- P(पहला पासा = 4) = 1/6
- P(दूसरा पासा = 6) = 1/6
- P(पहला पासा = 4 ∩ दूसरा पासा = 6) = 1/6 × 1/6 = 1/36
यह बताता है कि इस विशेष संयोजन के होने की लगभग 2.78% संभावना है।
पत्ते निकालना
आइए एक मानक 52-पत्तों के डेक से बिना प्रतिस्थापन के पहले एक लाल पत्ता और फिर एक इक्का निकालने की प्रायिकता निकालें।
क्योंकि हम प्रतिस्थापन के बिना निकाल रहे हैं, ये घटनाएँ आश्रित हैं:
- P(पहले ड्रॉ में लाल पत्ता) = 26/52 = 1/2
- P(दूसरे ड्रॉ में इक्का | पहले ड्रॉ में लाल पत्ता) = 3/51 यदि पहला पत्ता लाल इक्का था, अन्यथा 4/51 यदि पहला पत्ता इक्का नहीं था
इसे सही ढंग से संभालने के लिए, हमें दोनों परिदृश्यों पर विचार करना होगा:
- P(लाल गैर-इक्का फिर इक्का) = P(लाल गैर-इक्का) × P(इक्का | लाल गैर-इक्का) = 24/52 × 4/51 = 24/663
- P(लाल इक्का फिर एक और इक्का) = P(लाल इक्का) × P(इक्का | लाल इक्का) = 2/52 × 3/51 = 1/442
अतः कुल संयुक्त प्रायिकता होगी: P(लाल पत्ता ∩ दूसरे ड्रॉ में इक्का) = 24/663 + 1/442 = (24×2 + 3)/1326 = 51/1326 = 1/26
यह प्रायिकता लगभग 3.85% है।
कंचे वाली थैली
एक थैली में 5 नीले और 3 हरे कंचे हैं। आइए दो नीले कंचे निकालने की प्रायिकता दो अलग-अलग परिदृश्यों में निकालें।
प्रतिस्थापन के साथ:
- P(पहले ड्रॉ में नीला) = 5/8
- P(दूसरे ड्रॉ में नीला) = 5/8 (अपरिवर्तित क्योंकि पहला कंचा वापस रख दिया जाता है)
- P(नीला ∩ नीला) = 5/8 × 5/8 = 25/64 ≈ 39.06%
बिना प्रतिस्थापन के:
- P(पहले ड्रॉ में नीला) = 5/8
- P(दूसरे ड्रॉ में नीला | पहले ड्रॉ में नीला) = 4/7
- P(नीला ∩ नीला) = 5/8 × 4/7 = 20/56 = 5/14 ≈ 35.71%
यह तुलना रेखांकित करती है कि कंचों को वापस न रखने से बनने वाली निर्भरता संयुक्त प्रायिकता को कैसे कम कर देती है।
वास्तविक दुनिया के उपयोग
चिकित्सीय निदान
कई लक्षणों या परीक्षण-परिणामों का आकलन करते समय चिकित्सा संदर्भों में संयुक्त प्रायिकता अत्यंत महत्वपूर्ण होती है। एक निदानात्मक परिदृश्य पर विचार करें जहाँ चिकित्सकों को लक्षण A और B वाले रोगियों का एक विशेष स्थिति के लिए आकलन करना है।
ऐतिहासिक डेटा के आधार पर:
- P(लक्षण A) = 0.30 (जनसंख्या का 30% लक्षण A दिखाता है)
- P(लक्षण B) = 0.25 (जनसंख्या का 25% लक्षण B दिखाता है)
- P(लक्षण A ∩ लक्षण B) = 0.12 (12% दोनों लक्षण दिखाते हैं)
यह संयुक्त प्रायिकता चिकित्सकों को विभिन्न स्थितियों की संभावना का आकलन करने में मदद करती है। उल्लेखनीय है कि P(A ∩ B) P(A) × P(B) = 0.30 × 0.25 = 0.075 के बराबर नहीं है, जो दर्शाता है कि ये लक्षण स्वतंत्र नहीं हैं — यदि किसी रोगी में एक लक्षण है, तो दूसरे के होने की संभावना बढ़ जाती है।
वित्तीय जोखिम मॉडलिंग
निवेश विश्लेषकों को अक्सर एक साथ कई बाज़ार स्थितियों के होने की संयुक्त प्रायिकता का मूल्यांकन करना पड़ता है। मान लें कि एक विश्लेषक अगले तिमाही में स्टॉक मार्केट में गिरावट और ब्याज दरों में वृद्धि दोनों के जोखिम का आकलन कर रहा है।
यदि उनके मॉडल बताते हैं:
- P(स्टॉक मार्केट में गिरावट) = 0.35
- P(ब्याज दरों में वृद्धि) = 0.60
- P(ब्याज दरों में वृद्धि के संदर्भ में स्टॉक मार्केट में गिरावट) = 0.45
तो संयुक्त प्रायिकता की गणना होगी: P(स्टॉक मार्केट में गिरावट ∩ ब्याज दरों में वृद्धि) = 0.60 × 0.45 = 0.27
यह 27% प्रायिकता पोर्टफोलियो जोखिम को मात्राबद्ध करने में मदद करती है और इस परिदृश्य से बचाव के लिए हेजिंग रणनीतियों का मार्गदर्शन करती है।
ये उदाहरण दर्शाते हैं कि संयुक्त प्रायिकता विभिन्न क्षेत्रों में अनिश्चितता को मात्राबद्ध करने के लिए एक शक्तिशाली उपकरण के रूप में कैसे काम करती है, चाहे वह सरल संयोग खेलों का विश्लेषण हो या चिकित्सा और वित्त में जटिल निर्णय लेना।
संयुक्त प्रायिकता और शर्तीय प्रायिकता
संयुक्त और शर्तीय प्रायिकताएँ घनिष्ठ रूप से जुड़ी अवधारणाएँ हैं जो हमें कई घटनाओं से संबंधित जटिल परिदृश्यों का विश्लेषण करने देती हैं। इनके संबंध को समझना प्रायिक तर्क के लिए शक्तिशाली उपकरण प्रदान करता है।
मूलभूत संबंध
संयुक्त और शर्तीय प्रायिकता के बीच संबंध इस सूत्र से व्यक्त होता है:
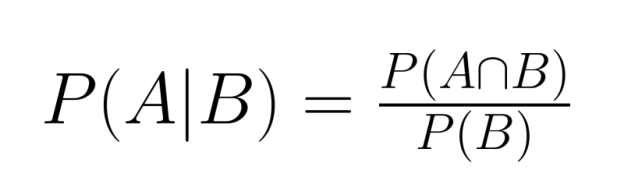
इस समीकरण को पुनर्व्यवस्थित करके, हम संयुक्त प्रायिकता को शर्तीय प्रायिकता के रूप में व्यक्त कर सकते हैं:
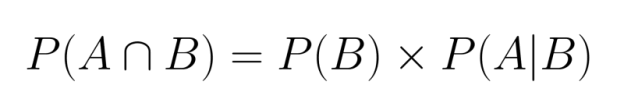
यह संबंध दिखाता है कि यदि हमें किसी एक घटना की सीमांत प्रायिकता और दूसरी की, पहली के संदर्भ में, शर्तीय प्रायिकता ज्ञात हो, तो हम संयुक्त प्रायिकता की गणना कर सकते हैं।
इसी प्रकार, हम यह भी लिख सकते हैं:
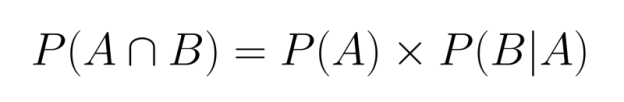
दोनों रूप मान्य और समतुल्य हैं, जो संयुक्त प्रायिकता की सममित प्रकृति को दर्शाते हैं।
बेयज़ प्रमेय से संबंध
संयुक्त और शर्तीय प्रायिकता के बीच संबंध बेयज़ प्रमेय के केंद्र में है, जो प्रायिक अनुमान का एक बुनियादी उपकरण है:
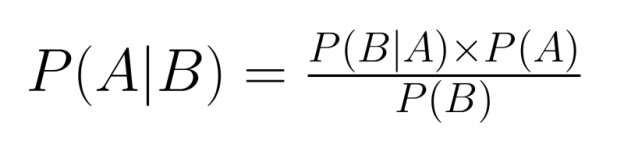
बेयज़ प्रमेय हमें शर्तीय प्रायिकताओं को "उलटने" देता है — यदि हमें P(B|A) ज्ञात है, तो हम P(A|B) निकाल सकते हैं। यह तब अत्यंत उपयोगी होता है जब हमारे पास एक दिशा में शर्तीय संबंध की जानकारी हो, लेकिन हमें विपरीत दिशा में तर्क करना हो।
उदाहरण के लिए, चिकित्सीय परीक्षण अक्सर P(सकारात्मक परीक्षण|रोग) की जानकारी देते हैं, लेकिन चिकित्सकों को P(रोग|सकारात्मक परीक्षण) निर्धारित करना होता है। बेयज़ प्रमेय संयुक्त प्रायिकता को शामिल करके इस अंतर को पाटता है:
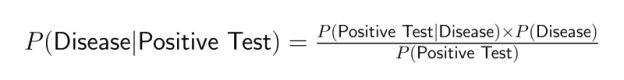
डेटा साइंस में उपयोग
संयुक्त प्रायिकता अनेक डेटा साइंस तकनीकों और अनुप्रयोगों की नींव बनाती है। यह समझना कि कई घटनाएँ एक-दूसरे के साथ कैसे अंतःक्रिया करती हैं, डेटा वैज्ञानिकों को अधिक सटीक मॉडल बनाने और विभिन्न क्षेत्रों में बेहतर पूर्वानुमान करने में मदद करता है।
पूर्वानुमानित मॉडलिंग
संयुक्त प्रायिकता कई वर्गीकरण एल्गोरिद्मों, विशेषकर Naive Bayes वर्गीकारकों, के लिए मौलिक है। ये लोकप्रिय मशीन लर्निंग मॉडल कई विशेषताओं की उपस्थिति के आधार पर विभिन्न परिणामों की प्रायिकता की गणना करते हैं।
Naive Bayes दृष्टिकोण बेयज़ प्रमेय को एक "साधारण" मान्यतानुसार लागू करता है कि विशेषताएँ शर्तीय रूप से स्वतंत्र हैं। यह संयुक्त प्रायिकता की गणनाओं को सरल बनाता है:

यह सरल मान्यता होने के बावजूद, Naive Bayes वर्गीकारक निम्न कार्यों में उल्लेखनीय रूप से अच्छा काम करते हैं:
- पाठ वर्गीकरण और स्पैम फ़िल्टरिंग
- भाव विश्लेषण
- चिकित्सीय निदान
- ग्राहक वर्गीकरण
यह दृष्टिकोण संगणना की दृष्टि से कुशल है और तब भी अक्सर आश्चर्यजनक रूप से अच्छा प्रदर्शन करता है जब स्वतंत्रता की मान्यता कड़ाई से लागू नहीं होती।
जोखिम आकलन
संयुक्त प्रायिकता धोखाधड़ी पहचान प्रणालियों में महत्वपूर्ण भूमिका निभाती है, जहाँ कई जोखिम कारकों का एक साथ मूल्यांकन करना पड़ता है। आधुनिक धोखाधड़ी पहचान एल्गोरिद्म संदिग्ध व्यवहारों के संयोजनों का विश्लेषण करते हैं ताकि संभावित धोखाधड़ी लेन-देन की पहचान की जा सके।
एक ऑनलाइन भुगतान प्रणाली पर विचार करें जो विभिन्न संकेतों की निगरानी करती है:
- लेन-देन की राशि
- भौगोलिक स्थान
- लेन-देन का समय
- डिवाइस जानकारी
- उपयोगकर्ता व्यवहार पैटर्न
जहाँ प्रत्येक संकेत अकेले धोखाधड़ी का संकेत नहीं दे सकता, वहीं विशिष्ट संयोजन (उनकी संयुक्त उपस्थिति) संदेह को काफी बढ़ा सकते हैं। उदाहरण के लिए, एक बड़ा लेन-देन, नए डिवाइस से, विदेशी देश से, असामान्य समय पर — यह एक संयुक्त घटना है जिसकी संभावित धोखाधड़ी प्रायिकता अधिक हो सकती है।
यह संयुक्त प्रायिकता आकलन, प्रत्येक कारक को अलग-थलग आंकी जाने की तुलना में, अधिक परिष्कृत जोखिम स्कोरिंग सक्षम करता है, जिससे फॉल्स पॉज़िटिव और फॉल्स नेगेटिव दोनों कम होते हैं।
मशीन लर्निंग
संयुक्त प्रायिकता की अवधारणाएँ कई उन्नत मशीन लर्निंग मॉडलों के केंद्र में हैं, जिनमें शामिल हैं:
बेयज़ियन नेटवर्क: ये ग्राफ़िकल मॉडल चर और उनके प्रायिक संबंधों का प्रतिनिधित्व करते हैं। वे जटिल संयुक्त प्रायिकता वितरणों के बारे में तर्क करना संभव बनाते हैं, उन्हें सरल शर्तीय प्रायिकताओं में विभाजित करके। बेयज़ियन नेटवर्क व्यापक रूप से उपयोग होते हैं:
- चिकित्सीय निदान प्रणालियाँ
- आनुवंशिक विश्लेषण
- निर्णय सहयोग प्रणालियाँ
- कार्य-कारण मॉडलिंग
हिडन मार्कोव मॉडल (HMMs): ये अनुक्रमिक मॉडल उन प्रणालियों का मॉडल बनाने के लिए संयुक्त प्रायिकताओं का उपयोग करते हैं जहाँ अंतर्निहित अवस्था छिपी होती है, लेकिन प्रेक्षणीय आउटपुट उत्पन्न करती है। उपयोग के मामले शामिल हैं:
- वाक् पहचान
- प्राकृतिक भाषा संसाधन
- जैविक अनुक्रम विश्लेषण
- वित्तीय समय-श्रृंखला मॉडलिंग
प्रायिक ग्राफ़िकल मॉडल: ये मॉडलों का एक व्यापक वर्ग है जो जटिल संयुक्त प्रायिकता वितरणों को एन्कोड करने के लिए ग्राफ़ संरचनाओं का उपयोग करता है। ये निम्नलिखित के लिए आवश्यक उपकरण हैं:
- छवि पहचान
- सिफारिश प्रणालियाँ
- असामान्यता पहचान
- रीइन्फोर्समेंट लर्निंग
इन अनुप्रयोगों के माध्यम से, संयुक्त प्रायिकता डेटा वैज्ञानिकों को ऐसे मॉडल बनाने में सक्षम बनाती है जो वास्तविक दुनिया के डेटा में मौजूद जटिल परस्पर निर्भरताओं को पकड़ते हैं, जिससे अधिक सटीक पूर्वानुमान और अनिश्चितता के तहत बेहतर निर्णय संभव होते हैं।
लोग संयुक्त प्रायिकता को कैसे गलत समझते हैं
इसके उपयोगी होने के बावजूद, संयुक्त प्रायिकता को अक्सर गलत समझा या गलत लागू किया जाता है। आइए कुछ आम गलतफहमियों और उनसे बचने के तरीकों पर नज़र डालें।
संयुक्त प्रायिकता को शर्तीय प्रायिकता समझ लेना
सबसे आम गलतियों में से एक है P(A∩B) को P(A|B) समझ लेना। यद्यपि ये संबंधित हैं, ये भिन्न अवधारणाओं का प्रतिनिधित्व करते हैं:
- संयुक्त प्रायिकता P(A∩B) यह प्रश्न उत्तर देती है: "A और B दोनों के घटित होने की प्रायिकता क्या है?"
- शर्तीय प्रायिकता P(A|B) यह प्रश्न उत्तर देती है: "जब B हो चुका है, तो A के होने की प्रायिकता क्या है?"
उदाहरण के लिए, किसी व्यक्ति में मधुमेह होना और 65 वर्ष से अधिक आयु का होना (संयुक्त) की प्रायिकता, उस प्रायिकता से अलग है जो बताती है कि कोई व्यक्ति 65 से अधिक है तो उसमें मधुमेह होने की संभावना (शर्तीय) क्या है।
यह भेद कई विश्लेषणात्मक संदर्भों में मायने रखता है। उदाहरण के लिए, जब कोई डेटा वैज्ञानिक रिपोर्ट करता है कि "5% उपयोगकर्ताओं ने दोनों, विज्ञापन पर क्लिक किया और खरीदारी की," तो यह संयुक्त प्रायिकता "विज्ञापन पर क्लिक करने वाले 40% उपयोगकर्ताओं ने खरीदारी की" (जो कि शर्तीय प्रायिकता है) से बहुत अलग है।
गलत तरीके से स्वतंत्रता मान लेना
एक और आम त्रुटि यह मान लेना है कि P(A∩B) = P(A) × P(B) बिना यह सत्यापित किए कि घटनाएँ वास्तव में स्वतंत्र हैं। जब घटनाएँ आश्रित हों, तो यह मान्यता महत्वपूर्ण त्रुटियों की ओर ले जा सकती है।
उदाहरण के लिए, बाज़ार विश्लेषण में, यदि उत्पाद A और उत्पाद B की खरीद को स्वतंत्र मान लिया जाए, तो यह गलत इन्वेंटरी योजना की ओर ले जा सकता है, यदि ये उत्पाद पूरक (जैसे प्रिंटर और इंक) हों या प्रतिस्थापनीय (जैसे एक ही वस्तु के अलग ब्रांड)।
स्वतंत्रता की जाँच महत्वपूर्ण है — यदि P(A∩B) ≠ P(A) × P(B), तो घटनाएँ आश्रित हैं और अधिक सावधानीपूर्वक संयुक्त प्रायिकता गणनाओं की आवश्यकता है।
सीमांत प्रायिकताओं की अनदेखी करना
संयुक्त प्रायिकताओं के साथ काम करते समय, विश्लेषक कभी-कभी केवल प्रतिच्छेद पर ध्यान केंद्रित करते हैं और व्यक्तिगत घटनाओं की समग्र आवृत्ति की अनदेखी करते हैं। इससे संबंधों की शक्ति के बारे में भ्रामक निष्कर्ष निकल सकते हैं।
उदाहरण के लिए, यह पता लगाना कि A और B उत्पाद खरीदने वाले 90% ग्राहकों ने उत्पाद C भी खरीदा, प्रभावशाली लग सकता है। हालाँकि, यदि किसी भी हालत में 89% सभी ग्राहक उत्पाद C खरीदते हैं, तो प्रकट संबंध प्रारंभिक रूप से दिखने जितना मजबूत नहीं है।
हमेशा संयुक्त प्रायिकताओं की तुलना संबंधित सीमांत प्रायिकताओं से करें ताकि घटनाओं के बीच संबंधों को बढ़ा-चढ़ा कर बताने से बचा जा सके। लिफ्ट अनुपात — संयुक्त प्रायिकता और सीमांत प्रायिकताओं के गुणनफल के अनुपात — संबंध का अधिक सटीक माप देता है:
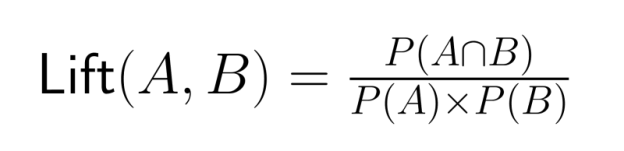
लिफ्ट का मान 1 से अधिक होने पर संकेत मिलता है कि घटनाएँ स्वतंत्र होने पर अपेक्षित से अधिक बार साथ घटित होती हैं।
इन सामान्य गलतियों को समझना डेटा वैज्ञानिकों को संयुक्त प्रायिकता का सही उपयोग करने और प्रायिक विश्लेषण से सार्थक अंतर्दृष्टि प्राप्त करने में मदद करता है।
उन्नत विषय और आगे के विचार
जैसे-जैसे डेटा वैज्ञानिक अपने करियर में आगे बढ़ते हैं, वे संयुक्त प्रायिकता के अधिक परिष्कृत अनुप्रयोगों का सामना करेंगे। आइए कुछ उन्नत अवधारणाओं का अन्वेषण करें जो हमने स्थापित नींव पर आधारित हैं।
उच्च-आयामी स्थानों में संयुक्त प्रायिकता
आधुनिक मशीन लर्निंग समस्याओं में, डेटा वैज्ञानिक अक्सर एक साथ दर्जनों या सैकड़ों चर के साथ काम करते हैं। इन उच्च-आयामी स्थानों में, संयुक्त प्रायिकताओं की गणना और अभिव्यक्ति चुनौतीपूर्ण हो जाती है।
संयुक्त वितरण को निर्दिष्ट करने के लिए आवश्यक मानकों की संख्या, चरों की संख्या के साथ घातीय रूप से बढ़ती है — जिसे "आयामीयता का अभिशाप" कहा जाता है। उदाहरण के लिए, 10 द्विआधारी चरों के संयुक्त वितरण को पूर्णतः निर्दिष्ट करने के लिए 2¹⁰ - 1 = 1,023 मानकों की आवश्यकता होती है।
इस जटिलता को प्रबंधित करने के लिए, डेटा वैज्ञानिक निम्नलिखित तकनीकों का उपयोग करते हैं:
- आयाम में कमी (Dimensionality reduction)
- चर चयन (Variable selection)
- शर्तीय स्वतंत्रता मान्यताएँ
- फैक्टरकृत निरूपण (जैसे बेयज़ियन नेटवर्क)
ये दृष्टिकोण कंप्यूटर विज़न, जीनोमिक्स, और प्राकृतिक भाषा संसाधन जैसे क्षेत्रों में व्यावहारिक अनुप्रयोगों के लिए उच्च-आयामी संयुक्त प्रायिकता गणनाओं को सुगम बनाते हैं।
संयुक्त प्रायिकता वितरण
अब तक के हमारे उदाहरण मुख्यतः असतत घटनाओं से जुड़े रहे हैं, लेकिन संयुक्त प्रायिकता निरंतर चरों तक संयुक्त प्रायिकता वितरणों के माध्यम से स्वाभाविक रूप से विस्तृत होती है।
असतत चरों के लिए, हम संयुक्त प्रायिकता द्रव्यमान फलन (PMFs) के साथ काम करते हैं, जो यह निर्दिष्ट करते हैं कि यादृच्छिक चरों के प्रत्येक संयोजन के विशिष्ट मान लेने की प्रायिकता क्या है:
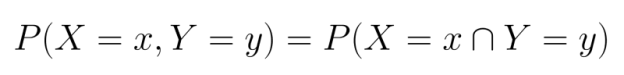
निरंतर चरों के लिए, हम संयुक्त प्रायिकता घनत्व फलन (PDFs) का उपयोग करते हैं। PMFs के विपरीत, PDFs सीधे प्रायिकता नहीं देतीं, बल्कि यह जानने के लिए क्षेत्रों पर समाकलन करना पड़ता है कि चर उन क्षेत्रों के भीतर आते हैं या नहीं:
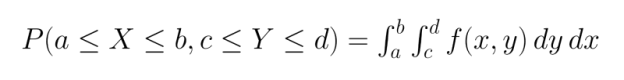
सामान्य संयुक्त वितरणों में शामिल हैं:
- बहुचर सामान्य वितरण (Multivariate normal)
- बहुचर t-वितरण
- डिरिख्ले वितरण
- मल्टिनोमियल वितरण
इन वितरणों की समझ अर्थशास्त्र, बायोइन्फॉर्मेटिक्स, और पर्यावरण विज्ञान जैसे क्षेत्रों में निरंतर चरों के बीच संबंधों के अधिक परिष्कृत मॉडलिंग को सक्षम बनाती है।
संयुक्त प्रायिकता की गणना के व्यावहारिक उपकरण
कई सॉफ़्टवेयर उपकरण और प्रोग्रामिंग भाषाएँ संयुक्त प्रायिकताओं के साथ काम करने के लिए फ़ंक्शनों और लाइब्रेरीज़ की पेशकश करती हैं:
Python:
-
NumPy और SciPy बहुचर प्रायिकता वितरणों के लिए फ़ंक्शन प्रदान करते हैं
-
Pandas प्रायोगिक संयुक्त प्रायिकता गणनाओं के लिए शक्तिशाली उपकरण प्रदान करता है
-
PyMC3 और PyStan जैसी लाइब्रेरीज़ संयुक्त वितरणों के साथ बेयज़ियन मॉडलिंग को लागू करती हैं
R:
-
Base R में कई बहुचर वितरण फ़ंक्शन शामिल हैं
-
copula जैसे पैकेज जटिल आश्रय संरचनाओं का मॉडलिंग सक्षम करते हैं
-
bnlearn बेयज़ियन नेटवर्क विश्लेषण का समर्थन करता है
SQL:
-
GROUP BY क्लॉज़ और COUNT फ़ंक्शंस का उपयोग करके प्रायोगिक संयुक्त प्रायिकताएँ निकाली जा सकती हैं
-
विंडो फ़ंक्शंस अधिक जटिल प्रायिक विश्लेषण सक्षम करते हैं
-
आधुनिक डेटाबेस प्रायिकता गणनाओं के लिए सांख्यिकीय फ़ंक्शंस का समर्थन करते हैं
ये उपकरण बड़े डेटासेट्स पर संयुक्त प्रायिकता अवधारणाएँ लागू करना व्यावहारिक बनाते हैं, जिससे डेटा वैज्ञानिक जटिल समस्याओं के लिए परिष्कृत प्रायिक मॉडल बना पाते हैं।
संयुक्त प्रायिकता और उसके बेयज़ियन विश्लेषण में अनुप्रयोगों की समझ को गहरा करने के लिए, DataCamp कई उत्कृष्ट पाठ्यक्रम प्रदान करता है:
ये पाठ्यक्रम आपको इस लेख में शामिल अवधारणाओं पर आगे निर्माण करने और संयुक्त प्रायिकता तकनीकों को वास्तविक दुनिया की डेटा साइंस समस्याओं को हल करने में लागू करने में मदद करेंगे।
निष्कर्ष
जैसा कि हमने इस पूरे लेख में देखा, संयुक्त प्रायिकता एक मौलिक सांख्यिकीय अवधारणा है, जिसके डेटा साइंस के अनेक क्षेत्रों में व्यापक अनुप्रयोग हैं। DataCamp के संसाधन, जैसे कि 40+ Python Statistics for Data Science Resources, आपकी समझ को मजबूत करने के उत्कृष्ट मार्ग प्रदान करते हैं। इस व्यापक संग्रह में प्रायिकता सिद्धांत, बेयज़ियन सोच, और अन्य सांख्यिकीय अवधारणाएँ सीखने के लिए विशिष्ट सिफारिशें शामिल हैं, जो संयुक्त प्रायिकता पर आधारित हैं।
जो लोग डेटा साइंस भूमिकाओं की तैयारी कर रहे हैं, उनके लिए हमारा Top 35 Statistics Interview Questions and Answers मार्गदर्शक संयुक्त प्रायिकता प्रश्नों के साथ अन्य महत्वपूर्ण सांख्यिकीय अवधारणाओं पर मूल्यवान अभ्यास प्रदान करता है। मुझे यह भी लगता है कि हमारा Probability Puzzles in R पाठ्यक्रम एक मज़ेदार विकल्प है।


जब कोई मौसम विश्लेषक एक भीषण तूफ़ान की भविष्यवाणी करता है, तो वह केवल भारी बारिश या तेज़ हवाओं का अलग-अलग पूर्वानुमान नहीं करता – वह इस संभावना का आकलन करता है कि दोनों मौसम स्थितियाँ एक साथ घटित होंगी। यह परिदृश्य संयुक्त प्रायिकता को दर्शाता है – दो घटनाओं के एक साथ होने की संभावना।
इस लेख में, हम समझेंगे कि संयुक्त प्रायिकता कैसे काम करती है, आश्रित और स्वतंत्र घटनाओं के लिए सूत्रों की जाँच करेंगे, व्यावहारिक उदाहरणों पर कार्य करेंगे, और देखेंगे कि डेटा साइंस और मशीन लर्निंग में इस अवधारणा को कैसे लागू किया जाता है। बुनियादी प्रायिकता परिभाषाओं और नियमों के एक सुविधाजनक संदर्भ के लिए, DataCamp की Introduction to Probability Rules Cheat Sheet देखें।
संयुक्त प्रायिकता क्या है?
संयुक्त प्रायिकता का अर्थ है दो (या अधिक) घटनाओं के एक ही समय पर घटित होने की संभावना। गणितीय रूप से, हम इसे P(A∩B) से निरूपित करते हैं, जिसे "A इंटरसेक्शन B की प्रायिकता" या सरल रूप से "A और B की प्रायिकता" पढ़ा जाता है।
संयुक्त प्रायिकता को समझने के लिए, पहले कुछ संदर्भ स्थापित करना आवश्यक है:
स्वतंत्र और आश्रित घटनाओं के बीच संयुक्त प्रायिकता में उल्लेखनीय अंतर होता है:
हम संयुक्त प्रायिकता को वेन आरेख का उपयोग करके देख सकते हैं, जहाँ ओवरलैपिंग क्षेत्र घटनाओं के प्रतिच्छेद का प्रतिनिधित्व करता है — वे स्थितियाँ जहाँ दोनों घटनाएँ एक साथ घटित होती हैं:
सेट A और B के बीच संबंध दर्शाने वाला वेन आरेख, जिसमें उनका प्रतिच्छेद A ∩ B हाइलाइट किया गया है। छवि: लेखक द्वारा।
इस ओवरलैपिंग क्षेत्र का क्षेत्रफल, कुल नमूना स्थान के सापेक्ष, हमें P(A∩B) देता है — वह संयुक्त प्रायिकता जिसे हमें गणना करनी है।
संयुक्त प्रायिकता का सूत्र और प्रमुख गुण
संयुक्त प्रायिकता की गणना इस पर निर्भर करती है कि घटनाएँ स्वतंत्र हैं या आश्रित, और इसके अनुसार अलग-अलग दृष्टिकोण अपनाने पड़ते हैं। आइए दोनों परिस्थितियों की जाँच करें और उन नियमों को समझें जो इन गणनाओं को संचालित करते हैं।
स्वतंत्र घटनाओं के लिए संयुक्त प्रायिकता
जब दो घटनाएँ स्वतंत्र हों, तो उनकी संयुक्त प्रायिकता की गणना सीधी हो जाती है। चूँकि कोई भी घटना दूसरी को प्रभावित नहीं करती, हम उनकी व्यक्तिगत प्रायिकताओं को बस गुणा कर सकते हैं:
P(A∩B) = P(A) × P(B)
यह गुणन नियम इसलिए लागू होता है क्योंकि स्वतंत्रता का अर्थ है कि किसी एक घटना का घटित होना दूसरी घटना की संभावना के बारे में कोई जानकारी नहीं देता।
उदाहरण: दो निष्पक्ष सिक्के उछालने पर विचार करें। पहले सिक्के पर चित्त आने की प्रायिकता 1/2 है, और दूसरे सिक्के पर चित्त आने की प्रायिकता भी 1/2 है। चूँकि ये घटनाएँ स्वतंत्र हैं (पहली उछाल दूसरी को प्रभावित नहीं करती), दोनों पर चित्त आने की प्रायिकता होगी:
अर्थात लगातार दो चित्त आने की 25% संभावना है।
आश्रित घटनाओं के लिए संयुक्त प्रायिकता
जब घटनाएँ आश्रित हों, तो हमें यह ध्यान में रखना पड़ता है कि पहली घटना दूसरी की प्रायिकता को कैसे प्रभावित करती है। इसके लिए गणना में शर्तीय प्रायिकता का उपयोग करना पड़ता है:
यहाँ, P(B|A) का अर्थ है घटना B के होने की प्रायिकता, यह जानते हुए कि घटना A पहले ही घटित हो चुकी है।
उदाहरण: मान लें कि बिना प्रतिस्थापन के एक मानक डेक से दो पत्ते निकाले जाते हैं। दो इक्के निकालने की प्रायिकता क्या है?
यह दर्शाता है कि आश्रय (dependence) संयुक्त प्रायिकता की गणना को कितनी महत्वपूर्ण रूप से प्रभावित करता है।
गुणन नियम और श्रृंखला नियम (Chain rule)
उपरोक्त गणनाएँ प्रायिकता के गुणन नियम को दर्शाती हैं। यह नियम दो से अधिक घटनाओं तक विस्तृत होता है, जिससे हम अनेक घटनाओं की संयुक्त प्रायिकता को शर्तीय प्रायिकताओं की श्रृंखला के माध्यम से निकाल सकते हैं:
इसे श्रृंखला नियम कहा जाता है, जो जटिल संयुक्त प्रायिकताओं को छोटे, प्रबंधनीय भागों में विभाजित करने का एक व्यवस्थित तरीका देता है।
उदाहरण: बिना प्रतिस्थापन के एक मानक डेक से लगातार तीन दिल (hearts) निकालने की प्रायिकता पर विचार करें:
श्रृंखला नियम डेटा साइंस में विशेष रूप से मूल्यवान हो जाता है जब हम घटनाओं के अनुक्रमों को मॉडल करते हैं या बहु-चरण प्रक्रियाओं पर कार्य करते हैं।
संयुक्त प्रायिकता को समझाने वाले उदाहरण
हमारी समझ को पुख्ता करने के लिए, आइए कुछ शास्त्रीय उदाहरणों और व्यावहारिक उपयोगों पर कार्य करें जो दिखाते हैं कि विभिन्न संदर्भों में ये अवधारणाएँ कैसे काम करती हैं।
शास्त्रीय उदाहरण
पासा फेंकना
मान लें कि दो छः-पक्षीय पासे फेंके जाते हैं। पहले पासे पर 4 और दूसरे पासे पर 6 आने की प्रायिकता क्या है?
चूँकि पहले पासे का परिणाम दूसरे पासे को प्रभावित नहीं करता, ये घटनाएँ स्वतंत्र हैं:
यह बताता है कि इस विशेष संयोजन के होने की लगभग 2.78% संभावना है।
पत्ते निकालना
आइए एक मानक 52-पत्तों के डेक से बिना प्रतिस्थापन के पहले एक लाल पत्ता और फिर एक इक्का निकालने की प्रायिकता निकालें।
क्योंकि हम प्रतिस्थापन के बिना निकाल रहे हैं, ये घटनाएँ आश्रित हैं:
इसे सही ढंग से संभालने के लिए, हमें दोनों परिदृश्यों पर विचार करना होगा:
अतः कुल संयुक्त प्रायिकता होगी: P(लाल पत्ता ∩ दूसरे ड्रॉ में इक्का) = 24/663 + 1/442 = (24×2 + 3)/1326 = 51/1326 = 1/26
यह प्रायिकता लगभग 3.85% है।
कंचे वाली थैली
एक थैली में 5 नीले और 3 हरे कंचे हैं। आइए दो नीले कंचे निकालने की प्रायिकता दो अलग-अलग परिदृश्यों में निकालें।
प्रतिस्थापन के साथ:
बिना प्रतिस्थापन के:
यह तुलना रेखांकित करती है कि कंचों को वापस न रखने से बनने वाली निर्भरता संयुक्त प्रायिकता को कैसे कम कर देती है।
वास्तविक दुनिया के उपयोग
चिकित्सीय निदान
कई लक्षणों या परीक्षण-परिणामों का आकलन करते समय चिकित्सा संदर्भों में संयुक्त प्रायिकता अत्यंत महत्वपूर्ण होती है। एक निदानात्मक परिदृश्य पर विचार करें जहाँ चिकित्सकों को लक्षण A और B वाले रोगियों का एक विशेष स्थिति के लिए आकलन करना है।
ऐतिहासिक डेटा के आधार पर:
यह संयुक्त प्रायिकता चिकित्सकों को विभिन्न स्थितियों की संभावना का आकलन करने में मदद करती है। उल्लेखनीय है कि P(A ∩ B) P(A) × P(B) = 0.30 × 0.25 = 0.075 के बराबर नहीं है, जो दर्शाता है कि ये लक्षण स्वतंत्र नहीं हैं — यदि किसी रोगी में एक लक्षण है, तो दूसरे के होने की संभावना बढ़ जाती है।
वित्तीय जोखिम मॉडलिंग
निवेश विश्लेषकों को अक्सर एक साथ कई बाज़ार स्थितियों के होने की संयुक्त प्रायिकता का मूल्यांकन करना पड़ता है। मान लें कि एक विश्लेषक अगले तिमाही में स्टॉक मार्केट में गिरावट और ब्याज दरों में वृद्धि दोनों के जोखिम का आकलन कर रहा है।
यदि उनके मॉडल बताते हैं:
तो संयुक्त प्रायिकता की गणना होगी: P(स्टॉक मार्केट में गिरावट ∩ ब्याज दरों में वृद्धि) = 0.60 × 0.45 = 0.27
यह 27% प्रायिकता पोर्टफोलियो जोखिम को मात्राबद्ध करने में मदद करती है और इस परिदृश्य से बचाव के लिए हेजिंग रणनीतियों का मार्गदर्शन करती है।
ये उदाहरण दर्शाते हैं कि संयुक्त प्रायिकता विभिन्न क्षेत्रों में अनिश्चितता को मात्राबद्ध करने के लिए एक शक्तिशाली उपकरण के रूप में कैसे काम करती है, चाहे वह सरल संयोग खेलों का विश्लेषण हो या चिकित्सा और वित्त में जटिल निर्णय लेना।
संयुक्त प्रायिकता और शर्तीय प्रायिकता
संयुक्त और शर्तीय प्रायिकताएँ घनिष्ठ रूप से जुड़ी अवधारणाएँ हैं जो हमें कई घटनाओं से संबंधित जटिल परिदृश्यों का विश्लेषण करने देती हैं। इनके संबंध को समझना प्रायिक तर्क के लिए शक्तिशाली उपकरण प्रदान करता है।
मूलभूत संबंध
संयुक्त और शर्तीय प्रायिकता के बीच संबंध इस सूत्र से व्यक्त होता है:
इस समीकरण को पुनर्व्यवस्थित करके, हम संयुक्त प्रायिकता को शर्तीय प्रायिकता के रूप में व्यक्त कर सकते हैं:
यह संबंध दिखाता है कि यदि हमें किसी एक घटना की सीमांत प्रायिकता और दूसरी की, पहली के संदर्भ में, शर्तीय प्रायिकता ज्ञात हो, तो हम संयुक्त प्रायिकता की गणना कर सकते हैं।
इसी प्रकार, हम यह भी लिख सकते हैं:
दोनों रूप मान्य और समतुल्य हैं, जो संयुक्त प्रायिकता की सममित प्रकृति को दर्शाते हैं।
बेयज़ प्रमेय से संबंध
संयुक्त और शर्तीय प्रायिकता के बीच संबंध बेयज़ प्रमेय के केंद्र में है, जो प्रायिक अनुमान का एक बुनियादी उपकरण है:
बेयज़ प्रमेय हमें शर्तीय प्रायिकताओं को "उलटने" देता है — यदि हमें P(B|A) ज्ञात है, तो हम P(A|B) निकाल सकते हैं। यह तब अत्यंत उपयोगी होता है जब हमारे पास एक दिशा में शर्तीय संबंध की जानकारी हो, लेकिन हमें विपरीत दिशा में तर्क करना हो।
उदाहरण के लिए, चिकित्सीय परीक्षण अक्सर P(सकारात्मक परीक्षण|रोग) की जानकारी देते हैं, लेकिन चिकित्सकों को P(रोग|सकारात्मक परीक्षण) निर्धारित करना होता है। बेयज़ प्रमेय संयुक्त प्रायिकता को शामिल करके इस अंतर को पाटता है:
डेटा साइंस में उपयोग
संयुक्त प्रायिकता अनेक डेटा साइंस तकनीकों और अनुप्रयोगों की नींव बनाती है। यह समझना कि कई घटनाएँ एक-दूसरे के साथ कैसे अंतःक्रिया करती हैं, डेटा वैज्ञानिकों को अधिक सटीक मॉडल बनाने और विभिन्न क्षेत्रों में बेहतर पूर्वानुमान करने में मदद करता है।
पूर्वानुमानित मॉडलिंग
संयुक्त प्रायिकता कई वर्गीकरण एल्गोरिद्मों, विशेषकर Naive Bayes वर्गीकारकों, के लिए मौलिक है। ये लोकप्रिय मशीन लर्निंग मॉडल कई विशेषताओं की उपस्थिति के आधार पर विभिन्न परिणामों की प्रायिकता की गणना करते हैं।
Naive Bayes दृष्टिकोण बेयज़ प्रमेय को एक "साधारण" मान्यतानुसार लागू करता है कि विशेषताएँ शर्तीय रूप से स्वतंत्र हैं। यह संयुक्त प्रायिकता की गणनाओं को सरल बनाता है:
यह सरल मान्यता होने के बावजूद, Naive Bayes वर्गीकारक निम्न कार्यों में उल्लेखनीय रूप से अच्छा काम करते हैं:
यह दृष्टिकोण संगणना की दृष्टि से कुशल है और तब भी अक्सर आश्चर्यजनक रूप से अच्छा प्रदर्शन करता है जब स्वतंत्रता की मान्यता कड़ाई से लागू नहीं होती।
जोखिम आकलन
संयुक्त प्रायिकता धोखाधड़ी पहचान प्रणालियों में महत्वपूर्ण भूमिका निभाती है, जहाँ कई जोखिम कारकों का एक साथ मूल्यांकन करना पड़ता है। आधुनिक धोखाधड़ी पहचान एल्गोरिद्म संदिग्ध व्यवहारों के संयोजनों का विश्लेषण करते हैं ताकि संभावित धोखाधड़ी लेन-देन की पहचान की जा सके।
एक ऑनलाइन भुगतान प्रणाली पर विचार करें जो विभिन्न संकेतों की निगरानी करती है:
जहाँ प्रत्येक संकेत अकेले धोखाधड़ी का संकेत नहीं दे सकता, वहीं विशिष्ट संयोजन (उनकी संयुक्त उपस्थिति) संदेह को काफी बढ़ा सकते हैं। उदाहरण के लिए, एक बड़ा लेन-देन, नए डिवाइस से, विदेशी देश से, असामान्य समय पर — यह एक संयुक्त घटना है जिसकी संभावित धोखाधड़ी प्रायिकता अधिक हो सकती है।
यह संयुक्त प्रायिकता आकलन, प्रत्येक कारक को अलग-थलग आंकी जाने की तुलना में, अधिक परिष्कृत जोखिम स्कोरिंग सक्षम करता है, जिससे फॉल्स पॉज़िटिव और फॉल्स नेगेटिव दोनों कम होते हैं।
मशीन लर्निंग
संयुक्त प्रायिकता की अवधारणाएँ कई उन्नत मशीन लर्निंग मॉडलों के केंद्र में हैं, जिनमें शामिल हैं:
बेयज़ियन नेटवर्क: ये ग्राफ़िकल मॉडल चर और उनके प्रायिक संबंधों का प्रतिनिधित्व करते हैं। वे जटिल संयुक्त प्रायिकता वितरणों के बारे में तर्क करना संभव बनाते हैं, उन्हें सरल शर्तीय प्रायिकताओं में विभाजित करके। बेयज़ियन नेटवर्क व्यापक रूप से उपयोग होते हैं:
हिडन मार्कोव मॉडल (HMMs): ये अनुक्रमिक मॉडल उन प्रणालियों का मॉडल बनाने के लिए संयुक्त प्रायिकताओं का उपयोग करते हैं जहाँ अंतर्निहित अवस्था छिपी होती है, लेकिन प्रेक्षणीय आउटपुट उत्पन्न करती है। उपयोग के मामले शामिल हैं:
प्रायिक ग्राफ़िकल मॉडल: ये मॉडलों का एक व्यापक वर्ग है जो जटिल संयुक्त प्रायिकता वितरणों को एन्कोड करने के लिए ग्राफ़ संरचनाओं का उपयोग करता है। ये निम्नलिखित के लिए आवश्यक उपकरण हैं:
इन अनुप्रयोगों के माध्यम से, संयुक्त प्रायिकता डेटा वैज्ञानिकों को ऐसे मॉडल बनाने में सक्षम बनाती है जो वास्तविक दुनिया के डेटा में मौजूद जटिल परस्पर निर्भरताओं को पकड़ते हैं, जिससे अधिक सटीक पूर्वानुमान और अनिश्चितता के तहत बेहतर निर्णय संभव होते हैं।
लोग संयुक्त प्रायिकता को कैसे गलत समझते हैं
इसके उपयोगी होने के बावजूद, संयुक्त प्रायिकता को अक्सर गलत समझा या गलत लागू किया जाता है। आइए कुछ आम गलतफहमियों और उनसे बचने के तरीकों पर नज़र डालें।
संयुक्त प्रायिकता को शर्तीय प्रायिकता समझ लेना
सबसे आम गलतियों में से एक है P(A∩B) को P(A|B) समझ लेना। यद्यपि ये संबंधित हैं, ये भिन्न अवधारणाओं का प्रतिनिधित्व करते हैं:
उदाहरण के लिए, किसी व्यक्ति में मधुमेह होना और 65 वर्ष से अधिक आयु का होना (संयुक्त) की प्रायिकता, उस प्रायिकता से अलग है जो बताती है कि कोई व्यक्ति 65 से अधिक है तो उसमें मधुमेह होने की संभावना (शर्तीय) क्या है।
यह भेद कई विश्लेषणात्मक संदर्भों में मायने रखता है। उदाहरण के लिए, जब कोई डेटा वैज्ञानिक रिपोर्ट करता है कि "5% उपयोगकर्ताओं ने दोनों, विज्ञापन पर क्लिक किया और खरीदारी की," तो यह संयुक्त प्रायिकता "विज्ञापन पर क्लिक करने वाले 40% उपयोगकर्ताओं ने खरीदारी की" (जो कि शर्तीय प्रायिकता है) से बहुत अलग है।
गलत तरीके से स्वतंत्रता मान लेना
एक और आम त्रुटि यह मान लेना है कि P(A∩B) = P(A) × P(B) बिना यह सत्यापित किए कि घटनाएँ वास्तव में स्वतंत्र हैं। जब घटनाएँ आश्रित हों, तो यह मान्यता महत्वपूर्ण त्रुटियों की ओर ले जा सकती है।
उदाहरण के लिए, बाज़ार विश्लेषण में, यदि उत्पाद A और उत्पाद B की खरीद को स्वतंत्र मान लिया जाए, तो यह गलत इन्वेंटरी योजना की ओर ले जा सकता है, यदि ये उत्पाद पूरक (जैसे प्रिंटर और इंक) हों या प्रतिस्थापनीय (जैसे एक ही वस्तु के अलग ब्रांड)।
स्वतंत्रता की जाँच महत्वपूर्ण है — यदि P(A∩B) ≠ P(A) × P(B), तो घटनाएँ आश्रित हैं और अधिक सावधानीपूर्वक संयुक्त प्रायिकता गणनाओं की आवश्यकता है।
सीमांत प्रायिकताओं की अनदेखी करना
संयुक्त प्रायिकताओं के साथ काम करते समय, विश्लेषक कभी-कभी केवल प्रतिच्छेद पर ध्यान केंद्रित करते हैं और व्यक्तिगत घटनाओं की समग्र आवृत्ति की अनदेखी करते हैं। इससे संबंधों की शक्ति के बारे में भ्रामक निष्कर्ष निकल सकते हैं।
उदाहरण के लिए, यह पता लगाना कि A और B उत्पाद खरीदने वाले 90% ग्राहकों ने उत्पाद C भी खरीदा, प्रभावशाली लग सकता है। हालाँकि, यदि किसी भी हालत में 89% सभी ग्राहक उत्पाद C खरीदते हैं, तो प्रकट संबंध प्रारंभिक रूप से दिखने जितना मजबूत नहीं है।
हमेशा संयुक्त प्रायिकताओं की तुलना संबंधित सीमांत प्रायिकताओं से करें ताकि घटनाओं के बीच संबंधों को बढ़ा-चढ़ा कर बताने से बचा जा सके। लिफ्ट अनुपात — संयुक्त प्रायिकता और सीमांत प्रायिकताओं के गुणनफल के अनुपात — संबंध का अधिक सटीक माप देता है:
लिफ्ट का मान 1 से अधिक होने पर संकेत मिलता है कि घटनाएँ स्वतंत्र होने पर अपेक्षित से अधिक बार साथ घटित होती हैं।
इन सामान्य गलतियों को समझना डेटा वैज्ञानिकों को संयुक्त प्रायिकता का सही उपयोग करने और प्रायिक विश्लेषण से सार्थक अंतर्दृष्टि प्राप्त करने में मदद करता है।
उन्नत विषय और आगे के विचार
जैसे-जैसे डेटा वैज्ञानिक अपने करियर में आगे बढ़ते हैं, वे संयुक्त प्रायिकता के अधिक परिष्कृत अनुप्रयोगों का सामना करेंगे। आइए कुछ उन्नत अवधारणाओं का अन्वेषण करें जो हमने स्थापित नींव पर आधारित हैं।
उच्च-आयामी स्थानों में संयुक्त प्रायिकता
आधुनिक मशीन लर्निंग समस्याओं में, डेटा वैज्ञानिक अक्सर एक साथ दर्जनों या सैकड़ों चर के साथ काम करते हैं। इन उच्च-आयामी स्थानों में, संयुक्त प्रायिकताओं की गणना और अभिव्यक्ति चुनौतीपूर्ण हो जाती है।
संयुक्त वितरण को निर्दिष्ट करने के लिए आवश्यक मानकों की संख्या, चरों की संख्या के साथ घातीय रूप से बढ़ती है — जिसे "आयामीयता का अभिशाप" कहा जाता है। उदाहरण के लिए, 10 द्विआधारी चरों के संयुक्त वितरण को पूर्णतः निर्दिष्ट करने के लिए 2¹⁰ - 1 = 1,023 मानकों की आवश्यकता होती है।
इस जटिलता को प्रबंधित करने के लिए, डेटा वैज्ञानिक निम्नलिखित तकनीकों का उपयोग करते हैं:
ये दृष्टिकोण कंप्यूटर विज़न, जीनोमिक्स, और प्राकृतिक भाषा संसाधन जैसे क्षेत्रों में व्यावहारिक अनुप्रयोगों के लिए उच्च-आयामी संयुक्त प्रायिकता गणनाओं को सुगम बनाते हैं।
संयुक्त प्रायिकता वितरण
अब तक के हमारे उदाहरण मुख्यतः असतत घटनाओं से जुड़े रहे हैं, लेकिन संयुक्त प्रायिकता निरंतर चरों तक संयुक्त प्रायिकता वितरणों के माध्यम से स्वाभाविक रूप से विस्तृत होती है।
असतत चरों के लिए, हम संयुक्त प्रायिकता द्रव्यमान फलन (PMFs) के साथ काम करते हैं, जो यह निर्दिष्ट करते हैं कि यादृच्छिक चरों के प्रत्येक संयोजन के विशिष्ट मान लेने की प्रायिकता क्या है:
निरंतर चरों के लिए, हम संयुक्त प्रायिकता घनत्व फलन (PDFs) का उपयोग करते हैं। PMFs के विपरीत, PDFs सीधे प्रायिकता नहीं देतीं, बल्कि यह जानने के लिए क्षेत्रों पर समाकलन करना पड़ता है कि चर उन क्षेत्रों के भीतर आते हैं या नहीं:
सामान्य संयुक्त वितरणों में शामिल हैं:
इन वितरणों की समझ अर्थशास्त्र, बायोइन्फॉर्मेटिक्स, और पर्यावरण विज्ञान जैसे क्षेत्रों में निरंतर चरों के बीच संबंधों के अधिक परिष्कृत मॉडलिंग को सक्षम बनाती है।
संयुक्त प्रायिकता की गणना के व्यावहारिक उपकरण
कई सॉफ़्टवेयर उपकरण और प्रोग्रामिंग भाषाएँ संयुक्त प्रायिकताओं के साथ काम करने के लिए फ़ंक्शनों और लाइब्रेरीज़ की पेशकश करती हैं:
Python:
NumPyऔरSciPyबहुचर प्रायिकता वितरणों के लिए फ़ंक्शन प्रदान करते हैंPandas प्रायोगिक संयुक्त प्रायिकता गणनाओं के लिए शक्तिशाली उपकरण प्रदान करता है
PyMC3औरPyStanजैसी लाइब्रेरीज़ संयुक्त वितरणों के साथ बेयज़ियन मॉडलिंग को लागू करती हैंR:
Base R में कई बहुचर वितरण फ़ंक्शन शामिल हैं
copulaजैसे पैकेज जटिल आश्रय संरचनाओं का मॉडलिंग सक्षम करते हैंbnlearnबेयज़ियन नेटवर्क विश्लेषण का समर्थन करता हैSQL:
GROUP BYक्लॉज़ औरCOUNTफ़ंक्शंस का उपयोग करके प्रायोगिक संयुक्त प्रायिकताएँ निकाली जा सकती हैंविंडो फ़ंक्शंस अधिक जटिल प्रायिक विश्लेषण सक्षम करते हैं
आधुनिक डेटाबेस प्रायिकता गणनाओं के लिए सांख्यिकीय फ़ंक्शंस का समर्थन करते हैं
ये उपकरण बड़े डेटासेट्स पर संयुक्त प्रायिकता अवधारणाएँ लागू करना व्यावहारिक बनाते हैं, जिससे डेटा वैज्ञानिक जटिल समस्याओं के लिए परिष्कृत प्रायिक मॉडल बना पाते हैं।
संयुक्त प्रायिकता और उसके बेयज़ियन विश्लेषण में अनुप्रयोगों की समझ को गहरा करने के लिए, DataCamp कई उत्कृष्ट पाठ्यक्रम प्रदान करता है:
ये पाठ्यक्रम आपको इस लेख में शामिल अवधारणाओं पर आगे निर्माण करने और संयुक्त प्रायिकता तकनीकों को वास्तविक दुनिया की डेटा साइंस समस्याओं को हल करने में लागू करने में मदद करेंगे।
निष्कर्ष
जैसा कि हमने इस पूरे लेख में देखा, संयुक्त प्रायिकता एक मौलिक सांख्यिकीय अवधारणा है, जिसके डेटा साइंस के अनेक क्षेत्रों में व्यापक अनुप्रयोग हैं। DataCamp के संसाधन, जैसे कि 40+ Python Statistics for Data Science Resources, आपकी समझ को मजबूत करने के उत्कृष्ट मार्ग प्रदान करते हैं। इस व्यापक संग्रह में प्रायिकता सिद्धांत, बेयज़ियन सोच, और अन्य सांख्यिकीय अवधारणाएँ सीखने के लिए विशिष्ट सिफारिशें शामिल हैं, जो संयुक्त प्रायिकता पर आधारित हैं।
जो लोग डेटा साइंस भूमिकाओं की तैयारी कर रहे हैं, उनके लिए हमारा Top 35 Statistics Interview Questions and Answers मार्गदर्शक संयुक्त प्रायिकता प्रश्नों के साथ अन्य महत्वपूर्ण सांख्यिकीय अवधारणाओं पर मूल्यवान अभ्यास प्रदान करता है। मुझे यह भी लगता है कि हमारा Probability Puzzles in R पाठ्यक्रम एक मज़ेदार विकल्प है।