Wanneer een weerman een zware storm voorspelt, gaat het niet alleen om hevige regen of harde wind los van elkaar – hij beoordeelt de kans dat beide weersomstandigheden samen optreden. Dit scenario illustreert gezamenlijke kans – de waarschijnlijkheid dat twee gebeurtenissen gelijktijdig plaatsvinden.
In dit artikel verkennen we hoe gezamenlijke kans werkt, bekijken we formules voor zowel afhankelijke als onafhankelijke gebeurtenissen, werken we praktische voorbeelden uit en zien we hoe dit concept wordt toegepast in data science en machine learning. Voor een handige referentie met basisdefinities en -regels van kansrekening, bekijk de Introduction to Probability Rules Cheat Sheet van DataCamp.
Wat is gezamenlijke kans?
Gezamenlijke kans geeft de waarschijnlijkheid weer dat twee (of meer) gebeurtenissen tegelijkertijd plaatsvinden. Wiskundig noteren we dit als P(A∩B), uitgesproken als "de kans op A doorsnede B" of simpelweg "de kans op A en B".
Om gezamenlijke kans te begrijpen, moeten we eerst wat context schetsen:
- Steekproefruimte: De verzameling van alle mogelijke uitkomsten in een experiment.
- Gebeurtenis: Een deelverzameling van uitkomsten uit de steekproefruimte.
- Marginale kans: De kans dat één enkele gebeurtenis optreedt, ongeacht andere gebeurtenissen.
- Voorwaardelijke kans: De kans op een gebeurtenis, gegeven dat een andere gebeurtenis al heeft plaatsgevonden.
Gezamenlijke kans verschilt aanzienlijk tussen onafhankelijke en afhankelijke gebeurtenissen:
- Onafhankelijke gebeurtenissen: Gebeurtenissen waarbij het optreden van de ene geen invloed heeft op de kans van de andere. Bijvoorbeeld, het opgooien van twee munten—de uitkomst van de eerste worp beïnvloedt de tweede niet.
- Afhankelijke gebeurtenissen: Gebeurtenissen waarbij het optreden van de ene de kans op de andere beïnvloedt. Bijvoorbeeld, kaarten trekken zonder terugleggen—het verwijderen van één kaart verandert de samenstelling van het resterende spel.
We kunnen gezamenlijke kans visualiseren met een Venn-diagram, waarbij het overlappende gebied de doorsnede van gebeurtenissen vertegenwoordigt—de scenario's waarin beide gebeurtenissen gelijktijdig optreden:
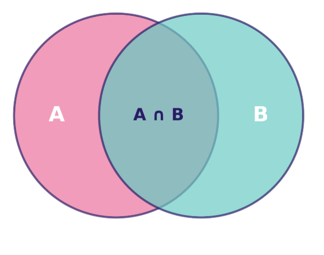
Venn-diagram dat de relatie toont tussen verzamelingen A en B, met hun doorsnede A ∩ B gemarkeerd. Afbeelding door de auteur.
De oppervlakte van dit overlappende gebied, relatief aan de totale steekproefruimte, geeft ons P(A∩B)—de gezamenlijke kans die we willen berekenen.
Het berekenen van gezamenlijke kans vereist verschillende benaderingen, afhankelijk van of gebeurtenissen onafhankelijk of afhankelijk zijn. Laten we beide scenario's bekijken en de regels verkennen die deze berekeningen bepalen.
Gezamenlijke kans voor onafhankelijke gebeurtenissen
Als twee gebeurtenissen onafhankelijk zijn, wordt het berekenen van hun gezamenlijke kans eenvoudig. Omdat geen van beide gebeurtenissen de andere beïnvloedt, kunnen we hun afzonderlijke kansen simpelweg vermenigvuldigen:
P(A∩B) = P(A) × P(B)
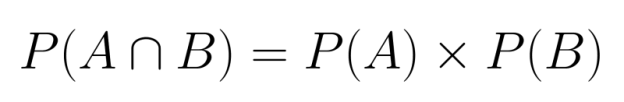
Deze vermenigvuldigingsregel geldt omdat onafhankelijkheid betekent dat weten dat de ene gebeurtenis is opgetreden geen informatie geeft over de waarschijnlijkheid van de andere gebeurtenis.
Voorbeeld: Stel dat je twee eerlijke munten opgooit. De kans op kop bij de eerste munt is 1/2, en de kans op kop bij de tweede munt is ook 1/2. Omdat deze gebeurtenissen onafhankelijk zijn (de eerste worp beïnvloedt de tweede niet), is de kans op twee keer kop:

Dit betekent dat er 25% kans is om twee keer achter elkaar kop te gooien.
Gezamenlijke kans voor afhankelijke gebeurtenissen
Als gebeurtenissen afhankelijk zijn, moeten we meenemen hoe de eerste gebeurtenis de kans op de tweede beïnvloedt. Hiervoor gebruiken we voorwaardelijke kans in onze berekening:
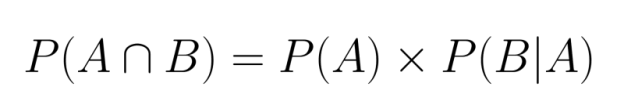
Hier stelt P(B|A) de kans voor dat gebeurtenis B optreedt, gegeven dat gebeurtenis A al heeft plaatsgevonden.
Voorbeeld: Stel je trekt twee kaarten uit een standaard spel zonder terugleggen. Wat is de kans om twee azen te trekken?
- De kans op een aas bij de eerste trek is P(Aas₁) = 4/52 = 1/13
- Na een aas te hebben getrokken, blijven er in een spel van 51 kaarten nog 3 azen over, dus P(Aas₂|Aas₁) = 3/51 = 1/17
- Daarom:
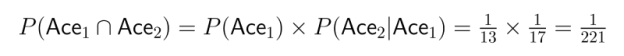
Dit laat zien hoe afhankelijkheid de berekening van gezamenlijke kans aanzienlijk beïnvloedt.
Vermenigvuldigingsregel en kettingregel
De bovenstaande berekeningen demonstreren de vermenigvuldigingsregel van kansrekening. Deze regel strekt zich uit tot meer dan twee gebeurtenissen en stelt ons in staat gezamenlijke kansen voor meerdere gebeurtenissen te berekenen met een keten van voorwaardelijke kansen:
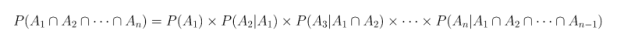
Dit staat bekend als de kettingregel, die een systematische manier biedt om complexe gezamenlijke kansen op te splitsen in hanteerbare delen.
Voorbeeld: Beschouw de kans op drie harten achter elkaar trekken uit een standaard spel zonder terugleggen:
- P(Hart₁) = 13/52 = 1/4
- P(Hart₂|Hart₁) = 12/51
- P(Hart₃|Hart₁ ∩ Hart₂) = 11/50
- P(Hart₁ ∩ Hart₂ ∩ Hart₃) = 1/4 × 12/51 × 11/50 = 11/850
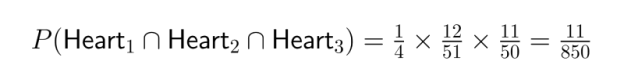
De kettingregel is in data science bijzonder waardevol bij het modelleren van sequenties van gebeurtenissen of bij meerstapsprocessen.
Voorbeelden ter illustratie van gezamenlijke kans
Om ons begrip van gezamenlijke kans te verdiepen, werken we enkele klassieke voorbeelden uit en verkennen we praktische toepassingen die laten zien hoe deze concepten in verschillende contexten werken.
Klassieke voorbeelden
Dobbelsteenworpen
Stel dat je twee zeskantige dobbelstenen gooit. Wat is de kans op een 4 met de eerste dobbelsteen en een 6 met de tweede?
Omdat de uitkomst van de eerste dobbelsteen de tweede niet beïnvloedt, zijn dit onafhankelijke gebeurtenissen:
- P(Eerste dobbelsteen = 4) = 1/6
- P(Tweede dobbelsteen = 6) = 1/6
- P(Eerste dobbelsteen = 4 ∩ Tweede dobbelsteen = 6) = 1/6 × 1/6 = 1/36
Dit vertelt ons dat er ongeveer 2,78% kans is dat deze specifieke combinatie optreedt.
Kaarten trekken
Laten we de kans berekenen om een rode kaart te trekken gevolgd door een Aas uit een standaard spel van 52 kaarten zonder terugleggen.
Omdat we zonder terugleggen trekken, zijn deze gebeurtenissen afhankelijk:
- P(Rode kaart bij eerste trek) = 26/52 = 1/2
- P(Aas bij tweede trek | Rode kaart bij eerste trek) = 3/51 als de eerste kaart een rode Aas was, of 4/51 als de eerste kaart geen Aas was
Om dit correct te behandelen, moeten we beide scenario's overwegen:
- P(Rood geen Aas dan Aas) = P(Rood geen Aas) × P(Aas | Rood geen Aas) = 24/52 × 4/51 = 24/663
- P(Rode Aas dan nog een Aas) = P(Rode Aas) × P(Aas | Rode Aas) = 2/52 × 3/51 = 1/442
Daarom is de totale gezamenlijke kans: P(Rode kaart ∩ Aas bij tweede trek) = 24/663 + 1/442 = (24×2 + 3)/1326 = 51/1326 = 1/26
De kans is ongeveer 3,85%.
Knikkers in een zak
Beschouw een zak met 5 blauwe knikkers en 3 groene knikkers. Laten we de kans berekenen om twee blauwe knikkers te trekken onder twee verschillende scenario's.
Met terugleggen:
- P(Blauw bij eerste trek) = 5/8
- P(Blauw bij tweede trek) = 5/8 (onveranderd omdat de eerste knikker wordt teruggelegd)
- P(Blauw ∩ Blauw) = 5/8 × 5/8 = 25/64 ≈ 39,06%
Zonder terugleggen:
- P(Blauw bij eerste trek) = 5/8
- P(Blauw bij tweede trek | Blauw bij eerste trek) = 4/7
- P(Blauw ∩ Blauw) = 5/8 × 4/7 = 20/56 = 5/14 ≈ 35,71%
Deze vergelijking laat zien hoe de afhankelijkheid die ontstaat door niet terug te leggen de gezamenlijke kans verlaagt.
Toepassingen in de echte wereld
Medische diagnose
Gezamenlijke kans is cruciaal in medische contexten bij het beoordelen van meerdere symptomen of testresultaten. Denk aan een diagnostische situatie waarin artsen patiënten met symptomen A en B moeten beoordelen op een specifieke aandoening.
Op basis van historische gegevens:
- P(Symptoom A) = 0,30 (30% van de populatie vertoont symptoom A)
- P(Symptoom B) = 0,25 (25% van de populatie vertoont symptoom B)
- P(Symptoom A ∩ Symptoom B) = 0,12 (12% vertonen beide symptomen)
Deze gezamenlijke kans helpt artsen de waarschijnlijkheid van verschillende aandoeningen te beoordelen. Het is vermeldenswaard dat P(A ∩ B) niet gelijk is aan P(A) × P(B) = 0,30 × 0,25 = 0,075, wat aangeeft dat deze symptomen niet onafhankelijk zijn—weten dat een patiënt het ene symptoom heeft, vergroot de kans dat hij het andere ook heeft.
Financieel risicomodel
Beleggingsanalisten moeten vaak de gezamenlijke kans beoordelen dat meerdere marktomstandigheden gelijktijdig optreden. Denk aan een analist die het risico inschat op zowel een beursdaling als stijgende rentetarieven in het komende kwartaal.
Als hun modellen suggereren:
- P(Beursdaling) = 0,35
- P(Stijgende rente) = 0,60
- P(Beursdaling | Stijgende rente) = 0,45
De gezamenlijke kansberekening is dan: P(Beursdaling ∩ Stijgende rente) = 0,60 × 0,45 = 0,27
Deze kans van 27% helpt het portefeuillerisico te kwantificeren en stuurt hedgingstrategieën aan om tegen dit scenario te beschermen.
Deze voorbeelden laten zien hoe gezamenlijke kans een krachtig hulpmiddel is om onzekerheid te kwantificeren in uiteenlopende domeinen, of je nu eenvoudige kansspelen analyseert of complexe beslissingen neemt in de geneeskunde en financiën.
Gezamenlijke kans en voorwaardelijke kans
Gezamenlijke en voorwaardelijke kansen zijn nauw verweven concepten waarmee we complexe scenario's met meerdere gebeurtenissen kunnen analyseren. Inzicht in hun relatie biedt krachtige tools voor probabilistisch redeneren.
De fundamentele relatie
De relatie tussen gezamenlijke en voorwaardelijke kans wordt uitgedrukt door de formule:
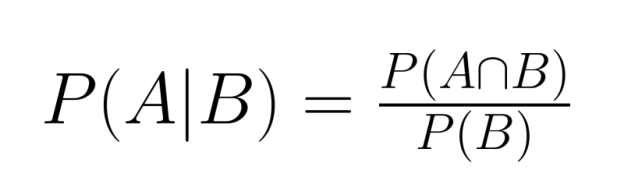
Door deze vergelijking te herschikken, kunnen we gezamenlijke kans uitdrukken in termen van voorwaardelijke kans:
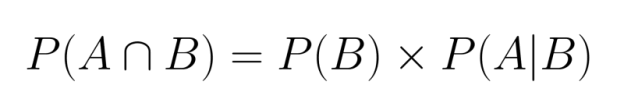
Deze relatie laat zien dat we de gezamenlijke kans kunnen berekenen als we de marginale kans van de ene gebeurtenis kennen en de voorwaardelijke kans van de andere, gegeven de eerste.
Evenzo kunnen we ook schrijven:
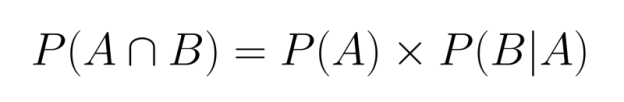
Beide formuleringen zijn geldig en equivalent, en tonen de symmetrische aard van gezamenlijke kans.
Relevantie voor de stelling van Bayes
De relatie tussen gezamenlijke en voorwaardelijke kans staat centraal in de stelling van Bayes, een fundamenteel hulpmiddel in probabilistische inferentie:
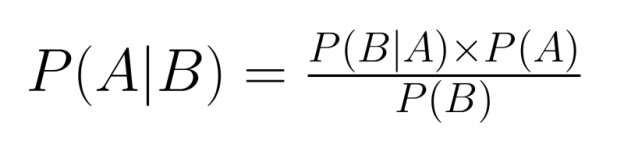
De stelling van Bayes stelt ons in staat "voorwaardelijke kansen om te keren"—als we P(B|A) kennen, kunnen we P(A|B) berekenen. Dit is van onschatbare waarde wanneer we informatie hebben over de ene voorwaardelijke relatie maar moeten redeneren over de omgekeerde relatie.
Medische tests geven bijvoorbeeld vaak informatie over P(Positieve test|Ziekte), maar artsen moeten P(Ziekte|Positieve test) bepalen. De stelling van Bayes overbrugt deze kloof door gezamenlijke kans te betrekken:
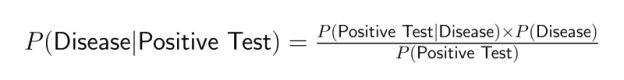
Toepassingen in data science
Gezamenlijke kans vormt de basis voor tal van technieken en toepassingen in data science. Begrijpen hoe meerdere gebeurtenissen op elkaar inwerken helpt dataspecialisten nauwkeurigere modellen te bouwen en betere voorspellingen te doen in diverse domeinen.
Predictive modeling
Gezamenlijke kans is fundamenteel voor veel classificatie-algoritmen, met name Naive Bayes-classificaties. Deze populaire machinelearningmodellen berekenen de kans op verschillende uitkomsten op basis van de aanwezigheid van meerdere features.
De Naive Bayes-aanpak past de stelling van Bayes toe met de "naïeve" aanname dat features voorwaardelijk onafhankelijk zijn. Dit vereenvoudigt de berekeningen van gezamenlijke kansen:

Ondanks deze vereenvoudigende aanname werken Naive Bayes-classificaties opvallend goed voor:
- Tekstclassificatie en spamfiltering
- Sentimentanalyse
- Medische diagnose
- Klantsegmentatie
Deze aanpak is computationeel efficiënt en presteert vaak verrassend goed, zelfs wanneer de onafhankelijkheidsaanname niet strikt geldt.
Risicobeoordeling
Gezamenlijke kans speelt een cruciale rol in fraudedetectiesystemen, waar meerdere risicofactoren samen moeten worden beoordeeld. Moderne fraudedetectiealgoritmen analyseren combinaties van verdachte gedragingen om mogelijk frauduleuze transacties te identificeren.
Beschouw een online betaalsysteem dat verschillende signalen monitort:
- Transactiebedrag
- Geografische locatie
- Tijdstip van transactie
- Apparaatgegevens
- Gebruikersgedragspatronen
Hoewel elk signaal op zich geen fraude hoeft aan te geven, kunnen specifieke combinaties (hun gezamenlijke optreden) de verdenking aanzienlijk vergroten. Een grote transactie, vanaf een nieuw apparaat, in een vreemd land, op een ongebruikelijk tijdstip is bijvoorbeeld een gezamenlijke gebeurtenis met mogelijk hoge fraudekans.
Deze beoordeling van gezamenlijke kans maakt verfijndere risicoscores mogelijk dan wanneer je elke factor afzonderlijk evalueert, wat zowel false positives als false negatives vermindert.
Machine learning
Concepten rond gezamenlijke kans staan centraal in veel geavanceerde machinelearningmodellen, waaronder:
Bayesiaanse netwerken: Deze grafische modellen representeren variabelen en hun probabilistische relaties. Ze maken redeneren over complexe gezamenlijke kansverdelingen mogelijk door ze op te splitsen in eenvoudigere voorwaardelijke kansen. Bayesiaanse netwerken worden veel gebruikt in:
- Systemen voor medische diagnose
- Genetische analyse
- Beslissingsondersteunende systemen
- Causaliteitsmodellering
Hidden Markov-modellen (HMM's): Deze sequentiële modellen gebruiken gezamenlijke kansen om systemen te modelleren waarbij de onderliggende toestand verborgen is maar waarneembare outputs produceert. Toepassingen zijn onder meer:
- Spraakherkenning
- Natural language processing
- Analyse van biologische sequenties
- Financiële tijdreeksmodellering
Probabilistische grafische modellen: Dit omvat een bredere klasse modellen die grafen gebruiken om complexe gezamenlijke kansverdelingen te coderen. Het zijn essentiële tools voor:
- Beeldherkenning
- Aanbevelingssystemen
- Anomaliedetectie
- Reinforcement learning
Via deze toepassingen kunnen dataspecialisten modellen bouwen die de complexe onderlinge afhankelijkheden in real-world data vastleggen, wat leidt tot nauwkeurigere voorspellingen en betere besluitvorming onder onzekerheid.
Hoe mensen gezamenlijke kans verkeerd interpreteren
Ondanks het nut wordt gezamenlijke kans vaak verkeerd begrepen of onjuist toegepast. Laten we een paar veelvoorkomende misvattingen bekijken en hoe je die kunt vermijden.
Gezamenlijke kans verwarren met voorwaardelijke kans
Een van de meest voorkomende fouten is P(A∩B) verwarren met P(A|B). Hoewel ze verwant zijn, vertegenwoordigen ze verschillende concepten:
- Gezamenlijke kans P(A∩B) beantwoordt: "Wat is de kans dat zowel A als B optreden?"
- Voorwaardelijke kans P(A|B) beantwoordt: "Gegeven dat B is opgetreden, wat is de kans dat A optreedt?"
Bijvoorbeeld, de kans dat iemand zowel diabetes heeft als ouder is dan 65 (gezamenlijk) is anders dan de kans dat iemand diabetes heeft gegeven dat hij ouder is dan 65 (voorwaardelijk).
Dit onderscheid is belangrijk in veel analytische contexten. Wanneer een dataspecialist bijvoorbeeld meldt dat "5% van de gebruikers zowel op een advertentie klikte als een aankoop deed", is deze gezamenlijke kans heel anders dan "40% van de gebruikers die op een advertentie klikten deed een aankoop", wat een voorwaardelijke kans is.
Onterecht onafhankelijkheid aannemen
Een andere veelgemaakte fout is automatisch aannemen dat P(A∩B) = P(A) × P(B) zonder te verifiëren dat gebeurtenissen echt onafhankelijk zijn. Deze aanname kan tot aanzienlijke fouten leiden wanneer gebeurtenissen in werkelijkheid afhankelijk zijn.
In marktanalyse kan het bijvoorbeeld fout uitpakken om onafhankelijkheid aan te nemen tussen de aankoop van product A en product B als deze producten complementair zijn (zoals printers en inkt) of substituten (zoals verschillende merken van hetzelfde artikel).
Het testen op onafhankelijkheid is cruciaal—als P(A∩B) ≠ P(A) × P(B), dan zijn de gebeurtenissen afhankelijk en zijn zorgvuldiger berekeningen van gezamenlijke kans vereist.
Marginale kansen negeren
Bij het werken met gezamenlijke kansen richten analisten zich soms uitsluitend op de doorsnede, terwijl ze de algehele frequentie van individuele gebeurtenissen negeren. Dit kan tot misleidende conclusies leiden over de sterkte van relaties.
Ontdekken dat 90% van de klanten die producten A en B kochten ook product C kochten, lijkt bijvoorbeeld indrukwekkend. Maar als 89% van alle klanten hoe dan ook product C koopt, is de schijnbare relatie veel zwakker dan aanvankelijk leek.
Vergelijk gezamenlijke kansen altijd met relevante marginale kansen om overschatting van relaties tussen gebeurtenissen te voorkomen. De lift-ratio—de verhouding van de gezamenlijke kans tot het product van marginale kansen—biedt een nauwkeurigere maat voor associatie:
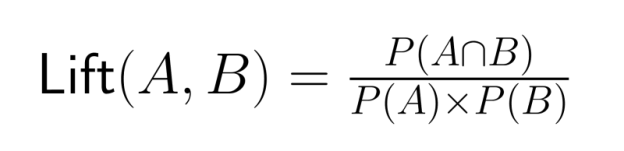
Een lift-waarde groter dan 1 geeft aan dat gebeurtenissen vaker samen voorkomen dan je zou verwachten als ze onafhankelijk waren.
Inzicht in deze veelvoorkomende valkuilen helpt dataspecialisten gezamenlijke kans correct toe te passen en betekenisvolle inzichten uit probabilistische analyses te halen.
Geavanceerde onderwerpen en verdere overwegingen
Naarmate dataspecialisten vorderen in hun carrière, komen ze meer geavanceerde toepassingen van gezamenlijke kans tegen. Laten we enkele geavanceerde concepten verkennen die voortbouwen op de fundamenten die we hebben gelegd.
Gezamenlijke kans in hoog-dimensionale ruimtes
Bij moderne machinelearningproblemen werken dataspecialisten vaak gelijktijdig met tientallen of zelfs honderden variabelen. In deze hoog-dimensionale ruimtes wordt het berekenen en representeren van gezamenlijke kansen uitdagend.
Het aantal parameters dat nodig is om een gezamenlijke verdeling te specificeren, groeit exponentieel met het aantal variabelen—een fenomeen dat bekendstaat als de "vloek van dimensionaliteit". Een gezamenlijke verdeling van 10 binaire variabelen vereist bijvoorbeeld 2¹⁰ - 1 = 1.023 parameters voor een volledige specificatie.
Om deze complexiteit beheersbaar te maken, gebruiken dataspecialisten technieken zoals:
- Dimensiereductie
- Variabelenselectie
- Aannames van voorwaardelijke onafhankelijkheid
- Gefactoriseerde representaties (zoals Bayesiaanse netwerken)
Deze benaderingen maken berekeningen van gezamenlijke kansen in hoge dimensies hanteerbaar voor praktische toepassingen in gebieden als computervisie, genomica en natural language processing.
Gezamenlijke kansverdelingen
Onze voorbeelden tot nu toe betroffen vooral discrete gebeurtenissen, maar gezamenlijke kans strekt zich op natuurlijke wijze uit naar continue variabelen via gezamenlijke kansverdelingen.
Voor discrete variabelen werken we met gezamenlijke kansmassafuncties (PMF's), die de kans specificeren dat elke combinatie van toevalsgrootheden specifieke waarden aanneemt:
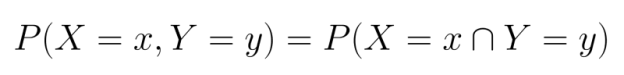
Voor continue variabelen gebruiken we gezamenlijke kansdichtheidsfuncties (PDF's). In tegenstelling tot PMF's geven PDF's niet direct kansen; je moet integreren over gebieden om de kans te vinden dat de variabelen binnen die gebieden vallen:
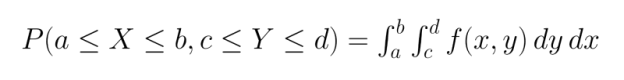
Veelvoorkomende gezamenlijke verdelingen zijn onder andere:
- Multivariate normale verdeling
- Multivariate t-verdeling
- Dirichlet-verdeling
- Multinomiale verdeling
Inzicht in deze verdelingen maakt geavanceerdere modellering van relaties tussen continue variabelen mogelijk in velden als economie, bio-informatica en milieuwetenschap.
Diverse softwaretools en programmeertalen bieden functies en bibliotheken om met gezamenlijke kansen te werken:
Python:
-
NumPy en SciPy bieden functies voor multivariate kansverdelingen
-
Pandas biedt krachtige tools voor empirische berekeningen van gezamenlijke kansen
-
Bibliotheken zoals PyMC3 en PyStan implementeren Bayesiaanse modellering met gezamenlijke verdelingen
R:
-
Base R bevat veel functies voor multivariate verdelingen
-
Pakketten zoals copula maken het mogelijk complexe afhankelijkheidsstructuren te modelleren
-
bnlearn ondersteunt analyse van Bayesiaanse netwerken
SQL:
-
GROUP BY-clausules met COUNT-functies kunnen empirische gezamenlijke kansen berekenen
-
Vensterfuncties maken complexere probabilistische analyses mogelijk
-
Moderne databases ondersteunen statistische functies voor kansberekeningen
Dankzij deze tools kun je concepten rond gezamenlijke kans in de praktijk toepassen op grote datasets en verfijnde probabilistische modellen bouwen voor complexe problemen.
Om je begrip van gezamenlijke kans en de toepassingen in Bayesiaanse analyse te verdiepen, biedt DataCamp verschillende uitstekende cursussen:
Deze cursussen helpen je voort te bouwen op de concepten in dit artikel en technieken met gezamenlijke kansen toe te passen om echte data science-problemen op te lossen.
Conclusie
Zoals we in dit artikel hebben gezien, is gezamenlijke kans een fundamenteel statistisch concept met een brede waaier aan toepassingen binnen tal van data science-velden. De bronnen van DataCamp, zoals gedeeld in de 40+ Python Statistics for Data Science Resources, bieden uitstekende routes om je begrip te versterken. Deze uitgebreide collectie bevat specifieke aanbevelingen om kansrekening, Bayesiaans denken en andere statistische concepten te leren die voortbouwen op gezamenlijke kans.
Voor wie zich voorbereidt op data science-functies, biedt onze gids Top 35 Statistics Interview Questions and Answers waardevolle oefening met vragen over gezamenlijke kans naast andere belangrijke statistische concepten. Ook onze cursus Probability Puzzles in R is wat mij betreft een leuke optie.




Wanneer een weerman een zware storm voorspelt, gaat het niet alleen om hevige regen of harde wind los van elkaar – hij beoordeelt de kans dat beide weersomstandigheden samen optreden. Dit scenario illustreert gezamenlijke kans – de waarschijnlijkheid dat twee gebeurtenissen gelijktijdig plaatsvinden.
In dit artikel verkennen we hoe gezamenlijke kans werkt, bekijken we formules voor zowel afhankelijke als onafhankelijke gebeurtenissen, werken we praktische voorbeelden uit en zien we hoe dit concept wordt toegepast in data science en machine learning. Voor een handige referentie met basisdefinities en -regels van kansrekening, bekijk de Introduction to Probability Rules Cheat Sheet van DataCamp.
Wat is gezamenlijke kans?
Gezamenlijke kans geeft de waarschijnlijkheid weer dat twee (of meer) gebeurtenissen tegelijkertijd plaatsvinden. Wiskundig noteren we dit als P(A∩B), uitgesproken als "de kans op A doorsnede B" of simpelweg "de kans op A en B".
Om gezamenlijke kans te begrijpen, moeten we eerst wat context schetsen:
Gezamenlijke kans verschilt aanzienlijk tussen onafhankelijke en afhankelijke gebeurtenissen:
We kunnen gezamenlijke kans visualiseren met een Venn-diagram, waarbij het overlappende gebied de doorsnede van gebeurtenissen vertegenwoordigt—de scenario's waarin beide gebeurtenissen gelijktijdig optreden:
Venn-diagram dat de relatie toont tussen verzamelingen A en B, met hun doorsnede A ∩ B gemarkeerd. Afbeelding door de auteur.
De oppervlakte van dit overlappende gebied, relatief aan de totale steekproefruimte, geeft ons P(A∩B)—de gezamenlijke kans die we willen berekenen.
De formule voor gezamenlijke kans en kern eigenschappen
Het berekenen van gezamenlijke kans vereist verschillende benaderingen, afhankelijk van of gebeurtenissen onafhankelijk of afhankelijk zijn. Laten we beide scenario's bekijken en de regels verkennen die deze berekeningen bepalen.
Gezamenlijke kans voor onafhankelijke gebeurtenissen
Als twee gebeurtenissen onafhankelijk zijn, wordt het berekenen van hun gezamenlijke kans eenvoudig. Omdat geen van beide gebeurtenissen de andere beïnvloedt, kunnen we hun afzonderlijke kansen simpelweg vermenigvuldigen:
P(A∩B) = P(A) × P(B)
Deze vermenigvuldigingsregel geldt omdat onafhankelijkheid betekent dat weten dat de ene gebeurtenis is opgetreden geen informatie geeft over de waarschijnlijkheid van de andere gebeurtenis.
Voorbeeld: Stel dat je twee eerlijke munten opgooit. De kans op kop bij de eerste munt is 1/2, en de kans op kop bij de tweede munt is ook 1/2. Omdat deze gebeurtenissen onafhankelijk zijn (de eerste worp beïnvloedt de tweede niet), is de kans op twee keer kop:
Dit betekent dat er 25% kans is om twee keer achter elkaar kop te gooien.
Gezamenlijke kans voor afhankelijke gebeurtenissen
Als gebeurtenissen afhankelijk zijn, moeten we meenemen hoe de eerste gebeurtenis de kans op de tweede beïnvloedt. Hiervoor gebruiken we voorwaardelijke kans in onze berekening:
Hier stelt P(B|A) de kans voor dat gebeurtenis B optreedt, gegeven dat gebeurtenis A al heeft plaatsgevonden.
Voorbeeld: Stel je trekt twee kaarten uit een standaard spel zonder terugleggen. Wat is de kans om twee azen te trekken?
Dit laat zien hoe afhankelijkheid de berekening van gezamenlijke kans aanzienlijk beïnvloedt.
Vermenigvuldigingsregel en kettingregel
De bovenstaande berekeningen demonstreren de vermenigvuldigingsregel van kansrekening. Deze regel strekt zich uit tot meer dan twee gebeurtenissen en stelt ons in staat gezamenlijke kansen voor meerdere gebeurtenissen te berekenen met een keten van voorwaardelijke kansen:
Dit staat bekend als de kettingregel, die een systematische manier biedt om complexe gezamenlijke kansen op te splitsen in hanteerbare delen.
Voorbeeld: Beschouw de kans op drie harten achter elkaar trekken uit een standaard spel zonder terugleggen:
De kettingregel is in data science bijzonder waardevol bij het modelleren van sequenties van gebeurtenissen of bij meerstapsprocessen.
Voorbeelden ter illustratie van gezamenlijke kans
Om ons begrip van gezamenlijke kans te verdiepen, werken we enkele klassieke voorbeelden uit en verkennen we praktische toepassingen die laten zien hoe deze concepten in verschillende contexten werken.
Klassieke voorbeelden
Dobbelsteenworpen
Stel dat je twee zeskantige dobbelstenen gooit. Wat is de kans op een 4 met de eerste dobbelsteen en een 6 met de tweede?
Omdat de uitkomst van de eerste dobbelsteen de tweede niet beïnvloedt, zijn dit onafhankelijke gebeurtenissen:
Dit vertelt ons dat er ongeveer 2,78% kans is dat deze specifieke combinatie optreedt.
Kaarten trekken
Laten we de kans berekenen om een rode kaart te trekken gevolgd door een Aas uit een standaard spel van 52 kaarten zonder terugleggen.
Omdat we zonder terugleggen trekken, zijn deze gebeurtenissen afhankelijk:
Om dit correct te behandelen, moeten we beide scenario's overwegen:
Daarom is de totale gezamenlijke kans: P(Rode kaart ∩ Aas bij tweede trek) = 24/663 + 1/442 = (24×2 + 3)/1326 = 51/1326 = 1/26
De kans is ongeveer 3,85%.
Knikkers in een zak
Beschouw een zak met 5 blauwe knikkers en 3 groene knikkers. Laten we de kans berekenen om twee blauwe knikkers te trekken onder twee verschillende scenario's.
Met terugleggen:
Zonder terugleggen:
Deze vergelijking laat zien hoe de afhankelijkheid die ontstaat door niet terug te leggen de gezamenlijke kans verlaagt.
Toepassingen in de echte wereld
Medische diagnose
Gezamenlijke kans is cruciaal in medische contexten bij het beoordelen van meerdere symptomen of testresultaten. Denk aan een diagnostische situatie waarin artsen patiënten met symptomen A en B moeten beoordelen op een specifieke aandoening.
Op basis van historische gegevens:
Deze gezamenlijke kans helpt artsen de waarschijnlijkheid van verschillende aandoeningen te beoordelen. Het is vermeldenswaard dat P(A ∩ B) niet gelijk is aan P(A) × P(B) = 0,30 × 0,25 = 0,075, wat aangeeft dat deze symptomen niet onafhankelijk zijn—weten dat een patiënt het ene symptoom heeft, vergroot de kans dat hij het andere ook heeft.
Financieel risicomodel
Beleggingsanalisten moeten vaak de gezamenlijke kans beoordelen dat meerdere marktomstandigheden gelijktijdig optreden. Denk aan een analist die het risico inschat op zowel een beursdaling als stijgende rentetarieven in het komende kwartaal.
Als hun modellen suggereren:
De gezamenlijke kansberekening is dan: P(Beursdaling ∩ Stijgende rente) = 0,60 × 0,45 = 0,27
Deze kans van 27% helpt het portefeuillerisico te kwantificeren en stuurt hedgingstrategieën aan om tegen dit scenario te beschermen.
Deze voorbeelden laten zien hoe gezamenlijke kans een krachtig hulpmiddel is om onzekerheid te kwantificeren in uiteenlopende domeinen, of je nu eenvoudige kansspelen analyseert of complexe beslissingen neemt in de geneeskunde en financiën.
Gezamenlijke kans en voorwaardelijke kans
Gezamenlijke en voorwaardelijke kansen zijn nauw verweven concepten waarmee we complexe scenario's met meerdere gebeurtenissen kunnen analyseren. Inzicht in hun relatie biedt krachtige tools voor probabilistisch redeneren.
De fundamentele relatie
De relatie tussen gezamenlijke en voorwaardelijke kans wordt uitgedrukt door de formule:
Door deze vergelijking te herschikken, kunnen we gezamenlijke kans uitdrukken in termen van voorwaardelijke kans:
Deze relatie laat zien dat we de gezamenlijke kans kunnen berekenen als we de marginale kans van de ene gebeurtenis kennen en de voorwaardelijke kans van de andere, gegeven de eerste.
Evenzo kunnen we ook schrijven:
Beide formuleringen zijn geldig en equivalent, en tonen de symmetrische aard van gezamenlijke kans.
Relevantie voor de stelling van Bayes
De relatie tussen gezamenlijke en voorwaardelijke kans staat centraal in de stelling van Bayes, een fundamenteel hulpmiddel in probabilistische inferentie:
De stelling van Bayes stelt ons in staat "voorwaardelijke kansen om te keren"—als we P(B|A) kennen, kunnen we P(A|B) berekenen. Dit is van onschatbare waarde wanneer we informatie hebben over de ene voorwaardelijke relatie maar moeten redeneren over de omgekeerde relatie.
Medische tests geven bijvoorbeeld vaak informatie over P(Positieve test|Ziekte), maar artsen moeten P(Ziekte|Positieve test) bepalen. De stelling van Bayes overbrugt deze kloof door gezamenlijke kans te betrekken:
Toepassingen in data science
Gezamenlijke kans vormt de basis voor tal van technieken en toepassingen in data science. Begrijpen hoe meerdere gebeurtenissen op elkaar inwerken helpt dataspecialisten nauwkeurigere modellen te bouwen en betere voorspellingen te doen in diverse domeinen.
Predictive modeling
Gezamenlijke kans is fundamenteel voor veel classificatie-algoritmen, met name Naive Bayes-classificaties. Deze populaire machinelearningmodellen berekenen de kans op verschillende uitkomsten op basis van de aanwezigheid van meerdere features.
De Naive Bayes-aanpak past de stelling van Bayes toe met de "naïeve" aanname dat features voorwaardelijk onafhankelijk zijn. Dit vereenvoudigt de berekeningen van gezamenlijke kansen:
Ondanks deze vereenvoudigende aanname werken Naive Bayes-classificaties opvallend goed voor:
Deze aanpak is computationeel efficiënt en presteert vaak verrassend goed, zelfs wanneer de onafhankelijkheidsaanname niet strikt geldt.
Risicobeoordeling
Gezamenlijke kans speelt een cruciale rol in fraudedetectiesystemen, waar meerdere risicofactoren samen moeten worden beoordeeld. Moderne fraudedetectiealgoritmen analyseren combinaties van verdachte gedragingen om mogelijk frauduleuze transacties te identificeren.
Beschouw een online betaalsysteem dat verschillende signalen monitort:
Hoewel elk signaal op zich geen fraude hoeft aan te geven, kunnen specifieke combinaties (hun gezamenlijke optreden) de verdenking aanzienlijk vergroten. Een grote transactie, vanaf een nieuw apparaat, in een vreemd land, op een ongebruikelijk tijdstip is bijvoorbeeld een gezamenlijke gebeurtenis met mogelijk hoge fraudekans.
Deze beoordeling van gezamenlijke kans maakt verfijndere risicoscores mogelijk dan wanneer je elke factor afzonderlijk evalueert, wat zowel false positives als false negatives vermindert.
Machine learning
Concepten rond gezamenlijke kans staan centraal in veel geavanceerde machinelearningmodellen, waaronder:
Bayesiaanse netwerken: Deze grafische modellen representeren variabelen en hun probabilistische relaties. Ze maken redeneren over complexe gezamenlijke kansverdelingen mogelijk door ze op te splitsen in eenvoudigere voorwaardelijke kansen. Bayesiaanse netwerken worden veel gebruikt in:
Hidden Markov-modellen (HMM's): Deze sequentiële modellen gebruiken gezamenlijke kansen om systemen te modelleren waarbij de onderliggende toestand verborgen is maar waarneembare outputs produceert. Toepassingen zijn onder meer:
Probabilistische grafische modellen: Dit omvat een bredere klasse modellen die grafen gebruiken om complexe gezamenlijke kansverdelingen te coderen. Het zijn essentiële tools voor:
Via deze toepassingen kunnen dataspecialisten modellen bouwen die de complexe onderlinge afhankelijkheden in real-world data vastleggen, wat leidt tot nauwkeurigere voorspellingen en betere besluitvorming onder onzekerheid.
Hoe mensen gezamenlijke kans verkeerd interpreteren
Ondanks het nut wordt gezamenlijke kans vaak verkeerd begrepen of onjuist toegepast. Laten we een paar veelvoorkomende misvattingen bekijken en hoe je die kunt vermijden.
Gezamenlijke kans verwarren met voorwaardelijke kans
Een van de meest voorkomende fouten is P(A∩B) verwarren met P(A|B). Hoewel ze verwant zijn, vertegenwoordigen ze verschillende concepten:
Bijvoorbeeld, de kans dat iemand zowel diabetes heeft als ouder is dan 65 (gezamenlijk) is anders dan de kans dat iemand diabetes heeft gegeven dat hij ouder is dan 65 (voorwaardelijk).
Dit onderscheid is belangrijk in veel analytische contexten. Wanneer een dataspecialist bijvoorbeeld meldt dat "5% van de gebruikers zowel op een advertentie klikte als een aankoop deed", is deze gezamenlijke kans heel anders dan "40% van de gebruikers die op een advertentie klikten deed een aankoop", wat een voorwaardelijke kans is.
Onterecht onafhankelijkheid aannemen
Een andere veelgemaakte fout is automatisch aannemen dat P(A∩B) = P(A) × P(B) zonder te verifiëren dat gebeurtenissen echt onafhankelijk zijn. Deze aanname kan tot aanzienlijke fouten leiden wanneer gebeurtenissen in werkelijkheid afhankelijk zijn.
In marktanalyse kan het bijvoorbeeld fout uitpakken om onafhankelijkheid aan te nemen tussen de aankoop van product A en product B als deze producten complementair zijn (zoals printers en inkt) of substituten (zoals verschillende merken van hetzelfde artikel).
Het testen op onafhankelijkheid is cruciaal—als P(A∩B) ≠ P(A) × P(B), dan zijn de gebeurtenissen afhankelijk en zijn zorgvuldiger berekeningen van gezamenlijke kans vereist.
Marginale kansen negeren
Bij het werken met gezamenlijke kansen richten analisten zich soms uitsluitend op de doorsnede, terwijl ze de algehele frequentie van individuele gebeurtenissen negeren. Dit kan tot misleidende conclusies leiden over de sterkte van relaties.
Ontdekken dat 90% van de klanten die producten A en B kochten ook product C kochten, lijkt bijvoorbeeld indrukwekkend. Maar als 89% van alle klanten hoe dan ook product C koopt, is de schijnbare relatie veel zwakker dan aanvankelijk leek.
Vergelijk gezamenlijke kansen altijd met relevante marginale kansen om overschatting van relaties tussen gebeurtenissen te voorkomen. De lift-ratio—de verhouding van de gezamenlijke kans tot het product van marginale kansen—biedt een nauwkeurigere maat voor associatie:
Een lift-waarde groter dan 1 geeft aan dat gebeurtenissen vaker samen voorkomen dan je zou verwachten als ze onafhankelijk waren.
Inzicht in deze veelvoorkomende valkuilen helpt dataspecialisten gezamenlijke kans correct toe te passen en betekenisvolle inzichten uit probabilistische analyses te halen.
Geavanceerde onderwerpen en verdere overwegingen
Naarmate dataspecialisten vorderen in hun carrière, komen ze meer geavanceerde toepassingen van gezamenlijke kans tegen. Laten we enkele geavanceerde concepten verkennen die voortbouwen op de fundamenten die we hebben gelegd.
Gezamenlijke kans in hoog-dimensionale ruimtes
Bij moderne machinelearningproblemen werken dataspecialisten vaak gelijktijdig met tientallen of zelfs honderden variabelen. In deze hoog-dimensionale ruimtes wordt het berekenen en representeren van gezamenlijke kansen uitdagend.
Het aantal parameters dat nodig is om een gezamenlijke verdeling te specificeren, groeit exponentieel met het aantal variabelen—een fenomeen dat bekendstaat als de "vloek van dimensionaliteit". Een gezamenlijke verdeling van 10 binaire variabelen vereist bijvoorbeeld 2¹⁰ - 1 = 1.023 parameters voor een volledige specificatie.
Om deze complexiteit beheersbaar te maken, gebruiken dataspecialisten technieken zoals:
Deze benaderingen maken berekeningen van gezamenlijke kansen in hoge dimensies hanteerbaar voor praktische toepassingen in gebieden als computervisie, genomica en natural language processing.
Gezamenlijke kansverdelingen
Onze voorbeelden tot nu toe betroffen vooral discrete gebeurtenissen, maar gezamenlijke kans strekt zich op natuurlijke wijze uit naar continue variabelen via gezamenlijke kansverdelingen.
Voor discrete variabelen werken we met gezamenlijke kansmassafuncties (PMF's), die de kans specificeren dat elke combinatie van toevalsgrootheden specifieke waarden aanneemt:
Voor continue variabelen gebruiken we gezamenlijke kansdichtheidsfuncties (PDF's). In tegenstelling tot PMF's geven PDF's niet direct kansen; je moet integreren over gebieden om de kans te vinden dat de variabelen binnen die gebieden vallen:
Veelvoorkomende gezamenlijke verdelingen zijn onder andere:
Inzicht in deze verdelingen maakt geavanceerdere modellering van relaties tussen continue variabelen mogelijk in velden als economie, bio-informatica en milieuwetenschap.
Praktische tools voor het berekenen van gezamenlijke kans
Diverse softwaretools en programmeertalen bieden functies en bibliotheken om met gezamenlijke kansen te werken:
Python:
NumPyenSciPybieden functies voor multivariate kansverdelingenPandas biedt krachtige tools voor empirische berekeningen van gezamenlijke kansen
Bibliotheken zoals
PyMC3enPyStanimplementeren Bayesiaanse modellering met gezamenlijke verdelingenR:
Base R bevat veel functies voor multivariate verdelingen
Pakketten zoals
copulamaken het mogelijk complexe afhankelijkheidsstructuren te modellerenbnlearnondersteunt analyse van Bayesiaanse netwerkenSQL:
GROUP BY-clausules metCOUNT-functies kunnen empirische gezamenlijke kansen berekenenVensterfuncties maken complexere probabilistische analyses mogelijk
Moderne databases ondersteunen statistische functies voor kansberekeningen
Dankzij deze tools kun je concepten rond gezamenlijke kans in de praktijk toepassen op grote datasets en verfijnde probabilistische modellen bouwen voor complexe problemen.
Om je begrip van gezamenlijke kans en de toepassingen in Bayesiaanse analyse te verdiepen, biedt DataCamp verschillende uitstekende cursussen:
Deze cursussen helpen je voort te bouwen op de concepten in dit artikel en technieken met gezamenlijke kansen toe te passen om echte data science-problemen op te lossen.
Conclusie
Zoals we in dit artikel hebben gezien, is gezamenlijke kans een fundamenteel statistisch concept met een brede waaier aan toepassingen binnen tal van data science-velden. De bronnen van DataCamp, zoals gedeeld in de 40+ Python Statistics for Data Science Resources, bieden uitstekende routes om je begrip te versterken. Deze uitgebreide collectie bevat specifieke aanbevelingen om kansrekening, Bayesiaans denken en andere statistische concepten te leren die voortbouwen op gezamenlijke kans.
Voor wie zich voorbereidt op data science-functies, biedt onze gids Top 35 Statistics Interview Questions and Answers waardevolle oefening met vragen over gezamenlijke kans naast andere belangrijke statistische concepten. Ook onze cursus Probability Puzzles in R is wat mij betreft een leuke optie.