
课程
Excel 财务建模
3 小时
28.2K
想象您在观察两只航空公司股票之间的价差。这类公司往往同向波动,因为它们共享相似的燃油成本、航线和乘客需求。某天早上,价差突然大幅拉大:某个代码遭遇了特有冲击,而另一只几乎未动。一位量化交易员看见这种情况,会问一个非常具体的问题:这个价差更可能收窄回去,还是出现了结构性变化?
均值回归是指变量在偏离其长期水平后,倾向于回到该水平的特性。它是大量时间序列模型和量化交易策略的基础,也是整个一类方法(s known as statistical arbitrage. The crit)背后的统计引擎。需要牢记的关键点——本文会反复强调这一点:均值回归是一个需要检验的属性,而不是对价格作出的先验假设。
均值回归描述的是一种动态倾向:当变量偏离其均衡水平时,力量会促使其被拉回。这个均衡可能是长期统计均值、由基本面隐含的公允价值,或两条序列之间的协整关系。正向偏离(数值高于均值)往往随后走低;负向偏离往往随后走高。
均值回归之所以有趣,在于它对冲击的含义。在一个均值回归过程里,冲击是暂时的。其影响会随时间消散,序列最终回归均衡。这与随机游走截然不同:在随机游走中,每个冲击都是永久性的,序列没有可回归的“家”。我们稍后会更正式地区分两者。
直觉如下:变量围绕某个均衡水平波动。一次冲击(盈利不及预期、政策意外、流动性收紧)把它推离该水平。偏离越远,回复力可能越强。随着时间推移,冲击效应衰减,变量渐渐回归。
与此相对的是随机游走。每期的值等于上一期的值加上一个随机冲击,而该冲击永不消失。没有可回归的均衡;序列只是漫无目的地游走。对于预测而言,这一区别至关重要:均值回归序列在更长的期限上在原理上是部分可预测的;随机游走则不是。
从直觉走向证据需要统计分析。没有单一检验足够有力。您需要多种证据指向同一方向。
先从可视化着手。均值回归序列倾向于围绕相对稳定的水平振荡,而不是持续单边上行或下行。但目测很容易被误导:趋势型序列在短窗口内可能看起来像回归;而缓慢均值回归过程在短期上几乎与随机游走难以区分。图形只是初筛,不是定论。
自相关衡量序列与其自身滞后值之间的相关性。在均值回归过程中,自相关函数(ACF)会快速衰减至零,反映偏离的暂态性。相反,含单位根的过程即便在较长滞后上也会保持接近1.0的自相关。ACF图能揭示这种模式——快速下落与均值回归一致,而缓慢线性衰减暗示非平稳。当然,仅凭自相关并不能确认平稳性,它只是证据之一。
扩展的Dickey-Fuller(ADF)检验是标准起点。它以序列存在单位根(即表现为随机游走)为原假设。拒绝原假设暗示序列可能是平稳的,而平稳性与均值回归行为密切相关。p值低于0.05为您继续分析提供依据,但并非确定无疑。
若检验支持均值回归,接下来要问的是其速度。速度参数(连续时间模型中常记为κ,或在某些参数化中为θ)告诉您偏离衰减的快慢。速度高意味着偏离迅速缩小;速度低则意味着过程在回归前要漫游很久。这在实践中很重要:非常缓慢的均值回归过程,可能在现实持有期内无法交易。
这个区别值得单列一节,因为这是人们最容易搞错的地方。
随机游走没有可回归的长期均值。冲击是永久的。序列是非平稳的,即其统计特性(均值、方差)随时间变化。短期之外的预测几乎徒劳。均值回归过程是平稳的(或至少是趋势平稳):其特性稳定,冲击是暂态的,较长期的预测具有真实信息含量。
陷阱在于:价格序列历史上多次回到某个水平,并不必然意味着其均值回归。游走得足够久,任何随机游走都可能重访起点。关键问题在于是否存在结构性的拉回均衡,而这需要检验,not 仅靠模式识别。
|
属性 |
均值回归 |
随机游走 |
|
长期行为 |
围绕稳定水平振荡 |
无界漂移 |
|
冲击持久性 |
暂时 |
永久 |
|
平稳性 |
平稳 |
非平稳 |
|
可预测性 |
较长周期上可以 |
非常有限 |
均值回归与平稳性也是一个容易混淆的点。两者密切相关,但并不相同。平稳性是一个形式化的统计性质:平稳过程具有恒定均值、恒定方差,且自协方差只取决于滞后而非具体时点。均值回归是一种动态倾向,即偏离后被拉回均衡。
大多数均值回归模型假定平稳性,而多数平稳过程也会表现出某种形式的均值回归行为。但这种关系并非一一对应。一个过程可以是平稳的,但其均值回归动力并不强;而“均值回归”这个标签有时也被宽泛地用于仅弱平稳的过程。阅读文献时,值得保持这一区分的清晰。
均值回归与动量倾向相反。均值回归假定异常的大幅波动更可能反转。一只相对其历史区间大跌的股票(在此观点下)预期会回升,并非因为价格“必须”回归,而是因为偏离公允价值带来了回报机会。
动量假定相反:近期的方向性运动更可能延续。一只过去12个月强劲上涨的股票,预期会继续跑赢。
证据表明,动量在中期(1至12个月)非常强,而均值回归更常见于短期(几天到数周)和超长期(多年)。市场可以并且确实会在不同时间尺度上同时展现两种行为。两者都不是普适法则。
描述均值回归行为的标准连续时间模型是 Ornstein-Uhlenbeck(OU)过程:
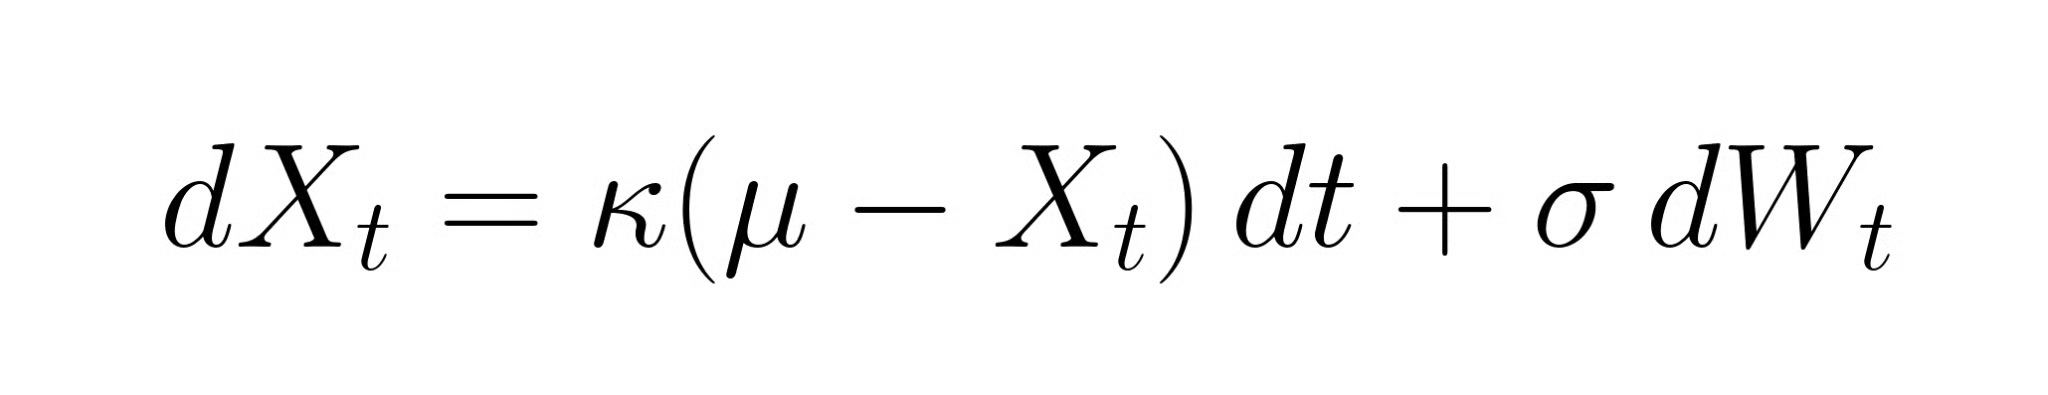
每一项都有特定作用。其中 κ(μ − Xt) 是回复力:当 Xt 高于长期均值 μ 时,过程被向下拉;当低于时,被向上拉。参数 κ 控制这种拉力的强度,即均值回归速度。σ dWt 项则加入波动率为 σ 的随机噪声。
用不同的 κ 值模拟 OU 路径能直观体现:当 κ 高时,路径紧贴均值,偏离迅速收敛;当 κ 低时,路径广泛游走,并在短窗口内几乎与随机游走难分。这也是为何要谨慎估计 κ:即使统计上显著,但若 κ 极小,在实践中也可能不可操作。
OU 模型给出 κ,但单看 κ 直观性较差。半衰期把这个抽象速度转化为具体量化:偏离均衡缩小一半所需的期望时间。
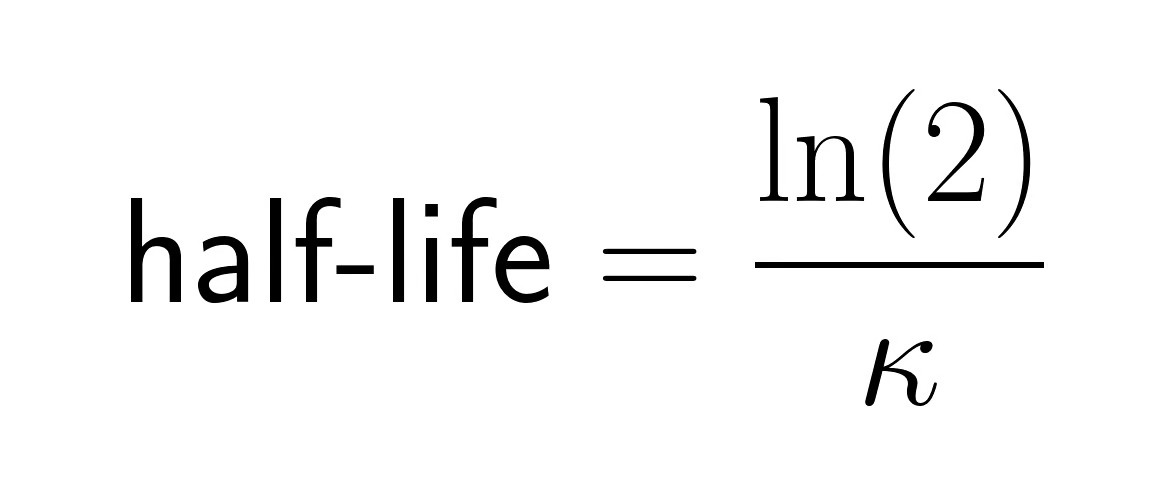
若半衰期为3天,过程较快;偏离在一周内就会收敛。若为6个月,则需要很长持有期来捕捉回归,而这会带来额外风险。量化交易员会将估计的半衰期与其目标持有期进行比较,再决定是否执行策略。
需要提醒的是:半衰期是期望值而非保证。任何一次偏离都可能持续更久,尤其在发生制度转换或结构性断裂时。
那么,金融市场中哪里真正存在均值回归?有些领域证据扎实,另一些则相对不足。
需要指出的是:单个股票价格通常是非平稳的。呈现均值回归行为的往往是价差、收益、波动率度量或其他变换后的序列,而非原始价格水平。
还有一个概念性区分,即便是经验丰富的人也容易被绊倒,弄错了就会导致策略构建不当。
两只资产相关性可达0.95,但其价差却是随机游走。务必进行检验。
配对交易是将均值回归用于实践的最清晰例子,您可能正因这一关联而读到本文。
首先识别两只具有合理长期经济关系的资产:两家石油巨头、两家大型银行、两家消费必需品公司。经济理由在此很重要。仅凭历史相关性筛选而无基本面依据,往往会得到在样本外分崩离析的伪关系。构造价差,通常是比率或两价的线性组合,并用回归估计对冲比率,而非天真地假设一比一。然后用上述工具检验该价差是否均值回归:ADF 检验、自相关分析、半衰期估计。若证据支持,则继续推进。
交易本身相对直接。当价差相对其历史均值异常拉大时,用z分数来度量偏离(当前价差减去移动均值,再除以标准差),做多表现落后的资产、做空表现领先的资产,预期价差收窄。z分数为+2表示价差高于历史常态两个标准差;常见做法是在±2.0进场,回归至零附近时离场。关键点,也是简单解释中常被忽略的一点:预期均值回归的是价差,而非任一单独股票。多空结构还能降低对整体市场波动的暴露。利润来自相对变动,而非市场方向。
配对交易是进入均值回归策略最直观的入口,但它只是更广泛方法家族——统计套利——中的一个实例。
统计套利(stat arb)利用证券之间的统计关系来发现相对错定价:当两只历史上相关的证券短暂偏离其预期关系时,押注它们将重新收敛。一个重要澄清:统计套利并非无风险套利。传统套利利用几乎机械式的价格差异,比如同一资产在两个交易所价格不同,只要执行足够快,利润几乎确定。统计套利押注的是概率性的收敛。两者的风险轮廓截然不同。
均值回归交易思路有多种。以下是其中一些:
直说无妨:统计信号并不保证盈利性收敛。交易成本、借贷成本与制度变迁都可能完全抹去表面上的优势。上述策略描述的是入场条件,而不是盈利条件。
下面进入实操。以下代码在一个模拟的价差上走通一个紧凑的均值回归分析流程,涵盖要点:绘图、滚动均值、ADF 检验和半衰期估计。将其中的模拟配对价差替换为真实价差(例如两只协整股票的对数价格比),同样的流程即可应用。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.stattools import adfuller
from statsmodels.regression.linear_model import OLS

# Simulate a mean-reverting spread using an AR(1) process
np.random.seed(42)
n = 500
phi = 0.92          # AR coefficient; close to 1 = slow mean reversion
spread = np.zeros(n)
for t in range(1, n):
    spread[t] = phi * spread[t-1] + np.random.normal(0, 1)

spread_series = pd.Series(spread, name="spread")

# --- Step 1: Plot the series with its rolling mean ---
rolling_mean = spread_series.rolling(window=60).mean()
plt.figure(figsize=(10, 4))
plt.plot(spread_series, label="Spread", alpha=0.7)
plt.plot(rolling_mean, label="60-period rolling mean", linewidth=2)
plt.axhline(0, color="black", linestyle="--", linewidth=0.8)
plt.title("Simulated Mean-Reverting Spread")
plt.legend()
plt.tight_layout()
plt.show()

# --- Step 2: ADF test for stationarity ---
adf_result = adfuller(spread_series.dropna())
print(f"ADF statistic : {adf_result[0]:.4f}")
print(f"p-value       : {adf_result[1]:.4f}")
print("Reject unit root?", "Yes" if adf_result[1] < 0.05 else "No")

# --- Step 3: Estimate half-life via AR(1) regression —
lagged = spread_series.shift(1).dropna()
delta  = spread_series.diff().dropna()
model  = OLS(delta, lagged).fit()
kappa  = -model.params.iloc[0]           # speed of mean reversion
half_life = np.log(2) / kappa
print(f"\nEstimated half-life: {half_life:.1f} periods")
用上面的随机种子运行后,会得到远低于0.05的 p 值,以及大约7期的半衰期。对于 φ = 0.92,理论值约为8.7期;单次运行会围绕该值波动。请记住:解读比机械操作更重要。历史窗口上统计显著的 ADF 结果并不意味着未来关系仍然成立。本回归省略了截距项,这对零均值数据是合理的。若真实价差具有非零均值,请使用 add_constant(lagged) 添加常数并提取第二个系数。
我们的《Python 时间序列分析》课程更深入地讲解了这些技术,包括ARIMA 建模、平稳性检验与预测。
均值回归有其可预见的失效方式。了解这些失效模式与了解策略本身同样重要。
历史均衡水平是由数据估计而来,而数据反映的是过去。结构性断裂(并购、监管变化、竞争格局转变)可能让历史均值完全失效。您以为回归至零的价差,新的均衡可能在+50个基点。继续使用基于旧均值构建的策略,几乎必然亏损。就配对交易而言,公司会并购、分化或改变商业模式,过去五年紧密协整的一对,可能一夜之间脱钩。
在短样本内,趋势型序列可能仅仅因为回到局部移动均值而看起来像均值回归。这在采用固定回溯窗口的回测中尤为常见。解决办法是跨多个样本期进行检验,并对仅在窄窗口内出现的结果保持怀疑。
频繁交易会侵蚀回报。半衰期为两天的策略可能需要每日再平衡,往返交易成本很容易超过每笔交易的预期利润。做空还会带来额外成本:证券借贷费用以及被券商回补的风险。模型价格与实际成交价格之间的滑点在上百笔交易中会不断累积。对于高频均值回归策略,纸面回报与实盘回报可能大相径庭。
当众多基金运行相似策略时,它们会彼此暴露。2007年8月的量化崩盘正是因为太多股票统计套利基金同时减仓,所引发的连锁反应与这些策略所基于的底层关系无关。策略奏效会吸引资金;资金过多时,策略便不再奏效,有时是渐进地失效,有时则是骤然失灵。
统计套利模型是针对特定市场环境校准的:波动率状态、利率周期、相关性结构。当环境发生变化,所有假设会同时移动。不是单个配对失灵,而是整个组合都异常,因为其所依赖的统计性质不再成立。历史回溯窗口不会提前发出警告。
结果高度依赖用于估计均值的回溯窗口、入场阈值与离场规则。任何一个参数的微调都可能把策略从盈利翻到亏损。请在信任任何回测前,明确进行压力测试。
最隐蔽的风险。参数够多、历史数据够长,几乎可以把任何时期都拟合得很好,但上线交易后会急剧退化。前瞻滚动测试与样本外验证不是可选项。
均值回归是一个听起来简单、用起来不易的概念。偏离均衡会倾向于反转,这一基本思想直观易懂。更难的是:判断特定序列是否具备此属性、估计其回归速度,并构建能抵御交易成本、制度变迁与参数不确定性的策略。统计套利把这一挑战形式化为一门交易学科,但核心难题未变:您所交易的关系,正与其他发现同样关系的人竞争。
几点要点:在假定前先检验;关注到底是什么在回归(价差与变换,而非原始价格);区分相关性与协整,因为它们不可互换;并将上述风险视为策略的一部分,而非事后思考。我们的《Python 时间序列分析》课程深入讲解平稳性检验、ARIMA 建模与预测。若聚焦交易应用,《Python 金融交易》课程涵盖量化策略的实作与评估。
与 DataCamp 一起学习
课程
课程
课程