统计套利(stat arb)是一类量化交易策略,利用证券之间的统计关系来识别潜在交易机会。其核心并不是孤立地预测某只股票涨跌,而是识别相对错价:当两只具有历史联系的证券短暂偏离预期关系时,押注它们将重新收敛。
先厘清一点:统计套利并非无风险套利。机会是概率性的,支撑策略的关系也可能完全失效。我在 BlueCrest 管理亚洲区资本市场头寸时就亲眼见过:一笔在纸面上看起来统计上可靠的交易,一旦宏观格局转变,可能瞬间崩塌。
本文将介绍统计套利如何通过配对交易与均值回归发挥作用、为何协整比相关性更重要,以及在实践中真实的风险是什么样子。
什么是统计套利?
统计套利利用历史和实时数据来识别证券之间的统计关系。当这些关系偏离预期状态时,交易员会建立对冲的多空头寸:买入相对被低估的证券,卖空相对被高估的证券,然后等待关系恢复常态。
多/空结构的作用在于降低对大盘波动的敞口。如果市场下跌 5%,两条腿会大致同向受影响,因此盈亏来自两只证券之间的相对变动,而不是市场方向。
统计套利如何运作
一般流程:识别相关证券,建模其历史关系,检测当前价差何时偏离历史常态,建立相互对冲的多空头寸,然后等待收敛或触发退出条件。
一个简单例子:若百事突然较可口可乐出现异常大的折价,且没有明显基本面原因,统计套利策略会买入百事、卖空可口可乐,预期价差回归。利润来自该价差收窄,而非个股朝某一方向单独波动。
配对交易:一个简单的统计套利示例
在上述基本流程下,配对交易是最直观的实践方式。选择两只具有历史关联的证券,构造它们价格之间的价差,当该价差相对历史行为异常偏离时进行交易:买入便宜的一只,卖空贵的一只,若价差收敛则平仓。
值得强调:仅有相关性并不能建立稳定、可交易的关系。两只股票即使高度相关,也仍可能永久性背离。下一节正是讨论这一点。
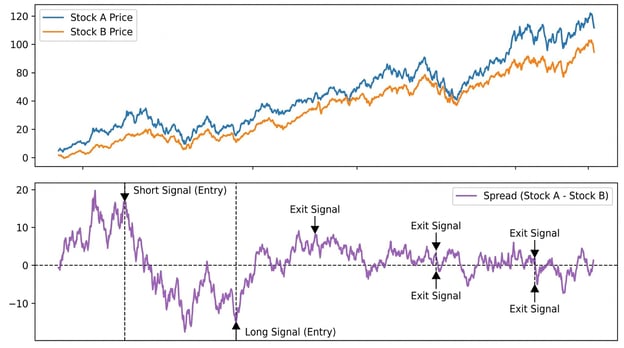
股票 A 与股票 B 的价格(上)及其价差(下),在关键回归点标注了入场与出场信号。图片作者自制。
统计套利中的均值回归
配对交易之所以有效(在其有效的情况下),是因为均值回归:偏离历史均值的价差最终倾向于回归。关键指标是z 分数:(当前价差-移动均值)/ 标准差。z 分数为 +2 表示价差高于历史常态两个标准差,一种不寻常读数,有些策略将其视为做空信号。
z 分数的价值在于标准化信号。与其问“这个价差是否很宽?”,不如问“相对于其通常行为,这个价差是否异常宽?”这才是均值回归策略真正试图回答的问题。
统计套利中的协整与相关性
均值回归给出了交易逻辑,但也引出一个不太舒服的问题:如何判断价差真的会回归,而不是永久性背离?这正是相关性与协整分道扬镳之处。值得重视:
相关性
相关性衡量两个变量之间线性关系的强度。两只股票相关性可达 0.9,却仍是糟糕的配对交易,因为相关性并不说明二者价差是否稳定或具备均值回归特性。
协整
协整描述非平稳时间序列之间的长期均衡关系。若两条价格序列的某个线性组合是平稳的,即围绕稳定均值波动而非漂移,那么它们就是协整的。这才是您真正需要的属性。
两只股票可能多年共同上行,随后永久性分化。高相关、无协整、无可靠交易。使用 Engle-Granger 检验或 Johansen 程序测试协整,可为“价差会回归”的假设提供更可辩护的依据。需要注意的是,PCA在这里是另一回事,本文不展开。
如何构建统计套利策略
理解原理是一回事,把它转化为可运行的策略是另一回事。从直觉走向可落地的量化流程包含五个步骤,跳过任何一步往往会得到纸面漂亮、实盘崩塌的策略。
- 从经济逻辑出发:相同板块、共享供应商、类似收入驱动因素。仅依赖历史相关性筛选、而缺乏基本面依据,容易得到伪关系。
- 对价差本身做增强型 Dickey-Fuller(ADF)检验。若不平稳,说明在漂移,而非均值回归。
- 用对冲比率构造价差,而非简单 1:1 价格假设。通过回归等方法用数据估计对冲比率,以确定两只证券的持仓比例。若估错,配对就不是真正的市场中性。
- 围绕 z 分数阈值定义入场与出场规则。在 ±2.0 入场,当价差回归至 0 附近时退出,在 ±3.0 止损。继续越过 ±3 的价差通常意味着关系正在瓦解,而非更好的入场点。最大持仓期同样重要:若在设定窗口内价差未回归,应了结仓位,而不是无限期等待可能永远不来的回归。
- 按美元中性进行头寸规模控制,在历史数据上进行包含真实交易成本的回测,并预期实盘表现将低于回测(而非高于)。
统计套利策略如何走向高级化
简单的配对交易只是入门而非天花板。当您熟悉核心机制后,方法通常会向两个方向扩展。
多资产统计套利与因子模型
多资产方法建模的是一篮子证券之间的关系,而非单独的配对。基于因子的办法通过通用的市场或行业因子剥离系统性收益,然后交易剩余的相对错价。PCA 则将这一思路扩展到数百只资产:识别共同波动的主要来源,然后交易那些主成分未能解释的收益。
其底层押注相同(剩余错价会回归),但发现错价的统计框架不同。您不再测试两条时间序列是否协整,而是分解整个截面收益,并押注剩余噪声是暂时的。
机器学习方法
机器学习已被用于关系发现、信号生成与状态识别。它并不会自动提升回报,且会引入自身的模型风险。策略仍然依赖均值回归;机器学习只是寻找同一信号的更复杂方式。
统计套利的风险与限制
更复杂的策略并不能消除底层风险,往往只是让这些风险更难察觉,直到为时已晚。以下是运行任何统计套利策略前值得理解的失效模式。
关系可能失效
支撑您策略的历史关系只是对过去的描述。行业整合、监管变动、公司业务模式转型:任何因素都可能永久性改变这种关系。一旦发生,价差不会回归,而是持续朝不利方向发展。
模型风险与交易成本
每个统计套利策略都建立在统计假设之上。若价差并非真正平稳、对冲比率估计有误、回看窗口选择不当,模型就会产生误导性信号。即便模型正确,交易成本也会以初级回测难以体现的方式侵蚀收益。
看似扣除成本前盈利的策略,扣除后可能即告亏损。在利率类资产中我也见过这种情况:理论交易很干净,实际交易并非如此。
执行摩擦与拥挤交易
做空不是免费的。证券借贷费用与被券商回补的风险都会带来真实成本。模型价与实际成交价之间的滑点在数百笔交易中会不断累积。而当许多基金运行相似策略时,它们会彼此暴露。
2007 年 8 月的量化崩盘正是因为过多权益统计套利基金同时去杠杆,随之而来的连锁反应与这些策略所基于的底层关系无关。
市场状态切换
统计套利模型是针对特定市场环境(波动率状态、利率周期、相关性结构)校准的。一旦环境变化,所有假设将同时移动。
这不是一对配对失效的问题;而是整个投资组合失灵,因为其所依赖的统计属性不再成立。低波动状态下看似平稳的价差动态,一旦波动上升,可能在一夜之间变得不稳定,而历史回看窗口无法提前预警。
回测过拟合
最阴险的风险。参数足够多、历史数据足够长,几乎可以把策略拟合到任意过去时期,但上线后表现会急剧劣化。样本外测试是最低限度的保护,且即便如此也未必足够。
统计套利与相关交易策略的比较
统计套利常与若干相邻策略混为一谈。
统计套利 vs. 传统套利
传统套利利用几乎机械性的价差:同一资产在两家交易所价格不同。若能足够快地执行,利润几近确定。统计套利则押注概率性的收敛,风险画像完全不同。
统计套利 vs. 配对交易
配对交易是统计套利的一种,而非该领域的同义词。两者常被混用,但统计套利涵盖多因子模型、基于 PCA 的策略,以及覆盖大型组合的机器学习方法。配对交易只是多数人的起点。
统计套利 vs. 算法交易
算法交易是更广泛的范畴,指任何自动化执行策略。统计套利是其中的一个具体家族。高频做市与趋势跟随也属于算法交易,但都不是统计套利。
结论
统计套利的本质,是押注关系的延续。您寻找两只历史上同向移动的证券,等待它们分化,并布局于价差收敛。数学将这种直觉形式化,但当数学让您持有而市场让您撤退时,恰恰是这种直觉让您保持诚实。
统计套利真正困难的地方不在统计学,而在于您所交易的关系也在与所有发现相同关系的人竞争。它们有效时会吸引资金。当吸引的资金过多时,它们就会失效,有时是逐渐失效,有时是一瞬间,正如 2007 年所示。
关于统计基础、平稳性检验与时间序列建模,Time Series Analysis in Python 课程是合适的下一步。关于回测与量化工作流,Financial Trading in Python 课程涵盖了策略的实务实现与评估。


统计套利(stat arb)是一类量化交易策略,利用证券之间的统计关系来识别潜在交易机会。其核心并不是孤立地预测某只股票涨跌,而是识别相对错价:当两只具有历史联系的证券短暂偏离预期关系时,押注它们将重新收敛。
先厘清一点:统计套利并非无风险套利。机会是概率性的,支撑策略的关系也可能完全失效。我在 BlueCrest 管理亚洲区资本市场头寸时就亲眼见过:一笔在纸面上看起来统计上可靠的交易,一旦宏观格局转变,可能瞬间崩塌。
本文将介绍统计套利如何通过配对交易与均值回归发挥作用、为何协整比相关性更重要,以及在实践中真实的风险是什么样子。
什么是统计套利?
统计套利利用历史和实时数据来识别证券之间的统计关系。当这些关系偏离预期状态时,交易员会建立对冲的多空头寸:买入相对被低估的证券,卖空相对被高估的证券,然后等待关系恢复常态。
多/空结构的作用在于降低对大盘波动的敞口。如果市场下跌 5%,两条腿会大致同向受影响,因此盈亏来自两只证券之间的相对变动,而不是市场方向。
统计套利如何运作
一般流程:识别相关证券,建模其历史关系,检测当前价差何时偏离历史常态,建立相互对冲的多空头寸,然后等待收敛或触发退出条件。
一个简单例子:若百事突然较可口可乐出现异常大的折价,且没有明显基本面原因,统计套利策略会买入百事、卖空可口可乐,预期价差回归。利润来自该价差收窄,而非个股朝某一方向单独波动。
配对交易:一个简单的统计套利示例
在上述基本流程下,配对交易是最直观的实践方式。选择两只具有历史关联的证券,构造它们价格之间的价差,当该价差相对历史行为异常偏离时进行交易:买入便宜的一只,卖空贵的一只,若价差收敛则平仓。
值得强调:仅有相关性并不能建立稳定、可交易的关系。两只股票即使高度相关,也仍可能永久性背离。下一节正是讨论这一点。
股票 A 与股票 B 的价格(上)及其价差(下),在关键回归点标注了入场与出场信号。图片作者自制。
统计套利中的均值回归
配对交易之所以有效(在其有效的情况下),是因为均值回归:偏离历史均值的价差最终倾向于回归。关键指标是z 分数:(当前价差-移动均值)/ 标准差。z 分数为 +2 表示价差高于历史常态两个标准差,一种不寻常读数,有些策略将其视为做空信号。
z 分数的价值在于标准化信号。与其问“这个价差是否很宽?”,不如问“相对于其通常行为,这个价差是否异常宽?”这才是均值回归策略真正试图回答的问题。
统计套利中的协整与相关性
均值回归给出了交易逻辑,但也引出一个不太舒服的问题:如何判断价差真的会回归,而不是永久性背离?这正是相关性与协整分道扬镳之处。值得重视:
相关性
相关性衡量两个变量之间线性关系的强度。两只股票相关性可达 0.9,却仍是糟糕的配对交易,因为相关性并不说明二者价差是否稳定或具备均值回归特性。
协整
协整描述非平稳时间序列之间的长期均衡关系。若两条价格序列的某个线性组合是平稳的,即围绕稳定均值波动而非漂移,那么它们就是协整的。这才是您真正需要的属性。
两只股票可能多年共同上行,随后永久性分化。高相关、无协整、无可靠交易。使用 Engle-Granger 检验或 Johansen 程序测试协整,可为“价差会回归”的假设提供更可辩护的依据。需要注意的是,PCA在这里是另一回事,本文不展开。
如何构建统计套利策略
理解原理是一回事,把它转化为可运行的策略是另一回事。从直觉走向可落地的量化流程包含五个步骤,跳过任何一步往往会得到纸面漂亮、实盘崩塌的策略。
统计套利策略如何走向高级化
简单的配对交易只是入门而非天花板。当您熟悉核心机制后,方法通常会向两个方向扩展。
多资产统计套利与因子模型
多资产方法建模的是一篮子证券之间的关系,而非单独的配对。基于因子的办法通过通用的市场或行业因子剥离系统性收益,然后交易剩余的相对错价。PCA 则将这一思路扩展到数百只资产:识别共同波动的主要来源,然后交易那些主成分未能解释的收益。
其底层押注相同(剩余错价会回归),但发现错价的统计框架不同。您不再测试两条时间序列是否协整,而是分解整个截面收益,并押注剩余噪声是暂时的。
机器学习方法
机器学习已被用于关系发现、信号生成与状态识别。它并不会自动提升回报,且会引入自身的模型风险。策略仍然依赖均值回归;机器学习只是寻找同一信号的更复杂方式。
统计套利的风险与限制
更复杂的策略并不能消除底层风险,往往只是让这些风险更难察觉,直到为时已晚。以下是运行任何统计套利策略前值得理解的失效模式。
关系可能失效
支撑您策略的历史关系只是对过去的描述。行业整合、监管变动、公司业务模式转型:任何因素都可能永久性改变这种关系。一旦发生,价差不会回归,而是持续朝不利方向发展。
模型风险与交易成本
每个统计套利策略都建立在统计假设之上。若价差并非真正平稳、对冲比率估计有误、回看窗口选择不当,模型就会产生误导性信号。即便模型正确,交易成本也会以初级回测难以体现的方式侵蚀收益。
看似扣除成本前盈利的策略,扣除后可能即告亏损。在利率类资产中我也见过这种情况:理论交易很干净,实际交易并非如此。
执行摩擦与拥挤交易
做空不是免费的。证券借贷费用与被券商回补的风险都会带来真实成本。模型价与实际成交价之间的滑点在数百笔交易中会不断累积。而当许多基金运行相似策略时,它们会彼此暴露。
2007 年 8 月的量化崩盘正是因为过多权益统计套利基金同时去杠杆,随之而来的连锁反应与这些策略所基于的底层关系无关。
市场状态切换
统计套利模型是针对特定市场环境(波动率状态、利率周期、相关性结构)校准的。一旦环境变化,所有假设将同时移动。
这不是一对配对失效的问题;而是整个投资组合失灵,因为其所依赖的统计属性不再成立。低波动状态下看似平稳的价差动态,一旦波动上升,可能在一夜之间变得不稳定,而历史回看窗口无法提前预警。
回测过拟合
最阴险的风险。参数足够多、历史数据足够长,几乎可以把策略拟合到任意过去时期,但上线后表现会急剧劣化。样本外测试是最低限度的保护,且即便如此也未必足够。
统计套利与相关交易策略的比较
统计套利常与若干相邻策略混为一谈。
统计套利 vs. 传统套利
传统套利利用几乎机械性的价差:同一资产在两家交易所价格不同。若能足够快地执行,利润几近确定。统计套利则押注概率性的收敛,风险画像完全不同。
统计套利 vs. 配对交易
配对交易是统计套利的一种,而非该领域的同义词。两者常被混用,但统计套利涵盖多因子模型、基于 PCA 的策略,以及覆盖大型组合的机器学习方法。配对交易只是多数人的起点。
统计套利 vs. 算法交易
算法交易是更广泛的范畴,指任何自动化执行策略。统计套利是其中的一个具体家族。高频做市与趋势跟随也属于算法交易,但都不是统计套利。
结论
统计套利的本质,是押注关系的延续。您寻找两只历史上同向移动的证券,等待它们分化,并布局于价差收敛。数学将这种直觉形式化,但当数学让您持有而市场让您撤退时,恰恰是这种直觉让您保持诚实。
统计套利真正困难的地方不在统计学,而在于您所交易的关系也在与所有发现相同关系的人竞争。它们有效时会吸引资金。当吸引的资金过多时,它们就会失效,有时是逐渐失效,有时是一瞬间,正如 2007 年所示。
关于统计基础、平稳性检验与时间序列建模,Time Series Analysis in Python 课程是合适的下一步。关于回测与量化工作流,Financial Trading in Python 课程涵盖了策略的实务实现与评估。