
คอร์ส
การสร้างแบบจำลองทางการเงินใน Excel
3 ชม.
28.2K
ลองนึกภาพว่ากำลังจับตาสเปรดระหว่างหุ้นสายการบินสองบริษัทที่มักเคลื่อนไหวไปด้วยกันเพราะมีต้นทุนน้ำมัน เส้นทางบิน และอุปสงค์ผู้โดยสารคล้ายกัน เช้าวันหนึ่งสเปรดกลับกว้างขึ้นอย่างมาก: มีเหตุปัจจัยเฉพาะกระทบหุ้นตัวหนึ่ง ขณะที่อีกตัวแทบไม่ขยับ เทรดเดอร์เชิงปริมาณมองภาพนี้แล้วจะถามคำถามเฉพาะเจาะจงว่า: สเปรดนั้นมีแนวโน้มจะแคบลงกลับมา หรือมีการเปลี่ยนแปลงเชิงโครงสร้างบางอย่างเกิดขึ้น?
Mean reversion คือแนวโน้มที่ตัวแปรจะเคลื่อนกลับไปสู่ระดับระยะยาวหลังจากเบี่ยงออกไป แนวคิดนี้เป็นพื้นฐานของแบบจำลองอนุกรมเวลาหลากหลายและยุทธศาสตร์การเทรดเชิงปริมาณ และเป็นกลไกทางสถิติของแนวทางทั้งตระกูลที่เรียกว่า statistical arbitrage ประเด็นสำคัญที่ต้องจำไว้ ซึ่งบทความนี้จะย้ำอยู่เรื่อยๆ คือ: mean reversion เป็นคุณสมบัติที่ต้องทดสอบ ไม่ใช่สมมติฐานที่ตั้งกับราคา
Mean reversion อธิบายแนวโน้มแบบไดนามิก: เมื่อค่าตัวแปรลื่นไถลออกจากระดับดุลยภาพ จะมีแรงดึงพากลับ ระดับดุลยภาพนั้นอาจเป็นค่าเฉลี่ยระยะยาวตามสถิติ มูลค่ายุติธรรมตามปัจจัยพื้นฐาน หรือความสัมพันธ์แบบโคอินทิเกรตระหว่างสองอนุกรม ค่าเบี่ยงเบนด้านบวก (ค่าที่อยู่เหนือค่าเฉลี่ย) มักตามด้วยการปรับลง ค่าเบี่ยงเบนด้านลบมักตามด้วยการปรับขึ้น
สิ่งที่ทำให้ mean reversion น่าสนใจคือสิ่งที่บอกเป็นนัยเกี่ยวกับช็อก ในกระบวนการที่ย้อนกลับเข้าสู่ค่าเฉลี่ย ช็อกเป็นเรื่องชั่วคราว ผลกระทบจะค่อยๆ จางหายไป และอนุกรมจะกลับสู่ดุลยภาพ แตกต่างจาก random walk อย่างมาก ซึ่งทุกช็อกเป็นถาวร และอนุกรมไม่มี “บ้าน” ให้กลับ เดี๋ยวจะอธิบายความแตกต่างนี้อย่างเป็นระบบในอีกสักครู่
สัญชาตญาณพื้นฐานคือ ตัวแปรหนึ่งผันผวนรอบระดับดุลยภาพ ช็อก (เช่น กำไรต่ำกว่าคาด นโยบายเซอร์ไพรส์ สภาพคล่องตึงตัว) ทำให้มันถูกผลักออกห่าง ยิ่งเคลื่อนไกล แรงดึงกลับอาจยิ่งแข็งแกร่ง เมื่อเวลาผ่านไป ผลของช็อกจะจาง และค่าตัวแปรจะค่อยๆ กลับเข้าใกล้เดิม
เปรียบเทียบกับ random walk ค่าของแต่ละช่วงเท่ากับค่าช่วงก่อนหน้าบวกช็อกแบบสุ่ม และช็อกนั้นไม่เคยหายไป ไม่มีดุลยภาพให้กลับ อนุกรมจึงเร่ร่อนไปมา ความแตกต่างนี้สำคัญมากต่อการพยากรณ์: อนุกรมที่ย้อนกลับเข้าสู่ค่าเฉลี่ยนั้น อย่างน้อยตามหลักการ ย่อมพอคาดเดาได้บ้างในระยะยาว ขณะที่ random walk ทำไม่ได้
การขยับจากสัญชาตญาณไปสู่หลักฐานต้องอาศัยการวิเคราะห์ทางสถิติ ไม่มีการทดสอบใดทดสอบเดียวที่เพียงพอ ต้องการหลักฐานหลายรูปแบบที่ชี้ไปทางเดียวกัน
เริ่มจากภาพรวมด้วยสายตา อนุกรมที่ย้อนกลับเข้าสู่ค่าเฉลี่ยมักแกว่งรอบระดับที่ค่อนข้างคงที่ แทนที่จะลื่นไถลขึ้นหรือลงต่อเนื่อง แต่การดูด้วยตาอาจหลอกได้ง่าย: อนุกรมที่เป็นเทรนด์อาจดูเหมือนย้อนกลับเข้าสู่ค่าเฉลี่ยเมื่อดูช่วงสั้นๆ และกระบวนการที่ย้อนกลับช้ามากอาจดูแทบไม่ต่างจาก random walk กราฟจึงเป็นเพียงด่านแรก ไม่ใช่คำตัดสิน
ออโตคอรีเลชันวัดค่าสหสัมพันธ์ระหว่างอนุกรมกับค่าที่ล่าช้าของตัวเอง ในกระบวนการที่ย้อนกลับเข้าสู่ค่าเฉลี่ย ฟังก์ชันออโตคอรีเลชัน (ACF) จะลดลงอย่างรวดเร็วเข้าใกล้ศูนย์ สะท้อนธรรมชาติชั่วคราวของความเบี่ยงเบน ตรงกันข้าม กระบวนการที่มี unit root จะแสดงออโตคอรีเลชันที่คงอยู่ใกล้ 1.0 แม้ที่ระยะล่าช้ายาว กราฟ ACF ช่วยเผยรูปแบบนี้ได้ — การลดลงอย่างรวดเร็วสอดคล้องกับ mean reversion ขณะที่การลดลงช้าๆ แบบเชิงเส้นบ่งชี้ non-stationarity อย่างไรก็ดี ออโตคอรีเลชันเพียงอย่างเดียวไม่ยืนยัน stationarity มันเป็นเพียงหลักฐานส่วนหนึ่ง
การทดสอบ Augmented Dickey-Fuller (ADF) เป็นจุดเริ่มต้นมาตรฐาน โดยทดสอบสมมติฐานศูนย์ว่าอนุกรมมี unit root ซึ่งหมายถึงเป็น random walk การปฏิเสธสมมติฐานศูนย์บ่งชี้ว่าอนุกรมอาจ stationary ซึ่งสอดคล้องอย่างใกล้ชิดกับพฤติกรรมที่ย้อนกลับเข้าสู่ค่าเฉลี่ย ค่า p-value ต่ำกว่า 0.05 ให้เหตุผลเพียงพอให้ดำเนินต่อ แม้ยังไม่ใช่ความแน่นอน
หากผลทดสอบสนับสนุน mean reversion คำถามถัดไปคือมันเกิดเร็วแค่ไหน พารามิเตอร์ความเร็ว (มักเขียนเป็น κ ในแบบจำลองเวลาต่อเนื่อง หรือ θ ในการพารามิเตอร์ไรซ์บางแบบ) บอกว่า deviation สลายเร็วเพียงใด ค่าสูงหมายถึง deviation หดตัวไว ค่าต่ำหมายถึงกระบวนการเร่ร่อนไปมากก่อนกลับ สิ่งนี้สำคัญเชิงปฏิบัติ: กระบวนการที่ย้อนกลับช้ามากอาจไม่สามารถเทรดได้ในกรอบเวลาที่เป็นจริง
ความแตกต่างนี้สมควรมีหัวข้อของตัวเอง เพราะมักเป็นจุดที่คนเข้าใจผิดบ่อยที่สุด
Random walk ไม่มีค่าเฉลี่ยระยะยาวให้ย้อนกลับ ช็อกเป็นถาวร อนุกรมเป็นแบบไม่สถานี (non-stationary) หมายถึงคุณสมบัติทางสถิติ (ค่าเฉลี่ย ความแปรปรวน) เปลี่ยนไปตามเวลา การพยากรณ์เกินระยะสั้นมากๆ แทบไร้ประโยชน์ กระบวนการที่ย้อนกลับเข้าสู่ค่าเฉลี่ยเป็นแบบสถานี (หรืออย่างน้อยก็ trend-stationary): คุณสมบัติคงที่ ช็อกเป็นชั่วคราว และการพยากรณ์ระยะยาวขึ้นมีข้อมูลที่มีความหมาย
กับดักคือ: ซีรีส์ราคาที่เคยกลับไปยังระดับหนึ่งหลายครั้งในอดีต ไม่จำเป็นต้องเป็น mean-reverting เดินนานพอ เมื่อใดก็จะย้อนกลับไปจุดเริ่มได้ใน random walk คำถามคือมีแรงดึงเชิงโครงสร้างกลับสู่ดุลยภาพหรือไม่ ซึ่งต้องอาศัยการทดสอบ ไม่ใช่การดูรูปแบบ
|
คุณสมบัติ |
Mean-reverting |
Random walk |
|
พฤติกรรมระยะยาว |
แกว่งรอบระดับที่เสถียร |
ลื่นไถลไปอย่างไร้ขอบเขต |
|
การคงอยู่ของช็อก |
ชั่วคราว |
ถาวร |
|
สภาพสถานี |
สถานี |
ไม่สถานี |
|
ความสามารถในการพยากรณ์ |
มี ในระยะเวลาที่ยาวขึ้น |
จำกัดมาก |
Mean reversion กับ stationarity เป็นอีกจุดที่ชวนสับสน ทั้งสองเกี่ยวข้องกันอย่างใกล้ชิด แต่ไม่ใช่เรื่องเดียวกัน Stationarity เป็นสมบัติทางสถิติแบบเป็นทางการ: กระบวนการที่เป็นสถานีมีค่าเฉลี่ยคงที่ ความแปรปรวนคงที่ และออโตโคเวเรียนซ์ขึ้นกับระยะล่าช้าเท่านั้น ไม่ขึ้นกับช่วงเวลา Mean reversion เป็นแนวโน้มเชิงไดนามิก คือแรงดึงกลับสู่ดุลยภาพ
แบบจำลอง mean-reverting ส่วนใหญ่สมมติให้เป็นสถานี และกระบวนการที่เป็นสถานีส่วนใหญ่ก็แสดงพฤติกรรมย้อนกลับสู่ค่าเฉลี่ยในบางรูปแบบ แต่ความสัมพันธ์ไม่ใช่หนึ่งต่อหนึ่งเสมอไป กระบวนการหนึ่งอาจเป็นสถานีได้โดยไม่มีไดนามิก mean-reverting ที่เด่นชัด และคำว่า “mean-reverting” บางครั้งถูกใช้หลวมๆ กับกระบวนการที่เป็นสถานีอย่างอ่อน ควรรักษาความแตกต่างนี้ให้ชัดเมื่ออ่านวรรณกรรม
Mean reversion กับ momentum ดึงไปคนละทิศ Mean reversion ถือว่าการเคลื่อนไหวที่ใหญ่ผิดปกติมีแนวโน้มจะย้อนกลับ หุ้นที่ร่วงแรงเมื่อเทียบกับช่วงทางประวัติศาสตร์คาดว่าจะฟื้น (ภายใต้มุมมองนี้) ไม่ใช่เพราะราคาต้องย้อนกลับ แต่เพราะความเบี่ยงเบนจากมูลค่ายุติธรรมสร้างโอกาสผลตอบแทน
Momentum ถือกลับกัน: ทิศทางล่าสุดมีแนวโน้มจะไปต่อ หุ้นที่ปรับขึ้นแรงใน 12 เดือนที่ผ่านมา คาดว่าจะยังคงชนะตลาด
หลักฐานของ momentum แข็งแรงมากในกรอบกลาง (1–12 เดือน) ขณะที่ mean reversion มักเห็นชัดในกรอบสั้น (วันถึงสัปดาห์) และยาวมาก (หลายปี) ตลาดสามารถแสดงทั้งสองพฤติกรรมพร้อมกันในสเกลเวลาต่างกัน และไม่มีข้อกฎสากลใดๆ
แบบจำลองเวลาต่อเนื่องมาตรฐานสำหรับพฤติกรรมย้อนกลับสู่ค่าเฉลี่ยคือกระบวนการ Ornstein-Uhlenbeck (OU):
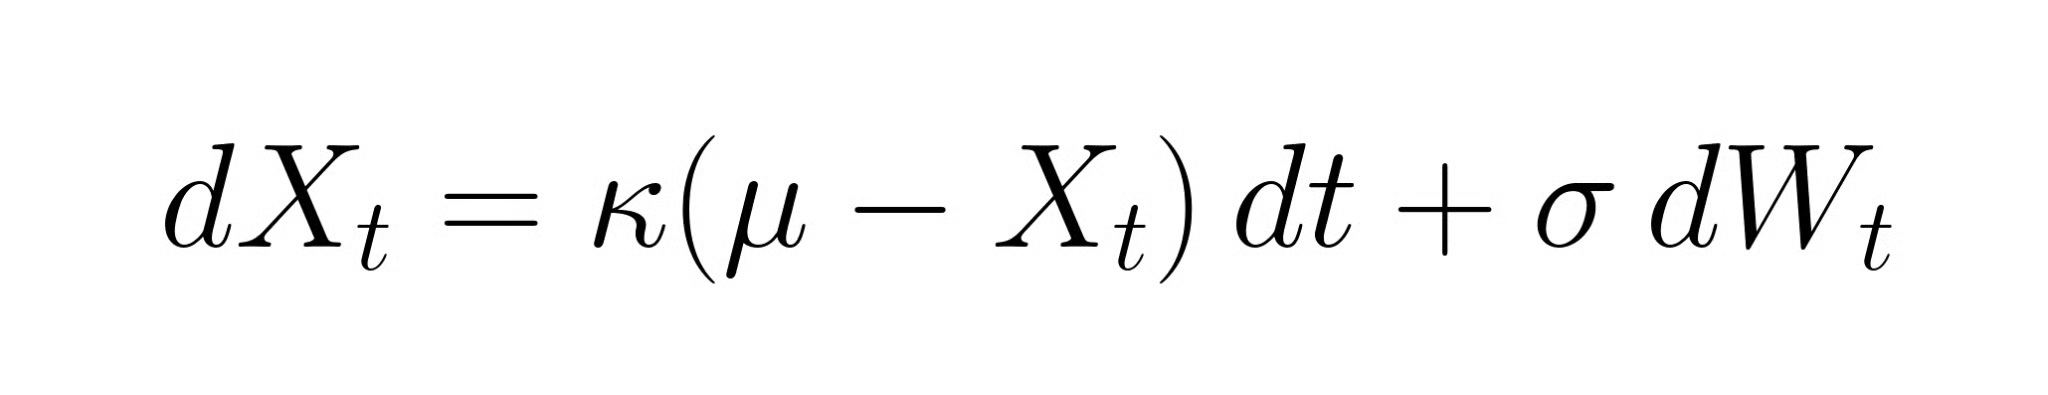
แต่ละเทอมมีหน้าที่เฉพาะ ส่วน κ(μ − Xt) คือแรงดึงกลับ: เมื่อ Xt อยู่เหนือค่าเฉลี่ยระยะยาว μ กระบวนการจะถูกดึงลง; เมื่ออยู่ต่ำกว่า จะถูกดึงขึ้น พารามิเตอร์ κ ควบคุมความแรงของแรงดึง ความเร็วของ mean reversion ส่วน σ dWt เพิ่มสัญญาณรบกวนแบบสุ่มที่มีความผันผวน σ
การจำลองเส้นทาง OU ด้วยค่า κ ต่างกันทำให้สัญชาตญาณชัดเจนขึ้น เมื่อ κ สูง เส้นทางจะเกาะค่าเฉลี่ยแน่น และความเบี่ยงเบนยุบตัวเร็ว เมื่อ κ ต่ำ เส้นทางจะเร่ร่อนกว้าง และในช่วงสั้นๆ ดูแทบไม่ต่างจาก random walk นี่จึงเป็นเหตุผลว่าทำไมการประมาณ κ อย่างรอบคอบจึงสำคัญ: κ ที่มีนัยสำคัญทางสถิติแต่เล็กมากอาจใช้งานจริงไม่ได้
แบบจำลอง OU ให้ค่า κ แต่ค่า κ เพียงอย่างเดียวเข้าใจเชิงสัญชาตญาณได้ยาก Half-life จะแปลงความเร็วเชิงนามธรรมให้เป็นสิ่งที่จับต้องได้: เวลาคาดหมายที่ความเบี่ยงเบนจากดุลยภาพจะหดลงครึ่งหนึ่ง
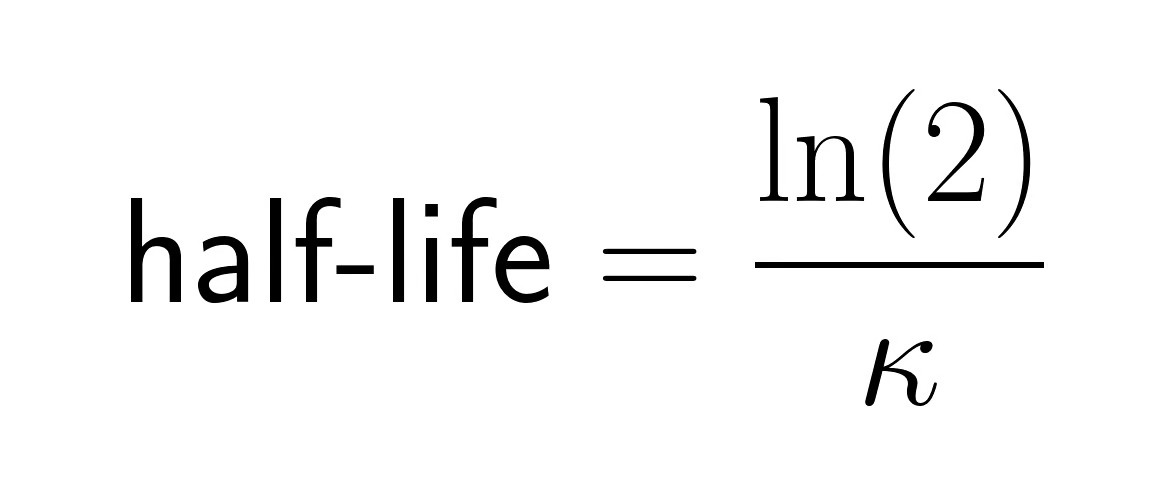
Half-life สามวันหมายถึงกระบวนการเร็ว ความเบี่ยงเบนยุบตัวภายในสัปดาห์ Half-life หกเดือนหมายถึงต้องถือสถานะนานเพื่อเก็บการย้อนกลับ ซึ่งนำความเสี่ยงอื่นๆ มาเอง เทรดเดอร์เชิงปริมาณจะเปรียบเทียบ half-life ที่ประเมินได้กับกรอบเวลาการถือครองเป้าหมายก่อนตัดสินใจใช้ยุทธศาสตร์
ข้อควรระวังหนึ่งประการ: half-life เป็นค่าคาดหมาย ไม่ใช่การรับประกัน ความเบี่ยงเบนใดๆ อาจคงอยู่นานกว่านั้นมาก โดยเฉพาะรอบการเปลี่ยนระบอบหรือจุดแตกหักเชิงโครงสร้าง
แล้ว mean reversion ปรากฏในตลาดการเงินจริงที่ไหนบ้าง? บางที่หลักฐานชัดเจน บางที่ไม่เท่าไร
สิ่งหนึ่งที่ควรเน้น: ราคาหุ้นรายตัวโดยทั่วไปเป็น non-stationary มักเป็นสเปรด ผลตอบแทน มาตรวัดความผันผวน หรือทรานส์ฟอร์เมชันอื่นๆ ที่แสดงพฤติกรรมย้อนกลับสู่ค่าเฉลี่ย ไม่ใช่ระดับราคาดิบ
ยังมีความแตกต่างเชิงแนวคิดอีกอย่างที่ทำให้แม้แต่ผู้มีประสบการณ์ในสายนี้สะดุด และการเข้าใจผิดทำให้ยุทธศาสตร์ถูกสร้างมาไม่ดี
สินทรัพย์สองตัวอาจมีคอร์รีเลชัน 0.95 แต่สเปรดเป็น random walk ได้เสมอ จงทดสอบทุกครั้ง
การเทรดเป็นคู่เป็นตัวอย่างที่ชัดที่สุดของการนำ mean reversion มาใช้จริง และอาจเป็นเหตุผลที่ทำให้มาถึงบทความนี้
เริ่มจากคัดเลือกสินทรัพย์สองตัวที่มีความสัมพันธ์ทางเศรษฐกิจระยะยาวที่สมเหตุสมผล: ผู้ผลิตน้ำมันรายใหญ่สองราย ธนาคารขนาดใหญ่สองแห่ง บริษัทสินค้าอุปโภคบริโภคพื้นฐานสองบริษัท เหตุผลทางเศรษฐกิจสำคัญมาก การสกรีนจากคอร์รีเลชันในอดีตเพียงอย่างเดียวโดยไร้ฐานปัจจัยพื้นฐานมักให้ความสัมพันธ์ลวงที่พังเมื่อออกนอกตัวอย่าง สร้างสเปรด โดยทั่วไปเป็นอัตราส่วนหรือการผสมเชิงเส้นของสองราคา ใช้อัตราส่วนเฮดจ์ที่ประมาณจากรีเกรสชันแทนการสมมติ 1:1 แบบไร้เดียงสา จากนั้นทดสอบว่าสเปรดนั้นเป็น mean-reverting หรือไม่ด้วยเครื่องมือข้างต้น: การทดสอบ ADF การวิเคราะห์ออโตคอรีเลชัน การประมาณ half-life หากหลักฐานสนับสนุน ก็ไปต่อ
ตัวเทรดเองค่อนข้างตรงไปตรงมา เมื่อสเปรดกว้างออกไกลจากค่าเฉลี่ยในอดีตอย่างผิดปกติ วัดด้วย z-score ที่ทำให้ความเบี่ยงเบนเป็นมาตรฐานโดย (สเปรดปัจจุบันลบค่าเฉลี่ยเคลื่อนที่) หารด้วยส่วนเบี่ยงเบนมาตรฐาน ให้เข้าซื้อหุ้นที่ตามหลังและชอร์ตหุ้นที่นำหน้า โดยคาดว่าสเปรดจะกลับแคบลง ค่า z-score ที่ +2 บ่งชี้ว่าสเปรดสูงกว่าค่าปกติในอดีตสองส่วนเบี่ยงเบนมาตรฐาน แนวทางทั่วไปคือเข้าเมื่อ ±2.0 และออกเมื่อย้อนกลับเข้าใกล้ศูนย์ ประเด็นสำคัญที่มักถูกละเลยในคำอธิบายง่ายๆ: เป็นสเปรดที่คาดว่าจะย้อนกลับ ไม่ใช่หุ้นรายตัว โครงสร้าง long/short ยังช่วยลดการเปิดรับทิศทางตลาดกว้าง กำไรมาจากการเคลื่อนแปรสัมพันธ์ ไม่ใช่ทิศตลาด
การเทรดเป็นคู่เป็นจุดเริ่มต้นที่เข้าใจง่ายของยุทธศาสตร์ mean reversion แต่เป็นเพียงหนึ่งกรณีของแนวทางที่กว้างกว่าซึ่งเรียกว่า statistical arbitrage.
Statistical arbitrage (stat arb) ใช้ความสัมพันธ์ทางสถิติระหว่างหลักทรัพย์เพื่อมองหา mispricing เชิงสัมพัทธ์: เมื่อหลักทรัพย์ที่เชื่อมโยงกันตามประวัติศาสตร์แยกออกจากความสัมพันธ์ที่คาดไว้ชั่วคราว ให้เดิมพันว่ามันจะบรรจบ ชี้แจงสำคัญ: statistical arbitrage ไม่ใช่อาร์บิทราจไร้ความเสี่ยง อาร์บิทราจแบบดั้งเดิมอาศัยความไม่สอดคล้องด้านราคาที่แทบเป็นกลไกเดียวกัน สินทรัพย์เดียวกันซื้อขายต่างราคาบนสองตลาด ที่ซึ่งกำไรแทบแน่นอนหากทำได้เร็วพอ ส่วน statistical arbitrage เดิมพันกับการบรรจบแบบมีความน่าจะเป็น โปรไฟล์ความเสี่ยงแตกต่างกันโดยสิ้นเชิง
มีแนวคิดการเทรดแบบ mean reversion หลากหลาย ต่อไปนี้เป็นบางส่วน:
ขอพูดตรงๆ: สัญญาณทางสถิติไม่ได้รับประกันการบรรจบที่ทำกำไร ต้นทุนธุรกรรม ต้นทุนการกู้หลักทรัพย์ และการเปลี่ยนระบอบ สามารถลบล้างความได้เปรียบที่เห็นได้ทั้งหมด ยุทธศาสตร์ข้างต้นบรรยายเงื่อนไขการเข้า ไม่ใช่เงื่อนไขการทำเงิน
มาถึงส่วนปฏิบัติ โค้ดด้านล่างพาไล่ทำการวิเคราะห์ mean reversion อย่างกระชับบนสเปรดจำลอง ครอบคลุมสิ่งจำเป็น: การพล็อต ค่าเฉลี่ยแบบกลิ้ง การทดสอบ ADF และการประมาณ half-life นำสเปรดจริงมาแทน เช่น อัตราส่วนราคาล็อกของหุ้นสองตัวที่โคอินทิเกรต แล้วใช้ไปป์ไลน์เดียวกันได้
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.stattools import adfuller
from statsmodels.regression.linear_model import OLS

# Simulate a mean-reverting spread using an AR(1) process
np.random.seed(42)
n = 500
phi = 0.92          # AR coefficient; close to 1 = slow mean reversion
spread = np.zeros(n)
for t in range(1, n):
    spread[t] = phi * spread[t-1] + np.random.normal(0, 1)

spread_series = pd.Series(spread, name="spread")

# --- Step 1: Plot the series with its rolling mean ---
rolling_mean = spread_series.rolling(window=60).mean()
plt.figure(figsize=(10, 4))
plt.plot(spread_series, label="Spread", alpha=0.7)
plt.plot(rolling_mean, label="60-period rolling mean", linewidth=2)
plt.axhline(0, color="black", linestyle="--", linewidth=0.8)
plt.title("Simulated Mean-Reverting Spread")
plt.legend()
plt.tight_layout()
plt.show()

# --- Step 2: ADF test for stationarity ---
adf_result = adfuller(spread_series.dropna())
print(f"ADF statistic : {adf_result[0]:.4f}")
print(f"p-value       : {adf_result[1]:.4f}")
print("Reject unit root?", "Yes" if adf_result[1] < 0.05 else "No")

# --- Step 3: Estimate half-life via AR(1) regression —
lagged = spread_series.shift(1).dropna()
delta  = spread_series.diff().dropna()
model  = OLS(delta, lagged).fit()
kappa  = -model.params.iloc[0]           # speed of mean reversion
half_life = np.log(2) / kappa
print(f"\nEstimated half-life: {half_life:.1f} periods")
เมื่อรันด้วย seed ข้างต้น จะได้ p-value ต่ำกว่า 0.05 มาก และ half-life ราวเจ็ดช่วง ค่าเชิงทฤษฎีสำหรับ φ = 0.92 ประมาณ 8.7 ช่วง; แต่ละครั้งรันจะผันผวนรอบค่านั้น โปรดจำไว้ว่า การตีความสำคัญกว่ากลไก ผล ADF ที่มีนัยสำคัญบนหน้าต่างประวัติศาสตร์ไม่ได้หมายความว่าความสัมพันธ์จะคงอยู่ต่อไปข้างหน้า รีเกรสชันนี้ละเว้นอินเตอร์เซปต์ ซึ่งใช้ได้กับข้อมูลที่มีค่าเฉลี่ยเป็นศูนย์ สำหรับสเปรดจริงที่มีค่าเฉลี่ยไม่เป็นศูนย์ ให้เพิ่มค่าคงที่ด้วย add_constant(lagged) แล้วดึงสัมประสิทธิ์ตัวที่สอง
คอร์ส Time Series Analysis in Python ของเราเจาะลึกเทคนิคเหล่านี้ รวมถึง การจำลองแบบ ARIMA การทดสอบสถานี และการพยากรณ์
Mean reversion ล้มเหลวในรูปแบบที่พอเดาได้ การรู้โหมดความล้มเหลวมีประโยชน์พอๆ กับการรู้ยุทธศาสตร์
ระดับดุลยภาพในอดีตถูกประมาณจากข้อมูล และข้อมูลสะท้อนอดีต การเปลี่ยนแปลงเชิงโครงสร้าง (การควบรวม การเปลี่ยนแปลงกฎระเบียบ การเปลี่ยนพลวัตการแข่งขัน) อาจทำให้ค่าเฉลี่ยในอดีตใช้ไม่ได้เลย สเปรดที่คิดว่าเป็น mean-reverting ไปศูนย์ อาจมีดุลยภาพใหม่ที่ +50 เบสิสพอยต์ การใช้ยุทธศาสตร์บนค่าเฉลี่ยเดิมเป็นหนทางสู่การขาดทุนที่เชื่อถือได้ เฉพาะใน pairs trading บริษัทอาจควบรวม แยกทาง หรือเปลี่ยนโมเดลธุรกิจ และคู่ที่โคอินทิเกรตแน่นมาห้าปีอาจหลุดกันข้ามคืน
ในตัวอย่างช่วงสั้น อนุกรมที่เป็นเทรนด์อาจดูเหมือนย้อนกลับเข้าสู่ค่าเฉลี่ยเพียงเพราะย้อนกลับสู่ค่าเฉลี่ยเคลื่อนที่ท้องถิ่น สิ่งนี้พบได้บ่อยในแบ็กเทสต์ที่ใช้หน้าต่างมองย้อนคงที่ วิธีแก้คือทดสอบครอบคลุมหลายช่วงตัวอย่าง และระแวงผลที่ปรากฏเฉพาะหน้าต่างแคบๆ
การเทรดถี่บั่นทอนผลตอบแทน ยุทธศาสตร์ที่มี half-life สองวันอาจต้องรีบาลานซ์รายวัน และต้นทุนรอบทิศทางสามารถเกินกำไรคาดหมายต่อเทรดได้ง่าย การชอร์ตเพิ่มต้นทุนต่อ: ค่าธรรมเนียมยืมหุ้นและความเสี่ยงถูกบังคับซื้อคืนโดยโบรกเกอร์ สลิปเพจระหว่างราคาที่จำลองกับราคาจริงสะสมผ่านหลายร้อยเทรด ผลตอบแทนบนกระดาษกับผลตอบแทนจริงอาจต่างกันมากสำหรับยุทธศาสตร์ mean reversion ความถี่สูง
เมื่อหลายกองทุนรันยุทธศาสตร์คล้ายกัน พวกเขาจะเปิดรับพฤติกรรมของกันและกัน เหตุการณ์สิงหาคม 2007 ที่กองทุนควอนต์ล่ม เกิดขึ้นเพราะกองทุน stat arb หุ้นจำนวนมากชำระสถานะพร้อมกัน พากันล้มเป็นโดมิโนซึ่งไม่เกี่ยวกับความสัมพันธ์พื้นฐานที่ยุทธศาสตร์ตั้งอยู่ เมื่อยุทธศาสตร์เวิร์ก มันดึงดูดทุน; เมื่อทุนมากเกินไป มันหยุดเวิร์ก บางครั้งค่อยเป็นค่อยไป บางครั้งในพริบตา
แบบจำลอง stat arb ถูกปรับให้เข้ากับสภาพตลาดหนึ่งๆ: ระบอบความผันผวน วัฏจักรดอกเบี้ย โครงสร้างคอร์รีเลชัน เมื่อสภาพนั้นเปลี่ยน สมมติฐานทุกอย่างจะขยับพร้อมกัน ไม่ใช่แค่คู่หนึ่งพัง; แต่ทั้งพอร์ตผิดเพี้ยน เพราะคุณสมบัติทางสถิติที่วางพื้นไว้ไม่เป็นจริงอีกต่อไป หน้าต่างมองย้อนทางประวัติศาสตร์จะไม่เตือนล่วงหน้า
ผลลัพธ์ขึ้นกับหน้าต่างมองย้อนที่ใช้ประมาณค่าเฉลี่ย เกณฑ์เข้าเทรด และกฎออก อย่างมาก การเปลี่ยนเพียงเล็กน้อยในสิ่งเหล่านี้อาจพลิกยุทธศาสตร์จากมีกำไรเป็นขาดทุนได้ ทดสอบความทนทานต่อความแปรผันนี้อย่างชัดเจนก่อนเชื่อผลแบ็กเทสต์ใดๆ
ความเสี่ยงที่แยบคายที่สุด ด้วยพารามิเตอร์มากพอและข้อมูลประวัติศาสตร์มากพอ สามารถฟิตยุทธศาสตร์ให้เข้ากับเกือบทุกช่วงอดีต และมันจะเสื่อมลงอย่างแรงในการเทรดจริง การทดสอบแบบวอล์กฟอร์เวิร์ดและการตรวจสอบนอกตัวอย่างไม่ใช่ทางเลือก แต่เป็นสิ่งจำเป็น
Mean reversion เป็นแนวคิดที่ดูง่ายจนกว่าจะลองใช้ ความคิดพื้นฐานว่าความเบี่ยงเบนจากดุลยภาพมักย้อนกลับนั้นเข้าใจได้ไม่ยาก ที่ยากกว่าคือการพิสูจน์ว่าอนุกรมใดอนุกรมหนึ่งมีคุณสมบัตินี้จริง การประมาณว่ากลับเร็วแค่ไหน และการสร้างยุทธศาสตร์ที่รอดพ้นต้นทุนธุรกรรม การเปลี่ยนระบอบ และความไม่แน่นอนของพารามิเตอร์ Statistical arbitrage ทำให้ความท้าทายนี้เป็นวินัยการเทรดที่เป็นระบบ แต่แก่นปัญหายังเหมือนเดิม: ความสัมพันธ์ที่กำลังเทรดกำลังแข่งกับทุกคนที่พบความสัมพันธ์เดียวกัน
ข้อคิดที่ควรจำ: ทดสอบก่อนจะสันนิษฐาน; ใส่ใจว่าสิ่งใดกำลังย้อนกลับ (สเปรดและทรานส์ฟอร์เมชัน ไม่ใช่ราคาดิบ); แยกให้ชัดระหว่างคอร์รีเลชันกับโคอินทิเกรชัน เพราะแทนกันไม่ได้; และมองความเสี่ยงข้างต้นเป็นส่วนหนึ่งของยุทธศาสตร์ ไม่ใช่ภายหลัง คอร์ส Time Series Analysis in Python ของเราครอบคลุมการทดสอบสถานี การจำลอง ARIMA และการพยากรณ์อย่างลึกซึ้ง สำหรับการประยุกต์ด้านการเทรดโดยเฉพาะ Financial Trading in Python ครอบคลุมการลงมือทำและประเมินยุทธศาสตร์เชิงปริมาณในทางปฏิบัติ
เรียนรู้กับ DataCamp
คอร์ส
คอร์ส
คอร์ส