Kurs
Finanzmodellierung in Excel
3 Std.
28.2K
Stell dir vor, du beobachtest den Spread zwischen zwei Airline-Aktien – Unternehmen, die sich meist ähnlich bewegen, weil sie dieselben Treibstoffkosten, Strecken und Nachfragetreiber teilen. Eines Morgens weitet sich der Spread deutlich: Ein idiosynkratischer Schock trifft das eine Ticker, während das andere kaum reagiert. Eine Quant-Traderin stellt sich nun eine sehr konkrete Frage: Wird sich dieser Spread wahrscheinlich wieder einengen – oder hat sich strukturell etwas verändert?
Mean Reversion ist die Tendenz einer Variablen, nach einer Abweichung wieder in Richtung eines langfristigen Niveaus zurückzukehren. Sie bildet die Grundlage vieler Zeitreihenmodelle und quantitativer Handelsstrategien und ist der statistische Motor hinter einer ganzen Familie von Ansätzens, die als Statistical Arbitrage bekannt sind. Das entscheidende – und darauf kommen wir in diesem Artikel immer wieder zurück: Mean Reversion ist eine Eigenschaft, die du testest, nicht eine Annahme, die du über Preise triffst.
Mean Reversion beschreibt eine dynamische Tendenz: Wenn eine Variable von ihrem Gleichgewichtsniveau abdriftet, wirken Kräfte, die sie zurückziehen. Dieses Gleichgewicht kann ein langfristiger statistischer Mittelwert sein, ein von Fundamentaldaten implizierter Fair Value oder eine kointegrete Beziehung zwischen zwei Reihen. Eine positive Abweichung (Wert liegt über dem Mittel) wird tendenziell von einem Rückgang gefolgt. Eine negative Abweichung tendenziell von einem Anstieg.
Spannend wird Mean Reversion wegen der Implikation für Schocks. In einem mean-revertierenden Prozess ist ein Schock temporär. Seine Wirkung klingt mit der Zeit ab, und die Reihe kehrt schließlich Richtung Gleichgewicht zurück. Das unterscheidet sich grundlegend von einem Random Walk, bei dem jeder Schock dauerhaft ist und die Reihe kein „Zuhause“ hat, zu dem sie zurückkehrt. Auf diese Unterscheidung kommen wir gleich ausführlicher.
Die grundlegende Intuition: Eine Variable schwankt um ein Gleichgewichtsniveau. Ein Schock (ein Earnings-Miss, eine Politiküberraschung, ein Liquiditätsengpass) drückt sie davon weg. Je weiter sie sich entfernt, desto stärker kann die Rückstellkraft wirken. Mit der Zeit lässt die Wirkung des Schocks nach, und die Variable driftet zurück.
Im Kontrast dazu ein Random Walk: Der Wert jeder Periode entspricht dem der Vorperiode plus einem zufälligen Schock – und dieser verschwindet nie. Es gibt kein Gleichgewicht, zu dem man zurückkehrt; die Reihe wandert einfach. Für Prognosen ist der Unterschied enorm: Mean-revertierende Reihen sind prinzipiell über längere Horizonte etwas vorhersagbar. Random Walks sind es nicht.
Von der Intuition zur Evidenz kommst du nur mit Statistik. Kein einzelner Test reicht aus. Du willst mehrere Belege, die in dieselbe Richtung zeigen.
Starte visuell. Eine mean-revertierende Reihe oszilliert eher um ein relativ stabiles Niveau, statt dauerhaft zu trenden. Aber Vorsicht: Die Optik kann täuschen. Eine trendende Reihe kann über kurze Fenster mean-revertierend aussehen, und ein langsam mean-revertierender Prozess kann fast nicht von einem Random Walk zu unterscheiden sein. Der Plot ist ein erster Eindruck, kein Urteil.
Autokorrelation misst die Korrelation einer Reihe mit ihren verzögerten Werten. In einem mean-revertierenden Prozess fällt die Autokorrelationsfunktion (ACF) rasch gegen null – ein Zeichen für die vorübergehende Natur von Abweichungen. Ein Unit-Root-Prozess zeigt stattdessen Autokorrelationen nahe 1,0 selbst bei großen Lags. Das ACF-Diagramm kann dieses Muster zeigen: Ein schneller Abfall passt zu Mean Reversion, ein langsamer, linearer Rückgang deutet auf Nichtstationarität hin. Aber: Autokorrelation allein bestätigt keine Stationarität. Es ist nur ein Baustein.
Der Augmented-Dickey-Fuller-(ADF)-Test ist der Standardstart. Die Nullhypothese besagt, dass die Reihe eine Unit Root hat, also ein Random Walk ist. Wird die Null verworfen, spricht das für Stationarität – und damit nahegelegt mean-revertierendes Verhalten. Ein p-Wert unter 0,05 gibt dir eine Grundlage weiterzumachen, aber keine Gewissheit.
Wenn die Tests Mean Reversion stützen, lautet die nächste Frage: Wie schnell passiert sie? Der Geschwindigkeitsparameter (in Stetigzeitmodellen oft mit κ bezeichnet, teils auch mit θ) gibt an, wie rasch Abweichungen abklingen. Hohe Geschwindigkeit bedeutet, Abweichungen schrumpfen schnell; niedrige Geschwindigkeit heißt, der Prozess wandert länger, bevor er zurückkehrt. Praktisch wichtig: Ein sehr langsamer mean-revertierender Prozess ist über realistische Horizonte oft nicht handelbar.
Diese Unterscheidung verdient ein eigenes Kapitel, weil sie am häufigsten falsch verstanden wird.
Ein Random Walk hat keinen langfristigen Mittelwert, zu dem er zurückkehrt. Schocks sind dauerhaft. Die Reihe ist nicht stationär – ihre statistischen Eigenschaften (Mittelwert, Varianz) ändern sich über die Zeit. Prognosen über den sehr kurzen Horizont hinaus sind zwecklos. Ein mean-revertierender Prozess ist stationär (oder zumindest trendstationär): Eigenschaften sind stabil, Schocks sind vorübergehend, und längerfristige Prognosen tragen echte Information.
Die Falle dabei: Eine Preisreihe, die historisch mehrmals zu einem bestimmten Niveau zurückgekehrt ist, ist nicht automatisch mean-revertierend. Wartest du lange genug, kehrt jeder Random Walk irgendwann zu seinem Startwert zurück. Die Frage ist, ob es eine strukturelle Rückführung zum Gleichgewicht gibt – und das erfordert Tests, keine Mustererkennung.
|
Eigenschaft |
Mean-revertierend |
Random Walk |
|
Langfristiges Verhalten |
Oszilliert um stabiles Niveau |
Driftet unbegrenzt |
|
Persistenz von Schocks |
Vorübergehend |
Dauerhaft |
|
Stationarität |
Stationär |
Nicht stationär |
|
Prognostizierbarkeit |
Ja, über längere Horizonte |
Sehr begrenzt |
Mean Reversion und Stationarität führen ebenfalls oft zu Verwirrung. Beides hängt eng zusammen, ist aber nicht identisch. Stationarität ist eine formale statistische Eigenschaft: Eine stationäre Reihe hat konstanten Mittelwert, konstante Varianz und eine Autokovarianz, die nur vom Lag abhängt, nicht vom Zeitpunkt. Mean Reversion ist eine dynamische Tendenz, die Rückführung zum Gleichgewicht.
Die meisten Mean-Reversion-Modelle setzen Stationarität voraus, und die meisten stationären Prozesse zeigen irgendeine Form der Mean Reversion. Aber die Beziehung ist nicht perfekt eins zu eins. Ein Prozess kann stationär sein, ohne stark mean-revertierende Dynamik zu haben, und „mean-revertierend“ wird in der Literatur teils locker für schwach stationäre Prozesse verwendet. Es lohnt sich, die Unterscheidung im Blick zu behalten.
Mean Reversion und Momentum ziehen in entgegengesetzte Richtungen. Mean Reversion unterstellt, dass ungewöhnlich starke Bewegungen eher zur Umkehr neigen. Eine Aktie, die relativ zu ihrer Historie stark gefallen ist, sollte sich (unter dieser Sicht) erholen – nicht weil Preise „müssen“, sondern weil die Abweichung vom Fair Value eine Renditechance schafft.
Momentum nimmt das Gegenteil an: Jüngste Richtungsbewegungen setzen sich eher fort. Eine Aktie, die in den letzten zwölf Monaten stark gestiegen ist, wird voraussichtlich weiter überperformen.
Für Momentum ist die Evidenz auf mittleren Horizonten (ein bis zwölf Monate) recht stark, während Mean Reversion deutlicher auf kurzen (Tage bis Wochen) und sehr langen (mehrjährige) Horizonten auftritt. Märkte können beide Muster gleichzeitig auf unterschiedlichen Zeitskalen zeigen. Keines ist ein Naturgesetz.
Das Standardmodell in stetiger Zeit für mean-revertierendes Verhalten ist der Ornstein-Uhlenbeck-(OU)-Prozess:
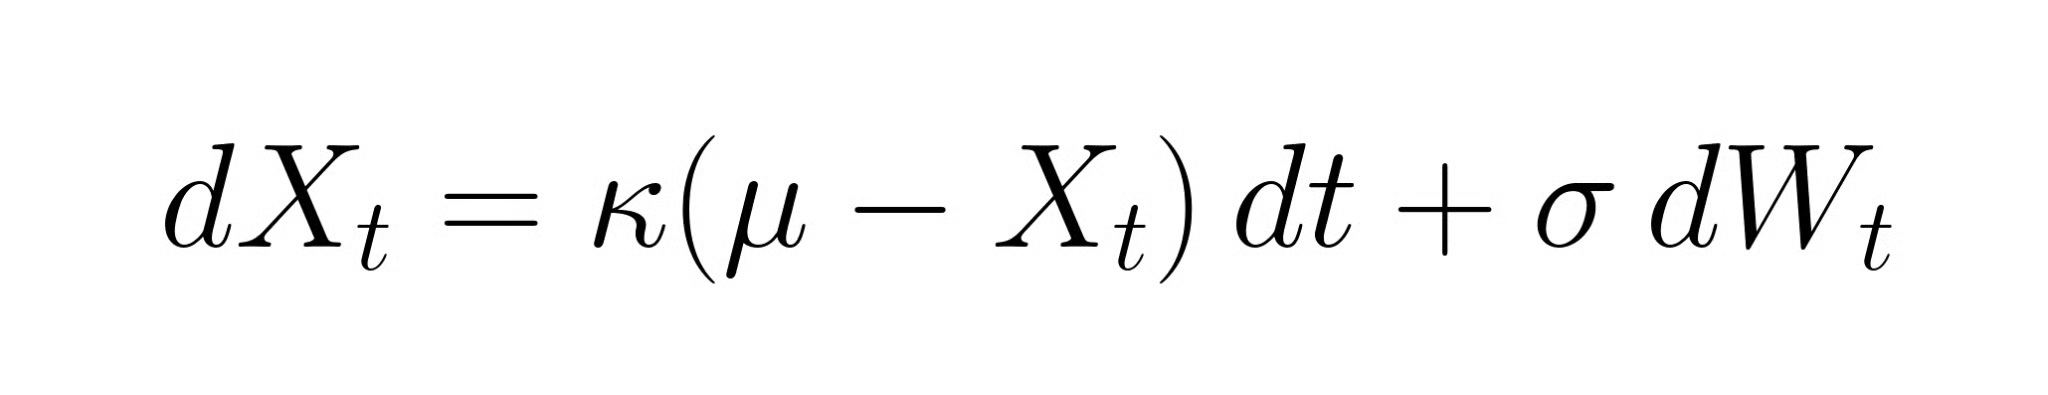
Jeder Term hat eine klare Rolle. Der Teil κ(μ − Xt) ist die Rückstellkraft: Liegt Xt über dem langfristigen Mittel μ, wird der Prozess nach unten gezogen; darunter nach oben. Der Parameter κ steuert die Stärke dieses Zugs – die Geschwindigkeit der Mean Reversion. Der Term σ dWt fügt Rauschen mit Volatilität σ hinzu.
OU-Pfade mit unterschiedlichen κ-Werten zu simulieren macht die Intuition greifbar. Bei hohem κ schmiegen sich Pfade eng an den Mittelwert, Abweichungen kollabieren schnell. Bei niedrigem κ wandern Pfade weit und sehen über kurze Fenster fast wie ein Random Walk aus. Deshalb ist die sorgfältige Schätzung von κ so wichtig: Ein statistisch signifikanter, aber winziger κ ist in der Praxis oft nicht nutzbar.
Das OU-Modell liefert κ, aber κ allein ist intuitiv schwer greifbar. Die Halbwertszeit übersetzt diese abstrakte Geschwindigkeit in etwas Konkretes: die erwartete Zeit, bis eine Abweichung vom Gleichgewicht auf die Hälfte geschrumpft ist.
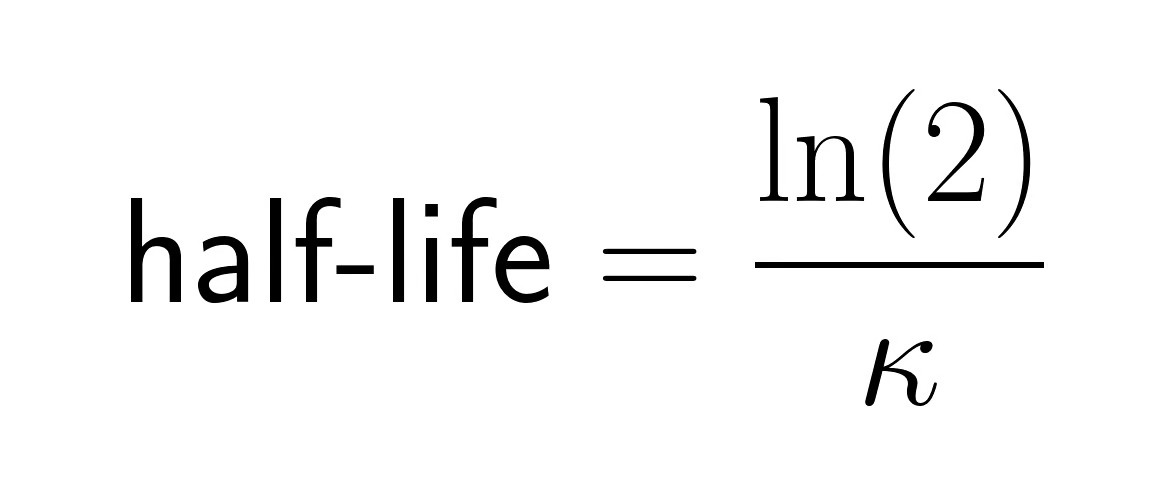
Eine Halbwertszeit von drei Tagen bedeutet: Der Prozess ist schnell; Abweichungen kollabieren innerhalb einer Woche. Sechs Monate Halbwertszeit bedeuten: Du brauchst eine lange Haltedauer, um die Rückkehr einzufangen – mit entsprechenden Risiken. Quant-Trader vergleichen die geschätzte Halbwertszeit mit ihren Ziel-Haltedauern, bevor sie eine Strategie umsetzen.
Ein Hinweis: Die Halbwertszeit ist ein Erwartungswert, keine Garantie. Einzelne Abweichungen können deutlich länger bestehen bleiben – vor allem bei Regimewechseln oder strukturellen Brüchen.
Wo zeigt sich Mean Reversion tatsächlich in Märkten? In manchen Bereichen ist die Evidenz solide, in anderen weniger.
Wichtig: Einzelne Aktienkurse sind im Allgemeinen nicht stationär. Es sind Spreads, Renditen, Volatilitätsmaße oder andere Transformationen, die eher mean-revertierendes Verhalten zeigen – nicht die Rohpreise.
Noch eine konzeptionelle Unterscheidung, über die selbst Erfahrene stolpern – und ein Missverständnis führt zu schlecht konstruierten Strategien.
Du kannst zwei Assets mit 0,95 Korrelation haben, deren Spread ein Random Walk ist. Immer testen.
Pairs Trading ist das klarste Praxisbeispiel für Mean Reversion – vielleicht bist du genau deswegen hier gelandet.
Du startest mit zwei Assets mit plausibler langfristiger ökonomischer Beziehung: zwei Öl-Majors, zwei Großbanken, zwei Konsumgüterkonzerne. Die ökonomische Begründung ist wichtig. Reines Screening nach historischen Korrelationen ohne Fundament führt oft zu Scheinkorrelationen, die out of sample zerfallen. Du konstruierst einen Spread – typischerweise ein Verhältnis oder eine Linearkombination der beiden Preise – mit einer Hedge-Ratio aus einer Regression statt der naiven 1:1-Annahme. Dann testest du, ob dieser Spread mean-revertiert – mit den oben genannten Tools: ADF-Test, Autokorrelationsanalyse, Halbwertszeit-Schätzung. Spricht die Evidenz dafür, gehst du weiter.
Der Trade selbst ist recht geradlinig. Weitet sich der Spread ungewöhnlich weit von seinem historischen Mittel, gemessen per z-Score als (aktueller Spread minus gleitender Mittelwert) geteilt durch Standardabweichung, kaufst du den Underperformer long und gehst den Outperformer short – in der Erwartung, dass der Spread enger wird. Ein z-Score von +2 signalisiert, dass der Spread zwei Standardabweichungen über dem historischen Niveau liegt; gängig ist der Einstieg bei ±2,0 und der Ausstieg bei einer Rückkehr Richtung null. Wichtig – und in vereinfachten Erklärungen oft verloren: Es ist der Spread, der mean-revertieren soll, nicht die einzelne Aktie. Die Long/Short-Struktur reduziert zudem die Marktrisikobelastung. Der Gewinn stammt aus der relativen Bewegung, nicht aus der Marktrichtung.
Pairs Trading ist der intuitivste Einstieg in Mean-Reversion-Strategien, aber nur ein Beispiel aus einer größeren Familie von Ansätzen namens Statistical Arbitrage.
Statistical Arbitrage (Stat Arb) nutzt statistische Beziehungen zwischen Wertpapieren, um relative Fehlbewertungen zu identifizieren: Wenn zwei historisch verbundene Titel vorübergehend von ihrer erwarteten Beziehung abweichen, wettest du auf Konvergenz. Wichtig: Statistical Arbitrage ist kein risikofreies Arbitragegeschäft. Klassische Arbitrage nutzt nahezu mechanische Preisunterschiede derselben Assets auf zwei Börsen – der Gewinn ist bei schneller Ausführung fast sicher. Statistical Arbitrage setzt auf probabilistische Konvergenz. Völlig andere Risikoprofile.
Es gibt verschiedene Ideen für Mean-Reversion-Trades. Hier sind einige davon:
Deutlich gesagt: Ein statistisches Signal garantiert keine profitable Konvergenz. Transaktionskosten, Leihgebühren und Regimewechsel können scheinbare Vorteile vollständig auffressen. Die Strategien oben beschreiben Einstiegsbedingungen – nicht Gewinnbedingungen.
Jetzt wird’s praktisch. Der folgende Code zeigt eine kompakte Mean-Reversion-Analyse auf einem simulierten Spread – inklusive Plot, rollierendem Mittel, ADF-Test und Halbwertszeit-Schätzung. Ersetze die Daten durch einen echten Pairs-Spread, z. B. das Log-Preisverhältnis zweier kointegrierter Aktien – die Pipeline bleibt dieselbe.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.stattools import adfuller
from statsmodels.regression.linear_model import OLS

# Simulate a mean-reverting spread using an AR(1) process
np.random.seed(42)
n = 500
phi = 0.92          # AR coefficient; close to 1 = slow mean reversion
spread = np.zeros(n)
for t in range(1, n):
    spread[t] = phi * spread[t-1] + np.random.normal(0, 1)

spread_series = pd.Series(spread, name="spread")

# --- Step 1: Plot the series with its rolling mean ---
rolling_mean = spread_series.rolling(window=60).mean()
plt.figure(figsize=(10, 4))
plt.plot(spread_series, label="Spread", alpha=0.7)
plt.plot(rolling_mean, label="60-period rolling mean", linewidth=2)
plt.axhline(0, color="black", linestyle="--", linewidth=0.8)
plt.title("Simulated Mean-Reverting Spread")
plt.legend()
plt.tight_layout()
plt.show()

# --- Step 2: ADF test for stationarity ---
adf_result = adfuller(spread_series.dropna())
print(f"ADF statistic : {adf_result[0]:.4f}")
print(f"p-value       : {adf_result[1]:.4f}")
print("Reject unit root?", "Yes" if adf_result[1] < 0.05 else "No")

# --- Step 3: Estimate half-life via AR(1) regression —
lagged = spread_series.shift(1).dropna()
delta  = spread_series.diff().dropna()
model  = OLS(delta, lagged).fit()
kappa  = -model.params.iloc[0]           # speed of mean reversion
half_life = np.log(2) / kappa
print(f"\nEstimated half-life: {half_life:.1f} periods")
Mit dem obigen Seed erhältst du einen p-Wert deutlich unter 0,05 und eine Halbwertszeit von etwa sieben Perioden. Der theoretische Wert für φ = 0,92 liegt bei rund 8,7 Perioden; einzelne Läufe schwanken darum. Wichtig: Interpretation schlägt Mechanik. Ein signifikanter ADF-Befund auf einem historischen Fenster garantiert nicht, dass die Beziehung künftig hält. Diese Regression lässt den Achsenabschnitt weg – das passt für Daten mit Nullmittel. Für reale Spreads mit Nichtnullmittel füge mit add_constant(lagged) eine Konstante hinzu und nimm den zweiten Koeffizienten.
Unser Time Series Analysis in Python Kurs geht deutlich tiefer – inklusive ARIMA-Modellierung, Stationaritätstests und Forecasting.
Mean Reversion scheitert auf vorhersehbare Weise. Die Fehlermodi zu kennen, ist genauso nützlich wie die Strategie selbst.
Historische Gleichgewichtsniveaus werden aus Daten geschätzt – und Daten spiegeln die Vergangenheit. Strukturelle Brüche (Fusion, Regulierung, Wettbewerb) können den historischen Mittelwert entwerten. Der Spread, von dem du meintest, er revertiere zu null, hat nun ein Gleichgewicht bei +50 Basispunkten. Eine auf dem alten Mittel aufgebaute Strategie ist ein sicherer Weg, Geld zu verlieren. Speziell im Pairs Trading: Firmen fusionieren, driften auseinander oder ändern ihr Geschäftsmodell – ein fünf Jahre eng kointegriertes Paar kann über Nacht entkoppeln.
Über kurze Stichproben kann eine trendende Reihe mean-revertierend wirken, weil sie zu einem lokalen gleitenden Mittel zurückkehrt. Besonders häufig in Backtests mit fixem Lookback. Abhilfe: über mehrere Zeiträume testen und Ergebnisse skeptisch sehen, die nur in engen Fenstern auftreten.
Häufiges Handeln frisst Renditen. Eine Strategie mit zwei Tagen Halbwertszeit erfordert womöglich tägliches Rebalancing; Roundtrips kosten schnell mehr als der erwartete Gewinn pro Trade. Shorten erzeugt weitere Kosten: Wertpapierleihe und das Risiko eines Buy-ins durch den Broker. Slippage zwischen Modell- und Fill-Preisen summiert sich über Hunderte Trades. Papier- und Live-Renditen driften bei hochfrequenten Mean-Reversion-Strategien stark auseinander.
Wenn viele Fonds ähnliche Strategien fahren, werden sie anfällig für ihr gegenseitiges Verhalten. Der Quant-Crash im August 2007 geschah genau deshalb: Zu viele Equity-Stat-Arb-Fonds liquidierten gleichzeitig – die Kaskade hatte wenig mit den zugrunde liegenden Beziehungen zu tun, auf denen die Strategien beruhten. Funktioniert eine Strategie, zieht sie Kapital an; zieht sie zu viel Kapital an, funktioniert sie nicht mehr – manchmal schleichend, manchmal abrupt.
Stat-Arb-Modelle sind auf ein bestimmtes Marktumfeld kalibriert: ein Volatilitätsregime, einen Zinszyklus, eine Korrelationsstruktur. Wenn sich das Umfeld ändert, verschieben sich alle Annahmen zugleich. Es ist nicht ein Paar, das bricht – es ist das ganze Portfolio, das aus dem Tritt gerät, weil die statistischen Eigenschaften, auf denen es basiert, nicht mehr gelten. Historische Lookbacks warnen dich nicht im Voraus.
Ergebnisse hängen stark vom Lookback für den Mittelwert, von Einstiegs-Schwellen und Exit-Regeln ab. Kleine Änderungen können eine Strategie von profitabel auf unprofitabel kippen lassen. Stressteste das explizit, bevor du einem Backtest glaubst.
Das tückischste Risiko. Mit genug Parametern und Daten lässt sich fast jeder Zeitraum perfekt fitten – live bricht es ein. Walk-Forward-Tests und Out-of-Sample-Validierung sind Pflicht.
Mean Reversion klingt simpel – bis du sie nutzen willst. Die Grundidee, dass Abweichungen vom Gleichgewicht zur Umkehr neigen, ist intuitiv. Schwieriger ist festzustellen, ob eine konkrete Reihe diese Eigenschaft tatsächlich hat, wie schnell sie revertiert und wie man Strategien baut, die Transaktionskosten, Regimewechsel und Parameterunsicherheit überstehen. Statistical Arbitrage formt diese Herausforderung zu einer Handelsdisziplin – die Kernschwierigkeit bleibt: Die Beziehungen, auf die du setzt, handeln auch andere.
Zum Mitnehmen: Teste, bevor du annimmst; achte darauf, was tatsächlich revertiert (Spreads und Transformationen, nicht Rohpreise); unterscheide Korrelation von Kointegration – sie sind nicht austauschbar; und behandle die oben genannten Risiken als Teil der Strategie, nicht als Nachgedanken. Unser Time Series Analysis in Python Kurs behandelt Stationaritätstests, ARIMA-Modellierung und Forecasting ausführlich. Für Trading-Anwendungen im Speziellen deckt Financial Trading in Python die Umsetzung und Bewertung quantitativer Strategien in der Praxis.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Blog
Matt Crabtree
14 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Allan Ouko
7 Min.
Tutorial
Sejal Jaiswal
24 Min.