

为何使用合成数据?
合成数据具备多项优势,使其成为组织和研究者的理想选择。它的使用可以应对数据科学、机器学习和软件开发中的多种挑战。以下是使用合成数据的一些原因:
1. 解决数据稀缺
在许多领域,收集足量且高质量的数据是一大难题。合成数据可以填补这些空白,从而开展全面分析并进行稳健的模型训练。
- 稀有事件模拟: 在金融或灾害管理等领域,某些关键事件发生频率很低。合成数据可以生成更多这类稀有事件的样本,从而提升模型在关键场景下的表现。
- 数据集平衡: 真实数据常存在类别不平衡。可有针对性地生成合成数据以平衡代表性不足的类别,从而提升模型精度。
- 补充小样本数据集: 在数据收集成本高或耗时的领域,合成数据可用于增强有限的真实数据,以达到有效机器学习所需的规模。
2. 增强数据隐私
通过使用不对应真实个体的合成数据,组织可以规避隐私问题,并遵循 GDPR、HIPAA 等法规。
- 匿名化的替代方案: 不同于有时可能被逆向还原的匿名化技术,合成数据从零生成,消除了再识别的风险。
- 跨境数据共享: 合成数据可在不违反数据保护法律的前提下,促进敏感项目的国际合作。
- 测试与开发: 开发者可在不接触真实个人信息的情况下使用逼真的数据,降低开发过程中发生数据泄露的风险。
3. 更优的机器学习模型
可按需将稀有事件或特定条件纳入合成数据,从而丰富数据集并提升模型精度。
- 边界案例覆盖: 可以生成对模型性能至关重要、但在真实数据中较为罕见的边界案例。
- 偏差降低: 通过精心设计的生成流程,可创建比现有真实数据更具多样性和代表性的数据集,从而有助于减少 AI 模型中的偏差。
- 迁移学习: 在真实数据稀缺的任务上先用合成数据进行预训练,再在有限的真实数据上微调,可提升性能。
4. 成本效率
与采集或购买真实数据相比,合成数据通常更具成本效益。
- 降低数据获取成本: 生成合成数据可能比收集真实数据更便宜,尤其是大规模或专业化数据集。
- 更低的存储与维护成本: 合成数据可按需生成,潜在地减少与大型真实数据集相关的长期存储成本。
- 降低法律与合规支出: 通过使用合成数据,组织可减少与数据隐私合规和潜在法律问题相关的成本。
合成数据生成技术
生成合成数据的方法有多种,每种都有其优势与适用场景。本节将对它们进行回顾。
1. 随机数据生成
这是最简单的方法,通过从统计分布中随机采样来生成数据。
import pandas as pd
import numpy as np
# Generate 1,000 samples from a normal distribution
heights = np.random.normal(loc=170, scale=10, size=1000)
weights = np.random.normal(loc=70, scale=15, size=1000)
# Create a correlation between height and weight
weights += (heights - 170) * 0.5
df = pd.DataFrame({'Height': heights, 'Weight': weights})
# Add categorical data
genders = np.random.choice(['Male', 'Female'], size=1000)
df['Gender'] = genders
df.head()
df.describe()上述代码使用正态分布生成一个随机数据集来模拟身高和体重。身高以 170 cm 为中心,标准差为 10;体重以 70 kg 为中心,标准差为 15。代码引入了身高与体重之间的线性关系,因此身高更高的人通常更重。代码还添加了一个 Gender 列,并随机赋值为“Male”或“Female”。
输出:
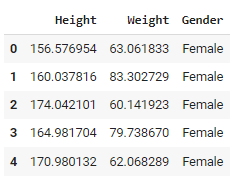
该方法实现迅速、易于上手,适合基础测试或原型制作。但也存在局限:它无法捕捉复杂关系或真实世界的模式,也难以顾及特定领域的细微差异或约束。
2. 基于规则的生成
基于规则的方法利用预定义规则或领域知识,生成具备特定特征的数据。请看以下示例:
import numpy as np
import pandas as pd
def generate_customer_data(num_records):
data = []
for _ in range(num_records):
age = np.random.randint(18, 80)
# Rule: Income is loosely based on age
base_income = 20000 + (age - 18) * 1000
income = np.random.normal(base_income, base_income * 0.2)
# Rule: Credit score is influenced by age and income
credit_score = min(850, max(300, int(600 + (age/80)*100 + (income/100000)*100 + np.random.normal(0, 50))))
# Rule: Loan amount is based on income and credit score
max_loan = income * (credit_score / 600)
loan_amount = np.random.uniform(0, max_loan)
data.append([age, income, credit_score, loan_amount])
return pd.DataFrame(data, columns=['Age', 'Income', 'CreditScore', 'LoanAmount'])
df = generate_customer_data(1000)
df.head()上述 Python 代码生成包含 1,000 条记录的客户数据集。对每位客户,随机分配 18 至 80 岁的年龄。基于年龄计算收入,年龄越大,一般收入越高。随后确定信用评分,受年龄与收入影响,并被限定在 300 到 850 之间。还会生成贷款金额,取决于个人收入和信用评分。
输出:
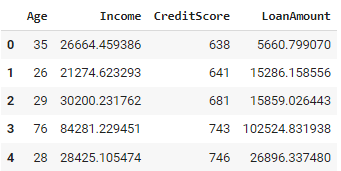
该方法确保生成的数据遵循已知关系和约束,使得可以将领域特定知识直接融入数据生成过程。然而,当系统包含大量相互关联的规则时,复杂度会迅速上升;对于庞大或复杂的数据集,定义和维护这些规则也可能耗时。
3. 基于模拟的生成
基于模拟的数据生成通过对真实世界过程建模来创建合成数据集。它通过基于预定义规则和变量来模拟事件或行为,使我们能够研究不同因素在动态系统中的交互方式。
该方法常用于测试场景和分析潜在结果,为客服流程、供应链、医疗运营等复杂系统提供有价值的洞见。下面是一个 Python 示例:
import simpy
import random
import pandas as pd
class Bank(object):
def __init__(self, env, num_tellers):
self.env = env
self.teller = simpy.Resource(env, num_tellers)
def service(self, customer):
service_time = random.expovariate(1/10) # Avg service time of 10 minutes
yield self.env.timeout(service_time)
def customer(env, name, bank, data):
arrival_time = env.now
print(f'{name} arrives at the bank at {arrival_time:.2f}')
with bank.teller.request() as request:
yield request
wait_time = env.now - arrival_time
print(f'{name} waits for {wait_time:.2f}')
yield env.process(bank.service(name))
service_time = env.now - arrival_time
print(f'{name} leaves the bank at {env.now:.2f}')
# Append the customer data to the list
data.append((name, arrival_time, wait_time, service_time))
def run_simulation(env, num_customers, bank, data):
for i in range(num_customers):
env.process(customer(env, f'Customer {i}', bank, data))
yield env.timeout(random.expovariate(1/5)) # New customer every 5 minutes on average
# Set up and run the simulation
env = simpy.Environment()
bank = Bank(env, num_tellers=3)
num_customers = 100
data = [] # This will hold the customer data
env.process(run_simulation(env, num_customers, bank, data))
env.run()
# Create a DataFrame from the collected data
df = pd.DataFrame(data, columns=['Customer', 'ArrivalTime', 'WaitTime', 'ServiceTime'])
print(df.head())
print(df.describe())该代码使用 SimPy 库模拟一家银行。顾客以随机间隔到达,等待 3 名柜员之一提供服务,服务后离开。
Bank 类定义了平均 10 分钟的服务时间,而 customer() 函数跟踪每位顾客的到达、等待时间与服务时长。run_simulation() 函数以平均每 5 分钟生成一位新顾客的节奏处理顾客。
输出:
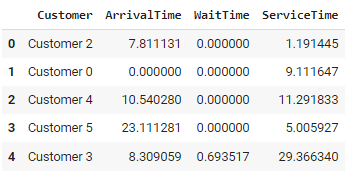
该方法可对复杂且动态的系统进行建模,支持场景测试和“假设”分析。但对于大规模模拟,计算开销可能较大;同时还需要对被建模系统有深入理解,方能确保结果准确。
4. 生成式模型
生成式模型(如生成对抗网络(GAN)和变分自编码器(VAE))已成为创建高度逼真合成数据的热门方法。这些模型学习输入数据的底层分布,并生成仿真真实世界的新样本。
两种方法广泛应用于图像生成和自然语言处理等任务,主要用于在真实数据稀缺或敏感时为机器学习模型创建合成数据。
查阅免费的 Datacamp 生成式 AI 概念课程,了解生成式 AI 模型如何开发及其未来对社会的影响。
合成数据生成工具
已有多种工具可用于便捷地为不同用例生成合成数据,覆盖统计建模、机器学习以及医疗模拟等场景。
这些工具旨在创建与真实世界数据集特征相匹配的数据,从而在不暴露敏感信息的前提下进行安全的试验与测试。
1. Python 中的 Synthetic Data Vault(SDV)
SDV 是一个 Python 库,提供一系列用于生成合成数据的模型。它支持多种数据类型,包括时间序列、关系型数据和表格数据。SDV 使用先进的概率模型,如高斯 copula以及深度学习方法来学习原始数据的结构,并生成高质量的合成版本。它广泛用于在真实数据有限或敏感的情况下,为机器学习应用生成训练数据。
要了解如何在 Python 中使用 SDV 库生成合成数据,请查看其官方GitHub 仓库或试试官方教程。
2. Gretel.AI
Gretel.AI 是一款云平台,提供合成数据生成与匿名化服务。它提供易用的 API 和预构建模型,可基于多种输入生成逼真的合成数据,包括结构化、半结构化和非结构化数据。Gretel.AI 致力于简化开发者和数据科学家的工作流程,以最小化配置快速生成合成数据。
查看 Gretel 的快速上手,开始使用 Gretel.AI 进行合成数据生成。
3. Synthea
Synthea 是一个专为医疗模拟开发的开源工具。它生成反映真实医疗史、治疗和结局的合成病历,并遵循医学与临床标准。研究人员和医疗机构常用 Synthea 来模拟患者群体并研究公共卫生趋势,而无需使用真实患者数据,对医疗数据分析极为有用。
4. synthpop(R 语言)
synthpop 是一个 R 包,专为生成真实世界数据集的合成版本而设计。它通过统计模型复刻原始数据中的关系与分布,使用户能够在不泄露机密的前提下安全共享与分析数据。对于需要发布数据集同时保护隐私的研究人员和机构而言,synthpop 尤其实用。
要了解如何在 R 中使用 synthpop 生成合成数据,请参阅教程Generating Synthetic Data Sets with synthpop in R。
生成式 AI 在合成数据中的作用
如前所述,生成式 AI 在创建合成数据方面发挥着重要作用,主要通过先进模型来学习真实世界数据的底层模式与分布,并生成逼真的合成版本。让我们逐一了解这些技术及其应用。
生成对抗网络(GAN)
GAN 是生成合成数据最强大的工具之一。它由两个相互对抗的神经网络组成:生成器与判别器。生成器负责创建合成数据,而判别器尝试区分真实与合成数据。通过这种对抗过程,生成器不断提升其生成高度逼真数据的能力。GAN 被广泛用于生成图像、视频甚至表格数据,并已在医疗、自动驾驶和娱乐等领域获得应用。
变分自编码器(VAE)
VAE 是另一类常用的合成数据生成模型。它通过将数据编码到压缩的潜在空间,再解码回原始形式来工作。这样,VAE 可通过在潜在空间中采样来生成新的数据点,适用于图像合成与异常检测等应用。尽管 VAE 的逼真度不及 GAN,但训练更稳定,并能更好地控制生成数据的结构。
用于文本生成的 Transformer 模型
Transformer(如 GPT 模型)通过生成连贯且上下文准确的句子和段落,彻底变革了文本生成。对于合成数据,Transformer 能生成近似真实世界数据集的人类文本,如客户评价、对话或其他文本数据。这些模型尤其适用于为自然语言处理(NLP)任务生成海量文本型合成数据,同时也可灵活微调以适配特定应用。
若想了解生成式人工智能在当今与未来商业环境中的作用,请查看 Generative AI for Business 课程。
开始动手生成合成数据
1. 选择合适的技术
合适的合成数据生成技术取决于您的用例、数据类型与目标。对于统计分布明确的简单数据集,随机数据生成或基于规则的生成即可满足需求。
如果您处理的是复杂、相互关联的数据,或需要保持关系完整性(如医疗或金融领域),则更适合采用基于模拟的方法,或使用 GAN、VAE 等生成式模型。对于文本生成或涉及大规模数据的任务,基于 Transformer 的模型可能效果更佳。
在选择技术时,应权衡实现难易度、数据逼真度与计算资源需求。
2. 使用 Gretel.AI API 在 Python 中实现
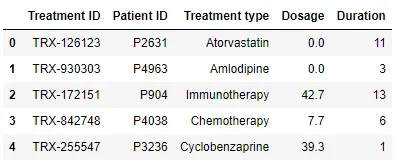
为演示该示例,我生成了一个包含三张表的模拟患者数据库,每张表各有 5,000 条记录。
表 1 - 患者(Patients)
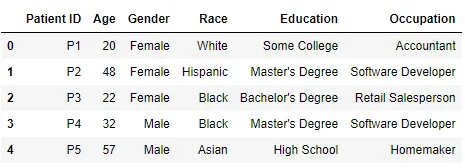
表 2 - 化验结果(Lab Results)
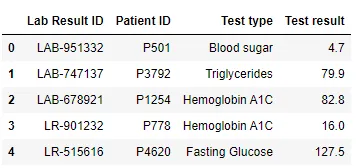
表 3 - 治疗(Treatments)
要实现该示例,您需要在 Gretel.AI 注册并生成一个 API 密钥。还需要在 Python 中安装一个库:
!pip install -U gretel-trainer在本用例中,我们将使用 gretel_trainer.relational 模块中的 RelationalData。它允许用户自动定义并维护多张表之间的关系,确保在合成输出中保留外键依赖与数据完整性。
这对于生成高质量、能够反映真实数据库结构与依赖关系的合成数据尤为有用,从而更便于在机器学习、研究或数据隐私合规等应用中使用。
代码示例:
import pandas as pd
from gretel_client import configure_session
from gretel_trainer.relational import RelationalData
configure_session(api_key="your_api_key", cache="yes", validate=True)
csv_dir = "csv/"
tables = [("patients", "Patient ID"), ("lab_results", "Lab Result ID"), ("treatments", "Treatment ID")]
foreign_keys = [("lab_results.Patient ID", "patients.Patient ID"), ("treatments.Patient ID", "patients.Patient ID")]
relational_data = RelationalData()
for table, pk in tables:
relational_data.add_table(name=table, primary_key=pk, data=pd.read_csv(f"{csv_dir}/{table}.csv"))
for fk, ref in foreign_keys:
relational_data.add_foreign_key(foreign_key=fk, referencing=ref)
from gretel_trainer.relational import MultiTable
multitable = MultiTable(
relational_data,
project_display_name="Clinical Trials",
gretel_model="amplify"
)
multitable.train()
multitable.generate(record_size_ratio=1)
synthetic_patients = multitable.synthetic_output_tables['patients']
synthetic_lab_results = multitable.synthetic_output_tables['lab_results']
synthetic_treatments = multitable.synthetic_output_tables['treatments']
该代码使用 Gretel.AI 的 API 为一个关系型数据库生成合成数据。它首先通过 API 密钥创建会话,并加载三份 CSV 文件(patients、lab_results 和 treatments),指定其主键并定义外键关系。
RelationalData 类用于维护这些关系。配置好数据后,使用 MultiTable 类训练模型,对整个关系型数据集进行合成。
模型训练完成后,使用 generate() 方法生成合成数据。record_size_ratio 参数决定生成数据规模相对于参考的比例。record_size_ratio=1 表示合成数据集的记录数 = 原始数据集,即 5,000 条记录。
3. 评估合成数据集质量
评估合成数据的质量对于确保其实用性与隐私性至关重要。首先比较原始与合成数据的统计分布——如均值、方差与相关性等指标应高度匹配。
另一种方法是使用合成数据训练机器学习模型,并将其性能(如准确率或 F1 分数)与在真实数据上训练的模型进行对比。
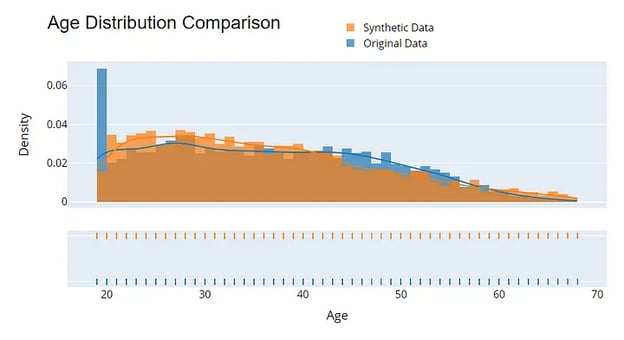
用于评估合成数据质量的示例可视化。图片由作者提供。
结论
合成数据生成已成为应对数据稀缺、隐私顾虑以及对多样化高质量数据集需求的有效途径。
从简单的随机数据生成到先进的 GAN 和 VAE 等生成式模型,合成数据使组织能够在保护敏感信息的同时进行创新并构建更优的机器学习模型。
诸如 SDV 的工具和 Gretel.AI 等托管服务,让即使是复杂的关系型数据库的合成数据生成也更易上手。
随着合成数据生成技术的发展,其应用将在推动 AI、医疗、金融及众多其他领域方面发挥愈发重要的作用。
想要更深入学习?观看训练课程 Using Synthetic Data for Machine Learning & AI in Python,了解何为合成数据、它如何保护隐私,以及它如何助力银行、医疗和众多行业加速采用 AI。
FAQs
合成数据与真实数据有何不同?
合成数据是为仿真真实数据的统计特性而人工生成的数据,但并不代表真实实体。真实数据来自现实世界的采集,而合成数据由算法生成,非常适合用于解决隐私与数据稀缺问题。
合成数据在训练 AI 模型方面是否与真实数据一样可靠?
是的,只要使用高质量的方法,准确捕捉真实数据中的模式与关系,合成数据就同样可靠。在某些情况下,它甚至能通过引入真实数据集中不常见的稀有事件或边界案例来增强模型。
我可以将合成数据用于合规目的吗?
可以。合成数据由于不对应真实个体或敏感信息,有助于消除隐私顾虑,从而支持合规。这使其在测试和跨境数据共享中很有用,不会违反数据保护法律。
使用合成数据是否存在局限?
尽管合成数据非常有用,但在高度细腻的领域中,它可能无法完全捕捉真实世界数据的复杂性。此外,如果生成过程设计不当,合成数据可能引入偏差或不现实的模式。因此,在完全依赖合成数据之前,务必根据您的具体用例评估其局限性。

在后 GPT 时代,对高质量数据集的需求前所未有地强烈。生成式 AI 和大型语言模型都依赖于稳健、高质量且规模充足的数据。然而,获取此类数据往往面临挑战,从隐私顾虑到全球范围内真实数据本身的稀缺。
合成数据生成应运而生:这一强大的解决方案既能缓解真实数据稀缺的问题,也能化解隐私争议。在本文中,我们将了解合成数据是什么、为何重要、生成它的技术与工具,以及如何开始实践。
什么是合成数据?
合成数据是人工生成的信息,其结构和统计特性仿真于真实世界数据,但并不对应实际个体或实体。它由算法创建,并在多种应用中作为真实数据的替代品使用。
上述特性使合成数据在软件测试、AI 模型训练、数据增强、金融建模和医疗研究中极具价值——这些场景需要规模大、类型多样的数据集,而真实数据可能稀缺、敏感,或受隐私法规限制。
通过计算机模拟或算法生成的合成数据,为真实世界数据提供了低成本的替代方案,并日益用于构建更精确的 AI 模型。图片来源:NVIDIA 博客
合成数据的类型
合成数据主要分为三类:结构化、非结构化和序列型,每类都有其特点与应用。下面分别介绍。
1. 结构化数据
结构化数据是按预定义格式组织的信息,通常存在于数据库和电子表格中。这类合成数据会仿真真实结构化数据的格式和统计属性。示例包括:
生成结构化合成数据的方法通常涉及统计建模、基于规则的系统,或诸如变分自编码器(VAE)或生成对抗网络(GAN)等机器学习技术。
2. 非结构化数据
非结构化数据不具备预定义格式,在机器学习应用中日益重要。合成的非结构化数据类型包括:
3. 序列型数据
序列型数据涉及时间或顺序,对于需要理解时间关系的模型至关重要。示例包括: