

Mengapa Menggunakan Data Sintetis?
Data sintetis menawarkan berbagai keunggulan, menjadikannya opsi menarik bagi organisasi dan peneliti. Penggunaannya dapat mengatasi beragam tantangan dalam data science, pembelajaran mesin, dan pengembangan perangkat lunak. Berikut beberapa alasan menggunakan data sintetis:
1. Mengatasi kelangkaan data
Di banyak bidang, mengumpulkan data berkualitas dalam jumlah memadai merupakan tantangan besar. Data sintetis dapat mengisi kekosongan ini, memungkinkan analisis komprehensif dan pelatihan model yang andal.
- Simulasi kejadian langka: Kejadian kritis tertentu jarang terjadi di bidang seperti keuangan atau manajemen bencana. Data sintetis dapat menghasilkan lebih banyak contoh kejadian langka ini, sehingga meningkatkan kinerja model pada skenario krusial tersebut.
- Dataset seimbang: Data dunia nyata sering bermasalah dengan ketidakseimbangan kelas. Data sintetis dapat dibuat untuk menyeimbangkan kelas yang kurang terwakili, menghasilkan model yang lebih akurat.
- Melengkapi dataset kecil: Di domain di mana pengumpulan data mahal atau memakan waktu, data sintetis dapat memperkaya data nyata yang terbatas untuk mencapai volume yang diperlukan bagi pembelajaran mesin yang efektif.
2. Meningkatkan privasi data
Dengan menggunakan data sintetis yang tidak berkaitan dengan individu sebenarnya, organisasi dapat menghindari kekhawatiran privasi dan memastikan kepatuhan terhadap regulasi seperti GDPR dan HIPAA.
- Alternatif anonimisasi: Tidak seperti teknik anonimisasi yang terkadang bisa dibalik, data sintetis dibuat dari nol, sehingga menghilangkan risiko re-identifikasi.
- Berbagi data lintas batas: Data sintetis dapat memfasilitasi kolaborasi internasional pada proyek sensitif tanpa melanggar undang-undang perlindungan data.
- Pengujian dan pengembangan: Pengembang dapat bekerja dengan data realistis tanpa terekspos informasi pribadi yang sebenarnya, sehingga mengurangi risiko kebocoran data selama proses pengembangan.
3. Model pembelajaran mesin yang lebih baik
Data sintetis dapat disesuaikan untuk menyertakan kejadian langka atau kondisi spesifik, memperkaya dataset dan meningkatkan akurasi model.
- Representasi kasus ekstrem: Data sintetis dapat dibuat untuk mencakup kasus ekstrem yang penting bagi kinerja model namun jarang ada dalam data nyata.
- Pengurangan bias: Dengan merancang proses pembuatan data sintetis secara cermat, dimungkinkan membuat dataset yang lebih beragam dan representatif daripada data nyata yang tersedia, membantu mengurangi bias pada model AI.
- Transfer learning: Data sintetis dapat digunakan untuk pra-pelatihan model pada tugas yang datanya langka, sehingga meningkatkan kinerja saat disesuaikan dengan data nyata yang terbatas.
4. Efisiensi biaya
Data sintetis sering kali lebih hemat biaya dibanding mengumpulkan atau membeli data nyata.
- Biaya akuisisi data berkurang: Menghasilkan data sintetis bisa lebih murah daripada mengumpulkan data nyata, khususnya untuk dataset berskala besar atau terspesialisasi.
- Biaya penyimpanan dan pemeliharaan lebih rendah: Data sintetis dapat dibuat sesuai permintaan, sehingga berpotensi mengurangi biaya penyimpanan jangka panjang terkait dataset nyata yang besar.
- Minimnya biaya legal dan kepatuhan: Dengan menggunakan data sintetis, organisasi dapat menekan biaya terkait kepatuhan privasi data dan potensi isu hukum.
Teknik Pembuatan Data Sintetis
Ada sejumlah metode untuk membuat data sintetis, masing-masing dengan keunggulan dan kasus penggunaan. Mari kita tinjau pada bagian ini.
1. Pembuatan data acak
Ini adalah metode paling sederhana, yaitu membuat data dengan mengambil sampel secara acak dari distribusi statistik.
import pandas as pd
import numpy as np
# Generate 1,000 samples from a normal distribution
heights = np.random.normal(loc=170, scale=10, size=1000)
weights = np.random.normal(loc=70, scale=15, size=1000)
# Create a correlation between height and weight
weights += (heights - 170) * 0.5
df = pd.DataFrame({'Height': heights, 'Weight': weights})
# Add categorical data
genders = np.random.choice(['Male', 'Female'], size=1000)
df['Gender'] = genders
df.head()
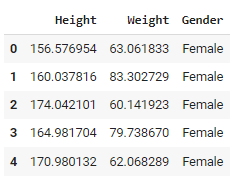
df.describe()Kode di atas membuat dataset acak yang mensimulasikan tinggi dan berat menggunakan distribusi normal. Tinggi berpusat di 170 cm dengan standar deviasi 10, dan berat berpusat di 70 kg dengan standar deviasi 15. Hubungan linear diperkenalkan antara tinggi dan berat, sehingga individu yang lebih tinggi umumnya berbobot lebih besar. Kode juga menambahkan kolom Gender dengan nilai acak “Male” atau “Female”.
Keluaran:
Metode ini cepat dan mudah diterapkan, sehingga berguna untuk pengujian dasar atau pembuatan prototipe. Namun, ada keterbatasannya. Metode ini tidak menangkap hubungan kompleks atau pola dunia nyata maupun memperhitungkan nuansa atau batasan spesifik domain.
2. Pembuatan berbasis aturan
Metode berbasis aturan menggunakan aturan yang telah ditentukan atau pengetahuan domain untuk membuat data dengan karakteristik tertentu. Perhatikan contoh berikut:
import numpy as np
import pandas as pd
def generate_customer_data(num_records):
data = []
for _ in range(num_records):
age = np.random.randint(18, 80)
# Rule: Income is loosely based on age
base_income = 20000 + (age - 18) * 1000
income = np.random.normal(base_income, base_income * 0.2)
# Rule: Credit score is influenced by age and income
credit_score = min(850, max(300, int(600 + (age/80)*100 + (income/100000)*100 + np.random.normal(0, 50))))
# Rule: Loan amount is based on income and credit score
max_loan = income * (credit_score / 600)
loan_amount = np.random.uniform(0, max_loan)
data.append([age, income, credit_score, loan_amount])
return pd.DataFrame(data, columns=['Age', 'Income', 'CreditScore', 'LoanAmount'])
df = generate_customer_data(1000)
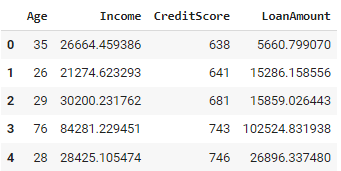
df.head()Kode Python di atas menghasilkan dataset data pelanggan dengan 1.000 rekaman. Untuk setiap pelanggan, ditetapkan usia acak antara 18 dan 80. Berdasarkan usia, dihitung pendapatan, dengan kecenderungan individu yang lebih tua berpendapatan lebih tinggi. Skor kredit kemudian ditentukan, dipengaruhi oleh usia dan pendapatan, dipastikan berada antara 300 dan 850. Jumlah pinjaman juga dihasilkan, bergantung pada pendapatan dan skor kredit individu.
Keluaran:
Pendekatan ini memastikan data yang dihasilkan mematuhi hubungan dan batasan yang telah diketahui, sehingga pengetahuan spesifik domain dapat langsung diintegrasikan ke proses pembuatan data. Namun, pendekatan ini bisa menjadi kompleks saat menangani sistem dengan banyak aturan saling terkait, dan mendefinisikan serta memelihara aturan semacam itu memakan waktu untuk dataset yang besar atau rumit.
3. Pembuatan berbasis simulasi
Pembuatan data berbasis simulasi memodelkan proses dunia nyata untuk membuat dataset sintetis. Ini melibatkan simulasi peristiwa atau perilaku berdasarkan aturan dan variabel yang telah ditentukan, memungkinkan kita mempelajari bagaimana berbagai faktor berinteraksi dalam sistem dinamis.
Metode ini sering digunakan untuk menguji skenario dan menganalisis potensi hasil, memberikan wawasan berharga terhadap sistem kompleks seperti proses layanan pelanggan, rantai pasok, dan operasi layanan kesehatan. Berikut contoh dalam Python:
import simpy
import random
import pandas as pd
class Bank(object):
def __init__(self, env, num_tellers):
self.env = env
self.teller = simpy.Resource(env, num_tellers)
def service(self, customer):
service_time = random.expovariate(1/10) # Avg service time of 10 minutes
yield self.env.timeout(service_time)
def customer(env, name, bank, data):
arrival_time = env.now
print(f'{name} arrives at the bank at {arrival_time:.2f}')
with bank.teller.request() as request:
yield request
wait_time = env.now - arrival_time
print(f'{name} waits for {wait_time:.2f}')
yield env.process(bank.service(name))
service_time = env.now - arrival_time
print(f'{name} leaves the bank at {env.now:.2f}')
# Append the customer data to the list
data.append((name, arrival_time, wait_time, service_time))
def run_simulation(env, num_customers, bank, data):
for i in range(num_customers):
env.process(customer(env, f'Customer {i}', bank, data))
yield env.timeout(random.expovariate(1/5)) # New customer every 5 minutes on average
# Set up and run the simulation
env = simpy.Environment()
bank = Bank(env, num_tellers=3)
num_customers = 100
data = [] # This will hold the customer data
env.process(run_simulation(env, num_customers, bank, data))
env.run()
# Create a DataFrame from the collected data
df = pd.DataFrame(data, columns=['Customer', 'ArrivalTime', 'WaitTime', 'ServiceTime'])
print(df.head())
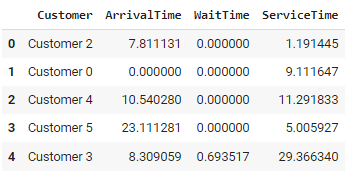
print(df.describe())Kode ini mensimulasikan sebuah bank menggunakan pustaka SimPy. Pelanggan datang pada interval acak, menunggu untuk dilayani oleh salah satu dari tiga teller yang tersedia, kemudian pergi setelah dilayani.
Kelas Bank mendefinisikan waktu layanan (rata-rata 10 menit), sementara fungsi customer() melacak kedatangan, waktu tunggu, dan durasi layanan setiap pelanggan. Pelanggan diproses dalam fungsi run_simulation(), yang menghasilkan kedatangan baru rata-rata setiap 5 menit.
Keluaran:
Pendekatan ini memungkinkan pemodelan sistem yang kompleks dan dinamis, memfasilitasi pengujian skenario dan analisis “bagaimana jika”. Namun, cara ini bisa memakan banyak komputasi untuk simulasi berskala besar dan memerlukan pemahaman menyeluruh atas sistem yang dimodelkan agar hasilnya akurat.
4. Model generatif
Model generatif seperti generative adversarial network (GAN) dan variational autoencoder (VAE) menjadi populer untuk membuat data sintetis yang sangat realistis. Model ini belajar menangkap distribusi dasar dari data masukan dan menghasilkan sampel baru yang meniru data dunia nyata.
Keduanya banyak digunakan pada tugas seperti pembuatan gambar dan pemrosesan bahasa alami, terutama untuk membuat data sintetis bagi model pembelajaran mesin saat data dunia nyata langka atau sensitif.
Lihat kursus gratis Generative AI Concepts di Datacamp untuk mempelajari bagaimana model AI generatif dikembangkan dan bagaimana dampaknya bagi masyarakat di masa depan.
Alat untuk Pembuatan Data Sintetis
Tersedia beberapa alat yang memudahkan pembuatan data sintetis untuk berbagai kasus penggunaan, mulai dari pemodelan statistik hingga pembelajaran mesin dan simulasi layanan kesehatan.
Alat-alat ini dirancang untuk membuat data yang mencerminkan karakteristik dataset dunia nyata, memungkinkan eksperimen dan pengujian yang aman tanpa mengekspos informasi sensitif.
1. Synthetic Data Vault (SDV) di Python
SDV adalah pustaka Python yang menyediakan rangkaian model untuk menghasilkan data sintetis. SDV mendukung berbagai tipe data, termasuk deret waktu, data relasional, dan data tabular. SDV menggunakan model probabilistik tingkat lanjut seperti Gaussian copula dan metode deep learning untuk mempelajari struktur data asli dan menghasilkan versi sintetis berkualitas tinggi. Alat ini banyak digunakan dalam aplikasi pembelajaran mesin untuk membuat data pelatihan sintetis saat data nyata terbatas atau sensitif.
Untuk mempelajari lebih lanjut tentang pembuatan data sintetis menggunakan pustaka SDV di Python, lihat repositori GitHub resmi atau coba tutorial resmi mereka.
2. Gretel.AI
Gretel.AI adalah platform berbasis cloud yang menawarkan layanan pembuatan data sintetis dan anonimisasi. Platform ini menyediakan API yang mudah digunakan dan model siap pakai yang dapat menghasilkan data sintetis realistis berdasarkan berbagai masukan, termasuk data terstruktur, semi-terstruktur, dan tidak terstruktur. Gretel.AI berfokus pada penyederhanaan alur kerja bagi pengembang dan data scientist, sehingga pembuatan data sintetis menjadi lebih mudah dengan penyiapan minimal.
Lihat panduan cepat Gretel untuk memulai pembuatan data sintetis menggunakan Gretel.AI
3. Synthea
Synthea adalah alat open-source yang dikembangkan khusus untuk simulasi layanan kesehatan. Alat ini menghasilkan catatan pasien sintetis yang mencerminkan riwayat medis, perawatan, dan luaran yang realistis, mengikuti standar medis dan klinis. Peneliti dan institusi kesehatan sering menggunakan Synthea untuk mensimulasikan populasi pasien dan mempelajari tren kesehatan masyarakat tanpa menggunakan data pasien nyata, sehingga sangat berharga untuk analisis data kesehatan.
4. synthpop (bahasa pemrograman R)
synthpop adalah paket R yang dirancang khusus untuk menghasilkan versi sintetis dari dataset dunia nyata. Paket ini bekerja dengan menggunakan model statistik untuk mereplikasi hubungan dan distribusi yang ditemukan dalam data asli, sehingga pengguna dapat berbagi dan menganalisis data dengan aman tanpa mengorbankan kerahasiaan. synthpop sangat berguna bagi peneliti dan institusi yang perlu merilis dataset sambil melindungi privasi.
Untuk mempelajari lebih lanjut tentang pembuatan data sintetis di R menggunakan synthpop, lihat tutorial Generating Synthetic Data Sets with synthpop in R.
Peran AI Generatif dalam Data Sintetis
Seperti disebutkan sebelumnya, AI generatif berperan penting dalam membuat data sintetis, terutama melalui model lanjutan yang mempelajari pola dan distribusi dasar data dunia nyata dan menghasilkan versi sintetis yang realistis. Mari kita telusuri masing-masing teknik dan penerapannya.
Generative adversarial networks (GAN)
GAN adalah salah satu alat paling kuat untuk menghasilkan data sintetis. GAN terdiri dari dua jaringan saraf yang saling berkompetisi: generator dan discriminator. Generator membuat data sintetis, sementara discriminator berupaya membedakan antara data nyata dan sintetis. Melalui proses adversarial ini, generator meningkatkan kemampuannya dalam membuat data yang sangat realistis. GAN banyak digunakan untuk menghasilkan gambar, video, bahkan data tabular, dan telah diterapkan di bidang seperti layanan kesehatan, kendaraan otonom, dan hiburan.
Variational autoencoders (VAE)
VAE adalah model generatif populer lainnya untuk pembuatan data sintetis. Model ini bekerja dengan mengenkode data ke dalam ruang laten terkompresi lalu mendekodenya kembali ke bentuk semula. Hal ini memungkinkan VAE menghasilkan data baru dengan mengambil sampel dari ruang laten, sehingga berguna untuk aplikasi seperti sintesis gambar dan deteksi anomali. Meski VAE tidak mencapai tingkat realisme setara GAN, VAE lebih stabil saat pelatihan dan memberikan kontrol yang lebih baik atas struktur data yang dihasilkan.
Model Transformer untuk pembuatan teks
Transformer, seperti model GPT, merevolusi pembuatan teks dengan menghasilkan kalimat dan paragraf yang koheren serta kontekstual. Untuk data sintetis, transformer dapat menghasilkan teks menyerupai data dunia nyata, seperti ulasan pelanggan, percakapan, atau data tekstual lainnya. Model ini sangat berguna saat menghasilkan data sintetis berbasis teks dalam jumlah besar untuk tugas pemrosesan bahasa alami (NLP), dan juga fleksibel untuk disesuaikan dengan aplikasi spesifik.
Untuk mempelajari peran kecerdasan buatan generatif saat ini dan di masa depan dalam lingkungan bisnis, lihat kursus Generative AI for Business.
Memulai Pembuatan Data Sintetis
1. Memilih teknik yang tepat
Teknik pembuatan data sintetis yang sesuai bergantung pada kasus penggunaan, jenis data, dan tujuan Anda. Untuk dataset sederhana dengan distribusi statistik yang jelas, pembuatan data acak atau berbasis aturan sudah memadai.
Jika Anda menangani data kompleks dan saling terkait atau perlu menjaga integritas relasional (misalnya pada layanan kesehatan atau keuangan), pendekatan berbasis simulasi atau model generatif seperti GAN dan VAE mungkin lebih tepat. Untuk pembuatan teks atau tugas yang melibatkan data skala besar, model berbasis transformer dapat memberikan hasil yang lebih baik.
Pertimbangkan kompromi antara kemudahan implementasi, realisme data, dan kebutuhan komputasi saat memilih teknik.
2. Implementasi di Python menggunakan API Gretel.AI
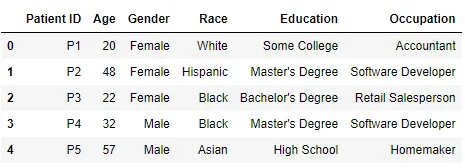
Untuk mendemonstrasikan contoh ini, saya telah membuat basis data pasien tiruan dengan tiga tabel, masing-masing berisi tepat 5.000 rekaman.
Tabel 1 - Patients
Tabel 2 - Lab Results
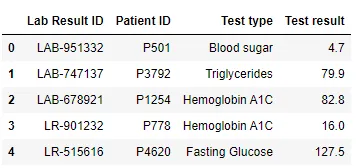
Tabel 3 - Treatments
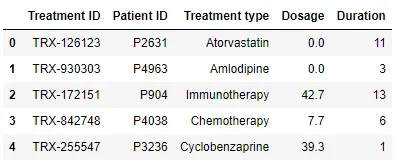
Untuk mengimplementasikan contoh ini, Anda harus mendaftar di Gretel.AI dan membuat kunci API. Anda juga harus memasang pustaka di Python:
!pip install -U gretel-trainerUntuk mengimplementasikan use case ini, kita akan menggunakan RelationalData dari modul gretel_trainer.relational. Modul ini memungkinkan pengguna secara otomatis mendefinisikan dan mempertahankan hubungan antar beberapa tabel, memastikan ketergantungan foreign key dan integritas data terjaga dalam keluaran sintetis.
Ini sangat berguna untuk menghasilkan data sintetis berkualitas tinggi yang mencerminkan struktur dan dependensi basis data dunia nyata, sehingga lebih mudah digunakan dalam aplikasi seperti pembelajaran mesin, riset, atau kepatuhan terhadap regulasi privasi data.
Contoh Kode:
import pandas as pd
from gretel_client import configure_session
from gretel_trainer.relational import RelationalData
configure_session(api_key="your_api_key", cache="yes", validate=True)
csv_dir = "csv/"
tables = [("patients", "Patient ID"), ("lab_results", "Lab Result ID"), ("treatments", "Treatment ID")]
foreign_keys = [("lab_results.Patient ID", "patients.Patient ID"), ("treatments.Patient ID", "patients.Patient ID")]
relational_data = RelationalData()
for table, pk in tables:
relational_data.add_table(name=table, primary_key=pk, data=pd.read_csv(f"{csv_dir}/{table}.csv"))
for fk, ref in foreign_keys:
relational_data.add_foreign_key(foreign_key=fk, referencing=ref)
from gretel_trainer.relational import MultiTable
multitable = MultiTable(
relational_data,
project_display_name="Clinical Trials",
gretel_model="amplify"
)
multitable.train()
multitable.generate(record_size_ratio=1)
synthetic_patients = multitable.synthetic_output_tables['patients']
synthetic_lab_results = multitable.synthetic_output_tables['lab_results']
synthetic_treatments = multitable.synthetic_output_tables['treatments']
Kode ini menggunakan API Gretel.AI untuk menghasilkan data sintetis bagi basis data relasional. Pertama, sesi dikonfigurasi menggunakan kunci API dan memuat tiga berkas CSV (patients, lab_results, dan treatments), dengan menentukan primary key-nya dan mendefinisikan hubungan foreign key.
Kelas RelationalData digunakan untuk mempertahankan hubungan tersebut. Setelah data dikonfigurasi, model dilatih menggunakan kelas MultiTable, yang menyintesis seluruh dataset relasional.
Setelah model dilatih, metode generate() digunakan untuk menghasilkan data sintetis. Parameter record_size_ratio menentukan rasio acuan terhadap ukuran data yang dihasilkan. record_size_ratio=1 berarti jumlah rekaman dalam dataset sintetis = dataset asli, yaitu 5.000 rekaman.
3. Mengevaluasi kualitas dataset sintetis
Evaluasi kualitas data sintetis penting untuk memastikan kegunaan dan privasinya. Mulailah dengan membandingkan distribusi statistik antara data asli dan sintetis—metrik seperti mean, varians, dan korelasi seharusnya selaras dengan baik.
Metode lain adalah menggunakan data sintetis untuk melatih model pembelajaran mesin dan membandingkan kinerjanya (misalnya, akurasi atau skor F1) dengan model yang dilatih pada data nyata.
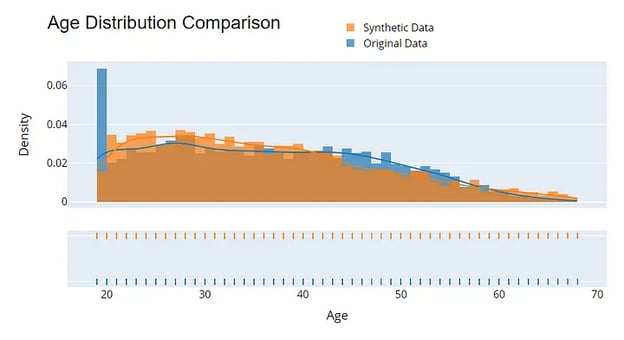
Contoh visualisasi untuk menilai kualitas data sintetis. Gambar oleh Penulis.
Kesimpulan
Pembuatan data sintetis muncul untuk mengatasi tantangan terkait kelangkaan data, kekhawatiran privasi, dan kebutuhan akan dataset yang beragam dan berkualitas tinggi.
Dengan teknik yang berkisar dari pembuatan data acak sederhana hingga model generatif tingkat lanjut seperti GAN dan VAE, data sintetis memungkinkan organisasi berinovasi dan membangun model pembelajaran mesin yang lebih baik sambil menjaga informasi sensitif.
Alat seperti SDV dan layanan terkelola seperti Gretel.AI membuat pembuatan data sintetis menjadi lebih mudah diakses, bahkan untuk basis data relasional yang kompleks.
Seiring berkembangnya pembuatan data sintetis, penerapannya akan semakin penting untuk memajukan AI, layanan kesehatan, keuangan, dan banyak bidang lainnya.
Ingin menyelami lebih jauh? Tonton pelatihan Using Synthetic Data for Machine Learning & AI in Python untuk mengetahui apa itu data sintetis, bagaimana data ini melindungi privasi, dan bagaimana data ini digunakan untuk mempercepat adopsi AI di perbankan, layanan kesehatan, dan banyak industri lainnya.
FAQs
Bagaimana data sintetis berbeda dari data nyata?
Data sintetis dihasilkan secara artifisial untuk meniru sifat statistik data nyata namun tidak merepresentasikan entitas aktual. Sementara data nyata dikumpulkan dari sumber dunia nyata, data sintetis diproduksi melalui algoritma, sehingga ideal untuk mengatasi masalah privasi dan kelangkaan data.
Apakah data sintetis sama andalnya dengan data nyata untuk melatih model AI?
Ya, data sintetis bisa sama andalnya, asalkan dihasilkan dengan metode berkualitas tinggi yang secara akurat menangkap pola dan hubungan dalam data nyata. Dalam beberapa kasus, data sintetis bahkan dapat meningkatkan model dengan memasukkan kejadian langka atau kasus ekstrem yang biasanya tidak ditemukan dalam dataset nyata.
Dapatkah saya menggunakan data sintetis untuk kepatuhan regulasi?
Ya, data sintetis dapat membantu kepatuhan regulasi dengan menghilangkan kekhawatiran privasi karena tidak berkaitan dengan individu nyata atau informasi sensitif. Hal ini membuatnya berguna untuk pengujian dan berbagi data lintas batas tanpa melanggar undang-undang perlindungan data.
Apakah ada keterbatasan dalam menggunakan data sintetis?
Meski data sintetis merupakan alat yang kuat, data ini mungkin tidak menangkap seluruh kompleksitas data dunia nyata, terutama pada domain yang sangat bernuansa. Selain itu, data sintetis dapat memperkenalkan bias atau pola yang tidak realistis jika proses pembuatannya tidak dirancang dengan hati-hati. Oleh karena itu, penting untuk mengevaluasi keterbatasan data sintetis pada kasus penggunaan spesifik Anda sebelum mengandalkannya sepenuhnya.




Di era pasca-GPT, kebutuhan akan dataset berkualitas tinggi semakin besar. AI Generatif dan model bahasa besar sangat bergantung pada ketersediaan data yang andal, berkualitas tinggi, dan dalam jumlah besar. Namun, memperoleh data seperti itu sering menghadapi tantangan, mulai dari kekhawatiran privasi hingga kelangkaan data nyata di seluruh dunia.
Inilah peran pembuatan data sintetis: solusi ampuh yang mengatasi kelangkaan data nyata sekaligus meredakan kekhawatiran privasi. Dalam artikel ini, kita akan mempelajari apa itu data sintetis, mengapa data ini penting, teknik dan alat untuk menghasilkannya, serta cara memulai.
Apa itu Data Sintetis?
Data sintetis adalah informasi yang dihasilkan secara artifisial yang meniru data dunia nyata dalam struktur dan sifat statistiknya, tetapi tidak berkaitan dengan entitas aktual. Data ini dibuat secara algoritmik dan digunakan sebagai pengganti data nyata dalam berbagai aplikasi.
Karakteristik tersebut menjadikan data sintetis sangat berharga untuk pengujian perangkat lunak, pelatihan model AI, augmentasi data, pemodelan keuangan, dan riset kesehatan, di mana diperlukan dataset yang besar dan beragam, tetapi data nyata mungkin langka, sensitif, atau dibatasi oleh regulasi privasi.
Data sintetis yang dihasilkan dari simulasi komputer atau algoritma menyediakan alternatif berbiaya rendah dibanding data dunia nyata dan semakin banyak digunakan untuk membuat model AI yang akurat. Sumber gambar: blog NVIDIA
Jenis-Jenis Data Sintetis
Tiga jenis utama data sintetis adalah terstruktur, tidak terstruktur, dan berurutan, masing-masing dengan karakteristik dan aplikasinya. Mari kita bahas lebih rinci.
1. Data terstruktur
Data terstruktur adalah informasi yang diorganisasi dalam format yang telah ditentukan, umumnya ditemukan dalam basis data dan spreadsheet. Jenis data sintetis ini meniru format dan sifat statistik dari data terstruktur nyata. Contohnya meliputi:
Metode pembuatan untuk data terstruktur sering melibatkan pemodelan statistik, sistem berbasis aturan, atau teknik pembelajaran mesin seperti variational autoencoder (VAE) atau generative adversarial network (GAN).
2. Data tidak terstruktur
Data tidak terstruktur tidak memiliki format yang telah ditentukan dan semakin penting dalam aplikasi pembelajaran mesin. Jenis data sintetis tidak terstruktur meliputi:
3. Data berurutan
Data berurutan melibatkan waktu atau urutan, sehingga penting untuk model yang perlu memahami hubungan temporal. Contohnya mencakup: