

Neden Sentetik Veri Kullanmalı?
Sentetik veriler, kurumlar ve araştırmacılar için cazip kılan pek çok avantaj sunar. Kullanımı, veri bilimi, makine öğrenimi ve yazılım geliştirmedeki çeşitli zorlukları giderebilir. Sentetik veri kullanmanın bazı nedenleri şunlardır:
1. Veri kıtlığını aşma
Pek çok alanda, yeterli kalitede veri toplamak önemli bir engeldir. Sentetik veriler bu boşlukları doldurarak kapsamlı analiz ve sağlam model eğitimi sağlar.
- Nadir olay simülasyonu: Finans veya afet yönetimi gibi alanlarda bazı kritik olaylar seyrek gerçekleşir. Sentetik veriler bu nadir olayların daha fazla örneğini üreterek, bu kritik senaryolarda model performansını iyileştirebilir.
- Dengeli veri kümeleri: Gerçek dünya verileri sıklıkla sınıf dengesizliğinden muzdariptir. Sentetik veriler, az temsil edilen sınıfları dengelemek üzere üretilebilir ve daha doğru modeller elde edilmesini sağlar.
- Küçük veri kümelerini destekleme: Veri toplamanın pahalı veya zaman alıcı olduğu alanlarda, sentetik veriler sınırlı gerçek veriyi artırarak etkili makine öğrenimi için gereken hacme ulaşmayı sağlar.
2. Veri mahremiyetini güçlendirme
Gerçek bireylere karşılık gelmeyen sentetik veriler kullanarak, kurumlar GDPR ve HIPAA gibi düzenlemelere uyum ve mahremiyet endişelerini aşabilir.
- Anonimleştirmeye alternatif: Bazen geri döndürülebilen anonimleştirme tekniklerinden farklı olarak, sentetik veri sıfırdan üretilir ve yeniden tanımlama riskini ortadan kaldırır.
- Sınır ötesi veri paylaşımı: Sentetik veriler, veri koruma yasalarını ihlal etmeden hassas projelerde uluslararası iş birliğini kolaylaştırabilir.
- Test ve geliştirme: Geliştiriciler, gerçek kişisel bilgilere maruz kalmadan gerçekçi verilerle çalışabilir ve geliştirme sürecinde veri ihlali riskini azaltır.
3. Daha iyi makine öğrenimi modelleri
Sentetik veriler, nadir olaylar veya belirli koşulları içerecek şekilde özelleştirilebilir; bu da veri kümelerini zenginleştirir ve model doğruluğunu artırır.
- Sınır durumlarının temsili: Sentetik veriler, gerçek veride nadir görülen ancak model performansı için kritik olan sınır durumları içerecek şekilde üretilebilir.
- Önyargı azaltma: Sentetik veri üretim süreçleri dikkatle tasarlanarak, mevcut gerçek verilerden daha çeşitli ve temsili veri kümeleri oluşturulabilir; bu da yapay zekâ modellerindeki önyargıyı azaltmaya yardımcı olur.
- Transfer öğrenimi: Sentetik veriler, gerçek verinin kıt olduğu görevlerde modelleri önceden eğitmek için kullanılabilir; sınırlı gerçek verilerle ince ayar yapıldığında performansı iyileştirir.
4. Maliyet etkinliği
Sentetik veriler, gerçek verileri toplamaktan veya satın almaktan daha ekonomik olabilir.
- Azalan veri edinim maliyetleri: Özellikle büyük ölçekli veya uzmanlaşmış veri kümeleri için, sentetik veri üretmek gerçek veri toplamaktan daha ucuz olabilir.
- Daha düşük depolama ve bakım maliyetleri: Sentetik veriler talep üzerine üretilebildiğinden, büyük gerçek veri kümeleriyle ilişkili uzun vadeli depolama maliyetlerini azaltabilir.
- Asgariye indirilmiş hukuki ve uyum giderleri: Sentetik veriler kullanılarak, kurumlar veri mahremiyeti uyumu ve olası hukuki meselelerle ilişkili maliyetleri azaltabilir.
Sentetik Veri Üretim Teknikleri
Sentetik veri üretmek için farklı avantajlara ve kullanım alanlarına sahip çeşitli yöntemler vardır. Bu bölümde bunları gözden geçirelim.
1. Rastgele veri üretimi
Bu, istatistiksel dağılımlardan rastgele örnekleme yoluyla veri üretmeyi içeren en basit yöntemdir.
import pandas as pd
import numpy as np
# Generate 1,000 samples from a normal distribution
heights = np.random.normal(loc=170, scale=10, size=1000)
weights = np.random.normal(loc=70, scale=15, size=1000)
# Create a correlation between height and weight
weights += (heights - 170) * 0.5
df = pd.DataFrame({'Height': heights, 'Weight': weights})
# Add categorical data
genders = np.random.choice(['Male', 'Female'], size=1000)
df['Gender'] = genders
df.head()
df.describe()Yukarıdaki kod, normal dağılımlar kullanarak boy ve kilo simülasyonu yapan rastgele bir veri kümesi üretir. Boylar 170 cm çevresinde, standart sapma 10; kilolar 70 kg çevresinde, standart sapma 15’tir. Boy ile kilo arasında doğrusal bir ilişki tanımlanmıştır; böylece daha uzun bireyler genellikle daha ağırdır. Kod ayrıca “Male” veya “Female” olarak rastgele atanan değerlerle bir Gender sütunu ekler.
Çıktı:
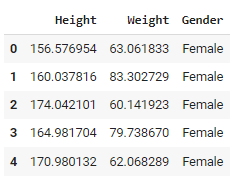
Bu yöntem hızlı ve uygulaması kolaydır; temel testler veya prototipleme için kullanışlıdır. Ancak bazı sınırlamaları vardır: Karmaşık ilişkileri veya gerçek dünya örüntülerini yakalayamaz ve alanla ilgili belirli nüansları veya kısıtları hesaba katmaz.
2. Kural tabanlı üretim
Kural tabanlı yöntemler, belirli özelliklere sahip veriler oluşturmak için önceden tanımlanmış kurallar veya alan bilgisini kullanır. Aşağıdaki örneğe göz atın:
import numpy as np
import pandas as pd
def generate_customer_data(num_records):
data = []
for _ in range(num_records):
age = np.random.randint(18, 80)
# Rule: Income is loosely based on age
base_income = 20000 + (age - 18) * 1000
income = np.random.normal(base_income, base_income * 0.2)
# Rule: Credit score is influenced by age and income
credit_score = min(850, max(300, int(600 + (age/80)*100 + (income/100000)*100 + np.random.normal(0, 50))))
# Rule: Loan amount is based on income and credit score
max_loan = income * (credit_score / 600)
loan_amount = np.random.uniform(0, max_loan)
data.append([age, income, credit_score, loan_amount])
return pd.DataFrame(data, columns=['Age', 'Income', 'CreditScore', 'LoanAmount'])
df = generate_customer_data(1000)
df.head()Yukarıdaki Python kodu, 1.000 kayıttan oluşan bir müşteri veri kümesi üretir. Her müşteri için 18 ile 80 arasında rastgele bir yaş atanır. Yaşa bağlı olarak, daha yaşlı bireylerin genellikle daha yüksek gelire sahip olduğu bir gelir hesaplanır. Kredi puanı, yaş ve gelirden etkilenerek belirlenir ve 300 ile 850 arasında kalması sağlanır. Ayrıca, kişinin geliri ve kredi puanına bağlı bir kredi tutarı da üretilir.
Çıktı:
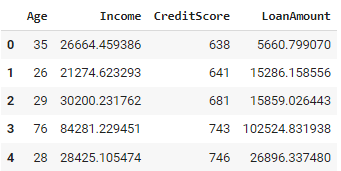
Bu yaklaşım, üretilen verilerin bilinen ilişki ve kısıtları izlemesini sağlar; böylece alanla ilgili bilgiyi doğrudan veri üretim sürecine dâhil etmek mümkün olur. Ancak, çok sayıda birbiriyle ilişkili kuralın bulunduğu sistemlerde karmaşıklaşabilir ve büyük ya da girift veri kümeleri için bu kuralları tanımlamak ve sürdürmek zaman alıcı olabilir.
3. Simülasyon tabanlı üretim
Simülasyon tabanlı veri üretimi, gerçek dünya süreçlerini modelleyerek sentetik veri kümeleri oluşturur. Önceden tanımlanmış kural ve değişkenlere dayalı olay veya davranışları simüle etmeyi içerir ve dinamik sistemlerde farklı faktörlerin nasıl etkileştiğini incelemeye imkân verir.
Bu yöntem, senaryoları test etmek ve olası sonuçları analiz etmek için sıklıkla kullanılır; müşteri hizmet süreçleri, tedarik zincirleri ve sağlık operasyonları gibi karmaşık sistemlere ilişkin değerli içgörüler sağlar. İşte Python’da bir örnek:
import simpy
import random
import pandas as pd
class Bank(object):
def __init__(self, env, num_tellers):
self.env = env
self.teller = simpy.Resource(env, num_tellers)
def service(self, customer):
service_time = random.expovariate(1/10) # Avg service time of 10 minutes
yield self.env.timeout(service_time)
def customer(env, name, bank, data):
arrival_time = env.now
print(f'{name} arrives at the bank at {arrival_time:.2f}')
with bank.teller.request() as request:
yield request
wait_time = env.now - arrival_time
print(f'{name} waits for {wait_time:.2f}')
yield env.process(bank.service(name))
service_time = env.now - arrival_time
print(f'{name} leaves the bank at {env.now:.2f}')
# Append the customer data to the list
data.append((name, arrival_time, wait_time, service_time))
def run_simulation(env, num_customers, bank, data):
for i in range(num_customers):
env.process(customer(env, f'Customer {i}', bank, data))
yield env.timeout(random.expovariate(1/5)) # New customer every 5 minutes on average
# Set up and run the simulation
env = simpy.Environment()
bank = Bank(env, num_tellers=3)
num_customers = 100
data = [] # This will hold the customer data
env.process(run_simulation(env, num_customers, bank, data))
env.run()
# Create a DataFrame from the collected data
df = pd.DataFrame(data, columns=['Customer', 'ArrivalTime', 'WaitTime', 'ServiceTime'])
print(df.head())
print(df.describe())Kod, SimPy kitaplığını kullanarak bir bankayı simüle eder. Müşteriler rastgele aralıklarla gelir, üç gişe görevlisinden birinden hizmet almak için bekler ve hizmet aldıktan sonra ayrılır.
Bank sınıfı (ortalama 10 dakika) hizmet süresini tanımlar; customer() işlevi ise her müşterinin gelişini, bekleme süresini ve hizmet süresini izler. Müşteriler, ortalama her 5 dakikada bir yeni geliş üreten run_simulation() işlevinde işlenir.
Çıktı:
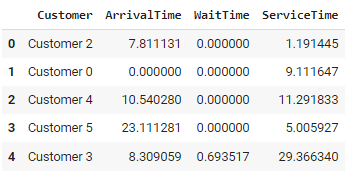
Bu yaklaşım, senaryo testi ve “ya olursa” analizlerini mümkün kılan karmaşık ve dinamik sistemlerin modellenmesini sağlar. Ancak, büyük ölçekli simülasyonlarda hesaplama açısından yoğun olabilir ve doğru sonuçlar için modellenen sistemi kapsamlı biçimde anlamayı gerektirir.
4. Üretici modeller
Üretici modeller olarak üretici çekişmeli ağlar (GAN) ve varyasyonel otokodlayıcılar (VAE), son derece gerçekçi sentetik veriler oluşturmak için popüler hâle gelmiştir. Bu modeller, girdi verisinin temel dağılımını öğrenir ve gerçek dünyadaki verileri taklit eden yeni örnekler üretir.
Her iki yöntem de, gerçek dünya verilerinin kıt veya hassas olduğu durumlarda makine öğrenimi modelleri için sentetik veri oluşturmak amacıyla, özellikle görüntü üretimi ve doğal dil işleme görevlerinde yaygın olarak kullanılır.
Üretken yapay zekâ modellerinin nasıl geliştirildiğini ve gelecekte toplumu nasıl etkileyeceğini öğrenmek için Datacamp’teki Generative AI Concepts adlı ücretsiz kursa göz atın.
Sentetik Veri Üretimi için Araçlar
İstatistiksel modellemeden makine öğrenimine ve sağlık simülasyonlarına kadar çeşitli kullanım durumları için sentetik veri üretmeyi kolaylaştıran birçok araç mevcuttur.
Bu araçlar, gerçek dünya veri kümelerinin özelliklerini yansıtan veriler oluşturmak üzere tasarlanmıştır; böylece hassas bilgileri ifşa etmeden güvenli deney ve test imkânı sağlar.
1. Python’da Synthetic Data Vault (SDV)
SDV, sentetik veri üretimi için bir dizi model sunan bir Python kitaplığıdır. Zaman serileri, ilişkisel veriler ve tablosal veriler dâhil çok çeşitli veri türlerini destekler. SDV, özgün verinin yapısını öğrenmek ve yüksek kaliteli sentetik sürümler üretmek için Gaussian copula gibi gelişmiş olasılıksal modelleri ve derin öğrenme yöntemlerini kullanır. Gerçek verinin sınırlı veya hassas olduğu durumlarda makine öğrenimi uygulamalarında sentetik eğitim verileri üretmek için yaygın biçimde kullanılır.
Python’da SDV kitaplığıyla sentetik veri üretimi hakkında daha fazla bilgi edinmek için resmi GitHub deposuna göz atın veya resmi öğreticilerini deneyin.
2. Gretel.AI
Gretel.AI, sentetik veri üretimi ve anonimleştirme hizmetleri sunan bulut tabanlı bir platformdur. Yapılandırılmış, yarı yapılandırılmış ve yapılandırılmamış veriler de dâhil çeşitli girdilere dayalı gerçekçi sentetik veriler üretebilen, kullanıcı dostu API’ler ve önceden hazırlanmış modeller sağlar. Gretel.AI, geliştirici ve veri bilimcilerin iş akışını basitleştirmeye odaklanır; böylece minimum kurulumla sentetik veri üretmeyi kolaylaştırır.
Gretel.AI ile sentetik veri üretimine başlamak için Gretel’in hızlı başlangıç kılavuzuna göz atın.
3. Synthea
Synthea, özellikle sağlık simülasyonları için geliştirilmiş açık kaynaklı bir araçtır. Tıbbi ve klinik standartlara uyarak, gerçekçi tıbbi geçmişleri, tedavileri ve sonuçları yansıtan sentetik hasta kayıtları üretir. Araştırmacılar ve sağlık kurumları, gerçek hasta verisi kullanmadan hasta popülasyonlarını simüle etmek ve halk sağlığı eğilimlerini incelemek için Synthea’yı sıklıkla kullanır; bu da onu sağlık verisi analizi için çok değerli kılar.
4. synthpop (R programlama dili)
synthpop, gerçek dünya veri kümelerinin sentetik sürümlerini üretmek için özel olarak tasarlanmış bir R paketidir. Özgün veride bulunan ilişkileri ve dağılımları yinelemek için istatistiksel modeller kullanır; böylece kullanıcıların gizliliği tehlikeye atmadan verileri güvenle paylaşmasına ve analiz etmesine olanak tanır. synthpop, özellikle gizliliği koruyarak veri kümesi yayımlaması gereken araştırmacılar ve kurumlar için yararlıdır.
R’da synthpop kullanarak sentetik veri üretimi hakkında daha fazla bilgi için Generating Synthetic Data Sets with synthpop in R öğreticisine göz atın.
Sentetik Veride Üretken Yapay Zekânın Rolü
Daha önce belirtildiği gibi, üretken yapay zekâ sentetik veri oluşturulmasında önemli bir rol oynar; esas olarak gerçek dünya verilerinin temel örüntü ve dağılımlarını öğrenip gerçekçi sentetik sürümler üreten gelişmiş modeller aracılığıyla. Bu tekniklerin her birini ve uygulamalarını inceleyelim.
Üretici çekişmeli ağlar (GAN)
GAN’ler, sentetik veri üretimi için en güçlü araçlardan biridir. üretici ve ayrıştırıcı olmak üzere iki rekabetçi sinir ağından oluşurlar. Üretici sentetik veriler oluştururken, ayrıştırıcı gerçek ve sentetik veriyi ayırt etmeye çalışır. Bu çekişmeli süreç sayesinde üretici, son derece gerçekçi veriler üretme becerisini geliştirir. GAN’ler; görüntü, video ve hatta tablosal veri üretiminde yaygın olarak kullanılır ve sağlık, otonom sürüş ve eğlence gibi alanlarda uygulamalar bulmuştur.
Varyasyonel otokodlayıcılar (VAE)
VAE’ler, sentetik veri üretimi için kullanılan bir diğer popüler üretici modeldir. Veriyi sıkıştırılmış bir gizil uzaya kodlayıp sonra tekrar özgün formuna çözerler. Bu sayede VAE’ler, gizil uzaydan örnekleme yaparak yeni veri noktaları üretebilir; bu da onları görüntü sentezi ve anomali tespiti gibi uygulamalar için kullanışlı kılar. VAE’ler GAN’lerle aynı düzeyde gerçekçilik sağlamasa da eğitim sırasında daha kararlıdır ve üretilen verinin yapısı üzerinde daha iyi kontrol sunar.
Metin üretimi için dönüştürücü modeller
Transformer’lar, GPT modelleri gibi, tutarlı ve bağlama uygun cümle ve paragraflar üreterek metin üretimini dönüştürmüştür. Sentetik veri için transformer’lar, müşteri yorumları, konuşmalar veya diğer metinsel veriler gibi gerçek dünya veri kümelerini yansıtan insan benzeri metinler üretebilir. Bu modeller, doğal dil işleme (NLP) görevleri için büyük ölçekli metin tabanlı sentetik veri üretirken özellikle kullanışlıdır; ayrıca belirli uygulamalar için ince ayar yapmaya da elverişlidir.
Üretken yapay zekânın günümüzde ve gelecekte iş dünyasında oynadığı rolü öğrenmek için Generative AI for Business kursuna göz atın.
Sentetik Veri Üretimine Başlama
1. Doğru tekniği seçmek
Uygun sentetik veri üretim tekniği, kullanım durumunuza, veri türünüze ve hedeflerinize bağlıdır. İyi tanımlanmış istatistiksel dağılımlara sahip basit veri kümeleri için rastgele veri üretimi veya kural tabanlı üretim yeterli olabilir.
Karmaşık, birbiriyle ilişkili verilerle çalışıyorsanız veya ilişkisel bütünlüğü korumanız gerekiyorsa (ör. sağlık veya finans), simülasyon tabanlı bir yaklaşım ya da GAN ve VAE gibi üretici modeller daha uygun olabilir. Metin üretimi veya büyük ölçekli verileri içeren görevlerde ise dönüştürücü tabanlı modeller daha iyi sonuçlar verebilir.
Bir teknik seçerken uygulama kolaylığı, veri gerçekçiliği ve hesaplama gereksinimleri arasındaki ödünleşimleri dikkate alın.
2. Gretel.AI API kullanarak Python’da uygulama
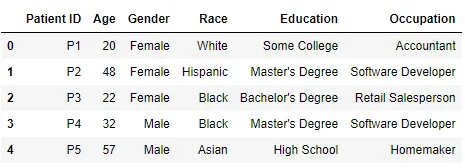
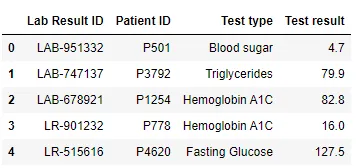
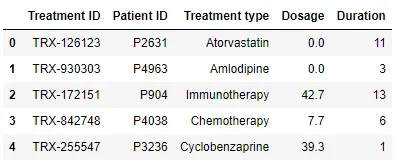
Bu örneği göstermek için, her biri tam olarak 5.000 kayda sahip üç tablodan oluşan sahte bir hasta veritabanı oluşturdum.
Tablo 1 - Hastalar
Tablo 2 - Laboratuvar Sonuçları
Tablo 3 - Tedaviler
Bu örneği uygulamak için Gretel.AI’ye kaydolmanız ve bir API anahtarı oluşturmanız gerekir. Ayrıca Python’da bir kütüphane kurmanız gerekecektir:
!pip install -U gretel-trainerBu kullanım durumunu uygulamak için gretel_trainer.relational modülündeki RelationalDatayı kullanacağız. Bu modül, kullanıcıların birden çok tablo arasındaki ilişkileri otomatik olarak tanımlayıp sürdürmesine olanak tanıyarak, yabancı anahtar bağımlılıklarının ve veri bütünlüğünün sentetik çıktıda korunmasını sağlar.
Bu, gerçek dünya veritabanlarının yapı ve bağımlılıklarını yansıtan yüksek kaliteli sentetik veriler üretmek için özellikle kullanışlıdır ve makine öğrenimi, araştırma veya veri mahremiyeti düzenlemeleriyle uyum gibi uygulamalarda kullanmayı kolaylaştırır.
Kod Örneği:
import pandas as pd
from gretel_client import configure_session
from gretel_trainer.relational import RelationalData
configure_session(api_key="your_api_key", cache="yes", validate=True)
csv_dir = "csv/"
tables = [("patients", "Patient ID"), ("lab_results", "Lab Result ID"), ("treatments", "Treatment ID")]
foreign_keys = [("lab_results.Patient ID", "patients.Patient ID"), ("treatments.Patient ID", "patients.Patient ID")]
relational_data = RelationalData()
for table, pk in tables:
relational_data.add_table(name=table, primary_key=pk, data=pd.read_csv(f"{csv_dir}/{table}.csv"))
for fk, ref in foreign_keys:
relational_data.add_foreign_key(foreign_key=fk, referencing=ref)
from gretel_trainer.relational import MultiTable
multitable = MultiTable(
relational_data,
project_display_name="Clinical Trials",
gretel_model="amplify"
)
multitable.train()
multitable.generate(record_size_ratio=1)
synthetic_patients = multitable.synthetic_output_tables['patients']
synthetic_lab_results = multitable.synthetic_output_tables['lab_results']
synthetic_treatments = multitable.synthetic_output_tables['treatments']
Bu kod, ilişkisel bir veritabanı için sentetik veri üretmek üzere Gretel.AI API’sini kullanır. Önce bir API anahtarıyla oturum kurar ve birincil anahtarları belirtilmiş üç CSV dosyasını (patients, lab_results ve treatments) yükler, ardından yabancı anahtar ilişkilerini tanımlar.
RelationalData sınıfı, bu ilişkileri sürdürmek için kullanılır. Veriler yapılandırıldıktan sonra, tüm ilişkisel veri kümesini sentezleyen MultiTable sınıfı kullanılarak bir model eğitilir.
Model eğitildikten sonra, generate() yöntemi sentetik veri üretmek için kullanılır. record_size_ratio parametresi, üretilen verinin boyutuna referans oranını belirler. record_size_ratio=1, sentetik veri kümesindeki kayıt sayısının özgün veri kümesine eşit olduğu anlamına gelir; yani 5.000 kayıt.
3. Sentetik veri kümesinin kalitesini değerlendirme
Sentetik verinin kalitesini değerlendirmek, işe yararlığını ve mahremiyetini güvence altına almak için esastır. Öncelikle özgün ve sentetik veriler arasındaki istatistiksel dağılımları karşılaştırın — ortalama, varyans ve korelasyon gibi metriklerin yakından örtüşmesi gerekir.
Bir diğer yöntem, sentetik veriyi kullanarak makine öğrenimi modelleri eğitmek ve performanslarını (ör. doğruluk veya F1 skoru) gerçek verilerle eğitilmiş modellerle karşılaştırmaktır.
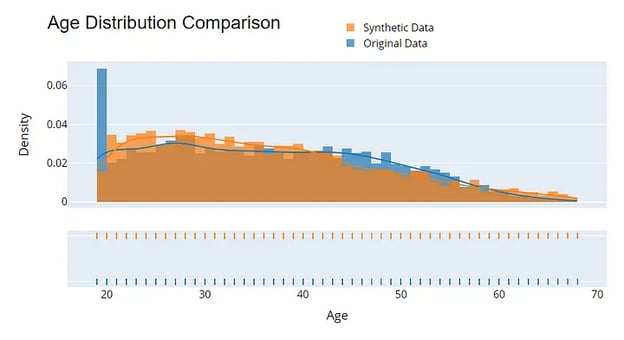
Sentetik verinin kalitesini değerlendirmek için örnek görselleştirme. Görsel: Yazar.
Sonuç
Sentetik veri üretimi; veri kıtlığı, mahremiyet endişeleri ve çeşitli, yüksek kaliteli veri kümelerine duyulan ihtiyaçla ilgili zorlukları ele almak üzere ortaya çıkmıştır.
Basit rastgele veri üretiminden GAN ve VAE gibi gelişmiş üretici modellere kadar uzanan tekniklerle, sentetik veri kurumların hassas bilgileri korurken yenilik yapmasını ve daha iyi makine öğrenimi modelleri inşa etmesini sağlar.
SDV gibi araçlar ve Gretel.AI gibi yönetilen hizmetler, karmaşık ilişkisel veritabanları için bile sentetik veri üretimini daha erişilebilir hâle getirir.
Sentetik veri üretimi geliştikçe, uygulamaları yapay zekânın, sağlığın, finansın ve sayısız diğer alanın ilerlemesinde giderek daha önemli olacaktır.
Daha derine inmek ister misiniz? Bankacılık, sağlık ve daha birçok sektörde sentetik verinin mahremiyeti nasıl koruduğunu ve yapay zekâ benimsenmesini nasıl hızlandırdığını keşfetmek için Python’da Makine Öğrenimi & Yapay Zekâ için Sentetik Veri Kullanımı eğitimini izleyin.
SSS
Sentetik veri, gerçek veriden nasıl farklıdır?
Sentetik veri, gerçek verinin istatistiksel özelliklerini taklit edecek şekilde yapay olarak üretilir ancak gerçek varlıkları temsil etmez. Gerçek veri, gerçek dünya kaynaklarından toplanırken; sentetik veri algoritmalar aracılığıyla üretilir ve bu da onu mahremiyet ve veri kıtlığı sorunlarını aşmak için ideal kılar.
Sentetik veri, yapay zekâ modellerini eğitmek için gerçek veri kadar güvenilir midir?
Evet, yeter ki gerçek verideki örüntüleri ve ilişkileri doğru şekilde yakalayan, yüksek kaliteli yöntemlerle üretilmiş olsun; sentetik veri de en az gerçek veriler kadar güvenilir olabilir. Hatta bazı durumlarda, gerçek veri kümelerinde tipik olarak bulunmayan nadir olayları veya sınır durumları ekleyerek modelleri geliştirebilir.
Düzenleyici uyum için sentetik verileri kullanabilir miyim?
Evet, sentetik veri, gerçek bireylere veya hassas bilgilere karşılık gelmediğinden, mahremiyet kaygılarını ortadan kaldırarak düzenlemelere uyuma yardımcı olabilir. Bu da verileri, veri koruma yasalarını ihlal etmeden sınırlar arasında test etmek ve paylaşmak için kullanışlı kılar.
Sentetik veri kullanmanın herhangi bir sınırlaması var mı?
Sentetik veri güçlü bir araç olmakla birlikte, özellikle son derece nüanslı alanlarda gerçek dünya verisinin tüm karmaşıklığını yakalamayabilir. Ayrıca, üretim süreci dikkatle tasarlanmazsa önyargı veya gerçekçi olmayan örüntüler de ortaya çıkabilir. Bu nedenle, sentetik veriye tamamen güvenmeden önce, belirli kullanım durumunuzdaki sınırlamaları değerlendirmeniz önemlidir.





GPT sonrası dünyada, yüksek kaliteli veri kümelerine olan talep hiç olmadığı kadar arttı. Üretken yapay zekâ ve büyük dil modelleri güçlü, kaliteli ve bol miktarda verinin mevcudiyetine dayanır. Ancak, bu tür verileri elde etmek genellikle mahremiyet endişelerinden, dünyadaki gerçek verinin azlığına kadar uzanan zorluklarla karşılaşır.
İşte sentetik veri üretimi: Gerçek verinin kıtlığını gideren ve mahremiyet endişelerini bertaraf eden güçlü bir çözüm. Bu blog yazısında sentetik verinin ne olduğunu, neden önemli olduğunu, nasıl üretileceğine ilişkin teknik ve araçları ve nasıl başlayabileceğinizi öğreneceğiz.
Sentetik Veri Nedir?
Sentetik veri, gerçek dünyadaki verilerin yapısını ve istatistiksel özelliklerini taklit eden ancak gerçek varlıklarla birebir örtüşmeyen, yapay olarak üretilmiş bilgilerdir. Algoritmik olarak oluşturulur ve çeşitli uygulamalarda gerçek verinin yerine kullanılır.
Bu özellikler, yazılım testi, yapay zekâ modeli eğitimi, veri artırma, finansal modelleme ve sağlık araştırmaları gibi, büyük ve çeşitli veri kümelerinin gerekli olduğu ancak gerçek verinin az, hassas ya da gizlilik düzenlemeleriyle kısıtlı olduğu alanlarda sentetik veriyi çok değerli kılar.
Bilgisayar simülasyonları veya algoritmalarla üretilen sentetik veriler, gerçek dünya verilerine uygun maliyetli bir alternatif sunar ve giderek daha fazla doğru yapay zekâ modelleri oluşturmak için kullanılmaktadır. Görsel kaynağı: NVIDIA blog
Sentetik Veri Türleri
Üç ana sentetik veri türü yapılandırılmış, yapılandırılmamış ve sıralı veridir; her birinin kendine özgü özellikleri ve kullanım alanları vardır. Haydi bunları daha ayrıntılı inceleyelim.
1. Yapılandırılmış veri
Yapılandırılmış veri, genellikle veritabanları ve e-tablolarda bulunan, önceden tanımlanmış bir düzende organize edilmiş bilgidir. Bu tür sentetik veri, gerçek yapılandırılmış verinin biçimini ve istatistiksel özelliklerini taklit eder. Örnekler şunları içerir:
Yapılandırılmış sentetik verinin üretim yöntemleri sıklıkla istatistiksel modelleme, kural tabanlı sistemler veya varyasyonel otokodlayıcılar (VAE) ya da üretici çekişmeli ağlar (GAN) gibi makine öğrenimi tekniklerini içerir.
2. Yapılandırılmamış veri
Yapılandırılmamış verinin önceden tanımlı bir formatı yoktur ve makine öğrenimi uygulamalarında giderek daha önemli hâle gelmektedir. Sentetik yapılandırılmamış veri türleri şunlardır:
3. Sıralı veri
Sıralı veri zaman veya düzen içerir ve zamansal ilişkileri anlaması gereken modeller için temel önemdedir. Örnekler şunlardır: