
Khóa học
Tìm hiểu Machine Learning
2 giờ
313.7K
Trong thế giới hậu-GPT, nhu cầu về các bộ dữ liệu chất lượng cao chưa bao giờ lớn đến vậy. AI tạo sinh và mô hình ngôn ngữ lớn đều phụ thuộc vào tính sẵn có của dữ liệu mạnh, chất lượng cao và số lượng lớn. Tuy nhiên, việc thu thập dữ liệu như vậy thường gặp thách thức, từ lo ngại về quyền riêng tư đến sự khan hiếm dữ liệu thực trên toàn thế giới.
Đó là lúc tạo dữ liệu tổng hợp xuất hiện: một giải pháp mạnh mẽ giải quyết tình trạng khan hiếm dữ liệu thực và xử lý các lo ngại về quyền riêng tư. Trong bài viết này, chúng ta sẽ tìm hiểu dữ liệu tổng hợp là gì, vì sao nó quan trọng, các kỹ thuật và công cụ để tạo ra, và cách bạn có thể bắt đầu.
Dữ liệu tổng hợp là thông tin được tạo nhân tạo, mô phỏng dữ liệu thế giới thực về cấu trúc và tính chất thống kê nhưng không tương ứng với các thực thể thật. Nó được tạo ra bằng thuật toán và dùng thay thế cho dữ liệu thực trong nhiều ứng dụng.
Những đặc điểm này khiến dữ liệu tổng hợp trở nên vô giá cho kiểm thử phần mềm, huấn luyện mô hình AI, tăng cường dữ liệu, mô hình tài chính và nghiên cứu y tế, nơi cần các bộ dữ liệu lớn, đa dạng nhưng dữ liệu thực có thể khan hiếm, nhạy cảm hoặc bị hạn chế bởi quy định về quyền riêng tư.
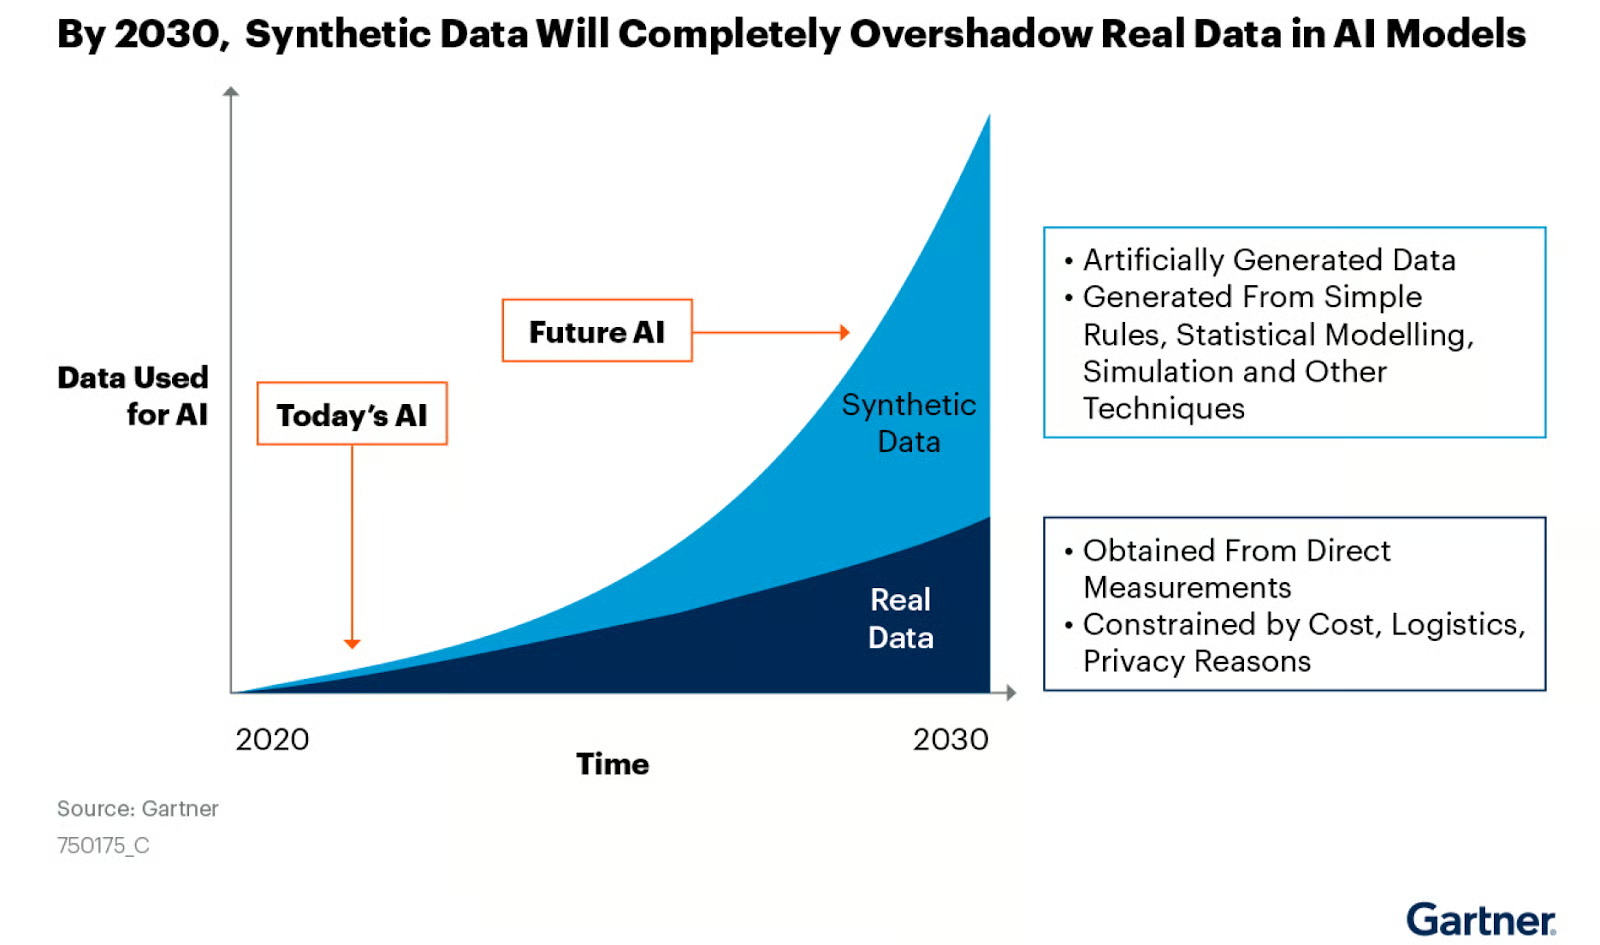
Dữ liệu tổng hợp được tạo từ mô phỏng máy tính hoặc thuật toán cung cấp một lựa chọn thay thế rẻ hơn cho dữ liệu thế giới thực và ngày càng được dùng để tạo các mô hình AI chính xác. Nguồn ảnh: blog NVIDIA
Ba loại chính của dữ liệu tổng hợp là có cấu trúc, phi cấu trúc và tuần tự, mỗi loại có đặc trưng và ứng dụng riêng. Hãy cùng tìm hiểu chi tiết hơn.
Dữ liệu có cấu trúc là thông tin được tổ chức theo định dạng xác định trước, thường thấy trong cơ sở dữ liệu và bảng tính. Loại dữ liệu tổng hợp này mô phỏng định dạng và tính chất thống kê của dữ liệu có cấu trúc thực. Ví dụ gồm:
Các phương pháp tạo dữ liệu tổng hợp có cấu trúc thường bao gồm mô hình thống kê, hệ thống dựa trên luật hoặc kỹ thuật học máy như biến đổi tự mã hoá biến thiên (VAE) hoặc mạng sinh đối kháng (GAN).
Dữ liệu phi cấu trúc không có định dạng xác định trước và ngày càng quan trọng trong các ứng dụng học máy. Các loại dữ liệu phi cấu trúc tổng hợp bao gồm:
Dữ liệu tuần tự liên quan đến thời gian hoặc thứ tự, rất cần thiết cho các mô hình cần hiểu quan hệ theo thời gian. Ví dụ gồm:
Dữ liệu tổng hợp mang lại nhiều lợi ích, khiến nó trở thành lựa chọn hấp dẫn cho các tổ chức và nhà nghiên cứu. Việc sử dụng có thể giải quyết nhiều thách thức trong khoa học dữ liệu, học máy và phát triển phần mềm. Dưới đây là một số lý do nên dùng dữ liệu tổng hợp:
Ở nhiều lĩnh vực, thu thập đủ dữ liệu chất lượng là rào cản đáng kể. Dữ liệu tổng hợp có thể lấp đầy khoảng trống này, cho phép phân tích toàn diện và huấn luyện mô hình vững chắc.
Bằng cách sử dụng dữ liệu tổng hợp không tương ứng với cá nhân thực, các tổ chức có thể tránh lo ngại quyền riêng tư và tuân thủ các quy định như GDPR và HIPAA.
Dữ liệu tổng hợp có thể được điều chỉnh để bao gồm sự kiện hiếm hoặc điều kiện cụ thể, làm giàu bộ dữ liệu và cải thiện độ chính xác của mô hình.
Dữ liệu tổng hợp thường tiết kiệm chi phí hơn so với việc thu thập hoặc mua dữ liệu thực.
Có nhiều phương pháp tạo dữ liệu tổng hợp, mỗi phương pháp có ưu điểm và trường hợp sử dụng riêng. Hãy cùng điểm qua trong phần này.
Đây là phương pháp đơn giản nhất, tạo dữ liệu bằng cách lấy mẫu ngẫu nhiên từ các phân phối thống kê.
import pandas as pd
import numpy as np

# Generate 1,000 samples from a normal distribution
heights = np.random.normal(loc=170, scale=10, size=1000)
weights = np.random.normal(loc=70, scale=15, size=1000)

# Create a correlation between height and weight
weights += (heights - 170) * 0.5
df = pd.DataFrame({'Height': heights, 'Weight': weights})

# Add categorical data
genders = np.random.choice(['Male', 'Female'], size=1000)
df['Gender'] = genders
df.head()
df.describe()
Đoạn mã trên tạo một bộ dữ liệu ngẫu nhiên mô phỏng chiều cao và cân nặng bằng phân phối chuẩn. Chiều cao tập trung quanh 170 cm với độ lệch chuẩn 10, và cân nặng quanh 70 kg với độ lệch chuẩn 15. Một quan hệ tuyến tính được đưa vào giữa chiều cao và cân nặng, nên người cao hơn thường nặng hơn. Mã cũng thêm cột Gender với giá trị gán ngẫu nhiên “Male” hoặc “Female”.
Kết quả:
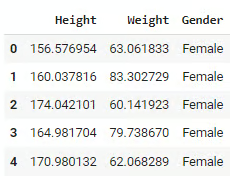
Phương pháp này nhanh và dễ triển khai, hữu ích cho kiểm thử cơ bản hoặc tạo mẫu. Tuy nhiên, có những hạn chế: không nắm bắt được các mối quan hệ phức tạp hay mô thức thế giới thực, cũng như không xét đến sắc thái hay ràng buộc đặc thù miền.
Phương pháp dựa trên luật dùng các quy tắc định sẵn hoặc kiến thức miền để tạo dữ liệu với đặc trưng cụ thể. Xem ví dụ sau:
import numpy as np
import pandas as pd

def generate_customer_data(num_records):
    data = []
    for _ in range(num_records):
        age = np.random.randint(18, 80)

        # Rule: Income is loosely based on age
        base_income = 20000 + (age - 18) * 1000
        income = np.random.normal(base_income, base_income * 0.2)

        # Rule: Credit score is influenced by age and income
        credit_score = min(850, max(300, int(600 + (age/80)*100 + (income/100000)*100 + np.random.normal(0, 50))))

        # Rule: Loan amount is based on income and credit score
        max_loan = income * (credit_score / 600)
        loan_amount = np.random.uniform(0, max_loan)

        data.append([age, income, credit_score, loan_amount])

    return pd.DataFrame(data, columns=['Age', 'Income', 'CreditScore', 'LoanAmount'])

df = generate_customer_data(1000)
df.head()
Mã Python trên tạo một bộ dữ liệu khách hàng gồm 1.000 bản ghi. Với mỗi khách hàng, tuổi được gán ngẫu nhiên từ 18 đến 80. Dựa trên tuổi, thu nhập được tính, theo đó người lớn tuổi thường có thu nhập cao hơn. Điểm tín dụng được xác định, chịu ảnh hưởng bởi tuổi và thu nhập, đảm bảo nằm trong khoảng 300 đến 850. Số tiền vay cũng được tạo, phụ thuộc vào thu nhập và điểm tín dụng của cá nhân.
Kết quả:
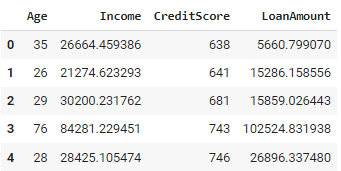
Cách tiếp cận này đảm bảo dữ liệu tạo ra tuân theo các mối quan hệ và ràng buộc đã biết, cho phép đưa trực tiếp kiến thức miền vào quy trình tạo dữ liệu. Tuy nhiên, nó có thể trở nên phức tạp khi xử lý hệ thống có nhiều quy tắc liên quan, và việc định nghĩa, duy trì các quy tắc như vậy tốn thời gian với bộ dữ liệu lớn hoặc tinh vi.
Tạo dữ liệu dựa trên mô phỏng mô hình hoá các quy trình thế giới thực để tạo bộ dữ liệu tổng hợp. Nó bao gồm mô phỏng sự kiện hoặc hành vi dựa trên quy tắc và biến số định sẵn, cho phép chúng ta nghiên cứu cách các yếu tố khác nhau tương tác trong hệ thống động.
Phương pháp này thường dùng để kiểm thử kịch bản và phân tích kết quả tiềm năng, cung cấp hiểu biết giá trị về các hệ thống phức tạp như quy trình dịch vụ khách hàng, chuỗi cung ứng và hoạt động y tế. Dưới đây là ví dụ trong Python:
import simpy
import random
import pandas as pd

class Bank(object):
    def __init__(self, env, num_tellers):
        self.env = env
        self.teller = simpy.Resource(env, num_tellers)

    def service(self, customer):
        service_time = random.expovariate(1/10)  # Avg service time of 10 minutes
        yield self.env.timeout(service_time)

def customer(env, name, bank, data):
    arrival_time = env.now
    print(f'{name} arrives at the bank at {arrival_time:.2f}')

    with bank.teller.request() as request:
        yield request
        wait_time = env.now - arrival_time
        print(f'{name} waits for {wait_time:.2f}')

        yield env.process(bank.service(name))

        service_time = env.now - arrival_time
        print(f'{name} leaves the bank at {env.now:.2f}')

    # Append the customer data to the list
    data.append((name, arrival_time, wait_time, service_time))

def run_simulation(env, num_customers, bank, data):
    for i in range(num_customers):
        env.process(customer(env, f'Customer {i}', bank, data))
        yield env.timeout(random.expovariate(1/5))  # New customer every 5 minutes on average

# Set up and run the simulation
env = simpy.Environment()
bank = Bank(env, num_tellers=3)
num_customers = 100
data = []  # This will hold the customer data
env.process(run_simulation(env, num_customers, bank, data))
env.run()

# Create a DataFrame from the collected data
df = pd.DataFrame(data, columns=['Customer', 'ArrivalTime', 'WaitTime', 'ServiceTime'])
print(df.head())
print(df.describe())
Đoạn mã mô phỏng một ngân hàng bằng thư viện SimPy. Khách hàng đến theo khoảng ngẫu nhiên, chờ phục vụ từ một trong ba giao dịch viên và rời đi sau khi được phục vụ.
Lớp Bank xác định thời gian phục vụ (trung bình 10 phút), trong khi hàm customer() theo dõi thời điểm đến, thời gian chờ và thời lượng phục vụ của mỗi khách hàng. Khách hàng được xử lý trong hàm run_simulation(), tạo lượt đến mới trung bình mỗi 5 phút.
Kết quả:
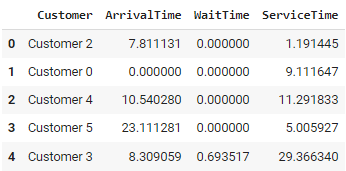
Cách tiếp cận này cho phép mô hình hoá các hệ thống phức tạp và động, hỗ trợ kiểm thử kịch bản và phân tích “điều gì xảy ra nếu”. Tuy nhiên, nó có thể đòi hỏi nhiều tính toán cho mô phỏng quy mô lớn và cần hiểu biết sâu về hệ thống được mô hình để đảm bảo kết quả chính xác.
Các mô hình tạo sinh như mạng sinh đối kháng (GAN) và biến đổi tự mã hoá biến thiên (VAE) đã trở nên phổ biến để tạo dữ liệu tổng hợp có độ chân thực cao. Các mô hình này học cách nắm bắt phân phối nền của dữ liệu đầu vào và tạo mẫu mới mô phỏng dữ liệu thế giới thực.
Cả hai phương pháp đều được dùng rộng rãi trong các tác vụ như tạo ảnh và xử lý ngôn ngữ tự nhiên, chủ yếu để tạo dữ liệu tổng hợp cho mô hình học máy khi dữ liệu thực khan hiếm hoặc nhạy cảm.
Hãy khám phá khoá học miễn phí Generative AI Concepts trên Datacamp để tìm hiểu cách phát triển mô hình AI tạo sinh và tác động của chúng đến xã hội trong tương lai.
Có nhiều công cụ giúp tạo dữ liệu tổng hợp cho nhiều trường hợp sử dụng, từ mô hình thống kê đến học máy và mô phỏng y tế.
Các công cụ này được thiết kế để tạo dữ liệu phản chiếu đặc trưng của bộ dữ liệu thế giới thực, cho phép thử nghiệm và kiểm thử an toàn mà không để lộ thông tin nhạy cảm.
SDV là thư viện Python cung cấp một bộ mô hình để tạo dữ liệu tổng hợp. Nó hỗ trợ nhiều kiểu dữ liệu, bao gồm chuỗi thời gian, dữ liệu quan hệ và dữ liệu dạng bảng. SDV sử dụng các mô hình xác suất tiên tiến như Gaussian copula và phương pháp học sâu để học cấu trúc của dữ liệu gốc và tạo ra phiên bản tổng hợp chất lượng cao. Nó được dùng rộng rãi trong ứng dụng học máy để tạo dữ liệu huấn luyện tổng hợp khi dữ liệu thực hạn chế hoặc nhạy cảm.
Để tìm hiểu thêm về tạo dữ liệu tổng hợp bằng thư viện SDV trong Python, hãy xem kho GitHub chính thức hoặc thử các hướng dẫn chính thức.
Gretel.AI là nền tảng đám mây cung cấp dịch vụ tạo dữ liệu tổng hợp và ẩn danh hoá. Nó cung cấp API thân thiện và mô hình dựng sẵn có thể tạo dữ liệu tổng hợp chân thực dựa trên nhiều loại đầu vào, bao gồm dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc. Gretel.AI tập trung đơn giản hoá quy trình cho nhà phát triển và nhà khoa học dữ liệu, giúp tạo dữ liệu tổng hợp với cấu hình tối thiểu.
Xem hướng dẫn khởi động nhanh của Gretel để bắt đầu tạo dữ liệu tổng hợp với Gretel.AI
Synthea là công cụ mã nguồn mở được phát triển riêng cho mô phỏng y tế. Nó tạo hồ sơ bệnh nhân tổng hợp phản ánh lịch sử y khoa, điều trị và kết quả chân thực, tuân theo tiêu chuẩn y tế và lâm sàng. Các nhà nghiên cứu và tổ chức y tế thường dùng Synthea để mô phỏng quần thể bệnh nhân và nghiên cứu xu hướng sức khoẻ cộng đồng mà không cần dữ liệu bệnh nhân thực, vô cùng hữu ích cho phân tích dữ liệu y tế.
synthpop là gói R được thiết kế để tạo phiên bản tổng hợp của các bộ dữ liệu thế giới thực. Nó hoạt động bằng cách sử dụng mô hình thống kê để tái tạo các mối quan hệ và phân phối có trong dữ liệu gốc, cho phép người dùng chia sẻ và phân tích dữ liệu an toàn mà không ảnh hưởng tính bảo mật. synthpop đặc biệt hữu ích cho các nhà nghiên cứu và tổ chức cần phát hành bộ dữ liệu trong khi vẫn bảo vệ quyền riêng tư.
Để tìm hiểu thêm về tạo dữ liệu tổng hợp trong R bằng synthpop, hãy xem hướng dẫn Generating Synthetic Data Sets with synthpop in R.
Như đã đề cập, AI tạo sinh đóng vai trò quan trọng trong việc tạo dữ liệu tổng hợp, chủ yếu thông qua các mô hình tiên tiến học các mô thức và phân phối ẩn của dữ liệu thế giới thực và tạo ra phiên bản tổng hợp chân thực. Hãy cùng khám phá từng kỹ thuật và ứng dụng của chúng.
GAN là một trong những công cụ mạnh mẽ nhất để tạo dữ liệu tổng hợp. Chúng gồm hai mạng nơ-ron cạnh tranh: bộ sinh và bộ phân biệt. Bộ sinh tạo dữ liệu tổng hợp, trong khi bộ phân biệt cố gắng phân biệt dữ liệu thực và dữ liệu tổng hợp. Thông qua quá trình đối kháng này, bộ sinh cải thiện khả năng tạo dữ liệu rất chân thực. GAN được dùng rộng rãi để tạo hình ảnh, video và thậm chí dữ liệu dạng bảng, và đã tìm thấy ứng dụng trong y tế, xe tự hành và giải trí.
VAE là một mô hình tạo sinh phổ biến khác để tạo dữ liệu tổng hợp. Chúng hoạt động bằng cách mã hoá dữ liệu vào không gian tiềm ẩn nén rồi giải mã trở lại dạng ban đầu. Điều này cho phép VAE tạo điểm dữ liệu mới bằng cách lấy mẫu từ không gian tiềm ẩn, hữu ích cho các ứng dụng như tổng hợp ảnh và phát hiện bất thường. Dù VAE không đạt mức chân thực như GAN, chúng ổn định hơn trong huấn luyện và cung cấp khả năng kiểm soát tốt hơn cấu trúc dữ liệu sinh ra.
Transformer, như các mô hình GPT, đã cách mạng hoá việc sinh văn bản bằng cách tạo ra câu và đoạn văn mạch lạc, đúng ngữ cảnh. Với dữ liệu tổng hợp, Transformer có thể sinh văn bản giống con người, phản chiếu các bộ dữ liệu thế giới thực như đánh giá khách hàng, hội thoại hoặc dữ liệu văn bản khác. Các mô hình này đặc biệt hữu ích khi tạo lượng lớn dữ liệu tổng hợp dựa trên văn bản cho các tác vụ NLP, đồng thời linh hoạt để tinh chỉnh cho ứng dụng cụ thể.
Để tìm hiểu vai trò của trí tuệ nhân tạo tạo sinh trong môi trường kinh doanh hiện tại và tương lai, hãy xem khoá học Generative AI for Business.
Kỹ thuật tạo dữ liệu tổng hợp phù hợp phụ thuộc vào trường hợp sử dụng, kiểu dữ liệu và mục tiêu của bạn. Với các bộ dữ liệu đơn giản có phân phối thống kê xác định rõ, tạo dữ liệu ngẫu nhiên hoặc dựa trên luật có thể là đủ.
Nếu bạn xử lý dữ liệu phức tạp, có quan hệ ràng buộc hoặc cần bảo toàn tính toàn vẹn quan hệ (ví dụ trong y tế hoặc tài chính), cách tiếp cận dựa trên mô phỏng hoặc các mô hình tạo sinh như GAN và VAE có thể phù hợp hơn. Với sinh văn bản hoặc tác vụ liên quan dữ liệu quy mô lớn, các mô hình dựa trên Transformer có thể cho kết quả tốt hơn.
Hãy cân nhắc đánh đổi giữa mức độ dễ triển khai, tính chân thực của dữ liệu và yêu cầu tính toán khi chọn kỹ thuật.
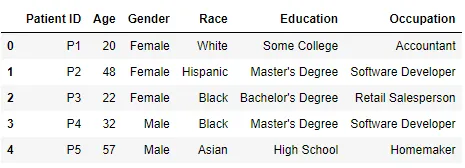
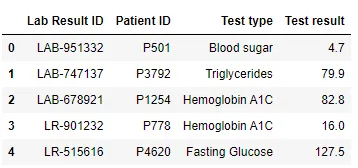
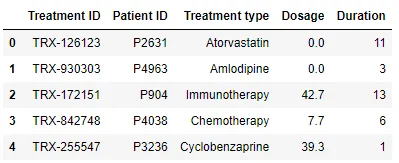
Để minh hoạ ví dụ này, tôi đã tạo một cơ sở dữ liệu bệnh nhân giả gồm ba bảng, mỗi bảng có đúng 5.000 bản ghi.
Bảng 1 - Bệnh nhân
Bảng 2 - Kết quả xét nghiệm
Bảng 3 - Điều trị
Để triển khai ví dụ này, bạn sẽ cần đăng ký trên Gretel.AI và tạo khoá API. Bạn cũng sẽ cần cài một thư viện trong Python:
!pip install -U gretel-trainerĐể triển khai trường hợp sử dụng này, chúng ta sẽ dùng RelationalData từ mô-đun gretel_trainer.relational. Nó cho phép người dùng tự động định nghĩa và duy trì quan hệ giữa nhiều bảng, đảm bảo phụ thuộc khoá ngoại và tính toàn vẹn dữ liệu được bảo toàn trong đầu ra tổng hợp.
Điều này đặc biệt hữu ích để tạo dữ liệu tổng hợp chất lượng cao phản chiếu cấu trúc và phụ thuộc của cơ sở dữ liệu thế giới thực, giúp dễ sử dụng trong các ứng dụng như học máy, nghiên cứu hoặc tuân thủ quy định về quyền riêng tư dữ liệu.
Ví dụ mã:
import pandas as pd
from gretel_client import configure_session
from gretel_trainer.relational import RelationalData

configure_session(api_key="your_api_key", cache="yes", validate=True)

csv_dir = "csv/"
tables = [("patients", "Patient ID"), ("lab_results", "Lab Result ID"), ("treatments", "Treatment ID")]
foreign_keys = [("lab_results.Patient ID", "patients.Patient ID"), ("treatments.Patient ID", "patients.Patient ID")]

relational_data = RelationalData()
for table, pk in tables:
    relational_data.add_table(name=table, primary_key=pk, data=pd.read_csv(f"{csv_dir}/{table}.csv"))
for fk, ref in foreign_keys:
    relational_data.add_foreign_key(foreign_key=fk, referencing=ref)

from gretel_trainer.relational import MultiTable

multitable = MultiTable(
    relational_data,
    project_display_name="Clinical Trials",
    gretel_model="amplify"
)
multitable.train()

multitable.generate(record_size_ratio=1)
synthetic_patients = multitable.synthetic_output_tables['patients']
synthetic_lab_results = multitable.synthetic_output_tables['lab_results']
synthetic_treatments = multitable.synthetic_output_tables['treatments']
Đoạn mã này sử dụng API Gretel.AI để tạo dữ liệu tổng hợp cho cơ sở dữ liệu quan hệ. Trước tiên, thiết lập phiên làm việc bằng khoá API và nạp ba tệp CSV (patients, lab_results và treatments), chỉ định khoá chính và định nghĩa quan hệ khoá ngoại.
Lớp RelationalData được dùng để duy trì các quan hệ này. Sau khi cấu hình dữ liệu, một mô hình được huấn luyện bằng lớp MultiTable, mô phỏng toàn bộ tập dữ liệu quan hệ.
Sau khi mô hình được huấn luyện, phương thức generate() được dùng để tạo dữ liệu tổng hợp. Tham số record_size_ratio xác định tỷ lệ tham chiếu đến kích thước dữ liệu tạo ra. record_size_ratio=1 nghĩa là số bản ghi trong bộ dữ liệu tổng hợp = bộ dữ liệu gốc, tức 5.000 bản ghi.
Đánh giá chất lượng dữ liệu tổng hợp là điều thiết yếu để đảm bảo tính hữu dụng và quyền riêng tư. Bắt đầu bằng cách so sánh phân phối thống kê giữa dữ liệu gốc và dữ liệu tổng hợp — các chỉ số như trung bình, phương sai và tương quan nên khớp chặt chẽ.
Một phương pháp khác là dùng dữ liệu tổng hợp để huấn luyện mô hình học máy và so sánh hiệu suất (ví dụ: độ chính xác hoặc F1) với mô hình huấn luyện trên dữ liệu thực.
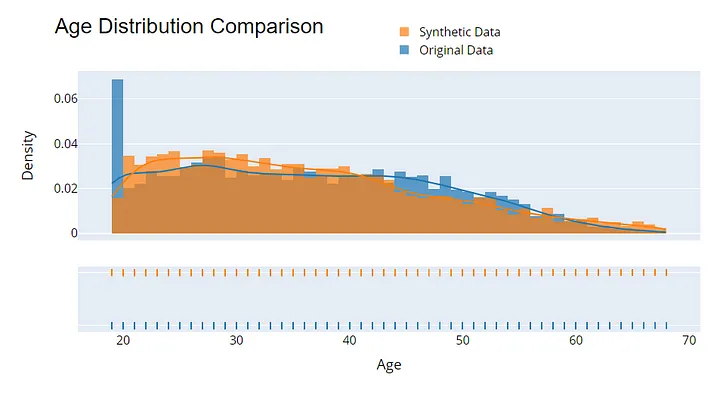
Ví dụ trực quan hoá để đánh giá chất lượng dữ liệu tổng hợp. Ảnh do Tác giả.
Tạo dữ liệu tổng hợp đã xuất hiện để giải quyết các thách thức liên quan đến khan hiếm dữ liệu, lo ngại quyền riêng tư và nhu cầu về các bộ dữ liệu đa dạng, chất lượng cao.
Với các kỹ thuật từ tạo dữ liệu ngẫu nhiên đơn giản đến mô hình tạo sinh tiên tiến như GAN và VAE, dữ liệu tổng hợp cho phép các tổ chức đổi mới và xây dựng mô hình học máy tốt hơn trong khi vẫn bảo vệ thông tin nhạy cảm.
Các công cụ như SDV và dịch vụ quản lý như Gretel.AI giúp việc tạo dữ liệu tổng hợp trở nên dễ tiếp cận hơn, ngay cả với cơ sở dữ liệu quan hệ phức tạp.
Khi việc tạo dữ liệu tổng hợp phát triển, các ứng dụng của nó sẽ ngày càng quan trọng trong việc thúc đẩy AI, y tế, tài chính và vô số lĩnh vực khác.
Bạn muốn tìm hiểu sâu hơn? Xem buổi đào tạo Using Synthetic Data for Machine Learning & AI in Python để khám phá dữ liệu tổng hợp là gì, cách nó bảo vệ quyền riêng tư và cách nó được sử dụng để tăng tốc ứng dụng AI trong ngân hàng, y tế và nhiều ngành khác.
Tìm hiểu thêm về học máy và AI với các khoá học sau!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
