
Corso
Capire il Machine Learning
2 ore
313.7K
Nel mondo post-GPT, la domanda di dataset di alta qualità non è mai stata così alta. L’IA generativa e i modelli linguistici di grandi dimensioni dipendono tutti dalla disponibilità di dati robusti, di alta qualità e in grande quantità. Tuttavia, ottenere tali dati spesso comporta sfide, che vanno dalle preoccupazioni per la privacy alla semplice scarsità di dati reali disponibili nel mondo.
Ecco la generazione di dati sintetici: una soluzione potente che affronta la scarsità di dati reali e risolve le problematiche di privacy. In questo post, vedremo cosa sono i dati sintetici, perché sono essenziali, le tecniche e gli strumenti per generarli e come iniziare.
I dati sintetici sono informazioni generate artificialmente che imitano i dati del mondo reale nella struttura e nelle proprietà statistiche, ma non corrispondono a entità reali. Sono creati algoritmicamente e vengono utilizzati come sostituti dei dati reali in varie applicazioni.
Queste caratteristiche rendono i dati sintetici preziosi per il collaudo software, l’addestramento di modelli di IA, il data augmentation, la modellazione finanziaria e la ricerca sanitaria, ambiti in cui servono dataset ampi e diversificati ma i dati reali possono essere scarsi, sensibili o vincolati da normative sulla privacy.
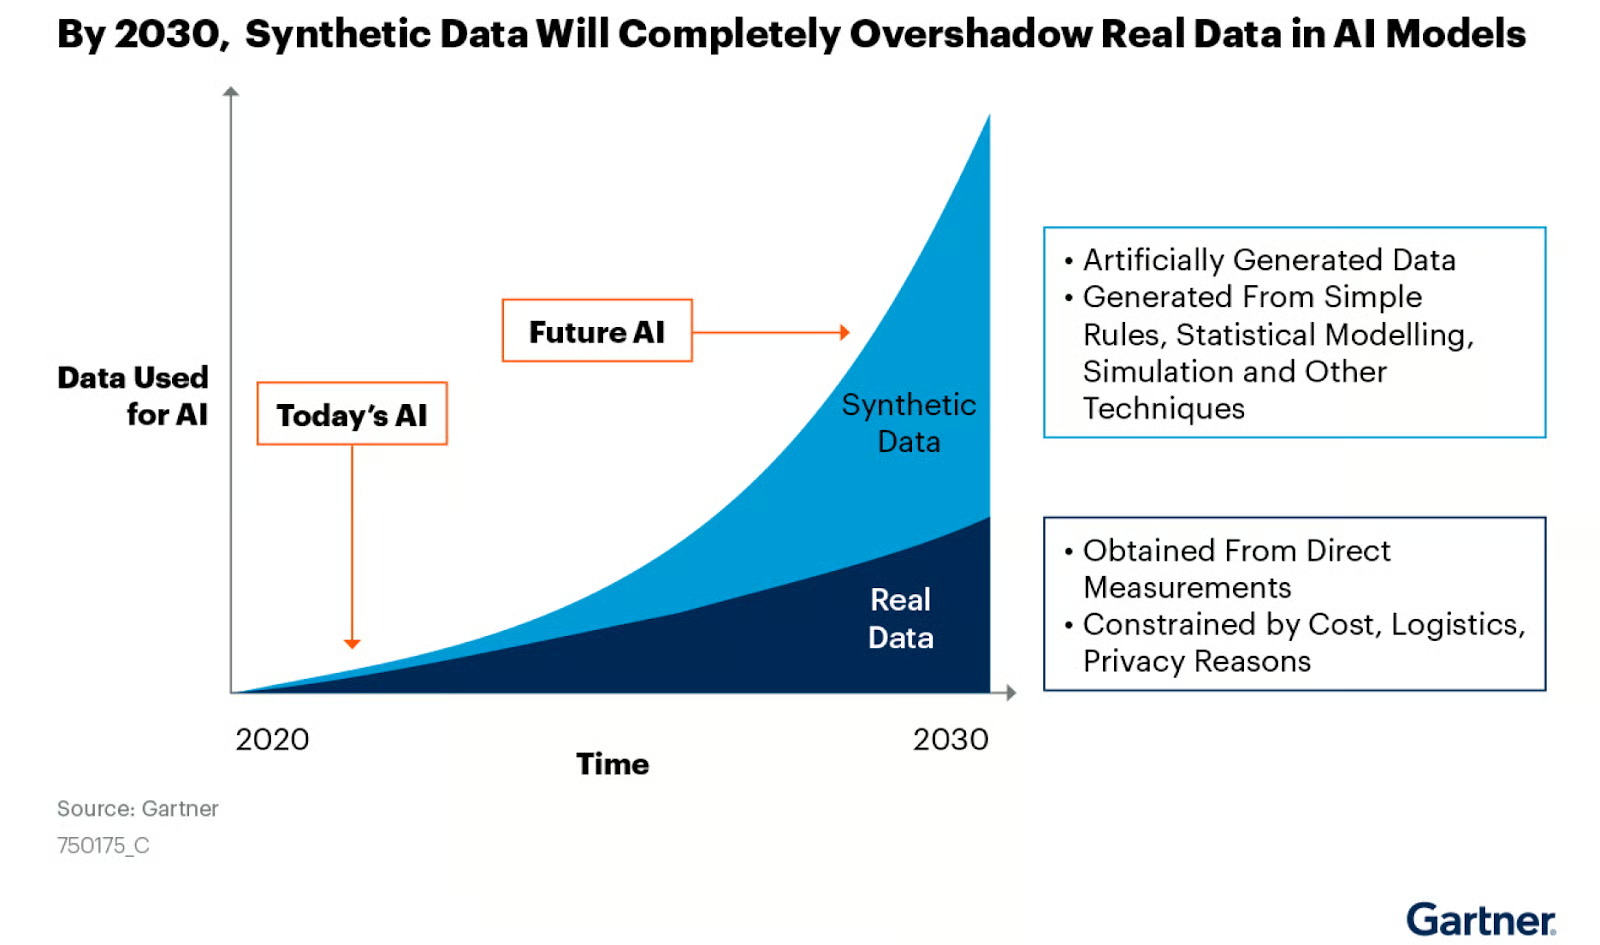
I dati sintetici generati da simulazioni o algoritmi offrono un’alternativa economica ai dati del mondo reale e sono sempre più utilizzati per creare modelli di IA accurati. Fonte immagine: blog NVIDIA
I tre principali tipi di dati sintetici sono strutturati, non strutturati e sequenziali, ciascuno con caratteristiche e applicazioni proprie. Vediamoli più nel dettaglio.
I dati strutturati sono informazioni organizzate in un formato predefinito, tipicamente presenti in database e fogli di calcolo. Questo tipo di dati sintetici imita il formato e le proprietà statistiche dei dati strutturati reali. Esempi includono:
I metodi di generazione per dati strutturati spesso coinvolgono modellazione statistica, sistemi basati su regole o tecniche di machine learning come i variational autoencoder (VAE) o le generative adversarial network (GAN).
I dati non strutturati non hanno un formato predefinito e sono sempre più importanti nelle applicazioni di machine learning. Tipologie di dati non strutturati sintetici includono:
I dati sequenziali coinvolgono il tempo o l’ordine, risultando essenziali per i modelli che devono comprendere le relazioni temporali. Esempi includono:
I dati sintetici offrono diversi vantaggi, rendendoli un’opzione interessante per organizzazioni e ricercatori. Il loro utilizzo può affrontare varie sfide in data science, machine learning e sviluppo software. Ecco alcuni motivi per usarli:
In molti settori, raccogliere abbastanza dati di qualità è un ostacolo significativo. I dati sintetici possono colmare queste lacune, consentendo analisi complete e un addestramento robusto dei modelli.
Usando dati sintetici che non corrispondono a persone reali, le organizzazioni possono evitare problemi di privacy e soddisfare normative come GDPR e HIPAA.
I dati sintetici possono essere calibrati per includere eventi rari o condizioni specifiche, arricchendo i dataset e migliorando l’accuratezza dei modelli.
I dati sintetici spesso sono più convenienti rispetto alla raccolta o all’acquisto di dati reali.
Esistono diversi metodi per generare dati sintetici, ognuno con vantaggi e casi d’uso specifici. Rivediamoli in questa sezione.
È il metodo più semplice: consiste nel generare dati campionando casualmente da distribuzioni statistiche.
import pandas as pd
import numpy as np

# Generate 1,000 samples from a normal distribution
heights = np.random.normal(loc=170, scale=10, size=1000)
weights = np.random.normal(loc=70, scale=15, size=1000)

# Create a correlation between height and weight
weights += (heights - 170) * 0.5
df = pd.DataFrame({'Height': heights, 'Weight': weights})

# Add categorical data
genders = np.random.choice(['Male', 'Female'], size=1000)
df['Gender'] = genders
df.head()
df.describe()
Il codice sopra genera un dataset casuale che simula altezza e peso usando distribuzioni normali. Le altezze sono centrate a 170 cm con deviazione standard 10, e i pesi sono centrati a 70 kg con deviazione standard 15. È introdotta una relazione lineare tra altezza e peso, così che in generale le persone più alte pesino di più. Il codice aggiunge anche una colonna Gender con valori assegnati casualmente “Male” o “Female”.
Output:
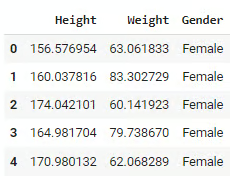
Questo metodo è rapido e facile da implementare, utile per test di base o prototipi. Tuttavia, presenta limiti: non cattura relazioni complesse o pattern reali e non tiene conto di sfumature o vincoli specifici del dominio.
I metodi basati su regole utilizzano regole predefinite o conoscenza del dominio per creare dati con caratteristiche specifiche. Ecco un esempio:
import numpy as np
import pandas as pd

def generate_customer_data(num_records):
    data = []
    for _ in range(num_records):
        age = np.random.randint(18, 80)

        # Rule: Income is loosely based on age
        base_income = 20000 + (age - 18) * 1000
        income = np.random.normal(base_income, base_income * 0.2)

        # Rule: Credit score is influenced by age and income
        credit_score = min(850, max(300, int(600 + (age/80)*100 + (income/100000)*100 + np.random.normal(0, 50))))

        # Rule: Loan amount is based on income and credit score
        max_loan = income * (credit_score / 600)
        loan_amount = np.random.uniform(0, max_loan)

        data.append([age, income, credit_score, loan_amount])

    return pd.DataFrame(data, columns=['Age', 'Income', 'CreditScore', 'LoanAmount'])

df = generate_customer_data(1000)
df.head()
Il codice Python sopra genera un dataset di clienti con 1.000 record. Per ciascun cliente assegna casualmente un’età tra 18 e 80. In base all’età calcola un reddito, per cui in generale le persone più anziane hanno redditi più alti. Il punteggio di credito è poi determinato, influenzato da età e reddito, garantendo che sia compreso tra 300 e 850. Viene generato anche un importo del prestito, dipendente dal reddito e dal punteggio di credito della persona.
Output:
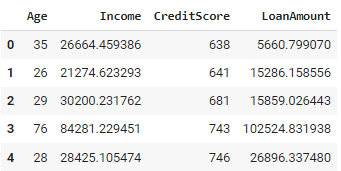
Questo approccio garantisce che i dati generati rispettino relazioni e vincoli noti, consentendo di incorporare direttamente la conoscenza del dominio nel processo di generazione. Tuttavia, può diventare complesso quando si affrontano sistemi con molte regole interrelate, e definire e mantenere tali regole può richiedere tempo per dataset ampi o intricati.
La generazione basata su simulazione modella processi reali per creare dataset sintetici. Comporta la simulazione di eventi o comportamenti in base a regole e variabili predefinite, permettendo di studiare come diversi fattori interagiscono in sistemi dinamici.
Questo metodo è spesso usato per testare scenari e analizzare potenziali esiti, offrendo insight preziosi in sistemi complessi come processi di customer service, supply chain e operazioni sanitarie. Ecco un esempio in Python:
import simpy
import random
import pandas as pd

class Bank(object):
    def __init__(self, env, num_tellers):
        self.env = env
        self.teller = simpy.Resource(env, num_tellers)

    def service(self, customer):
        service_time = random.expovariate(1/10)  # Avg service time of 10 minutes
        yield self.env.timeout(service_time)

def customer(env, name, bank, data):
    arrival_time = env.now
    print(f'{name} arrives at the bank at {arrival_time:.2f}')

    with bank.teller.request() as request:
        yield request
        wait_time = env.now - arrival_time
        print(f'{name} waits for {wait_time:.2f}')

        yield env.process(bank.service(name))

        service_time = env.now - arrival_time
        print(f'{name} leaves the bank at {env.now:.2f}')

    # Append the customer data to the list
    data.append((name, arrival_time, wait_time, service_time))

def run_simulation(env, num_customers, bank, data):
    for i in range(num_customers):
        env.process(customer(env, f'Customer {i}', bank, data))
        yield env.timeout(random.expovariate(1/5))  # New customer every 5 minutes on average

# Set up and run the simulation
env = simpy.Environment()
bank = Bank(env, num_tellers=3)
num_customers = 100
data = []  # This will hold the customer data
env.process(run_simulation(env, num_customers, bank, data))
env.run()

# Create a DataFrame from the collected data
df = pd.DataFrame(data, columns=['Customer', 'ArrivalTime', 'WaitTime', 'ServiceTime'])
print(df.head())
print(df.describe())
Il codice simula una banca usando la libreria SimPy. I clienti arrivano a intervalli casuali, attendono il servizio da uno dei tre sportellisti disponibili e poi lasciano dopo essere stati serviti.
La classe Bank definisce il tempo di servizio (in media 10 minuti), mentre la funzione customer() traccia l’arrivo, il tempo di attesa e la durata del servizio di ogni cliente. I clienti vengono processati nella funzione run_simulation(), che genera nuovi arrivi in media ogni 5 minuti.
Output:
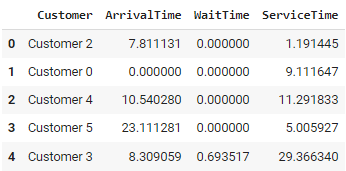
Questo approccio consente di modellare sistemi complessi e dinamici, abilitando test di scenario e analisi “what-if”. Tuttavia, può diventare oneroso dal punto di vista computazionale per simulazioni su larga scala e richiede una profonda comprensione del sistema modellato per risultati accurati.
I modelli generativi come le generative adversarial network (GAN) e i variational autoencoder (VAE) sono diventati popolari per creare dati sintetici altamente realistici. Questi modelli imparano a catturare la distribuzione sottostante dei dati in input e generano nuovi campioni che imitano i dati reali.
Entrambi i metodi sono ampiamente usati in attività come generazione di immagini e NLP, principalmente per creare dati sintetici per modelli di ML quando i dati reali sono scarsi o sensibili.
Dai un’occhiata al corso gratuito Generative AI Concepts su Datacamp per imparare come vengono sviluppati i modelli di IA generativa e come influenzeranno la società in futuro.
Sono disponibili diversi strumenti che facilitano la generazione di dati sintetici per vari casi d’uso, dalla modellazione statistica al machine learning e alle simulazioni in ambito sanitario.
Questi strumenti sono progettati per creare dati che rispecchiano le caratteristiche dei dataset reali, consentendo sperimentazione e test in sicurezza senza esporre informazioni sensibili.
SDV è una libreria Python che offre una suite di modelli per generare dati sintetici. Supporta vari tipi di dati, tra cui serie temporali, dati relazionali e tabellari. SDV utilizza modelli probabilistici avanzati come le copule gaussiane e metodi di deep learning per imparare la struttura dei dati originali e produrre versioni sintetiche di alta qualità. È ampiamente usata in applicazioni di ML per generare dati di addestramento quando i dati reali sono limitati o sensibili.
Per saperne di più sulla generazione di dati sintetici con la libreria SDV in Python, consulta il repository GitHub ufficiale o prova i loro tutorial ufficiali.
Gretel.AI è una piattaforma cloud che offre servizi di generazione e anonimizzazione di dati sintetici. Fornisce API user-friendly e modelli predefiniti in grado di generare dati sintetici realistici a partire da vari input, inclusi dati strutturati, semi-strutturati e non strutturati. Gretel.AI punta a semplificare il workflow per sviluppatori e data scientist, rendendo più semplice generare dati sintetici con setup minimo.
Dai un’occhiata al quick start di Gretel per iniziare a generare dati sintetici con Gretel.AI
Synthea è uno strumento open source sviluppato specificamente per simulazioni in ambito sanitario. Genera cartelle cliniche sintetiche che riflettono storie mediche, trattamenti ed esiti realistici, seguendo standard medici e clinici. Ricercatori e istituzioni sanitarie usano spesso Synthea per simulare popolazioni di pazienti e studiare trend di salute pubblica senza usare dati reali di pazienti, risultando prezioso per l’analisi dei dati sanitari.
synthpop è un pacchetto R progettato specificamente per generare versioni sintetiche di dataset reali. Funziona usando modelli statistici per replicare relazioni e distribuzioni presenti nei dati originali, consentendo di condividere e analizzare i dati in sicurezza senza compromettere la riservatezza. synthpop è particolarmente utile per ricercatori e istituzioni che devono rilasciare dataset proteggendo la privacy.
Per saperne di più sulla generazione di dati sintetici in R con synthpop, consulta il tutorial Generating Synthetic Data Sets with synthpop in R.
Come accennato, l’IA generativa gioca un ruolo significativo nella creazione di dati sintetici, soprattutto tramite modelli avanzati che apprendono pattern e distribuzioni sottostanti dei dati reali e generano versioni sintetiche realistiche. Esploriamo ciascuna tecnica e le sue applicazioni.
Le GAN sono tra gli strumenti più potenti per generare dati sintetici. Sono composte da due reti neurali in competizione: un generatore e un discriminatore. Il generatore crea dati sintetici, mentre il discriminatore tenta di distinguere tra dati reali e sintetici. Attraverso questo processo avversariale, il generatore migliora la sua capacità di creare dati altamente realistici. Le GAN sono ampiamente usate per generare immagini, video e persino dati tabellari, con applicazioni in salute, guida autonoma e intrattenimento.
I VAE sono un altro modello generativo popolare per la generazione di dati sintetici. Funzionano codificando i dati in uno spazio latente compresso e decodificandoli poi alla forma originale. Questo permette ai VAE di generare nuovi punti dati campionando dallo spazio latente, rendendoli utili per applicazioni come la sintesi di immagini e il rilevamento di anomalie. Pur non raggiungendo il livello di realismo delle GAN, sono più stabili in addestramento e offrono maggiore controllo sulla struttura dei dati generati.
I Transformer, come i modelli GPT, hanno rivoluzionato la generazione di testo producendo frasi e paragrafi coerenti e contestualmente accurati. Per i dati sintetici, i Transformer possono generare testo simile a quello umano che rispecchia dataset reali, come recensioni dei clienti, conversazioni o altri dati testuali. Questi modelli sono particolarmente utili quando si devono generare grandi volumi di dati sintetici testuali per compiti di NLP, ma offrono anche flessibilità di fine-tuning per applicazioni specifiche.
Per capire il ruolo che l’intelligenza artificiale generativa ricopre oggi e ricoprirà in futuro nel business, guarda il corso Generative AI for Business.
La tecnica appropriata dipende dal caso d’uso, dal tipo di dati e dagli obiettivi. Per dataset semplici con distribuzioni statistiche ben definite, la generazione casuale o basata su regole può essere sufficiente.
Se lavori con dati complessi e interrelati o devi preservare l’integrità relazionale (ad es. in sanità o finanza), un approccio basato su simulazione o modelli generativi come GAN e VAE potrebbe essere più adatto. Per la generazione di testo o task con grandi volumi di dati, i modelli basati su Transformer possono dare risultati migliori.
Considera i trade-off tra facilità di implementazione, realismo dei dati e requisiti computazionali quando scegli una tecnica.
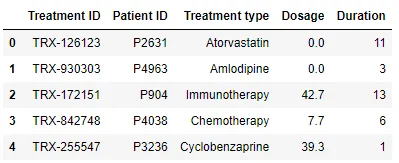
Per questo esempio ho generato un database fittizio di pazienti con tre tabelle, ciascuna con esattamente 5.000 record.
Tabella 1 - Pazienti
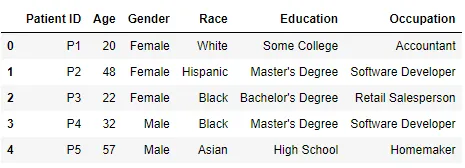
Tabella 2 - Esami di laboratorio
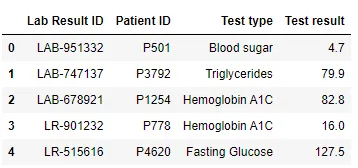
Tabella 3 - Trattamenti
Per implementare questo esempio, dovrai registrarti su Gretel.AI e generare una chiave API. Dovrai anche installare una libreria in Python:
!pip install -U gretel-trainerPer questo caso d’uso, useremo RelationalData dal modulo gretel_trainer.relational. Consente di definire e mantenere automaticamente le relazioni tra più tabelle, assicurando che le dipendenze delle chiavi esterne e l’integrità dei dati siano preservate nell’output sintetico.
Questo è particolarmente utile per generare dati sintetici di alta qualità che rispecchiano la struttura e le dipendenze dei database reali, rendendone più semplice l’uso in applicazioni come ML, ricerca o conformità alle normative sulla privacy dei dati.
Esempio di codice:
import pandas as pd
from gretel_client import configure_session
from gretel_trainer.relational import RelationalData

configure_session(api_key="your_api_key", cache="yes", validate=True)

csv_dir = "csv/"
tables = [("patients", "Patient ID"), ("lab_results", "Lab Result ID"), ("treatments", "Treatment ID")]
foreign_keys = [("lab_results.Patient ID", "patients.Patient ID"), ("treatments.Patient ID", "patients.Patient ID")]

relational_data = RelationalData()
for table, pk in tables:
    relational_data.add_table(name=table, primary_key=pk, data=pd.read_csv(f"{csv_dir}/{table}.csv"))
for fk, ref in foreign_keys:
    relational_data.add_foreign_key(foreign_key=fk, referencing=ref)

from gretel_trainer.relational import MultiTable

multitable = MultiTable(
    relational_data,
    project_display_name="Clinical Trials",
    gretel_model="amplify"
)
multitable.train()

multitable.generate(record_size_ratio=1)
synthetic_patients = multitable.synthetic_output_tables['patients']
synthetic_lab_results = multitable.synthetic_output_tables['lab_results']
synthetic_treatments = multitable.synthetic_output_tables['treatments']
Questo codice usa l’API di Gretel.AI per generare dati sintetici per un database relazionale. Prima imposta una sessione con una chiave API e carica tre file CSV (patients, lab_results e treatments), specificandone le chiavi primarie e definendo le relazioni di chiave esterna.
La classe RelationalData è usata per mantenere queste relazioni. Dopo aver configurato i dati, si addestra un modello usando la classe MultiTable, che sintetizza l’intero dataset relazionale.
Dopo l’addestramento del modello, il metodo generate() viene utilizzato per generare dati sintetici. Il parametro record_size_ratio determina il rapporto rispetto alla dimensione dei dati generati. record_size_ratio=1 significa che il numero di record nel dataset sintetico = dataset originale, cioè 5.000 record.
Valutare la qualità dei dati sintetici è fondamentale per garantirne utilità e privacy. Inizia confrontando le distribuzioni statistiche tra dati originali e sintetici: metriche come media, varianza e correlazione dovrebbero corrispondere da vicino.
Un altro metodo consiste nell’usare i dati sintetici per addestrare modelli di machine learning e confrontare le loro prestazioni (ad es. accuratezza o F1) con modelli addestrati su dati reali.
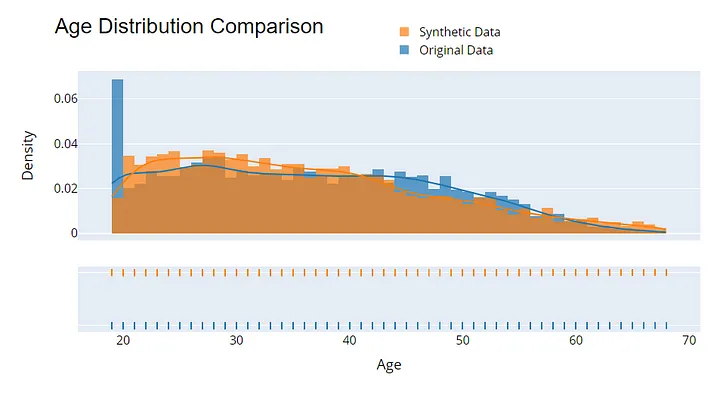
Esempio di visualizzazione per valutare la qualità dei dati sintetici. Immagine dell’autore.
La generazione di dati sintetici è emersa per affrontare sfide legate alla scarsità di dati, alla privacy e al bisogno di dataset diversificati e di alta qualità.
Con tecniche che vanno dalla semplice generazione casuale a modelli generativi avanzati come GAN e VAE, i dati sintetici permettono alle organizzazioni di innovare e costruire modelli di ML migliori proteggendo al contempo le informazioni sensibili.
Strumenti come SDV e servizi gestiti come Gretel.AI rendono più accessibile la generazione di dati sintetici, anche per database relazionali complessi.
Man mano che la generazione di dati sintetici evolve, le sue applicazioni saranno sempre più importanti per far avanzare l’IA, la sanità, la finanza e molti altri settori.
Vuoi approfondire? Guarda la formazione Using Synthetic Data for Machine Learning & AI in Python per scoprire cosa sono i dati sintetici, come proteggono la privacy e come vengono usati per accelerare l’adozione dell’IA in banking, sanità e molti altri settori.
Approfondisci machine learning e IA con i seguenti corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



