
Cursus
Inzicht in Machine Learning
2 uur
313.7K
In de post-GPT-wereld is de vraag naar hoogwaardige datasets groter dan ooit. Generatieve AI en large language models hangen allemaal af van de beschikbaarheid van robuuste, hoogwaardige én omvangrijke data. Het bemachtigen van zulke data gaat echter vaak gepaard met uitdagingen, van privacykwesties tot de schaarste aan echte data wereldwijd.
Enter synthetische datageneratie: een krachtige oplossing die de schaarste aan echte data aanpakt en privacyzorgen wegneemt. In deze blogpost leer je wat synthetische data is, waarom het essentieel is, welke technieken en tools je kunt gebruiken en hoe je ermee aan de slag gaat.
Synthetische data is kunstmatig gegenereerde informatie die de structuur en statistische eigenschappen van echte data nabootst, maar niet overeenkomt met echte entiteiten. Het wordt algoritmisch gecreëerd en dient als vervanging voor echte data in uiteenlopende toepassingen.
Deze kenmerken maken synthetische data van onschatbare waarde voor softwaretesting, training van AI-modellen, data-augmentatie, financieel modelleren en onderzoek in de zorg, waar grote, diverse datasets nodig zijn maar echte data schaars, gevoelig of beperkt is door privacywetgeving.
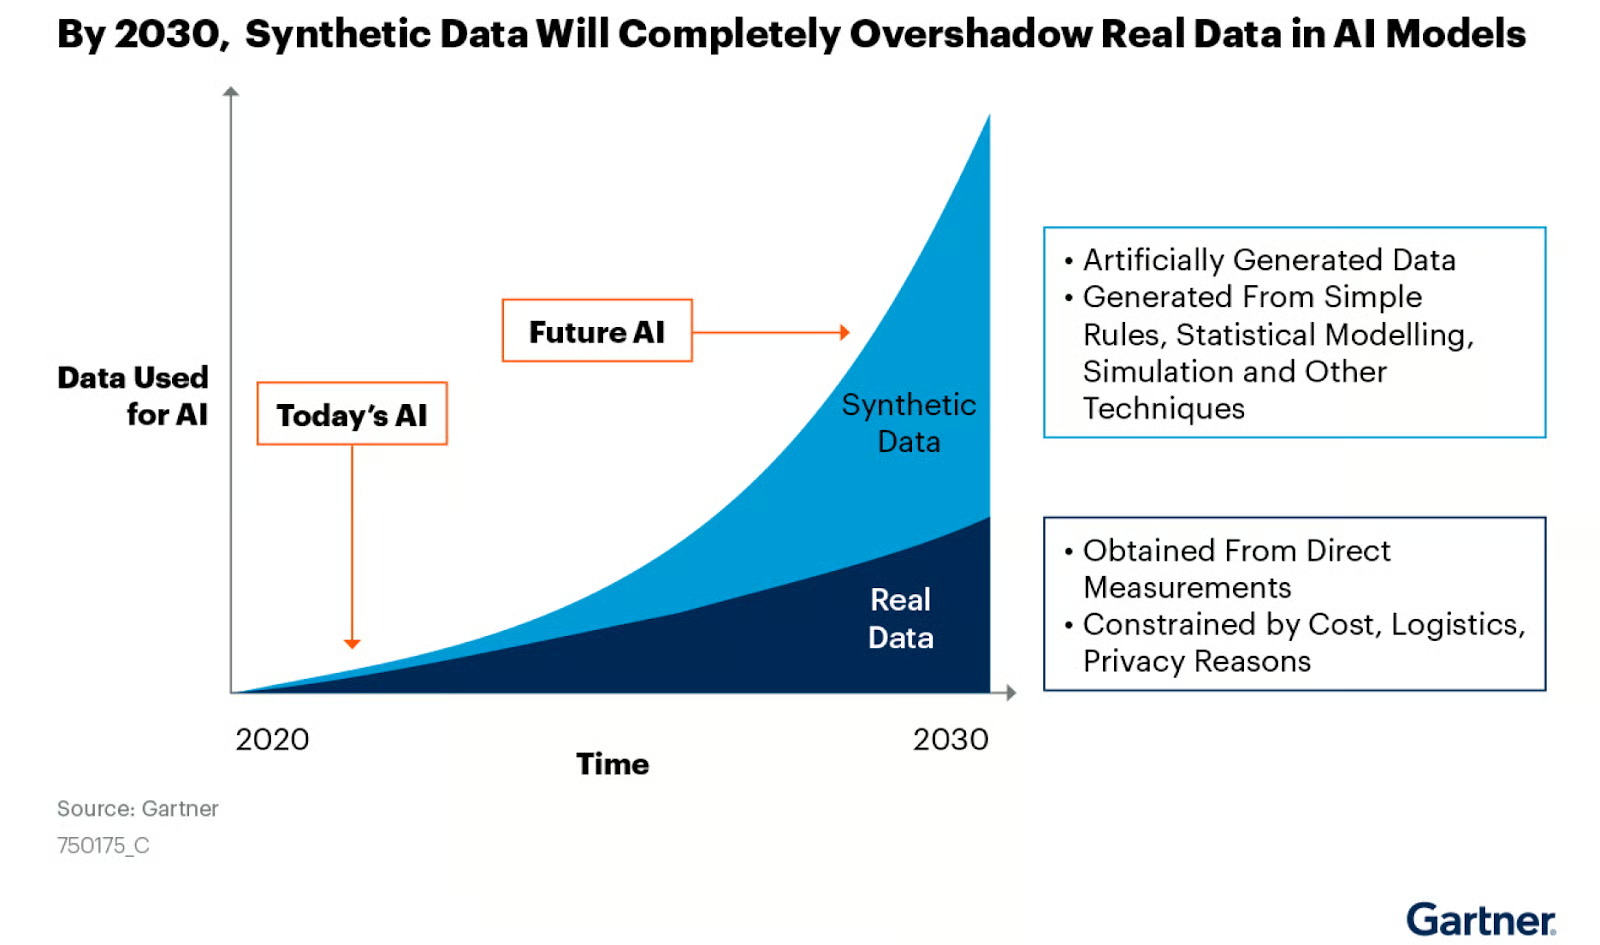
Synthetische data die is gegenereerd via computersimulaties of algoritmen biedt een goedkoop alternatief voor echte data en wordt steeds vaker gebruikt om nauwkeurige AI-modellen te creëren. Bron: NVIDIA-blog
De drie hoofdtypen synthetische data zijn gestructureerd, ongestructureerd en sequentieel, elk met eigen kenmerken en toepassingen. Laten we ze in meer detail bekijken.
Gestructureerde data is informatie die is georganiseerd in een vooraf gedefinieerd formaat, meestal te vinden in databases en spreadsheets. Dit type synthetische data bootst het formaat en de statistische eigenschappen van echte gestructureerde data na. Voorbeelden zijn:
Generatiemethoden voor gestructureerde synthetische data omvatten vaak statistische modellering, regelgebaseerde systemen of machinelearningtechnieken zoals variational autoencoders (VAE’s) of generative adversarial networks (GAN’s).
Ongestructureerde data heeft geen vooraf gedefinieerd formaat en wordt steeds belangrijker in machinelearningtoepassingen. Typen synthetische ongestructureerde data zijn onder andere:
Sequentiële data omvat tijd of volgorde en is essentieel voor modellen die temporele relaties moeten begrijpen. Voorbeelden zijn:
Synthetische data biedt verschillende voordelen en is daardoor aantrekkelijk voor organisaties en onderzoekers. Het gebruik ervan kan diverse uitdagingen in data science, machine learning en softwareontwikkeling aanpakken. Dit zijn enkele redenen om synthetische data te gebruiken:
In veel vakgebieden is het verzamelen van voldoende kwalitatieve data een grote horde. Synthetische data kan deze gaten vullen, waardoor grondige analyses en robuuste modeltraining mogelijk worden.
Door synthetische data te gebruiken die niet overeenkomt met echte personen, kunnen organisaties privacyzorgen en naleving van regelgeving zoals de AVG en HIPAA omzeilen.
Synthetische data kan worden afgestemd op zeldzame gebeurtenissen of specifieke omstandigheden, waardoor datasets worden verrijkt en de modelnauwkeurigheid verbetert.
Synthetische data kan vaak kostenefficiënter zijn dan het verzamelen of kopen van echte data.
Er bestaan verschillende methoden om synthetische data te genereren, elk met eigen voordelen en toepassingsgebieden. We lopen ze in deze sectie door.
Dit is de eenvoudigste methode en houdt in dat data willekeurig wordt bemonsterd uit statistische verdelingen.
import pandas as pd
import numpy as np

# Generate 1,000 samples from a normal distribution
heights = np.random.normal(loc=170, scale=10, size=1000)
weights = np.random.normal(loc=70, scale=15, size=1000)

# Create a correlation between height and weight
weights += (heights - 170) * 0.5
df = pd.DataFrame({'Height': heights, 'Weight': weights})

# Add categorical data
genders = np.random.choice(['Male', 'Female'], size=1000)
df['Gender'] = genders
df.head()
df.describe()
De bovenstaande code genereert een willekeurige dataset die lengte en gewicht simuleert met normale verdelingen. De lengtes zijn gecentreerd rond 170 cm met een standaarddeviatie van 10, en de gewichten rond 70 kg met een standaarddeviatie van 15. Er wordt een lineair verband geïntroduceerd tussen lengte en gewicht, zodat langere personen over het algemeen zwaarder zijn. De code voegt ook een kolom Gender toe met willekeurig toegewezen waarden “Male” of “Female”.
Output:
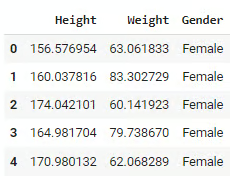
Deze methode is snel en eenvoudig te implementeren en daardoor nuttig voor basistests of prototyping. Er zijn echter beperkingen: complexe relaties of patronen uit de echte wereld worden niet vastgelegd en domeinspecifieke nuances of randvoorwaarden blijven buiten beschouwing.
Regelgebaseerde methoden gebruiken vooraf gedefinieerde regels of domeinkennis om data met specifieke kenmerken te creëren. Bekijk het volgende voorbeeld:
import numpy as np
import pandas as pd

def generate_customer_data(num_records):
    data = []
    for _ in range(num_records):
        age = np.random.randint(18, 80)

        # Rule: Income is loosely based on age
        base_income = 20000 + (age - 18) * 1000
        income = np.random.normal(base_income, base_income * 0.2)

        # Rule: Credit score is influenced by age and income
        credit_score = min(850, max(300, int(600 + (age/80)*100 + (income/100000)*100 + np.random.normal(0, 50))))

        # Rule: Loan amount is based on income and credit score
        max_loan = income * (credit_score / 600)
        loan_amount = np.random.uniform(0, max_loan)

        data.append([age, income, credit_score, loan_amount])

    return pd.DataFrame(data, columns=['Age', 'Income', 'CreditScore', 'LoanAmount'])

df = generate_customer_data(1000)
df.head()
De bovenstaande Python-code genereert een dataset met klantgegevens van 1.000 records. Voor elke klant wordt willekeurig een leeftijd tussen 18 en 80 toegewezen. Op basis van de leeftijd wordt een inkomen berekend, waarbij oudere personen gemiddeld hogere inkomens hebben. De kredietscore wordt vervolgens bepaald, beïnvloed door leeftijd en inkomen, en ligt tussen 300 en 850. Er wordt ook een leenbedrag gegenereerd dat afhangt van het inkomen en de kredietscore van de persoon.
Output:
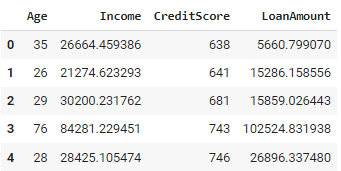
Deze aanpak zorgt ervoor dat de gegenereerde data voldoet aan bekende relaties en randvoorwaarden, waardoor je domeinspecifieke kennis direct in het generatieproces kunt opnemen. Het kan echter complex worden bij systemen met veel onderling gerelateerde regels, en het definiëren en onderhouden van zulke regels kost tijd bij grote of complexe datasets.
Simulatiegebaseerde datageneratie modelleert processen uit de echte wereld om synthetische datasets te creëren. Het omvat het simuleren van gebeurtenissen of gedrag op basis van vooraf gedefinieerde regels en variabelen, zodat we kunnen bestuderen hoe verschillende factoren in dynamische systemen op elkaar inwerken.
Deze methode wordt vaak gebruikt om scenario’s te testen en mogelijke uitkomsten te analyseren, wat waardevolle inzichten biedt in complexe systemen zoals klantenserviceprocessen, supplychains en zorgoperaties. Hier is een voorbeeld in Python:
import simpy
import random
import pandas as pd

class Bank(object):
    def __init__(self, env, num_tellers):
        self.env = env
        self.teller = simpy.Resource(env, num_tellers)

    def service(self, customer):
        service_time = random.expovariate(1/10)  # Avg service time of 10 minutes
        yield self.env.timeout(service_time)

def customer(env, name, bank, data):
    arrival_time = env.now
    print(f'{name} arrives at the bank at {arrival_time:.2f}')

    with bank.teller.request() as request:
        yield request
        wait_time = env.now - arrival_time
        print(f'{name} waits for {wait_time:.2f}')

        yield env.process(bank.service(name))

        service_time = env.now - arrival_time
        print(f'{name} leaves the bank at {env.now:.2f}')

    # Append the customer data to the list
    data.append((name, arrival_time, wait_time, service_time))

def run_simulation(env, num_customers, bank, data):
    for i in range(num_customers):
        env.process(customer(env, f'Customer {i}', bank, data))
        yield env.timeout(random.expovariate(1/5))  # New customer every 5 minutes on average

# Set up and run the simulation
env = simpy.Environment()
bank = Bank(env, num_tellers=3)
num_customers = 100
data = []  # This will hold the customer data
env.process(run_simulation(env, num_customers, bank, data))
env.run()

# Create a DataFrame from the collected data
df = pd.DataFrame(data, columns=['Customer', 'ArrivalTime', 'WaitTime', 'ServiceTime'])
print(df.head())
print(df.describe())
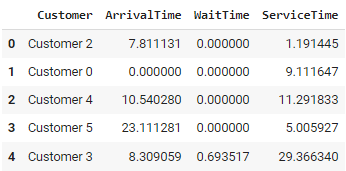
De code simuleert een bank met de SimPy-bibliotheek. Klanten komen op willekeurige intervallen binnen, wachten op service bij een van de drie beschikbare loketten en vertrekken na de service.
De klasse Bank definieert de servicetijd (gemiddeld 10 minuten), terwijl de functie customer() de aankomst, wachttijd en serviceduur van elke klant bijhoudt. Klanten worden afgehandeld in de functie run_simulation(), die gemiddeld elke 5 minuten nieuwe klanten genereert.
Output:
Deze aanpak maakt het mogelijk complexe en dynamische systemen te modelleren, waarmee je scenario’s kunt testen en “what-if”-analyses kunt uitvoeren. Het kan echter rekenintensief worden bij grootschalige simulaties en vereist grondig begrip van het gemodelleerde systeem om accurate resultaten te waarborgen.
Generatieve modellen zoals generative adversarial networks (GAN’s) en variational autoencoders (VAE’s) zijn populair geworden voor het creëren van zeer realistische synthetische data. Deze modellen leren de onderliggende verdeling van de invoerdata te vangen en genereren nieuwe samples die echte data nabootsen.
Beide methoden worden veel gebruikt voor taken als beeldgeneratie en natural language processing, vooral om synthetische data te creëren voor machinelearningmodellen wanneer echte data schaars of gevoelig is.
Bekijk de gratis cursus Generative AI Concepts op Datacamp om te leren hoe generatieve AI-modellen worden ontwikkeld en welke impact ze in de toekomst op de samenleving zullen hebben.
Er zijn verschillende tools beschikbaar die het eenvoudiger maken om synthetische data te genereren voor uiteenlopende use-cases, van statistische modellering tot machine learning en simulaties in de gezondheidszorg.
Deze tools zijn ontworpen om data te creëren die de kenmerken van echte datasets weerspiegelt, zodat je veilig kunt experimenteren en testen zonder gevoelige informatie bloot te leggen.
SDV is een Python-bibliotheek met een reeks modellen voor het genereren van synthetische data. Het ondersteunt diverse datatypen, waaronder tijdreeksen, relationele data en tabeldata. SDV gebruikt geavanceerde probabilistische modellen zoals Gaussian copula’s en deep learning-methoden om de structuur van de oorspronkelijke data te leren en hoogwaardige synthetische versies te produceren. Het wordt veel gebruikt in machinelearningtoepassingen om synthetische trainingsdata te genereren wanneer echte data beperkt of gevoelig is.
Wil je meer weten over het genereren van synthetische data met de SDV-bibliotheek in Python? Bekijk de officiële GitHub-repository of probeer hun officiële tutorials.
Gretel.AI is een cloudplatform dat diensten voor synthetische datageneratie en anonimisering biedt. Het levert gebruiksvriendelijke API’s en kant-en-klare modellen die realistische synthetische data kunnen genereren op basis van uiteenlopende input, waaronder gestructureerde, semigestructureerde en ongestructureerde data. Gretel.AI richt zich op het vereenvoudigen van de workflow voor ontwikkelaars en data scientists, zodat je met minimale setup synthetische data kunt genereren.
Bekijk Gretels quickstart om aan de slag te gaan met synthetische data genereren met Gretel.AI
Synthea is een open-sourcetool die specifiek is ontwikkeld voor simulaties in de gezondheidszorg. Het genereert synthetische patiëntdossiers die realistische medische geschiedenissen, behandelingen en uitkomsten weerspiegelen, volgens medische en klinische standaarden. Onderzoekers en zorginstellingen gebruiken Synthea vaak om patiëntpopulaties te simuleren en trends in de volksgezondheid te bestuderen zonder echte patiëntdata te gebruiken, wat het van onschatbare waarde maakt voor data-analyse in de zorg.
synthpop is een R-pakket dat speciaal is ontworpen om synthetische versies van echte datasets te genereren. Het werkt met statistische modellen die de relaties en verdelingen uit de oorspronkelijke data repliceren, zodat gebruikers data veilig kunnen delen en analyseren zonder de vertrouwelijkheid in gevaar te brengen. synthpop is vooral handig voor onderzoekers en instellingen die datasets willen vrijgeven en tegelijkertijd privacy willen beschermen.
Wil je meer leren over het genereren van synthetische data in R met synthpop? Bekijk de tutorial Generating Synthetic Data Sets with synthpop in R.
Zoals eerder genoemd speelt generatieve AI een belangrijke rol bij het creëren van synthetische data, vooral via geavanceerde modellen die de onderliggende patronen en verdelingen van echte data leren en realistische synthetische versies genereren. Laten we deze technieken en hun toepassingen bekijken.
GAN’s behoren tot de krachtigste tools voor het genereren van synthetische data. Ze bestaan uit twee concurrerende neurale netwerken: een generator en een discriminator. De generator creëert synthetische data, terwijl de discriminator probeert te onderscheiden tussen echte en synthetische data. Door dit adversariële proces verbetert de generator zijn vermogen om zeer realistische data te creëren. GAN’s worden breed ingezet om afbeeldingen, video’s en zelfs tabeldata te genereren en vinden toepassingen in sectoren zoals gezondheidszorg, autonoom rijden en entertainment.
VAE’s zijn een ander populair generatief model voor het genereren van synthetische data. Ze werken door data te encoderen naar een gecomprimeerde latente ruimte en deze vervolgens terug te decoderen naar de oorspronkelijke vorm. Hierdoor kunnen VAE’s nieuwe datapunten genereren door te sampelen uit de latente ruimte, wat ze nuttig maakt voor toepassingen zoals beeldsynthese en anomaliedetectie. Hoewel VAE’s niet hetzelfde realisme bereiken als GAN’s, zijn ze stabieler tijdens training en bieden ze meer controle over de structuur van de gegenereerde data.
Transformers, zoals GPT-modellen, hebben tekstgeneratie getransformeerd door samenhangende en contextueel accurate zinnen en alinea’s te produceren. Voor synthetische data kunnen transformers mensachtige tekst genereren die echte datasets weerspiegelt, zoals klantreviews, gesprekken of andere tekstuele data. Deze modellen zijn vooral handig voor het genereren van grote hoeveelheden tekstgebaseerde synthetische data voor NLP-taken, maar zijn ook flexibel genoeg om te finetunen voor specifieke toepassingen.
Wil je leren welke rol generatieve AI vandaag speelt en in de toekomst zal spelen in een zakelijke context? Bekijk de cursus Generative AI for Business.
De geschikte techniek voor het genereren van synthetische data hangt af van je use-case, datatype en doelen. Voor eenvoudige datasets met goed gedefinieerde statistische verdelingen kunnen willekeurige datageneratie of regelgebaseerde methoden volstaan.
Werk je met complexe, onderling afhankelijke data of moet je relationele integriteit behouden (bijv. in de zorg of financiën), dan zijn een simulatiegebaseerde aanpak of generatieve modellen zoals GAN’s en VAE’s waarschijnlijk geschikter. Voor tekstgeneratie of taken met grootschalige data kunnen transformer-gebaseerde modellen betere resultaten opleveren.
Overweeg de trade-offs tussen implementatiegemak, realisme van de data en rekenkundige vereisten bij het kiezen van een techniek.
Voor dit voorbeeld heb ik een fictieve patiëntendatabase met drie tabellen gegenereerd, elk met precies 5.000 records.
Tabel 1 - Patiënten
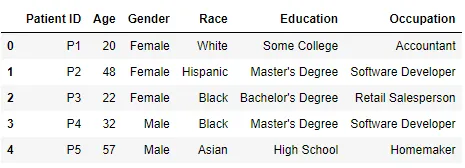
Tabel 2 - Labuitslagen
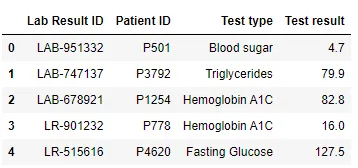
Tabel 3 - Behandelingen
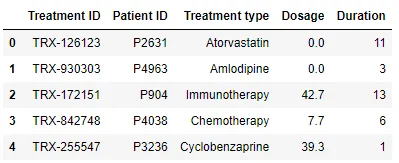
Om dit voorbeeld te implementeren, moet je je registreren bij Gretel.AI en een API-sleutel genereren. Je moet ook een bibliotheek in Python installeren:
!pip install -U gretel-trainerVoor deze use-case gebruiken we RelationalData uit de module gretel_trainer.relational. Hiermee kunnen gebruikers automatisch relaties tussen meerdere tabellen definiëren en behouden, zodat foreign key-afhankelijkheden en dataintegriteit in de synthetische output bewaard blijven.
Dit is vooral handig voor het genereren van hoogwaardige synthetische data die de structuur en afhankelijkheden van echte databases weerspiegelt, waardoor het eenvoudiger wordt om deze te gebruiken in toepassingen zoals machine learning, onderzoek of naleving van privacyregels.
Codevoorbeeld:
import pandas as pd
from gretel_client import configure_session
from gretel_trainer.relational import RelationalData

configure_session(api_key="your_api_key", cache="yes", validate=True)

csv_dir = "csv/"
tables = [("patients", "Patient ID"), ("lab_results", "Lab Result ID"), ("treatments", "Treatment ID")]
foreign_keys = [("lab_results.Patient ID", "patients.Patient ID"), ("treatments.Patient ID", "patients.Patient ID")]

relational_data = RelationalData()
for table, pk in tables:
    relational_data.add_table(name=table, primary_key=pk, data=pd.read_csv(f"{csv_dir}/{table}.csv"))
for fk, ref in foreign_keys:
    relational_data.add_foreign_key(foreign_key=fk, referencing=ref)

from gretel_trainer.relational import MultiTable

multitable = MultiTable(
    relational_data,
    project_display_name="Clinical Trials",
    gretel_model="amplify"
)
multitable.train()

multitable.generate(record_size_ratio=1)
synthetic_patients = multitable.synthetic_output_tables['patients']
synthetic_lab_results = multitable.synthetic_output_tables['lab_results']
synthetic_treatments = multitable.synthetic_output_tables['treatments']
Deze code gebruikt de Gretel.AI API om synthetische data te genereren voor een relationele database. Eerst wordt een sessie opgezet met een API-sleutel en worden drie CSV-bestanden (patients, lab_results en treatments) geladen, waarbij hun primaire sleutels worden opgegeven en foreign key-relaties worden gedefinieerd.
De klasse RelationalData wordt gebruikt om deze relaties te behouden. Na het configureren van de data wordt een model getraind met de klasse MultiTable, die de volledige relationele dataset synthetiseert.
Na training wordt de methode generate() gebruikt om synthetische data te genereren. De parameter record_size_ratio bepaalt de verhouding ten opzichte van de grootte van de gegenereerde data. record_size_ratio=1 betekent dat het aantal records in de synthetische dataset gelijk is aan de oorspronkelijke dataset, d.w.z. 5.000 records.
Het evalueren van de kwaliteit van synthetische data is essentieel om de bruikbaarheid en privacy te waarborgen. Begin met het vergelijken van statistische verdelingen tussen de oorspronkelijke en de synthetische data—statistieken zoals gemiddelde, variantie en correlatie moeten nauw aansluiten.
Een andere methode is om synthetische data te gebruiken om machinelearningmodellen te trainen en hun prestaties (bijv. accuracy of F1-score) te vergelijken met modellen die op echte data zijn getraind.
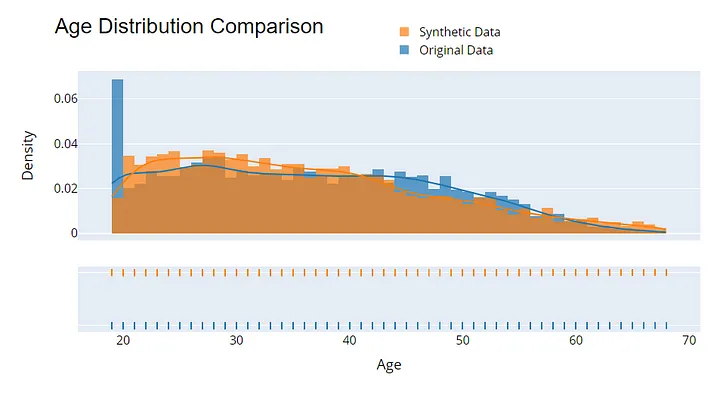
Voorbeeldvisualisatie om de kwaliteit van synthetische data te beoordelen. Afbeelding door de auteur.
Synthetische datageneratie is opgekomen om uitdagingen aan te pakken rond datagebrek, privacyzorgen en de behoefte aan diverse, hoogwaardige datasets.
Met technieken variërend van eenvoudige willekeurige datageneratie tot geavanceerde generatieve modellen zoals GAN’s en VAE’s stelt synthetische data organisaties in staat te innoveren en betere machinelearningmodellen te bouwen, terwijl gevoelige informatie wordt beschermd.
Tools zoals SDV en beheerde diensten zoals Gretel.AI maken het genereren van synthetische data toegankelijker, zelfs voor complexe relationele databases.
Naarmate synthetische datageneratie evolueert, zullen de toepassingen ervan steeds belangrijker worden voor de vooruitgang van AI, gezondheidszorg, financiën en talloze andere domeinen.
Dieper duiken? Bekijk de training Using Synthetic Data for Machine Learning & AI in Python om te ontdekken wat synthetische data is, hoe het privacy beschermt en hoe het wordt ingezet om AI-adoptie te versnellen in bankwezen, gezondheidszorg en vele andere sectoren.
Leer meer over machine learning en AI met de volgende cursussen!
Cursus
Cursus
Cursus