
课程
Python 中级回归:使用 statsmodels
4 小时
16.2K
VIF 由统计学家 Cuthbert Daniel 提出,是回归分析中广泛使用的诊断工具,用于检测多重共线性,而多重共线性已知会影响回归系数的稳定性与可解释性。更技术性地说,VIF 通过量化由于预测变量间的相关性导致某个回归系数方差被放大的程度来工作。
这一切之所以重要,是因为这些相关性会使得难以隔离每个预测变量对目标变量的独特作用,从而导致模型估计的可靠性下降。还要指出的是,为了讲清问题,VIF 总是针对模型中的每个预测变量分别计算。
某个预测变量 X 的 VIF 计算为:
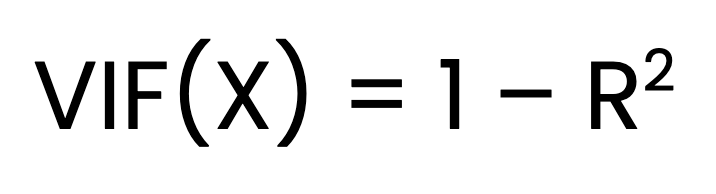
其中:
X 对所有其他预测变量回归时得到的判定系数。求解 VIF 包含三步。第一步,为每个预测变量分别对所有其他预测变量拟合一个线性回归模型。第二步,获取每个模型的 R2 值。最后一步,使用上述公式计算 VIF。
以下是如何解读 VIF 值以理解多重共线性的程度:
例如,若某个预测变量的 VIF 为 10,表示该预测变量系数的方差是在不存在多重共线性情况下的 10 倍。
多重共线性会导致标准误增加,使评估单个预测变量的显著性变得更加困难。这是因为共线变量携带相似信息,难以区分它们对结果变量的各自独立作用。
虽然多重共线性不一定会损害模型的预测能力,但确实会降低系数的可靠性与清晰度。当我们希望理解每个预测变量的个体影响时,这尤其成问题。
方差膨胀因子(VIF)是识别多重共线性的精确诊断指标。与对相关性的一般性观察不同,VIF 将所有预测变量对每个变量的联合影响进行隔离,突出两两相关中未必显现的交互。
为便于上手,我们将用一个独特的数据集分别在 Python 与 R 中演示。我们会使用自动化的包来计算 VIF,也会用 VIF 公式手算以帮助建立直觉。为了形成良好实践,我特意构造了一个数据集,其中我们会发现某个变量的 VIF 值很高,即使任意两个变量之间并没有很高的两两相关——我认为这是个颇具说服力的例子。先来看看我们将使用的数据集概览。
数据集概览:
这个虚构的数据集表示一家零售巨头在 1,000 家门店开展调研的结果。每家门店的顾客被要求对购物体验的各个方面按 -5 到 +5 打分,-5 表示非常差,+5 表示非常好。然后在每家门店对以下四个关键指标的顾客评分取平均:
Ambience: 顾客对门店环境的感知,如清洁度、布局、照明和整体氛围。
Customer_service: 对店员服务的评分,包括是否乐于助人、友善程度以及对顾客需求的响应度。
Offers: 对门店促销、折扣和优惠活动的评分。
Product_range: 对店内商品种类与质量的评价。
目标变量 Performance 衡量每家门店的整体表现。不过,从 VIF 的角度看它并不相关。 您可以在此处下载数据集。
我们先用 Python 包计算 VIF 值。第一步是加载数据集和所需库。
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from statsmodels.stats.outliers_influence import variance_inflation_factor
from statsmodels.tools.tools import add_constant

datacamp_retail_data = pd.read_csv(' vif_data.csv')
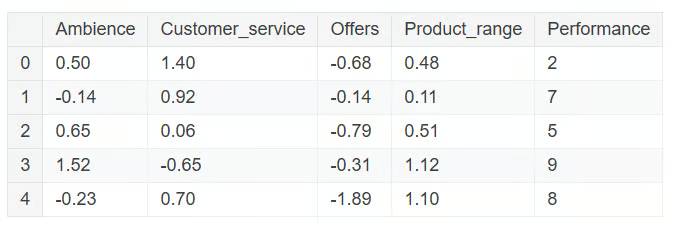
datacamp_retail_data.head()
上述代码会加载数据并显示前五条记录。
下一步,我们可以运行相关矩阵以检查两两相关。
下面的代码选择四列,并将其存入名为 correl_data 的新 DataFrame。然后使用 .corr() 函数计算两两相关矩阵。结果保存在对象 corr_matrix 中,这是一张表,显示所选各列两两之间的相关系数。
随后使用 Seaborn 的 heatmap() 可视化该矩阵,将每个相关系数显示为按颜色编码的单元格,其中蓝色表示负相关,红色表示正相关,基于 coolwarm 配色方案。
correl_data = datacamp_retail_data[['Ambience', 'Customer_service', 'Offers', 'Product_range']]

# Compute the pairwise correlation matrix
corr_matrix = correl_data.corr()

# Visualize the correlation matrix
plt.figure(figsize=(10, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', vmin=-1, vmax=1)
plt.title('Pairwise Correlation Matrix')
plt.show()
输出:
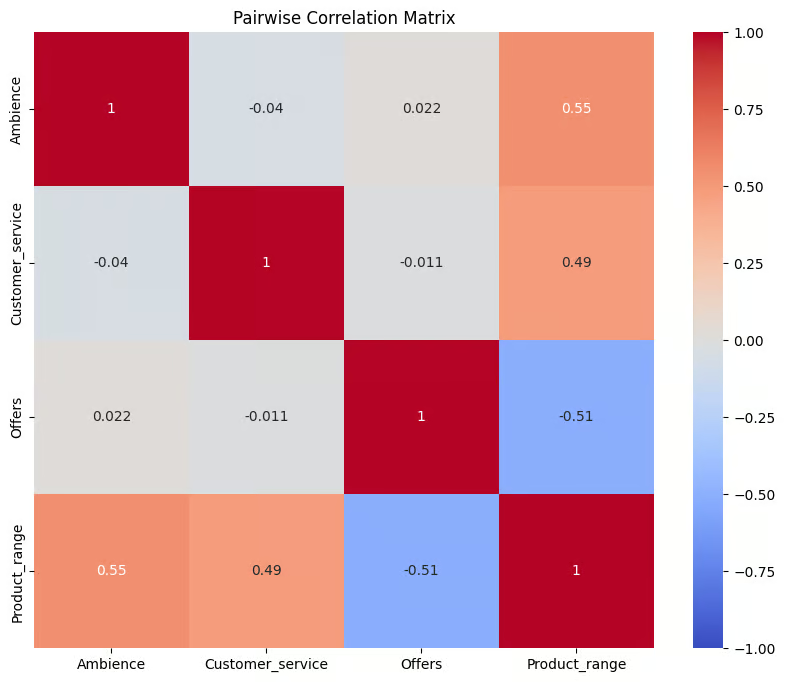
变量之间的相关性。作者供图
该图对 correl_data 中各变量之间的关系做了可视化概述。相关值范围为 -1 到 1,越接近 1 表示强正相关,越接近 -1 表示强负相关,接近 0 表示无相关。可以看出变量之间不存在强两两相关,没有一个相关值甚至超过 0.6。
接下来计算各预测变量的 VIF 值。下面的代码对数据集中每个预测变量计算 VIF 以检查多重共线性。
首先,通过移除目标列 Performance 并添加截距来定义 X。然后创建 DataFrame datacamp_vif_data,用于存储预测变量名称和其 VIF 值。接着使用循环,借助variance_inflation_factor() 函数计算每个预测变量的 VIF,VIF 越高表示越存在多重共线性。
# Define the predictor variables
X = datacamp_retail_data.drop(columns=['Performance'])

# Add a constant to the model (intercept)
X = add_constant(X)

# Calculate VIF for each feature
datacamp_vif_data = pd.DataFrame()
datacamp_vif_data['Feature'] = X.columns
datacamp_vif_data['VIF'] = [variance_inflation_factor(X.values, i) for i in range(X.shape[1])]
print(datacamp_vif_data)
输出:
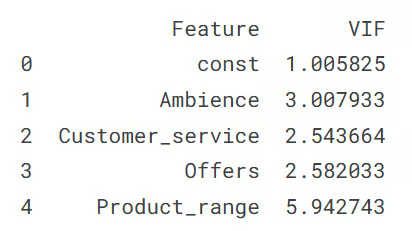
输出显示 VIF 值。作者供图
该输出显示了每个预测变量的 VIF 值,指出了数据集中的多重共线性程度。const 行表示截距项,其 VIF 接近 1,意味着不存在多重共线性。在预测变量中,Product_range 的 VIF 最高(5.94),提示需要采取纠正措施。其他预测变量的 VIF 值均低于 3,表示多重共线性较低。
另一种方法是分别将每个自变量对其他预测变量进行回归,单独计算各自的数值。
具体做法是,对 retail_data 中的每个特征,将该特征设为因变量(y),其余特征设为自变量(X)。随后拟合线性回归模型用 X 预测 y,并利用模型的 R 平方值按我们在开头部分讨论过的公式计算 VIF。
随后,将每个特征及其对应的 VIF 值存入字典(vif_manual),并转换成 DataFrame(vif_manual_df)以便展示。
datacamp_retail_data = retail_data.drop(columns=['Performance'])

# Manual VIF Calculation
vif_manual = {}

for feature in retail_data.columns:
    # Define the target variable (current feature) and predictors (all other features)
    y = datacamp_retail_data[feature]
    X = datacamp_retail_data.drop(columns=[feature])

    # Fit the linear regression model
    model = LinearRegression().fit(X, y)

    # Calculate R-squared
    r_squared = model.score(X, y)

    # Calculate VIF
    vif = 1 / (1 - r_squared)
    vif_manual[feature] = vif

# Convert the dictionary to a DataFrame for better display
vif_manual_df = pd.DataFrame(list(vif_manual.items()), columns=['Feature', 'VIF'])
print(vif_manual_df)
输出:
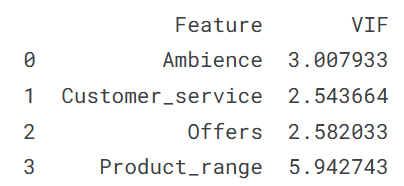
输出显示 VIF 值。作者供图
输出显示了每个特征及其 VIF 值,有助于识别潜在的多重共线性问题。您可以看到结果显然与上面一致;其解读也相同,即 Product_range 变量表现出多重共线性。
本节将重复上面 Python 部分关于方差膨胀因子的练习,面向使用 R 语言的开发者。我们从加载数据集和必要的库开始。
library(tidyverse)
library(car)
library(corrplot)

data <- read.csv('vif_data.csv')
str(data)
输出:
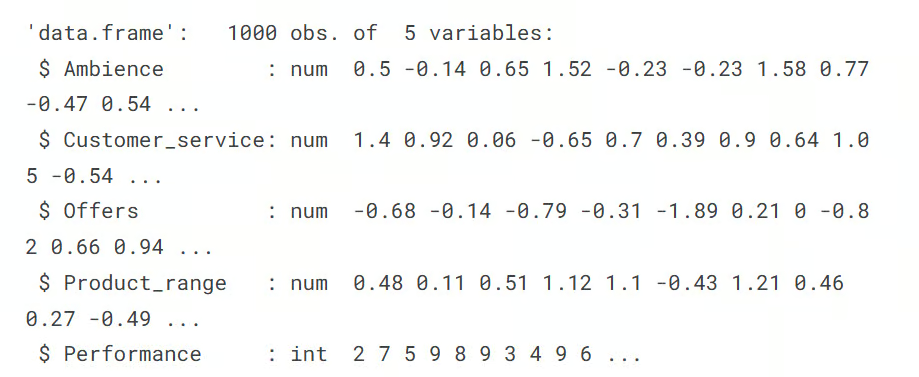
下一步是计算两两相关矩阵,并用热力图可视化。cor() 和 corrplot 函数可帮助我们完成此任务。
# Remove the target column
predictors_data <- data[, !(names(data) %in% "Performance")]

# Calculate the correlation matrix
correlation_matrix <- cor(predictors_data)

# Plot the correlation heatmap
# Load necessary libraries
library(ggplot2)
library(reshape2)
melted_corr_matrix <- melt(correlation_matrix)

# Plot the heatmap with ggplot2
ggplot(data = melted_corr_matrix, aes(x = Var1, y = Var2, fill = value)) +
  geom_tile(color = "white") +
  scale_fill_gradient2(low = "blue", high = "red", mid = "white",
                       midpoint = 0, limit = c(-1, 1), space = "Lab",
                       name="Correlation") +
  theme_minimal() + # Minimal theme for a clean look
  theme(axis.text.x = element_text(angle = 45, vjust = 1, hjust = 1)) +
  labs(x = "", y = "") + # Remove axis labels
  geom_text(aes(Var1, Var2, label = round(value, 2)), color = "black", size = 4) +
  theme(axis.text=element_text(size=15))
输出:
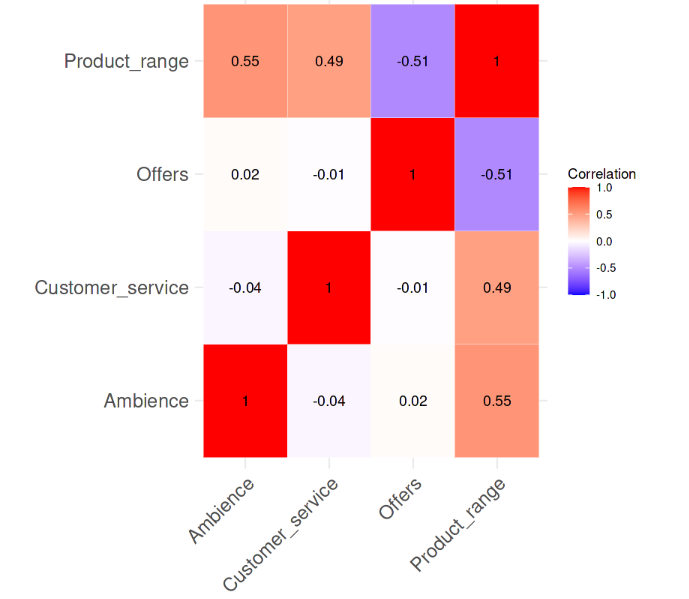
变量之间的相关性。作者供图
从相关热力图可以看出,变量之间不存在强两两相关,没有一个相关值甚至超过 0.6。现在我们来计算 VIF 值,看看是否有值得警惕的情况。下面的代码行完成该任务。
# Fit a regression model
model <- lm(Performance ~ Ambience + Customer_service + Offers + Product_range, data = data)

# Calculate VIF
vif(model)
输出:

从输出可见,在预测变量中,只有 Product_range 的 VIF 值大于 5,提示存在较高的多重共线性,需要采取纠正措施。
另一种 VIF 计算方法是分别计算每个变量的 VIF:将每个自变量对其他预测变量进行回归。
如下代码所示,使用 sapply() 对每个预测变量进行遍历,其中每个预测变量在一个线性回归模型中被设为因变量,其他预测变量作为自变量。
随后使用每个模型的 R 平方值按公式计算 VIF 值。最后,结果 vif_values 显示每个预测变量的 VIF,帮助识别多重共线性问题。
# VIF calculation for each predictor manually
predictors <- c("Ambience", "Customer_service", "Offers", "Product_range")

vif_values <- sapply(predictors, function(pred) {
    formula <- as.formula(paste(pred, "~ ."))
    model <- lm(formula, data = data[, predictors])
    1 / (1 - summary(model)$r.squared)
})

print(vif_values)
输出:

我们得到相同的结果,很明显 Product_range 的 VIF 值高于 5,需要进行干预。
回顾一下,以下是检测多重共线性的常用方法:
在所有这些方法中,VIF 尤其有用,因为即使两两相关性较低,它也能检测到多重共线性,正如我们自己的示例所示。这使得 VIF 成为更全面的工具。
如果 VIF 值表明存在较高的多重共线性,而您又不一定想直接删除变量,可以考虑以下一些更高级的缓解策略:
掌握 VIF 的使用是识别并修复多重共线性的关键,这能提升回归模型的准确性与清晰度。定期检查 VIF 值并在需要时采取纠正措施,有助于数据从业者与分析师构建值得信赖的模型。该方法确保每个预测变量的作用清晰,从而更容易从模型中得出可靠结论,并据此做出更好的决策。参加我们的Machine Learning Scientist in Python 职业路径,系统掌握如何构建与运用模型。此外,完成该项目也能为您的简历增色。
与 DataCamp 一起学习
课程
课程
课程