
कोर्स
इंटरमीडिएट Regression with statsmodels in Python
4 घंटा
16.2K
सांख्यिकीविद् Cuthbert Daniel द्वारा विकसित, VIF प्रतिगमन विश्लेषण में मल्टिकॉलिनियरिटी का पता लगाने के लिए व्यापक रूप से प्रयुक्त डायग्नोस्टिक टूल है, जो प्रतिगमन गुणांकों की स्थिरता और वैयाख्येयता को प्रभावित करने के लिए जाना जाता है। तकनीकी रूप से, VIF यह मापता है कि प्रेडिक्टर्स के बीच सहसंबंधों के कारण किसी प्रतिगमन गुणांक का वैरिएंस कितना फुल जाता है।
यह सब इसलिए महत्वपूर्ण है क्योंकि ये सहसंबंध प्रत्येक प्रेडिक्टर के लक्ष्य चर पर विशिष्ट प्रभाव को पृथक करना कठिन बना देते हैं, जिससे मॉडल के अनुमान कम विश्वसनीय हो जाते हैं। यह भी ध्यान देने योग्य है कि सही तस्वीर समझने के लिए, VIF हमेशा मॉडल में प्रत्येक प्रेडिक्टर के लिए अलग-अलग गणना किया जाता है।
किसी प्रेडिक्टर X के लिए VIF की गणना इस प्रकार की जाती है:
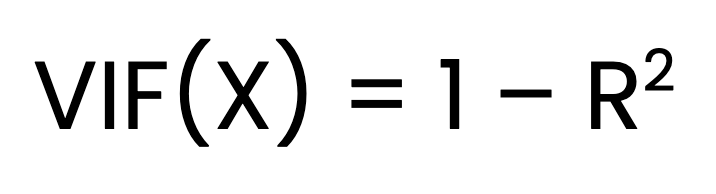
जहाँ:
X को अन्य सभी प्रेडिक्टर्स पर रिग्रेस किया जाता है।VIF निकालना तीन चरणों की प्रक्रिया है। पहला चरण है प्रत्येक प्रेडिक्टर के लिए अन्य सभी प्रेडिक्टर्स के विरुद्ध अलग-अलग रैखिक प्रतिगमन मॉडल फिट करना। दूसरे चरण में, प्रत्येक मॉडल के लिए R2 मान प्राप्त करना। अंतिम चरण में, ऊपर दिए गए सूत्र का उपयोग करके VIF की गणना करना।
मल्टिकॉलिनियरिटी के स्तर को समझने के लिए VIF मानों की व्याख्या इस प्रकार करें:
उदाहरण के लिए, यदि किसी प्रेडिक्टर का VIF 10 है, तो यह दर्शाता है कि उस प्रेडिक्टर के गुणांक का वैरिएंस, मल्टिकॉलिनियरिटी न होने की तुलना में, 10 गुना है।
मल्टिकॉलिनियरिटी मानक त्रुटियों को बढ़ाती है, जिससे व्यक्तिगत प्रेडिक्टर्स की सांख्यिकीय महत्ता का आकलन करना कठिन हो जाता है। ऐसा इसलिए होता है क्योंकि को-लिनियर चर समान जानकारी वहन करते हैं, जिससे परिणाम चर पर उनके विशिष्ट व्यक्तिगत प्रभावों को अलग करना मुश्किल हो जाता है।
हालाँकि मल्टिकॉलिनियरिटी अनिवार्य रूप से मॉडल की पूर्वानुमान क्षमता को नुकसान नहीं पहुँचाती, लेकिन यह गुणांकों की विश्वसनीयता और स्पष्टता को कम करती है। यह विशेष रूप से तब समस्या बनती है जब हम प्रत्येक प्रेडिक्टर के व्यक्तिगत प्रभाव को समझना चाहते हैं।
वैरिएंस इन्फ्लेशन फैक्टर (VIF) मल्टिकॉलिनियरिटी की पहचान करने के लिए एक सटीक डायग्नोस्टिक मीट्रिक के रूप में काम करता है। सामान्य सहसंबंधी अवलोकनों के विपरीत, VIF प्रत्येक चर पर सभी प्रेडिक्टर्स के संयुक्त प्रभाव को पृथक करता है, और ऐसे इंटरैक्शनों को उजागर करता है जो युग्म सहसंबंधों से स्पष्ट नहीं हो सकते।
इसे क्रियान्वित रूप में समझने के लिए, आइए Python और R दोनों में एक अनूठे डेटासेट के साथ उदाहरण से गुजरते हैं। हम ऑटोमेटेड पैकेजों से और VIF सूत्र का उपयोग करके दोनों तरीकों से VIF की गणना करेंगे ताकि सहज समझ बने। अभ्यास को सार्थक बनाने के लिए, मैंने जानबूझकर एक ऐसा डेटासेट बनाया है जहाँ हम अपने किसी एक चर के लिए उच्च VIF मान पाएँगे, भले ही किसी दो चरों के बीच बहुत अधिक युग्म सहसंबंध न हो—मुझे लगता है यह एक प्रभावी उदाहरण है। आइए उस डेटासेट का अवलोकन करके शुरू करें जिसका हम उपयोग करेंगे।
डेटासेट अवलोकन:
यह काल्पनिक डेटासेट एक रिटेल दिग्गज के 1,000 स्टोर्स में किए गए एक अध्ययन के सर्वेक्षण परिणामों का प्रतिनिधित्व करता है। प्रत्येक स्टोर पर ग्राहकों से उनकी खरीदारी के अनुभव के विभिन्न पहलुओं को -5 से +5 के पैमाने पर रेट करने को कहा गया, जहाँ -5 बहुत नकारात्मक अनुभव और +5 बहुत सकारात्मक अनुभव को दर्शाता है। प्रत्येक स्टोर पर ग्राहकों की रेटिंग का औसत चार प्रमुख पैरामीटर्स पर लिया गया:
Ambience: स्टोर के वातावरण के बारे में ग्राहक की धारणा, जैसे स्वच्छता, लेआउट, लाइटिंग और समग्र माहौल।
Customer_service: स्टाफ द्वारा प्रदान की गई सेवा का रेटिंग, जिसमें मददगार होना, मित्रता और ग्राहक की आवश्यकताओं के प्रति तत्परता शामिल है।
Offers: स्टोर के प्रोमोशनल ऑफ़र्स, छूट और डील्स का रेटिंग।
Product_range: स्टोर में उपलब्ध उत्पादों की विविधता और गुणवत्ता का आकलन।
लक्ष्य चर, Performance, प्रत्येक स्टोर के समग्र प्रदर्शन को मापता है। हालाँकि, VIF के दृष्टिकोण से यह प्रासंगिक नहीं है। आप डेटासेट यहाँ से डाउनलोड कर सकते हैं।
हम Python पैकेजों का उपयोग करके VIF मानों की गणना से शुरुआत करेंगे। पहला कदम है डेटासेट और आवश्यक लाइब्रेरीज़ को लोड करना।
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from statsmodels.stats.outliers_influence import variance_inflation_factor
from statsmodels.tools.tools import add_constant

datacamp_retail_data = pd.read_csv(' vif_data.csv')
datacamp_retail_data.head()
ऊपर दिया गया कोड डेटा लोड करेगा और पहली पाँच पंक्तियाँ दिखाएगा।
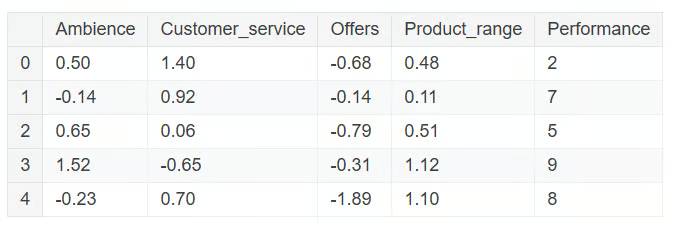
अगले चरण में, हम युग्म सहसंबंध की जाँच के लिए एक कोरिलेशन मैट्रिक्स चला सकते हैं।
नीचे दिया गया कोड चार कॉलम चुनता है और उन्हें correl_data नामक नए DataFrame में संग्रहीत करता है। फिर यह .corr() फ़ंक्शन का उपयोग करके युग्म सहसंबंध मैट्रिक्स की गणना करता है। परिणाम corr_matrix ऑब्जेक्ट में संग्रहीत होता है, जो चयनित कॉलमों की प्रत्येक जोड़ी के बीच सहसंबंध गुणांक दिखाने वाली एक तालिका है।
इसके बाद, Seaborn के heatmap() फ़ंक्शन का उपयोग करके मैट्रिक्स को दृश्य रूप में प्रदर्शित किया जाता है, जिसमें प्रत्येक सहसंबंध गुणांक रंग-कोडेड सेल के रूप में दिखता है, जहाँ coolwarm रंग मानचित्र के आधार पर नीला नकारात्मक और लाल सकारात्मक सहसंबंध का प्रतिनिधित्व करता है।
correl_data = datacamp_retail_data[['Ambience', 'Customer_service', 'Offers', 'Product_range']]

# Compute the pairwise correlation matrix
corr_matrix = correl_data.corr()

# Visualize the correlation matrix
plt.figure(figsize=(10, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', vmin=-1, vmax=1)
plt.title('Pairwise Correlation Matrix')
plt.show()
आउटपुट:
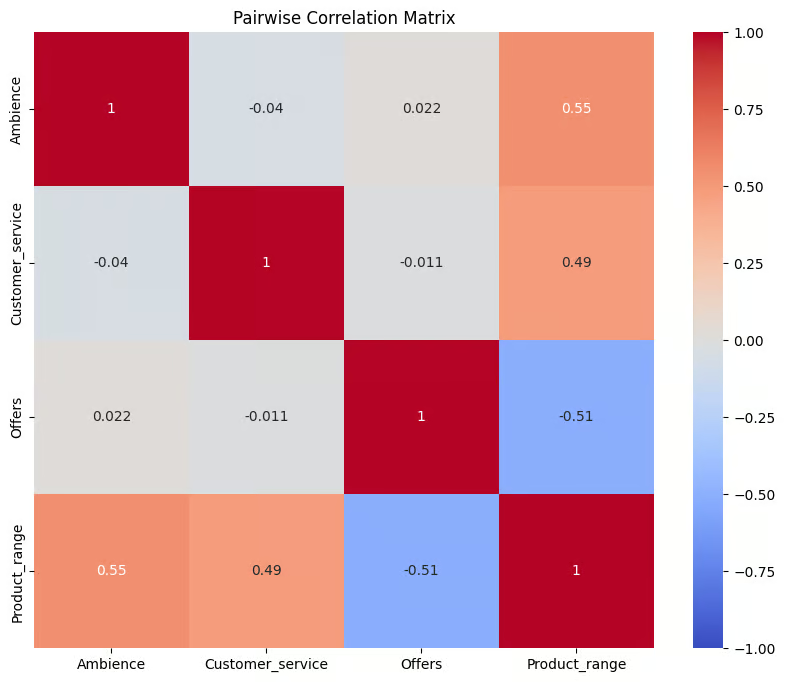
चरों के बीच सहसंबंध। लेखक द्वारा छवि
यह प्लॉट correl_data में चरों के बीच संबंधों का दृश्य सारांश देता है। सहसंबंध मान -1 से 1 तक होते हैं; 1 के निकट मान मजबूत सकारात्मक सहसंबंध, -1 के निकट मान मजबूत नकारात्मक सहसंबंध, और 0 के आसपास के मान सहसंबंध न होने का संकेत देते हैं। यह स्पष्ट है कि चरों के बीच कोई मजबूत युग्म सहसंबंध नहीं है, क्योंकि कोई भी मान 0.6 से अधिक नहीं है।
अगला चरण प्रेडिक्टर चरों के लिए VIF मानों की गणना करना है। नीचे दिया गया कोड डेटासेट में प्रत्येक प्रेडिक्टर के लिए मानों की गणना करता है ताकि मल्टिकॉलिनियरिटी की जाँच की जा सके।
पहले, Performance लक्ष्य कॉलम को हटाकर और एक इंटरसेप्ट जोड़कर X को परिभाषित किया जाता है। फिर, datacamp_vif_data नामक DataFrame बनाया जाता है ताकि प्रेडिक्टर के नाम और उनके VIF मान संग्रहीत किए जा सकें। इसके बाद, एक लूप का उपयोग करके variance_inflation_factor() फ़ंक्शन से प्रत्येक प्रेडिक्टर के लिए VIF की गणना की जाती है, जहाँ उच्च VIF मल्टिकॉलिनियरिटी की उपस्थिति का संकेत देते हैं।
# Define the predictor variables
X = datacamp_retail_data.drop(columns=['Performance'])

# Add a constant to the model (intercept)
X = add_constant(X)

# Calculate VIF for each feature
datacamp_vif_data = pd.DataFrame()
datacamp_vif_data['Feature'] = X.columns
datacamp_vif_data['VIF'] = [variance_inflation_factor(X.values, i) for i in range(X.shape[1])]
print(datacamp_vif_data)
आउटपुट:
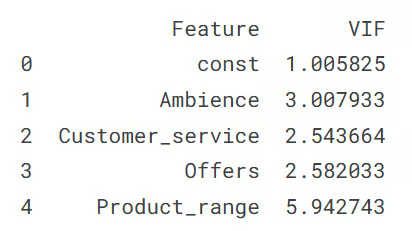
VIF मान दिखाता आउटपुट। लेखक द्वारा छवि
यह आउटपुट प्रत्येक प्रेडिक्टर चर के लिए VIF मान दिखाता है, जो डेटासेट में मल्टिकॉलिनियरिटी के स्तर का संकेत देता है। const पंक्ति इंटरसेप्ट टर्म का प्रतिनिधित्व करती है, जिसका VIF 1 के क़रीब है, अर्थात इसमें मल्टिकॉलिनियरिटी नहीं है। प्रेडिक्टर चरों में, Product_range का VIF सबसे अधिक (5.94) है, जो बताता है कि इसके लिए सुधारात्मक कदमों की ज़रूरत है। अन्य सभी प्रेडिक्टर्स के VIF मान 3 से नीचे हैं, जो कम मल्टिकॉलिनियरिटी दर्शाते हैं।
दूसरा तरीका यह है कि प्रत्येक स्वतंत्र चर को अन्य प्रेडिक्टर चरों के विरुद्ध रिग्रेस करके मानों की अलग-अलग गणना की जाए।
इसका काम करने का तरीका यह है कि retail_data में प्रत्येक फीचर के लिए, उस फीचर को निर्भर चर (y) और शेष फीचर्स को स्वतंत्र चर (X) बनाया जाता है। फिर y को X से प्रेडिक्ट करने के लिए एक रैखिक प्रतिगमन मॉडल फिट किया जाता है, और मॉडल के R-squared मान का उपयोग प्रारंभिक खंड में चर्चा किए गए VIF सूत्र से VIF निकालने में किया जाता है।
इसके बाद, प्रत्येक फीचर और उसके संबंधित VIF मानों को एक डिक्शनरी (vif_manual) में संग्रहीत किया जाता है, जिसे फिर प्रदर्शन के लिए एक DataFrame (vif_manual_df) में बदला जाता है।
datacamp_retail_data = retail_data.drop(columns=['Performance'])

# Manual VIF Calculation
vif_manual = {}

for feature in retail_data.columns:
    # Define the target variable (current feature) and predictors (all other features)
    y = datacamp_retail_data[feature]
    X = datacamp_retail_data.drop(columns=[feature])

    # Fit the linear regression model
    model = LinearRegression().fit(X, y)

    # Calculate R-squared
    r_squared = model.score(X, y)

    # Calculate VIF
    vif = 1 / (1 - r_squared)
    vif_manual[feature] = vif

# Convert the dictionary to a DataFrame for better display
vif_manual_df = pd.DataFrame(list(vif_manual.items()), columns=['Feature', 'VIF'])
print(vif_manual_df)
आउटपुट:
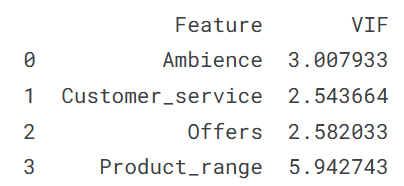
VIF मान दिखाता आउटपुट। लेखक द्वारा छवि
आउटपुट प्रत्येक फीचर के साथ उसका VIF मान दिखाता है, जो संभावित मल्टिकॉलिनियरिटी समस्याओं की पहचान में मदद करता है। आप देख सकते हैं कि परिणाम स्पष्ट रूप से वही है जो हमें ऊपर मिला; और व्याख्या भी वही होगी, अर्थात Product_range चर मल्टिकॉलिनियरिटी प्रदर्शित कर रहा है।
इस खंड में, हम Python खंड में ऊपर किए गए वैरिएंस इन्फ्लेशन फैक्टर के अभ्यास को दोहराएँगे, खासकर उन डेवलपर्स के लिए जो R प्रोग्रामिंग भाषा के साथ काम करते हैं। हम डेटासेट और आवश्यक लाइब्रेरीज़ लोड करके शुरू करते हैं।
library(tidyverse)
library(car)
library(corrplot)

data <- read.csv('vif_data.csv')
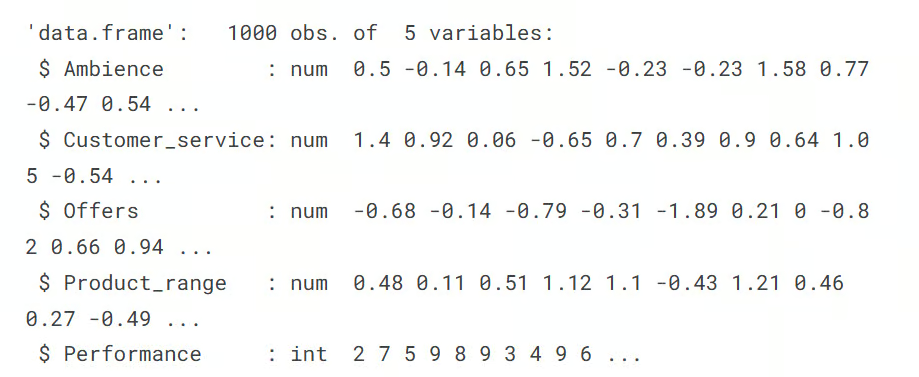
str(data)
आउटपुट:
अगला चरण युग्म सहसंबंध मैट्रिक्स की गणना करना और उसे हीटमैप से विज़ुअलाइज़ करना है। cor() और corrplot फ़ंक्शंस इसमें हमारी मदद करते हैं।
# Remove the target column
predictors_data <- data[, !(names(data) %in% "Performance")]

# Calculate the correlation matrix
correlation_matrix <- cor(predictors_data)

# Plot the correlation heatmap
# Load necessary libraries
library(ggplot2)
library(reshape2)
melted_corr_matrix <- melt(correlation_matrix)

# Plot the heatmap with ggplot2
ggplot(data = melted_corr_matrix, aes(x = Var1, y = Var2, fill = value)) +
  geom_tile(color = "white") +
  scale_fill_gradient2(low = "blue", high = "red", mid = "white",
                       midpoint = 0, limit = c(-1, 1), space = "Lab",
                       name="Correlation") +
  theme_minimal() + # Minimal theme for a clean look
  theme(axis.text.x = element_text(angle = 45, vjust = 1, hjust = 1)) +
  labs(x = "", y = "") + # Remove axis labels
  geom_text(aes(Var1, Var2, label = round(value, 2)), color = "black", size = 4) +
  theme(axis.text=element_text(size=15))
आउटपुट:
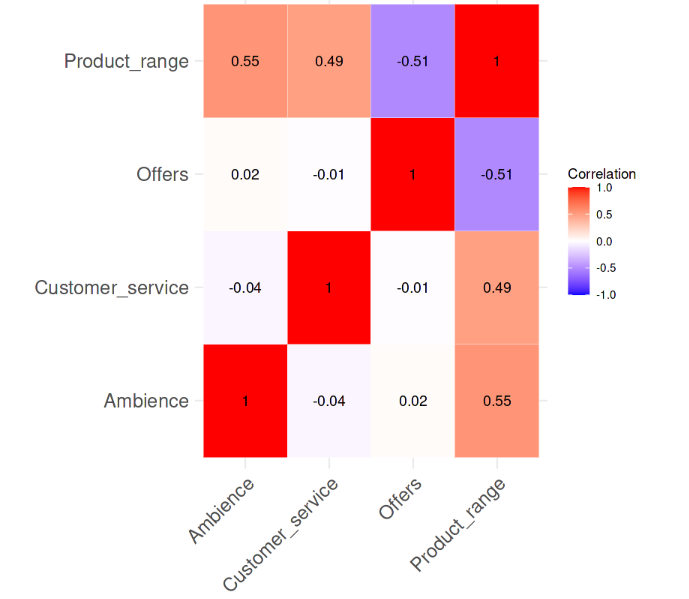
चरों के बीच सहसंबंध। लेखक द्वारा छवि
कोरिलेशन हीटमैप से स्पष्ट है कि चरों के बीच कोई मजबूत युग्म-सहसंबंध नहीं है, क्योंकि कोई भी मान 0.6 से अधिक नहीं है। अब, हम VIF मानों की गणना करेंगे और देखेंगे कि क्या कुछ चिंताजनक है। नीचे दी पंक्ति वही कार्य करती है।
# Fit a regression model
model <- lm(Performance ~ Ambience + Customer_service + Offers + Product_range, data = data)

# Calculate VIF
vif(model)
आउटपुट:

आउटपुट से पता चलता है कि प्रेडिक्टर चरों में, केवल Product_range का VIF मान 5 से अधिक है, जो उच्च मल्टिकॉलिनियरिटी का संकेत देता है और इसके लिए सुधारात्मक कदमों की आवश्यकता है।
VIF गणना का दूसरा तरीका यह होगा कि प्रत्येक चर के लिए मानों की अलग-अलग गणना की जाए, जहाँ प्रत्येक स्वतंत्र चर को अन्य प्रेडिक्टर चरों के विरुद्ध रिग्रेस किया जाए।
यह नीचे दिए गए कोड में किया गया है, जो प्रत्येक प्रेडिक्टर पर sapply() फ़ंक्शन का उपयोग करता है; हर प्रेडिक्टर को एक रैखिक प्रतिगमन मॉडल में आश्रित चर और अन्य प्रेडिक्टर्स को स्वतंत्र चर के रूप में सेट किया जाता है।
प्रत्येक मॉडल के R-squared मान का उपयोग फिर उसके सूत्र से VIF मानों की गणना में किया जाता है। अंततः vif_values परिणाम प्रत्येक प्रेडिक्टर के लिए VIF दिखाता है, जो मल्टिकॉलिनियरिटी समस्याओं की पहचान में सहायक है।
# VIF calculation for each predictor manually
predictors <- c("Ambience", "Customer_service", "Offers", "Product_range")

vif_values <- sapply(predictors, function(pred) {
    formula <- as.formula(paste(pred, "~ ."))
    model <- lm(formula, data = data[, predictors])
    1 / (1 - summary(model)$r.squared)
})

print(vif_values)
आउटपुट:

हमें वही परिणाम मिलता है और यह स्पष्ट है कि Product_range चर, जिसका VIF मान 5 से ऊपर है, हस्तक्षेप की मांग करता है।
दोहराव के रूप में, मल्टिकॉलिनियरिटी का पता लगाने के लोकप्रिय तरीके निम्नलिखित हैं:
इन सभी तरीकों में, VIF विशेष रूप से उपयोगी है क्योंकि यह तब भी मल्टिकॉलिनियरिटी का पता लगा सकता है जब युग्म सहसंबंध कम हों, जैसा कि हमने अपने उदाहरण में देखा। यह VIF को अधिक व्यापक टूल बनाता है।
यदि VIF मान उच्च मल्टिकॉलिनियरिटी का संकेत दें, और आप सीधे चर को हटाना नहीं चाहते, तो मल्टिकॉलिनियरिटी कम करने के लिए कुछ उन्नत रणनीतियाँ हैं:
VIF का उपयोग करना जानना मल्टिकॉलिनियरिटी की पहचान और समाधान की कुंजी है, जो प्रतिगमन मॉडलों की सटीकता और स्पष्टता को बेहतर बनाता है। VIF मानों की नियमित जाँच करना और आवश्यकता पड़ने पर सुधारात्मक कदम उठाना डेटा प्रोफेशनल्स और विश्लेषकों को भरोसेमंद मॉडल बनाने में मदद करता है। यह दृष्टिकोण सुनिश्चित करता है कि प्रत्येक प्रेडिक्टर का प्रभाव स्पष्ट हो, जिससे मॉडल से विश्वसनीय निष्कर्ष निकालना और परिणामों के आधार पर बेहतर निर्णय लेना आसान हो जाता है। हमारे Machine Learning Scientist in Python करियर ट्रैक को लें ताकि सच में समझ सकें कि मॉडल कैसे बनाए और उपयोग किए जाते हैं। साथ ही, कार्यक्रम पूर्ण करना आपके रिज़्यूमे पर शानदार दिखता है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स