Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
11.5K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleIm Wettlauf der Spitzenmodelle Ende 2026 drehte sich zuletzt vieles eher um den Preis als um die reine Leistungsfähigkeit. Allein im September kamen OpenAIs GPT-6 Astra und Anthropics Claude Fable 5.1 jeweils mit $10 pro 1 Mio. Eingabetokens und $50 pro 1 Mio. Ausgabetokens auf den Markt – ohne kostenlose Tarife.
DeepSeek wählt den komplett anderen Weg.
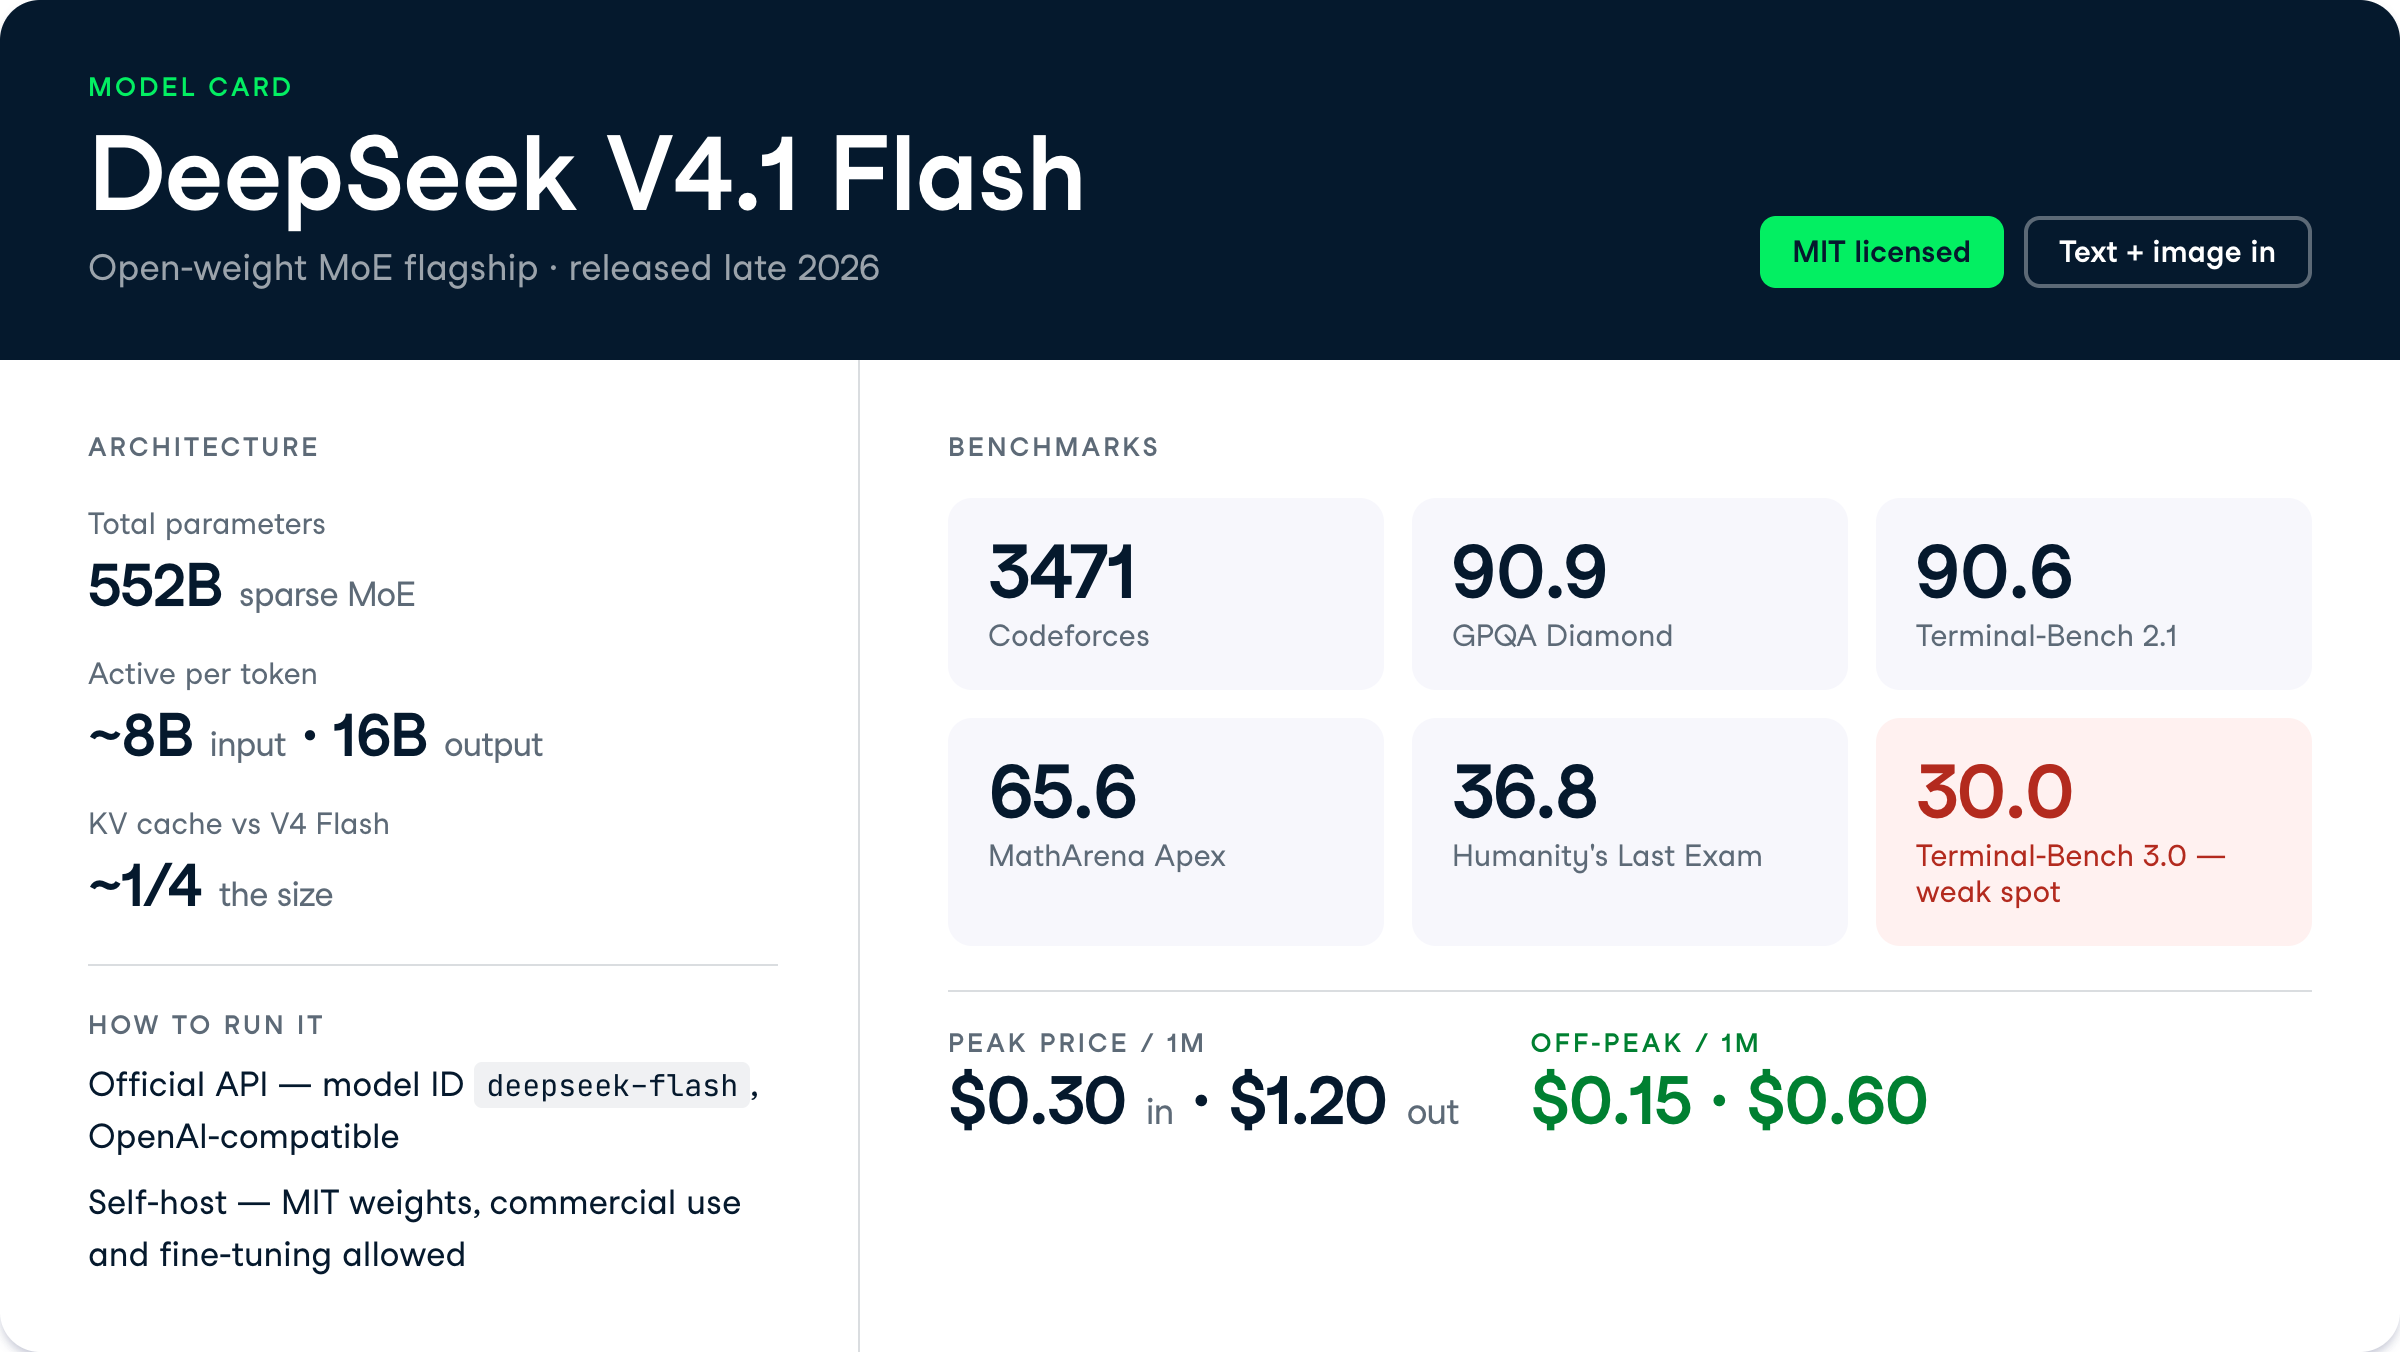
DeepSeek V4.1 Flash ist ein Mixture-of-Experts-Modell mit 552 Milliarden Parametern, das für Eingaben rund 8 Mrd. und für Ausgaben 16 Mrd. Parameter aktiviert, mit MIT-lizenzierten offenen Gewichten ausgeliefert wird und zu Spitzenzeiten $0,30/$1,20 pro 1 Mio. Tokens kostet. Außerhalb der Spitzenzeiten sinken die Preise auf $0,15/$0,60 – günstiger als vergleichbare Flash-Modelle wie Gemini 3.8 Flash und GLM-5.3-Flash.
In diesem Artikel schauen wir uns alle Neuerungen von DeepSeek V4.1 Flash an, von den Features bis zu den Benchmarks. Wenn du das Modell in Aktion sehen willst, lies unser DeepSeek V4.1 API-Tutorial.
Mehr zur DeepSeek-Familie findest du in unserem Leitfaden zum Ausführen von DeepSeek-V4-Flash-0731 mit Unsloth Studio und OpenCode sowie in unserem Vergleich von DeepSeek V4.1 Flash vs. Gemini 3.8 Flash.
DeepSeek V4.1 Flash ist das neueste Modell der Flash-Reihe von DeepSeek, ausgelegt auf Effizienz und hohen Durchsatz statt auf forschungsgradige Schwergewichte.
Es setzt auf eine spärliche Mixture-of-Experts-Architektur (MoE) mit insgesamt 552 Mrd. Parametern, von denen pro Token nur etwa 8 Mrd. bei der Eingabe und 16 Mrd. bei der Ausgabe aktiv sind. Diese sparsame Aktivierung senkt die Bereitstellungskosten und erreicht dennoch auf mehreren Benchmarks Werte nahe der Spitze.
Die größte Neuerung gegenüber der Vorgänger-Generation ist die Effizienz.
DeepSeek hat den KV-Cache auf etwa ein Viertel der Größe des vorherigen V4 Flash reduziert. Das verringert den Speicherbedarf und erlaubt günstigere, längere Kontexte. Laut Unternehmen übertrifft V4.1 Flash den älteren V4 Pro 0813 bei Performance, Kosten, Geschwindigkeit und Gesamtdauer – V4 Pro wird daher aus dem Programm genommen.
Bei den Benchmarks sticht insbesondere Terminal-Bench 2.1 mit 90,6 heraus. Als wir den früheren DeepSeek-V4-Flash-0731 getestet haben, lag er auf demselben Benchmark bei 82,7. V4.1 Flash ist also ein klarer Sprung für agentische Terminal-Aufgaben innerhalb derselben Modellfamilie.
Das Feature-Set von V4.1 Flash folgt zwei Leitideen: günstig laufen und offen bleiben. Hier sind die Fähigkeiten, die für Data Scientists und ML Engineers im Alltag zählen.
V4.1 Flash wird mit MIT-lizenzierten Gewichten ausgeliefert – eine der freizügigsten Standardlizenzen. Sie erlaubt kommerzielle Nutzung, Weiterverteilung und Fine-Tuning ohne Umsatzschwellen.
Für Teams mit strengen Datenschutzanforderungen heißt das: Du kannst das Modell komplett auf eigener Hardware betreiben statt Anfragen an die DeepSeek API zu senden.
Der Trade-off: Die MIT-Lizenz verlagert Verantwortung für Safety, Fine-Tuning und Inferenzoptimierung auf dich.
Als wir V4-Flash-0731 lokal betrieben haben, brauchte es drei NVIDIA A100 80GB GPUs bei Q8-Quantisierung. Selbsthosting lohnt sich also nur, wenn wirklich ausreichend GPU-Speicher verfügbar ist.
V4.1 Flash nimmt Bilder direkt als Eingabe entgegen – ohne separaten Vision-Adapter oder Preprocessing-Schritt. So kannst du Screenshots, Diagramme oder Dokumentscans zusammen mit Text in derselben Anfrage schicken – praktisch für dokumentenlastige Pipelines und UI-Agent-Workflows.
Native Multimodalität zu diesem Preis ist selten. Im ZeroBench-main mit Tools erreicht V4.1 Flash 49,0 – ein grober Indikator, wie gut es visuelle Eingaben in sein Reasoning einbezieht.
Der KV-Cache von V4.1 Flash ist etwa ein Viertel so groß wie beim vorherigen V4 Flash. Das senkt die Speicherkosten für lange Kontexte in einer Serving-Session.
Für alle, die Always-on-Inferenz betreiben, bedeutet ein kleinerer KV-Cache: mehr gleichzeitige Sessions pro GPU oder geringere Speicherlast pro Anfrage.
Kombiniert mit Cache-Hit-Eingaben für $0,006 pro 1 Mio. Tokens in der Peak-Zeit wird Kontextwiederverwendung extrem günstig. Wenn du denselben System-Prompt oder dasselbe Dokument wiederholt sendest, kostet der gecachte Teil fast nichts.
DeepSeek fährt ein zweistufiges Preismodell: Außerhalb der Spitzenzeiten liegen die Preise bei der Hälfte der Peak-Raten, um Batch- und geplante Workloads in diese Zeitfenster zu schieben. Aus $0,30/$1,20 werden so $0,15/$0,60 pro 1 Mio. Tokens, wenn du deine Jobs timen kannst.
Die Krux ist operativ: Always-on-Workloads werden schwerer kalkulierbar, und um den Rabatt mitzunehmen, brauchst du eine eigene Scheduling-Logik, die du bauen und pflegen musst.
V4.1 Flash punktet besonders auf agentischen und Reasoning-Benchmarks und erreicht dort Werte nahe der Spitze – bei einem Bruchteil der Token-Kosten.
Auf den schwierigsten agentischen Prüfungen fällt die Leistung deutlich ab – das solltest du wissen, bevor du es auf sehr langlaufende Aufgaben ansetzt.
V4.1 Flash erzielt 90,6 auf Terminal-Bench 2.1, der misst, wie gut ein Modell mehrstufige Aufgaben in einer Terminal-Umgebung löst.
Zum Vergleich: DeepSeek-V4-Flash-0731 lag in unseren Tests auf demselben Benchmark bei 82,7, und GPT-5.6 Terra erreichte 87,4 in unserem Terra-vs.-Sonnet-5-Vergleich.
Auf härteren agentischen Evaluierungen dreht sich das Bild.
V4.1 Flash fällt auf 30,0 bei Terminal-Bench 3.0. Das Modell beherrscht Standard-Terminalaufgaben gut, tut sich aber mit der anspruchsvolleren Agenten-Suite schwer. Das Codeforces-Rating von 3471 signalisiert starke Competitive-Programming-Fähigkeiten.
Auf GPQA Diamond, einem Set aus Fragen auf Graduate-Niveau in den Naturwissenschaften, die sich nicht einfach aus dem Gedächtnis beantworten lassen, erreicht V4.1 Flash 90,9.
Das ist für diese Preisklasse ein sehr guter Wert und bringt es in die Diskussion mit deutlich teureren Spitzenmodellen.
Auf Humanity's Last Exam (HLE), einem bewusst extrem harten Experten-Benchmark, erzielt V4.1 Flash 36,8 bzw. 39,1 in der Stern-Konfiguration.
Zum Vergleich: Auf agentisch-wissenschaftlichen Evaluierungen wie Terminal-Bench-Science 0.1 liegt Claude Fable 5.1 bei 52,6 %. V4.1 Flash führt die schwersten Expertentests also nicht an, liefert aber solide ab.
V4.1 Flash erreicht 65,6 auf MathArena Apex, einem Wettbewerbs-Mathe-Benchmark, der mehrstufiges symbolisches Schließen belohnt.
Das gehört zu den stärkeren Ergebnissen des Modells und deutet darauf hin, dass es für quantitative und mathelastige Workloads gut geeignet ist.
Ein Wert Mitte 60 ist hier wichtig für alle, die Tools mit zuverlässigem arithmetischem und algebraischem Schlussfolgern bauen – denn viele günstigere Modelle scheitern genau an diesen Aufgaben.
Die Entscheidung dreht sich weniger um Modellvarianten und mehr um die Art der Bereitstellung, da dieselben Gewichte auf drei Arten laufen. Am Ende geht es um Kostenplanbarkeit, Datenschutz und deine Fähigkeit, Jobs zu planen.
DeepSeek fährt außerdem eine Migrationsphase. Ab 12:00 Uhr Pekinger Zeit am 14. September 2026 bis zur künftigen Veröffentlichung von V4.1 Pro werden Anfragen an Legacy-Endpunkte umgeleitet – bestehende Nutzer werden also in die V4.1-Familie geschoben. Wenn du noch V4 Pro 0813 nutzt: Dieses Modell wird ausgemustert, plane daher jetzt den Wechsel zu V4.1 Flash.
| Anwendungsfall | Empfohlener Weg | Warum |
|---|---|---|
| Hohes Volumen, Always-on-Coding-Agent | Offizielle API, Peak-Preise | $0,30/$1,20 pro 1 Mio. liegt bereits klar unter Spitzenwettbewerbern; kein Scheduling-Overhead |
| Große Batch-Reasoning- oder Mathe-Jobs | Offizielle API, Off-Peak | Off-Peak halbiert die Rate auf $0,15/$0,60 pro 1 Mio., wenn du die Läufe planen kannst |
| Sensible oder proprietäre Daten | MIT-Gewichte selbst hosten | Hält die Inferenz auf eigener Hardware; erfordert echten GPU-Speicher |
| Starke Kontextwiederverwendung | API mit Prompt-Caching | Cache-Hit-Eingaben für $0,006 pro 1 Mio. machen wiederholten Kontext nahezu kostenlos |
V4.1 Flash gehört zu den günstigsten leistungsfähigen Modellen – besonders außerhalb der Spitzenzeiten. So teilen sich die Token-Preise auf.
| Rate | Peak | Off-Peak |
|---|---|---|
| Eingabe pro 1 Mio. Tokens | $0,30 | $0,15 |
| Ausgabe pro 1 Mio. Tokens | $1,20 | $0,60 |
| Cache-Hit-Eingabe pro 1 Mio. Tokens | $0,006 | Nicht veröffentlicht |
Off-Peak-Preise liegen bei der Hälfte der Peak-Raten und sollen Batch- und geplante Workloads in Off-Peak-Fenster verschieben.
Zum Vergleich: GPT-6 Astra und Claude Fable 5.1 verlangen $10 pro 1 Mio. Eingabe und $50 pro 1 Mio. Ausgabe. V4.1 Flash ist damit in der Peak-Zeit rund 30× günstiger bei der Eingabe und 40× günstiger bei der Ausgabe.
Das auslaufende Modell V4 Pro 0813 kostet $0,435 pro 1 Mio. Eingabe und $0,87 pro 1 Mio. Ausgabe bei einem 1 Mio.-Token-Kontext.
Da DeepSeek angibt, dass V4.1 Flash V4 Pro bei Performance, Kosten und Geschwindigkeit übertrifft, gibt es wenig Grund, beim älteren Modell zu bleiben.
V4.1 Flash ist über die offizielle DeepSeek API verfügbar, und seine MIT-lizenzierten Gewichte sind für Self-Hosting veröffentlicht.
Ab dem 14. September 2026 werden Legacy-Endpunkte bis zum Erscheinen von V4.1 Pro auf die V4.1-Familie umgeleitet.
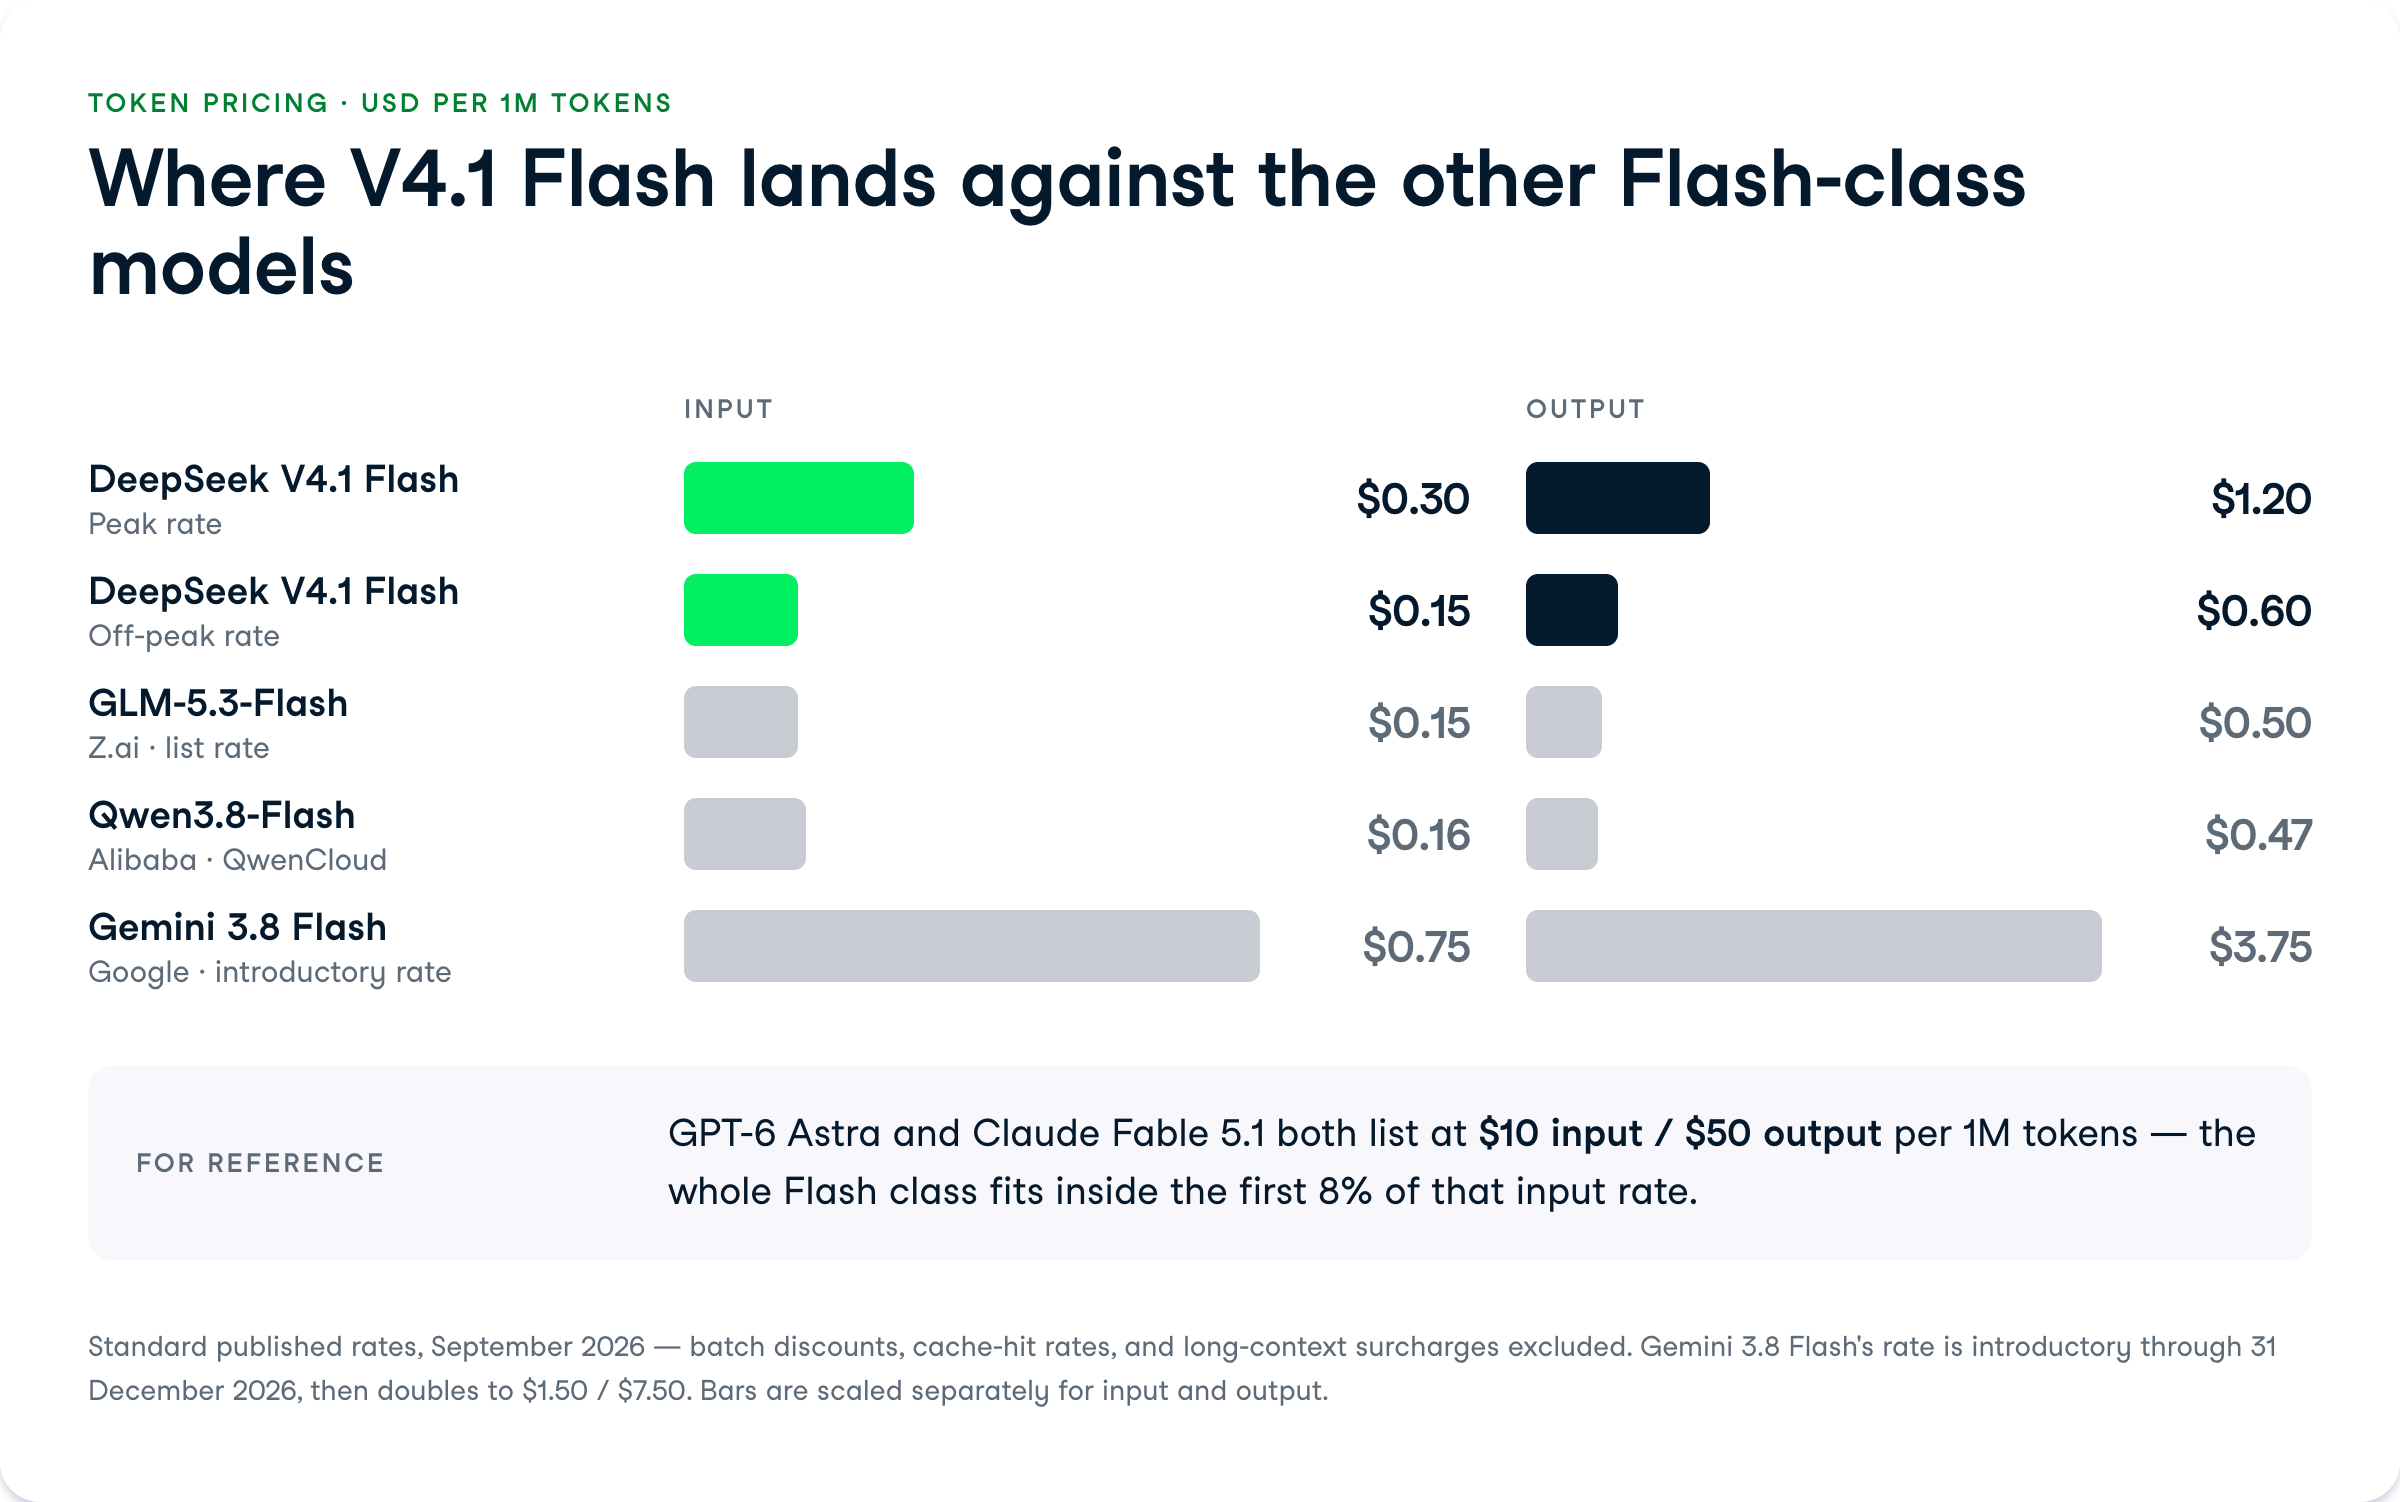
V4.1 Flash ist sowohl ein API-Modell als auch ein Open-Weight-Release – du kommst also auf zwei Wegen dran.
In der API ist die Modell-ID oft als deepseek-flash gelistet, und der Endpunkt ist OpenAI-kompatibel. Heißt: Die meisten bestehenden OpenAI-Clients laufen mit geänderter Basis-URL.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Für Self-Hosting erlauben die MIT-lizenzierten Gewichte kommerzielle Nutzung, Weiterverteilung und Fine-Tuning ohne Umsatzschwellen.
Als wir V4-Flash-0731 lokal mit Unsloth Studio betrieben haben, brauchte es drei NVIDIA A100 80GB GPUs bei Q8-Quantisierung. Plane ähnliche Hardware für ein Setup in Vollpräzision ein.
Eine vollständige lokale Anleitung findest du in unserem Tutorial zum Ausführen von DeepSeek-V4-Flash mit Unsloth Studio und OpenCode, das GPU-Verteilung und Inferenz-Setup im Detail behandelt.
V4.1 Flash setzt ein Ausrufezeichen bei Preis und Offenheit, während der Rest der Spitzengruppe Richtung $10/$50 pro 1 Mio. Tokens geht und den Zugang hinter Bezahlstufen versteckt.
Ein 552B-MoE-Modell mit MIT-Gewichten, nativer Bild-Eingabe, 90,9 auf GPQA Diamond und Peak-Preisen 30× unter GPT-6 Astra ist ein starkes Angebot für großvolumige Workloads.
Ich würde für Coding-Agents und Batch-Reasoning-Jobs wechseln – besonders, wenn du Off-Peak timen kannst.
Die Schwächen zeigen sich bei 30,0 auf Terminal-Bench 3.0: Bei den härtesten agentischen Aufgaben wackelt es, und Peak/Off-Peak-Abrechnung bringt Scheduling-Arbeit mit sich, die du selbst stemmen musst.
Wenn du Agent-Workflows rund um solche Modelle bauen willst, ist unser AI Agent Fundamentals Skill Track ein guter Startpunkt.
Top-DataCamp-Kurse
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Hesam Sheikh Hassani
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Nathaniel Taylor-Leach
Blog
Blog
Zoumana Keita
15 Min.
Blog
Nisha Arya Ahmed
15 Min.