Kurs
Grundlagen von Data Engineering
2 Std.
372.2K
Heute entstehen Unmengen an Daten aus unterschiedlichsten Quellen – dafür braucht es einen reiferen Ansatz, um Daten zu managen und zu analysieren. Warum? Klassische Methoden stoßen bei diesen Volumina an ihre Grenzen. Wir brauchen moderne Werkzeuge, um Informationen effizient zu speichern und abzurufen.
Genau hier setzt die Semantikschicht an: Sie vermittelt zwischen Datenbanken und Anwendungen. Sie bietet eine unabhängige Sicht auf die Daten, indem sie eine gemeinsame Geschäftsterminologie, Regeln und Beziehungen zwischen Datenelementen definiert.
In diesem Artikel schauen wir uns Bedeutung und Vorteile der Semantikschicht im Detail an.
Die Semantikschicht überbrückt die Lücke zwischen der technischen Struktur der zugrunde liegenden Datenquellen (zum Beispiel Data Warehouses und Data Lakes) und den Bedarfen der Nutzenden.
Datenbanken verwenden oft technische Tabellennamen und kryptische Feldbezeichnungen. Die Semantikschicht schafft eine neue, unabhängige Sicht auf die Daten – mit klaren geschäftlichen Begriffen, die jede Person im Unternehmen versteht.
Diese Schicht etabliert außerdem ein gemeinsames Geschäftsvokabular, denn unterschiedliche Bereiche verwenden für dasselbe Konzept häufig verschiedene Begriffe. „Sales“ im Vertrieb kann zum Beispiel „Umsatz“ im Finanzteam heißen. So stellt die Semantikschicht sicher, dass alle vom Gleichen sprechen – und Verwirrung bei der Datenanalyse vermieden wird.
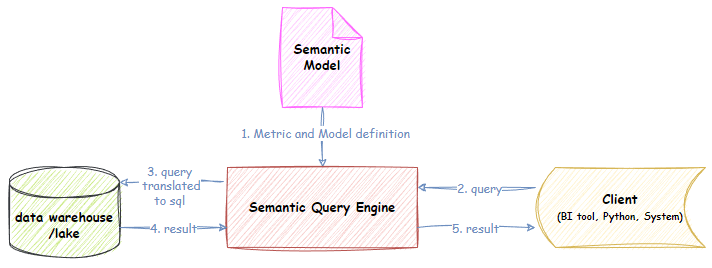
Aufbau einer Semantikschicht. Quelle: Dimodelo
Die meisten Unternehmen kämpfen mit Datensilos, uneinheitlichen Definitionen und komplexen Zugriffsprozessen. Mit einer Semantikschicht wird der Datenzugriff einfacher und reibungslose Abläufe werden wahrscheinlicher.
Schauen wir uns an, warum eine Semantikschicht nötig ist:
Unternehmen verteilen ihre Daten oft über mehrere Datenbanken, Tabellenkalkulationen und Cloud-Anwendungen. Das führt zu Silos und erschwert den Gesamtüberblick – mit der Folge inkonsistenter Definitionen und Begrifflichkeiten.
Die Semantikschicht begegnet dem, indem sie die Daten unter einem konsistenten Geschäftsvokabular vereint. So bleiben Daten bereichsübergreifend konsistent und folgen klaren Regeln. Dadurch können Datenteams Inkonsistenzen aus unterschiedlichen Quellen bereinigen und für Analysen auf sauberere, verlässlichere Daten zurückgreifen.
Komplexe Datenstrukturen erfordern technisches Know-how – das schränkt den Zugang zu wertvollen Erkenntnissen für Nicht-Techniker wie Business-Analysten oder Führungskräfte ein.
Die Semantikschicht demokratisiert den Datenzugang, indem sie Informationen benutzerfreundlich aufbereitet und mehr Menschen befähigt, Daten eigenständig zu erkunden und zu analysieren. Du kannst es als Self‑Service‑Ansatz sehen – und er reduziert die Abhängigkeit von IT-Teams bei einfachen Datentätigkeiten.
Mit einer gut definierten Semantikschicht finden Datenprofis schneller die relevanten Daten und analysieren sie zügiger. Das führt zu schnelleren Insights und besseren, datenbasierten Entscheidungen, um Chancen agiler zu nutzen.
Semantikschichten haben unterschiedliche Zwecke. Welche Variante dein Unternehmen braucht, hängt von Herkunft und Nutzung der Daten ab. Hier sind die gängigsten Typen:
Die universelle Semantikschicht ist eine eigenständige Ebene, getrennt vom Data Warehouse oder BI-Tool. Sie ist die Single Source of Truth für Definitionen und Business-Logik und bietet Vorteile wie zentrale Verwaltung, bessere Governance und Flexibilität:
Die universelle Semantikschicht erfordert zwar zusätzliche Investitionen, ist aber für komplexe Datenlandschaften oft die bessere Wahl.
Diese Variante liegt innerhalb des Data Warehouses. Sie hilft Data Engineers, das Datenmodell zu organisieren und die Wartbarkeit im Warehouse zu verbessern. Der Fokus liegt auf:
Analog zur Warehouse-Variante dient die Semantikschicht im Data Lake dazu, Schemata für unstrukturierte oder semi-strukturierte Daten zu organisieren und zu verwalten. Sie hilft Nutzenden, Bedeutung und Beziehungen zwischen Datenelementen im Lake zu verstehen.
Das ist der häufigste Typ. Er sitzt zwischen Data Warehouse (oder Data Lake) und BI-Tools wie Power BI oder Tableau. So werden Daten für Business-Anwender leichter zugänglich – ohne die zugrunde liegende Struktur verstehen zu müssen.
Die geschäftliche Semantikschicht definiert:
Sales statt sales_table).Customer mit Order).Total Revenue).Du willst mehr über Power‑BI‑Semantikmodelle erfahren? Lies unseren ausführlichen Blogbeitrag What are Power BI Semantic Models? mit Komponenten, Modi und Best Practices für Erstellung und Pflege.
Eine Plattform für die Semantikschicht verbindet diese mit Business-Anwendungen oder Analysetools wie Power BI, Tableau und anderen. Sie abstrahiert die Datenquellen und bietet eine einheitliche, geschäftsfreundliche Sicht auf die zugrunde liegenden Daten, damit Nutzende Informationen schnell finden und analysieren können.
Die Hauptkomponenten einer Semantikschicht-Plattform sind:
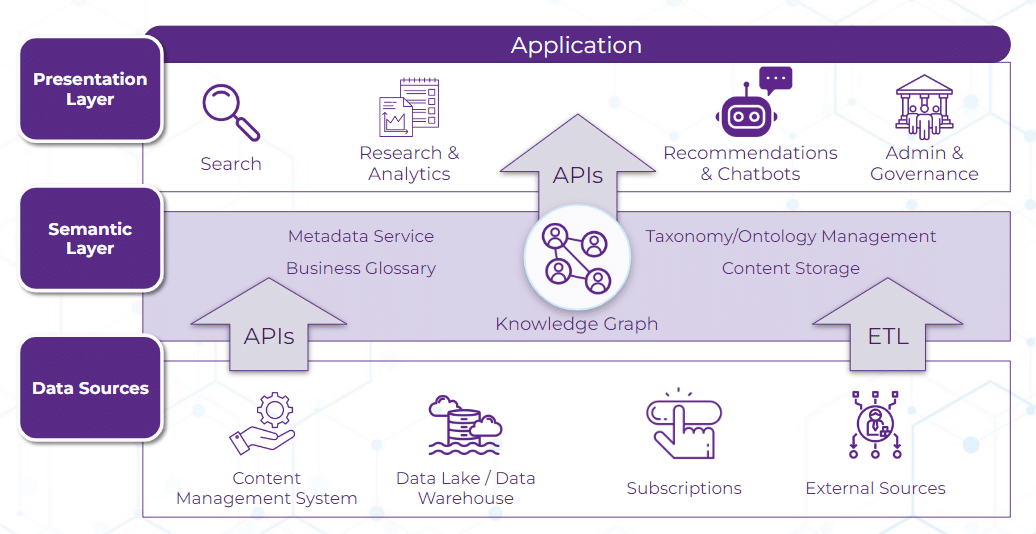
Hauptkomponenten einer Semantikschicht. Quelle: Enterprise Knowledge
Zu verstehen, wie eine Semantikschicht aufgebaut wird, ist ebenso wichtig wie ihr Nutzen. Folge diesen Schritten, um eine wirksame Semantikschicht zu erstellen, die eine konsistente, geschäftsfreundliche Datensicht liefert:
Zuerst gilt es, die Geschäftsanforderungen zu erheben und die spezifischen Needs der Endnutzer zu verstehen. Dafür arbeiten Data Analysts und Fachexperten zusammen, um zu klären, welche Daten gebraucht werden, welche Fragen zu beantworten sind und welche Reports oder Analysen entstehen sollen.
Sind alle Anforderungen bekannt, lässt sich eine Semantikschicht entwickeln, die genau zu den Bedürfnissen der Organisation passt.
Nach der Anforderungserhebung bewerten Datenteams die bestehenden Datenquellen. So verstehen sie Format und Qualität der dort gespeicherten Daten. Das zeigt, welche Aufbereitung und Transformation nötig ist, bevor die Daten in die Semantikschicht integriert werden.
Anschließend entwirft das Team das semantische Modell auf Basis der Anforderungen und der Datenbewertung. Das Modell bildet Geschäftsentitäten und ihre Beziehungen für Endnutzer verständlich ab.
Für den Entwurf kommen etablierte Modellierungsmethoden wie Dimensionenmodellierung oder Data‑Vault‑Modellierung zum Einsatz, damit das Modell skalierbar und erweiterbar bleibt.
Steht das Modell, implementieren Data Analysts die Semantikschicht mit geeigneten Tools und Technologien. Sie erstellen Sichten sowie berechnete Felder, Hierarchien und weitere Konstrukte, um Rohdaten im Datenmodellierungs-Tool oder der Business‑Intelligence‑Plattform in das semantische Modell zu überführen – falls eine genutzt wird.
Danach bauen Datenteams über Connectoren oder APIs Verbindungen zwischen Semantikschicht und Datenquellen auf und schreiben Prozesse zur Extraktion und Transformation, um Daten zu bewegen und für die Semantikschicht aufzubereiten.
So werden Daten transformiert und normalisiert, an das semantische Modell angepasst und über alle Quellen hinweg aktuell gehalten.
Die Semantikschicht wird gründlich getestet und validiert, um Korrektheit und Passgenauigkeit zu den Anforderungen sicherzustellen. In dieser Phase passiert Folgendes:
Ist alles erledigt, wird die Semantikschicht in der Produktionsumgebung ausgerollt und steht Endnutzern zur Verfügung. Nun werden Prozesse für die laufende Wartung etabliert, um Datenqualität zu überwachen und die Semantikschicht bei veränderten Anforderungen zu aktualisieren.
Damit die Semantikschicht optimal läuft, wird ihre Performance regelmäßig überprüft und es werden Verbesserungsmöglichkeiten identifiziert.
So vielversprechend eine Semantikschicht ist – bei der Umsetzung können Hürden entstehen, die Datenteams sorgfältig berücksichtigen sollten. Hier einige der zentralen Herausforderungen:
Wenn du diese Punkte frühzeitig einplanst, steigen die Chancen für eine erfolgreiche Implementierung deutlich.
Eine Semantikschicht verbessert Zugänglichkeit und Nutzbarkeit, indem sie eine einheitliche Sicht auf komplexe Datensätze bietet. Hier sind einige bewährte Integrationsansätze.
Bei einer Metadata‑first‑Architektur erzeugt die Semantikschicht eine logische Architektur mit Fokus auf Metadaten. Sie liefert eine einheitliche Sicht auf Unternehmensdaten – ohne physische Konsolidierung. So lassen sich Definitionen und Governance auf Unternehmensebene standardisieren, während spezifische Komponenten für einzelne Bereiche dezentral bleiben können.
Dieser Ansatz ist ideal, wenn du Standardisierung mit der Agilität einzelner Geschäftseinheiten in Einklang bringen willst.
Hier wird ein gemeinsames Vokabular in OML geschaffen, das sich automatisch aus verteilten Modellen in einen Knowledge Graph instanziieren lässt. Damit werden Zugriff, Klassifizierung, Prüfung und Wiederverwendung föderierter Informationsdienste erleichtert.
Bei dieser Art Semantikschicht kommt häufig UFO – eine grundlegende Ontologie mit gemeinsamem Vokabular für Konzepte und Beziehungen – zum Einsatz, insbesondere zur Integration domänenübergreifender Daten.
Dieser dezentrale Ansatz nutzt die inhärenten semantischen Fähigkeiten einzelner Tools und Systeme (z. B. CMS, CRM, BI‑Dashboards), um Daten auf Ebene der Geschäftseinheit zu managen – ohne übergreifendes Enterprise‑Framework.
Das ist sinnvoll für Organisationen mit diversen, unabhängigen Einheiten, die sich schnell an veränderte Anforderungen anpassen müssen.
Dieses Modell konsolidiert Daten in einem EDW oder DL und dient als maßgebliche Quelle für Definitionen und Business‑Logik. Es eignet sich für große Unternehmen mit komplexen Anforderungen und strikter Governance – etwa Finanzinstitute oder Gesundheitsorganisationen.
Für kleine Organisationen ist dieser Ansatz weniger geeignet, da er hohe Anfangsinvestitionen in Zeit und Ressourcen erfordert.
Die Wahl des richtigen Tools hilft dir, Daten effizient zu managen und zu nutzen. Hier sind einige der besten Lösungen am Markt, ihre Funktionen und wie sie deinem Unternehmen helfen können.
| Tool | Schlüsselfunktionen | Vorteile |
|---|---|---|
| Cube.js | Headless BI, Datenmodellierung, Caching, APIs, Echtzeit-Analytics | Die Semantikschicht von Cube.js ermöglicht Echtzeit-Analysen und Visualisierungen für effiziente Datenauswertung. |
| MetricFlow | Datenmodellierung, Metrics Layer, Caching, APIs, Datentransformation | Die Semantikschicht von MetricFlow unterstützt nahtlose Integration mit verschiedenen Quellen und bietet eine einheitliche Sicht. |
| dbt | Datentransformation, Metrics Layer, Caching, APIs, Datenmodellierung | Die Semantikschicht von dbt schafft durch Modellierung von Strukturen und Beziehungen eine einheitliche Datensicht und erleichtert damit Analyse und Visualisierung komplexer Daten. |
| Tableau | Datenvisualisierung, Datenmodellierung, Caching, APIs | Die Semantikschicht von Tableau unterstützt Visualisierungen, sodass Nutzende interaktive Dashboards und Berichte erstellen können. |
| Power BI | Datenvisualisierung, Datenmodellierung, APIs, Datenintegration | Die Integrationsfähigkeiten von Power BI erleichtern das Anbinden verschiedenster Datenquellen. |
Die Semantikschicht ist ein wirkungsstarker Hebel für jede Organisation, die die großen Datenmengen im Unternehmen nutzbar machen will. Sie ermöglicht fundierte Entscheidungen und erhöht die Zugänglichkeit, indem sie einen einheitlichen Ansatz für den Umgang mit Daten bietet.
Natürlich bringt die Implementierung auch Herausforderungen mit sich – etwa höhere Komplexität und Skalierungsfragen. Mit guter Planung, Schulungen und den richtigen Tools lassen sich diese jedoch meistern.
Wenn du lernen willst, wie du Tools wie Power BI effektiv nutzt, findest du bei DataCamp zahlreiche Lernangebote. Der Kurs Introduction to Power BI legt ein solides Fundament für Einsteiger. Für einen umfassenderen Einstieg eignet sich der komplette Data Analyst in Power BI Lernpfad, der zusammen mit Microsoft entwickelt wurde.
Wenn du fortschrittliche Technologien integrieren willst, sieh dir außerdem den Kurs Implementing AI Solutions in Business an, um zu erfahren, wie KI Geschäftsprozesse innovativer und effizienter macht.
Mit DataCamp lernen
Kurs
Kurs
Kurs