Cours
Présentation de l’ingénierie des données
2 h
372.7K
Aujourd'hui, l'explosion de données issues de multiples sources impose une approche plus avancée pour gérer et analyser l'information. Pourquoi ? Parce que les méthodes traditionnelles ne tiennent pas l'échelle. Nous avons besoin d'outils modernes pour stocker et interroger les données efficacement.
C'est là qu'intervient la couche sémantique, qui fait l'interface entre les bases de données et les applications métiers. Elle propose une vue indépendante des données en définissant un vocabulaire métier commun, des règles et des liens entre les éléments de données.
Dans cet article, nous détaillons l'importance et les bénéfices de la couche sémantique.
La couche sémantique comble l'écart entre la structure technique des sources de données sous-jacentes (entrepôts de données, data lakes) et les besoins des utilisateurs.
Les bases de données utilisent souvent des noms de tables techniques et des champs obscurs. La couche sémantique crée une nouvelle vue, indépendante, en s'appuyant sur des notions métier claires compréhensibles par toute l'organisation.
Elle définit aussi un vocabulaire métier commun, car les services peuvent employer des termes différents pour une même réalité. Par exemple, « ventes » pour l'équipe commerciale correspondra à « chiffre d'affaires » pour la finance. Résultat : la couche sémantique aligne tout le monde et évite les ambiguïtés lors de l'analyse des données.
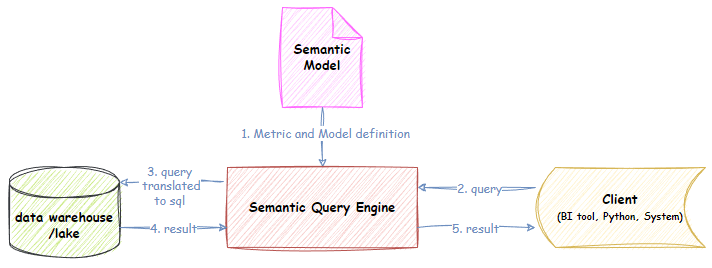
Structure de la couche sémantique. Source : Dimodelo
La plupart des organisations se heurtent à des silos de données, à des définitions incohérentes et à des processus d'accès complexes. Mettre en place une couche sémantique fluidifie l'accès aux données et facilite le fonctionnement global.
Voici pourquoi une couche sémantique est nécessaire :
Les données sont disséminées entre bases, feuilles de calcul et applications cloud. Ces silos empêchent d'avoir une vision d'ensemble et favorisent les divergences de définitions et de terminologie.
Pour y remédier, la couche sémantique unifie les données autour d'un vocabulaire métier cohérent. Elle garantit la constance d'un service à l'autre et impose des règles claires. Les équipes données corrigent ainsi les divergences issues de sources hétérogènes et disposent de données plus propres et fiables pour l'analyse.
Travailler sur des structures complexes exige des compétences techniques, ce qui limite l'accès aux insights pour les profils non techniques comme les analystes métiers et les dirigeants.
La couche sémantique démocratise l'accès en présentant des informations compréhensibles et permet à davantage d'utilisateurs d'explorer et d'analyser les données en autonomie. C'est une approche en libre-service qui réduit la dépendance aux équipes IT pour les besoins courants.
Avec une couche sémantique bien définie, les praticiens des données trouvent et analysent plus vite, génèrent des insights plus rapidement et prennent de meilleures décisions basées sur les données pour saisir les opportunités avec agilité.
Les couches sémantiques couvrent des usages variés. Le type dont vous avez besoin dépend de l'origine des données et des attentes. Voici les principaux :
Indépendante de l'entrepôt de données ou de l'outil de BI, la couche sémantique universelle constitue une source unique de vérité pour les définitions et la logique métier. Elle offre gestion centralisée, meilleure gouvernance et flexibilité :
Cette approche nécessite un investissement supplémentaire mais convient mieux aux environnements de données complexes.
Intégrée à l'entrepôt, elle aide les data engineers à organiser et gérer le modèle de données et améliore sa maintenabilité. Elle se concentre sur :
À l'instar de l'entrepôt, la couche sémantique d'un data lake organise et gère les schémas de données non structurées ou semi-structurées. Elle aide à comprendre le sens et les relations entre éléments au sein du lac.
La plus courante. Placée entre l'entrepôt (ou le data lake) et des outils comme Power BI ou Tableau, elle rend les données plus accessibles aux métiers sans connaissance de la structure sous-jacente.
La couche sémantique métier définit :
Sales au lieu de sales_table).Customer reliée à Order).Total Revenue).Vous souhaitez en savoir plus sur les semantic models de Power BI ? Consultez notre article détaillé What are Power BI Semantic Models? pour découvrir leurs composants, leurs modes et les bonnes pratiques de création et de gestion.
Une plateforme de couche sémantique relie cette couche aux applications métiers ou aux outils d'analyse comme Power BI, Tableau, etc. Elle abstrait les sources pour offrir une vue unifiée et orientée métier des données sous-jacentes, afin que les utilisateurs accèdent et analysent rapidement l'information.
Ses principaux composants incluent :
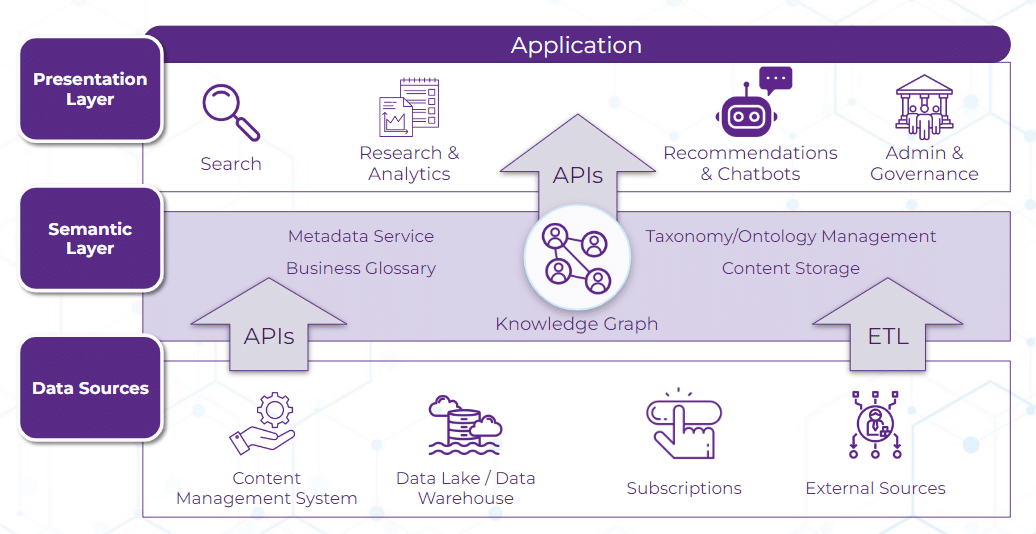
Principaux composants d'une couche sémantique. Source : Enterprise Knowledge
Comprendre comment se construit une couche sémantique est aussi crucial que d'en saisir l'intérêt. Suivez ces étapes pour bâtir une couche efficace offrant une vue cohérente et orientée métier :
Commencez par recenser les exigences et comprendre les besoins précis des utilisateurs finaux. Analystes et experts métier collaborent pour cerner les types de données requis, les questions à traiter et les rapports ou analyses attendus.
Une fois ces besoins formalisés, ils peuvent concevoir une couche sémantique adaptée à l'organisation.
Après la collecte des besoins, les équipes données passent en revue les sources existantes. Elles analysent format et qualité des données stockées, afin de déterminer les préparations et transformations nécessaires avant l'intégration dans la couche sémantique.
Ensuite, elles conçoivent le modèle sémantique à partir des besoins métiers et de l'évaluation des données. Ce modèle représente les entités et relations d'une manière parlante pour les utilisateurs.
Pour garantir évolutivité et extensibilité, elles s'appuient sur des techniques reconnues comme le modèle dimensionnel ou le data vault.
Une fois le modèle défini, les analystes le mettent en œuvre avec les outils appropriés. Ils créent vues, champs calculés, hiérarchies et autres artefacts pour traduire les données brutes dans le modèle, au sein de leur outil de modélisation ou de leur plateforme de business intelligence (BI).
Les équipes établissent des connexions entre couche sémantique et sources via connecteurs ou API, et conçoivent les processus d'extraction et de transformation pour alimenter et préparer les données.
Elles transforment et normalisent les données pour coller au modèle sémantique et veillent à leur synchronisation et actualisation.
Elles testent et valident rigoureusement la couche sémantique pour vérifier son exactitude et son alignement avec les besoins. Pendant cette phase, elles :
Une fois prête, la couche sémantique est déployée en production et mise à disposition des utilisateurs. Des processus de maintenance continue sont instaurés pour surveiller la qualité des données et faire évoluer la couche selon les besoins métiers.
Pour garantir un fonctionnement optimal, ses performances sont revues régulièrement afin d'identifier des axes d'amélioration.
Même si la couche sémantique semble gagnante pour l'organisation, sa mise en œuvre comporte des défis à anticiper avec soin. Parmi eux :
En tenant compte de ces défis, vous maximisez les chances de réussir votre implémentation.
Une couche sémantique améliore l'accessibilité et l'utilisabilité en offrant une vue unifiée de jeux de données complexes. Voici des approches courantes pour la mettre en place.
Cette approche crée une architecture logique centrée sur les métadonnées via la couche sémantique. Elle unifie la vue des données à l'échelle de l'entreprise sans consolidation physique. Les définitions et la gouvernance sont standardisées au niveau global, tout en permettant de décentraliser des composants adaptés à chaque entité métier.
C'est idéal pour concilier standardisation et agilité des unités métiers dans le traitement des données.
Ici, un vocabulaire commun en OML est créé et peut être instancié automatiquement depuis des modèles distribués dans un graphe de connaissances. Cela facilite l'accès, la classification, le contrôle et la réutilisation de services d'information fédérés.
Pour ce type de couche sémantique, on utilise UFO — une ontologie de base avec un vocabulaire partagé pour décrire concepts et relations — particulièrement utile pour intégrer des données de domaines différents.
Approche décentralisée qui s'appuie sur les capacités sémantiques natives des outils et systèmes (CMS, CRM, tableaux de bord BI, etc.) pour gérer les données au niveau des entités métiers, sans cadre d'entreprise unifié.
C'est une bonne option pour les organisations aux unités diverses et autonomes qui doivent s'adapter vite.
Ce modèle consolide les données dans un EDW ou un DL et sert de référence pour les définitions et la logique métier. Il convient aux grandes entreprises avec des exigences complexes et une gouvernance stricte, comme la finance ou la santé.
À l'inverse, il est peu adapté aux petites structures, car il demande des investissements initiaux importants en temps et en ressources.
Choisir le bon outil est clé pour bien gérer et exploiter vos données. Voici quelques outils phares du marché, leurs atouts et la valeur qu'ils peuvent apporter.
| Outil | Fonctionnalités clés | Bénéfices |
|---|---|---|
| Cube.js | Headless BI, modélisation des données, mise en cache, API, analyses en temps réel | La couche sémantique de Cube.js permet l'analytics en temps réel et la visualisation pour une analyse efficace. |
| MetricFlow | Modélisation des données, couche de métriques, mise en cache, API, transformation des données | La couche sémantique de MetricFlow facilite l'intégration avec diverses sources et fournit une vue unifiée. |
| dbt | Transformation des données, couche de métriques, mise en cache, API, modélisation des données | La couche sémantique de dbt offre une vue unifiée en modélisant structures et relations, ce qui simplifie l'analyse et la visualisation de données complexes. |
| Tableau | Visualisation des données, modélisation des données, mise en cache, API | La couche sémantique de Tableau soutient la visualisation, permettant de créer des tableaux de bord et rapports interactifs. |
| Power BI | Visualisation des données, modélisation des données, API, intégration des données | Les capacités d'intégration de Power BI facilitent la connexion à de multiples sources. |
La couche sémantique est un puissant levier de transformation pour toute organisation souhaitant exploiter l'ampleur et la diversité de ses données. Elle favorise des décisions éclairées et élargit l'accès grâce à une approche unifiée.
Elle comporte toutefois des écueils : complexité accrue et enjeux d'évolutivité. Avec une planification rigoureuse, de la formation et des outils adaptés, les équipes données peuvent les maîtriser.
Pour apprendre à valoriser vos données avec des outils comme Power BI, DataCamp propose de nombreuses ressources. Le cours Introduction to Power BI offre d'excellents fondamentaux pour débuter. Pour aller plus loin, explorez le parcours carrière Data Analyst in Power BI, co-créé avec Microsoft.
Enfin, si vous voulez intégrer des technologies avancées, découvrez le cours Implementing AI Solutions in Business pour voir comment l'IA peut être incorporée aux processus afin de stimuler innovation et efficacité.
Apprenez avec DataCamp
Cours
Cours
Cours