Curso
Programación asistida por IA para desarrolladores
1 h 30 min
10.7K
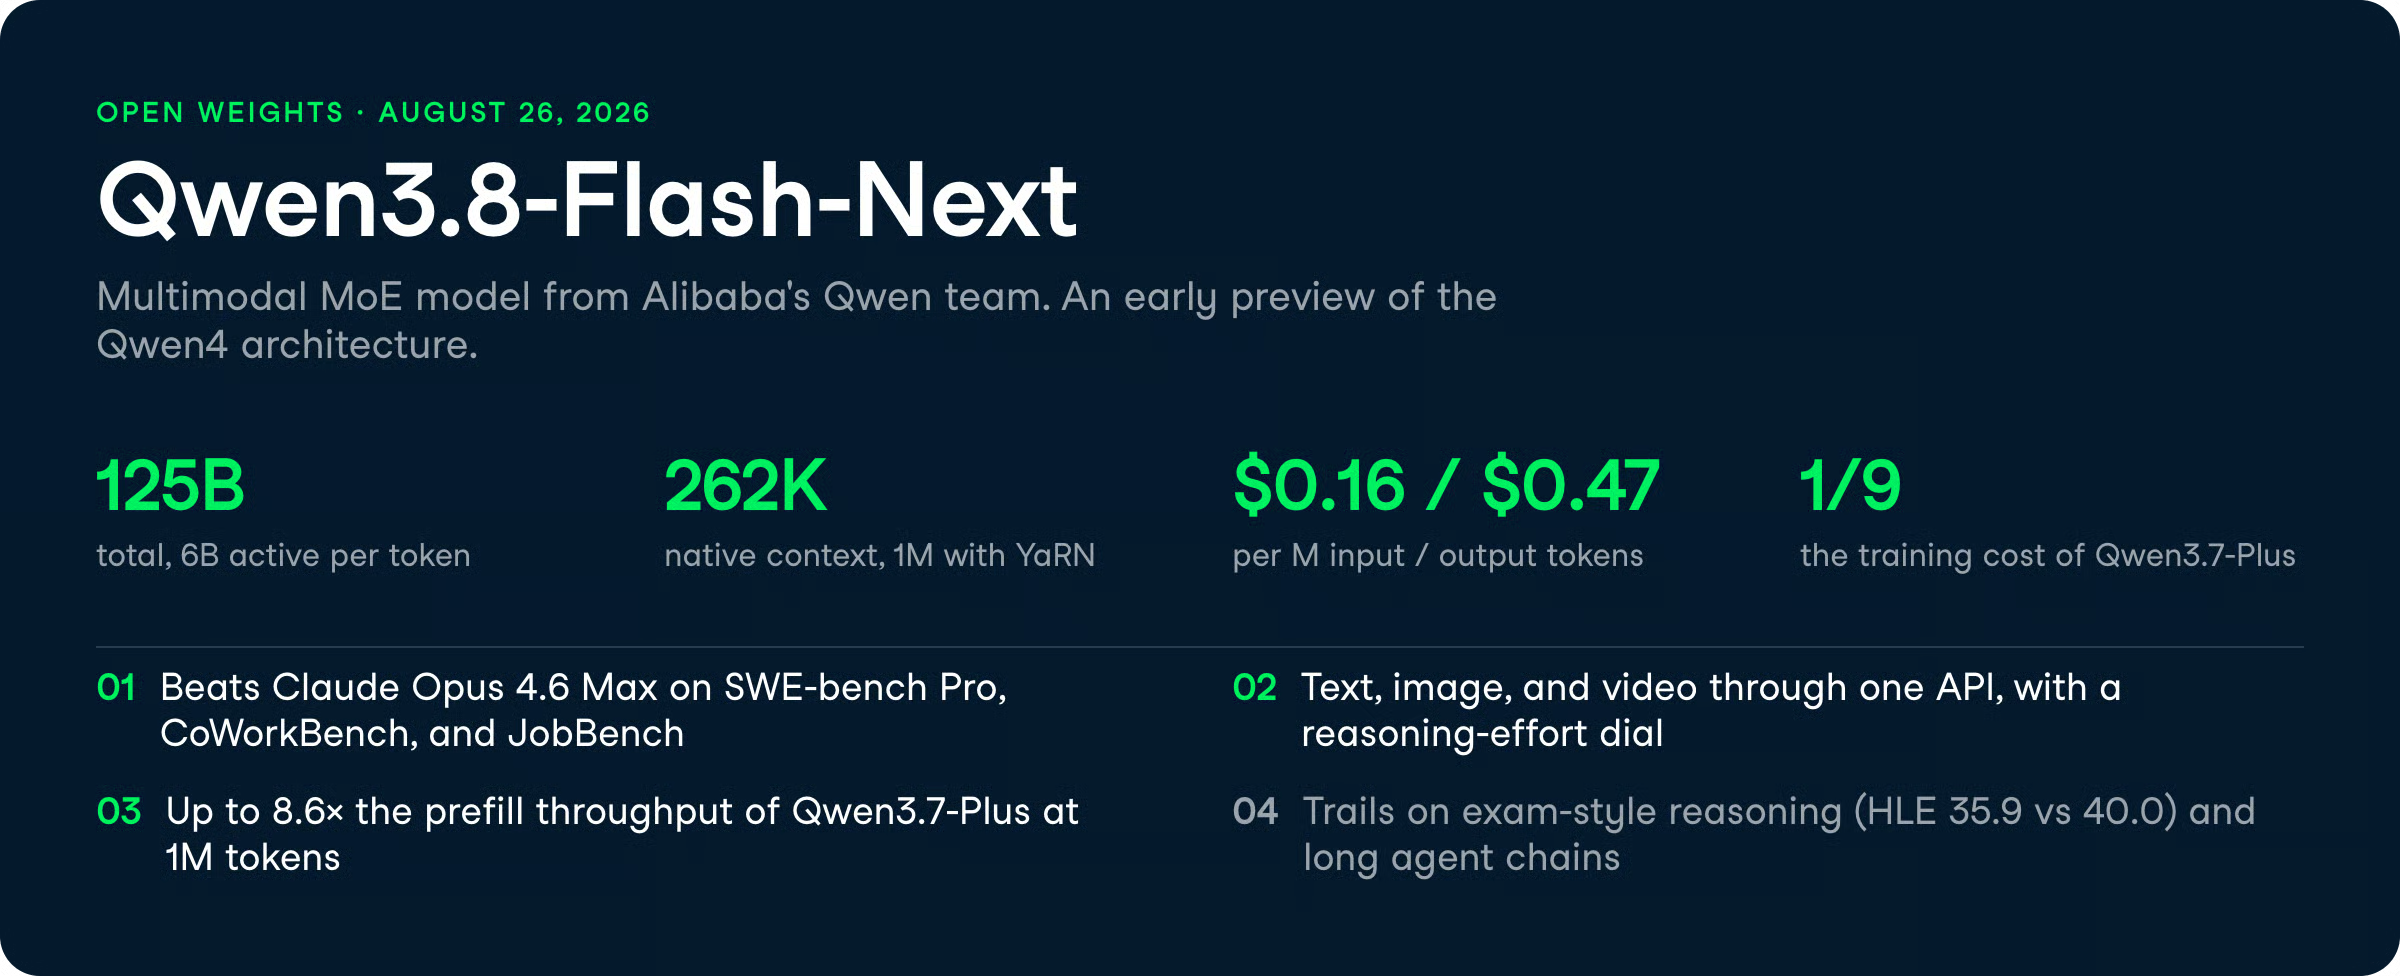
El mismo día del lanzamiento de GLM-5.3 Flash, el equipo Qwen de Alibaba abrió los pesos de Qwen3.8-Flash-Next, un modelo multimodal de mezcla de expertos (MoE) que también sirve como adelanto de la arquitectura que llegará con la familia Qwen4.
Es la misma jugada que Qwen3-Next hizo con Qwen3.5: publicar antes los cambios de arquitectura para que la comunidad pueda analizarlos a fondo antes de lanzar toda la línea.
La gran historia aquí es el coste. Gracias a una nueva arquitectura muy eficiente, entrenar Qwen3.8-Flash-Next costó aproximadamente una novena parte de lo que costó su predecesor, Qwen3.7-Plus. Y no sacrifica potencia para lograrlo; de hecho, supera a pesos pesados como Claude Opus 4.6 Max en pruebas de código clave como SWE-bench.
En este artículo, cubro todas las novedades de Qwen3.8-Flash-Next: su arquitectura y funciones, y un repaso a los benchmarks. Si quieres un paso a paso para descargar y ejecutar el modelo en local, lee nuestro tutorial de Qwen3.8-Flash-Next. Si buscas contexto sobre otros modelos chinos, consulta nuestra guía de Qwen3.8-Max y el tutorial sobre ejecutar DeepSeek-V4-Flash-0731 en local. También te recomiendo echar un vistazo al nuevo lanzamiento de Qwen3.8-Omni-Flash.
Qwen3.8-Flash-Next es un modelo multimodal MoE del equipo Qwen de Alibaba, lanzado el 26 de agosto de 2026, planteado como un caballo de batalla eficiente en costes más que como un buque insignia.
Se sitúa por debajo de los modelos Max en inteligencia, pero recorta el precio frente a casi todo, que es precisamente la propuesta de la gama "Flash".
El modelo admite de forma nativa una ventana de contexto de 262.144 tokens, ampliable a 1.000.000 con YaRN (método [Yet another RoPE extensioN], una técnica de codificación posicional que extiende la ventana de contexto del modelo para manejar entradas de texto masivas manteniendo su rendimiento).
Gestiona texto, imagen y vídeo desde una única API, una de las razones por las que muchos lo llamaron el "favorito de la comunidad de la noche a la mañana" en los resúmenes de lanzamientos de agosto de 2026.
Lo que hace relevante este lanzamiento para quienes lo van a usar en producción es la relación benchmark-por-dólar.
Qwen3.8-Flash-Next supera a su hermano de 27B en todos los benchmarks publicados y mejora a Claude Opus 4.6 Max en la mayoría de evaluaciones de código y agentes, activando solo 6B parámetros por token. Es un adelanto de la arquitectura Qwen4, así que las decisiones de diseño aquí señalan hacia dónde va Alibaba.
Qwen3.8-Flash-Next mejora el modelo en cuatro ejes: atención, residuales, embedding y optimización.
A continuación, explico qué gana realmente el usuario con cada cambio, más allá de la teoría.
La mejora más palpable es la velocidad con entradas largas.
Qwen3.8-Flash-Next usa un diseño híbrido de atención, donde comprime la mayor parte del historial de contexto para ahorrar espacio y emplea una herramienta de "Sparse Attention" dirigida para recuperar solo los detalles más relevantes cuando hace falta.
Las aceleraciones a 1 millón de tokens son enormes: hasta 7,6x más rápido procesando el prompt (prefill) y 4,9x más rápido generando (decode). En un despliegue típico con prefijos en caché, el throughput global sube 8,6x frente a Qwen3.7-Plus.
Para quien ejecute recuperación a gran volumen o agentes de código a escala de repositorios, esa diferencia de throughput es la función clave.
Pagas por cómputo, y este diseño recorta la factura justo en las secuencias largas que antes eran notoriamente caras.
Qwen incorpora un truco interesante llamado N-gram Embedding para sumar 51.000 millones de parámetros prácticamente gratis. En lugar de mirar un único token, tiene en cuenta el token actual y sus vecinos recientes, dando al modelo una gran "memoria de patrones locales".
Como el modelo sabe de antemano qué consultar, esos 51B parámetros extra residen en memoria del sistema (RAM), no en la GPU. Se cargan automáticamente en segundo plano, así que no ocupan VRAM de forma permanente ni aumentan el cómputo por token.
Obtienes la "cabeza" de un modelo mucho mayor sin pagar el peaje habitual en VRAM.
Qwen3.8-Flash-Next maneja texto, imagen y vídeo desde una única interfaz, y su visión rinde muy por encima de su rango de precio.
Supera con holgura a Claude Opus 4.6 Max en pruebas de uso móvil (84,5 vs 62,0 en AndroidWorld) y en comprensión visual del mundo real (88,5 vs 73,9 en RealWorldQA).
También arrasa en matemáticas visuales, con hasta 95,7 en MathVision (muy por delante del 65,5 de Opus).
Si tu flujo implica interpretar capturas, gráficos o interfaces, Qwen ofrece una ventaja real frente a Claude a este precio.
La API te da un control reasoning effort con tres niveles (alto, medio y bajo), para intercambiar profundidad de razonamiento por menor latencia y coste.
El modelo también integra un módulo de predicción multi-token, que básicamente anticipa varios pasos para acelerar la generación en cargas reales.
La consecuencia práctica es el control.
Puedes bajar el razonamiento para tráfico masivo sensible a costes y subirlo en tareas agentivas complejas, usando el mismo ID de modelo.
En los datos publicados, Qwen3.8-Flash-Next lidera en la mayoría de benchmarks de código y agentes, aunque queda por detrás en algunas evaluaciones de razonamiento tipo examen.
Supera a su hermano de 27B en todo, con las mayores diferencias en trabajo agentivo.
Todas las comparaciones siguientes provienen de la tabla oficial del lanzamiento de Qwen salvo que se indique lo contrario.
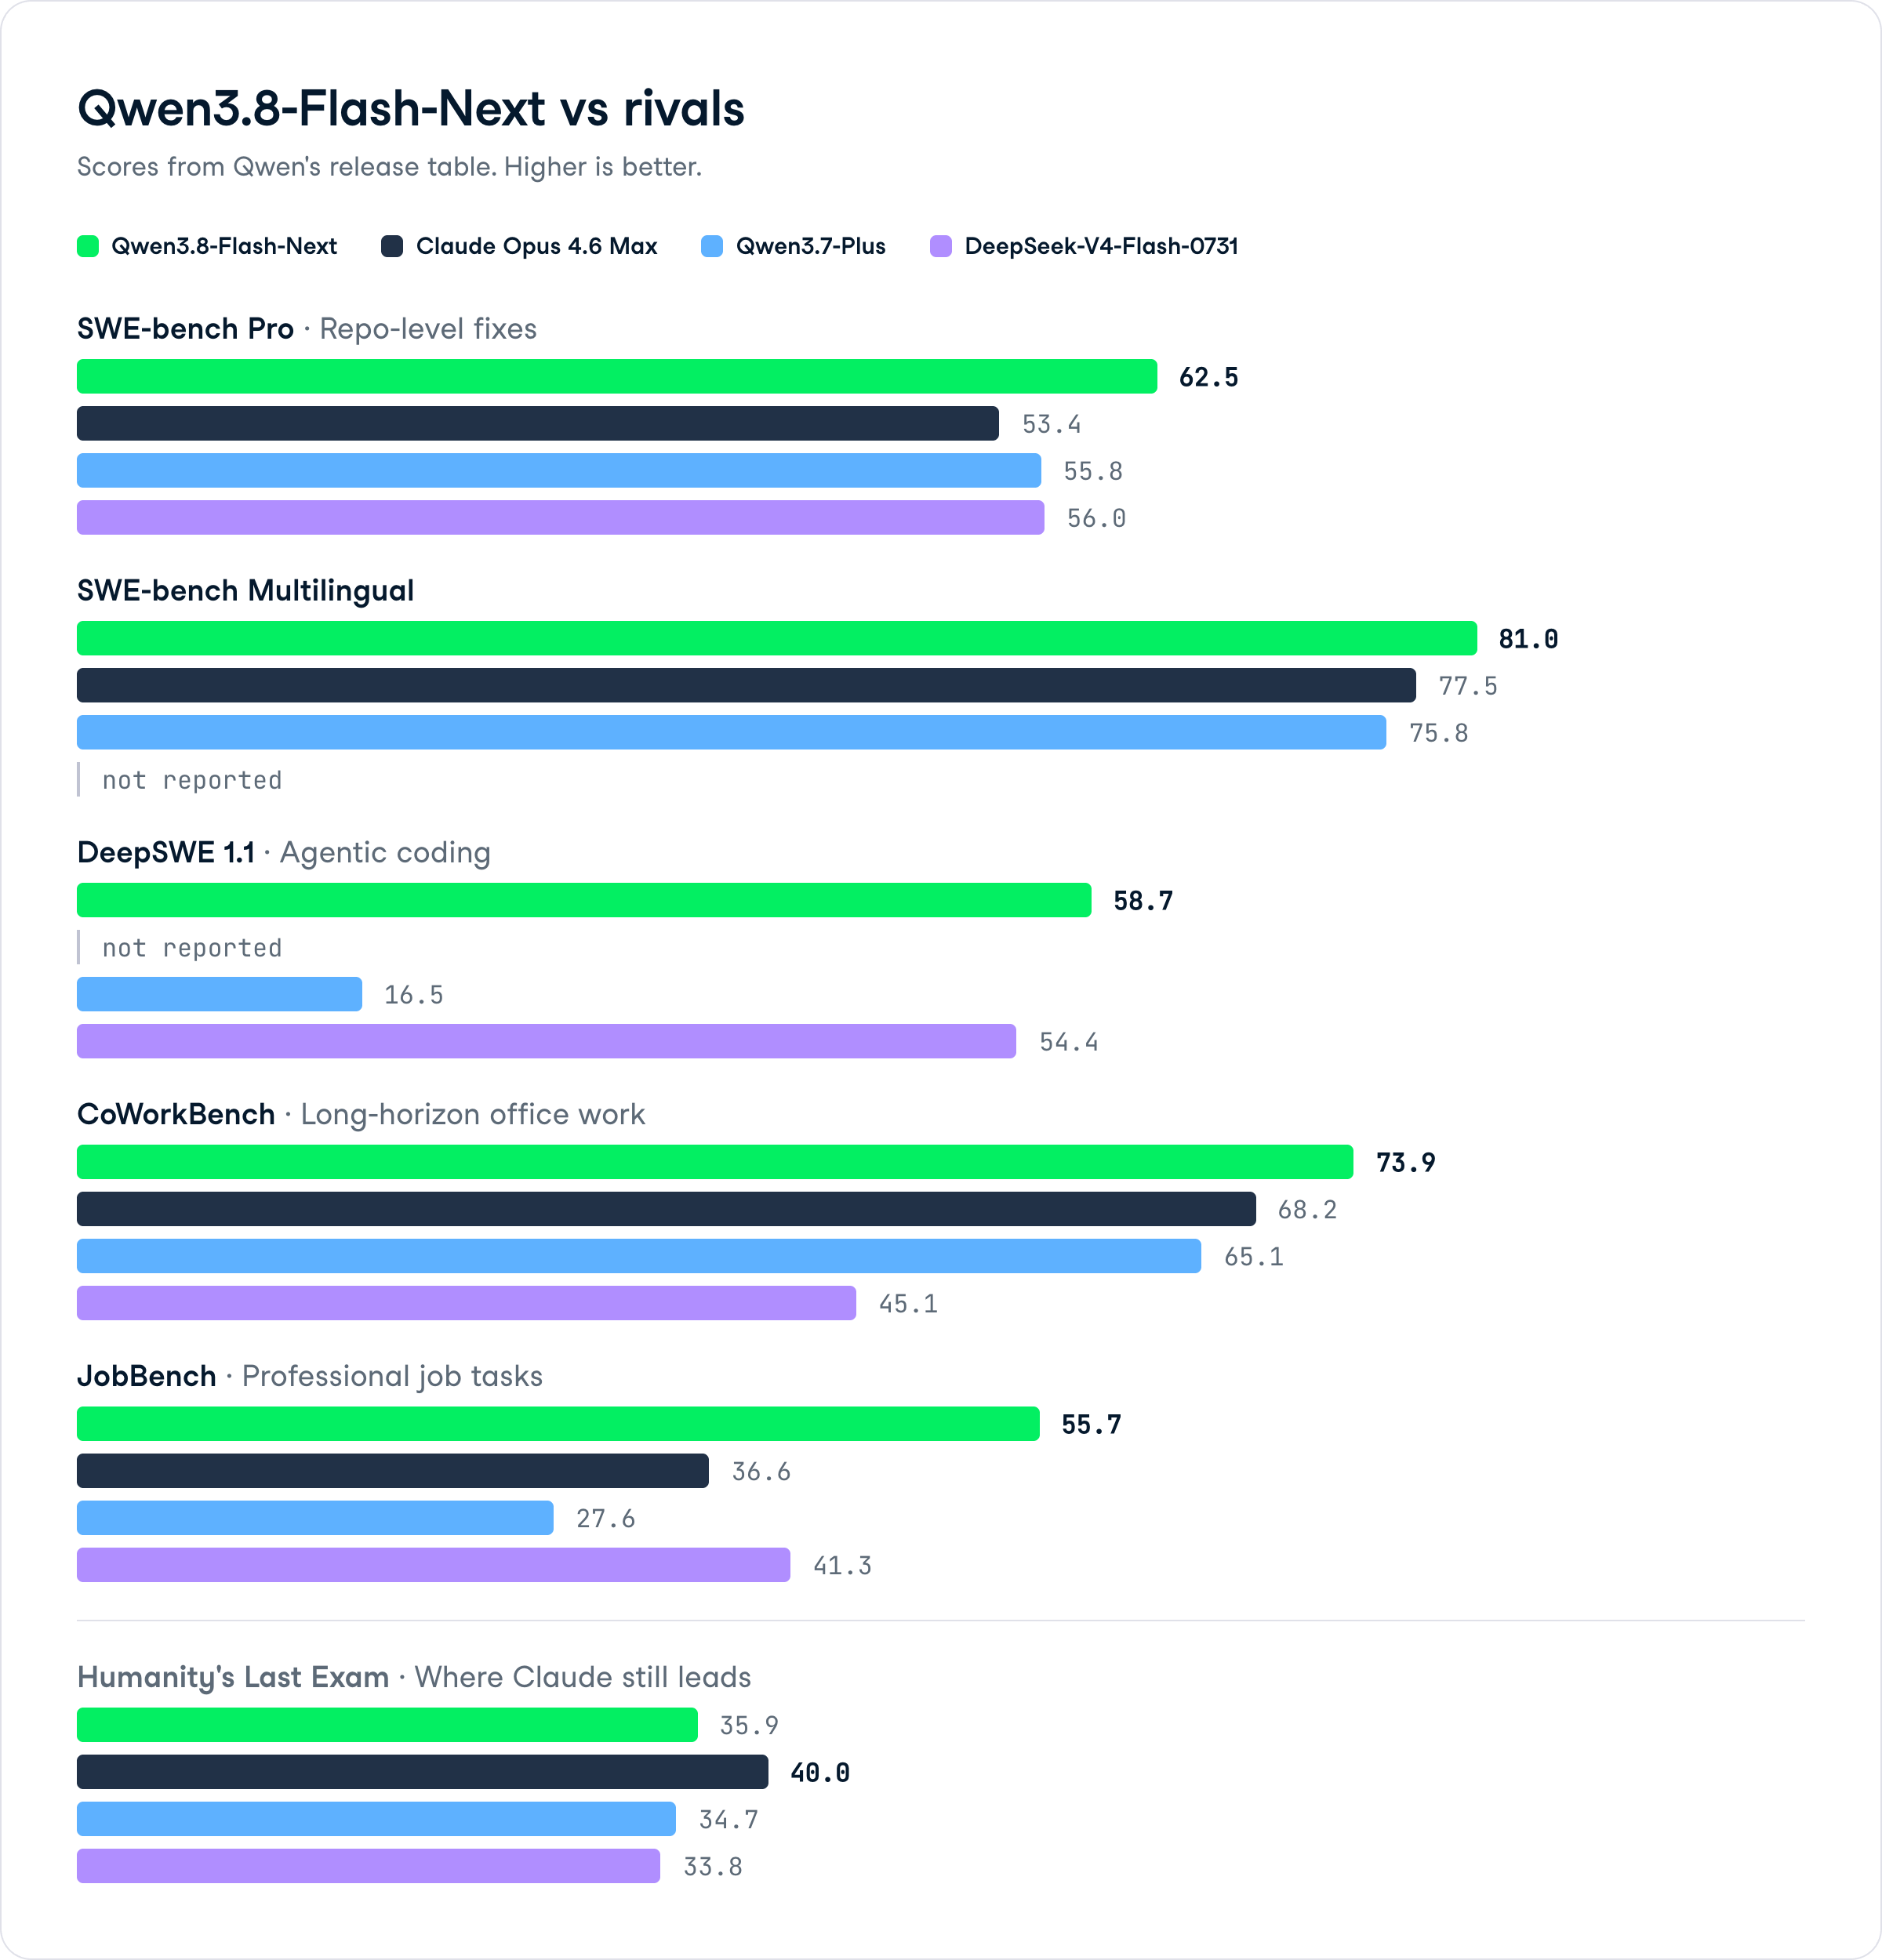
SWE-bench Pro mide correcciones reales a nivel de repositorio, y Qwen3.8-Flash-Next logra 62,5, por delante del 53,4 de Claude Opus 4.6 Max y del 55,8 de Qwen3.7-Plus.
En SWE-bench Multilingual, que evalúa correcciones en varios idiomas, alcanza 81,0 frente al 77,5 de Opus 4.6 Max.
Estos son los números que sostienen el lanzamiento.
Que un modelo con 6B activos supere a un Claude de gama Max en ingeniería a nivel de repos es la razón de tanto revuelo.
DeepSWE 1.1 evalúa codificación agentiva con arneses como Claude Code y mini-SWE-agent, y Qwen3.8-Flash-Next marca 58,7 frente a los 42,2 de su hermano de 27B y los 16,5 de Qwen3.7-Plus.
DeepSeek-V4-Flash-0731 se queda en 54,4 aquí.
Cuando ejecutamos DeepSeek-V4-Flash-0731 como agente de código en nuestro tutorial, construyó una web completa de analítica bursátil desde un único prompt en unos 20 minutos, generando chat a ~33 tokens por segundo.
La diferencia en DeepSWE entre ambos modelos sugiere que Qwen3.8-Flash-Next debería aguantar bien en bucles de codificación agentiva similares.
En la vertiente de agentes, el modelo firma números sólidos en varias evaluaciones:
La brecha en JobBench destaca.
En tareas de flujo de trabajo profesional, Qwen3.8-Flash-Next saca casi 20 puntos a un Claude de nivel Max, un resultado que merece una prueba para automatización empresarial.
En razonamiento general, Qwen3.8-Flash-Next llega a 91,7 en GPQA Diamond (razonamiento científico), ligeramente por encima del 91,3 de Claude Opus 4.6 Max, y 91,9 en LiveCodeBench v6 (codeo competitivo) frente al 88,8 de Opus 4.6 Max.
No gana en todo, eso sí.
En Humanity's Last Exam (HLE), que evalúa razonamiento multidisciplinar, puntúa 35,9 frente al 40,0 de Claude Opus 4.6 Max. En Agents' Last Exam Pass@1, DeepSeek-V4-Flash-0731 lo supera 25,2 a 24,3.
El patrón se repite en seguimientos independientes: Qwen3.8-Flash-Next lidera en código práctico y trabajo con agentes, mientras que Claude mantiene ventaja en algunos benchmarks tipo examen.
Qwen3.8-Flash-Next-Base gana 8 de 14 benchmarks de preentrenamiento frente a los modelos base de Qwen3.8-27B y el mucho mayor Qwen3.7-Plus.
Lidera en MMLU-Pro (73,23), SuperGPQA (51,36), BBH (90,87), GSM8K (93,29), EvalPlus (78,76), SWEBench-Pretrain (50,99), MGSM (89,33) y MMMLU (84,86).
Lo llamativo es que lo hace con 6B parámetros activados frente a los 17B activos y 397B totales de Qwen3.7-Plus, y se queda a menos de un punto en MMLU, MMLU-Redux, GPQA, MATH y MultiPL-E.
Los 51B parámetros de N-gram embedding se direccionan de forma determinista y nunca entran en el coste de matmul por token, así que es eficiencia real y no un truco de conteo de parámetros.
Así queda el modelo frente a Claude Opus 4.6 Max, su predecesor Qwen3.7-Plus y DeepSeek-V4-Flash-0731 en las evaluaciones principales.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62,5 | 53,4 | 55,8 | 56,0 |
| SWE-bench Multilingual | 81,0 | 77,5 | 75,8 | -- |
| DeepSWE 1.1 | 58,7 | -- | 16,5 | 54,4 |
| CoWorkBench | 73,9 | 68,2 | 65,1 | 45,1 |
| JobBench | 55,7 | 36,6 | 27,6 | 41,3 |
| GPQA Diamond | 91,7 | 91,3 | 90,3 | 90,8 |
| LiveCodeBench v6 | 91,9 | 88,8 | 89,6 | 90,6 |
| HLE | 35,9 | 40,0 | 34,7 | 33,8 |
Los pesos de Qwen3.8-Flash-Next están disponibles ya como modelo de pesos abiertos en Hugging Face y ModelScope.
La versión de producción, con 1M de contexto por defecto y herramientas integradas, se sirve como Qwen3.8-Flash en QwenCloud con el ID de modelo qwen3.8-flash.
El precio es donde este modelo compite más fuerte:
Como referencia, en nuestra cobertura de Qwen3.8-Max ese modelo figura a $2,00 de entrada y $6,00 de salida por millón de tokens, así que Flash-Next recorta más de 10x el precio de entrada respecto a su hermano Max.
QwenCloud es compatible con las APIs de Chat Completions y Responses de OpenAI y con una interfaz compatible con Anthropic, así que se integra en Claude Code, Codex y Qwen Code con cambios mínimos de configuración.
Ten en cuenta que en el anuncio el acceso por API aparecía como "próximamente"; consulta QwenCloud para confirmar disponibilidad en tiempo real.
GLM-5.3-Flash es el otro modelo económico que se lanzó el mismo día y es el rival más directo para comparar en paralelo.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Arquitectura | 125B totales / 6B activos | 320B totales / 18B activos |
| Contexto nativo | 262K (1M con YaRN) | 1M tokens |
| DeepSWE v1.1 | 58,7 | 63,4 |
| SWE-bench Pro | 62,5 | No publicado |
| Precio de entrada | $0,16/1M | ~$0,075/1M (promo) |
| Multimodal | Sí | Sí |
GLM-5.3-Flash lidera en DeepSWE v1.1 (63,4 vs 58,7) y marca 84,3 en Terminal-Bench 2.1, un benchmark para el que Qwen no publica cifras.
También ofrece un precio de entrada más bajo durante su ventana promocional y una ventana de 1M tokens de forma nativa, sin necesidad de YaRN.
Qwen3.8-Flash-Next lidera en SWE-bench Pro (62,5), CoWorkBench (73,9) y JobBench (55,7), donde GLM no publica números equivalentes. Qwen además activa muchos menos parámetros por token (6B vs 18B), lo que lo hace sensiblemente más barato de autoalojar y más rápido de servir a escala.
En resumen, GLM muestra mejores cifras publicadas en los benchmarks que ambos comparten directamente. Qwen lidera en evaluaciones de oficina y flujo profesional, y es la mejor opción si gestionas tu propia infraestructura. Para un análisis completo de GLM-5.3-Flash, consulta nuestra guía.
Qwen3.8-Flash-Next es la forma en la que Alibaba deja claro que la batalla está en la eficiencia de costes.
Superar a Claude Opus 4.6 Max en SWE-bench Pro, CoWorkBench y JobBench con 6B parámetros activos, a $0,16 por millón de tokens de entrada, es una propuesta muy seria para quien ejecute cargas de trabajo de código o agentes a gran volumen.
Yo lo trataría como un valor por defecto sólido para pipelines con herramientas y mucho código, con dos matices.
La comunidad señala inestabilidad ocasional en cadenas agentivas muy largas y fragilidad cuando las herramientas devuelven JSON no estándar, y el modelo es menos conservador en seguridad que la serie Claude, por lo que requiere prompts cuidadosos en contenidos límite.
Los resultados en HLE y Agents' Last Exam también muestran que no es el modelo al que acudir para el razonamiento tipo examen más difícil.
Como adelanto de la arquitectura Qwen4, el híbrido GDN + QSA y los N-gram Embeddings son diseños a vigilar, porque serán la base de toda la familia Qwen4.
Si Alibaba mantiene esta relación benchmark-por-dólar en la gama flagship, la conversación sobre precios en la frontera cambiará.
Si quieres construir flujos agentivos y de código con modelos como este, te recomiendo empezar por nuestro itinerario de aprendizaje AI Agent Fundamentals para ponerte al día con los conceptos clave.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
15 min