Curso
Programación asistida por IA para desarrolladores
1 h 30 min
9.9K
Qwen3.6-27B se ha vuelto una opción popular para ejecutar en local un modelo capaz de razonar y programar. Es rápido y potente, pero un modelo completo de 27 mil millones de parámetros sigue requiriendo bastante memoria.
Usar cuantización convencional puede reducir esos requisitos, aunque a costa de una degradación de rendimiento que puede notarse.
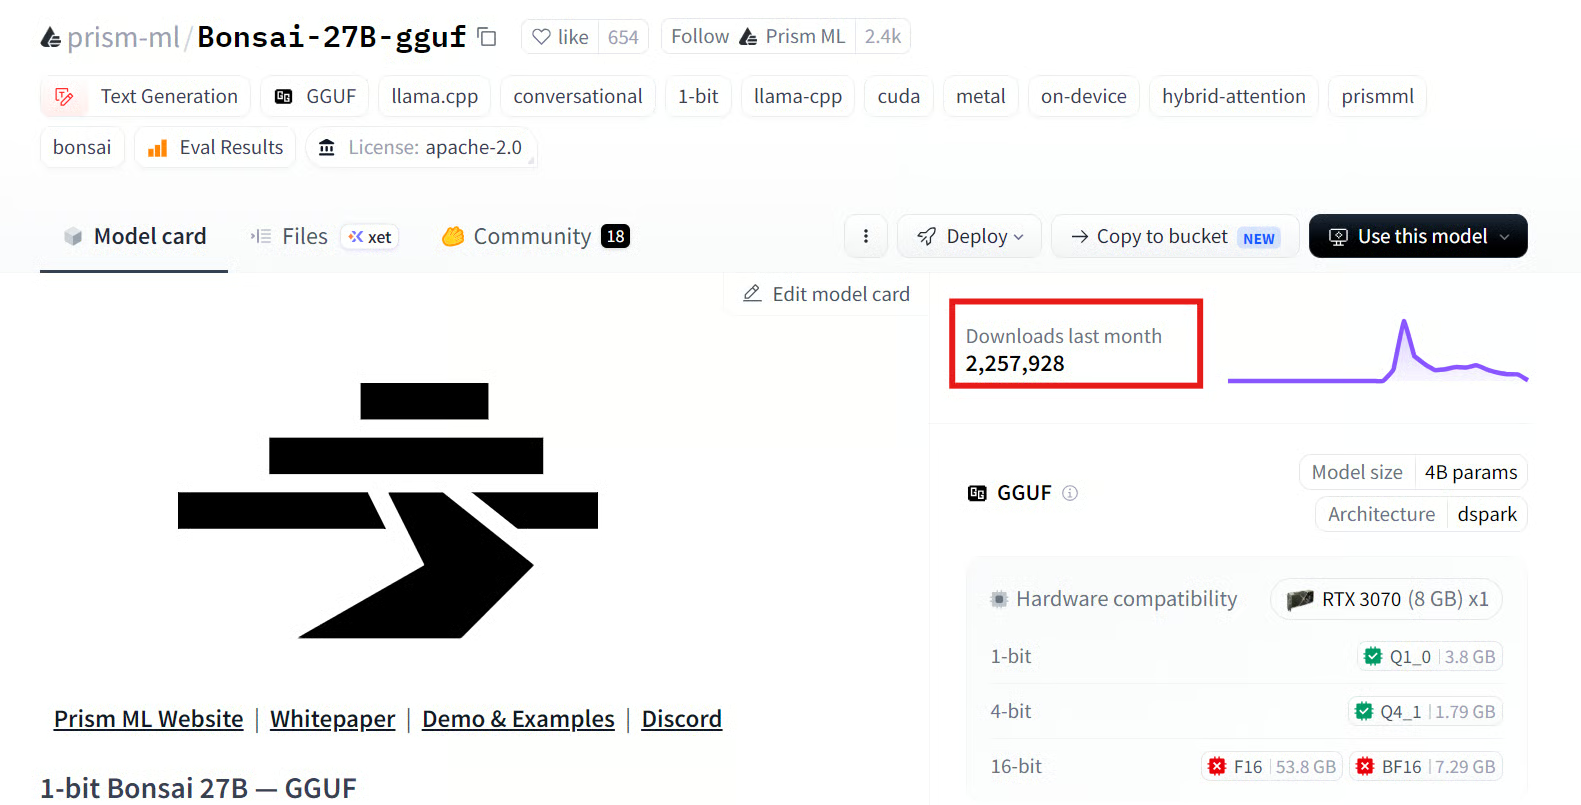
Fuente: prism-ml/Bonsai-27B-gguf
Prism ML abordó este problema de otra forma con Bonsai 27B, una versión de 1 bit muy comprimida de Qwen3.6-27B.
Según Prism ML, Bonsai conserva casi el 90% del rendimiento en benchmarks del modelo original y reduce los pesos a aproximadamente 3,9 GB.
Esto hace posible experimentar con un modelo de razonamiento de clase 27B en hardware de consumo mucho más accesible.
En este tutorial, usaré el modelo de 1 bit Bonsai-27B-Q1_0.gguf y el script de configuración personalizado de Prism ML. El script descarga el modelo automáticamente, selecciona un runtime precompilado compatible y lo ajusta al hardware disponible.
Después probaré Bonsai desde la línea de comandos, abriré su interfaz web local, accederé mediante una API compatible con OpenAI y lo conectaré con el agente de programación Pi.
Lo interesante de Bonsai 27B es que no es simplemente otro Qwen cuantizado de forma convencional.
La mayoría de los modelos GGUF locales se comprimen tras el entrenamiento reduciendo la precisión numérica de un modelo existente.
Bonsai adopta un enfoque más agresivo al adaptar el modelo a pesos binarios, lo que permite que gran parte de la red opere con valores cercanos a −1 o +1.
Esto importa porque ejecutar modelos de lenguaje grandes suele estar limitado por la capacidad y el ancho de banda de memoria, más que por la potencia de cómputo en bruto.
Reducir la precisión de los pesos disminuye la cantidad de datos que hay que almacenar y mover durante la inferencia.
Con un runtime optimizado, esto puede hacer que un gran modelo de 27B sea práctico en hardware de consumo que normalmente tendría problemas para cargarlo o ejecutarlo.
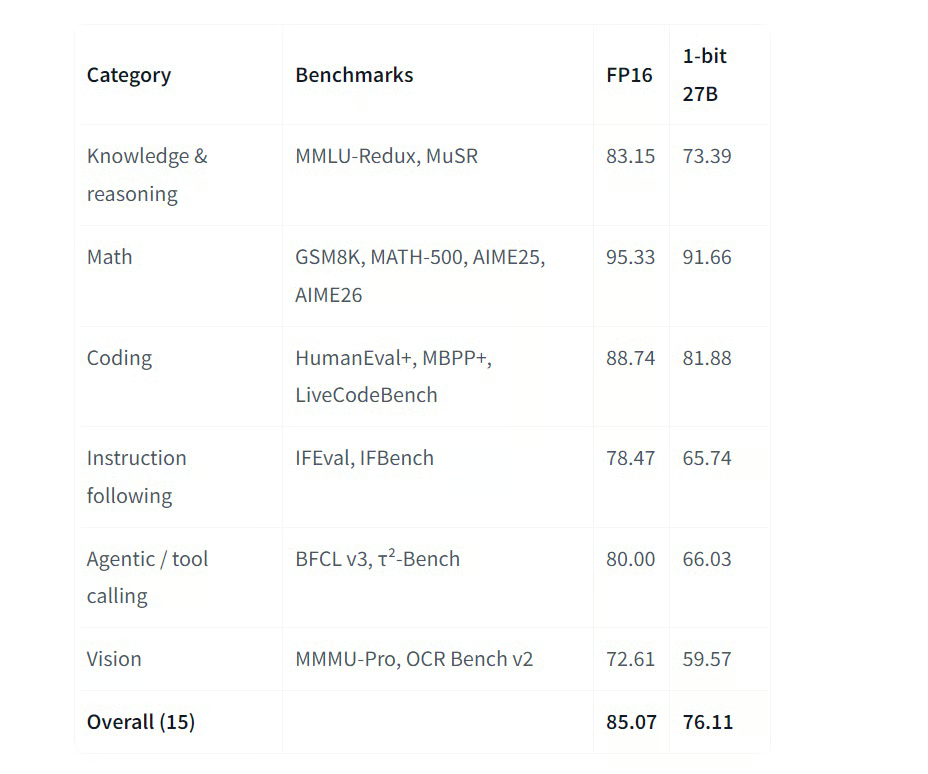
Fuente: prism-ml/Bonsai-27B-gguf · Hugging Face
Bonsai también mantiene capacidades que van más allá del chat básico.
Es compatible con razonamiento, programación, llamadas a herramientas estructuradas, prompts de contexto largo y flujos agentivos.
También puede funcionar detrás de una API compatible con OpenAI, lo que facilita la conexión con agentes de código, sistemas de recuperación, herramientas de automatización y aplicaciones que ya soportan endpoints al estilo OpenAI.
No obstante, no conviene tratar Bonsai como idéntico al modelo Qwen3.6-27B de precisión completa.
Una compresión tan extrema implica concesiones y puede afectar de forma distinta, según la tarea, al seguimiento de instrucciones, la selección de herramientas, la consistencia del razonamiento y la calidad del resultado.
Su gran ventaja es el equilibrio que ofrece: capacidades de modelo grande con requisitos de hardware mucho más bajos.
Antes de empezar, asegúrate de que tu sistema tiene:
Una GPU dedicada es opcional porque Bonsai también puede ejecutarse en CPU.
Eso sí, la inferencia en CPU suele ser más lenta, especialmente cuando el modelo genera respuestas de razonamiento largas.
Para esta guía, uso una sola NVIDIA RTX 5070 Ti con 16 GB de VRAM.
Esto aporta memoria suficiente para cargar los pesos del modelo, de unos 3,9 GB, íntegramente en la GPU y deja memoria adicional para la caché KV, activaciones y la sobrecarga del runtime.
Ahora bien, la VRAM disponible también determina cuánto contexto puedes usar.
Aunque Bonsai 27B admite conversaciones de más de 256K tokens, cargar todo su contexto de entrenamiento puede consumir mucha memoria adicional y agotar sistemas con poca RAM o VRAM.
Por ello, Prism ML usa un tamaño de contexto predeterminado consciente de la memoria en lugar de asignar automáticamente la ventana completa de 262K tokens.
En este tutorial, empezaremos con una ventana de contexto de 8.192 tokens para pruebas en la línea de comandos. Luego la ampliaremos al iniciar el servidor, según la memoria disponible.
Una ventana de contexto menor basta para la mayoría de tareas de programación y chat, y ofrece un arranque más rápido con menor uso de memoria.
Abre una terminal y clona el repositorio oficial de demostración de Bonsai:
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
El repositorio incluye scripts para descargar el modelo, detectar tu hardware, seleccionar el binario de runtime correcto, ejecutar el modelo desde la terminal y lanzar un servidor local.
Ejecuta el siguiente comando de configuración:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_OPENWEBUI=0 \
BONSAI_CODE_INTERPRETER=0 \
./setup.sh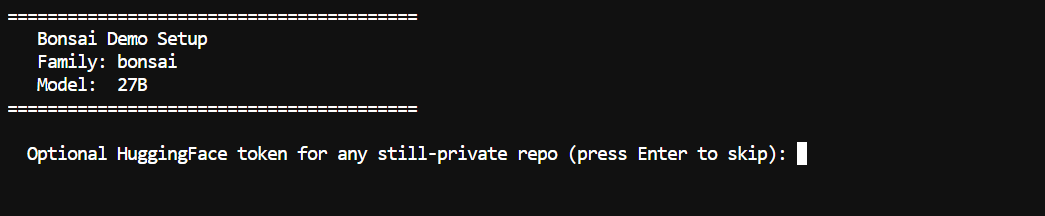
Durante la configuración, puede que se te pida introducir un token de acceso de Hugging Face.
Es opcional para archivos públicos del modelo, así que puedes omitirlo pulsando Enter.
Aun así, usar un token puede ayudar a evitar límites de descarga anónima.

El script descarga aproximadamente 7,15 GB de archivos, entre ellos:
Bonsai-27B-Q1_0.ggufmmproj)Ajustar BONSAI_FAMILY=bonsai selecciona el modelo Bonsai compacto de 1 bit en lugar de la versión ternaria más grande.
Las siguientes opciones deshabilitan dos entornos adicionales:
BONSAI_OPENWEBUI=0
BONSAI_CODE_INTERPRETER=0
Open WebUI no es necesario para este tutorial porque el binario del servidor incluido ya proporciona una interfaz de chat ligera en el navegador.
El entorno de code-interpreter tampoco es necesario para la configuración local básica.
Durante la instalación, el script de setup automáticamente:
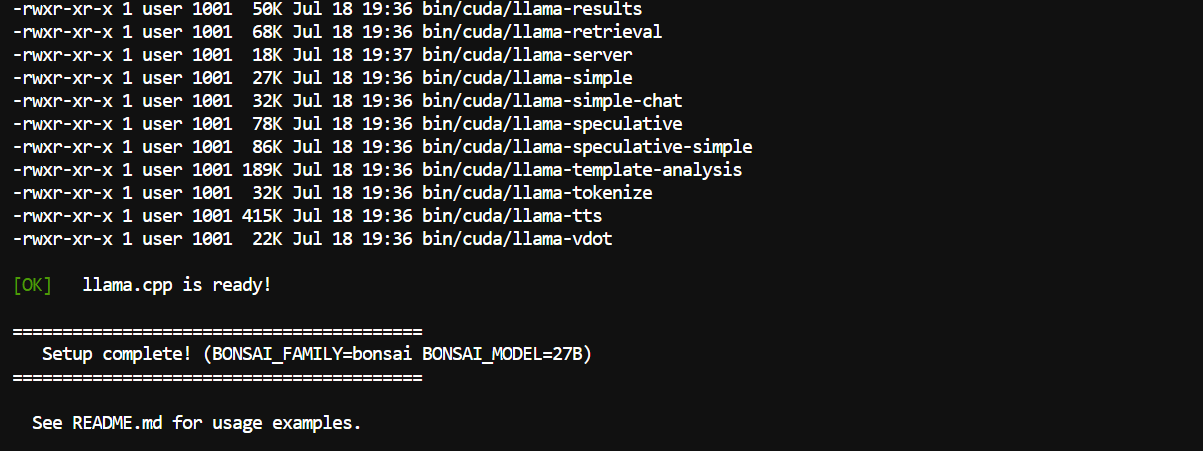
Esta configuración automática es especialmente útil porque no necesitas compilar manualmente llama.cpp ni seleccionar por tu cuenta un binario de CUDA, ROCm, Vulkan, Metal o CPU.
Te recomiendo el tutorial de llama.cpp si necesitas un repaso rápido.
Tras la instalación, prueba el modelo directamente desde la terminal usando la interfaz de línea de comandos de llama.cpp incluida:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_CTX=8192 \
./scripts/run_llama.sh \
-p "Create a simple Python function that calculates compound interest."
Este comando:
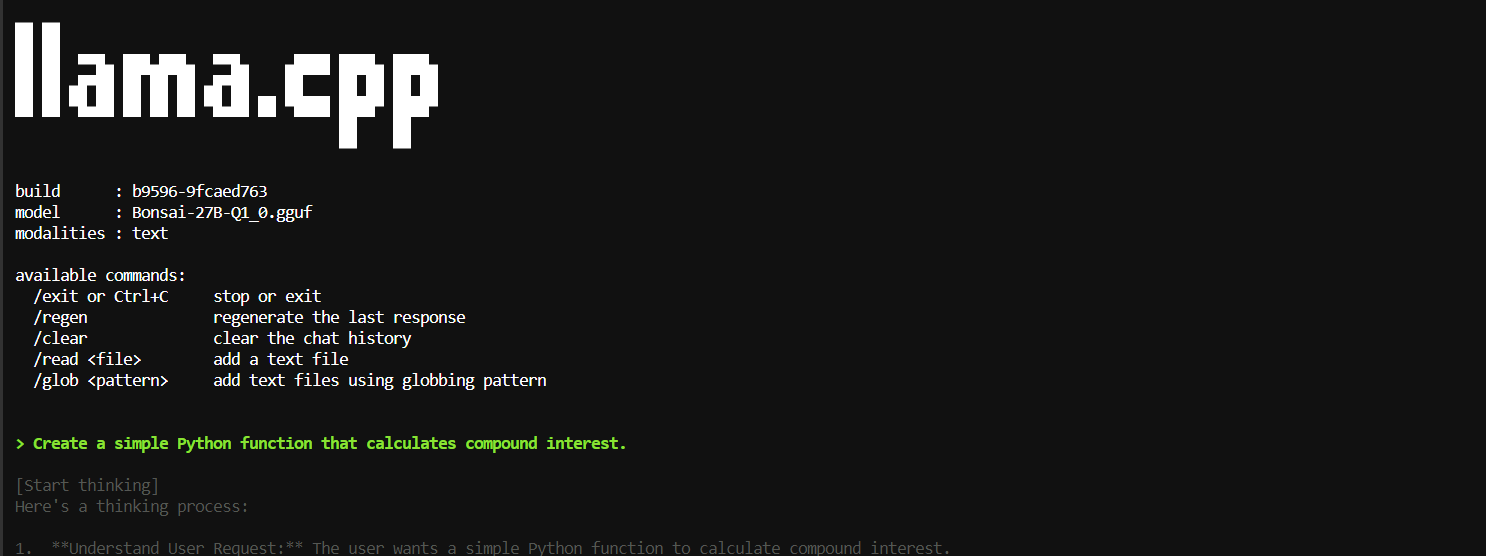
El primer arranque puede tardar unos instantes mientras el modelo se carga en la memoria del sistema o en la VRAM de la GPU.
Cuando esté listo, la terminal muestra el modelo activo, la información de compilación y los comandos disponibles antes de generar la respuesta.
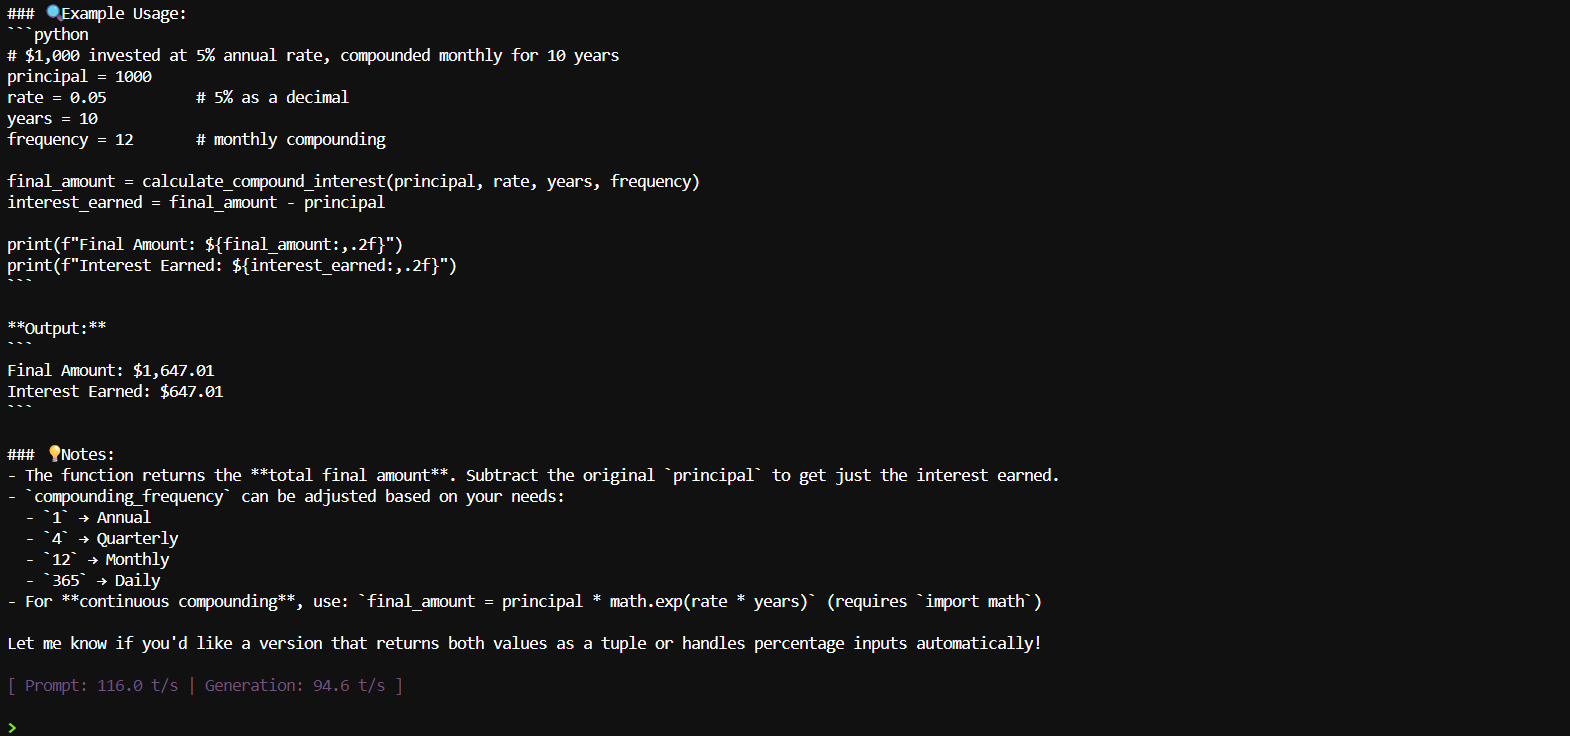
Como se ve en la salida, Bonsai primero produce su proceso de razonamiento y luego genera un ejemplo completo en Python, incluyendo la función, instrucciones de uso y el resultado calculado.
Tras la primera respuesta, la sesión permanece abierta, de modo que puedes introducir más prompts sin reiniciar el modelo.
Primero, pulsa Ctrl+C para cerrar la sesión interactiva del paso anterior.
Luego inicia el servidor local de Bonsai:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_CTX=100000 \
./scripts/start_llama_server.sh \
--alias bonsai-27b \
--host 0.0.0.0 \
--port 8910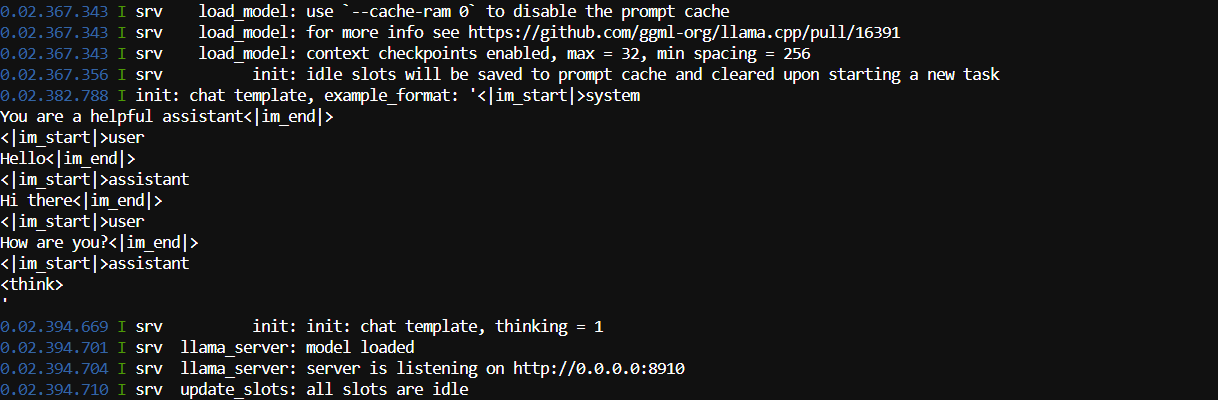
Este comando:
bonsai-27bUna ventana de 100.000 tokens requiere mucha más memoria que la prueba anterior de 8.192 tokens en CLI. Reduce BONSAI_CTX si el modelo no arranca o tu sistema se queda sin RAM o VRAM.
Como --host 0.0.0.0 expone el servidor a tu red local, evita usarlo en redes no confiables. Para acceso solo local, sustitúyelo por:
--host 127.0.0.1Mantén esta terminal abierta mientras uses el modelo. Si la cierras, el servidor se detendrá.
El servidor de Bonsai ofrece:
La API compatible con OpenAI está disponible en:
http://127.0.0.1:8910/v1Abre una segunda terminal y envía una solicitud al endpoint de chat-completions:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "bonsai-27b",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function for loading and validating a CSV file."
      }
    ],
    "max_tokens": 1000
  }'
La solicitud usa la misma estructura que la API de OpenAI Chat Completions:
model selecciona el alias del servidor que creaste antesmessages contiene la conversaciónmax_tokens limita el número de tokens generadosLa API devolvió JSON a unas 95 tokens por segundo, pero la respuesta se detuvo en el límite de 1.000 tokens; aumenta "max_tokens" a 3000 para obtener una respuesta completa antes de conectar Bonsai con aplicaciones, agentes o programas en Python.
Abre esta dirección en tu navegador:
http://127.0.0.1:8910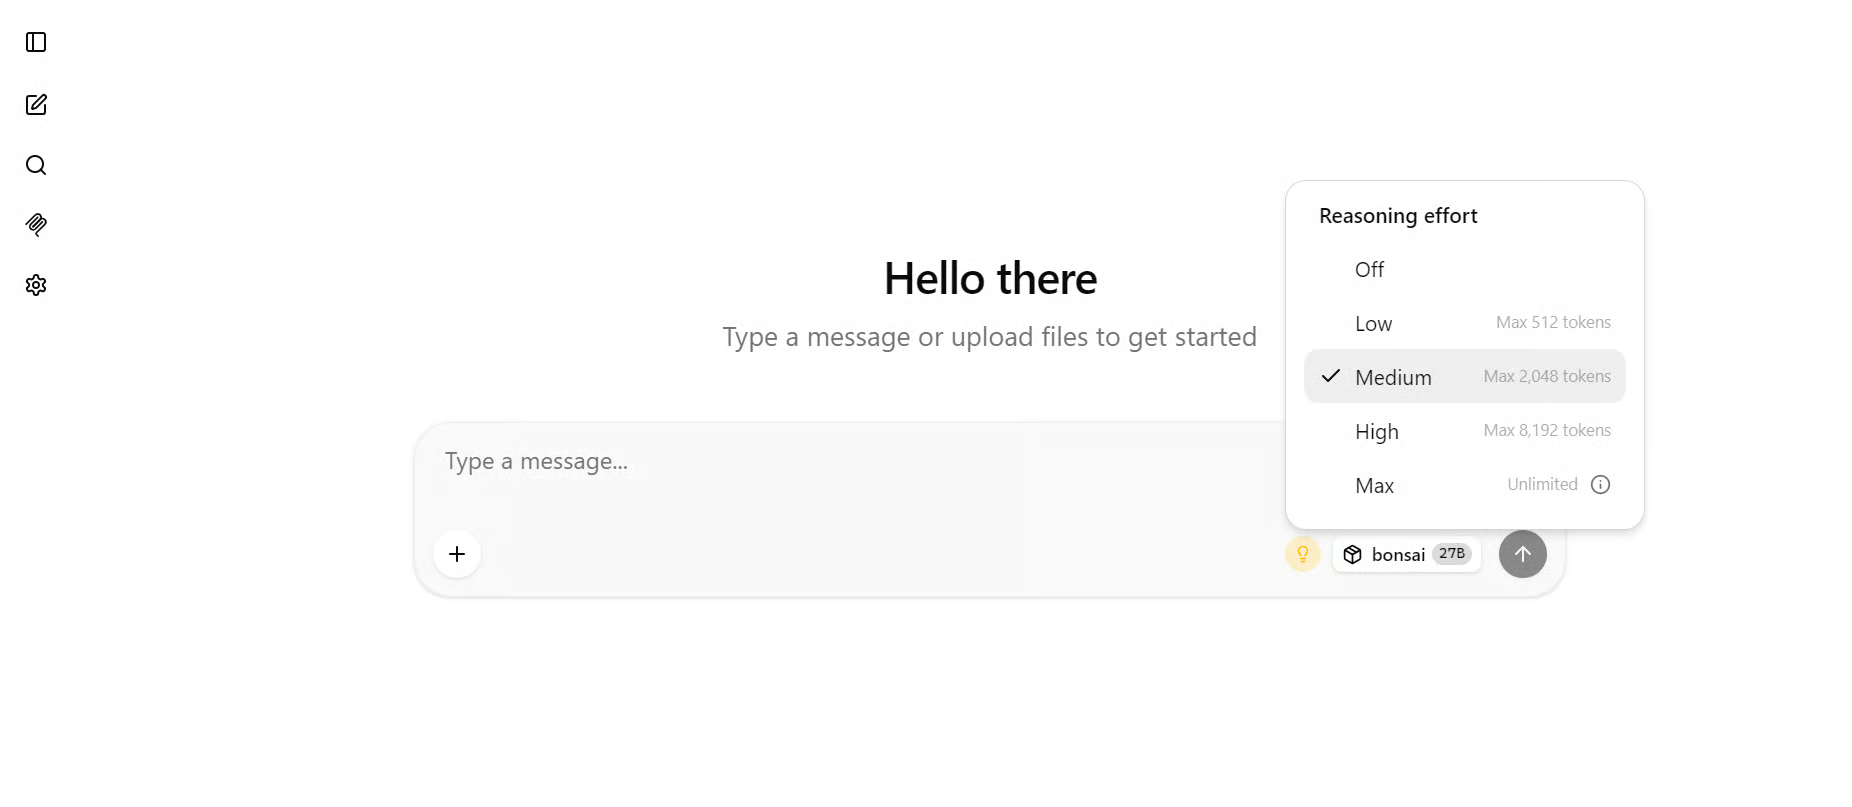
La interfaz integrada de llama.cpp te permite chatear con Bonsai, subir archivos y ajustar el esfuerzo de razonamiento de Off a Max.
Pruébalo con un prompt de código como:
Create a Python command-line application that converts CSV files to JSON.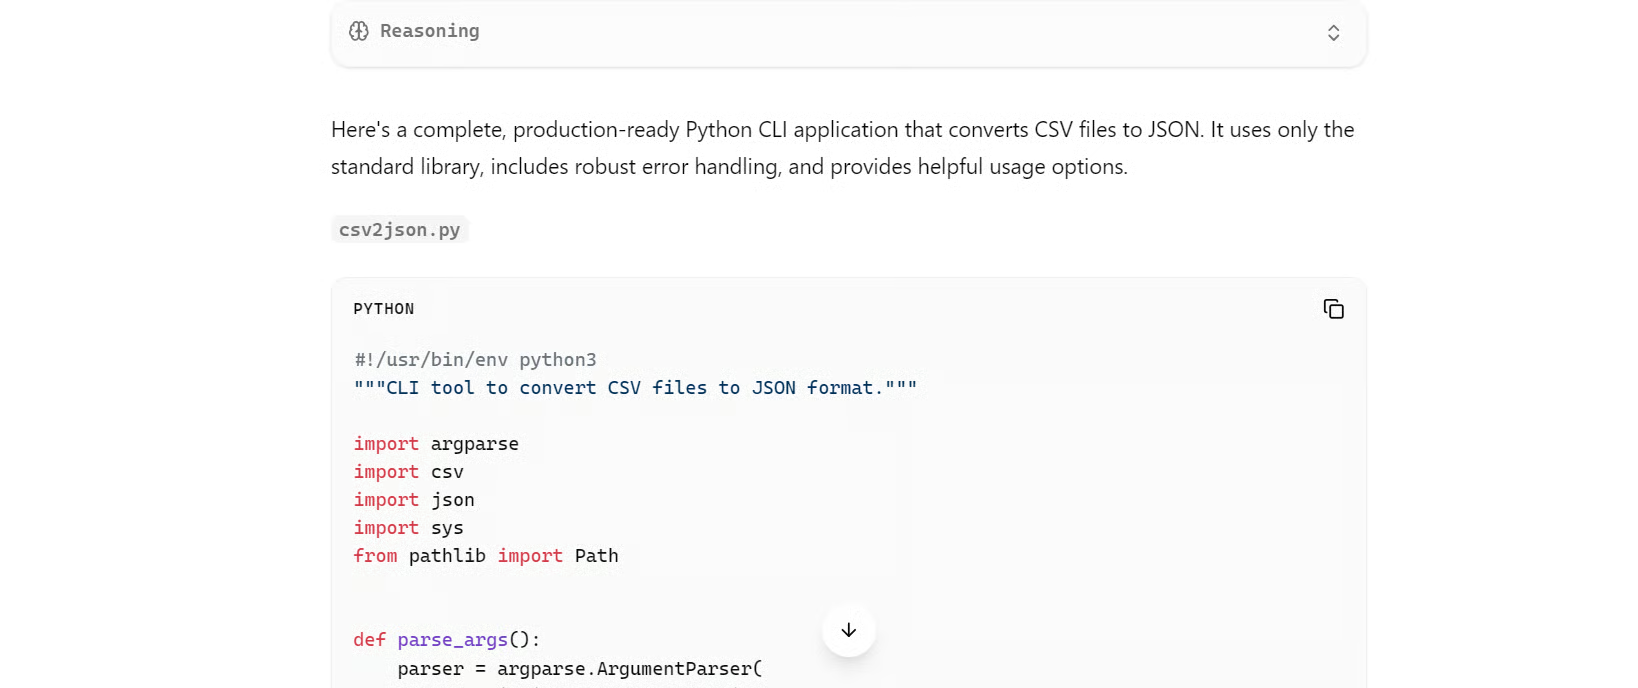
Bonsai generó un script completo en Python a unas 92 tokens por segundo en mi RTX 5070 Ti.
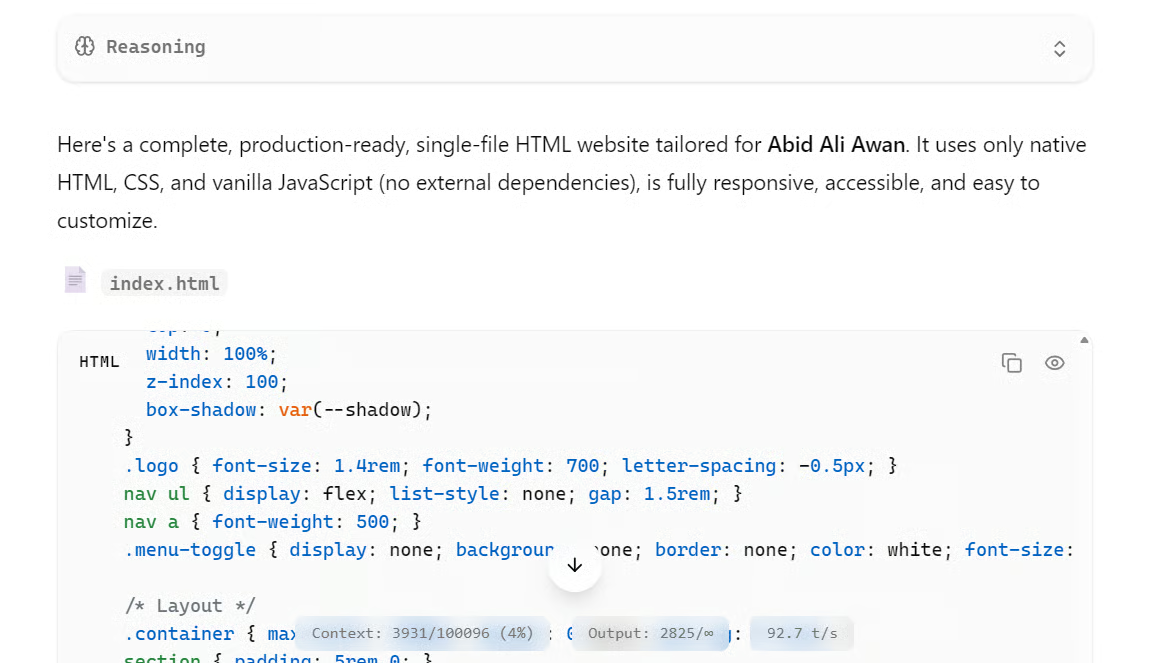
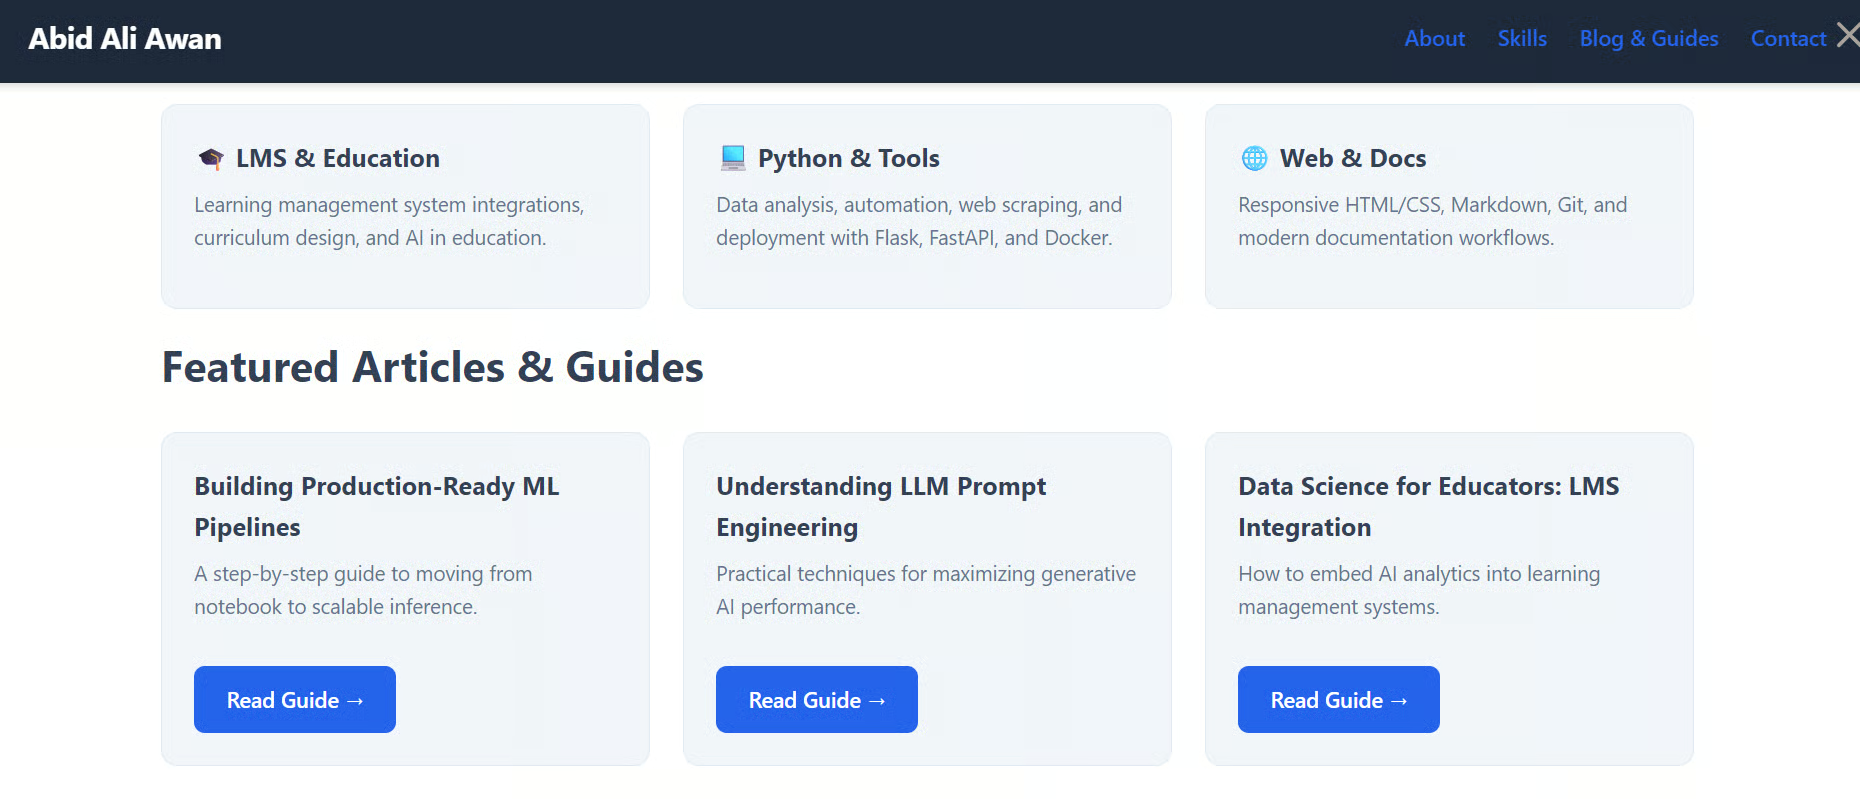
También le pedí crear una web de porfolio personal.
Aunque el código funcionaba, no me convenció la interfaz generada, ya que el diseño era básico y genérico.
Esto sugiere que Bonsai es capaz de producir código funcional, pero puede requerir prompts más detallados y varias iteraciones para lograr una interfaz pulida.
Pi es un agente de programación basado en terminal que usamos para probar Bonsai 27B en un flujo agentivo real a través de su API local compatible con OpenAI.
Abre una nueva terminal e instala el agente de programación Pi:
curl -fsSL https://pi.dev/install.sh | sh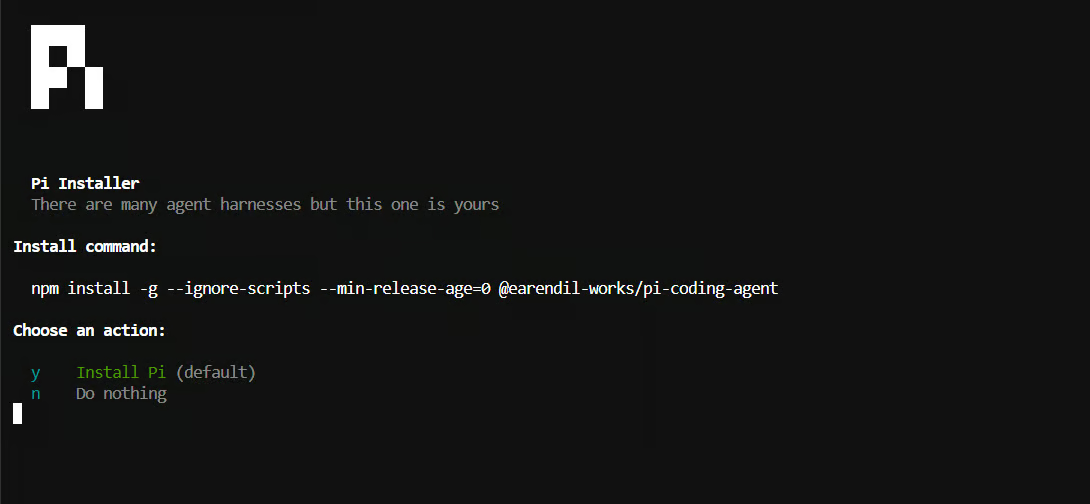
Cuando se te pida, pulsa Enter o escribe y para continuar con la instalación por defecto.
Confirma que Pi se instaló correctamente:
pi --versionEn el momento de la prueba, la versión instalada era:
0.82.0Asegúrate de que el servidor de Bonsai sigue en ejecución, luego abre una terminal nueva y crea el directorio de configuración de Pi:
mkdir -p ~/.pi/agentCrea el archivo de configuración de modelos personalizado:
nano ~/.pi/agent/models.jsonPega la siguiente configuración:
{
  "providers": {
    "bonsai-local": {
      "baseUrl": "http://127.0.0.1:8910/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false
      },
      "models": [
        {
          "id": "bonsai-27b",
          "name": "Bonsai 27B Local",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 100000,
          "maxTokens": 50000,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
Esta configuración conecta Pi con el endpoint local compatible con OpenAI, registra el modelo como Bonsai 27B Local y ajusta los 100.000 tokens de contexto del servidor.
Guarda y cierra el archivo:
Ctrl + O
Enter
Ctrl + X
Pi carga automáticamente los proveedores de modelos personalizados desde ~/.pi/agent/models.json.
Asegúrate de que el servidor de Bonsai sigue en ejecución y crea un nuevo directorio de proyecto:
mkdir simple-python
cd simple-python
Inicia Pi usando el modelo local de Bonsai:
pi --provider bonsai-local --model bonsai-27b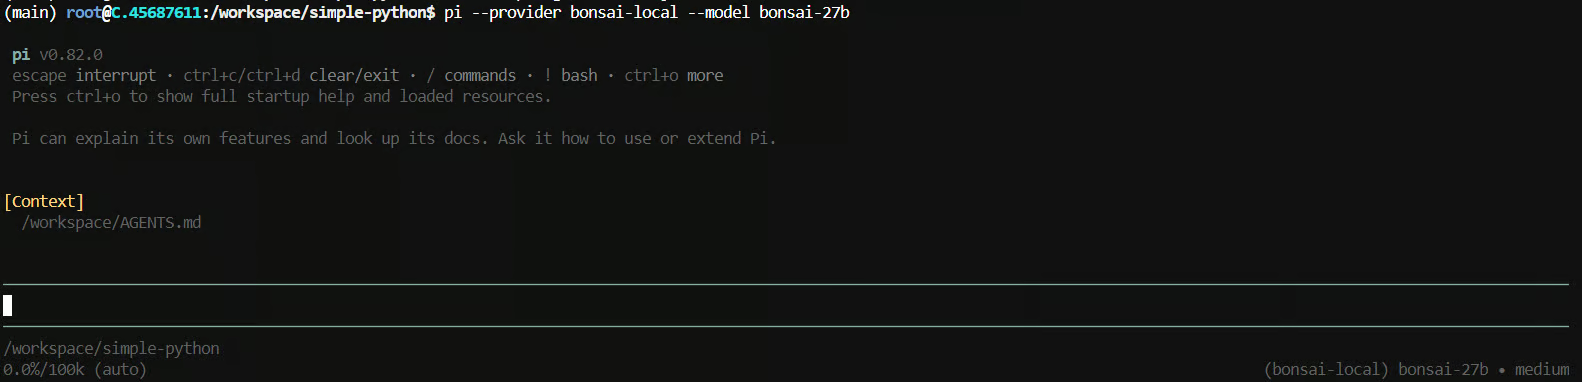
Introduce un prompt como:
Build a simple Python application with a FastAPI backend and a modern,
responsive web interface that accepts user input, processes it,
and displays the result.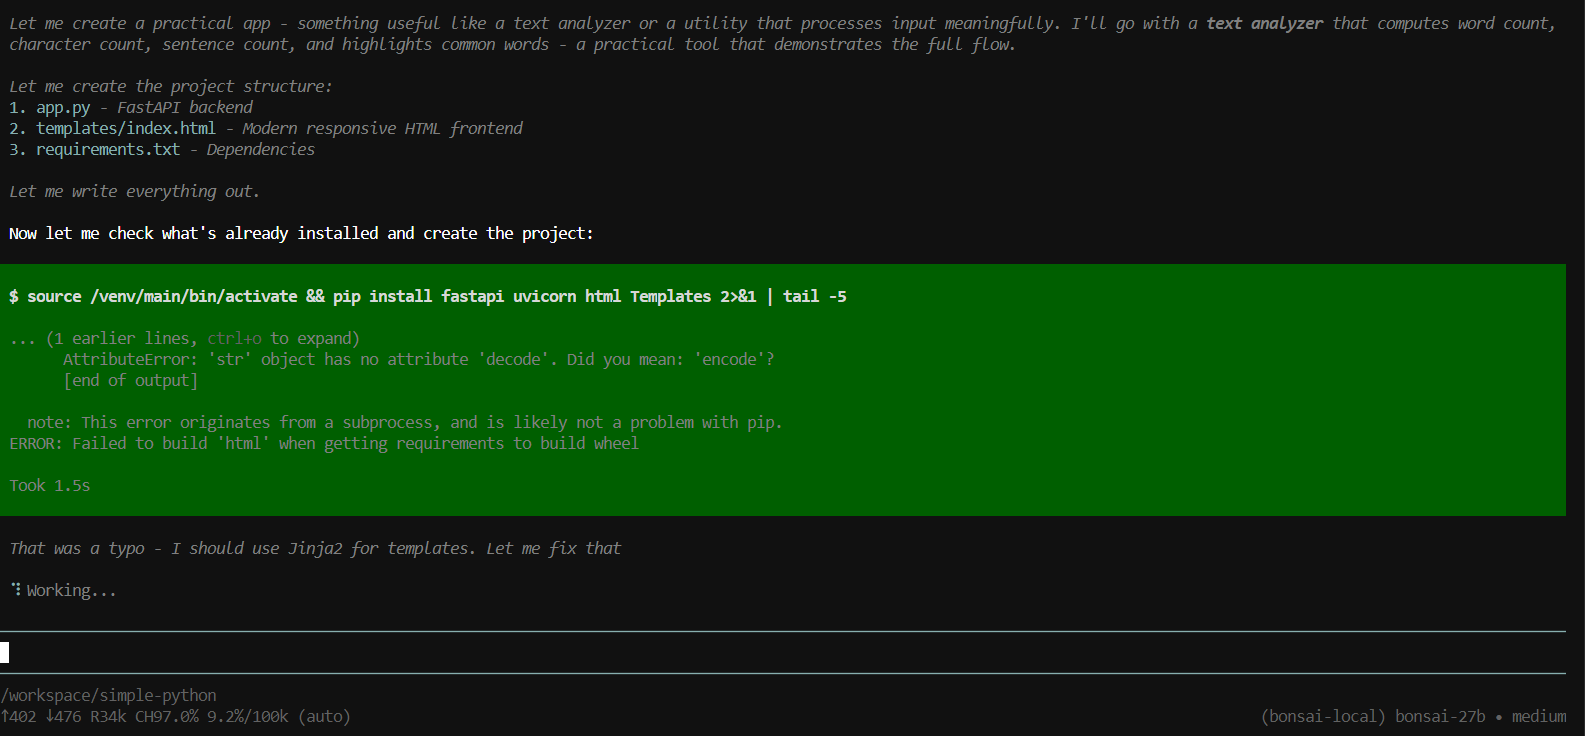
Pi empezó a razonar, creó los archivos del proyecto, instaló los paquetes necesarios y produjo una aplicación de análisis de texto con backend FastAPI y frontend responsive.
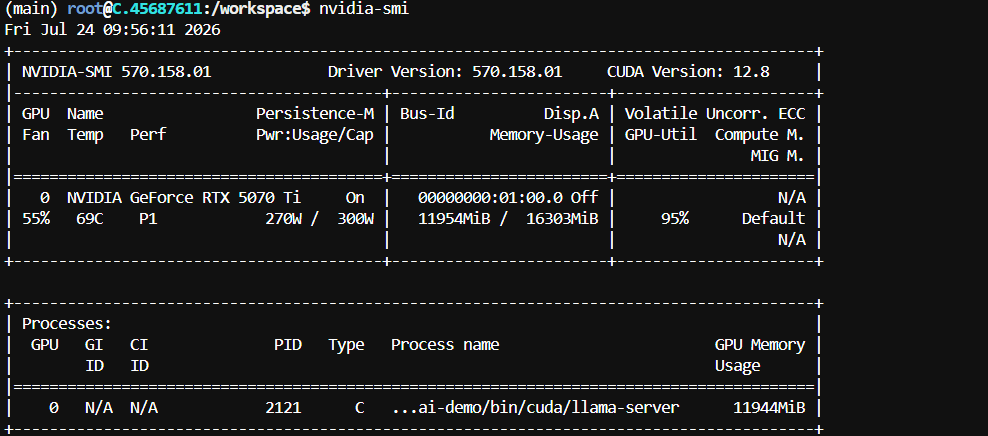
Mientras el modelo corría con una ventana de contexto de 100.000 tokens, nvidia-smi mostró aproximadamente 11,9 GB de uso de VRAM en mi RTX 5070 Ti:
Al final de la ejecución, Pi confirmó que la tarea había terminado y generó un resumen claro de todo lo realizado.
Incluía los archivos creados, las funcionalidades principales de la aplicación, las pruebas realizadas y los comandos exactos para ejecutar el proyecto en local.
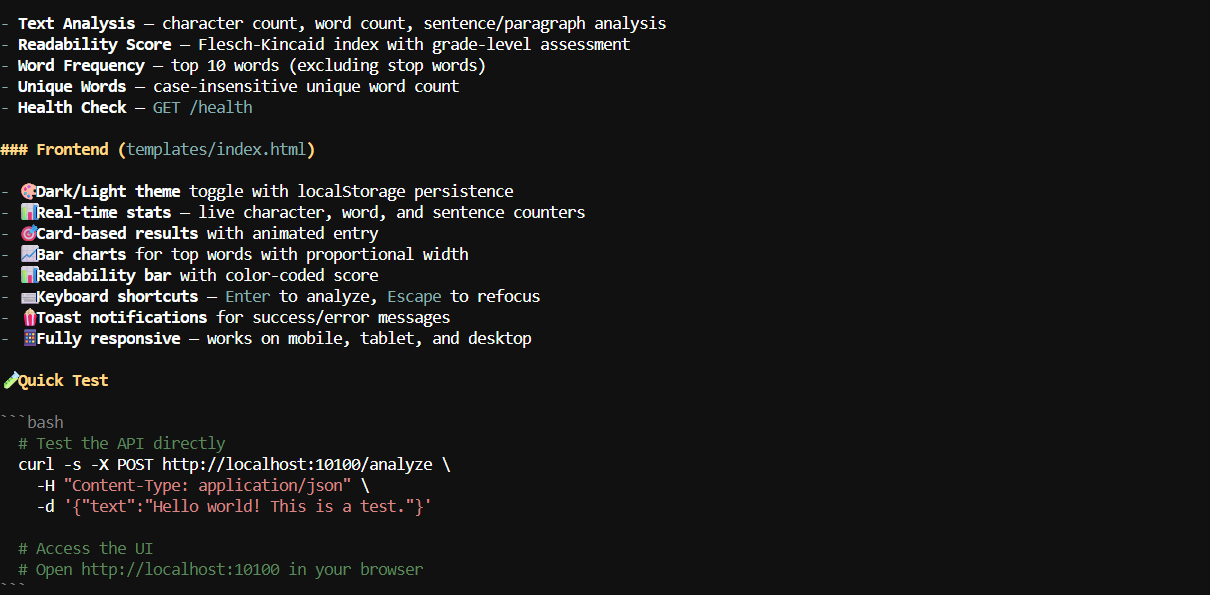
Tras la generación, Pi resumió los archivos y características creados.
Probé el backend con:
curl -s -X POST http://localhost:10100/analyze \
  -H "Content-Type: application/json" \
  -d '{"text":"Hello world! This is a test."}'
La API funcionó y la interfaz tenía mejor aspecto que la web generada antes mediante la interfaz web básica.
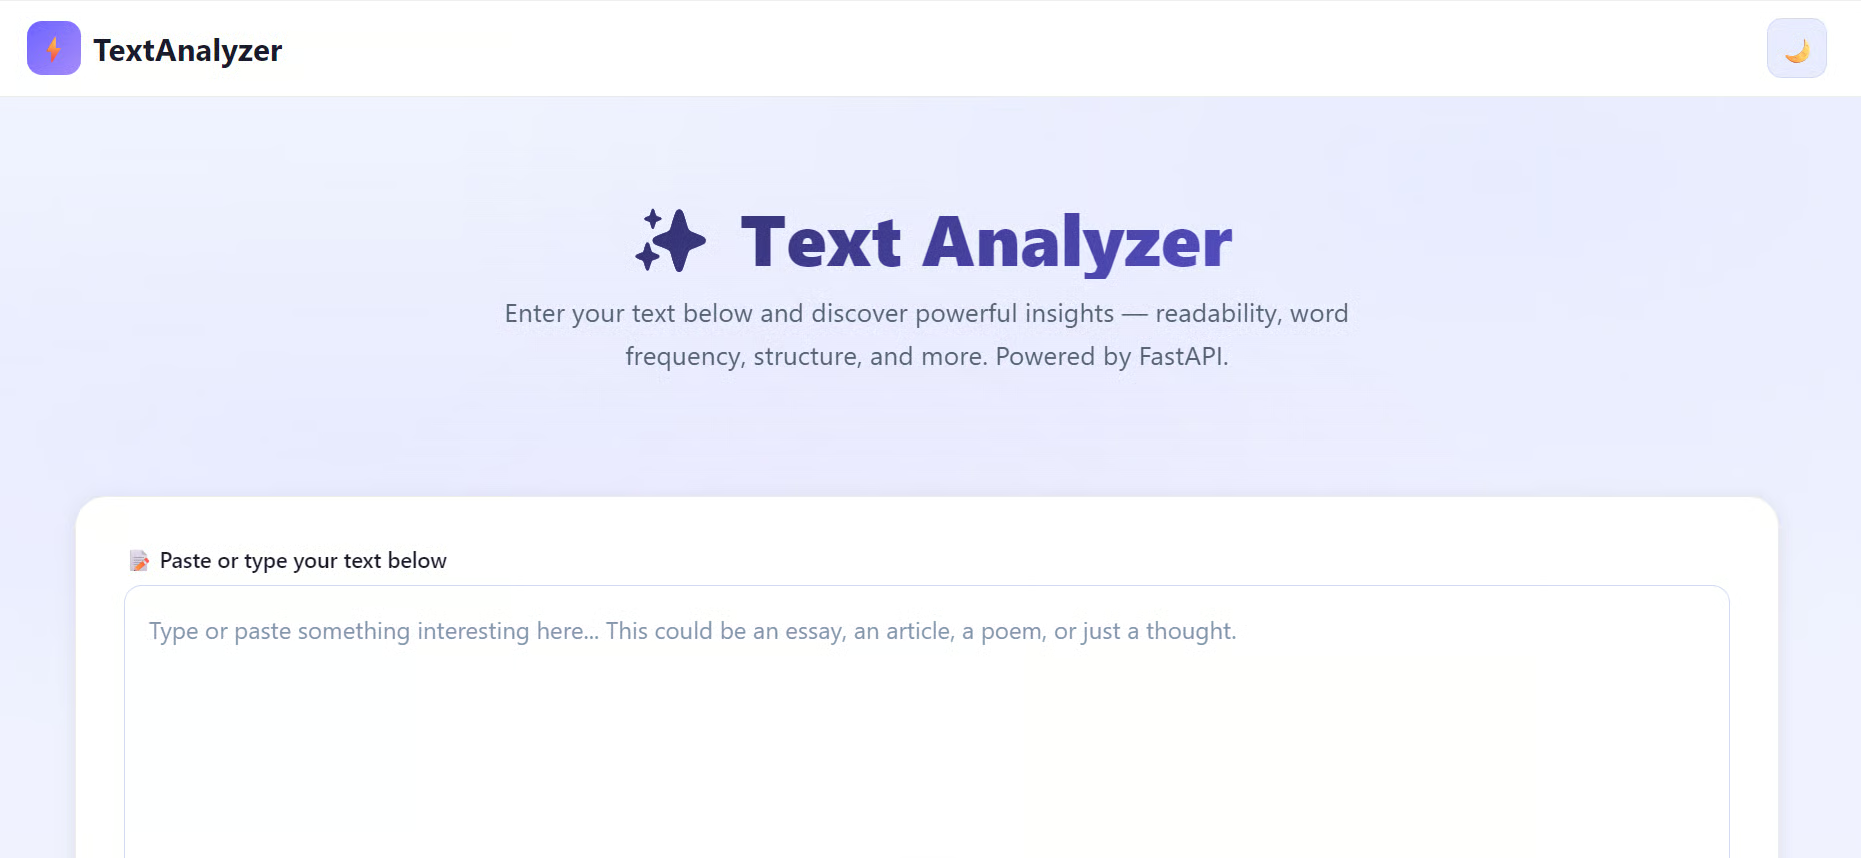
Aun así, la aplicación estaba incompleta: faltaban algunos botones y controles, y el frontend no mostraba todas las estadísticas disponibles en la API del backend.
Esto demuestra que Bonsai puede construir una aplicación full‑stack funcional, pero el resultado aún requiere pruebas y pulido.
En mis pruebas, Bonsai 27B sigue notándose como un modelo muy comprimido.
Su calidad de salida no está del todo a la altura de un Q4 cuantizado de Qwen3.6-27B, que he probado previamente y me ha resultado más fiable para flujos con agentes de código.
La versión Q4 requiere más memoria, pero ofrece un razonamiento más sólido, mejor generación de código y resultados más consistentes.
Dicho esto, Bonsai 27B sigue siendo sorprendentemente capaz para un modelo de alrededor de 3,8 GB.
Entiende instrucciones, crea archivos de proyecto, ejecuta comandos, prueba su trabajo y puede construir aplicaciones funcionales en local. En esta categoría de tamaño, es uno de los modelos más capaces que he probado.
Para trabajo serio con agentes de código, seguiría eligiendo la versión Q4 de Qwen3.6-27B, especialmente porque mi RTX 3090 tiene 24 GB de VRAM y puede manejar el modelo más grande sin problemas.
Aun así, he disfrutado usando Bonsai 27B y me ha impresionado el ecosistema más amplio de Prism ML. Su configuración automática, runtime optimizado, interfaz web integrada, API compatible con OpenAI e integraciones con agentes facilitan mucho que más personas ejecuten y prueben en local un gran modelo de razonamiento en hardware de consumo.
Cursos destacados de DataCamp
Curso
Curso
programa
blog
Abid Ali Awan
9 min
Tutorial
Ryan Ong
12 min
Tutorial
Dimitri Didmanidze
9 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
11 min