Curso
Codificação com IA para Desenvolvedores
1 h 30 min
9.9K
O Qwen3.6-27B virou uma escolha popular para rodar localmente um modelo competente em raciocínio e código. Ele é rápido e potente, mas um modelo completo de 27 bilhões de parâmetros ainda exige bastante memória.
Usar quantização convencional pode reduzir esses requisitos, mas também pode causar queda perceptível de performance.
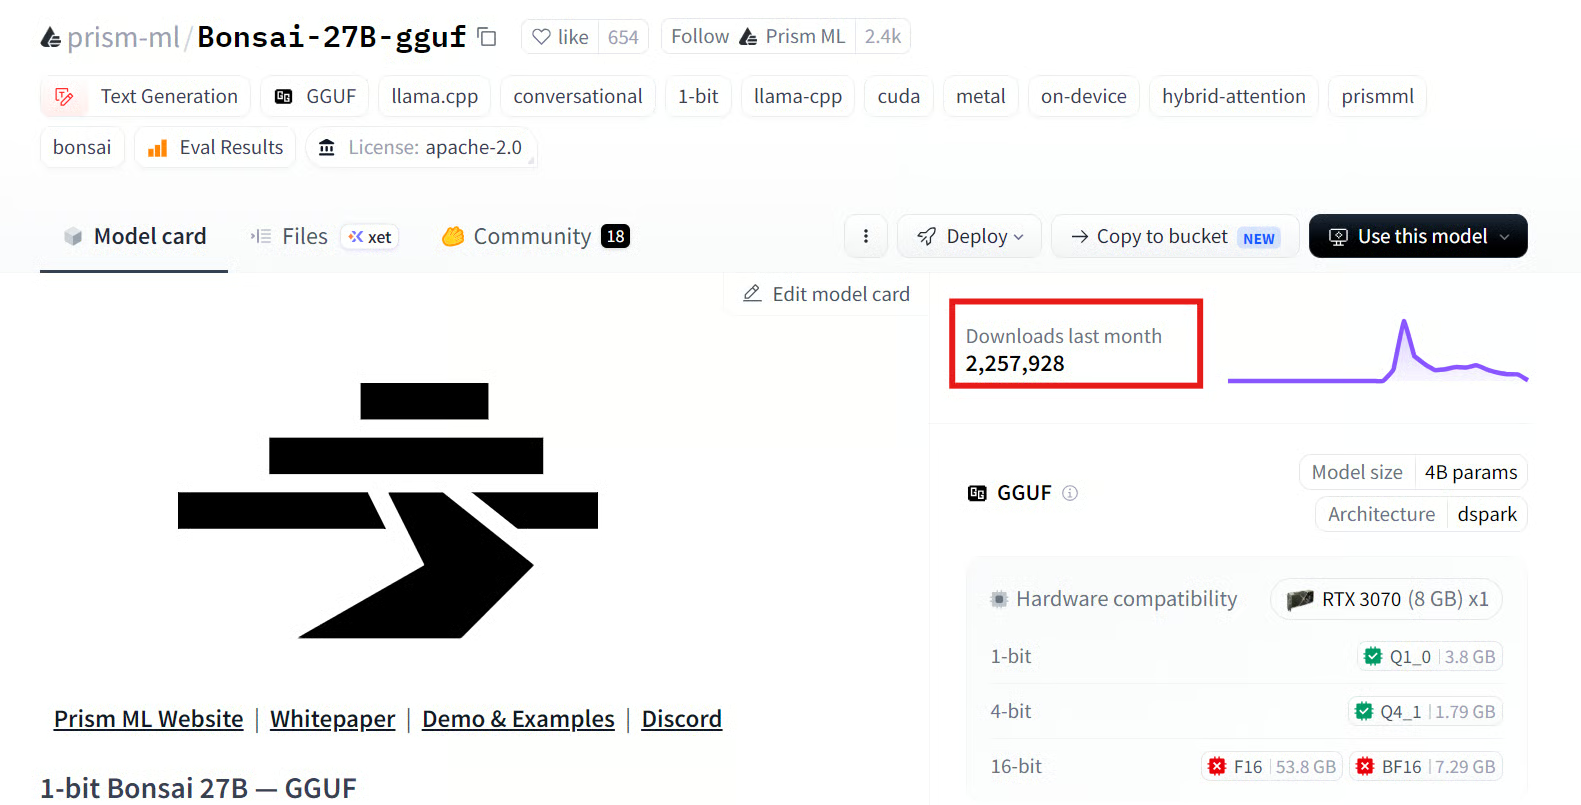
Fonte: prism-ml/Bonsai-27B-gguf
A Prism ML abordou esse problema de outro jeito com o Bonsai 27B, uma versão em 1 bit altamente compactada do Qwen3.6-27B.
Segundo a Prism ML, o Bonsai mantém quase 90% da performance do modelo original em benchmarks, reduzindo os pesos para aproximadamente 3,9 GB.
Isso torna viável experimentar um modelo de raciocínio da classe 27B em hardwares de consumo muito mais acessíveis.
Neste tutorial, vou usar o modelo em 1 bit Bonsai-27B-Q1_0.gguf e o script de setup customizado da Prism ML. O script baixa o modelo automaticamente, seleciona um runtime pré-compilado compatível e o configura para o hardware disponível.
Depois, vou testar o Bonsai no terminal, abrir a interface web local, acessá-lo via uma API compatível com a OpenAI e conectá-lo ao agente de código Pi.
O que torna o Bonsai 27B interessante é que ele não é apenas mais um Qwen quantizado de forma convencional.
A maioria dos modelos GGUF locais é compactada após o treinamento, reduzindo a precisão numérica de um modelo existente.
O Bonsai adota uma abordagem mais agressiva ao adaptar o modelo a pesos binários, permitindo que grande parte da rede opere com valores próximos de −1 ou +1.
Isso é importante porque rodar grandes modelos de linguagem costuma ser limitado por capacidade e largura de banda de memória, mais do que apenas poder de computação bruto.
Reduzir a precisão dos pesos diminui a quantidade de dados que precisam ser armazenados e movimentados durante a inferência.
Com um runtime otimizado, isso pode tornar um modelo grande de 27B prático em hardwares de consumo que normalmente teriam dificuldade para carregá-lo ou rodá-lo.
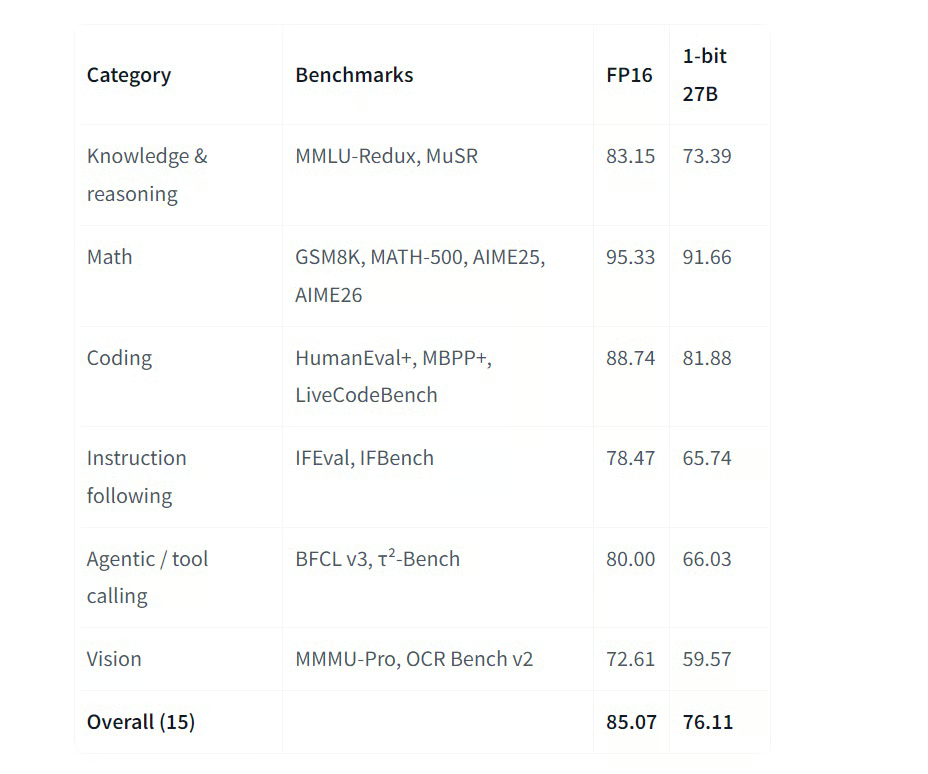
Fonte: prism-ml/Bonsai-27B-gguf · Hugging Face
O Bonsai também preserva capacidades que vão além de um chat básico.
Ele oferece suporte a raciocínio, programação, chamadas estruturadas de ferramentas, prompts de longo contexto e fluxos agentic.
Ele também pode rodar por trás de uma API compatível com a OpenAI, facilitando a conexão com agentes de código, sistemas de recuperação, ferramentas de automação e apps que já suportam endpoints no padrão OpenAI.
No entanto, o Bonsai não deve ser tratado como idêntico ao modelo Qwen3.6-27B em precisão total.
Compressão extrema ainda envolve trade-offs e pode afetar o seguimento de instruções, a escolha de ferramentas, a consistência do raciocínio e a qualidade das saídas de forma diferente entre tarefas.
Sua principal vantagem é o equilíbrio: recursos de modelo grande com requisitos de hardware substancialmente menores.
Antes de começar, confirme se seu sistema possui:
Uma GPU dedicada é opcional, porque o Bonsai também roda via CPU.
Porém, a inferência na CPU geralmente será mais lenta, especialmente quando o modelo gera respostas longas de raciocínio.
Para este guia, estou usando uma NVIDIA RTX 5070 Ti com 16 GB de VRAM.
Isso oferece memória suficiente para carregar os pesos do modelo (cerca de 3,9 GB) inteiramente na GPU e ainda sobra memória para o cache KV, ativações do modelo e overhead do runtime.
No entanto, a VRAM disponível também determina quanto de contexto você pode usar.
Embora o Bonsai 27B suporte conversas acima de 256 mil tokens, carregar todo o contexto de treinamento pode consumir muita memória extra e esgotar sistemas com pouca RAM ou VRAM.
Por isso, a Prism ML usa um tamanho de contexto padrão consciente de memória, em vez de alocar automaticamente a janela completa de 262 mil tokens.
Neste tutorial, vamos começar com uma janela de contexto de 8.192 tokens para testes no terminal. Depois, aumentaremos ao iniciar o servidor, dependendo da memória disponível.
Uma janela de contexto menor é suficiente para a maioria das tarefas de código e chat, além de oferecer inicialização mais rápida com menor uso de memória.
Abra um terminal e clone o repositório oficial de demo do Bonsai:
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
O repositório inclui scripts para baixar o modelo, detectar seu hardware, selecionar o binário de runtime correto, rodar o modelo pelo terminal e iniciar um servidor local.
Execute o seguinte comando de setup:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_OPENWEBUI=0 \
BONSAI_CODE_INTERPRETER=0 \
./setup.sh
Durante o setup, pode ser solicitado um token de acesso do Hugging Face.
Isso é opcional para arquivos públicos do modelo, então você pode pular pressionando Enter.
Mesmo assim, usar um token pode ajudar a evitar limites de download anônimo.

O script baixa aproximadamente 7,15 GB de arquivos, incluindo:
Bonsai-27B-Q1_0.ggufmmproj)Definir BONSAI_FAMILY=bonsai seleciona o modelo compacto em 1 bit do Bonsai em vez da versão ternária maior.
As opções abaixo desativam dois ambientes adicionais:
BONSAI_OPENWEBUI=0
BONSAI_CODE_INTERPRETER=0
O Open WebUI não é necessário neste tutorial, pois o binário de servidor incluído já oferece uma interface de chat leve no navegador.
O ambiente de code interpreter também não é necessário para a configuração local básica.
Durante a instalação, o script de setup automaticamente:
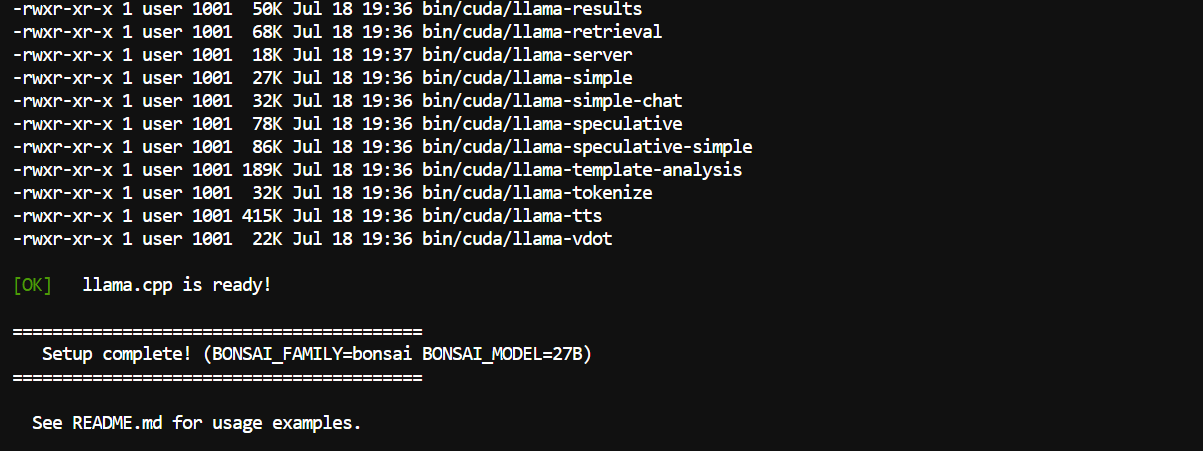
Esse setup automatizado é especialmente útil porque você não precisa compilar manualmente o llama.cpp ou escolher por conta própria um binário de CUDA, ROCm, Vulkan, Metal ou CPU.
Recomendo o tutorial do llama.cpp se você precisar de um guia rápido.
Depois da instalação, teste o modelo diretamente pelo terminal usando a interface de linha de comando do llama.cpp:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_CTX=8192 \
./scripts/run_llama.sh \
-p "Create a simple Python function that calculates compound interest."
Esse comando:
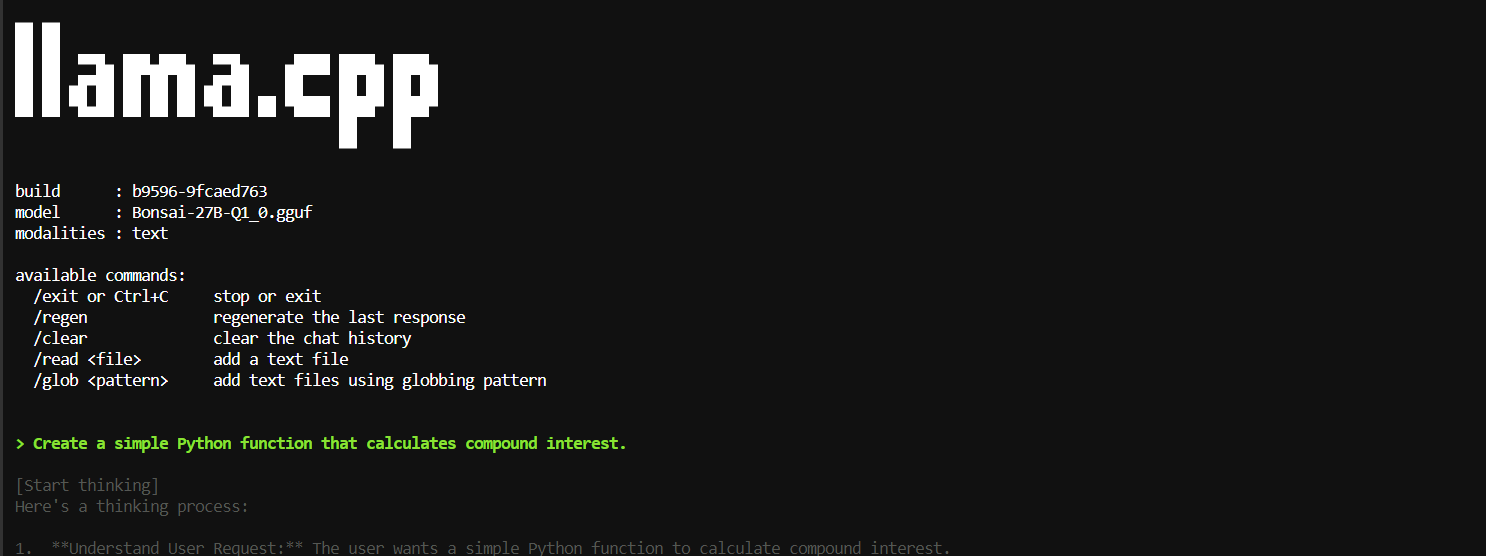
O primeiro carregamento pode levar alguns instantes enquanto o modelo é alocado na memória do sistema ou na VRAM da GPU.
Quando estiver pronto, o terminal exibe o modelo ativo, informações de build e comandos disponíveis antes de gerar a resposta.
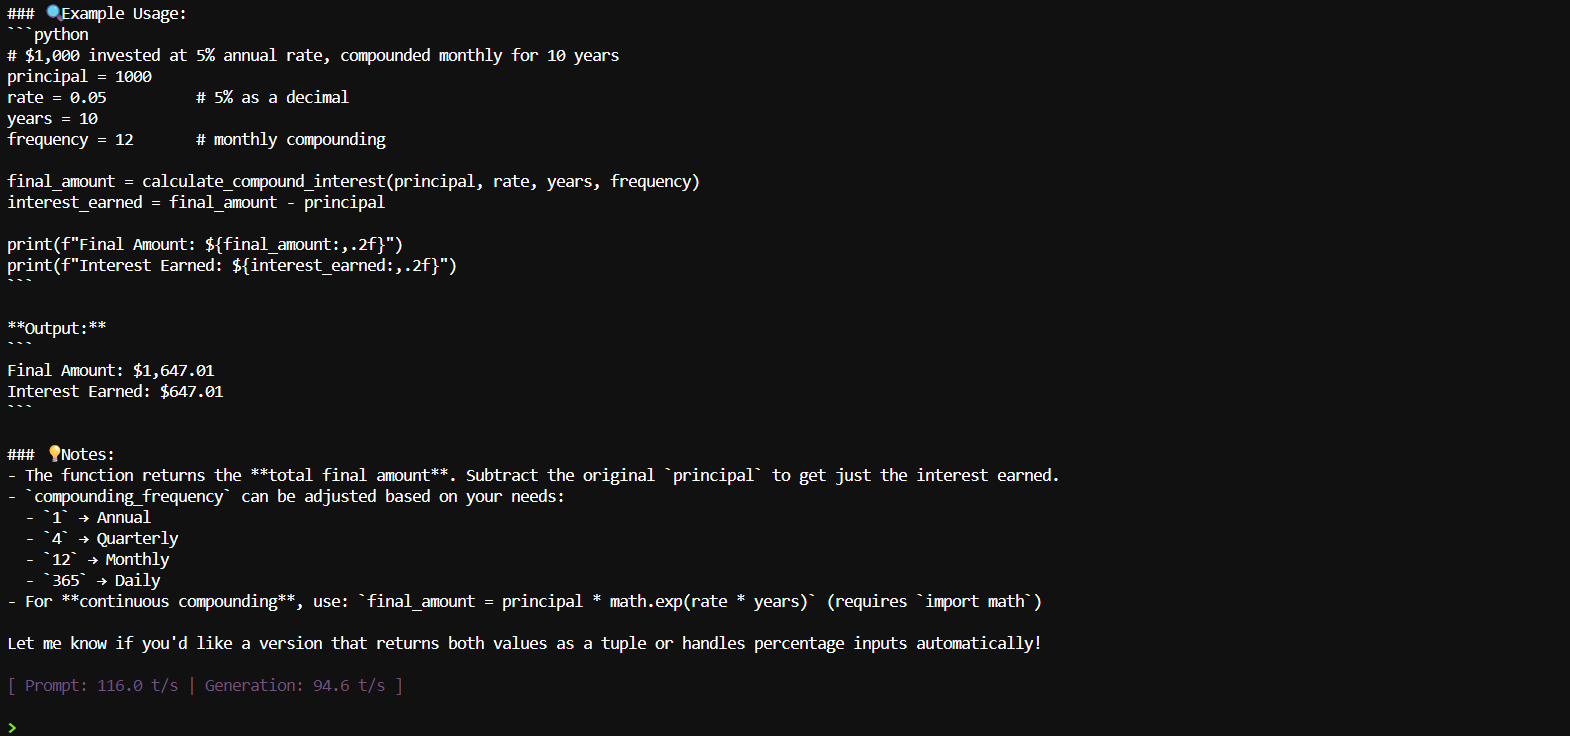
Como mostrado na saída, o Bonsai primeiro produz seu processo de raciocínio e depois gera um exemplo completo em Python, incluindo a função, instruções de uso e o resultado calculado.
Após a primeira resposta, a sessão permanece aberta, permitindo inserir novos prompts sem reiniciar o modelo.
Primeiro, pressione Ctrl+C para fechar a sessão interativa do passo anterior.
Depois, inicie o servidor local do Bonsai:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_CTX=100000 \
./scripts/start_llama_server.sh \
--alias bonsai-27b \
--host 0.0.0.0 \
--port 8910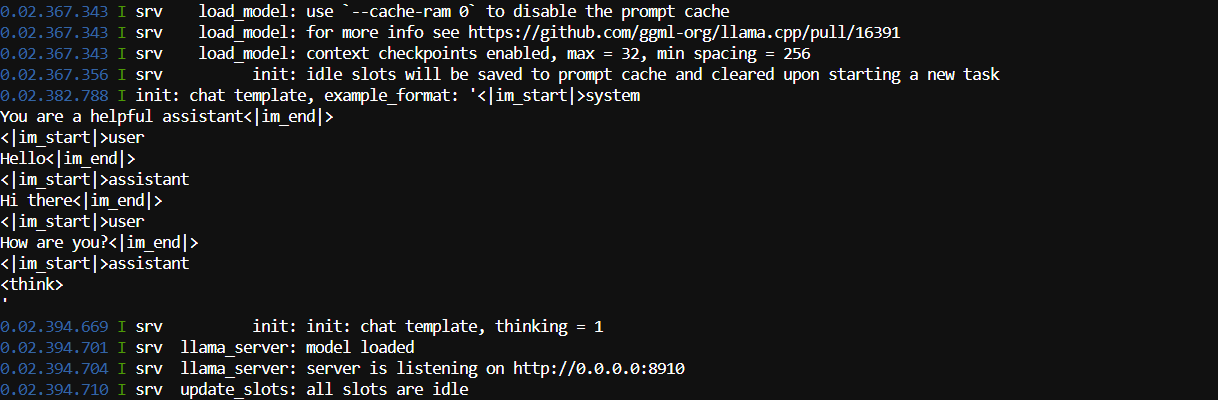
Esse comando:
bonsai-27bUma janela de 100.000 tokens exige bem mais memória do que o teste anterior de 8.192 tokens no CLI. Reduza BONSAI_CTX se o modelo não iniciar ou se o sistema ficar sem RAM ou VRAM.
Como o --host 0.0.0.0 expõe o servidor à sua rede local, evite usá-lo em redes não confiáveis. Para acesso apenas local, substitua por:
--host 127.0.0.1Mantenha este terminal aberto enquanto estiver usando o modelo. Fechá-lo interrompe o servidor.
O servidor do Bonsai oferece:
A API compatível com a OpenAI está disponível em:
http://127.0.0.1:8910/v1Abra um segundo terminal e envie uma requisição para o endpoint de chat-completions:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "bonsai-27b",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function for loading and validating a CSV file."
      }
    ],
    "max_tokens": 1000
  }'
A requisição usa a mesma estrutura da API de Chat Completions da OpenAI:
model seleciona o alias do servidor criado antesmessages contém a conversamax_tokens limita a quantidade de tokens geradosA API retornou JSON a cerca de 95 tokens por segundo, mas a resposta parou no limite de 1.000 tokens. Então, aumente "max_tokens" para 3000 para obter uma resposta completa antes de conectar o Bonsai a aplicativos, agentes ou programas em Python.
Abra o endereço abaixo no seu navegador:
http://127.0.0.1:8910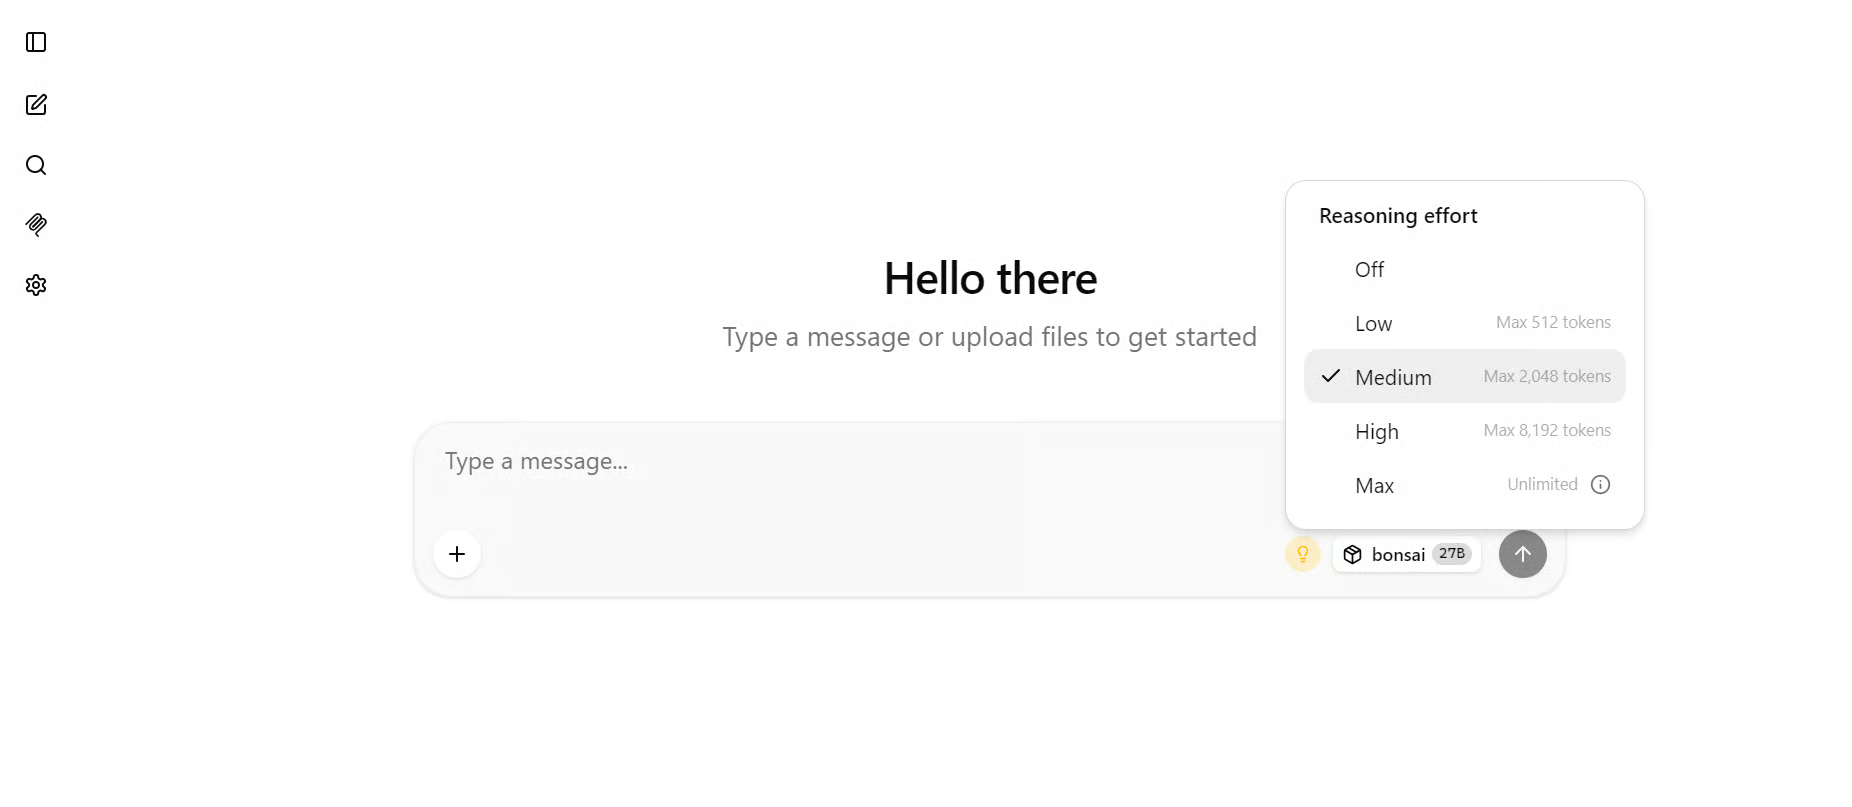
A interface integrada do llama.cpp permite conversar com o Bonsai, enviar arquivos e ajustar o esforço de raciocínio de Off até Max.
Teste com um prompt de código como:
Create a Python command-line application that converts CSV files to JSON.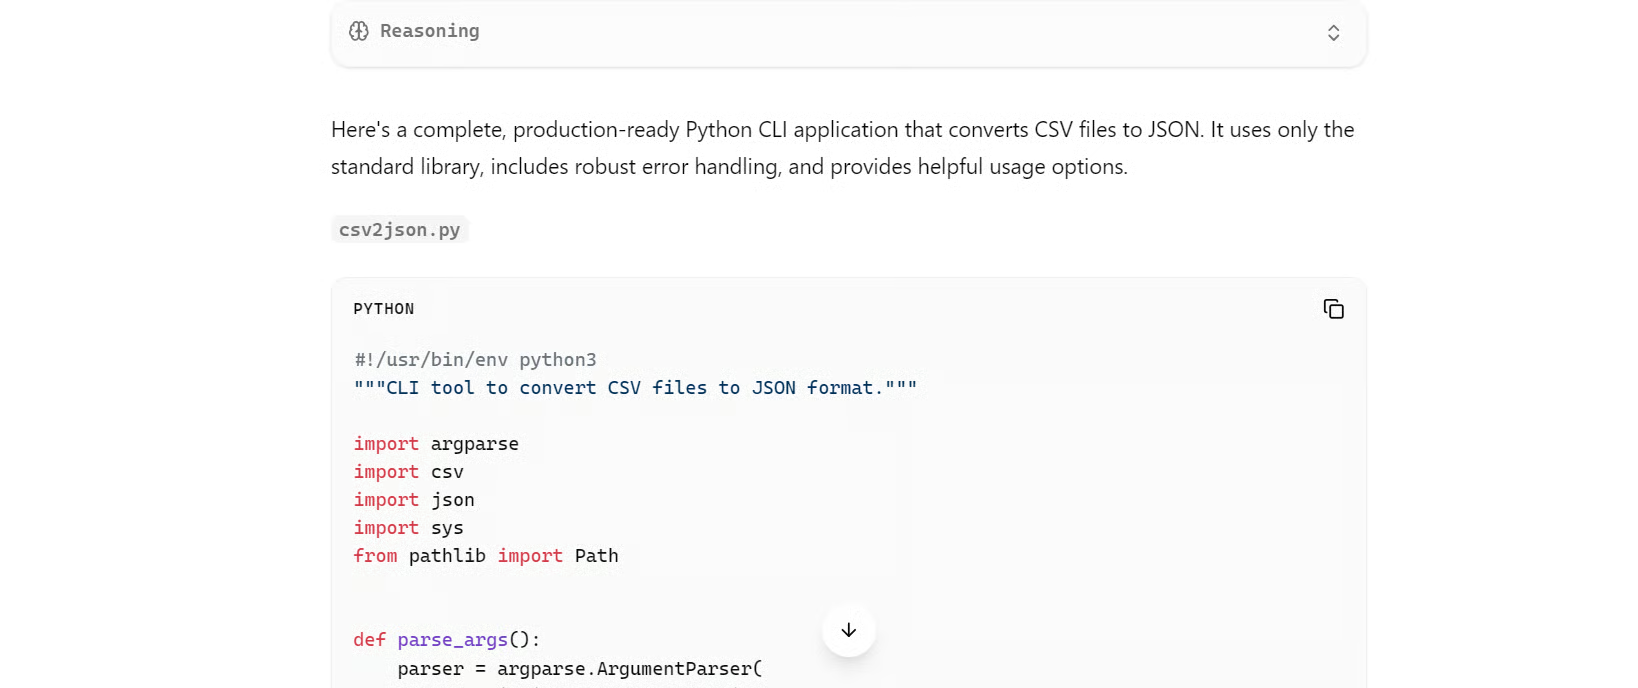
O Bonsai gerou um script Python completo a aproximadamente 92 tokens por segundo na minha RTX 5070 Ti.
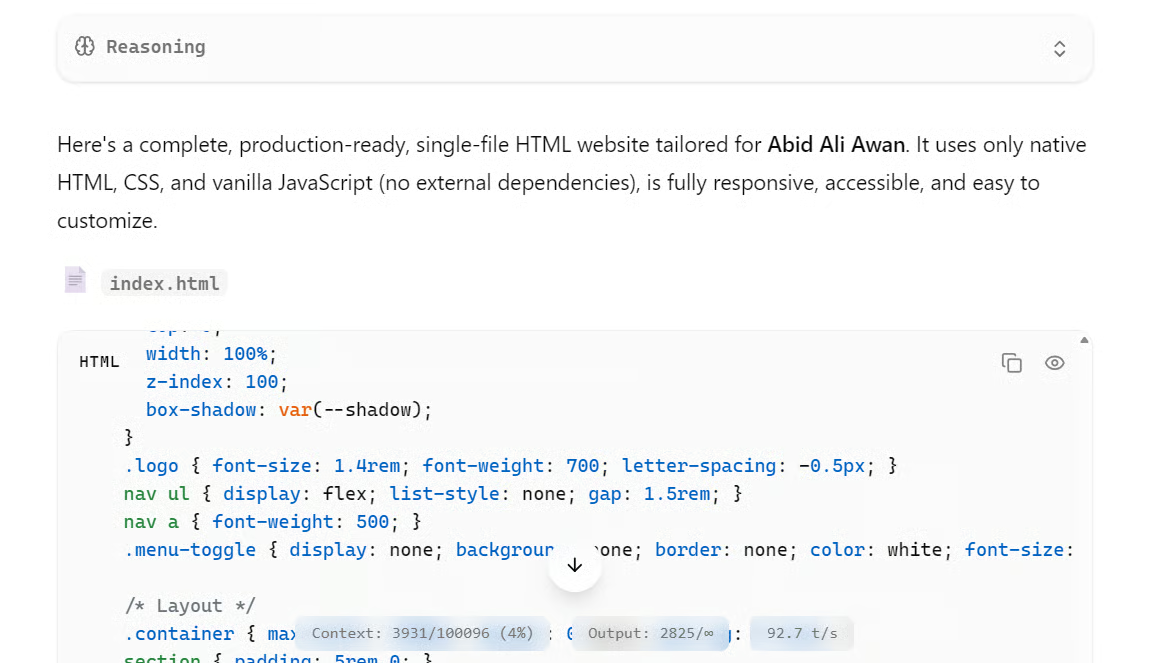
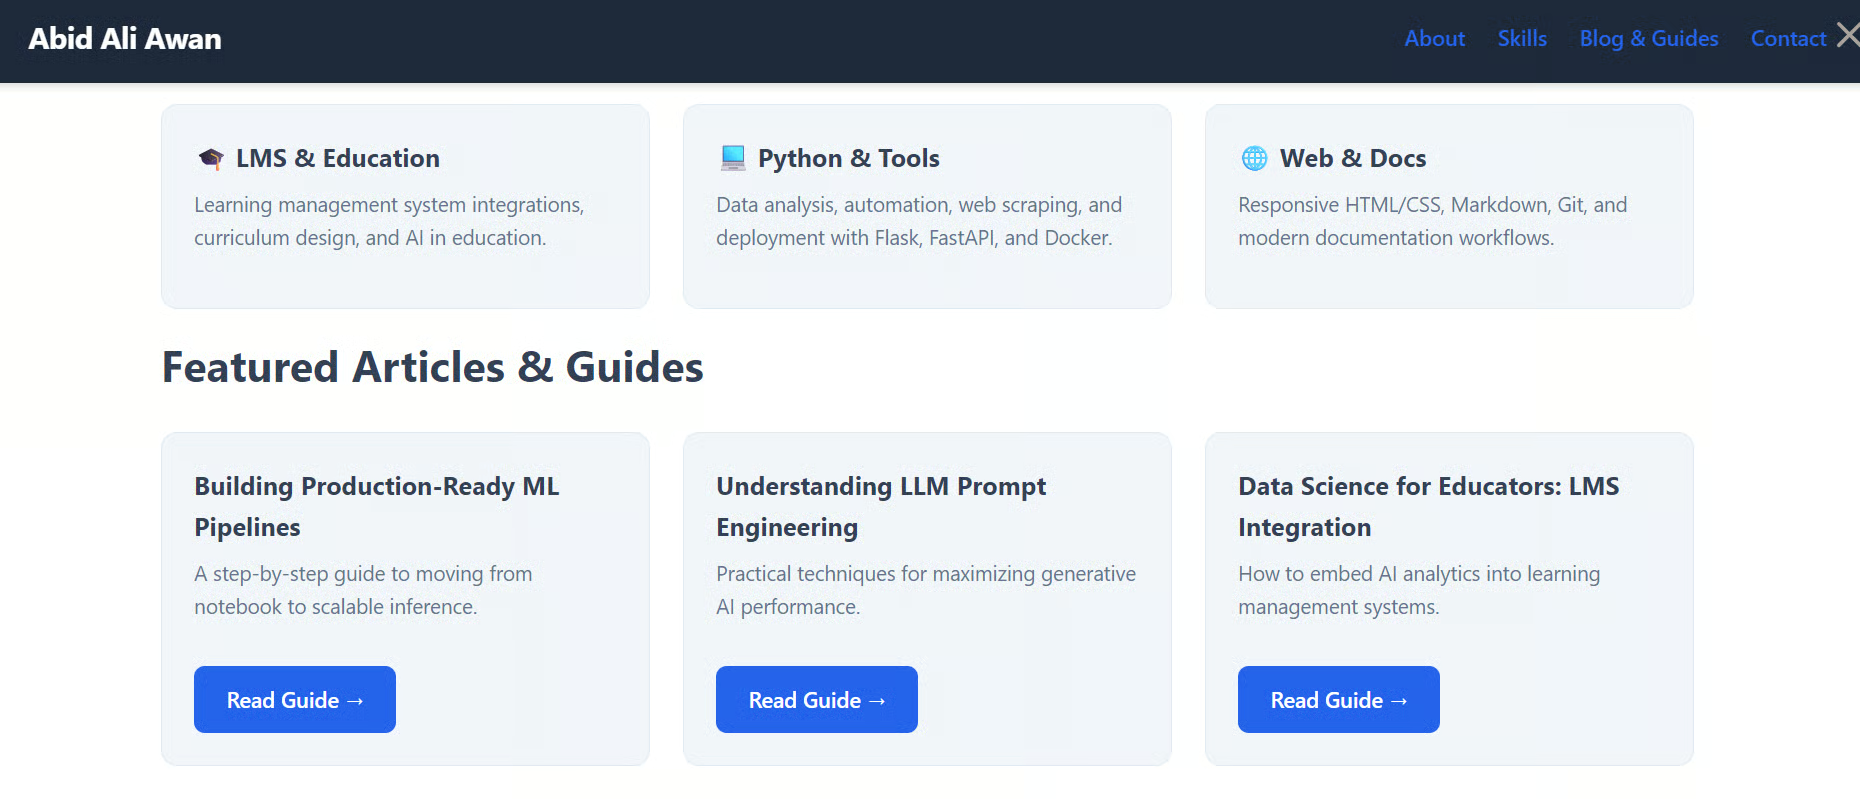
Também pedi para criar um site de portfólio pessoal.
Embora o código tenha funcionado, eu não fiquei satisfeito com a interface gerada, pois o design parecia básico e genérico.
Isso sugere que o Bonsai é capaz de produzir código funcional, mas pode exigir prompts mais detalhados e algumas iterações para entregar uma interface bem polida.
O Pi é um agente de código baseado em terminal que usaremos para testar o Bonsai 27B em um fluxo agentic real por meio de sua API local compatível com a OpenAI.
Abra um novo terminal e instale o agente de código Pi:
curl -fsSL https://pi.dev/install.sh | sh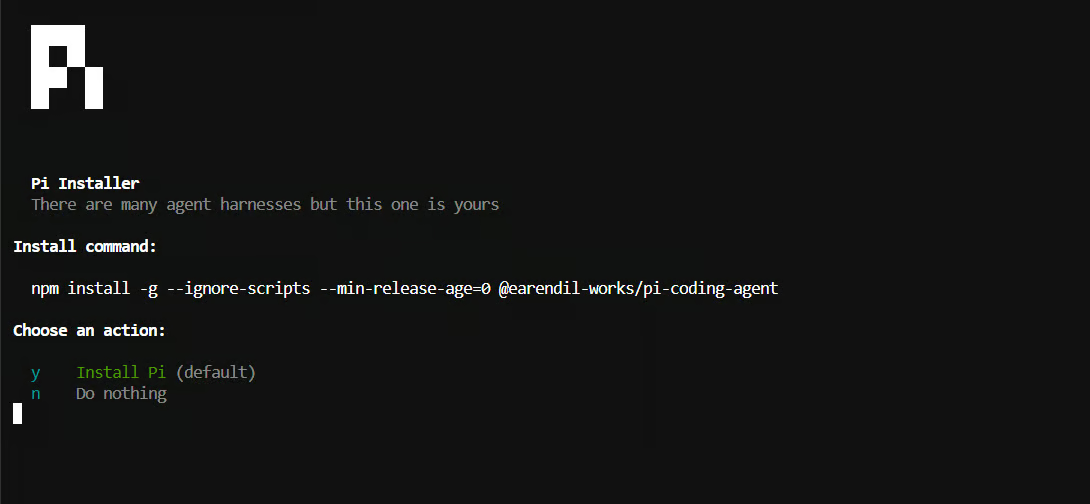
Quando solicitado, pressione Enter ou digite y para seguir com a instalação padrão.
Confirme que o Pi foi instalado com sucesso:
pi --versionNo momento do teste, a versão instalada era:
0.82.0Garanta que o servidor do Bonsai ainda esteja rodando e, em seguida, abra um novo terminal e crie o diretório de configuração do Pi:
mkdir -p ~/.pi/agentCrie o arquivo de configuração de modelo customizado:
nano ~/.pi/agent/models.jsonCole a configuração abaixo:
{
  "providers": {
    "bonsai-local": {
      "baseUrl": "http://127.0.0.1:8910/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false
      },
      "models": [
        {
          "id": "bonsai-27b",
          "name": "Bonsai 27B Local",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 100000,
          "maxTokens": 50000,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
Essa configuração conecta o Pi ao endpoint local compatível com a OpenAI, registra o modelo como Bonsai 27B Local e mantém o contexto de 100.000 tokens definido no servidor.
Salve e feche o arquivo:
Ctrl + O
Enter
Ctrl + X
O Pi carrega automaticamente provedores de modelo customizados de ~/.pi/agent/models.json.
Confirme que o servidor do Bonsai segue em execução e crie um novo diretório de projeto:
mkdir simple-python
cd simple-python
Inicie o Pi usando o modelo local do Bonsai:
pi --provider bonsai-local --model bonsai-27b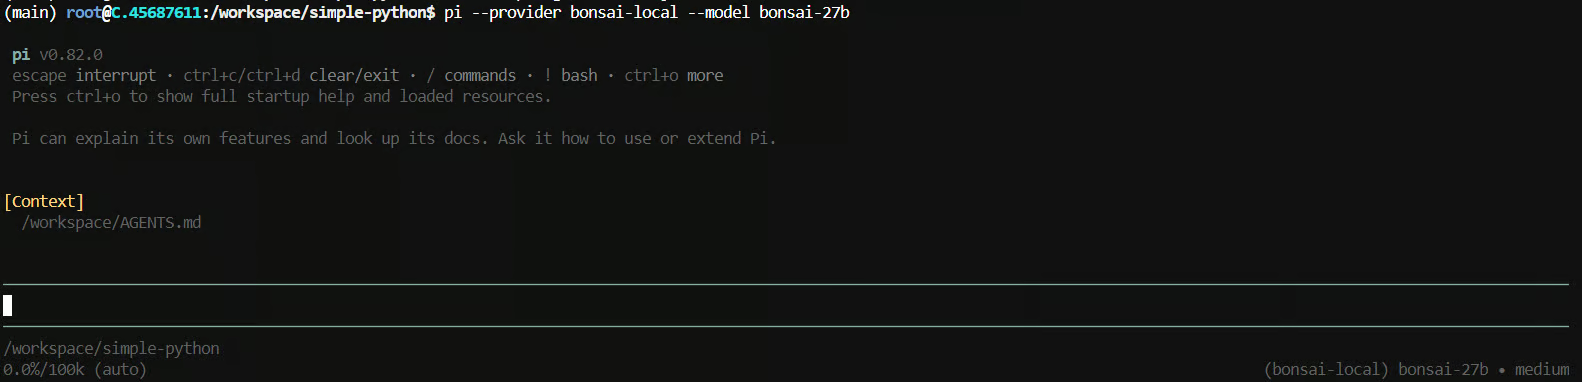
Digite um prompt como:
Build a simple Python application with a FastAPI backend and a modern,
responsive web interface that accepts user input, processes it,
and displays the result.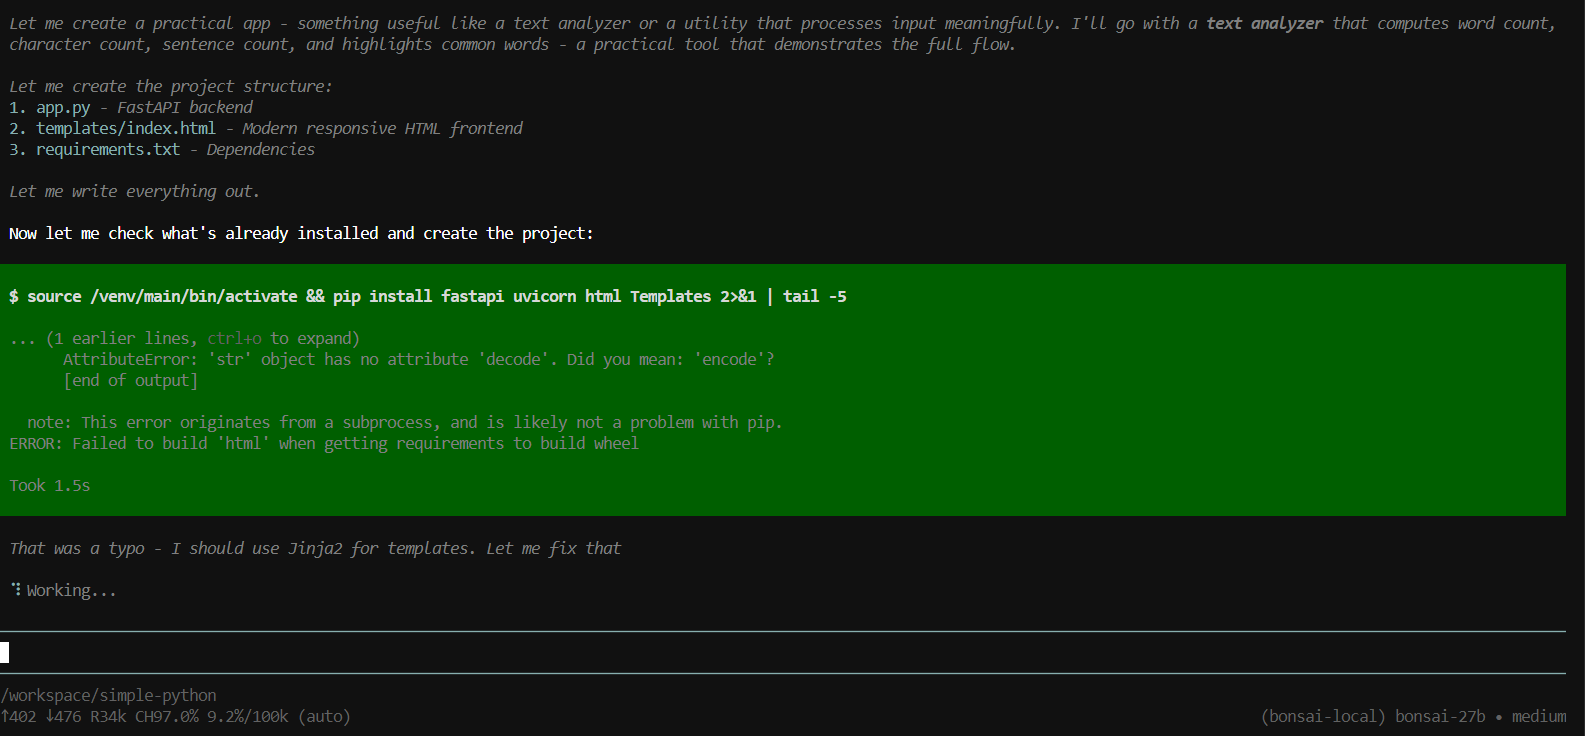
O Pi começou a raciocinar, criou os arquivos do projeto, instalou os pacotes necessários e produziu um app de análise de texto com backend em FastAPI e frontend responsivo.
Enquanto o modelo rodava com janela de 100.000 tokens, o nvidia-smi mostrou aproximadamente 11,9 GB de uso de VRAM na minha RTX 5070 Ti:
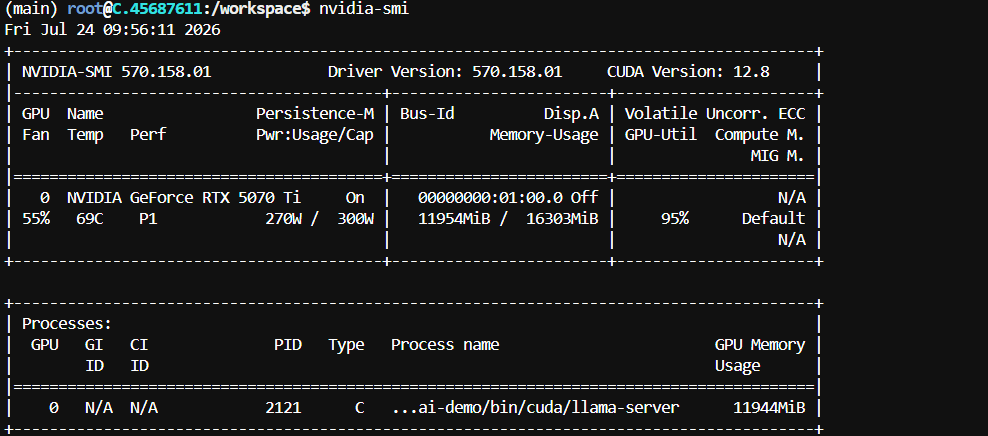
Ao final, o Pi confirmou a conclusão da tarefa e gerou um resumo claro de tudo o que fez.
Incluiu os arquivos criados, os principais recursos do app, os testes realizados e os comandos exatos para rodar o projeto localmente.
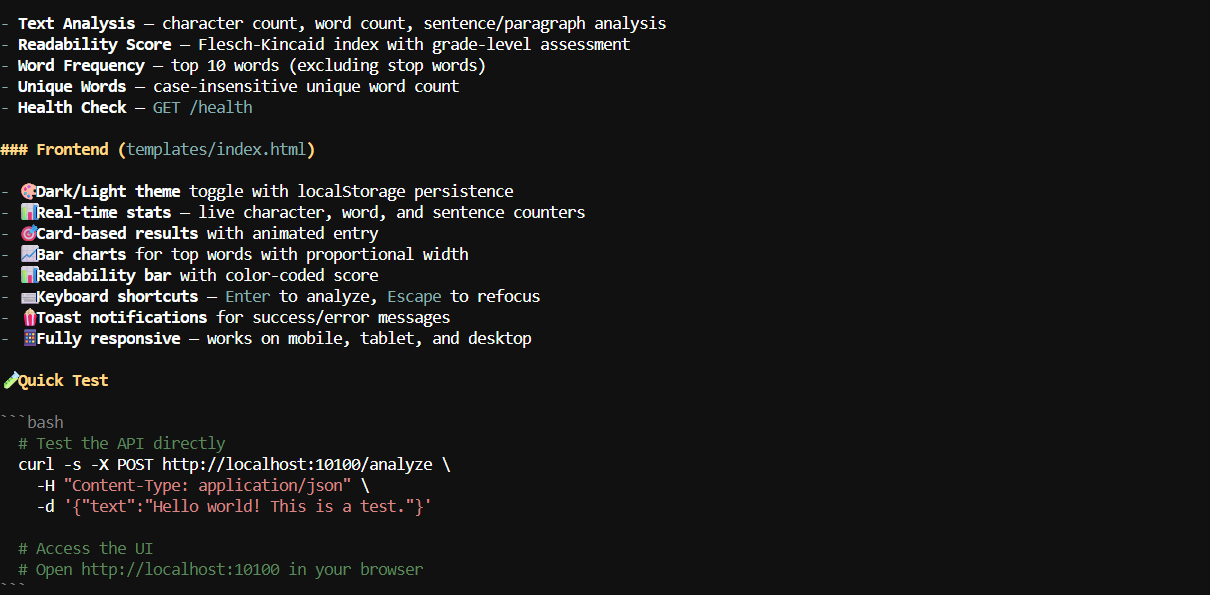
Após a geração, o Pi resumiu os arquivos e funcionalidades criados.
Testei o backend usando:
curl -s -X POST http://localhost:10100/analyze \
  -H "Content-Type: application/json" \
  -d '{"text":"Hello world! This is a test."}'
A API funcionou e a interface ficou melhor do que o site anterior gerado pela interface web básica.
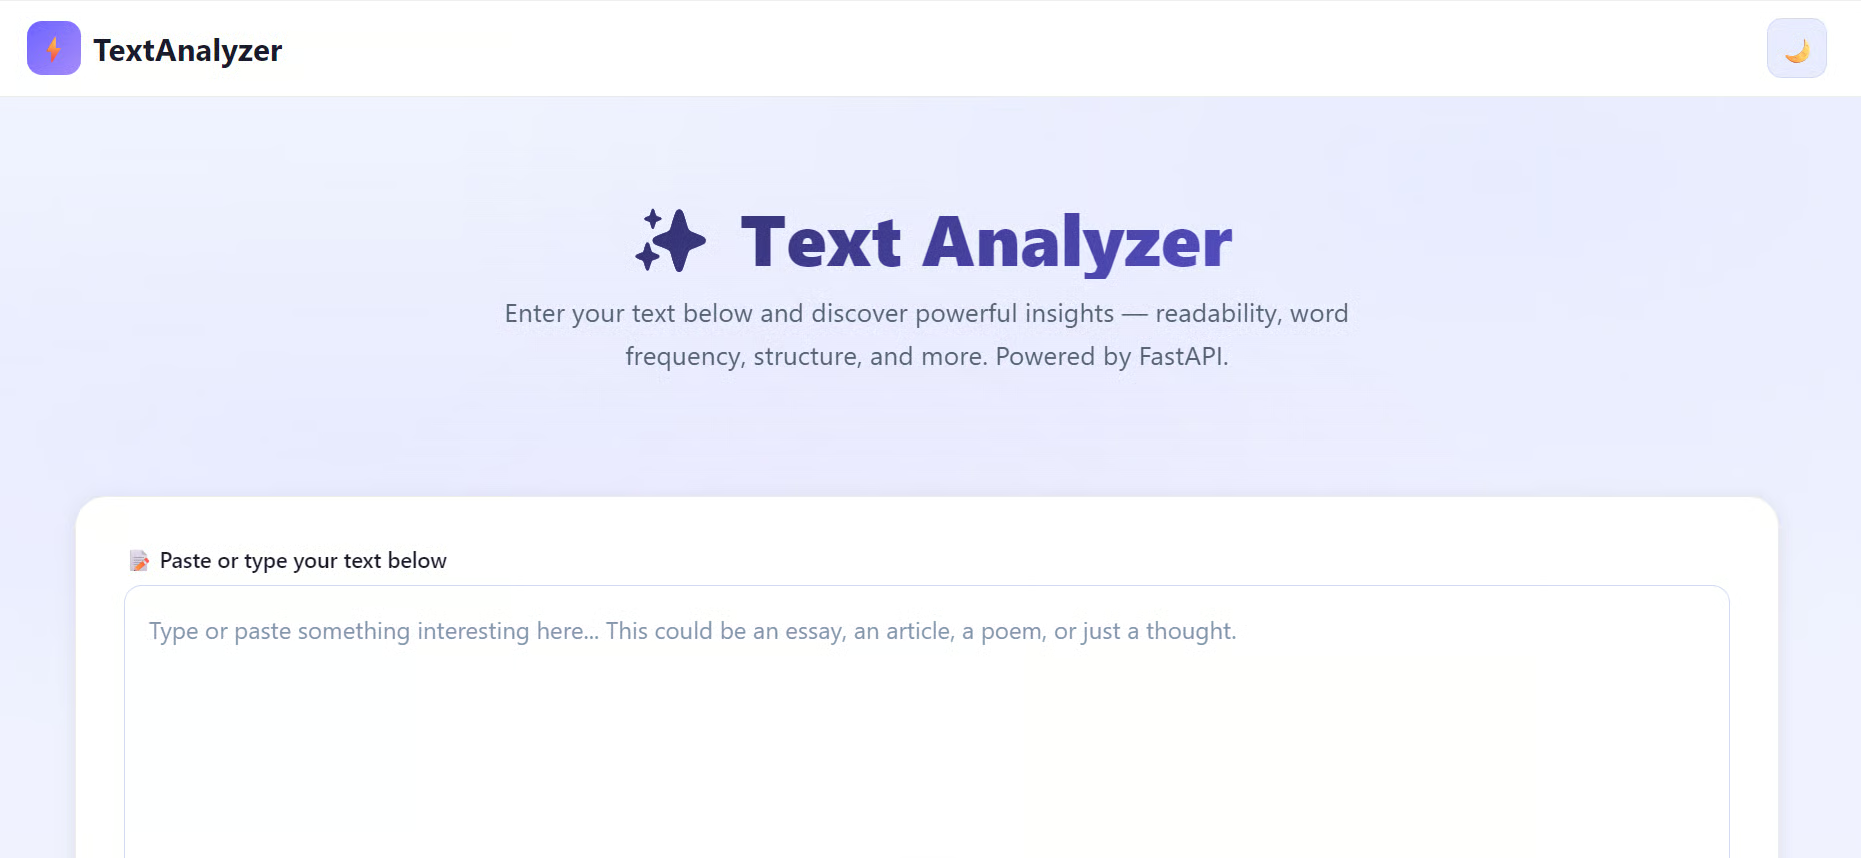
Mesmo assim, o app ainda estava incompleto: alguns botões e controles faltavam e o frontend não mostrava todas as estatísticas disponíveis na API do backend.
Isso mostra que o Bonsai consegue construir um app full stack funcional, mas o resultado ainda precisa de testes e refinamentos.
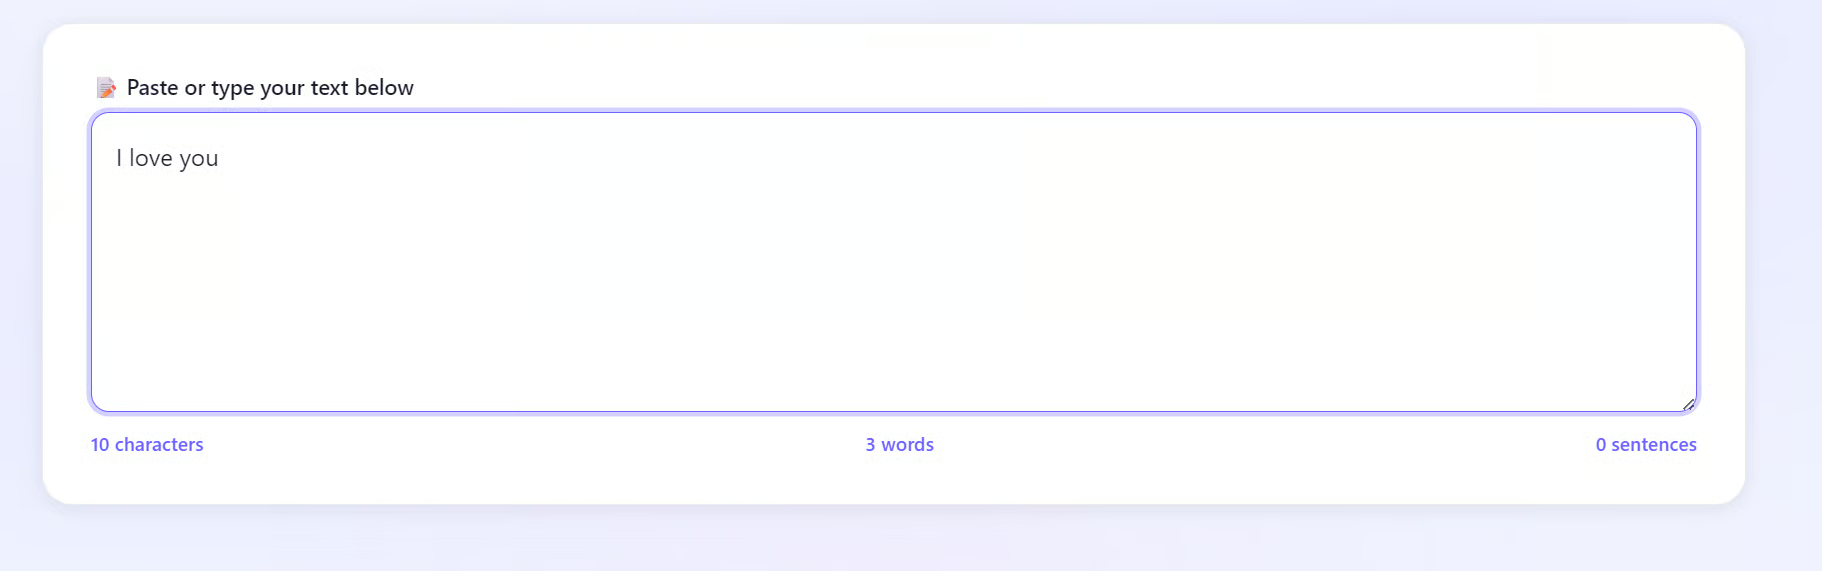
Nos meus testes, o Bonsai 27B ainda tem a sensação de um modelo fortemente compactado.
A qualidade das saídas não chega a um Qwen3.6-27B quantizado em Q4, que testei anteriormente e considerei mais confiável para fluxos com agentes de código.
A versão Q4 exige mais memória, mas entrega raciocínio mais sólido, melhor geração de código e resultados mais consistentes.
Dito isso, o Bonsai 27B continua impressionantemente capaz para um modelo com cerca de 3,8 GB.
Ele entende instruções, cria arquivos de projeto, executa comandos, testa o próprio trabalho e consegue construir aplicativos funcionais localmente. Dentro dessa categoria de tamanho, é um dos modelos mais capazes que já testei.
Para trabalho sério com agentes de código, eu ainda escolheria a versão Q4 do Qwen3.6-27B, especialmente porque minha RTX 3090 tem 24 GB de VRAM e dá conta do modelo maior com folga.
Ainda assim, gostei muito de usar o Bonsai 27B e fiquei impressionado com o ecossistema mais amplo da Prism ML. O setup automatizado, o runtime otimizado, a interface web integrada, a API compatível com a OpenAI e as integrações com agentes tornam muito mais fácil para mais pessoas rodar e experimentar um grande modelo de raciocínio localmente em hardwares de consumo.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Abid Ali Awan
9 min
Tutorial
Ryan Ong
12 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
11 min
Tutorial
Moez Ali
12 min