Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
9.9K
Hinweis: Bonsai 2 27B ist jetzt verfügbar, basierend auf Qwen3.8 27B
Qwen3.6-27B hat sich als beliebte Wahl etabliert, um ein leistungsfähiges Reasoning- und Coding-Modell lokal auszuführen. Es ist schnell und stark, aber ein vollständiges 27‑Milliarden‑Parameter‑Modell braucht dennoch spürbar viel Speicher.
Konventionelle Quantisierung senkt zwar die Anforderungen, kann aber die Performance spürbar verschlechtern.
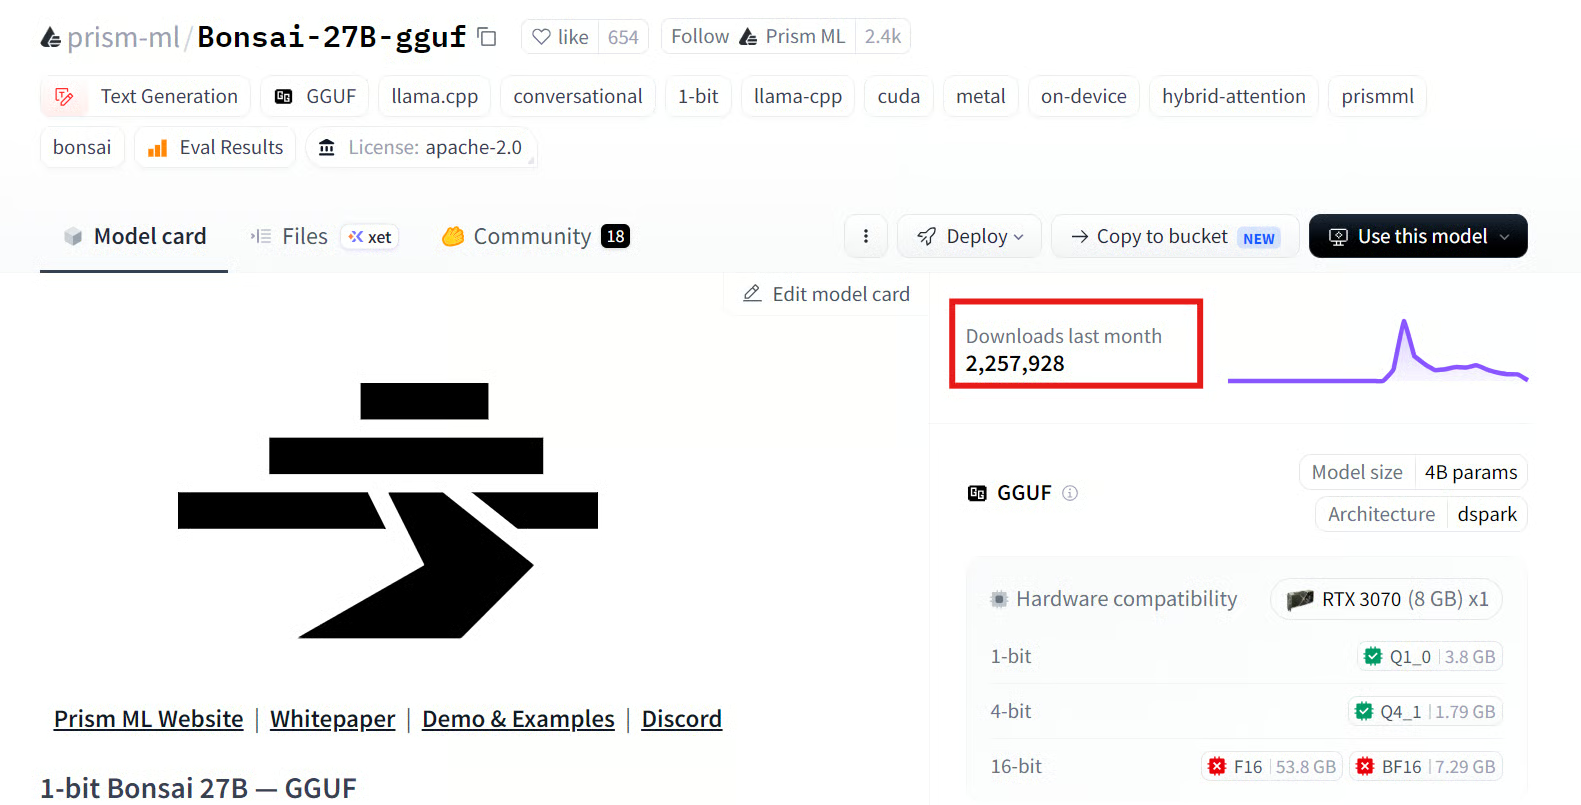
Quelle: prism-ml/Bonsai-27B-gguf
Prism ML ist das Problem anders angegangen und hat Bonsai 27B entwickelt – eine stark komprimierte 1‑Bit‑Version von Qwen3.6‑27B.
Laut Prism ML behält Bonsai fast 90% der Benchmark-Leistung des Ursprungsmodells bei, während die Modellgewichte auf etwa 3,9 GB schrumpfen.
So lässt sich mit einem 27B‑Modell für Reasoning auf deutlich zugänglicherer Consumer-Hardware experimentieren.
In diesem Tutorial nutze ich das 1‑Bit‑Bonsai-27B-Q1_0.gguf‑Modell und das benutzerdefinierte Setup-Skript von Prism ML. Das Skript lädt das Modell automatisch herunter, wählt eine kompatible vorgebaute Runtime und konfiguriert sie für die verfügbare Hardware.
Anschließend teste ich Bonsai in der Kommandozeile, starte das lokale Webinterface, greife über eine OpenAI-kompatible API darauf zu und verbinde es mit dem Pi Coding Agent.
Spannend an Bonsai 27B ist, dass es nicht einfach ein weiteres konventionell quantisiertes Qwen-Modell ist.
Die meisten lokalen GGUF-Modelle werden nach dem Training komprimiert, indem man die numerische Präzision eines bestehenden Modells reduziert.
Bonsai geht weiter und passt das Modell auf binäre Gewichte an, sodass große Teile des Netzwerks mit Werten nahe −1 oder +1 arbeiten können.
Das ist wichtig, weil beim Ausführen großer Sprachmodelle oft Speicherkapazität und Speicherbandbreite limitieren – nicht allein die reine Rechenleistung.
Weniger Präzision der Gewichte senkt die Datenmenge, die während der Inferenz gespeichert und bewegt werden muss.
Mit einer optimierten Runtime wird damit ein großes 27B‑Modell auf Consumer-Hardware praktikabel, die es sonst kaum laden oder ausführen könnte.
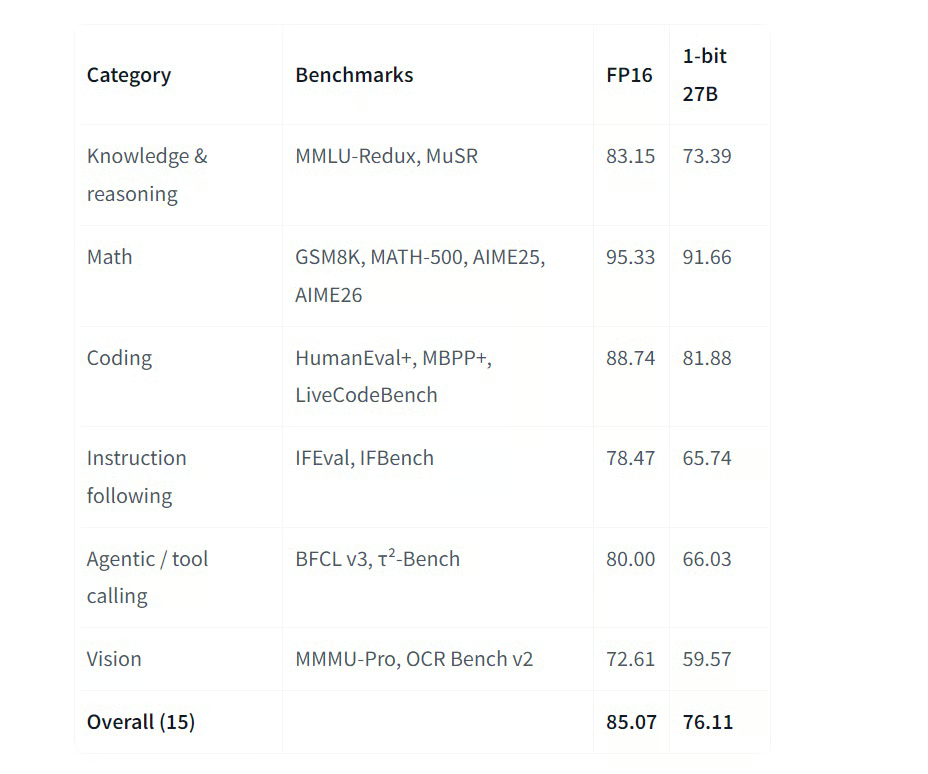
Quelle: prism-ml/Bonsai-27B-gguf · Hugging Face
Bonsai erhält zudem Fähigkeiten, die über reinen Chat hinausgehen.
Es unterstützt Reasoning, Coding, strukturierte Tool-Aufrufe, Long-Context-Prompts und agentische Workflows.
Es kann außerdem hinter einer OpenAI-kompatiblen API laufen, was die Anbindung an Coding-Agents, Retrieval-Systeme, Automations-Tools und Anwendungen erleichtert, die bereits OpenAI‑ähnliche Endpunkte unterstützen.
Allerdings sollte man Bonsai nicht als identisch zum Vollpräzisions‑Qwen3.6‑27B betrachten.
Extreme Kompression bleibt ein Trade-off und kann je nach Aufgabe Befolgung von Anweisungen, Tool-Auswahl, Konsistenz im Reasoning und Ausgabequalität unterschiedlich beeinflussen.
Der große Vorteil ist die Balance: Fähigkeiten großer Modelle bei deutlich geringeren Hardware-Anforderungen.
Stell vor dem Start sicher, dass dein System Folgendes mitbringt:
Eine dedizierte GPU ist optional, da Bonsai auch auf der CPU laufen kann.
Auf der CPU ist die Inferenz jedoch in der Regel langsamer – besonders bei langen Reasoning-Antworten.
Für dieses Tutorial nutze ich eine einzelne NVIDIA RTX 5070 Ti mit 16 GB VRAM.
Damit lässt sich das etwa 3,9 GB große Modell vollständig in den GPU‑Speicher laden und es bleibt Reserve für KV‑Cache, Aktivierungen und Runtime-Overhead.
Die verfügbare VRAM-Menge bestimmt aber auch, wie viel Kontext du nutzen kannst.
Obwohl Bonsai 27B Unterhaltungen über 256.000 Tokens unterstützt, kann das Laden des kompletten Trainingskontexts viel zusätzlichen Speicher beanspruchen und Systeme mit wenig RAM oder VRAM an ihre Grenzen bringen.
Prism ML nutzt daher standardmäßig eine speicherschonende Kontextgröße, statt automatisch das volle 262K‑Token‑Fenster zu belegen.
In diesem Tutorial starten wir für CLI‑Tests zunächst mit einem kleineren Kontextfenster von 8.192 Tokens und erhöhen es beim Serverstart abhängig vom verfügbaren Speicher.
Ein kleineres Kontextfenster reicht für die meisten Coding- und Chat-Aufgaben aus und sorgt für schnelleren Start bei geringerem Speicherverbrauch.
Öffne ein Terminal und klone das offizielle Bonsai-Demo-Repository:
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
Das Repository enthält Skripte zum Herunterladen des Modells, zur Hardware-Erkennung, zur Auswahl des richtigen Runtime‑Binaries, zum Ausführen des Modells im Terminal und zum Starten eines lokalen Servers.
Führe den folgenden Setup-Befehl aus:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_OPENWEBUI=0 \
BONSAI_CODE_INTERPRETER=0 \
./setup.sh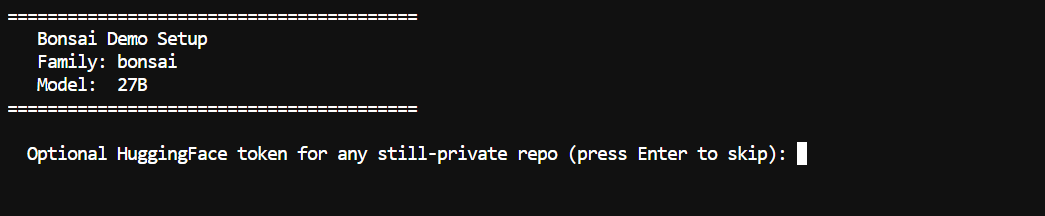
Während des Setups wirst du eventuell nach einem Hugging‑Face‑Access‑Token gefragt.
Für öffentliche Modell-Dateien ist das optional, du kannst also einfach mit Enter überspringen.
Mit Token lassen sich anonyme Download-Limits jedoch eher vermeiden.

Das Skript lädt ungefähr 7,15 GB Dateien herunter, darunter:
Bonsai-27B-Q1_0.ggufmmproj)Mit BONSAI_FAMILY=bonsai wählst du das kompakte 1‑Bit‑Bonsai‑Modell statt der größeren ternären Variante.
Die folgenden Optionen deaktivieren zwei zusätzliche Umgebungen:
BONSAI_OPENWEBUI=0
BONSAI_CODE_INTERPRETER=0
Open WebUI brauchst du hier nicht, da das enthaltene Server-Binary bereits ein leichtgewichtiges, browserbasiertes Chat‑Interface mitbringt.
Die Code‑Interpreter‑Umgebung ist für das grundlegende lokale Setup ebenfalls nicht nötig.
Während der Installation erledigt das Setup-Skript automatisch:
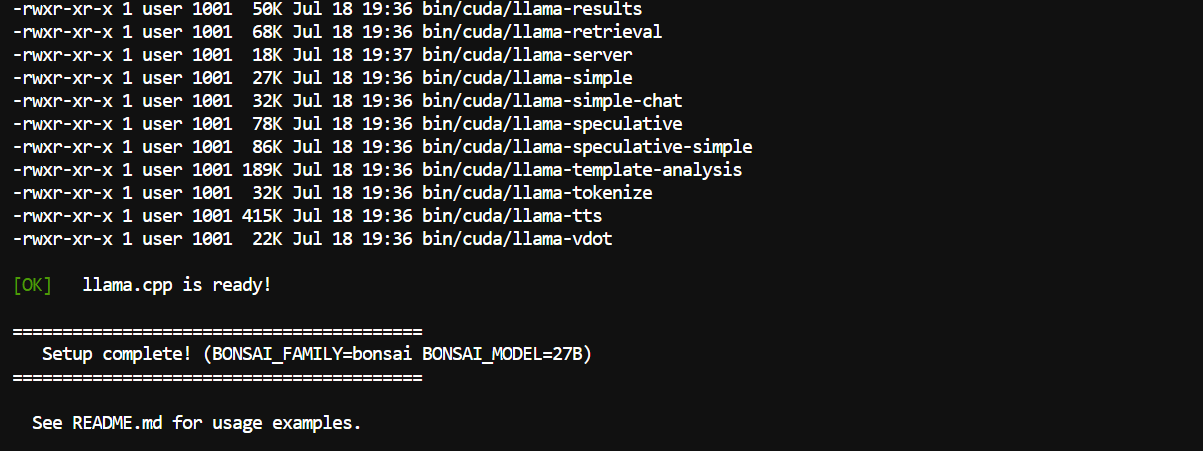
Das automatisierte Setup ist besonders hilfreich, da du llama.cpp nicht selbst kompilieren oder manuell ein CUDA-, ROCm-, Vulkan-, Metal- oder CPU‑Binary auswählen musst.
Wenn du einen schnellen Einstieg brauchst, empfehle ich das llama.cpp‑Tutorial.
Teste das Modell nach der Installation direkt im Terminal mit der enthaltenen llama.cpp‑Kommandozeile:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_CTX=8192 \
./scripts/run_llama.sh \
-p "Create a simple Python function that calculates compound interest."
Dieser Befehl:
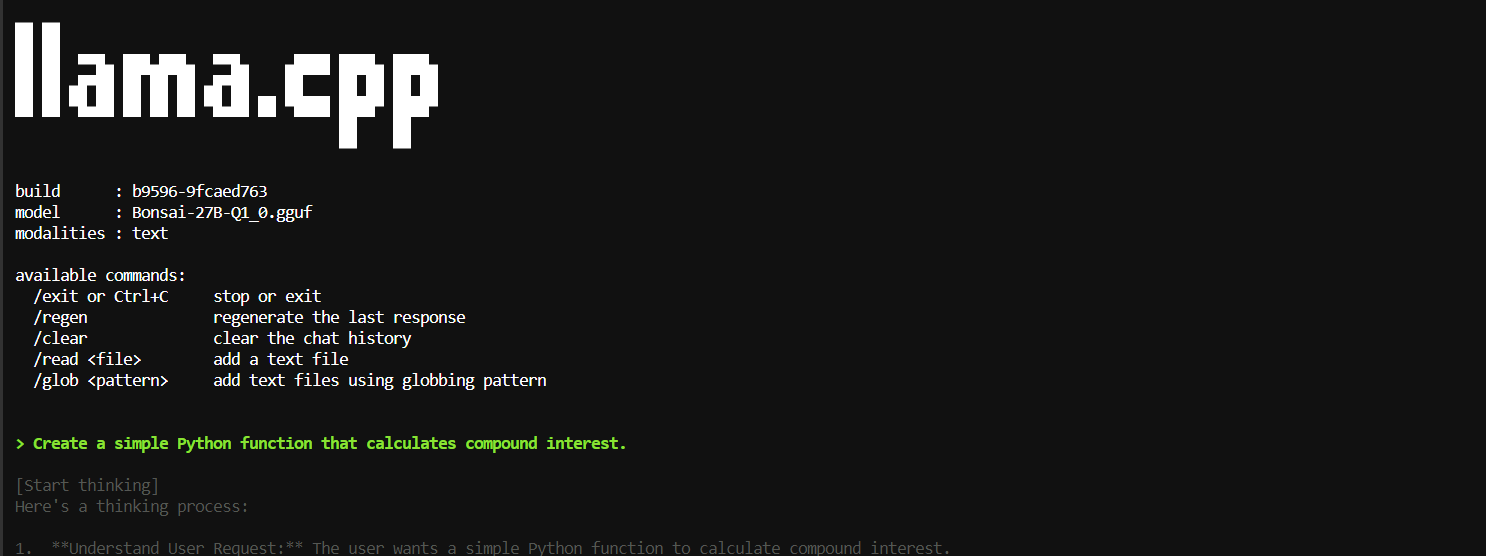
Der erste Start kann etwas dauern, bis das Modell in den Systemspeicher oder die GPU‑VRAM geladen ist.
Sobald alles bereit ist, zeigt das Terminal das aktive Modell, Build‑Informationen und verfügbare Befehle an und generiert dann die Antwort.
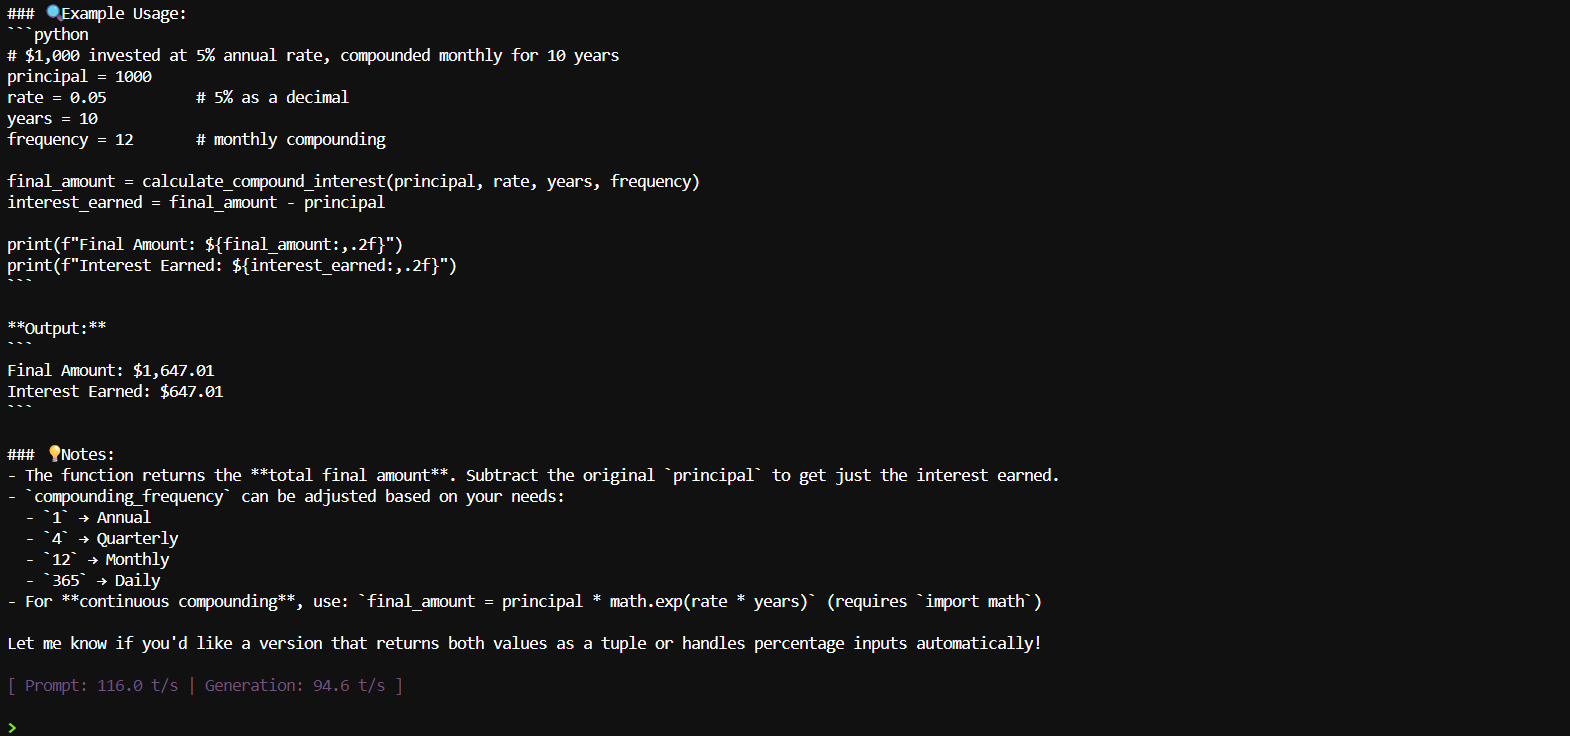
Wie im Output zu sehen, produziert Bonsai zunächst seinen Gedankengang und erstellt anschließend ein vollständiges Python‑Beispiel – inklusive Funktion, Nutzungshinweisen und berechnetem Ergebnis.
Nach der ersten Antwort bleibt die Sitzung offen, sodass du weitere Prompts eingeben kannst, ohne das Modell neu zu starten.
Beende zuerst mit Strg+C die interaktive CLI‑Sitzung aus dem vorherigen Schritt.
Starte dann den lokalen Bonsai‑Server:
BONSAI_FAMILY=bonsai \
BONSAI_MODEL=27B \
BONSAI_CTX=100000 \
./scripts/start_llama_server.sh \
--alias bonsai-27b \
--host 0.0.0.0 \
--port 8910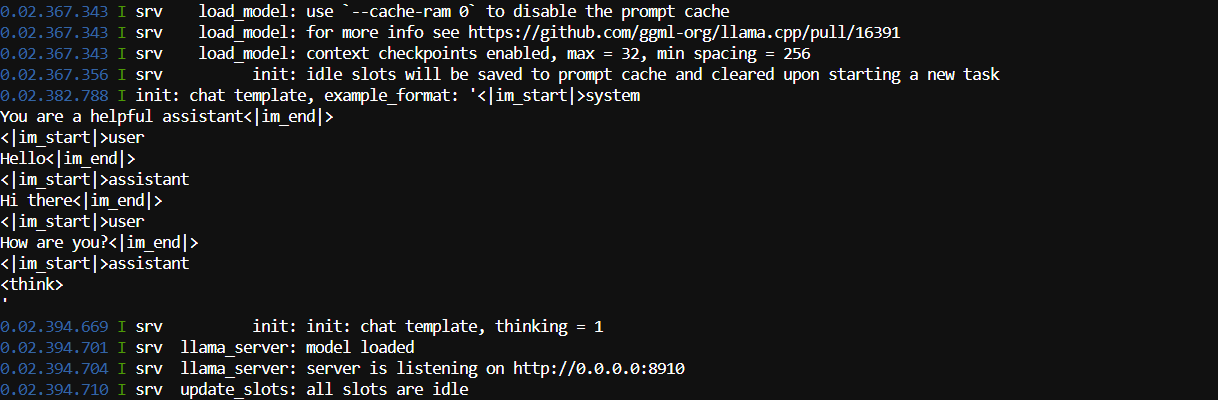
Dieser Befehl:
bonsai-27bEin Kontextfenster mit 100.000 Tokens braucht deutlich mehr Speicher als der frühere CLI‑Test mit 8.192 Tokens. Reduziere BONSAI_CTX, wenn das Modell nicht startet oder deinem System RAM bzw. VRAM ausgeht.
Da --host 0.0.0.0 den Server im lokalen Netzwerk freigibt, nutze das nicht in unzuverlässigen Netzwerken. Für reinen lokalen Zugriff ersetze es durch:
--host 127.0.0.1Lass dieses Terminal geöffnet, solange du das Modell nutzt. Ein Schließen stoppt den Server.
Der Bonsai‑Server bietet:
Die OpenAI‑kompatible API erreichst du unter:
http://127.0.0.1:8910/v1Öffne ein zweites Terminal und sende eine Anfrage an den Chat‑Completions‑Endpunkt:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "bonsai-27b",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function for loading and validating a CSV file."
      }
    ],
    "max_tokens": 1000
  }'
Die Anfrage nutzt den gleichen Aufbau wie die OpenAI Chat Completions API:
model wählt den zuvor angelegten Server‑Aliasmessages enthält die Unterhaltungmax_tokens begrenzt die Zahl der generierten TokensDie API lieferte JSON mit etwa 95 Tokens pro Sekunde, stoppte aber am 1.000‑Token‑Limit. Erhöhe "max_tokens" auf 3000, um vor der Anbindung an Apps, Agents oder Python‑Programme eine vollständige Antwort zu erhalten.
Öffne folgende Adresse im Browser:
http://127.0.0.1:8910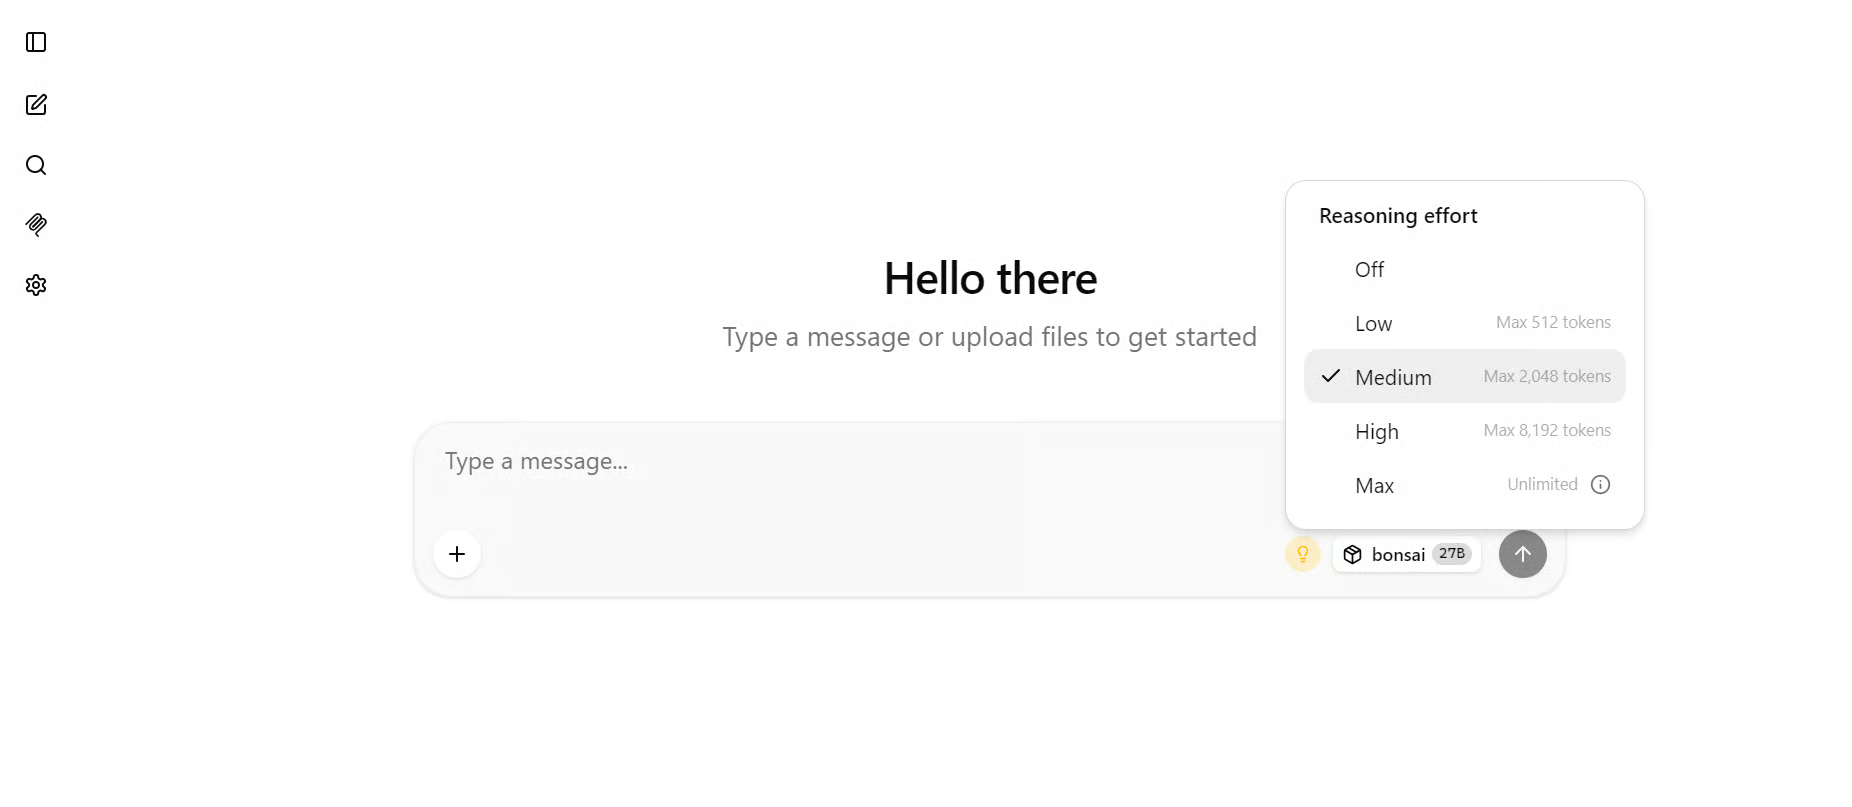
Das integrierte llama.cpp‑Interface ermöglicht Chat mit Bonsai, Dateiuploads und die Anpassung des Reasoning‑Aufwands von Off bis Max.
Teste es mit einem Coding‑Prompt wie:
Create a Python command-line application that converts CSV files to JSON.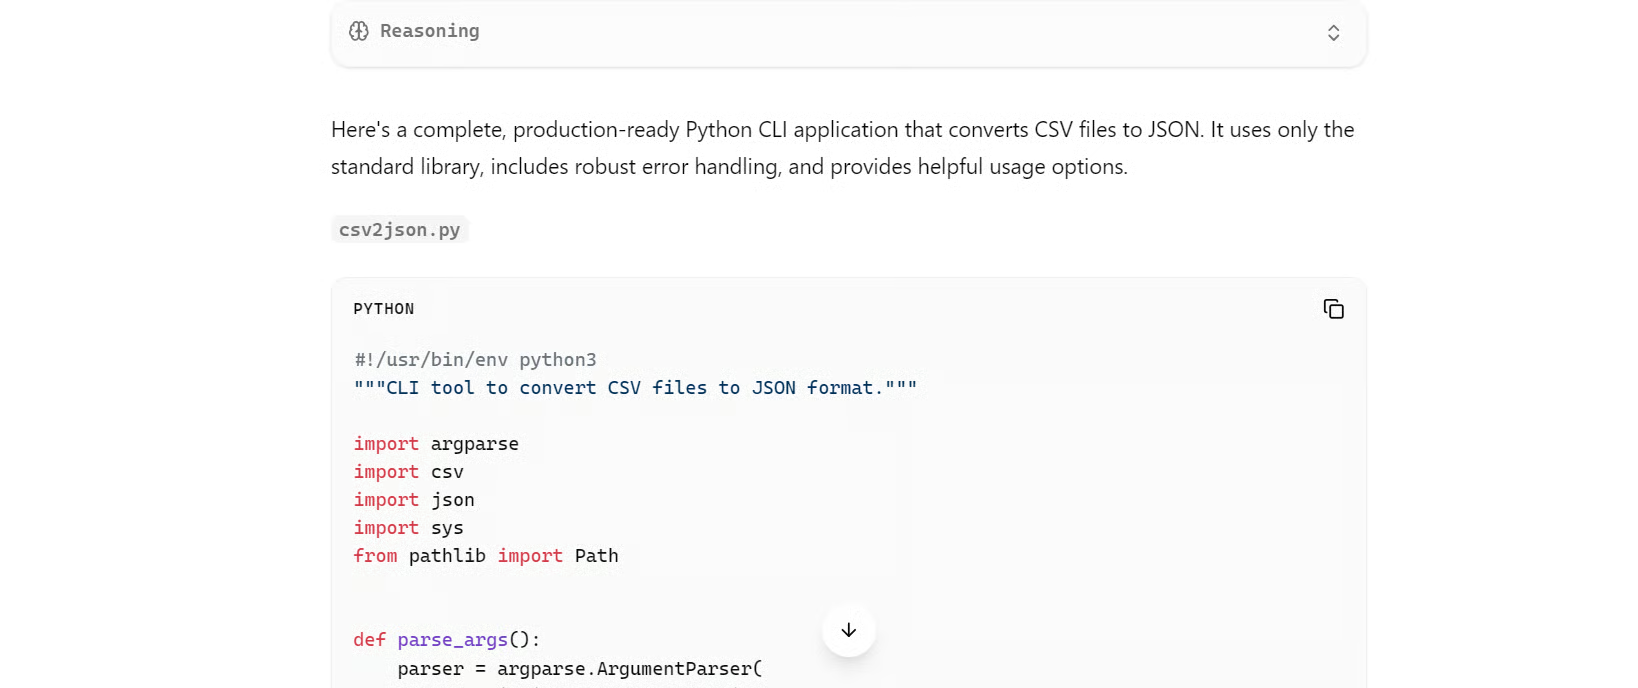
Bonsai generierte ein vollständiges Python‑Script mit rund 92 Tokens pro Sekunde auf meiner RTX 5070 Ti.
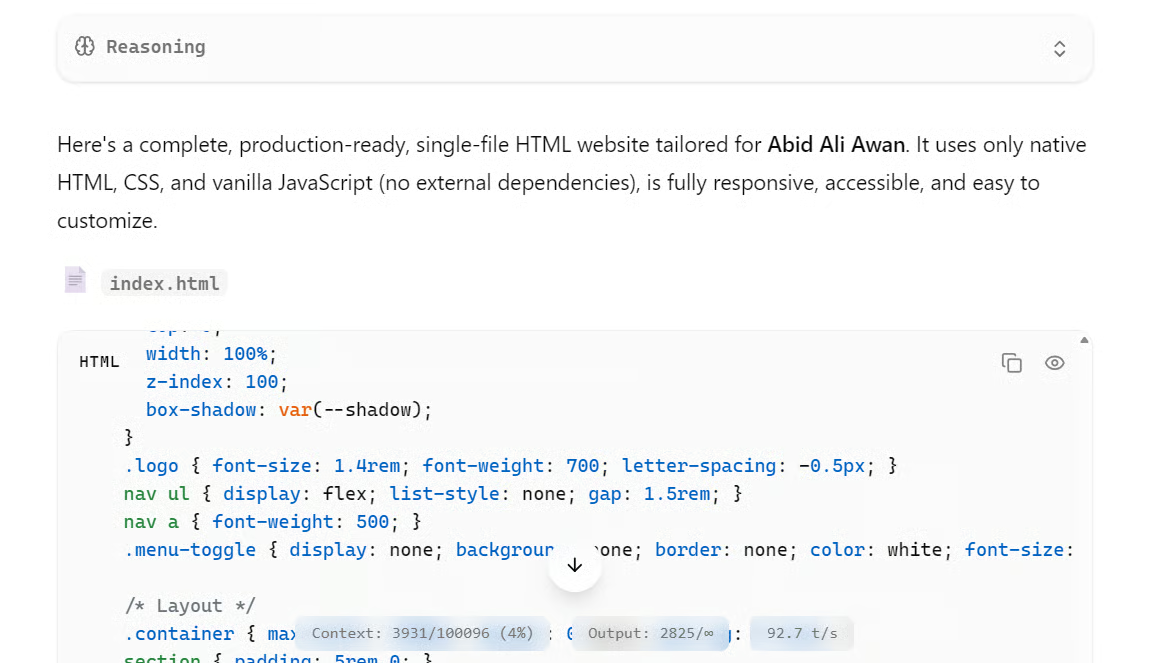
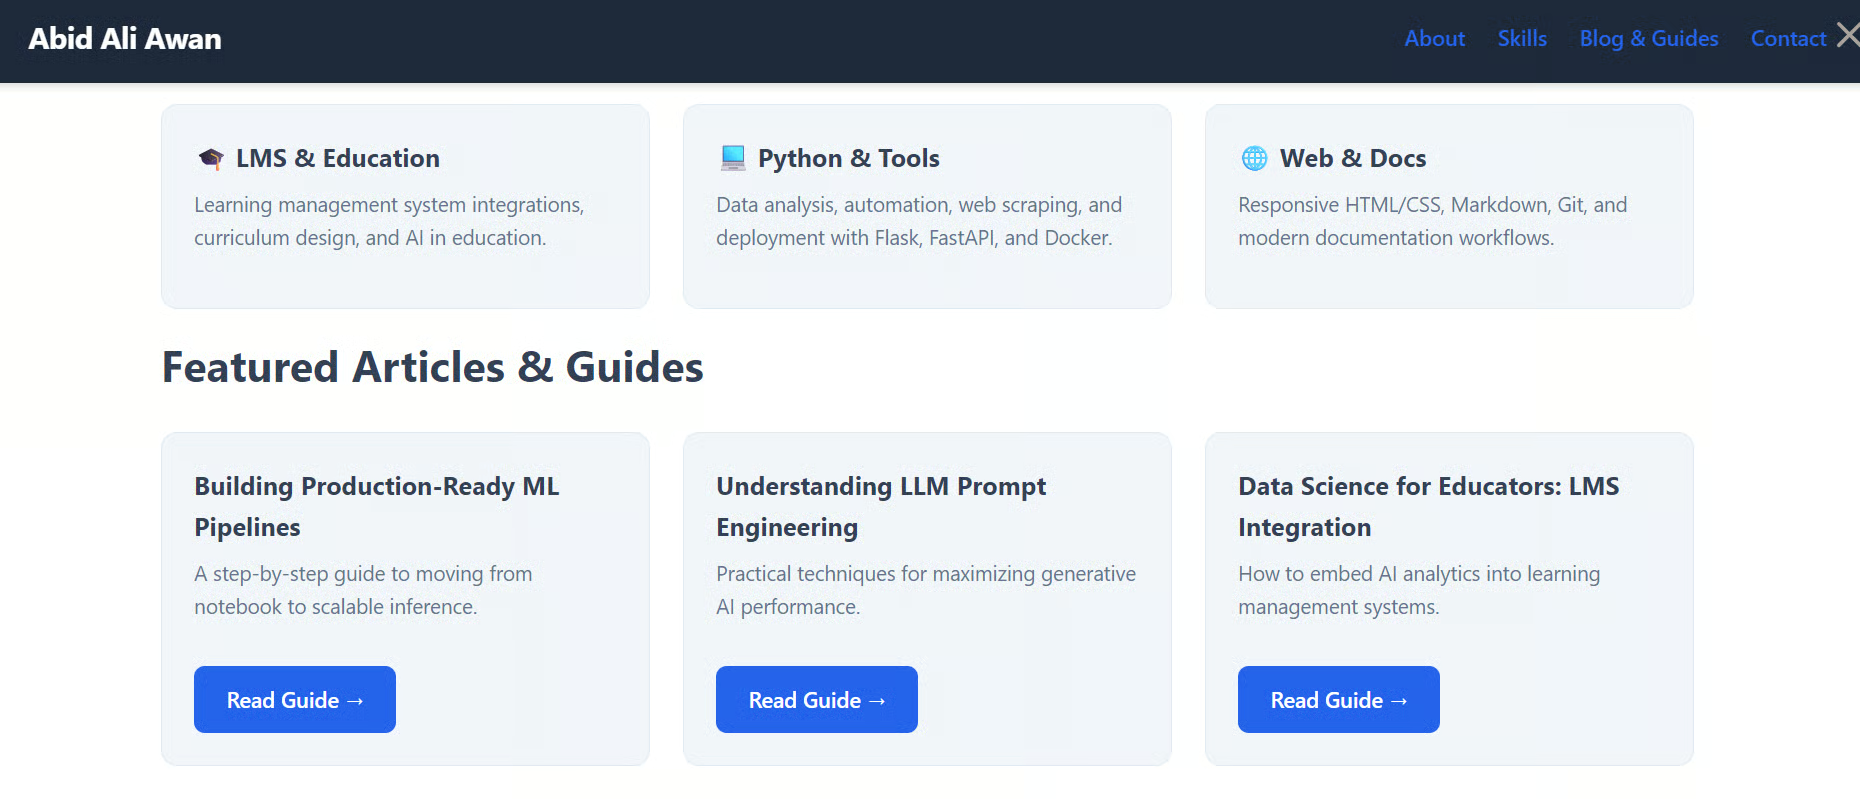
Ich habe es auch gebeten, eine persönliche Portfolio‑Website zu erstellen.
Obwohl der Code funktionierte, war ich mit dem generierten UI nicht zufrieden – das Design wirkte schlicht und austauschbar.
Das zeigt: Bonsai kann funktionsfähigen Code erzeugen, braucht für ein poliertes Interface aber oft detailliertere Prompts und mehrere Iterationen.
Pi ist ein terminalbasierter Coding‑Agent, mit dem wir Bonsai 27B in einem realen agentischen Coding‑Workflow über die lokale OpenAI‑kompatible API testen.
Öffne ein neues Terminal und installiere den Pi Coding Agent:
curl -fsSL https://pi.dev/install.sh | sh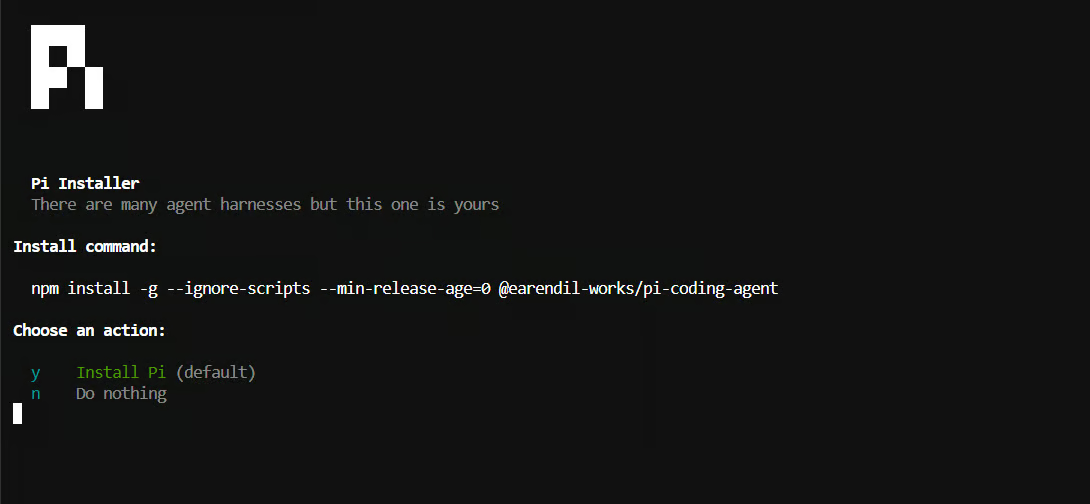
Wenn du dazu aufgefordert wirst, drücke Enter oder tippe y, um mit der Standardinstallation fortzufahren.
Prüfe, ob Pi erfolgreich installiert wurde:
pi --versionZum Testzeitpunkt war die installierte Version:
0.82.0Stelle sicher, dass der Bonsai‑Server noch läuft, öffne dann ein neues Terminal und lege Pis Konfigurationsordner an:
mkdir -p ~/.pi/agentErzeuge die benutzerdefinierte Modellkonfiguration:
nano ~/.pi/agent/models.jsonFüge die folgende Konfiguration ein:
{
  "providers": {
    "bonsai-local": {
      "baseUrl": "http://127.0.0.1:8910/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false
      },
      "models": [
        {
          "id": "bonsai-27b",
          "name": "Bonsai 27B Local",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 100000,
          "maxTokens": 50000,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
Damit verbindet sich Pi mit dem lokalen OpenAI‑kompatiblen Endpunkt, registriert das Modell als Bonsai 27B Local und übernimmt die 100.000‑Token‑Kontexteinstellung des Servers.
Speichere und schließe die Datei:
Ctrl + O
Enter
Ctrl + X
Pi lädt benutzerdefinierte Provider automatisch aus ~/.pi/agent/models.json.
Stelle sicher, dass der Bonsai‑Server noch läuft, und lege dann ein neues Projektverzeichnis an:
mkdir simple-python
cd simple-python
Starte Pi mit dem lokalen Bonsai‑Modell:
pi --provider bonsai-local --model bonsai-27b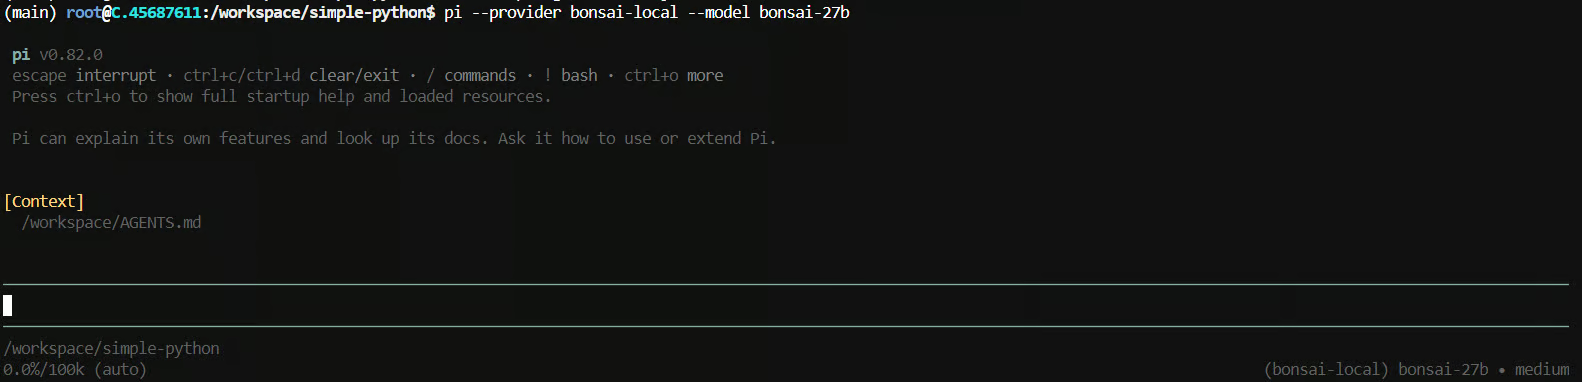
Gib zum Beispiel folgenden Prompt ein:
Build a simple Python application with a FastAPI backend and a modern,
responsive web interface that accepts user input, processes it,
and displays the result.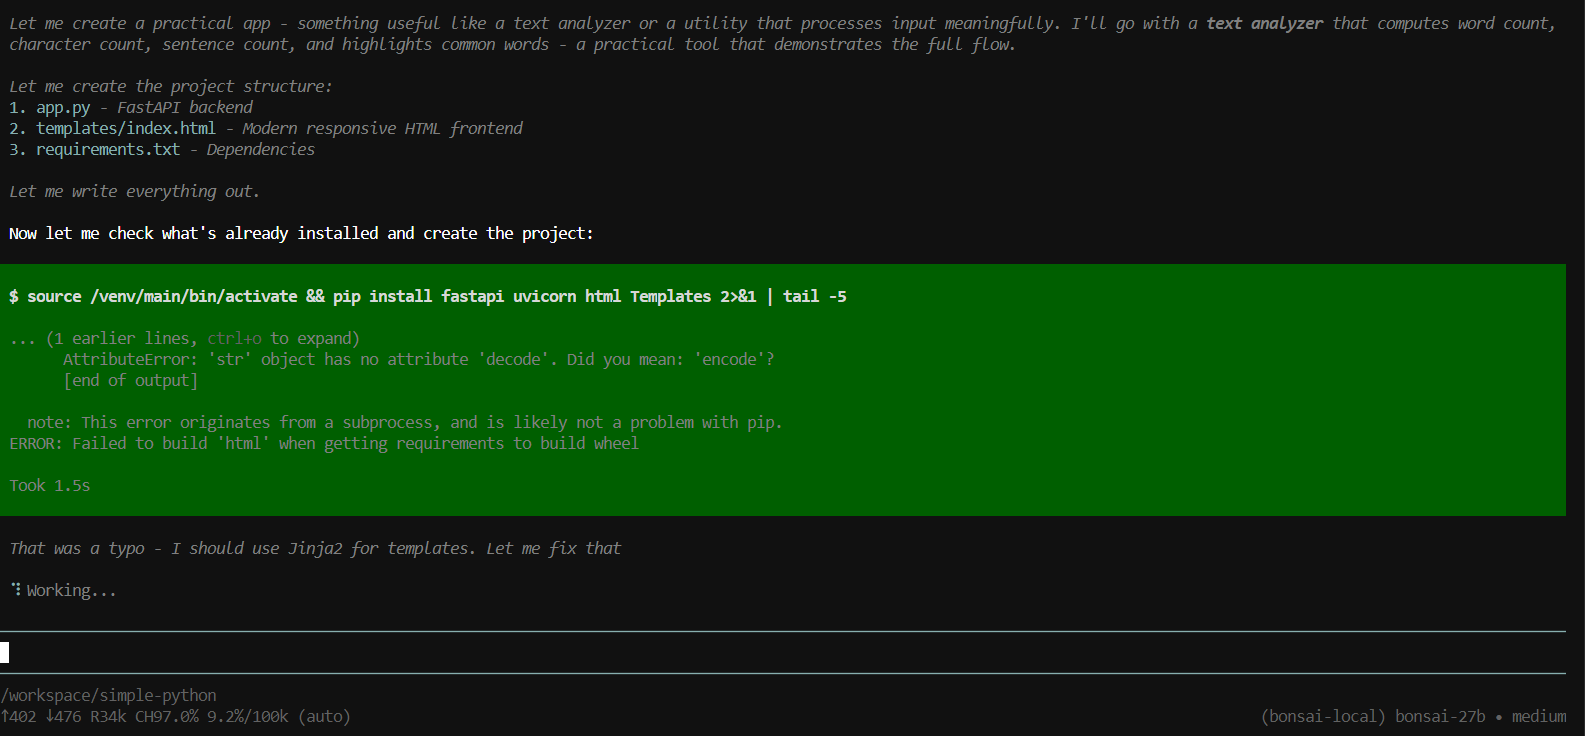
Pi begann zu überlegen, legte Projektdateien an, installierte die nötigen Pakete und erzeugte eine Textanalyse‑App mit FastAPI‑Backend und responsivem Frontend.
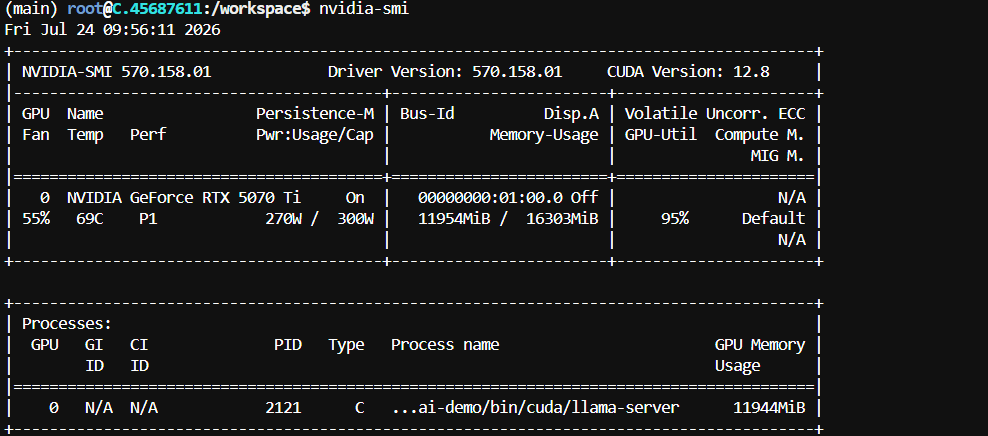
Bei einem Kontextfenster von 100.000 Tokens zeigte nvidia-smi etwa 11,9 GB VRAM‑Nutzung auf meiner RTX 5070 Ti:
Am Ende bestätigte Pi den Abschluss der Aufgabe und lieferte eine klare Zusammenfassung aller Schritte.
Dazu gehörten die erstellten Dateien, die Hauptfunktionen der App, durchgeführte Tests und die exakten Befehle, um das Projekt lokal zu starten.
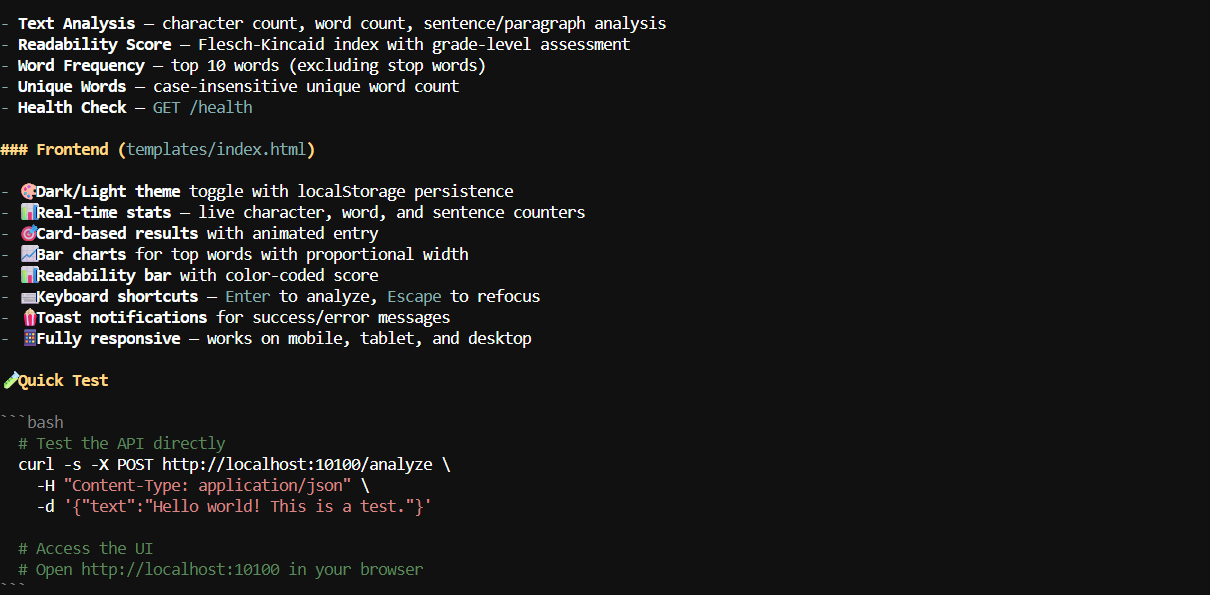
Nach der Generierung fasste Pi die erstellten Dateien und Features zusammen.
Ich habe das Backend mit folgendem Befehl getestet:
curl -s -X POST http://localhost:10100/analyze \
  -H "Content-Type: application/json" \
  -d '{"text":"Hello world! This is a test."}'
Die API funktionierte und das Interface sah besser aus als die zuvor über das einfache Web‑UI generierte Website.
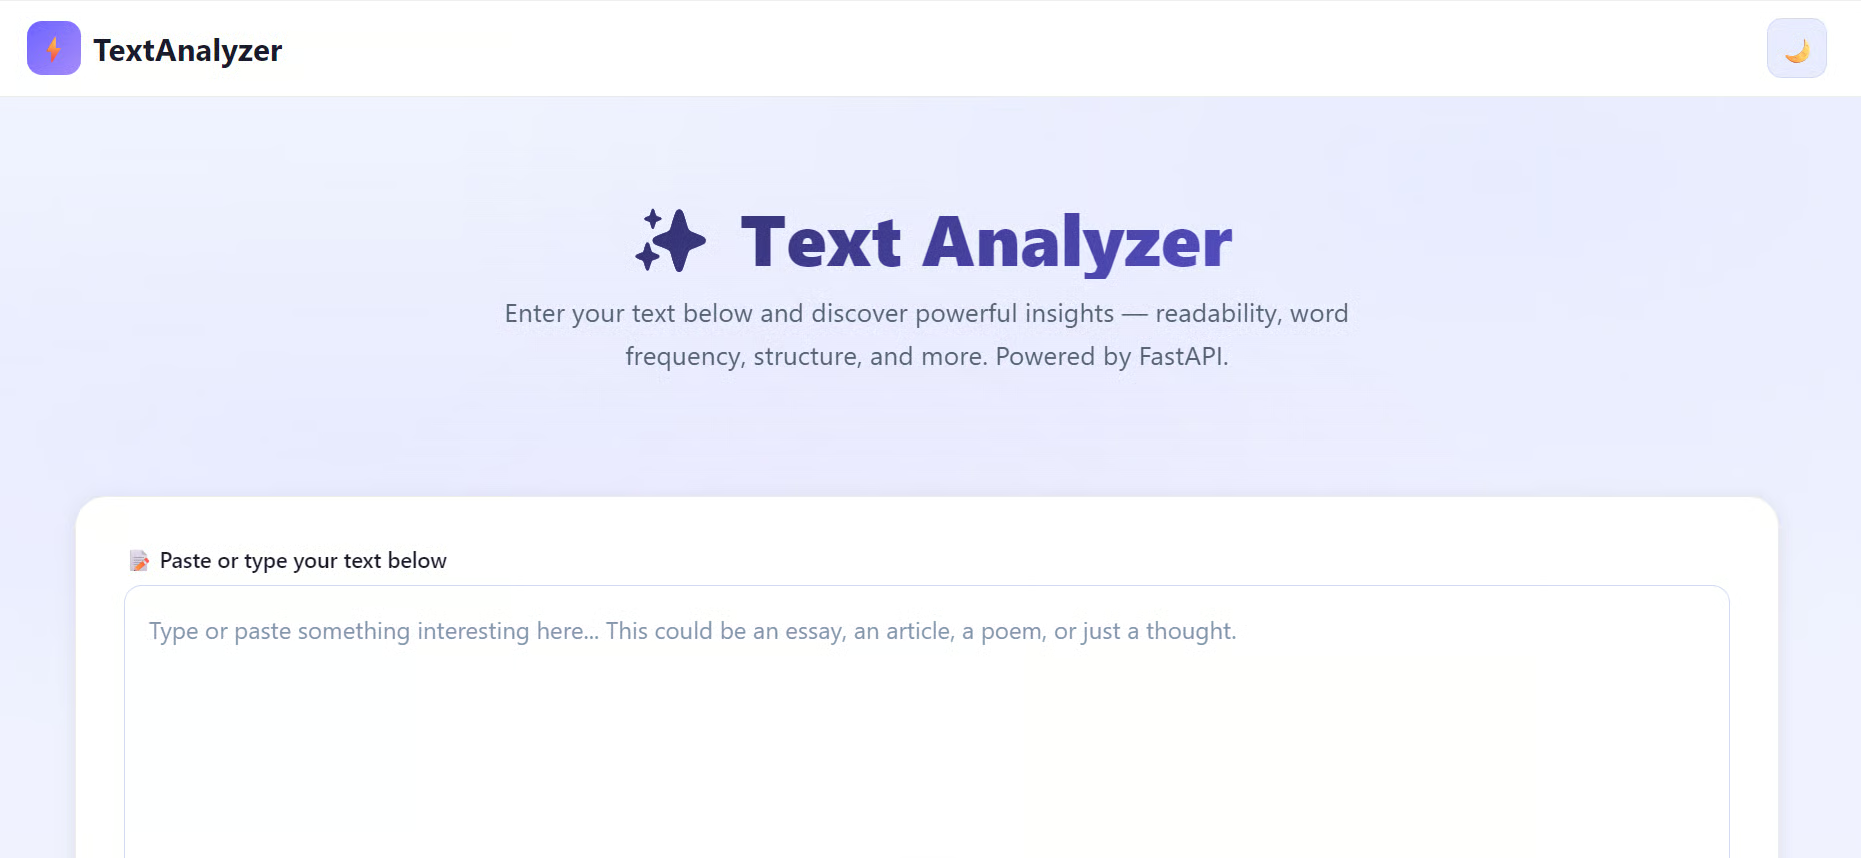
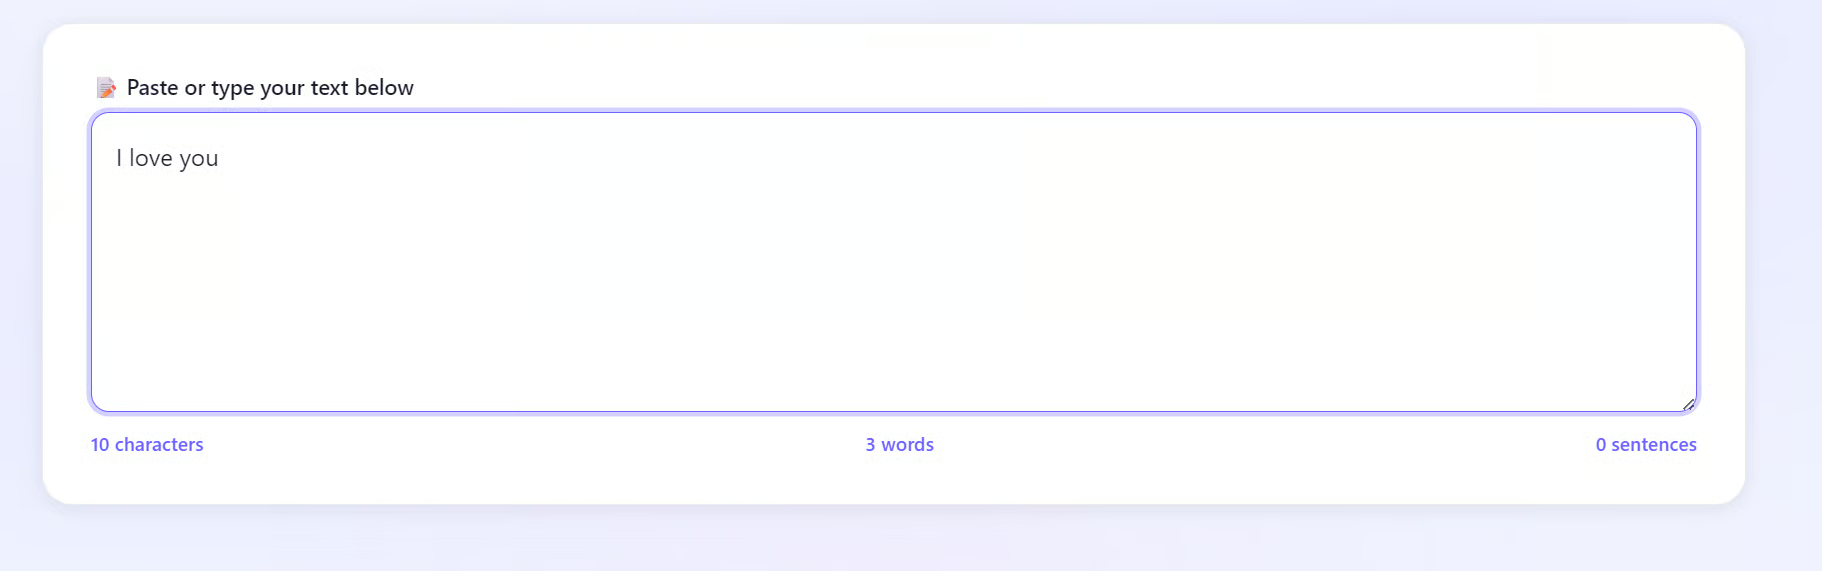
Die Anwendung war jedoch noch nicht vollständig: Einige Buttons und Bedienelemente fehlten, und das Frontend zeigte nicht alle Statistiken der Backend‑API an.
Das zeigt: Bonsai kann eine funktionsfähige Full‑Stack‑App bauen, aber das Ergebnis braucht weiterhin Tests und Feinschliff.
Bonsai 27B fühlt sich in meinen Tests weiterhin wie ein stark komprimiertes Modell an.
Die Ausgabequalität liegt nicht ganz auf dem Niveau eines Q4‑quantisierten Qwen3.6‑27B, das ich zuvor getestet habe und für Coding‑Agent‑Workflows als zuverlässiger empfand.
Die Q4‑Variante braucht mehr Speicher, liefert dafür aber stärkeres Reasoning, bessere Code‑Generierung und konsistentere Ergebnisse.
Trotzdem bleibt Bonsai 27B für ein Modell mit rund 3,8 GB beeindruckend leistungsfähig.
Es versteht Anweisungen, erstellt Projektdateien, führt Befehle aus, testet seine Arbeit und kann lokal funktionsfähige Anwendungen bauen. In dieser Größenklasse gehört es zu den fähigsten Modellen, die ich ausprobiert habe.
Für ernsthafte Coding‑Agent‑Projekte würde ich weiterhin die Q4‑Version von Qwen3.6‑27B wählen – zumal meine RTX 3090 mit 24 GB VRAM das größere Modell problemlos stemmen kann.
Nichtsdestotrotz hat mir Bonsai 27B sehr gefallen – und das größere Prism‑ML‑Ökosystem hat mich beeindruckt. Das automatisierte Setup, die optimierte Runtime, das integrierte Web‑Interface, die OpenAI‑kompatible API und die Agent‑Integrationen machen es deutlich einfacher, ein großes Reasoning‑Modell lokal auf Consumer‑Hardware zu betreiben und zu erleben.
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad