Curso
Creación de agentes de IA con Google ADK
1 h
7.5K
Qwen3-Coder es un modelo de código agentivo avanzado diseñado para que los desarrolladores generen y automaticen código con más potencia. Está disponible en varios tamaños, siendo su lanzamiento estrella el Qwen3-Coder-480B-A35B-Instruct.
Este modelo Mixture-of-Experts de 480.000 millones de parámetros cuenta con 35.000 millones de parámetros activos y marca un nuevo estándar entre los modelos de código de código abierto. Ofrece rendimiento puntero en Agentic Coding, uso agentivo del navegador y tareas de programación de base, con resultados comparables a modelos líderes como Claude Sonnet.
En este tutorial aprenderás a ejecutar Qwen3-Coder en local, usarlo con aplicaciones de chat como Msty, integrarlo con el Copilot de VSCode, configurar la extensión Kilo Code para flujos de trabajo agentivos avanzados y, por último, usar el framework de Python para integrarlo en una aplicación local.
También puedes consultar nuestras guías sobre Qwen3 y Qwen Code CLI para ampliar información.
Ollama ha mejorado muchísimo en los últimos meses y ahora ofrece una app de chat muy cómoda, similar a ChatGPT. Con la nueva app puedes descargar y ejecutar modelos de IA directamente desde la interfaz gráfica, haciendo que la IA en local sea más accesible que nunca.
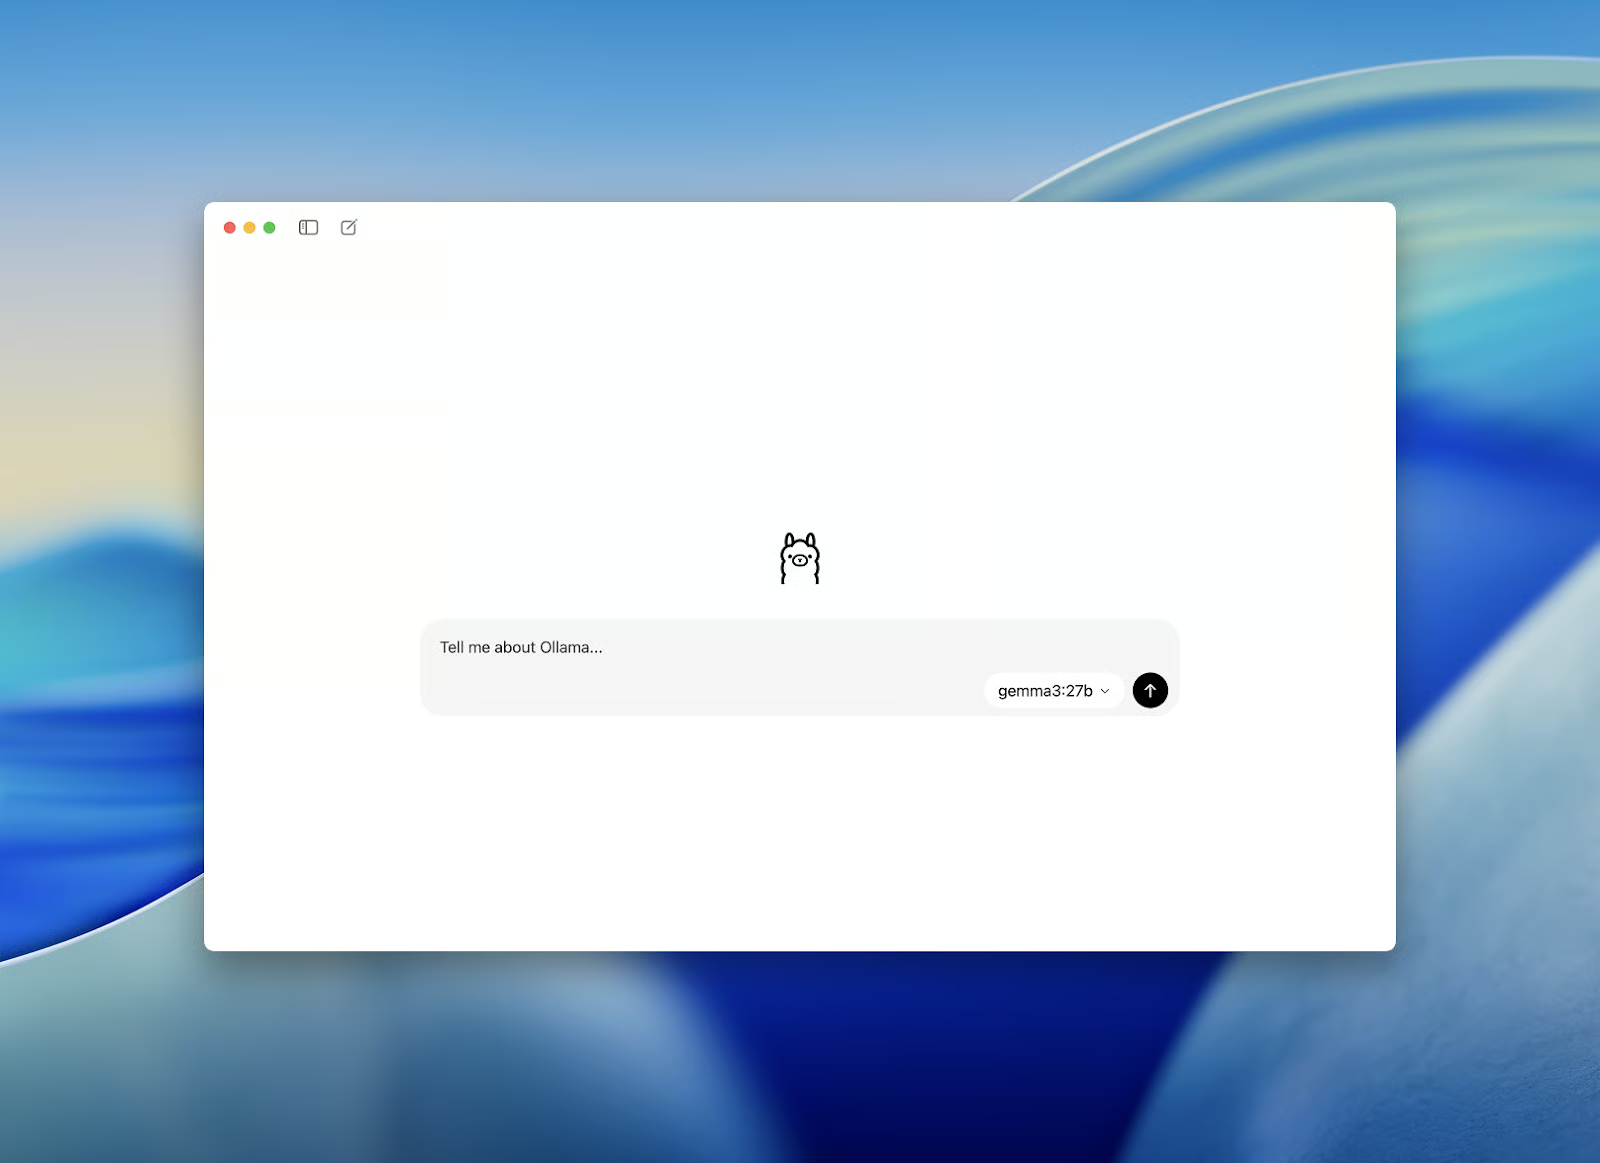
Fuente: Ollama's new app
Para Windows y macOS: visita la página de descargas y descarga el instalador para tu sistema operativo. La instalación es muy simple: sigue los pasos del asistente y listo.
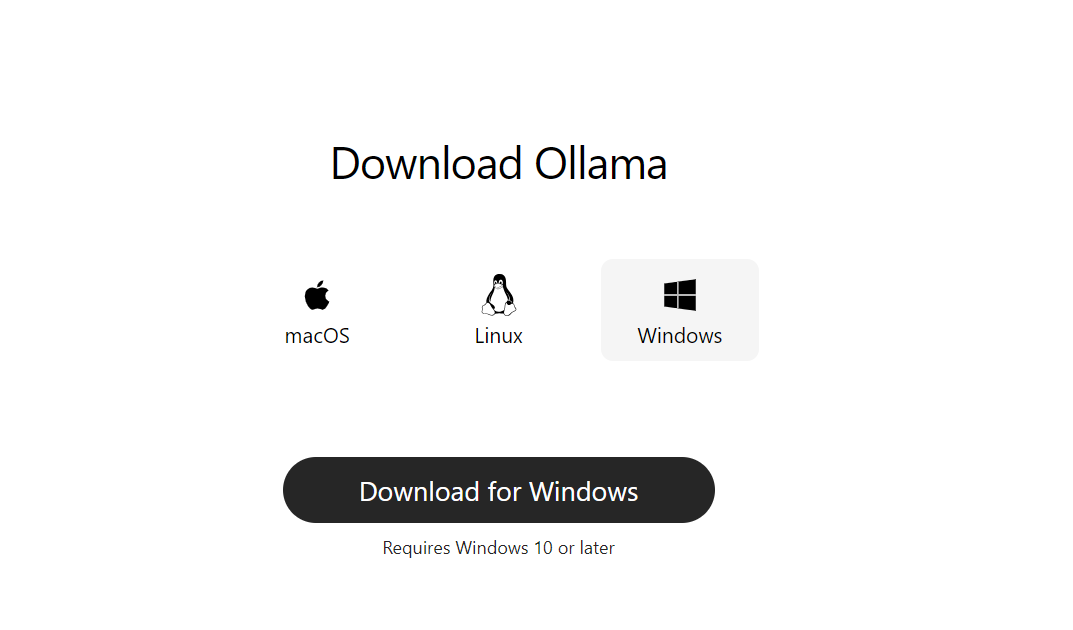
Fuente: Download Ollama
Para Linux: abre la terminal y ejecuta este comando. Descargará e instalará Ollama automáticamente en tu sistema.
curl -fsSL https://ollama.com/install.sh | sh Si aparece un mensaje indicando que no se detecta la GPU, tendrás que instalar un par de utilidades del sistema:
sudo apt update
sudo apt install -y pciutils lshw
Para compatibilidad con GPU NVIDIA, instala el controlador y el toolkit de CUDA:
sudo apt install -y nvidia-driver-525 nvidia-cuda-toolkitUna vez instalado, lanza la app de Ollama y empieza a descargar modelos o a chatear directamente desde la interfaz. Así podrás experimentar fácilmente con modelos de IA en local, ya uses Windows, macOS o Linux.
Para empezar con Qwen3-Coder, ve a la pestaña Models del sitio web de Ollama y busca “qwen3-coder”.
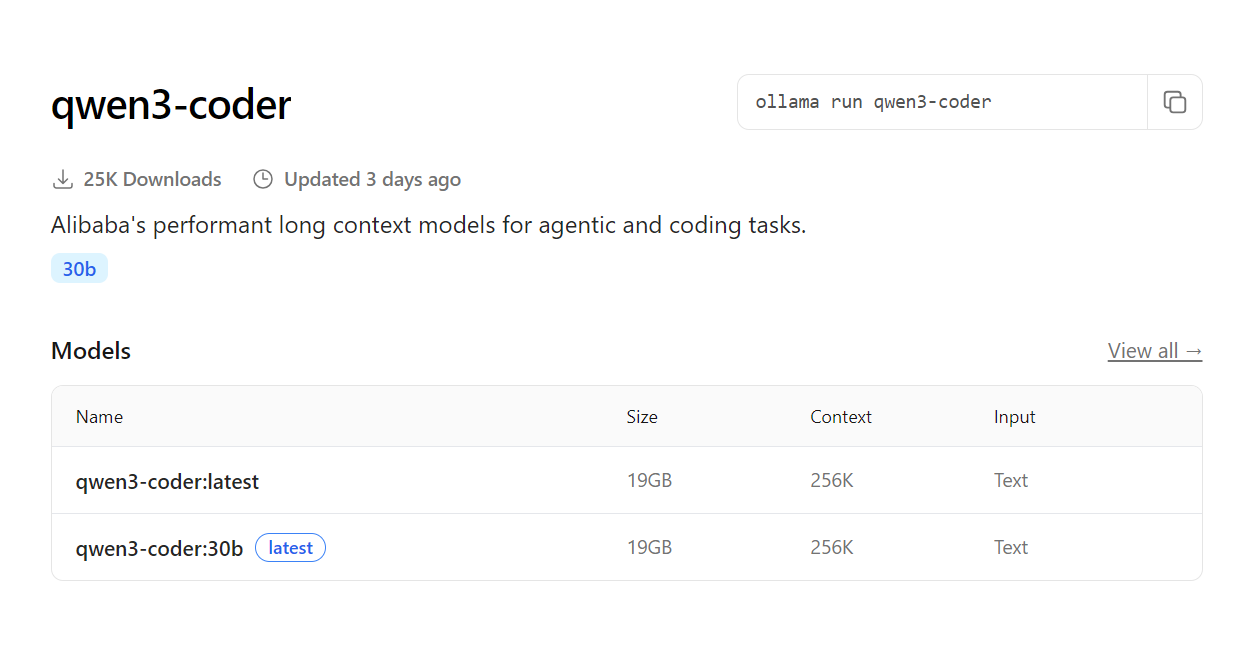
Fuente: qwen3-coder
Cuando lo encuentres, copia el comando de instalación y ejecútalo en tu terminal para descargar y poner en marcha el modelo:
ollama run qwen3-coderSegún tu velocidad de Internet, la descarga puede tardar unos minutos. Al terminar, el modelo estará listo para usarse directamente desde la terminal.
Puedes empezar a chatear o pedirle que te ayude a crear una app en el momento.
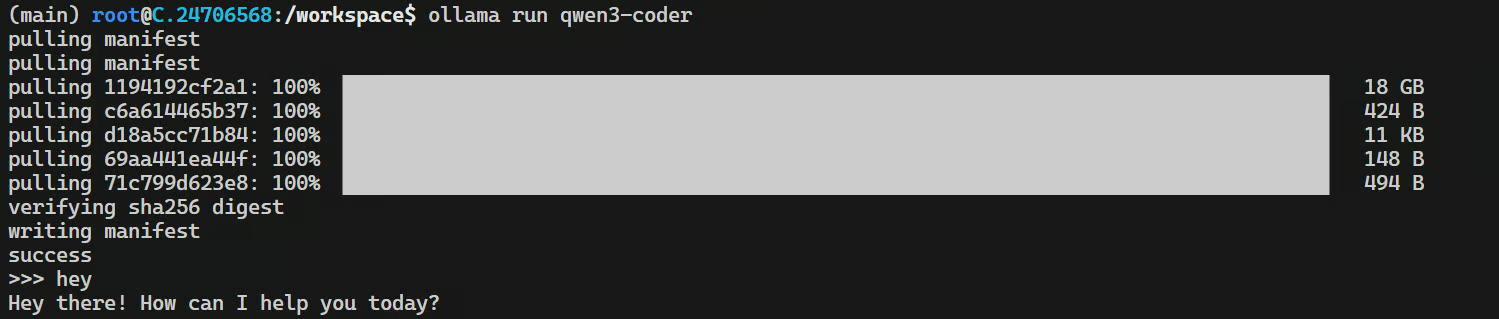
Aunque Ollama ya incluye una app de chat integrada, puedes sacarle mucho más partido conectando Qwen3-Coder con herramientas y aplicaciones avanzadas.
Para ello, necesitas servir el modelo como un endpoint de API:
ollama serveEste comando inicia un servidor compatible con OpenAI en http://localhost:11434/, lo que facilita conectar Qwen3-Coder con tus herramientas y flujos de desarrollo favoritos.
Msty es mi app de referencia para probar modelos de lenguaje grandes, tanto locales como propietarios. Está repleta de funciones útiles y encaja a la perfección con el servidor de Ollama. Visita la web oficial de Msty e instala la app para tu plataforma.
Después,
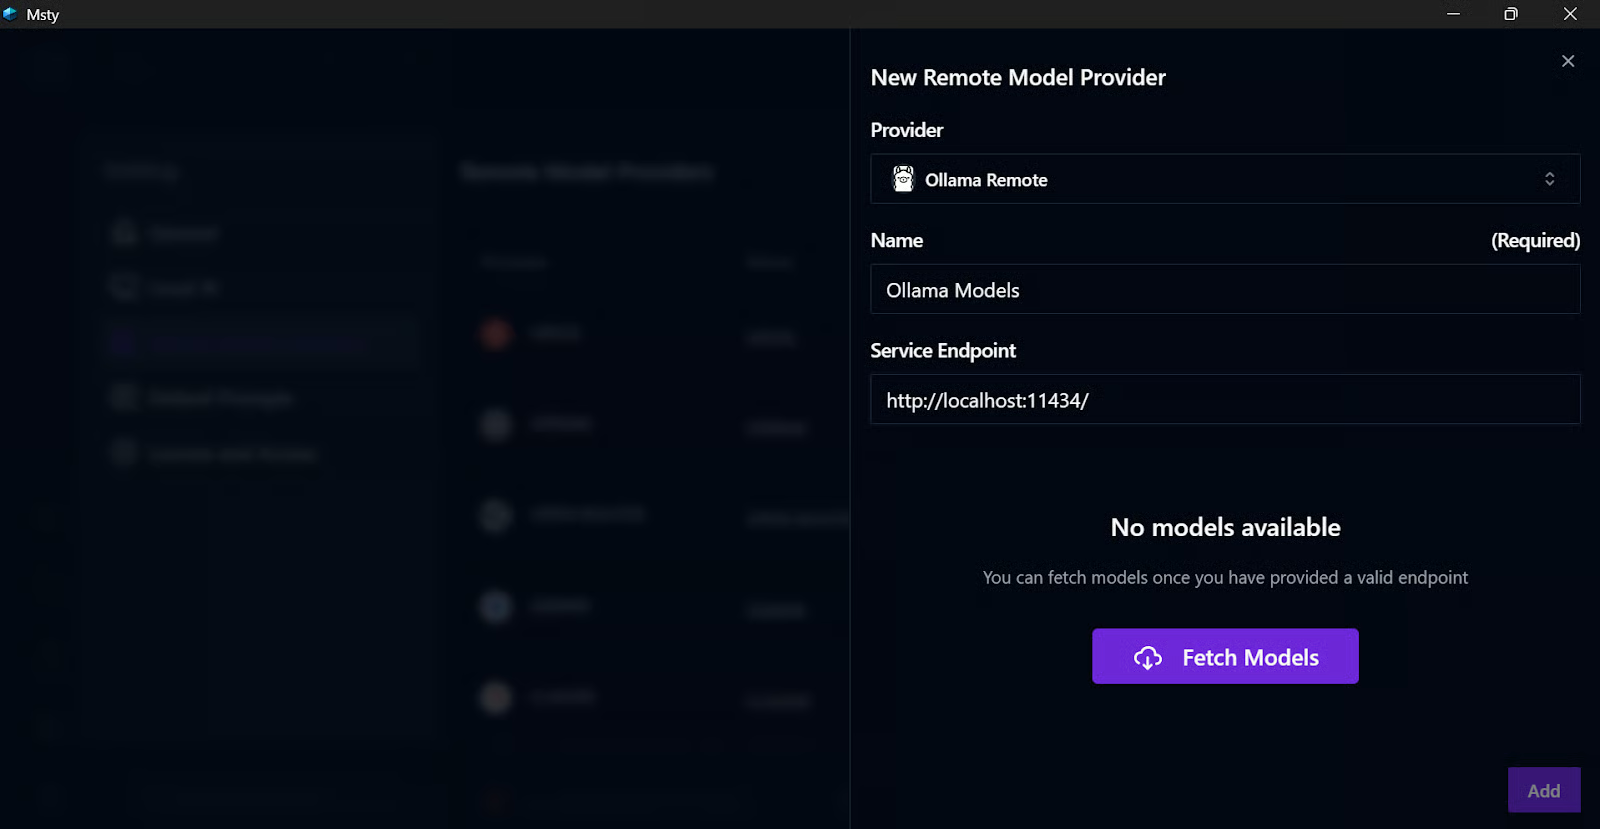
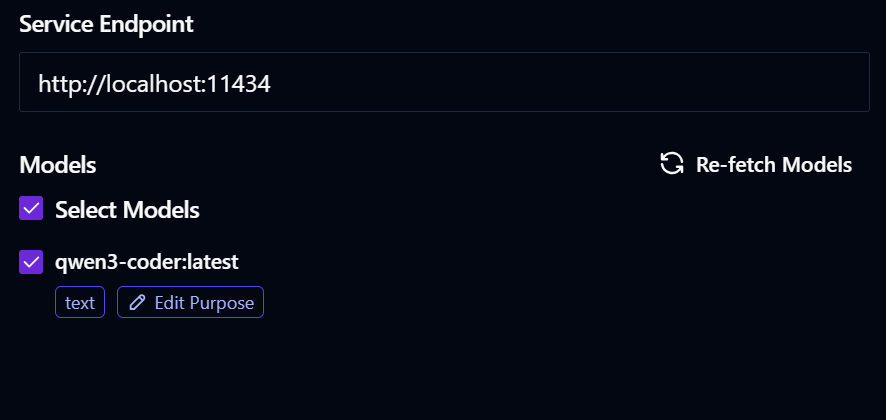
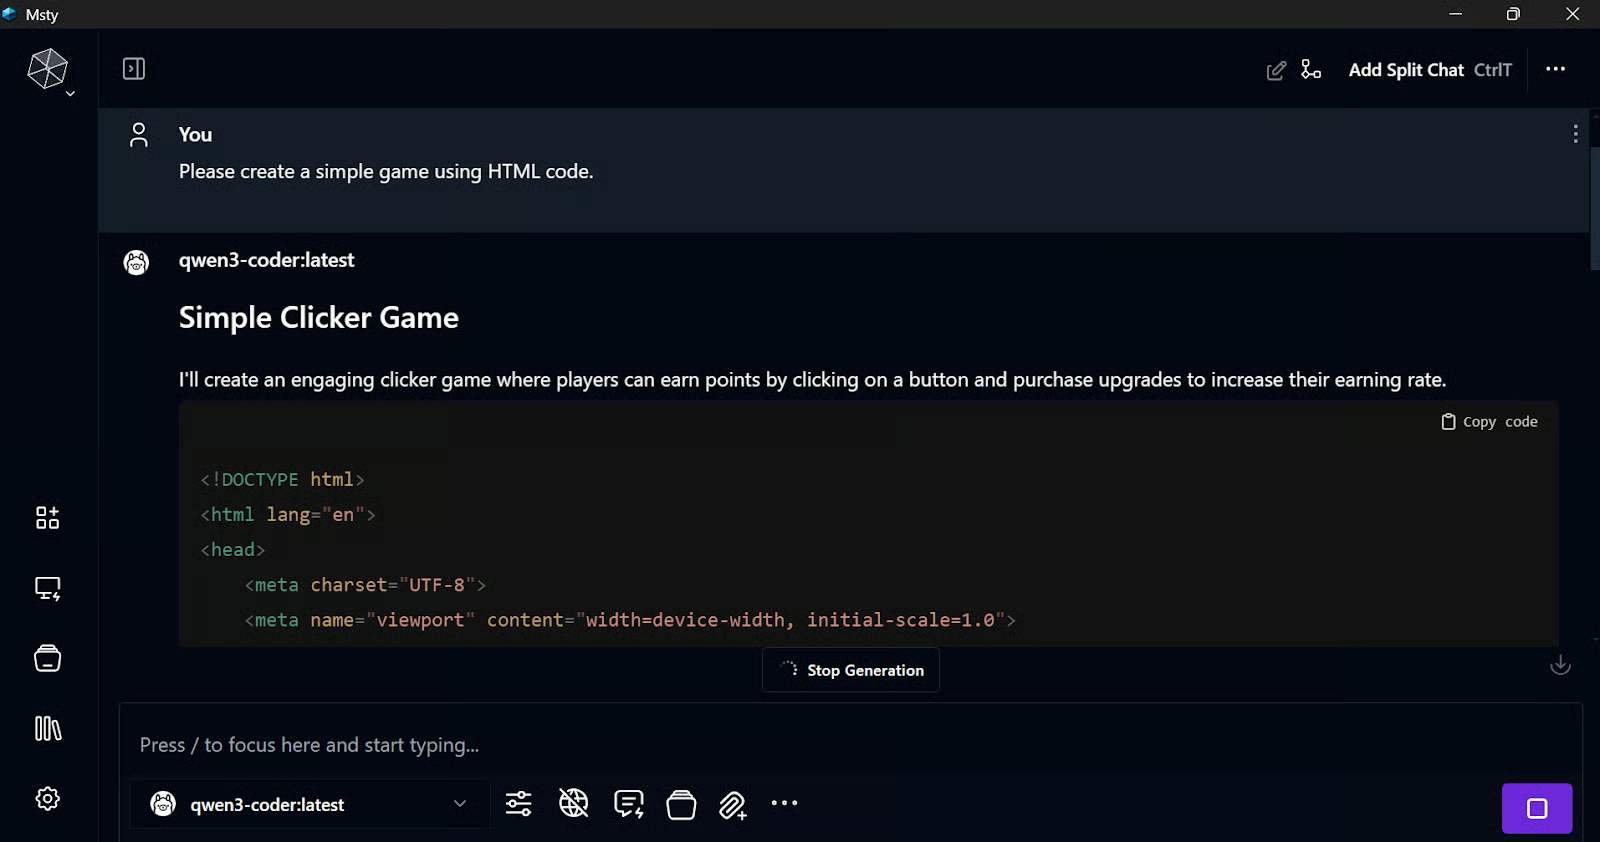
La integración es sencilla y muy versátil. Con Ollama serve puedes conectar modelos de Ollama a múltiples apps y herramientas para desbloquear aún más posibilidades creativas.
Como sabes, Qwen3-Coder está pensado específicamente para programar y para flujos agentivos. Si no lo integramos en nuestro editor, estamos perdiendo gran parte de su potencial.
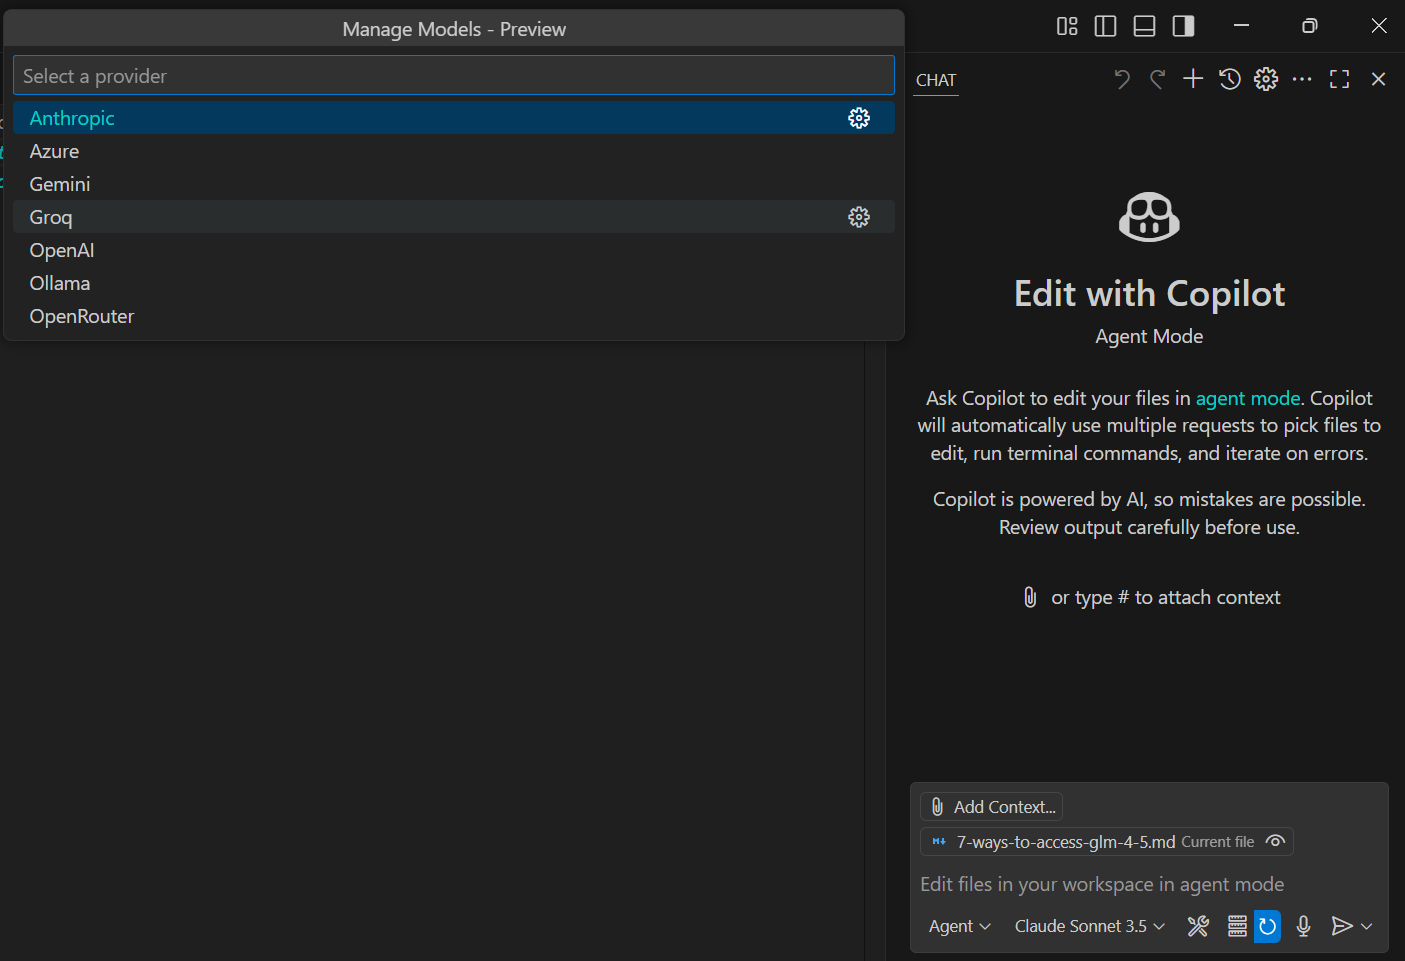
Ahora lo integraremos en GitHub Copilot en VS Code. Las instalaciones recientes de VS Code ya incluyen la extensión de Copilot. Solo tienes que hacer clic en el menú de selección de modelo en la parte inferior, luego en el enlace “Manage Models” y elegir Ollama como proveedor de modelos. Verás los modelos disponibles: selecciona Qwen3-Coder y empieza a usar el chat de GitHub Copilot como siempre.
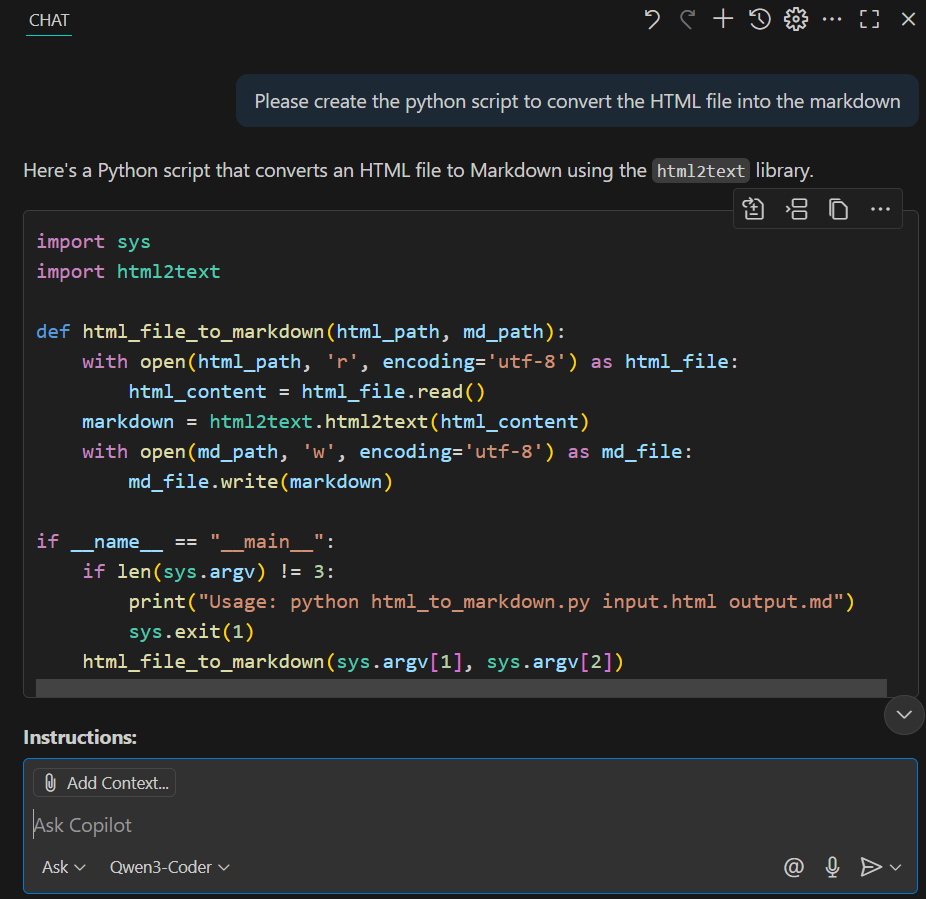
Le pedimos que creara un script para convertir HTML a Markdown y tardó solo 10 segundos en generar la respuesta completa.
Es rápido, local y fácil de usar.
La extensión de VSCode Kilo-Org/kilocode está ganando popularidad como uno de los mejores asistentes de código de IA de código abierto para planificar, construir y corregir código.
Para integrar nuestro modelo Qwen3-Coder en local, primero instala las extensiones necesarias y ve a la configuración. Cambia el proveedor de API a Ollama y detectará automáticamente el modelo desde la URL predeterminada.
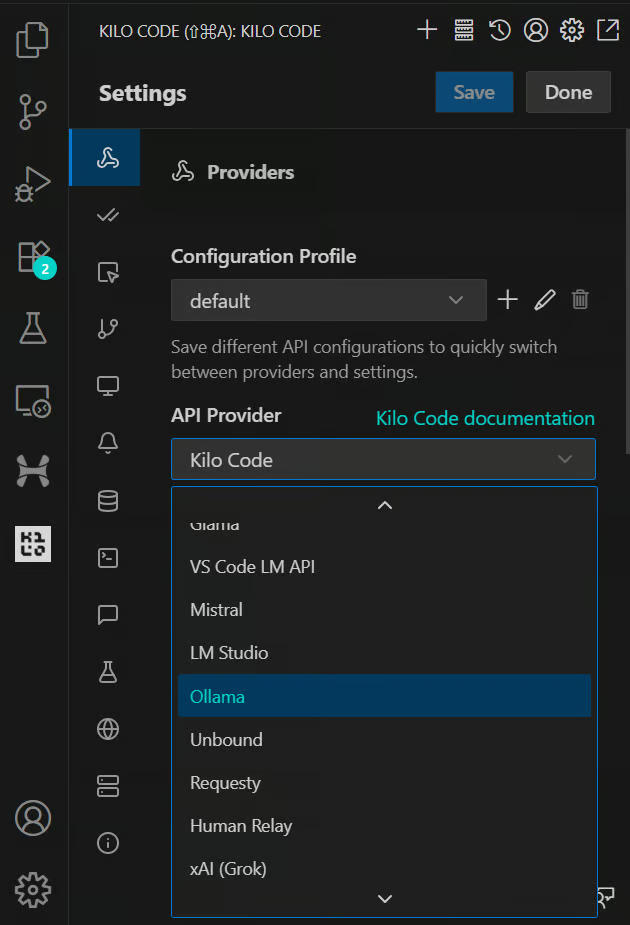
Después, vuelve al chat y pídele a la IA que construya un servidor de IA sencillo. Primero examinará todos los archivos del proyecto y luego te propondrá la mejor solución para tu consulta.
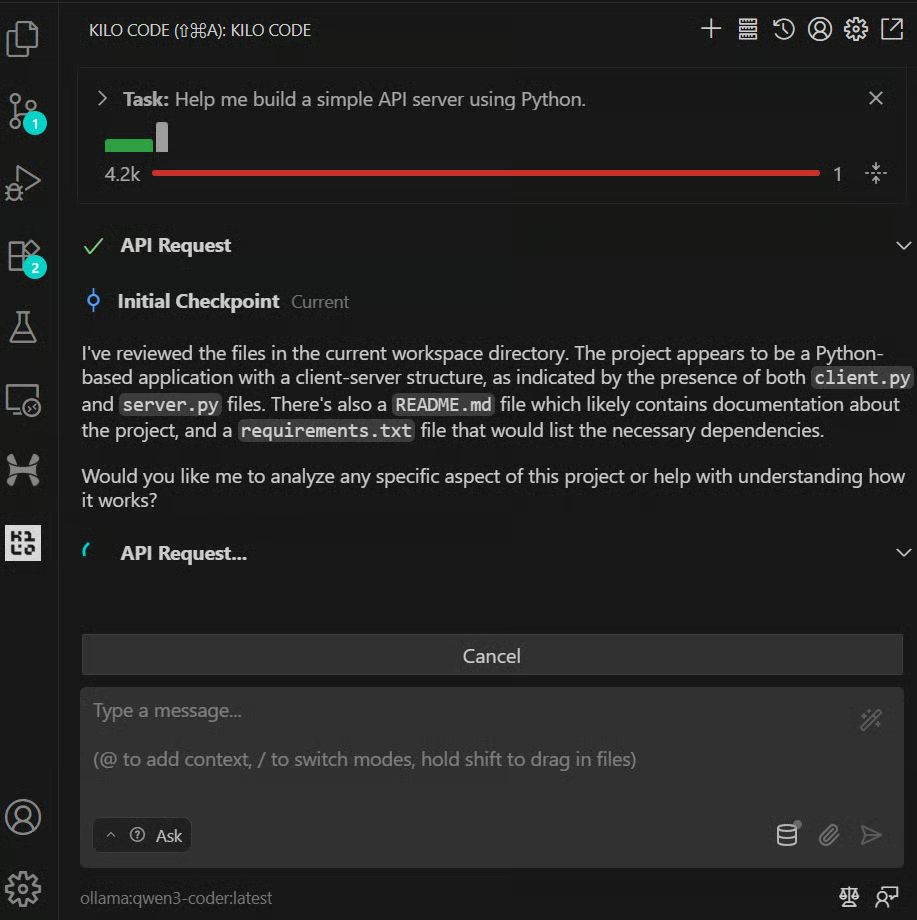
Integrar Qwen3-Coder en tus aplicaciones de Python es muy sencillo con el paquete de Python ollama/ollama-python. Te permite ejecutar modelos de IA potentes en local e incorporarlos directamente a tus flujos de trabajo
Para empezar, instala el paquete de Ollama:
pip install ollamaAquí tienes un ejemplo mínimo de cómo usar Qwen3-Coder en tu código Python, similar a llamar a la API de OpenAI:
from ollama import chat

def main():
    # Define a system + user prompt
    messages = [
        {"role": "system", "content": "You are a helpful coding assistant."},
        {
            "role": "user",
            "content": (
                "Please write a Python function `quicksort(arr)` "
                "that takes a list of integers and returns it sorted."
            ),
        },
    ]

    # Stream the response from Qwen3-Coder
    stream = chat(
        model="Qwen3-Coder",
        messages=messages,
        stream=True
    )

    # Print chunks as they arrive
    for chunk in stream:
        # chunk is a dict-like with ['message']['content']
        print(chunk["message"]["content"], end="", flush=True)

    # Finish with a newline
    print()

if __name__ == "__main__":
    main()
La respuesta empieza a emitirse casi al instante. La solución de quicksort siguiente tardó solo 15 segundos en generarse:
Here's a Python implementation of the quicksort algorithm:

```python
def quicksort(arr):
    """
    Sorts a list of integers using the quicksort algorithm.

    Args:
        arr: List of integers to be sorted

    Returns:
        A new list containing the sorted integers
    """
    # Base case: arrays with 0 or 1 element are already sorted
    if len(arr) <= 1:
        return arr

    # Choose pivot (using the middle element)
    pivot = arr[len(arr) // 2]

    # Partition the array into three parts
    left = [x for x in arr if x < pivot]      # Elements less than pivot
    middle = [x for x in arr if x == pivot]   # Elements equal to pivot
    right = [x for x in arr if x > pivot]     # Elements greater than pivot

    # Recursively sort left and right parts, then combine
    return quicksort(left) + middle + quicksort(right)

# Example usage:
if __name__ == "__main__":
    # Test cases
    print(quicksort([64, 34, 25, 12, 22, 11, 90]))  # [11, 12, 22, 25, 34, 64, 90]
    print(quicksort([5, 2, 8, 1, 9]))               # [1, 2, 5, 8, 9]
    print(quicksort([1]))                           # [1]
    print(quicksort([]))                            # []
    print(quicksort([3, 3, 3, 3]))                  # [3, 3, 3, 3]
```Esta guía demuestra lo accesible que se ha vuelto la IA en local. Hoy puedes ejecutar modelos de código abierto en un portátil antiguo e integrarlos en tus editores, aplicaciones de chat o incluso crear apps de IA locales a medida con el SDK de Python de Ollama.
También hay otras opciones, como usar Qwen Code CLI (lo tratamos en esta guía aparte: Qwen Code CLI: A Guide With Examples | DataCamp), o servir modelos en un servidor local y acceder a ellos por SSH desde varios equipos. Las posibilidades crecen a gran velocidad, haciendo que la IA en local sea más práctica y versátil que nunca.
Los mejores cursos de IA
Curso
Curso
Curso
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Tutorial
Moez Ali
11 min
Tutorial
Adel Nehme
9 min
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
12 min