
Kurs
KI-Agenten mit dem Google ADK entwickeln
1 Std.
7.5K
Qwen3-Coder ist ein fortschrittliches agentisches Codemodell, das Entwickler bei Codegenerierung und Automatisierung noch besser unterstützt. Es ist in mehreren Größen verfügbar, das Flaggschiff ist Qwen3-Coder-480B-A35B-Instruct.
Dieses Mixture-of-Experts-Modell mit 480 Milliarden Parametern hat 35 Milliarden aktive Parameter und setzt neue Maßstäbe für Open-Source-Codemodelle. Es liefert Spitzenleistung in Agentic Coding, agentischer Browser-Nutzung und grundlegenden Codieraufgaben – auf Augenhöhe mit führenden Modellen wie Claude Sonnet.
In diesem Tutorial zeigen wir, wie du Qwen3-Coder lokal ausführst, ihn mit Msty-Chat-Apps nutzt, in den VSCode Copilot integrierst, die Kilo-Code-Erweiterung für fortgeschrittene agentische Code-Workflows einrichtest und schließlich per Python-Framework in eine lokale Anwendung einbindest.
Mehr Hintergründe findest du in unseren separaten Guides zu Qwen3 und der Qwen Code CLI.
Ollama hat in den letzten Monaten große Fortschritte gemacht und bietet jetzt eine benutzerfreundliche Chat-App ähnlich wie ChatGPT. Mit der neuen App kannst du KI-Modelle direkt über die grafische Oberfläche herunterladen und starten – lokales KI-Computing war noch nie so zugänglich.
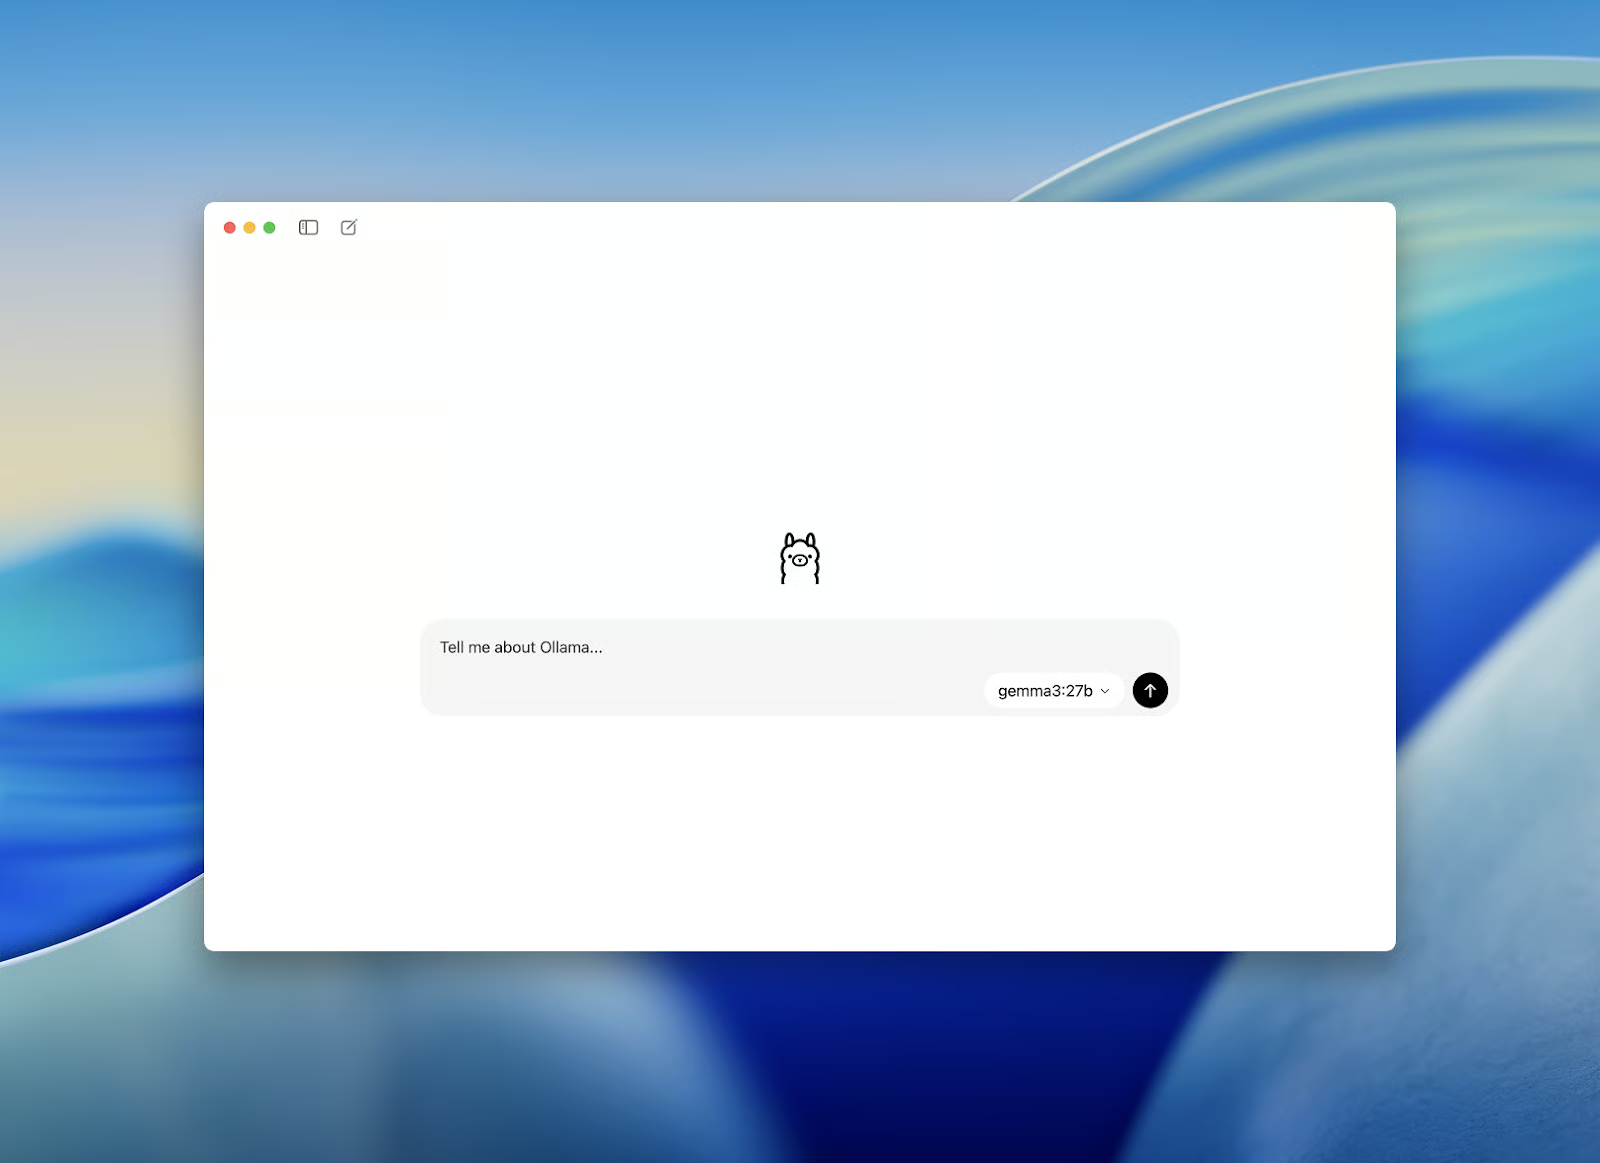
Quelle: Ollamas neue App
Für Windows und macOS: Besuche die Download-Seite und lade das Installationsprogramm für dein Betriebssystem herunter. Die Einrichtung ist unkompliziert – folge einfach den Anweisungen.
Quelle: Ollama herunterladen
Für Linux: Öffne dein Terminal und führe folgenden Befehl aus. Er lädt Ollama automatisch herunter und installiert es.
curl -fsSL https://ollama.com/install.sh | sh Wenn eine Meldung erscheint, dass keine GPU erkannt wurde, installiere diese Systemtools:
sudo apt update
sudo apt install -y pciutils lshw
Für NVIDIA-GPU-Support installiere Treiber und CUDA-Toolkit:
sudo apt install -y nvidia-driver-525 nvidia-cuda-toolkitNach der Installation kannst du die Ollama-App starten und Modelle herunterladen oder direkt über die Oberfläche chatten. So experimentierst du ganz leicht mit lokalen KI-Modellen – egal ob unter Windows, macOS oder Linux.
Um loszulegen, öffne den Models-Tab auf der Ollama-Website und suche nach „qwen3-coder“.
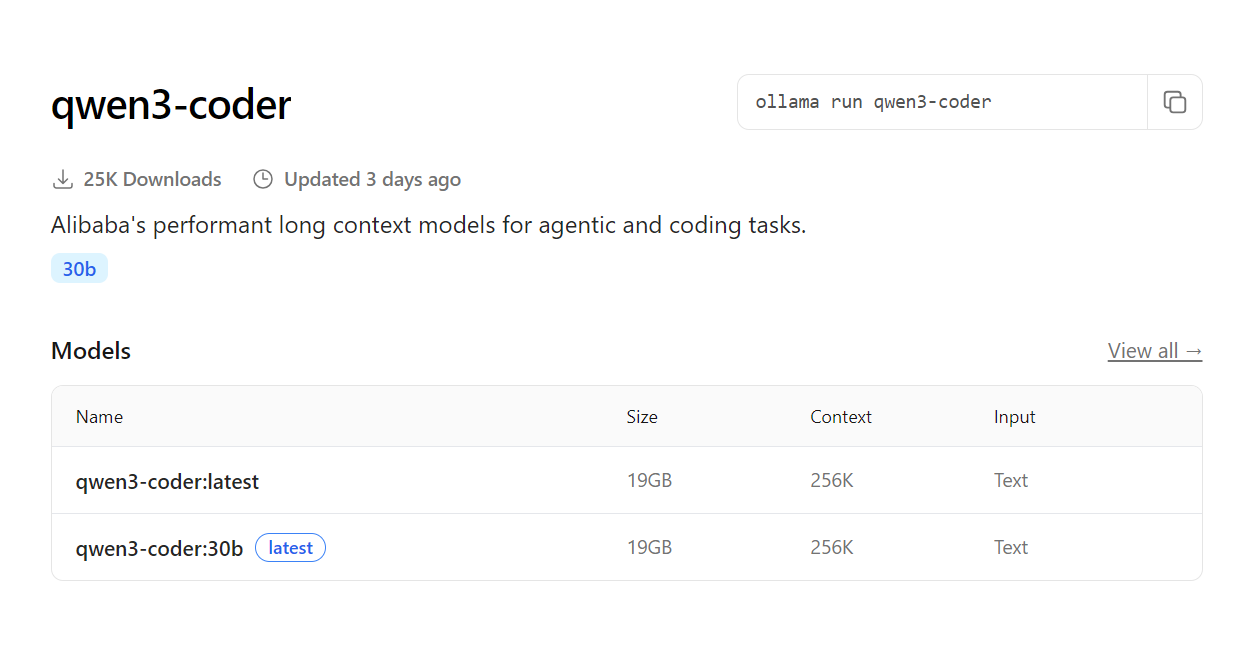
Quelle: qwen3-coder
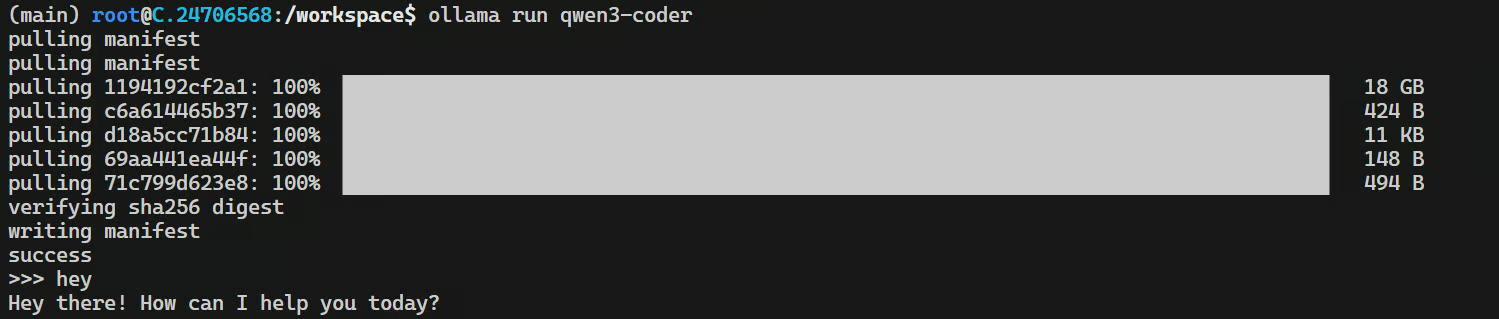
Kopiere anschließend den Installationsbefehl und führe ihn im Terminal aus, um das Modell herunterzuladen und zu starten:
ollama run qwen3-coderJe nach Internetgeschwindigkeit dauert der Download ein paar Minuten. Danach kannst du das Modell direkt im Terminal verwenden.
Starte einen Chat oder lass dir direkt eine App bauen.
Auch wenn Ollama inzwischen eine Chat-App mitliefert, holst du noch mehr heraus, wenn du Qwen3-Coder mit fortgeschrittenen Tools und Apps verbindest.
Dafür musst du das Modell als API-Endpunkt bereitstellen:
ollama serveDer Befehl startet einen OpenAI-kompatiblen Server unter http://localhost:11434/ – ideal, um Qwen3-Coder mit deinen bevorzugten Dev-Tools und Workflows zu verbinden.
Msty ist meine bevorzugte App, um lokale und proprietäre Large Language Models zu testen. Sie steckt voller praktischer Funktionen und passt perfekt zum Ollama-Server. Besuche die offizielle Msty-Website und installiere die App für deine Plattform.
Danach:
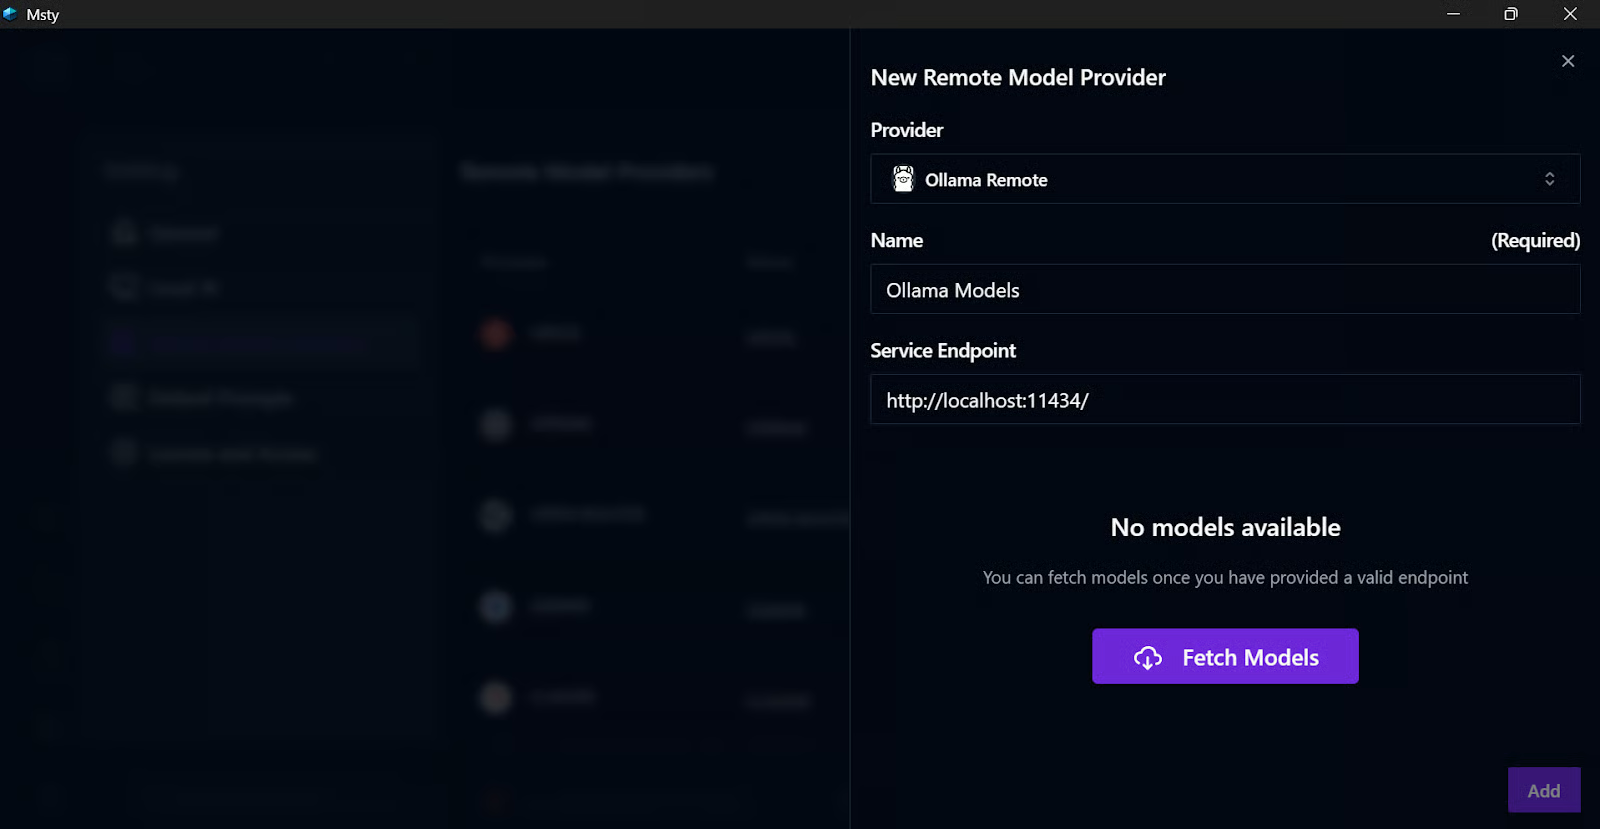
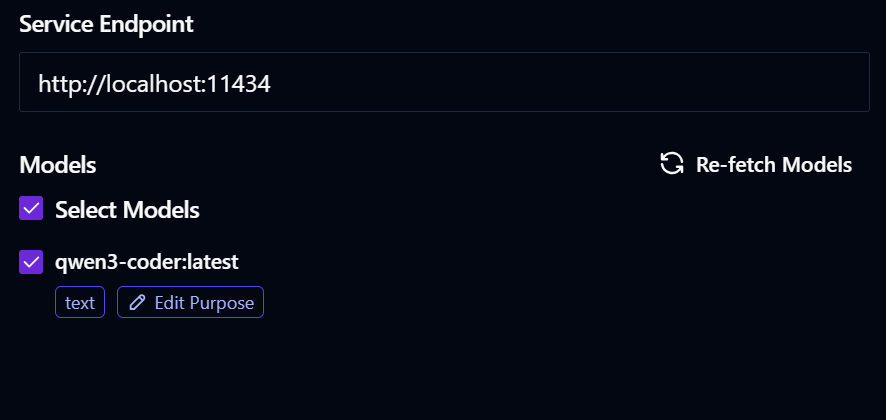
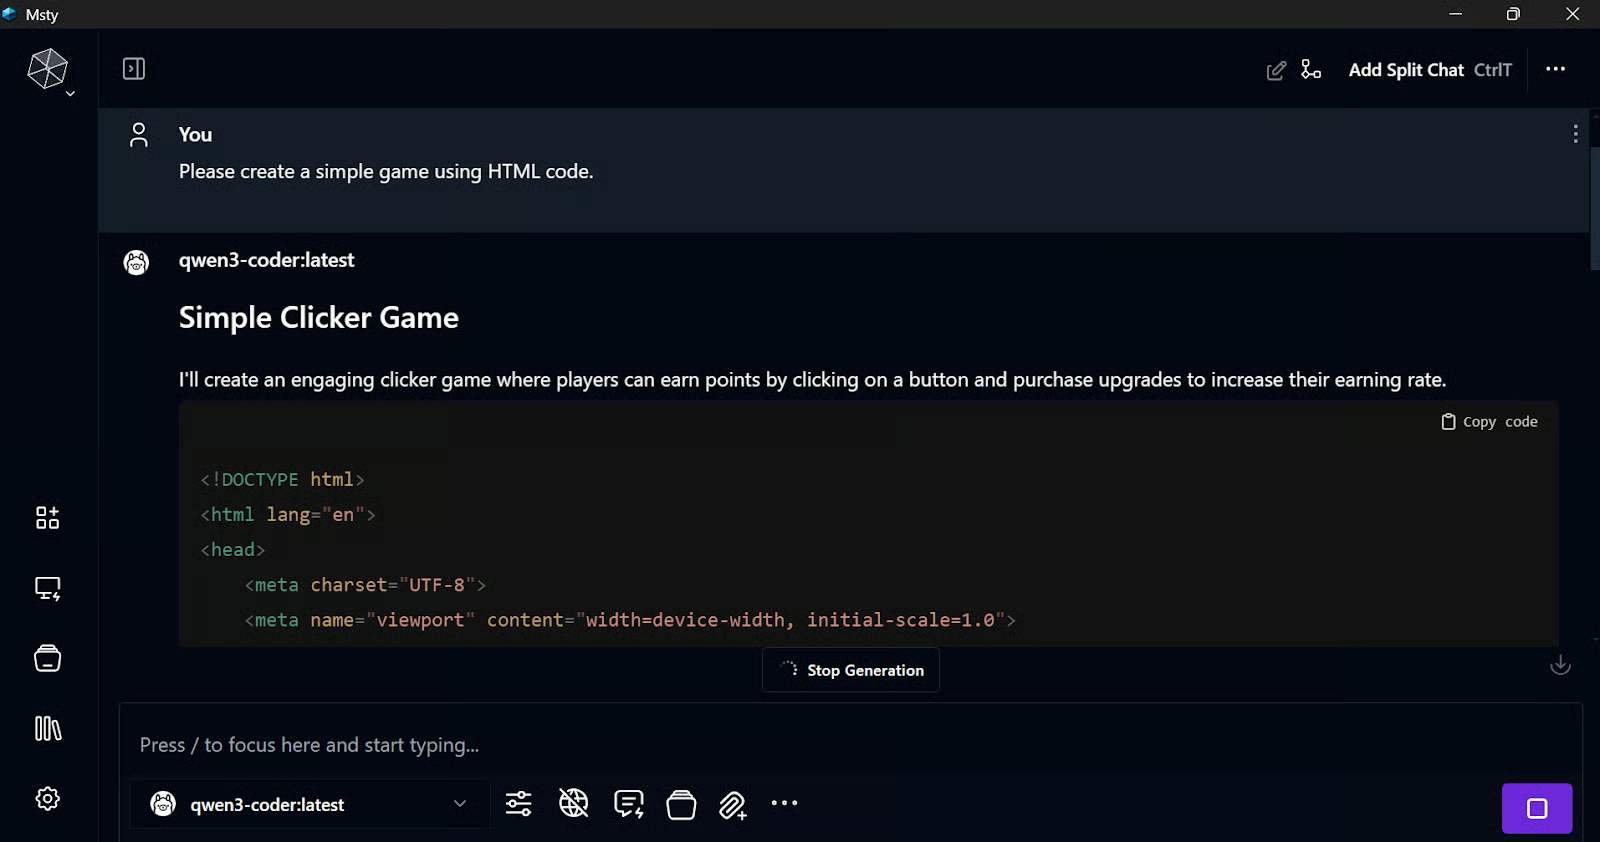
Diese Integration ist schnell eingerichtet und vielseitig. Mit ollama serve verbindest du Ollama-Modelle mit mehreren Apps und Tools – und öffnest dir noch mehr kreative Möglichkeiten.
Wie du weißt, ist Qwen3-Coder speziell für Coding und agentische Workflows gemacht. Ohne Integration in deinen Code-Editor verschenkst du Potenzial.
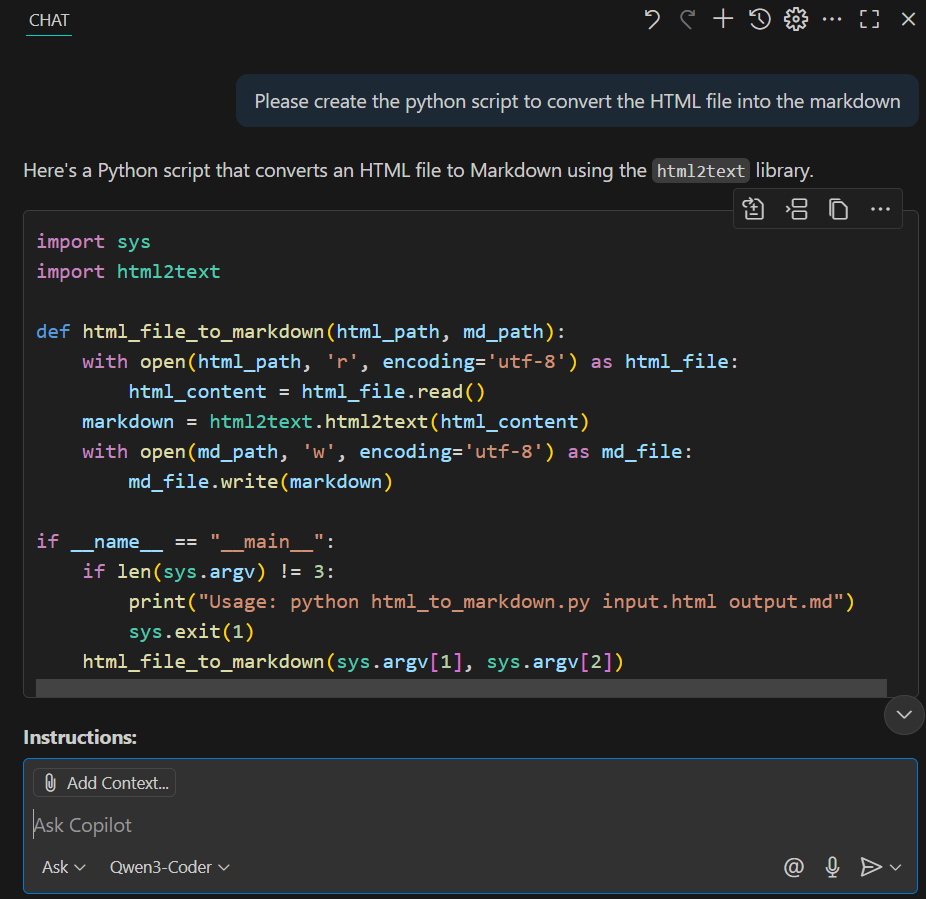
Wir binden Qwen3-Coder jetzt in den GitHub Copilot in VS Code ein. In aktuellen VS-Code-Installationen ist die Copilot-Erweiterung bereits enthalten. Klicke unten auf das Modell-Auswahlmenü, dann auf „Manage Models“, wähle Ollama als Model Provider. Anschließend siehst du die verfügbaren Modelle. Wähle Qwen3-Coder und nutze den GitHub-Copilot-Chat wie gewohnt.
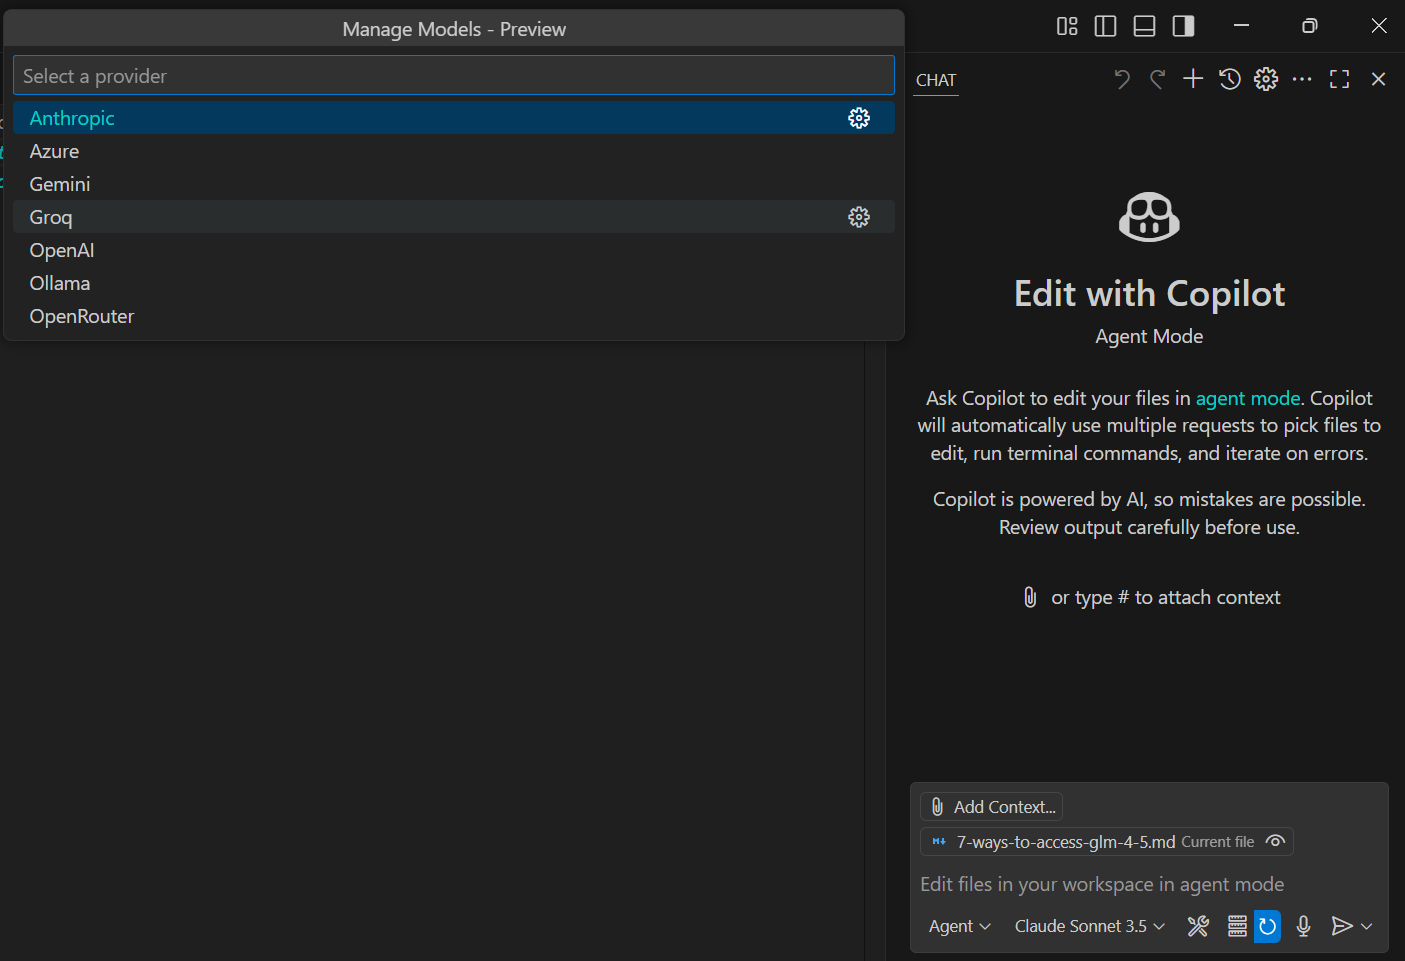
Wir haben das Modell gebeten, ein Skript zu erstellen, das HTML in Markdown umwandelt, und es brauchte nur 10 Sekunden für die komplette Antwort.
Schnell, lokal und einfach zu bedienen.
Die Kilo-Org/kilocode-Erweiterung für VS Code wird zunehmend als einer der besten Open-Source-KI-Coding-Assistenten für Planung, Entwicklung und Bugfixing gehandelt.
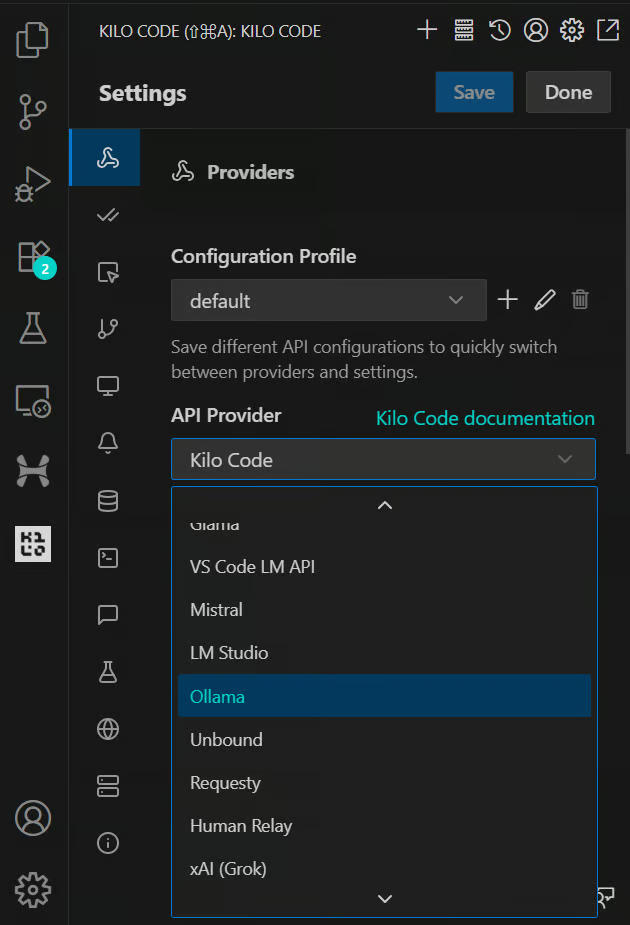
Um unser lokal laufendes Qwen3-Coder-Modell zu integrieren, installiere zuerst die nötigen Erweiterungen und öffne dann die Einstellungen. Stelle den API-Provider auf Ollama um – das Modell wird unter der Standard-URL automatisch erkannt.
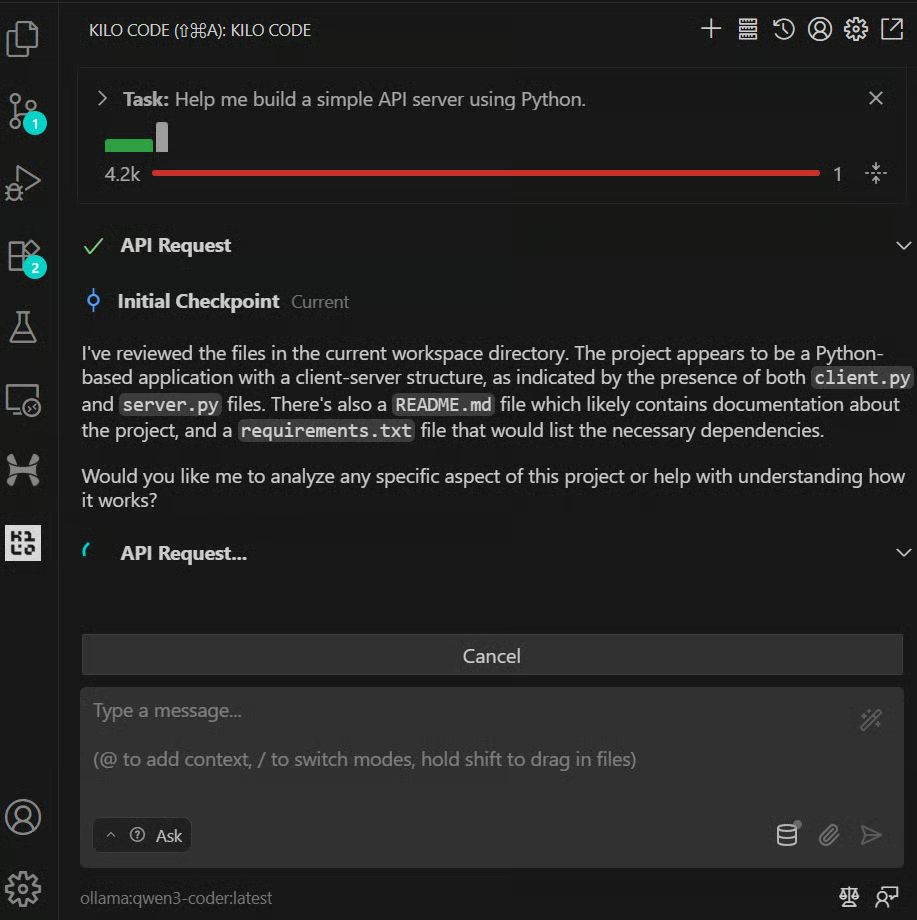
Wechsle danach zurück in den Chat und bitte die KI, einen einfachen KI-Server zu bauen. Zunächst analysiert sie alle Dateien im Projekt und liefert dir dann die beste Lösung für deine Anfrage.
Die Integration von Qwen3-Coder in deine Python-Anwendungen ist mit dem ollama/ollama-python-Paket ganz einfach. So kannst du leistungsstarke KI-Modelle lokal ausführen und direkt in deine Workflows einbetten.
Installiere zunächst das Ollama-Paket:
pip install ollamaHier ein minimales Beispiel, wie du Qwen3-Coder in Python nutzt – sehr ähnlich zu Aufrufen der OpenAI-API:
from ollama import chat

def main():
    # Define a system + user prompt
    messages = [
        {"role": "system", "content": "You are a helpful coding assistant."},
        {
            "role": "user",
            "content": (
                "Please write a Python function `quicksort(arr)` "
                "that takes a list of integers and returns it sorted."
            ),
        },
    ]

    # Stream the response from Qwen3-Coder
    stream = chat(
        model="Qwen3-Coder",
        messages=messages,
        stream=True
    )

    # Print chunks as they arrive
    for chunk in stream:
        # chunk is a dict-like with ['message']['content']
        print(chunk["message"]["content"], end="", flush=True)

    # Finish with a newline
    print()

if __name__ == "__main__":
    main()
Die Antwort beginnt fast sofort zu streamen. Die folgende Quicksort-Lösung wurde in nur 15 Sekunden generiert:
Here's a Python implementation of the quicksort algorithm:

```python
def quicksort(arr):
    """
    Sorts a list of integers using the quicksort algorithm.

    Args:
        arr: List of integers to be sorted

    Returns:
        A new list containing the sorted integers
    """
    # Base case: arrays with 0 or 1 element are already sorted
    if len(arr) <= 1:
        return arr

    # Choose pivot (using the middle element)
    pivot = arr[len(arr) // 2]

    # Partition the array into three parts
    left = [x for x in arr if x < pivot]      # Elements less than pivot
    middle = [x for x in arr if x == pivot]   # Elements equal to pivot
    right = [x for x in arr if x > pivot]     # Elements greater than pivot

    # Recursively sort left and right parts, then combine
    return quicksort(left) + middle + quicksort(right)

# Example usage:
if __name__ == "__main__":
    # Test cases
    print(quicksort([64, 34, 25, 12, 22, 11, 90]))  # [11, 12, 22, 25, 34, 64, 90]
    print(quicksort([5, 2, 8, 1, 9]))               # [1, 2, 5, 8, 9]
    print(quicksort([1]))                           # [1]
    print(quicksort([]))                            # []
    print(quicksort([3, 3, 3, 3]))                  # [3, 3, 3, 3]
```Diese Anleitung zeigt, wie zugänglich lokale KI inzwischen ist. Heute kannst du Open-Source-Modelle selbst auf älteren Laptops ausführen, sie in Code-Editoren und Chat-Apps integrieren oder mit dem Ollama-Python-SDK eigene lokale KI-Anwendungen bauen.
Es gibt auch weitere Optionen, etwa die Nutzung der Qwen Code CLI (siehe unser separater Guide: Qwen Code CLI: A Guide With Examples | DataCamp) oder das Bereitstellen von Modellen auf einem lokalen Server mit Zugriff per SSH von mehreren Rechnern. Die Möglichkeiten wachsen rasant – lokale KI wird damit praktischer und vielseitiger denn je.
Top-Kurse zu KI
Kurs
Kurs
Kurs