
Cours
Créer des agents IA avec Google ADK
1 h
7.5K
Qwen3-Coder est un modèle de code agentique avancé, conçu pour offrir aux développeurs des capacités accrues en génération de code et en automatisation. Il est proposé en plusieurs tailles, avec pour vitrine le modèle Qwen3-Coder-480B-A35B-Instruct.
Ce modèle Mixture-of-Experts de 480 milliards de paramètres dispose de 35 milliards de paramètres actifs et établit un nouveau standard pour les modèles de code open source. Il offre des performances de pointe en codage agentique, navigation agentique et tâches de codage fondamentales, avec des résultats comparables à des modèles leaders comme Claude Sonnet.
Dans ce tutoriel, nous allons voir comment exécuter Qwen3-Coder en local, l'utiliser avec les applications de chat Msty, l'intégrer à VSCode Copilot, configurer l'extension Kilo Code pour des workflows de code agentique avancés et, enfin, utiliser le framework Python pour l'intégrer dans une application locale.
Vous pouvez consulter nos guides dédiés à Qwen3 et au Qwen Code CLI pour en savoir plus.
Ollama a beaucoup évolué ces derniers mois et propose désormais une application de chat conviviale, similaire à ChatGPT. Avec cette nouvelle application, vous pouvez facilement télécharger et exécuter des modèles d'IA directement depuis l'interface graphique, rendant l'IA locale plus accessible que jamais.
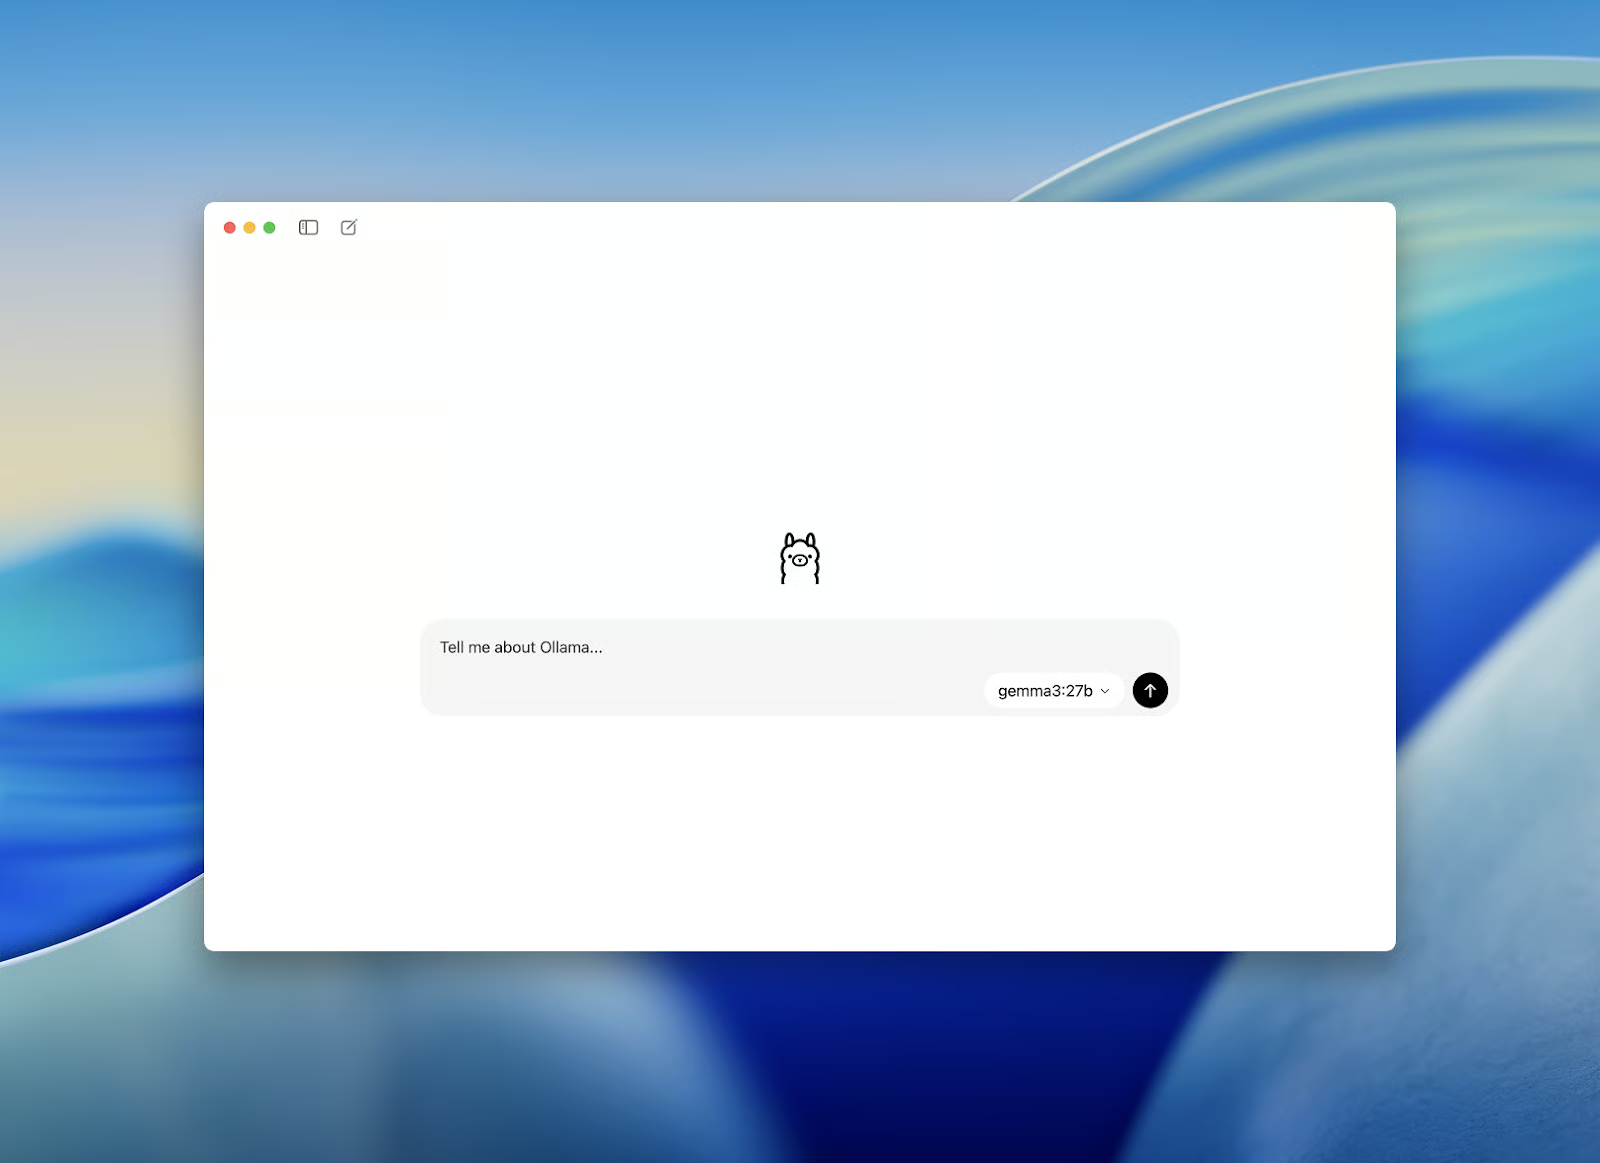
Source : Ollama's new app
Pour Windows et macOS : rendez-vous sur la page de téléchargement et téléchargez l'installateur pour votre système d'exploitation. L'installation est simple : suivez les instructions à l'écran.
Source : Download Ollama
Pour Linux : ouvrez votre terminal et exécutez la commande suivante. Elle téléchargera et installera automatiquement Ollama sur votre système.
curl -fsSL https://ollama.com/install.sh | sh Si un message indique que le GPU n'est pas détecté, vous devrez installer quelques utilitaires système :
sudo apt update
sudo apt install -y pciutils lshw
Pour la prise en charge des GPU NVIDIA, installez le pilote et le toolkit CUDA :
sudo apt install -y nvidia-driver-525 nvidia-cuda-toolkitUne fois l'installation terminée, vous pouvez lancer l'application Ollama et commencer à télécharger des modèles ou à discuter directement depuis l'interface. Cela facilite l'expérimentation de modèles d'IA locaux, que vous soyez sous Windows, macOS ou Linux.
Pour démarrer avec Qwen3-Coder, rendez-vous dans l'onglet Models sur le site Ollama et recherchez « qwen3-coder ».
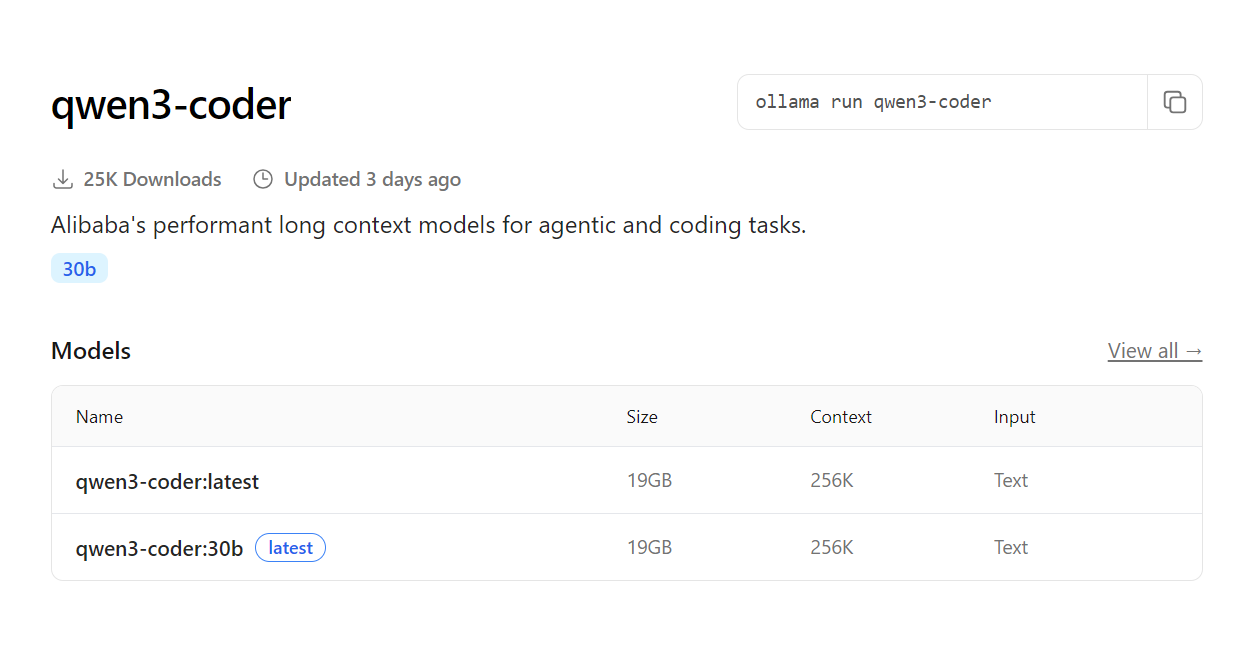
Source : qwen3-coder
Une fois trouvé, copiez la commande d'installation et exécutez-la dans votre terminal pour télécharger et lancer le modèle :
ollama run qwen3-coderSelon votre connexion, le téléchargement peut prendre quelques minutes. Une fois terminé, le modèle est prêt à l'emploi directement depuis le terminal.
Vous pouvez commencer à discuter ou lui demander de vous aider à créer une application immédiatement.
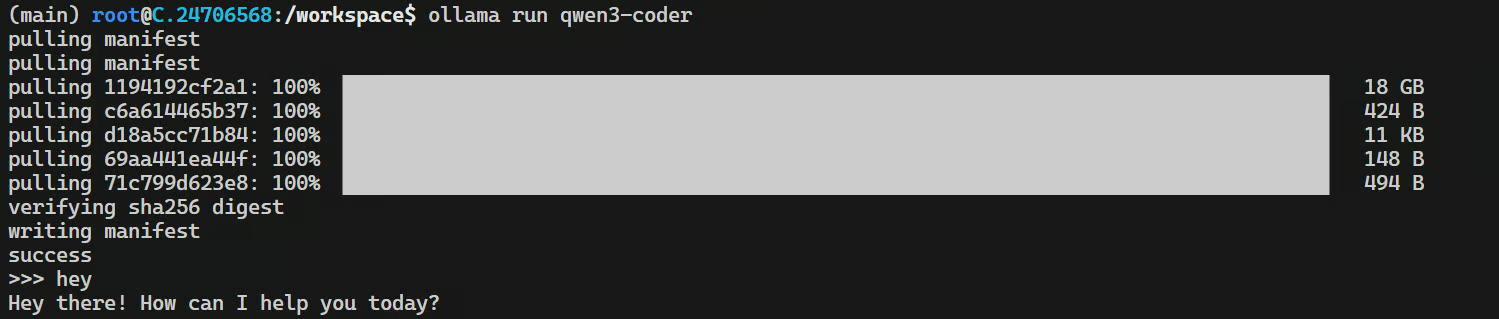
Même si Ollama inclut désormais une application de chat intégrée, vous pouvez aller plus loin en intégrant Qwen3-Coder à des outils et applications avancés.
Pour cela, il faut exposer le modèle via un point de terminaison API :
ollama serveCette commande démarre un serveur compatible OpenAI à l'adresse http://localhost:11434/, ce qui facilite la connexion de Qwen3-Coder à vos outils et workflows de développement préférés.
Msty est mon application de prédilection pour tester des modèles de langage locaux comme propriétaires. Elle regorge de fonctionnalités appréciables, ce qui en fait un excellent compagnon pour l'intégration avec le serveur Ollama. Rendez-vous sur le site officiel de Msty et installez l'app pour votre plateforme.
Ensuite,
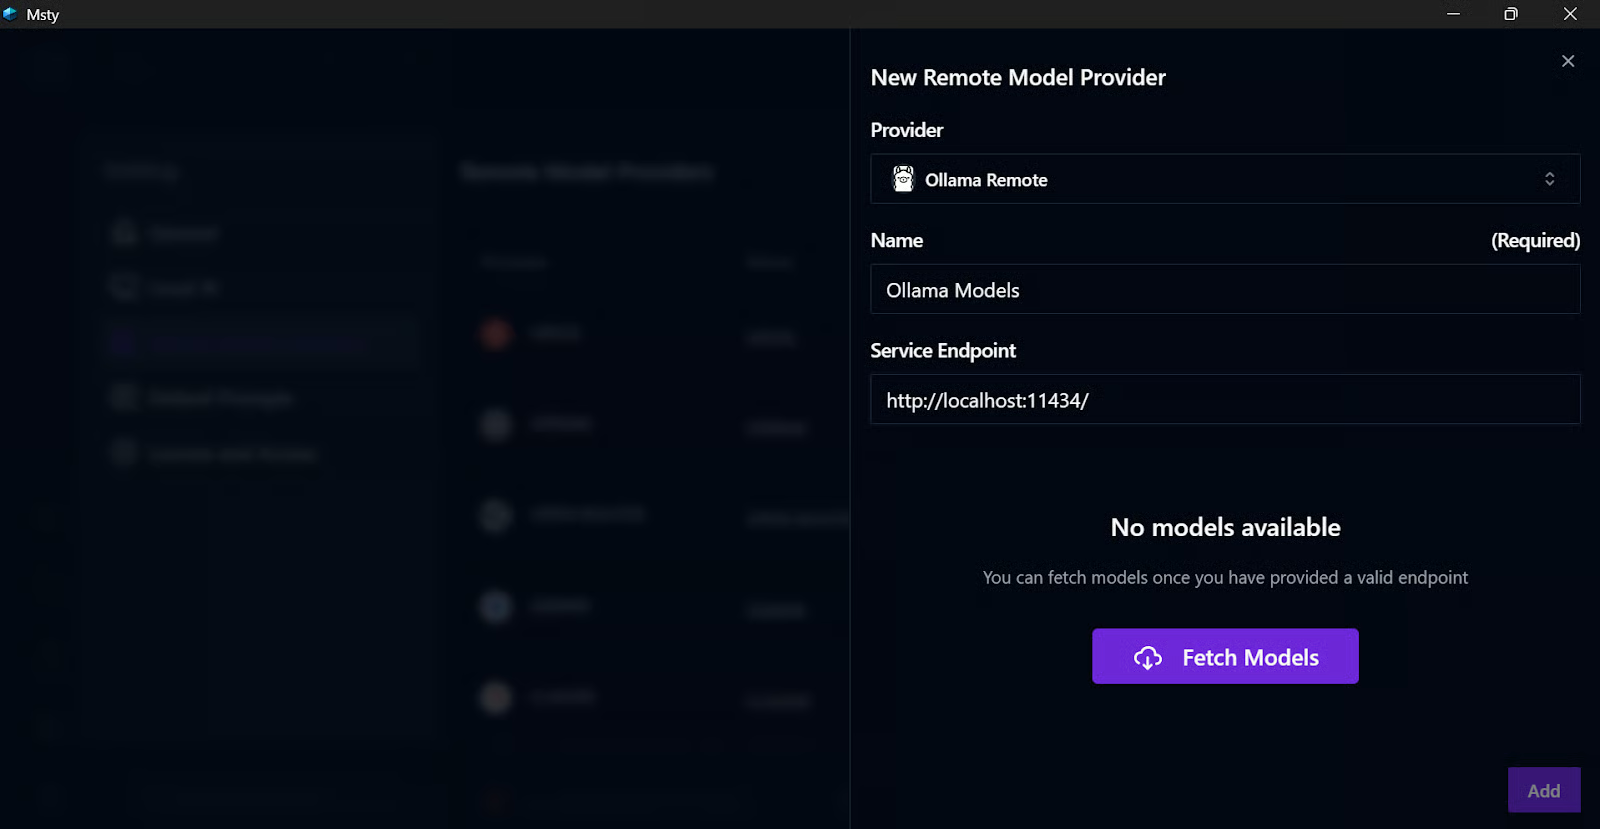
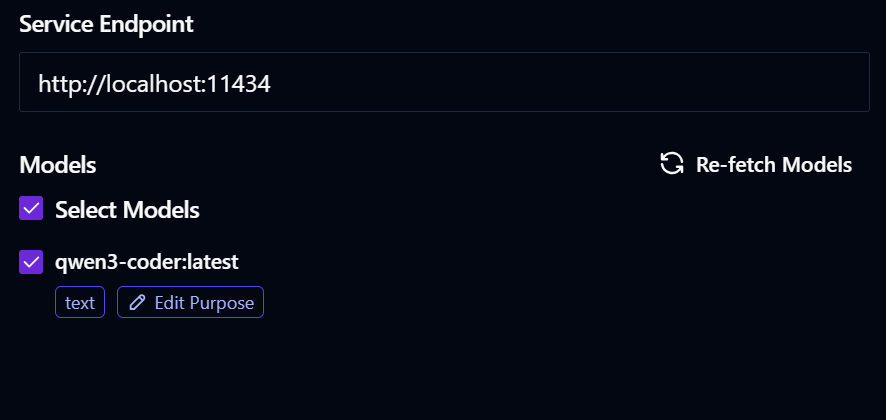
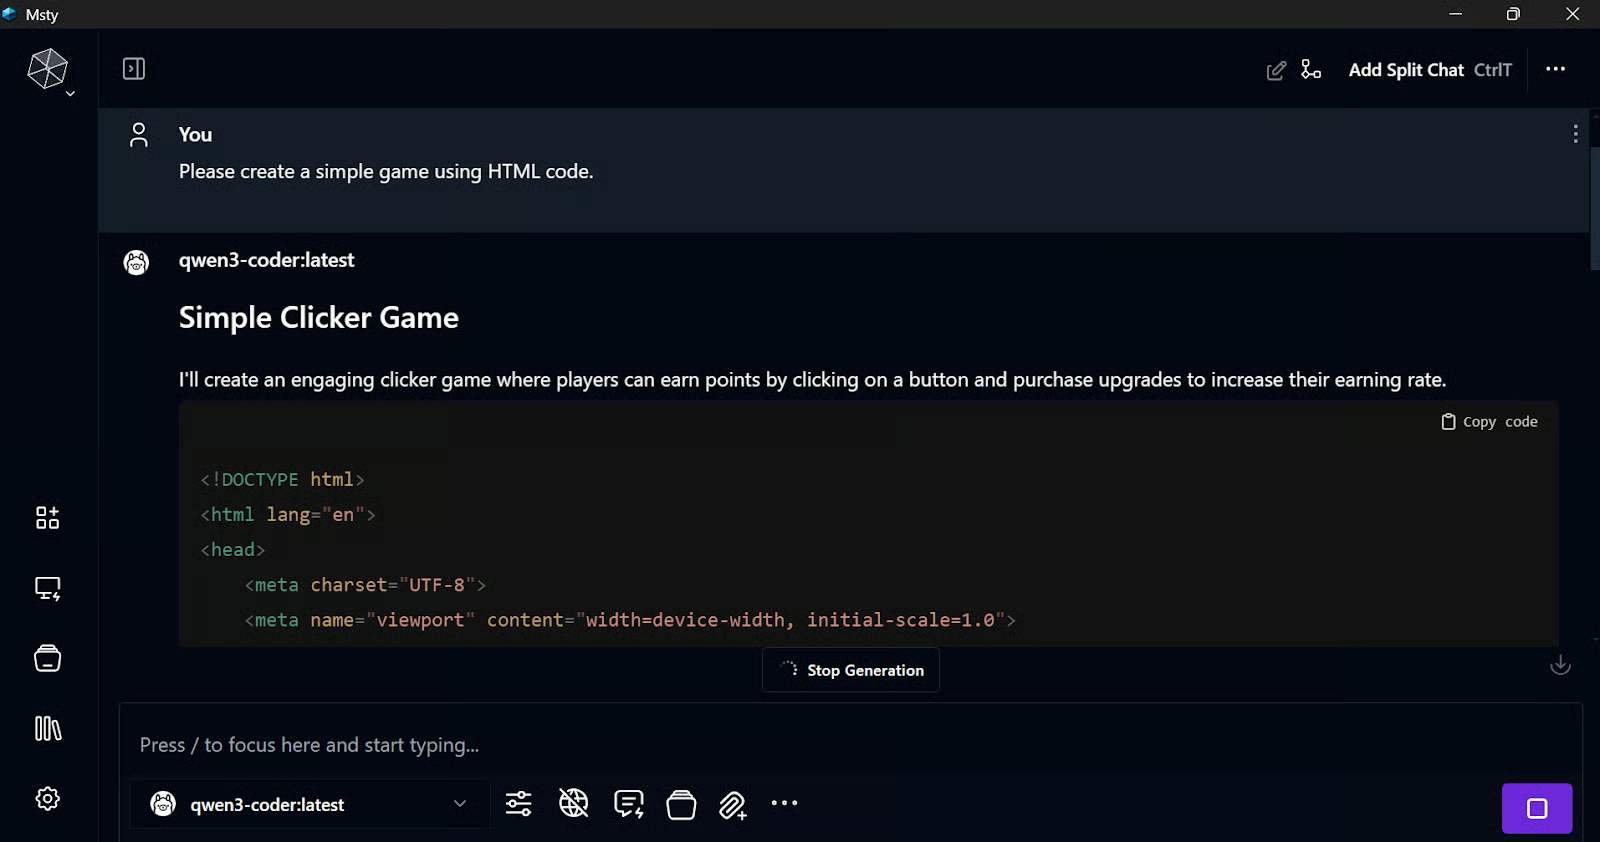
Cette intégration est simple et polyvalente. En exécutant Ollama serve, vous pouvez connecter les modèles Ollama à de multiples apps et outils, et décupler vos possibilités créatives.
Comme vous le savez, Qwen3-Coder est spécialement conçu pour le code et les workflows agentiques. Sans intégration à votre éditeur, vous passez à côté de son potentiel.
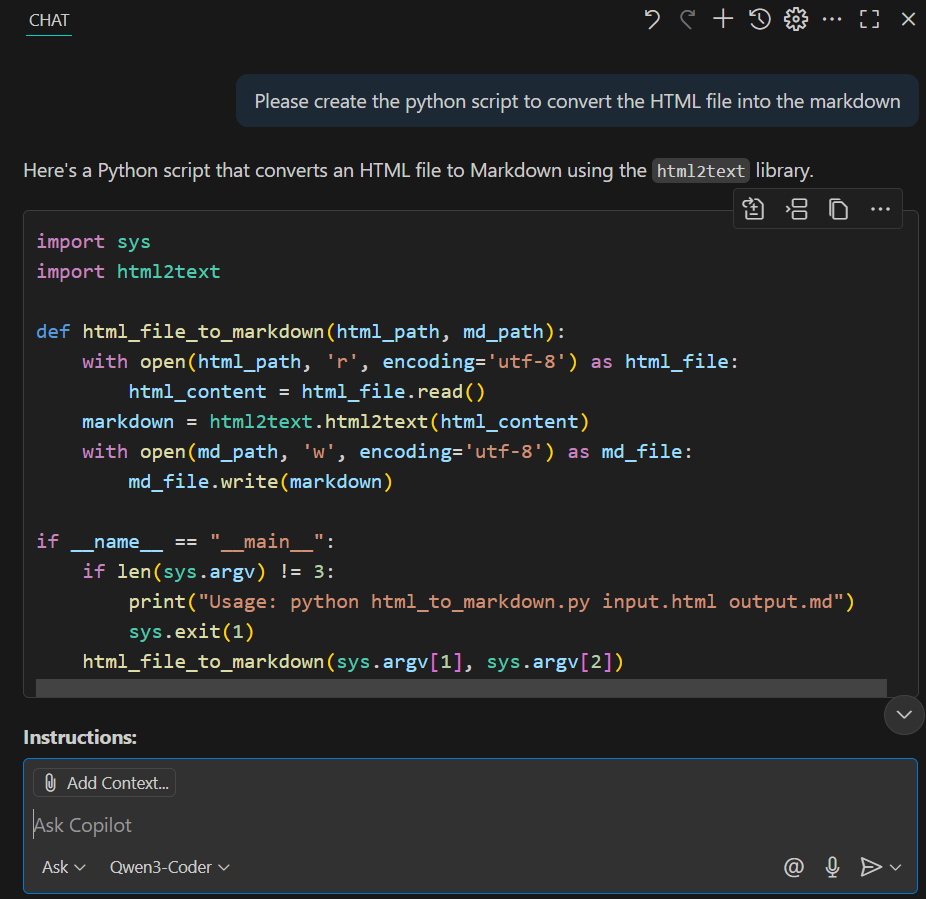
Nous allons maintenant intégrer Qwen3-Coder à GitHub Copilot dans VS Code. Les nouvelles installations de VS Code incluent déjà l'extension Copilot. Il vous suffit de cliquer sur le menu de sélection du modèle en bas, de choisir le lien « Manage Models », puis de sélectionner Ollama comme fournisseur de modèle. La liste des modèles disponibles s'affiche. Sélectionnez simplement Qwen3-Coder et utilisez GitHub Copilot Chat comme d'habitude.
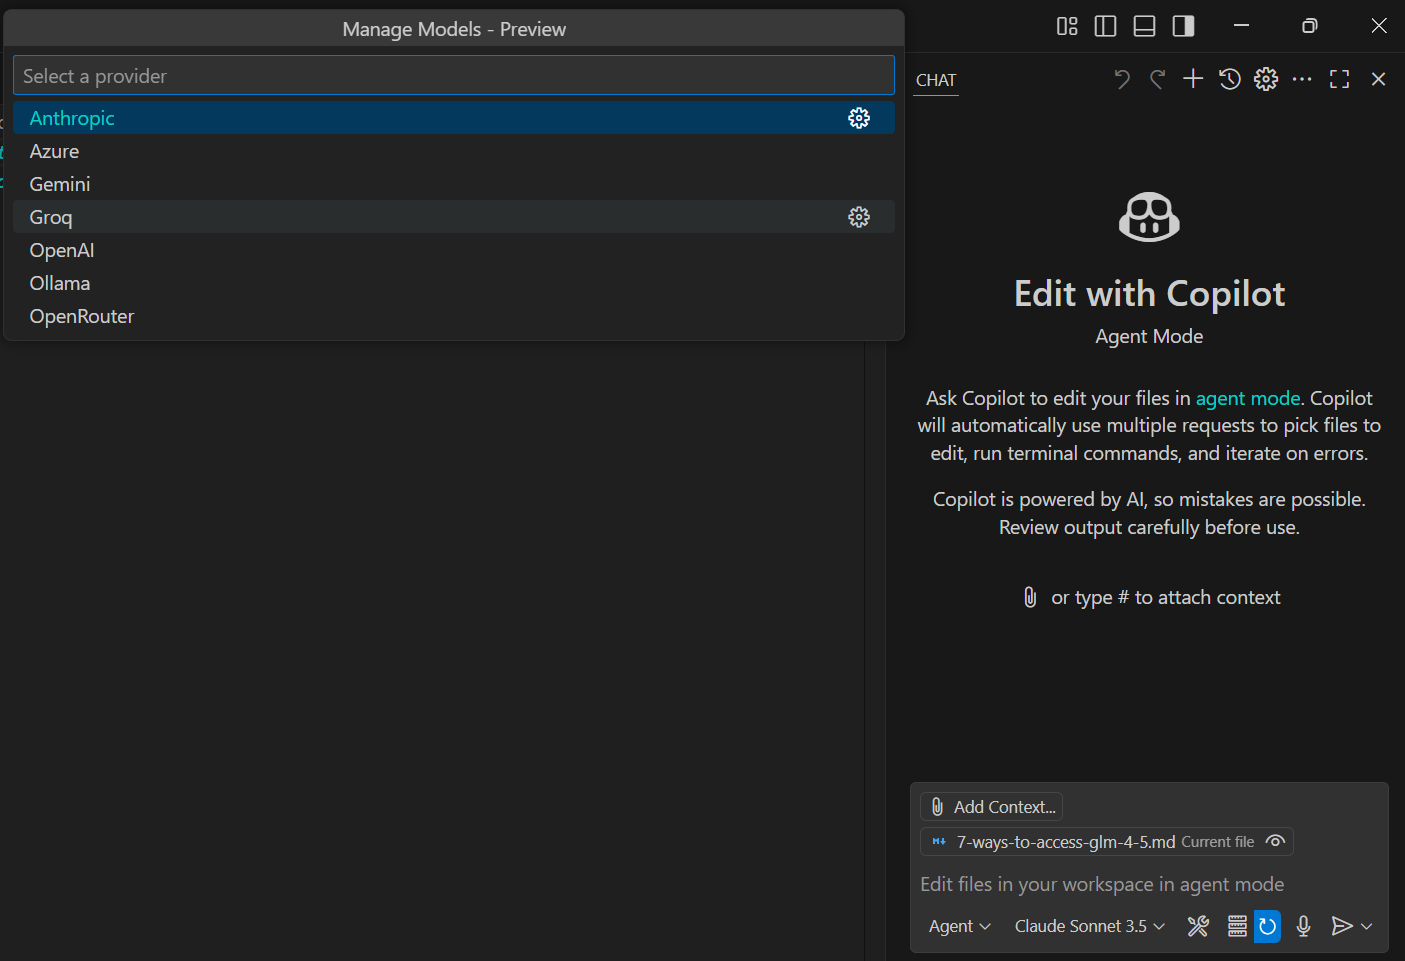
Nous lui avons demandé de créer un script convertissant du HTML en Markdown : il n'a fallu que 10 secondes pour générer la réponse complète.
C'est rapide, local et facile à utiliser.
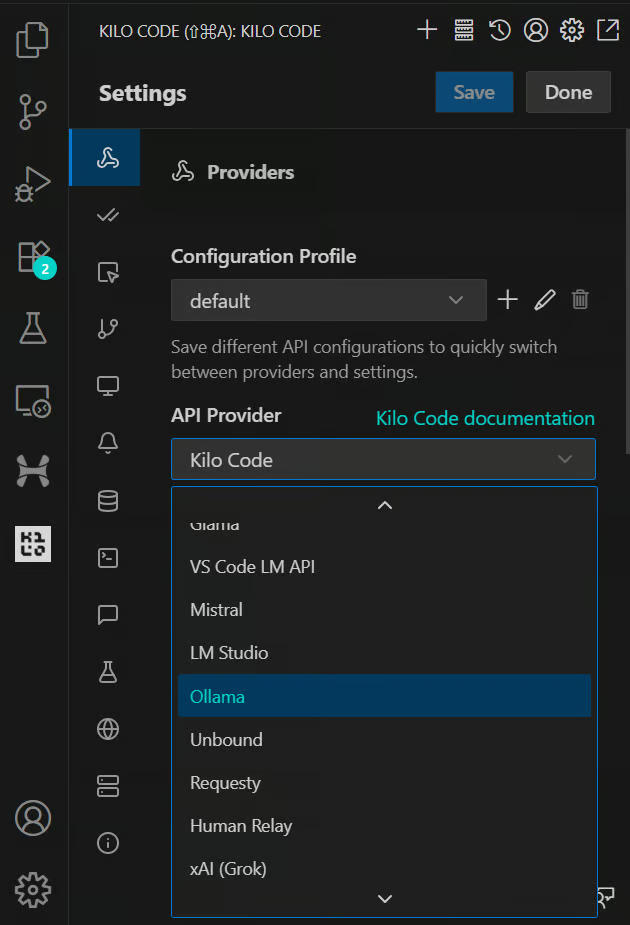
L'extension VSCode Kilo-Org/kilocode gagne en popularité comme l'un des meilleurs assistants de code IA open source pour planifier, construire et corriger du code.
Pour intégrer notre modèle Qwen3-Coder local, installez d'abord les extensions nécessaires, puis rendez-vous dans les paramètres. Basculez le fournisseur d'API sur Ollama : le modèle sera automatiquement détecté via l'URL par défaut.
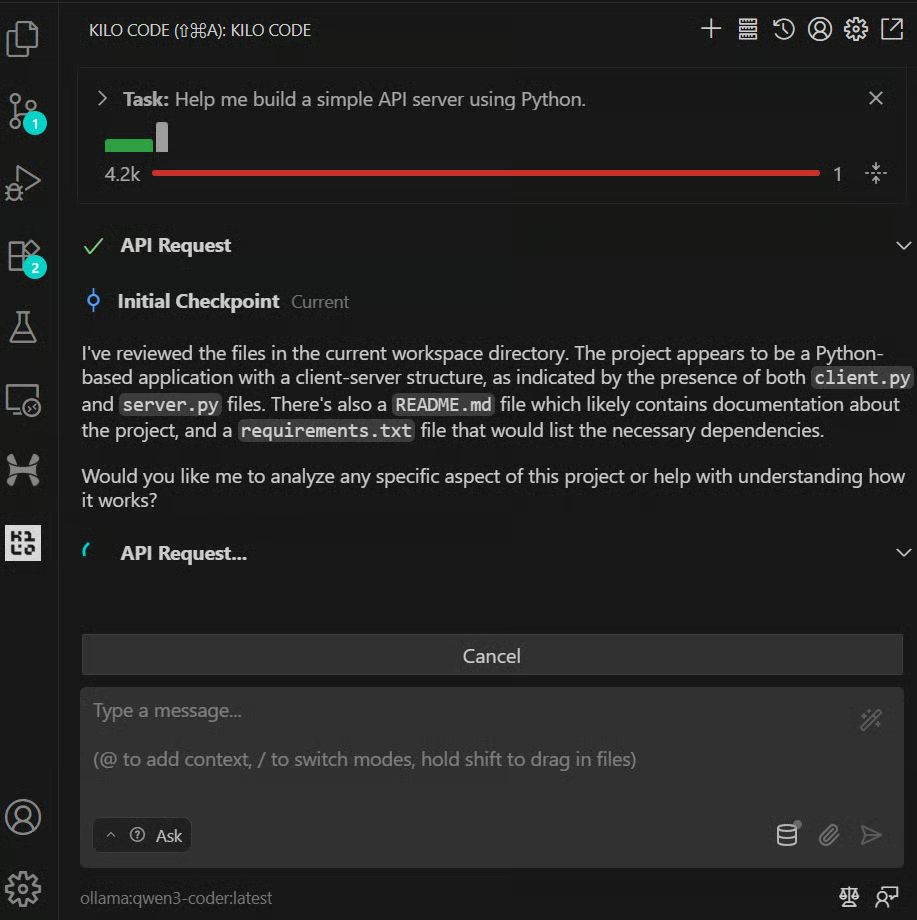
Revenez ensuite au chat et demandez à l'IA de créer un simple serveur d'IA. Elle analysera d'abord tous les fichiers du projet, puis vous proposera la meilleure solution à votre requête.
Intégrer Qwen3-Coder à vos applications Python est simple avec le package Python ollama/ollama-python. Vous pouvez ainsi exécuter des modèles d'IA puissants en local et les intégrer directement à vos workflows.
Pour commencer, installez simplement le package Ollama :
pip install ollamaVoici un exemple minimal pour utiliser Qwen3-Coder dans votre code Python, similaire à un appel à l'API d'OpenAI :
from ollama import chat

def main():
    # Define a system + user prompt
    messages = [
        {"role": "system", "content": "You are a helpful coding assistant."},
        {
            "role": "user",
            "content": (
                "Please write a Python function `quicksort(arr)` "
                "that takes a list of integers and returns it sorted."
            ),
        },
    ]

    # Stream the response from Qwen3-Coder
    stream = chat(
        model="Qwen3-Coder",
        messages=messages,
        stream=True
    )

    # Print chunks as they arrive
    for chunk in stream:
        # chunk is a dict-like with ['message']['content']
        print(chunk["message"]["content"], end="", flush=True)

    # Finish with a newline
    print()

if __name__ == "__main__":
    main()
La réponse commence à être diffusée presque instantanément. La solution quicksort ci-dessous a pris seulement 15 secondes à être générée :
Here's a Python implementation of the quicksort algorithm:

```python
def quicksort(arr):
    """
    Sorts a list of integers using the quicksort algorithm.

    Args:
        arr: List of integers to be sorted

    Returns:
        A new list containing the sorted integers
    """
    # Base case: arrays with 0 or 1 element are already sorted
    if len(arr) <= 1:
        return arr

    # Choose pivot (using the middle element)
    pivot = arr[len(arr) // 2]

    # Partition the array into three parts
    left = [x for x in arr if x < pivot]      # Elements less than pivot
    middle = [x for x in arr if x == pivot]   # Elements equal to pivot
    right = [x for x in arr if x > pivot]     # Elements greater than pivot

    # Recursively sort left and right parts, then combine
    return quicksort(left) + middle + quicksort(right)

# Example usage:
if __name__ == "__main__":
    # Test cases
    print(quicksort([64, 34, 25, 12, 22, 11, 90]))  # [11, 12, 22, 25, 34, 64, 90]
    print(quicksort([5, 2, 8, 1, 9]))               # [1, 2, 5, 8, 9]
    print(quicksort([1]))                           # [1]
    print(quicksort([]))                            # []
    print(quicksort([3, 3, 3, 3]))                  # [3, 3, 3, 3]
```Ce guide montre à quel point l'IA locale est devenue accessible. Aujourd'hui, vous pouvez exécuter des modèles open source sur un ancien ordinateur portable et les intégrer à vos éditeurs de code, à des applications de chat, voire créer des applications d'IA locales sur mesure via le SDK Python d'Ollama.
D'autres options existent, comme utiliser Qwen Code CLI (voir notre guide dédié : Qwen Code CLI : guide et exemples | DataCamp), ou servir des modèles sur un serveur local et y accéder en SSH depuis plusieurs ordinateurs. Les possibilités s'étendent rapidement, rendant l'IA locale plus pratique et polyvalente que jamais.
Les meilleurs cours en IA
Cours
Cours
Cours