Curso
Criando agentes de IA com o Google ADK
1 h
7.6K
Pratique e programa seu progresso.
Continuar Com O GoogleQwen3-Coder é um modelo avançado de código com agentes, criado para potencializar desenvolvedores com recursos aprimorados de geração e automação de código. Ele está disponível em vários tamanhos, com o destaque sendo o Qwen3-Coder-480B-A35B-Instruct.
Esse modelo Mixture-of-Experts de 480 bilhões de parâmetros tem 35 bilhões de parâmetros ativos e estabelece um novo padrão para modelos de código open-source. Ele entrega performance de ponta em Agentic Coding, uso agentivo de navegador e tarefas fundamentais de programação, com resultados comparáveis a modelos líderes como o Claude Sonnet.
Neste tutorial, vamos aprender a executar o Qwen3-Coder localmente, usá-lo com apps de chat como o Msty, integrá-lo ao VSCode Copilot, configurar a extensão Kilo Code para fluxos de trabalho avançados com agentes e, por fim, usar o framework em Python para integrá-lo a um aplicativo local.
Você também pode conferir nossos guias separados sobre Qwen3 e Qwen Code CLI para saber mais.
O Ollama teve melhorias significativas nos últimos meses e agora oferece um app de chat fácil de usar, parecido com o ChatGPT. Com o novo app, você baixa e roda modelos de IA direto pela interface gráfica, tornando a IA local mais acessível do que nunca.
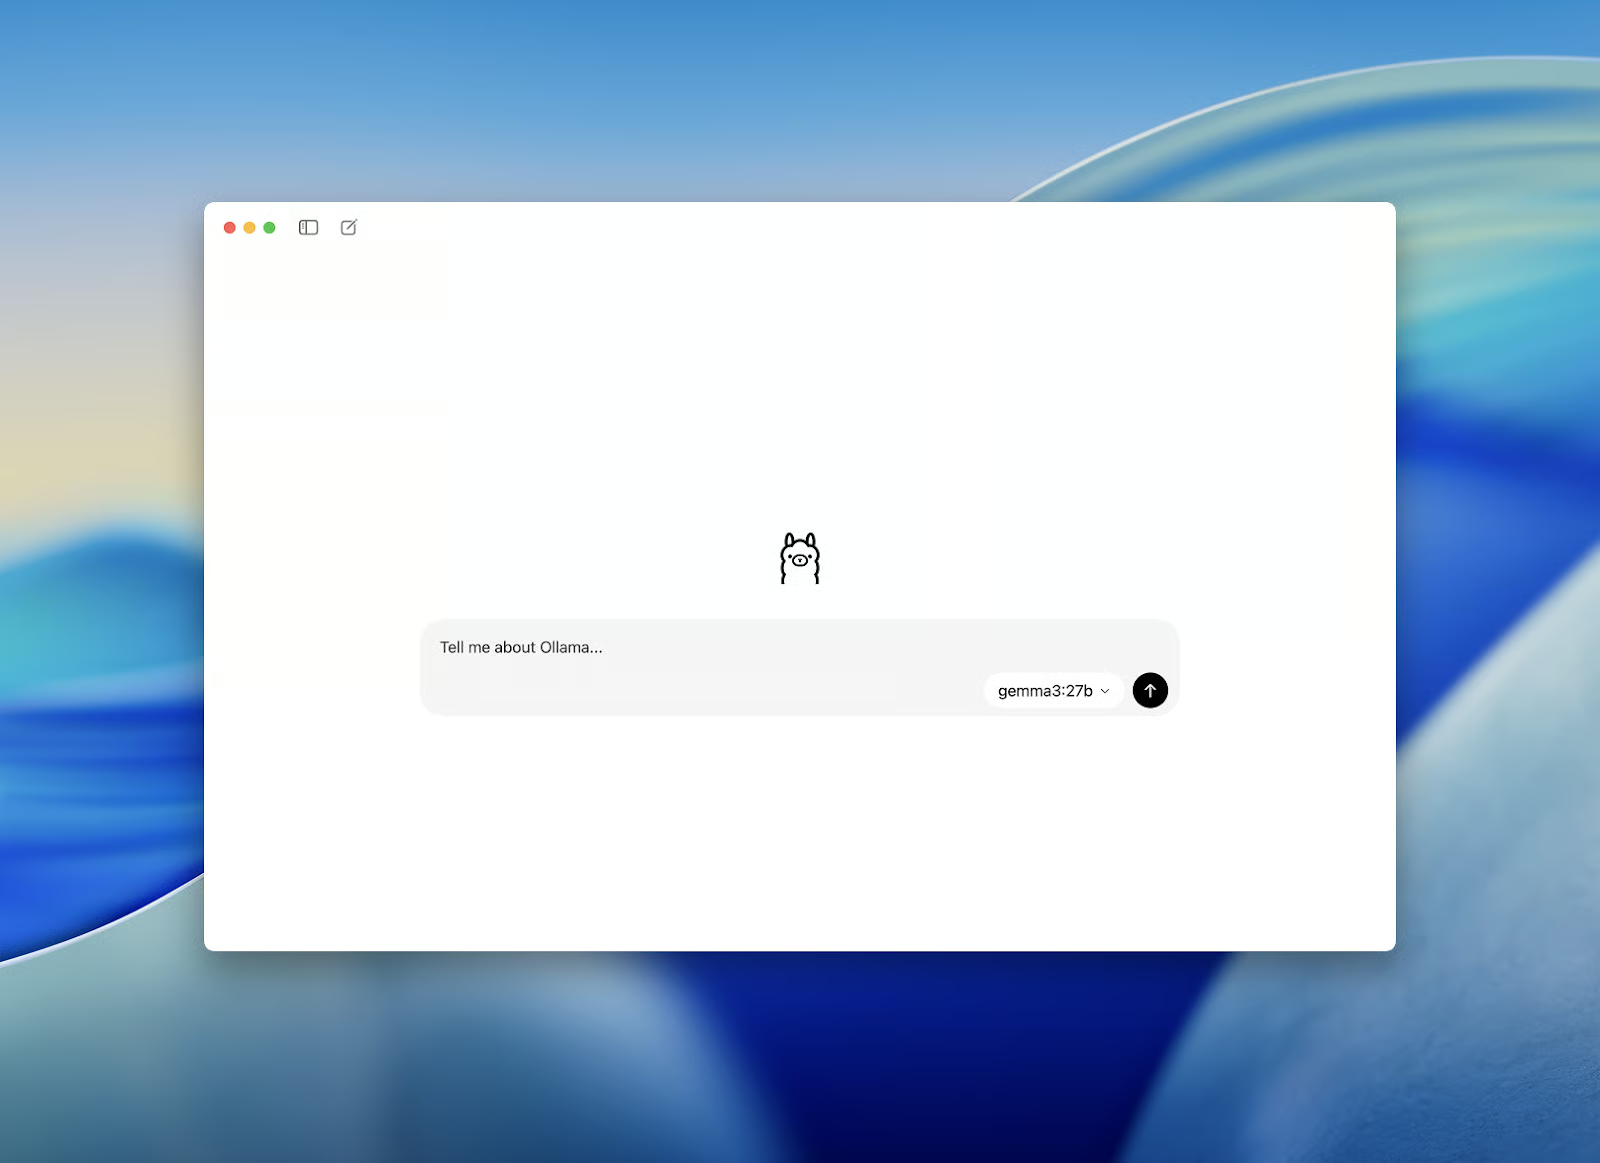
Fonte: novo app do Ollama
Para Windows e macOS: visite a página de download e baixe o instalador para o seu sistema operacional. A instalação é simples: siga as instruções na tela para começar.
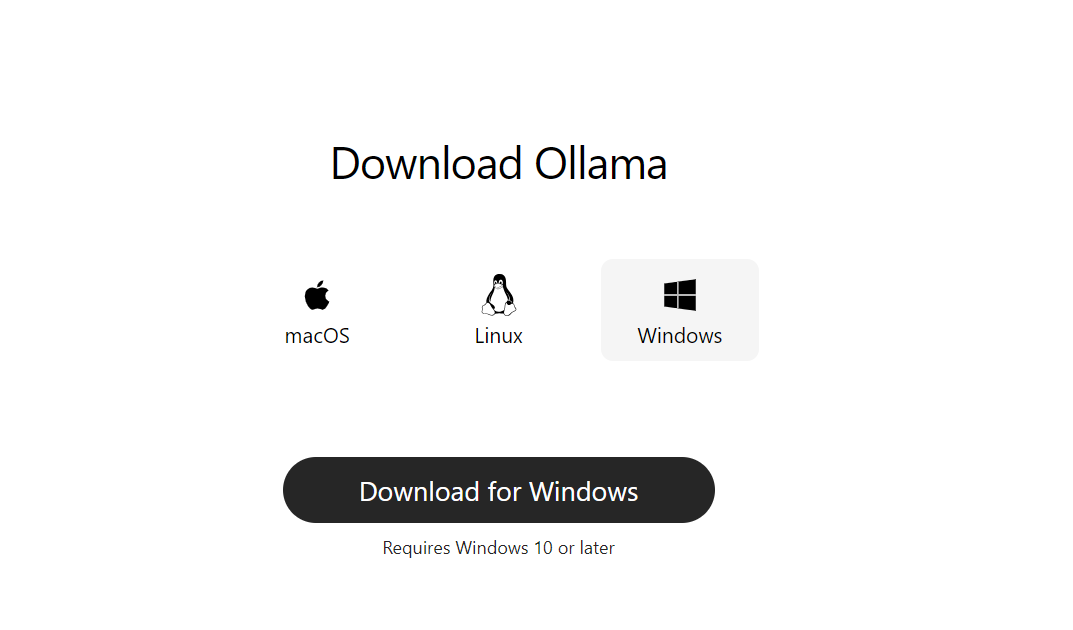
Fonte: Download do Ollama
Para Linux: abra o terminal e execute o comando abaixo. Ele baixa e instala o Ollama automaticamente no seu sistema.
curl -fsSL https://ollama.com/install.sh | sh Se aparecer uma mensagem informando que a GPU não foi detectada, você vai precisar instalar alguns utilitários do sistema:
sudo apt update
sudo apt install -y pciutils lshw
Para suporte a GPU NVIDIA, instale o driver e o toolkit CUDA:
sudo apt install -y nvidia-driver-525 nvidia-cuda-toolkitDepois de instalar, abra o app do Ollama e comece a baixar modelos ou conversar direto pela interface. Isso facilita testar modelos de IA locais, seja no Windows, macOS ou Linux.
Para começar com o Qwen3-Coder, vá até a aba Models no site do Ollama e pesquise por “qwen3-coder”.
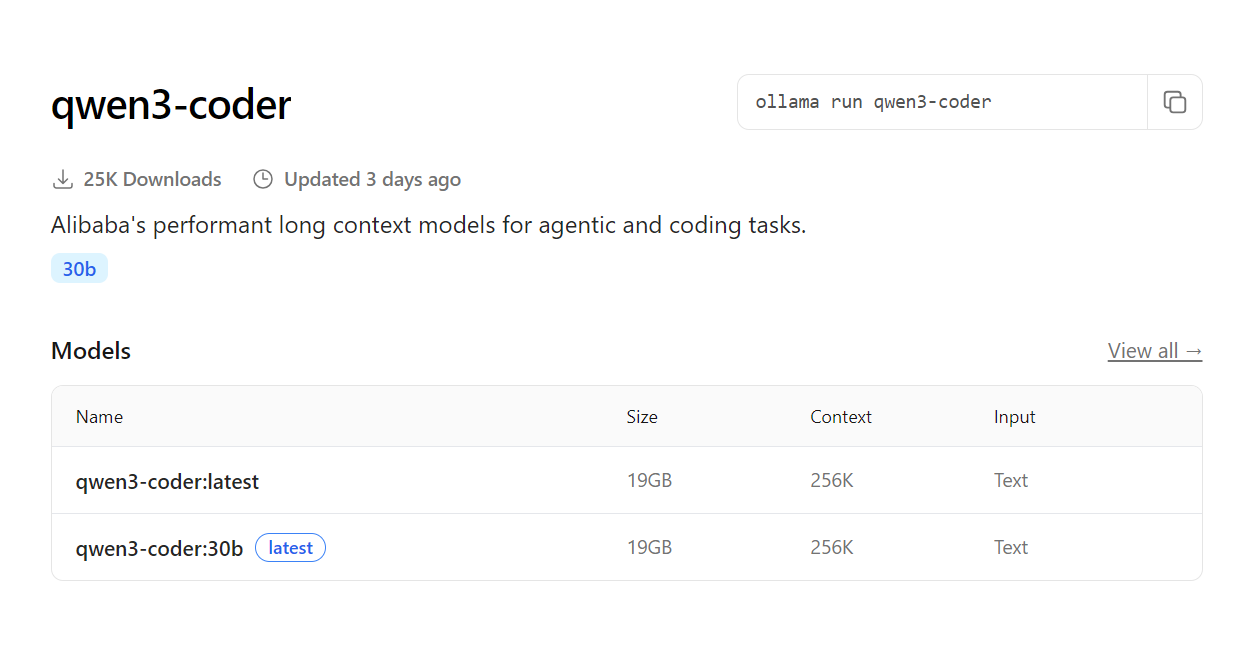
Fonte: qwen3-coder
Ao encontrar, copie o comando de instalação e rode no terminal para baixar e executar o modelo:
ollama run qwen3-coderDependendo da velocidade da sua internet, o download pode levar alguns minutos. Ao finalizar, o modelo já estará pronto para uso direto no terminal.
Você pode começar a conversar ou pedir ajuda para construir um app na hora.
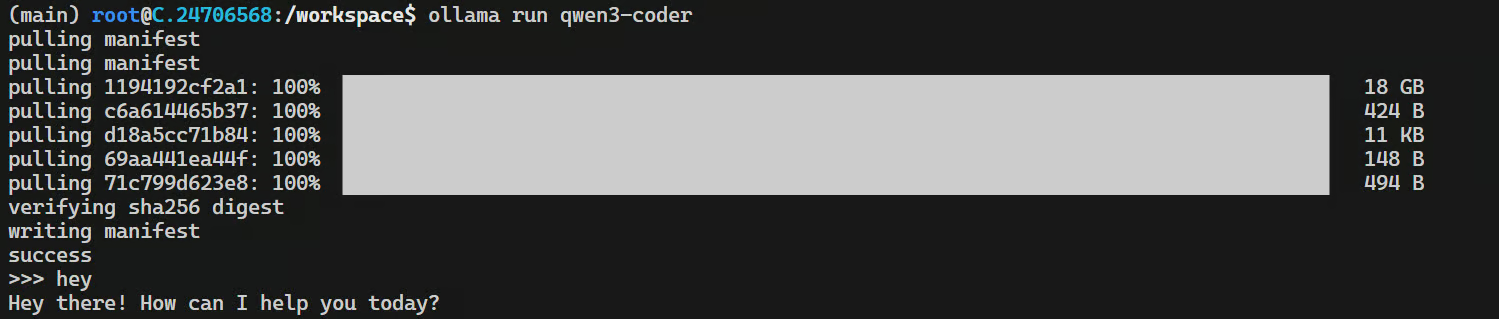
Embora o Ollama já traga um app de chat integrado, você pode ir além integrando o Qwen3-Coder com ferramentas e aplicativos avançados.
Para isso, é preciso expor o modelo como um endpoint de API:
ollama serveEsse comando inicia um servidor compatível com OpenAI em http://localhost:11434/, facilitando a conexão do Qwen3-Coder com suas ferramentas e fluxos de desenvolvimento preferidos.
O Msty é meu app preferido para testar modelos de linguagem locais e proprietários. Ele é repleto de recursos que você vai curtir, sendo um par perfeito para integrar com o servidor do Ollama. Visite o site oficial do Msty e instale o app para a sua plataforma.
Depois,
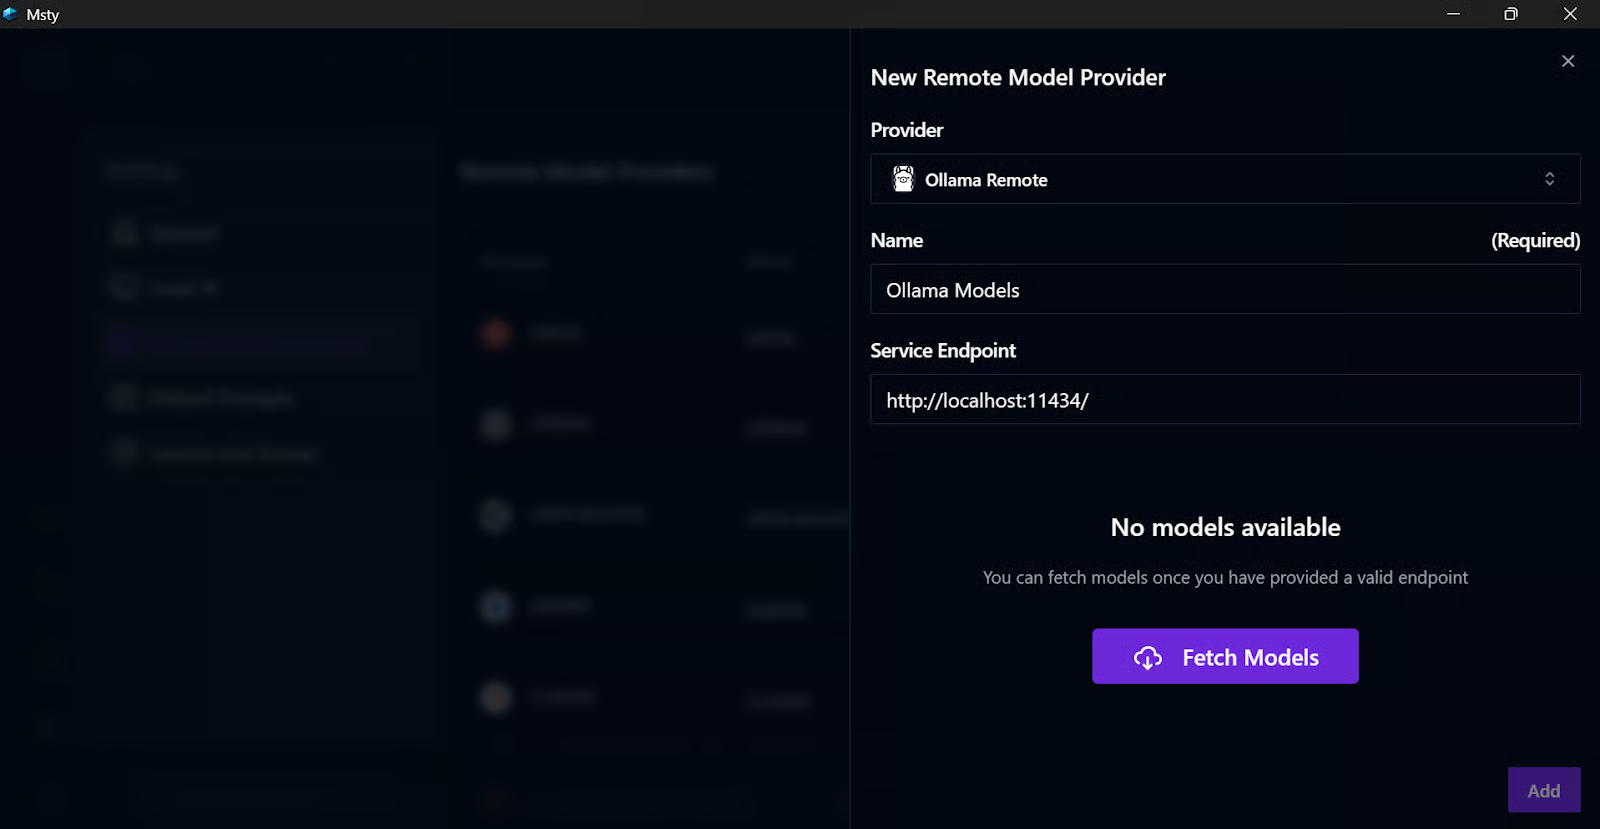
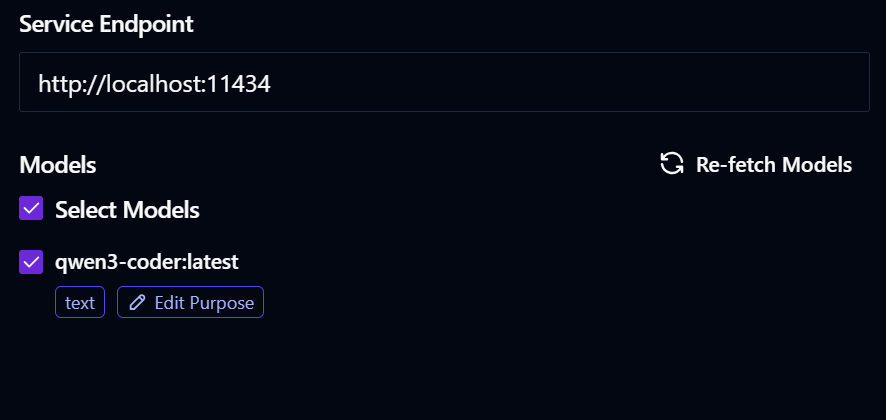
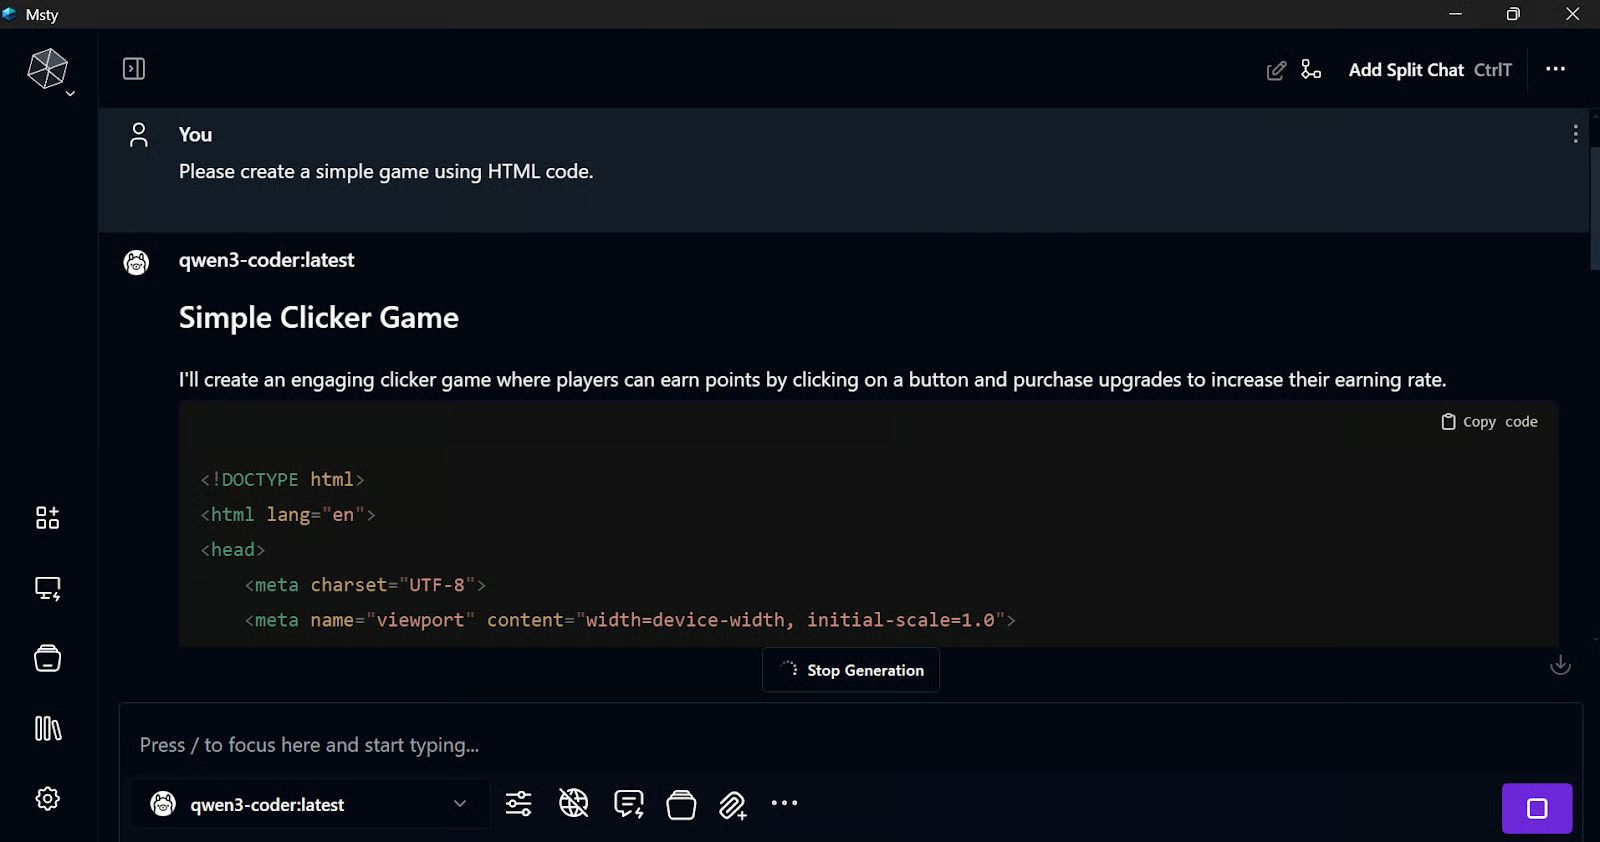
Essa integração é simples e versátil. Ao rodar Ollama serve, você conecta modelos do Ollama a vários apps e ferramentas, liberando ainda mais possibilidades criativas.
Como você sabe, o Qwen3-Coder foi feito especificamente para codificação e fluxos de trabalho com agentes. Se não o integrarmos ao editor, estamos deixando potencial na mesa.
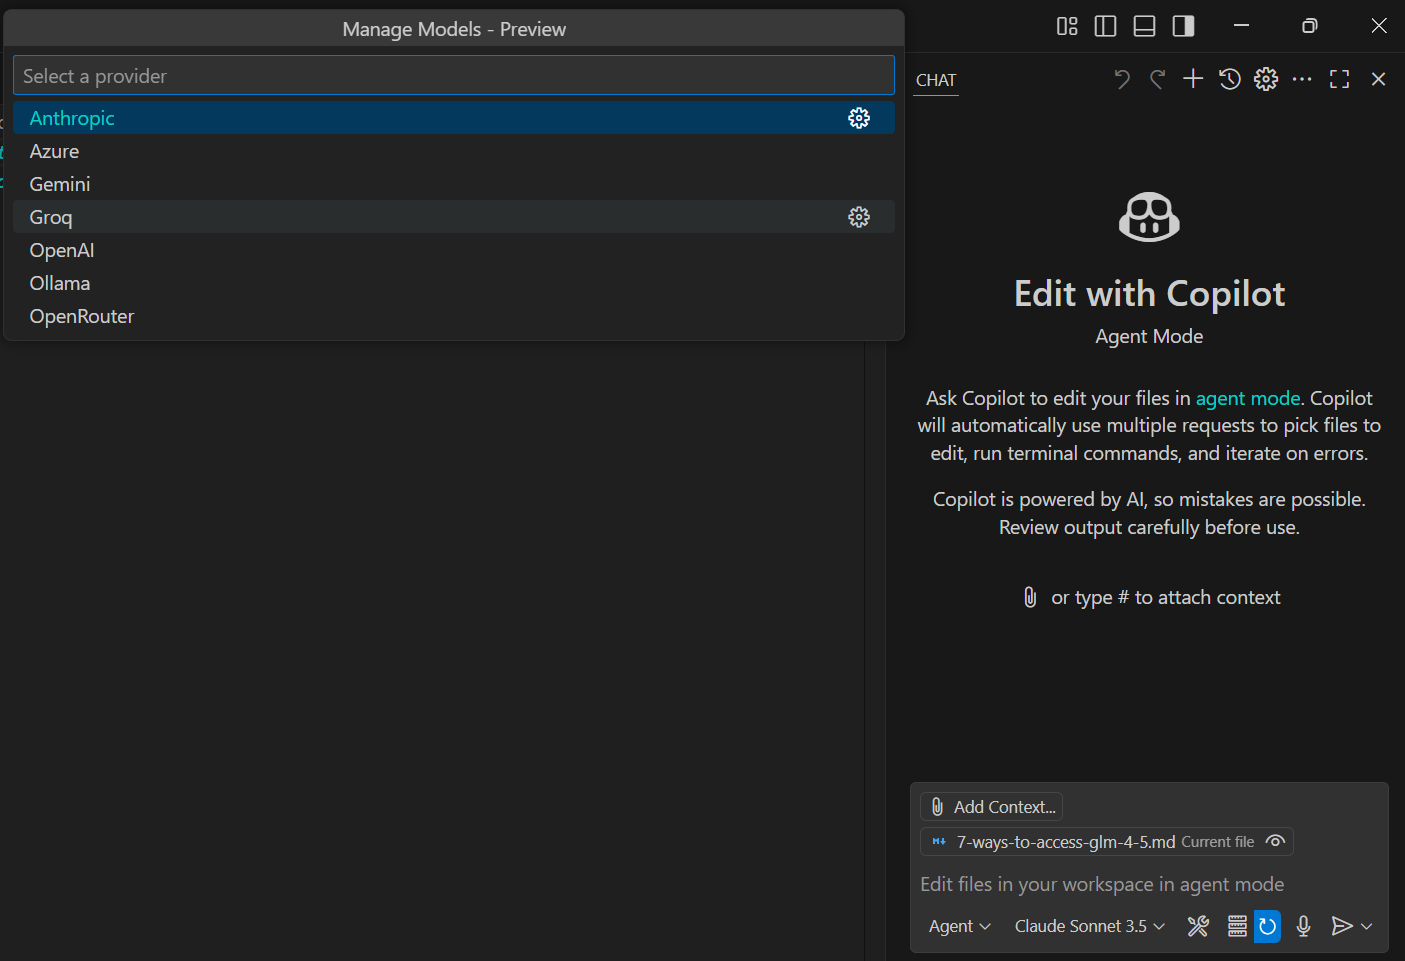
Agora vamos integrar o Qwen3-Coder ao GitHub Copilot no VS Code. As instalações mais novas do VS Code já vêm com a extensão do Copilot. Basta clicar no menu de seleção de modelo na parte inferior, depois em “Manage Models”, e escolher o Ollama como provedor. Isso exibirá os modelos disponíveis. Selecione o Qwen3-Coder e use o chat do GitHub Copilot como de costume.
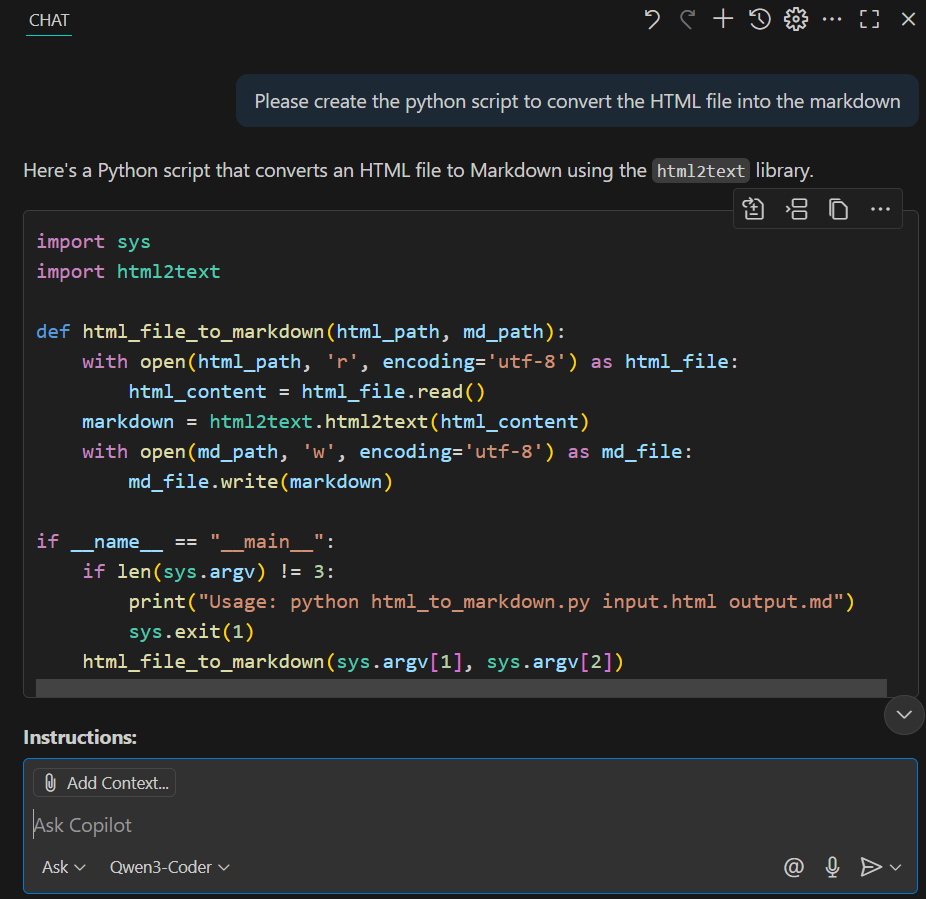
Pedimos para criar um script que converte HTML em Markdown, e levou só 10 segundos para gerar a resposta completa.
É rápido, local e fácil de usar.
A extensão do VSCode Kilo-Org/kilocode está ganhando popularidade como um dos melhores assistentes de código com IA open-source para planejar, construir e corrigir código.
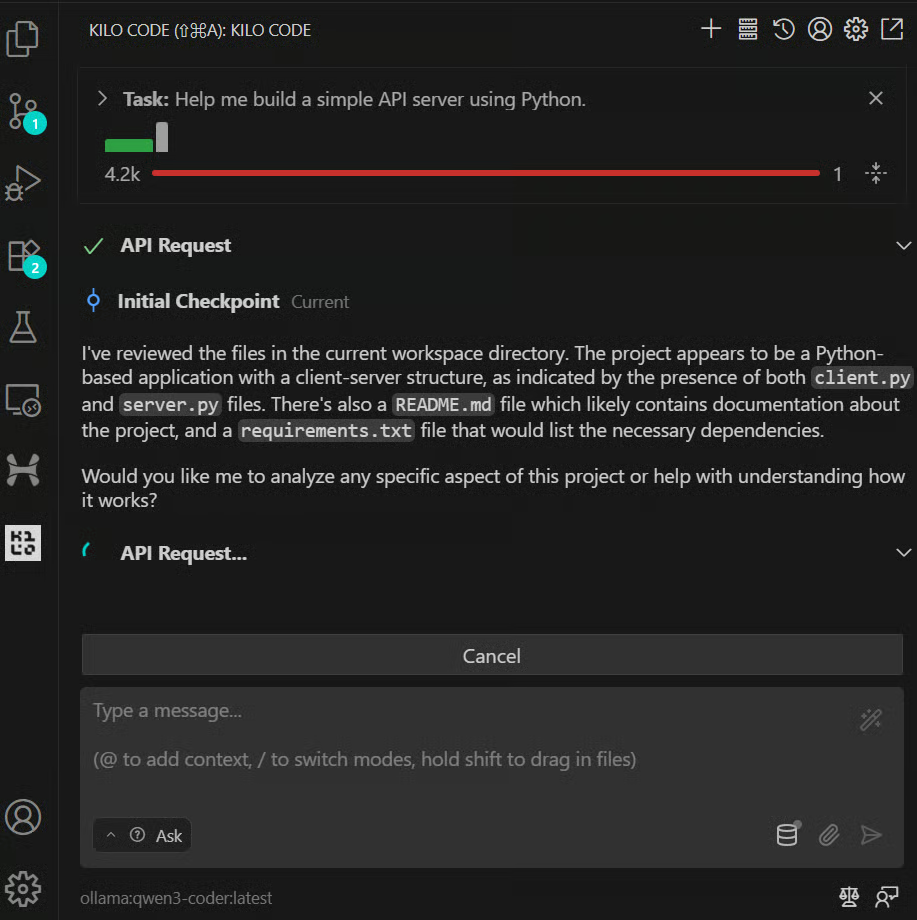
Para integrar nosso Qwen3-Coder rodando localmente, primeiro instale as extensões necessárias e depois vá até as configurações. Altere o provedor de API para Ollama e ele vai detectar o modelo automaticamente pela URL padrão.
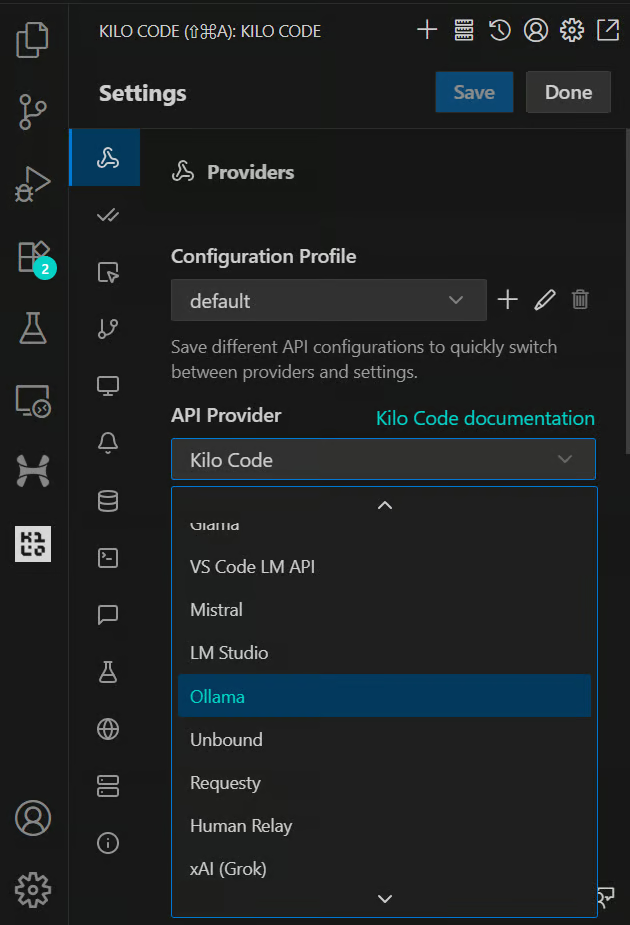
Em seguida, volte ao chat e peça para a IA criar um servidor de IA simples. Primeiro ela vai examinar todos os arquivos do projeto e depois sugerir a melhor solução para sua solicitação.
Integrar o Qwen3-Coder aos seus aplicativos em Python é simples com o pacote ollama/ollama-python. Isso permite rodar modelos de IA poderosos localmente e incorporá-los direto aos seus fluxos de trabalho
Para começar, basta instalar o pacote do Ollama:
pip install ollamaAqui está um exemplo mínimo de como usar o Qwen3-Coder no seu código Python, de forma semelhante a chamar a API da OpenAI:
from ollama import chat

def main():
    # Define um prompt de sistema + usuário
    messages = [
        {"role": "system", "content": "You are a helpful coding assistant."},
        {
            "role": "user",
            "content": (
                "Please write a Python function `quicksort(arr)` "
                "that takes a list of integers and returns it sorted."
            ),
        },
    ]

    # Faz streaming da resposta do Qwen3-Coder
    stream = chat(
        model="Qwen3-Coder",
        messages=messages,
        stream=True
    )

    # Imprime os chunks conforme chegam
    for chunk in stream:
        # chunk é um dict-like com ['message']['content']
        print(chunk["message"]["content"], end="", flush=True)

    # Finaliza com uma nova linha
    print()

if __name__ == "__main__":
    main()
A resposta começa a fazer streaming quase instantaneamente. A solução de quicksort abaixo levou apenas 15 segundos para ser gerada:
Here's a Python implementation of the quicksort algorithm:

```python
def quicksort(arr):
    """
    Sorts a list of integers using the quicksort algorithm.

    Args:
        arr: List of integers to be sorted

    Returns:
        A new list containing the sorted integers
    """
    # Base case: arrays with 0 or 1 element are already sorted
    if len(arr) <= 1:
        return arr

    # Choose pivot (using the middle element)
    pivot = arr[len(arr) // 2]

    # Partition the array into three parts
    left = [x for x in arr if x < pivot]      # Elements less than pivot
    middle = [x for x in arr if x == pivot]   # Elements equal to pivot
    right = [x for x in arr if x > pivot]     # Elements greater than pivot

    # Recursively sort left and right parts, then combine
    return quicksort(left) + middle + quicksort(right)

# Example usage:
if __name__ == "__main__":
    # Test cases
    print(quicksort([64, 34, 25, 12, 22, 11, 90]))  # [11, 12, 22, 25, 34, 64, 90]
    print(quicksort([5, 2, 8, 1, 9]))               # [1, 2, 5, 8, 9]
    print(quicksort([1]))                           # [1]
    print(quicksort([]))                            # []
    print(quicksort([3, 3, 3, 3]))                  # [3, 3, 3, 3]
```Este guia mostra como a IA local ficou acessível. Hoje, você consegue rodar modelos open-source em um notebook antigo e integrá-los ao seu editor de código, a apps de chat ou até criar apps de IA locais sob medida usando o Ollama Python SDK.
Há outras opções também, como usar o Qwen Code CLI (coberto em nosso guia separado: Qwen Code CLI: um guia com exemplos | DataCamp), ou servir modelos em um servidor local e acessá-los via SSH a partir de vários computadores. As possibilidades estão se expandindo rapidamente, tornando a IA local mais prática e versátil do que nunca.
Principais cursos de IA
Curso
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
DataCamp Team
4 min
blog
Abid Ali Awan
9 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
12 min
Tutorial