Curso
Análisis de series temporales en Python
4 h
70.6K
En la sesión de Facebook Live del 4 de enero, exploramos los datos de Google Trends de las palabras clave "diet", "gym" y "finance" para ver cómo varían con el tiempo. Nos preguntamos si en enero podría haber más búsquedas de estos términos, justo cuando intentamos empezar con buen pie el año.
En este tutorial, recorrerás paso a paso el código que preparamos durante la sesión. No vas a hacer muchas matemáticas: el énfasis está en la exploración visual del conjunto de datos.
Si quieres profundizar en pandas, echa un vistazo al itinerario Data Manipulation with Python de DataCamp. Para aprender más sobre series temporales con pandas, consulta el curso Manipulating Time Series Data in Python.
Así que la pregunta sigue en pie: ¿podría haber más búsquedas de estos términos en enero, cuando todos intentamos empezar una nueva etapa?
Vamos a comprobarlo yendo aquí y revisando los datos. Nota: este tutorial está inspirado en este artículo de FiveThirtyEight.
También puedes descargar los datos en .csv, guardarlos en un archivo e importarlos en tu propio entorno de Python para hacer tu análisis. Eso es lo que harás ahora. ¡Vamos a ello!
Para empezar, importa algunos paquetes: en este caso, utilizaremos numpy, pandas, matplotlib y seaborn.
Además, si quieres que las imágenes se muestren en Jupyter Notebook, puedes usar el “magic” de IPython añadiendo %matplotlib inline a tu código. Como alternativa, también puedes activar la configuración por defecto de Seaborn con sns.set():
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
Importa los datos que descargaste con .read_csv() y revisa las primeras filas con .head().
Nota: añade el argumento skiprows para omitir la primera fila del archivo.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
También puedes usar el método .info() para ver los tipos de datos, el número de filas y más:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Ahora que has importado los datos de Google Trends y les has echado un vistazo, toca prepararlos y dejarlos listos para el análisis.
Lo primero será renombrar las columnas de tu DataFrame df para que no tengan espacios. Hay varias formas de hacerlo, pero por ahora reasignarás a df.columns una lista con los nombres que quieres.
Comprueba el resultado llamando a df.head():
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Después, convertirás la columna 'month' a tipo DateTime y la pondrás como índice del DataFrame.
Nota: haces esto porque en el .info() viste que la columna 'Month' era de tipo object, un tipo genérico que abarca desde cadenas a enteros. No es lo ideal cuando trabajas con series temporales. Por eso usarás .to_datetime() para convertir 'month' en DateTime.
¡Ojo! Asegúrate de incluir el argumento inplace al establecer el índice de df para modificar el índice original y fijarlo a la columna 'month'.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Ahora toca explorar tu DataFrame de forma visual.
Puedes usar el método de visualización integrado de pandas .plot() para representar tus datos como 3 líneas en una misma figura (una por cada columna: 'diet', 'gym' y 'finance').
Nota: también puedes especificar argumentos como figsize, linewidth y fontsize para ajustar el tamaño de la figura, el grosor de línea y el tamaño de fuente del gráfico, respectivamente.
Además, verás que en el eje x no aparecen los meses como sugiere la etiqueta por defecto, sino los años. Para ser más preciso, cambia la etiqueta del eje x a 'Year' y ajusta el tamaño de fuente a 20.
Truco: si quieres suprimir la salida de Matplotlib, añade un punto y coma ; al final de la última línea.
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
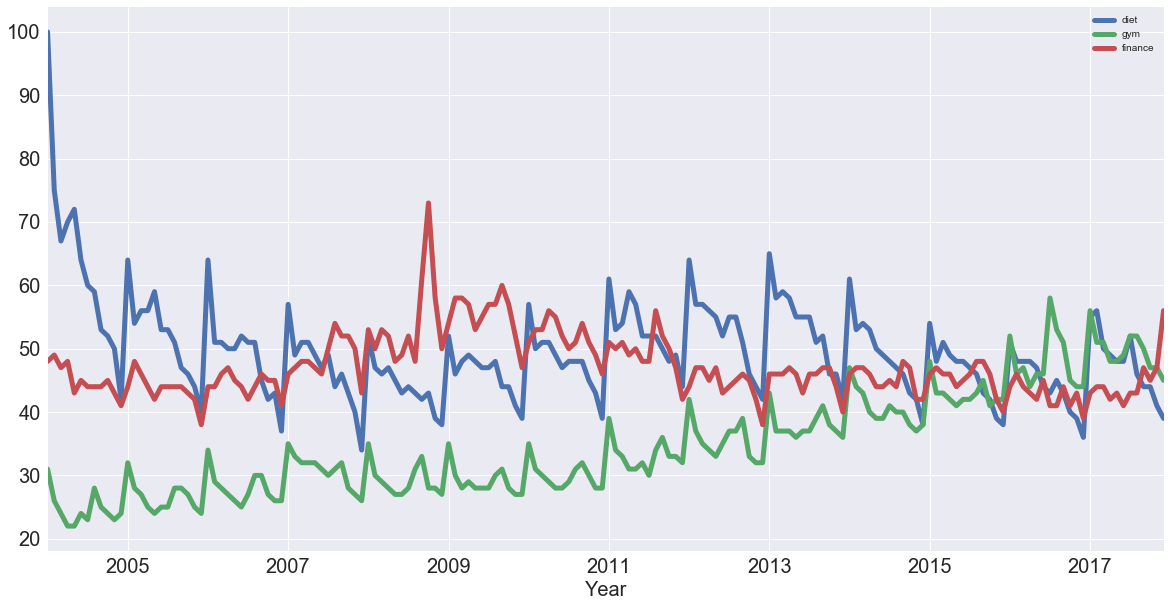
Nota: estos datos son relativos. Tal y como explica Google Trends:
Las cifras representan el interés de búsqueda relativo al punto más alto del gráfico para la región y el periodo seleccionados. Un valor de 100 indica la popularidad máxima del término. Un valor de 50 significa que el término es la mitad de popular. Del mismo modo, una puntuación de 0 indica que el término fue menos del 1% de popular con respecto al pico.
Si quieres, también puedes representar la columna 'diet' por separado como serie temporal:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
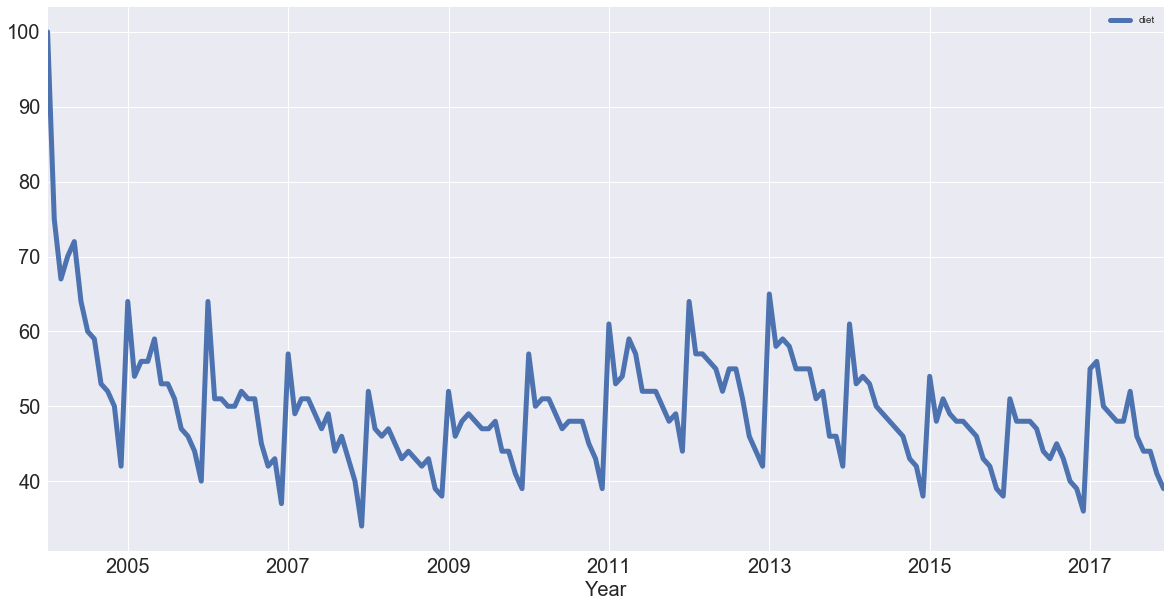
Nota: lo primero que salta a la vista es la estacionalidad: cada enero hay un gran salto. También parece haber una tendencia: sube ligeramente, luego baja, vuelve a subir y vuelve a bajar. Es decir, hay tendencias y componentes estacionales en estas series temporales.
Con esto en mente, vas a ver cómo identificar tendencias en tu serie temporal.
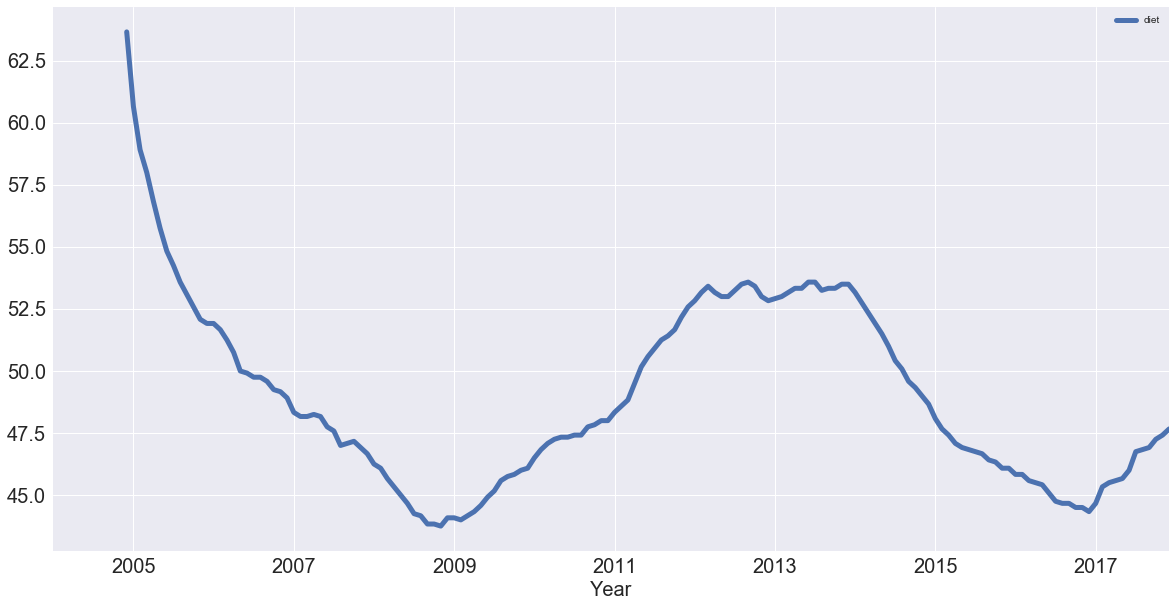
Hay varias formas de identificar tendencias en series temporales. Una muy común es calcular una media móvil, que consiste en que, para cada punto temporal, tomas la media de los puntos a ambos lados. El número de puntos viene dado por el tamaño de la ventana, que debes elegir.
Al promediar, se suaviza el ruido y la estacionalidad. Vamos a verlo con un ejemplo. Observa esta media móvil de 'diet' usando los métodos integrados de pandas.
Para decidir el tamaño de ventana, aquí tiene sentido empezar con doce meses, ya que hablamos de estacionalidad anual.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Nota: en el bloque anterior usaste dos corchetes para extraer la columna 'diet' como DataFrame; si hubieras usado uno, como df['diet'], habrías creado una Series de pandas.
En el bloque anterior también encadenaste métodos: llamaste a métodos de un objeto uno tras otro. El method chaining es muy popular y pandas permite usar este estilo de programación al máximo.
¡Ya tienes la tendencia que buscabas! Has eliminado gran parte de la estacionalidad respecto al gráfico anterior.
También puedes representar la media móvil de 'gym' con los métodos de pandas usando la misma ventana que para 'diet':
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
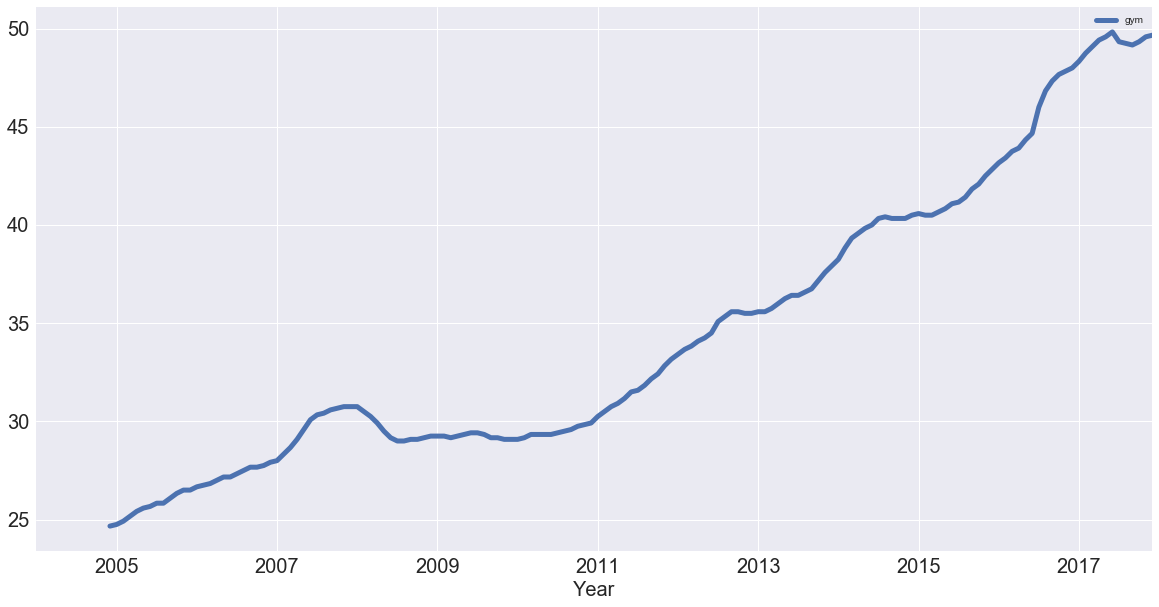
Has eliminado con éxito la estacionalidad y ves una tendencia al alza para "gym". Pero, ¿cómo se comparan estos dos términos de búsqueda?
Puedes averiguarlo representando las tendencias de 'gym' y 'diet' en una misma figura:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
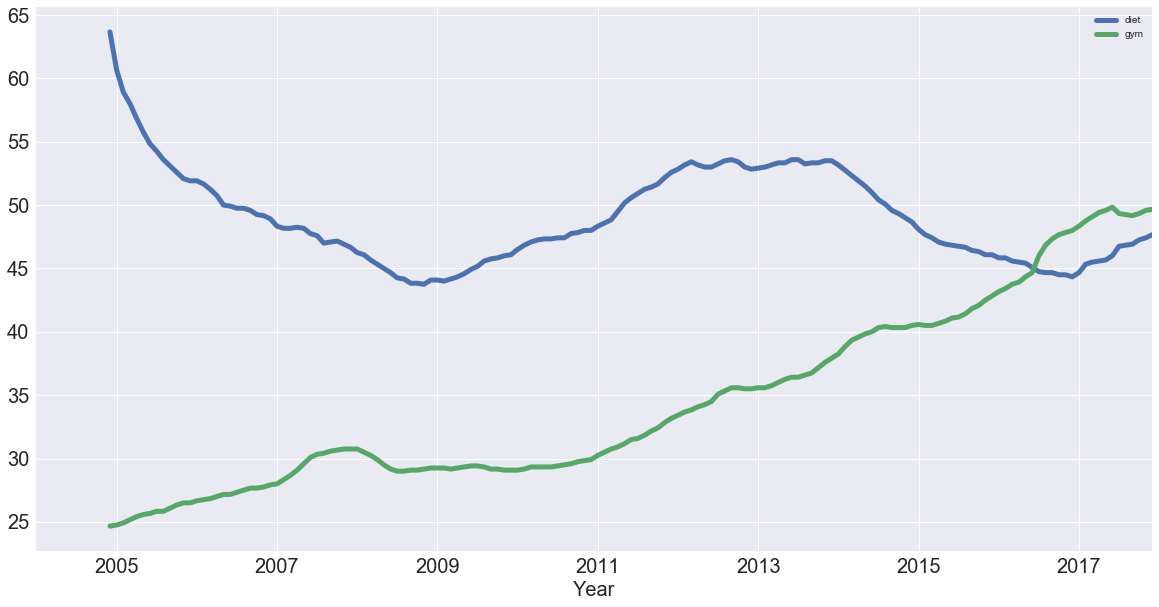
Has creado un nuevo DataFrame, df_rm, con dos columnas: las medias móviles de 'diet' y 'gym'. Usaste la función pd.concat(), que recibe una lista de columnas como primer argumento y, como querías concatenarlas como columnas, añadiste el argumento axis establecido en 1.
Después lo representaste con plot(), igual que antes. Sin la estacionalidad, se aprecia que diet podría tener cierta estacionalidad residual, mientras que gym crece con el tiempo.
Identificadas las tendencias, toca pensar en la estacionalidad, es decir, la naturaleza repetitiva de tu serie temporal. Como viste al principio, parecía haber tanto tendencia como componente estacional.
Una forma de estudiar la estacionalidad es eliminar la tendencia de la serie para investigar con más facilidad los patrones estacionales. Para quitar la tendencia, puedes restar a la señal original la tendencia que calculaste (la media móvil). Esto dependerá del tamaño de la ventana que elijas.
Otra forma de eliminar la tendencia es el “differencing”, donde miras la diferencia entre puntos sucesivos (llamado “differencing de primer orden”, porque comparas cada punto con el inmediatamente anterior).
Puedes usar pandas y los métodos diff() y plot() para calcular y representar la diferencia de primer orden de la Series 'diet':
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
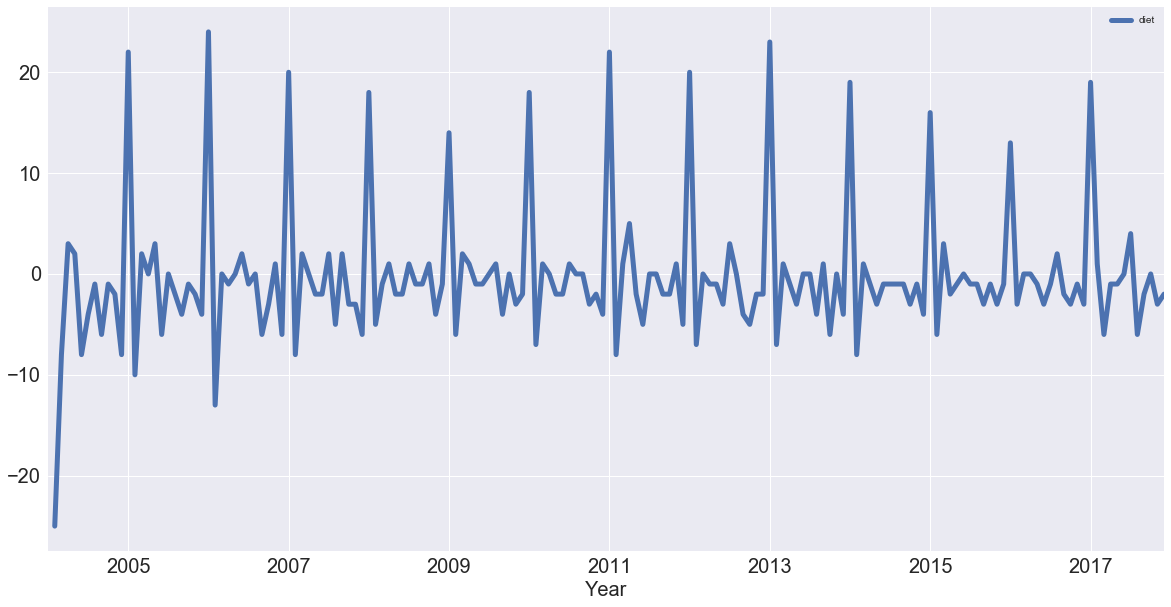
Verás que has eliminado gran parte de la tendencia y se aprecian claramente los picos de enero cada año. ¡Cada enero hay un pico enorme de 20 o más puntos sobre el valor más alto observado!
Nota: también puedes aplicar differencing de segundo orden, comparando cada punto con los dos anteriores si la tendencia no se ha eliminado del todo. Consulta aquí para saber más.
El differencing es muy útil para convertir tu serie temporal en una serie estacionaria. Sin entrar en detalles, una serie estacionaria es aquella cuyas propiedades estadísticas (como media y varianza) no cambian con el tiempo. Son útiles porque muchos métodos de predicción de series temporales suponen que la serie es aproximadamente estacionaria.
Con esto, vas a analizar la periodicidad de tu serie temporal mirando su función de autocorrelación. Pero antes, un breve repaso a la correlación.
Una serie temporal es periódica si se repite a intervalos regulares, por ejemplo, cada 12 meses.
Otra forma de pensarlo: si la serie tiene un pico en algún punto, tendrá otro pico 12 meses después; si tiene un valle, también lo tendrá 12 meses más tarde.
Dicho de otra manera, la serie está correlacionada consigo misma desplazada 12 meses. Es decir, si desplazas la serie 12 meses hacia atrás o hacia delante, se alineará consigo misma en cierta medida.
La correlación de una serie con una versión desplazada de sí misma es la autocorrelación.
Lo verás enseguida.
Primero, recordemos qué es la correlación con un enfoque intuitivo.
El coeficiente de correlación de dos variables captura cuán relacionadas linealmente están. Para entenderlo, veremos un ejemplo práctico con el conjunto de datos iris, que contiene mediciones de flores.
Para estudiarlo, importa el conjunto iris de scikit-learn, conviértelo en DataFrame y muestra las primeras filas con .head():
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Como recordatorio, todas las flores tienen sépalo y pétalo. El sépalo envuelve a los pétalos y suele ser verde y con aspecto de hoja; los pétalos suelen ser de colores. La columna 'target', la variable objetivo, es la especie de iris (Versicolor, Virginica o Setosa), codificadas como 0, 1 y 2 en la tabla.
Ahora, para pensar en la correlación, observa cómo se relacionan la longitud del sépalo con su anchura. Para ello, usa pandas o seaborn para crear un diagrama de dispersión de 'sepal length' frente a 'sepal width':
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
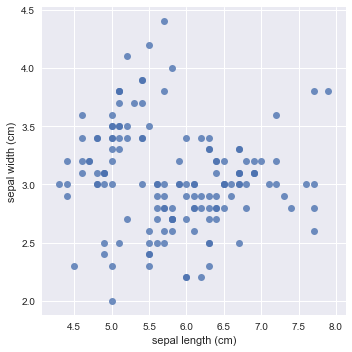
Nota: desactivaste la regresión lineal estableciendo el argumento fit_reg a False.
¿La longitud y la anchura del sépalo están correlacionadas positiva o negativamente en todas las flores? ¿Y dentro de cada especie? Es una distinción esencial.
Recuerda: correlación positiva significa que, a medida que aumenta la longitud del sépalo, también aumenta su anchura de forma lineal. Negativa significa que, si aumenta la longitud, la anchura disminuye linealmente.
A primera vista, parece haber correlación negativa en el gráfico: al aumentar la longitud del sépalo, la anchura disminuye ligeramente.
Ahora crearemos un diagrama de dispersión de 'sepal length' frente a 'sepal width', coloreado por la variable objetivo (species):
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
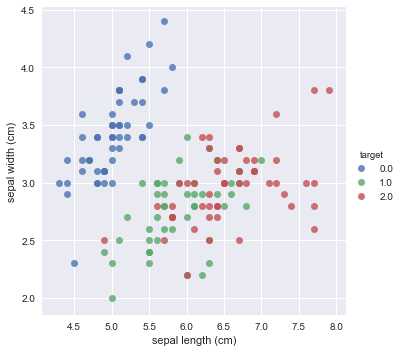
A primera vista, parece que el gráfico muestra correlación positiva: para cada especie, cuando aumenta la longitud del sépalo, también lo hace su anchura.
Las visualizaciones ayudan a construir intuición, pero puedes ir más allá calculando el coeficiente de correlación.
Puedes calcular los coeficientes de correlación de cada par de medidas con el método .corr():
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Nota: "sepal length (cm)" y "sepal width (cm)" parecen estar negativamente correlacionadas en el conjunto completo (coeficiente -0,1). Sin embargo, dentro de cada especie no lo están: ahí la correlación es positiva (por ejemplo, 0,78).
Esto se conoce como la paradoja de Simpson y es clave al pensar en inferencia causal. Puedes leer más aquí.
Profundicemos un poco más. Vamos a calcular los coeficientes de correlación dentro de cada especie encadenando .groupby() y .corr() para agrupar por la variable objetivo y obtener los coeficientes:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
En esta matriz de correlación puedes ver que:
Son correlaciones positivas decrecientes, pero todas mucho más altas que la correlación negativa que veías en el total.
Esto es muy revelador y recuerda la importancia de analizar los datos a fondo.
Ahora que has repasado la correlación, estás listo para analizar la periodicidad de tu serie temporal con su función de autocorrelación.
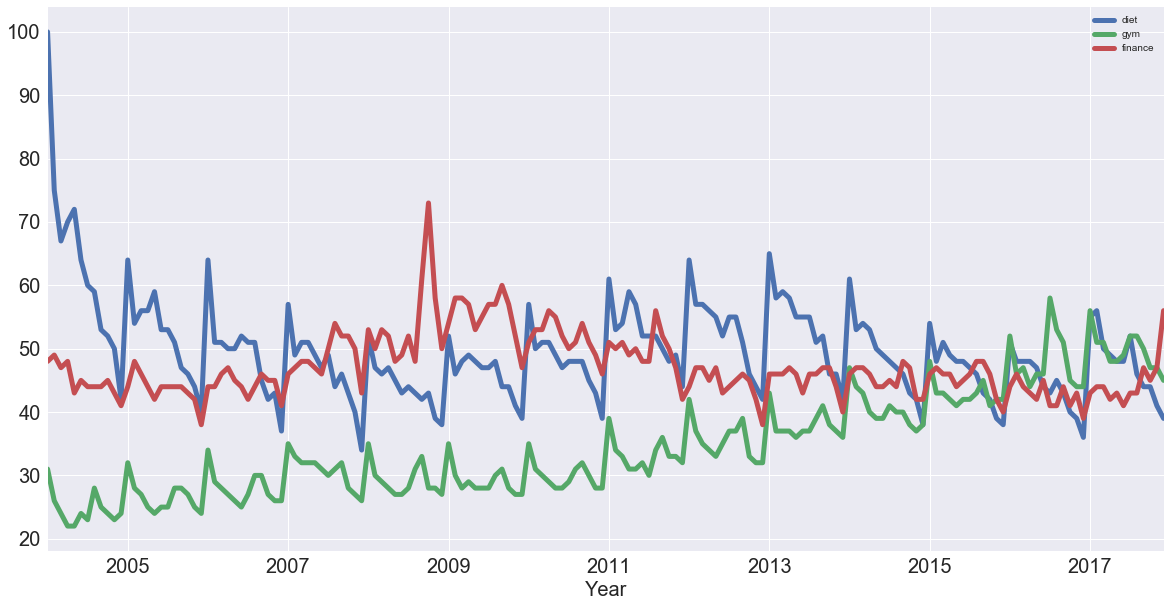
Para empezar, vuelve a representar todas tus series temporales para recordar su aspecto:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Luego, calcula los coeficientes de correlación de todas estas series con .corr():
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
¿Qué te dice esto?
Centrándonos en 'diet' y 'gym': están negativamente correlacionadas. ¡Interesante! Recuerda que hay componente estacional y de tendencia. A partir del coeficiente, "diet" y "gym" son negativamente correlacionadas. Pero, mirando las series, parece que sus componentes estacionales estarían positivamente correlacionados y sus tendencias, negativamente.
El coeficiente global está capturando ambas cosas.
Ahora quieres representar las diferencias de primer orden de estas series y luego calcular su correlación, que aproximará la correlación de las componentes estacionales. Recuerda: eliminar la tendencia puede revelar correlación en la estacionalidad.
Empieza representando las diferencias de primer orden con .diff() y .plot():
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
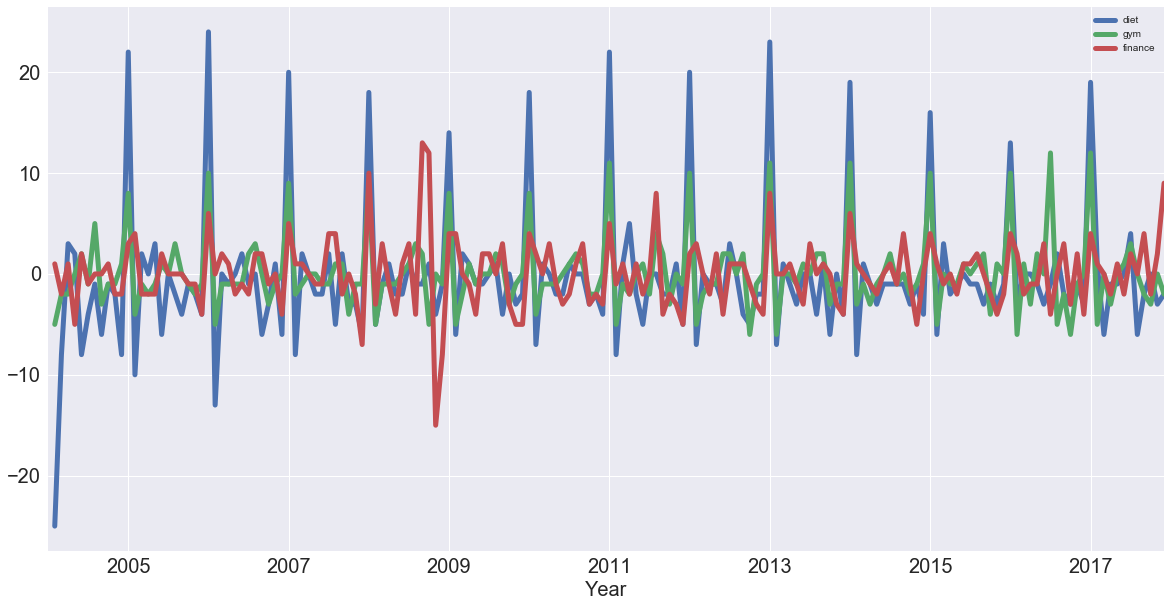
Verás que 'diet' y 'gym' están muy correlacionadas una vez eliminas la tendencia. Ahora calcula los coeficientes de correlación de las diferencias de primer orden:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Nota: de nuevo, antes veías una ligera correlación negativa al considerar conjuntamente tendencia y estacionalidad. Ahora, al mirar la componente estacional, 'diet' y 'gym' están muy correlacionadas (coeficiente 0,76).
Tras repasar la correlación entre variables y entre series temporales, toca representar la autocorrelación de la serie 'diet': en el eje x está el retardo (lag) y en el eje y, la correlación de la serie consigo misma a ese lag.
Si la serie se repite cada dos días, esperarías un pico en la función de autocorrelación en 2 días.
Aquí deberías ver un pico en 12 meses: la serie está correlacionada consigo misma desplazada doce meses.
Usa la interfaz plotting de pandas, que incluye la función autocorrelation_plot(). Puedes usarla para representar la serie 'diet':
pd.plotting.autocorrelation_plot(diet);
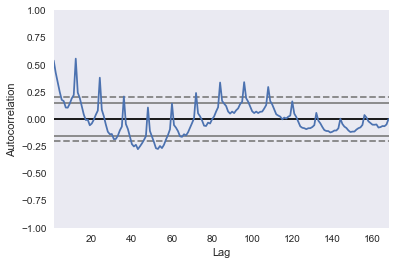
Si incluyeras más retardos en los ejes, verías que el gran pico de correlación se da a los 12 meses. Hay otro pico a los 24 meses, y otro a los 36; a medida que te alejas, la correlación disminuye.
Por supuesto, hay correlación perfecta consigo misma en el lag 0.
Las líneas discontinuas del gráfico indican la significación estadística de la correlación. En este caso, puedes afirmar que la serie 'diet' está genuinamente autocorrelacionada con un retardo de doce meses.
¡Has identificado la estacionalidad con repetición cada 12 meses!
En este tutorial hemos cubierto bastante terreno. Revisaste los datos de Google Trends de las palabras clave "diet" y "gym" y echaste un vistazo a "finance" para ver su evolución en el tiempo. Vimos conceptos como estacionalidad, tendencias, correlación, autocorrelación, ...
Si te quedas con ganas de más, aquí tienes dos ideas para continuar:
Aprende más sobre Python
Curso
Curso
Curso
Tutorial
Elena Kosourova
8 min
Tutorial
Duong Vu
11 min
Tutorial
Karlijn Willems
14 min
Tutorial
Karlijn Willems
15 min
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
20 min



