Cours
Comprendre le cloud
2 h
252.9K
Gérer un serveur physique ou virtuel n’a rien d’anodin : coûts de maintenance élevés, besoin de compétences pointues… L’informatique serverless résout ces problèmes en offrant un moyen économique de développer et d’exécuter des applications dans le cloud.
Dans cet article, nous passons en revue l’informatique serverless, ses usages et ses bénéfices pour les développeurs et les entreprises. Le sujet est d’actualité : la taille du marché du serverless a dépassé 9 millions $ en 2022 et devrait encore croître de 25 % sur les dix prochaines années. Allons à l’essentiel.
Imaginez que l’eau et l’électricité de votre logement soient facturées strictement à l’usage, plutôt qu’un forfait mensuel estimé. C’est le principe du serverless : les fournisseurs cloud allouent dynamiquement leur infrastructure pour vous permettre de créer et d’exécuter vos applications en fonction de l’utilisation, sans vous soucier de la maintenance des serveurs.
À la différence du cloud traditionnel, où l’on met en place des serveurs physiques ou virtualisés, du stockage et du réseau, en serverless c’est le fournisseur cloud qui gère l’infrastructure et alloue automatiquement les ressources au fur et à mesure que votre application monte en charge. Autrement dit, le serverless abstrait le serveur côté développeurs, qui peuvent se concentrer sur l’application plutôt que sur l’infrastructure qui l’héberge.
Supposons que votre application accueille 100 à 200 utilisateurs par jour. Si, du jour au lendemain, elle en reçoit 1 000 000, la plateforme serverless ajuste automatiquement les ressources pour absorber le pic. En cloud traditionnel, cela provoquerait des interruptions de service en raison du trafic accru, et il faudrait acheter du stockage supplémentaire si nécessaire — une opération longue.
| Catégorie | Informatique serverless | Informatique traditionnelle |
|---|---|---|
| Mise à l’échelle | Dynamique | Fixe |
| Facturation | À l’usage | Coûts récurrents, quel que soit l’usage, incluant maintenance et exploitation |
| Gestion de l’infrastructure | Abstraite pour les entreprises | Nécessite une gestion active |
Avant de présenter les fonctionnalités qui distinguent le serverless des autres modèles cloud, passons en revue quelques notions essentielles.
Appelée également Function as a Service (FaaS), l’application serverless est découpée en fonctions indépendantes déclenchées par des événements spécifiques : requêtes HTTP, modifications en base de données, messages, téléversements de fichiers, etc.
Par exemple, vous avez une application serverless qui traite automatiquement les images déposées dans un bucket Amazon S3. Lorsqu’un utilisateur téléverse une image, une fonction est déclenchée pour la traiter puis l’enregistrer dans un autre bucket S3. La fonction ne s’exécute qu’en cas de besoin, ce qui rend le système efficace et économique.
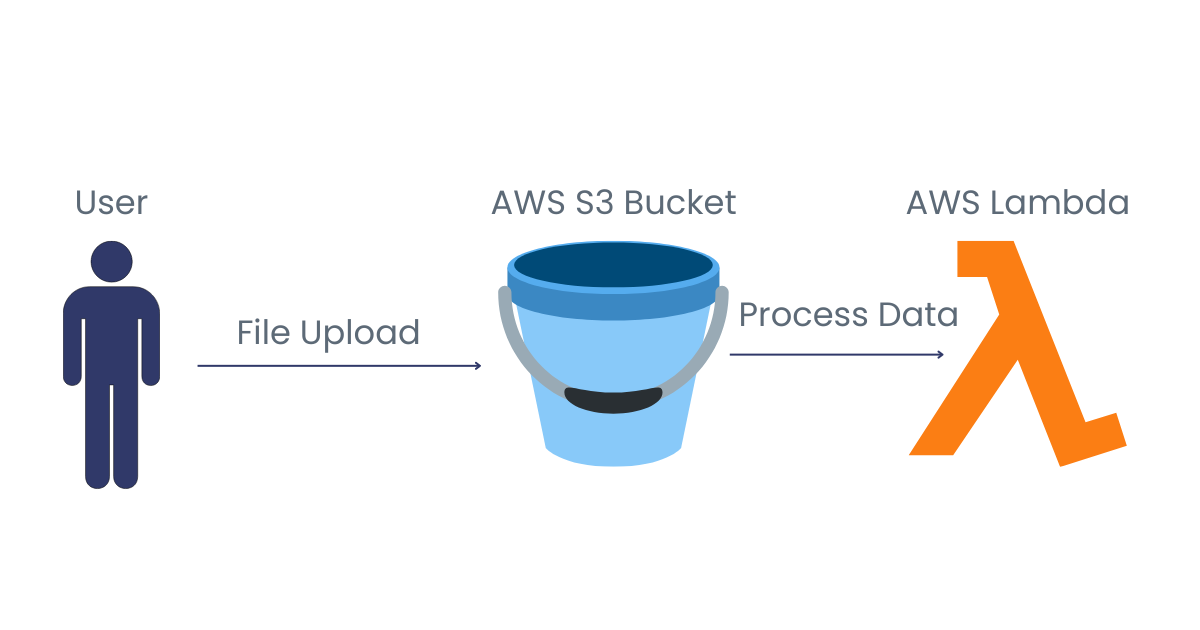
Exécution pilotée par les événements, avec l’exemple d’un téléversement de fichier. Image par l’auteur
La mise à l’échelle automatique consiste à allouer des ressources de calcul selon la demande et les charges de travail. C’est une caractéristique clé du serverless qui garantit l’adaptabilité et évite le gaspillage de ressources quand la charge est faible, tout en prévenant les interruptions lors des pics.
Par exemple, en cas de pic de trafic, la plateforme fournit automatiquement des instances supplémentaires pour absorber la charge. À l’inverse, elle réduit les ressources lorsque le trafic baisse afin de minimiser les coûts. L’application reste ainsi efficace sans intervention manuelle, réactive et économique dans divers scénarios.
Les plateformes serverless facturent selon les ressources réellement consommées, et non celles réservées. Contrairement aux modèles cloud traditionnels où une partie des ressources allouées peut rester inutilisée, vous payez uniquement le temps de calcul employé. La tarification est également métrée : coût par invocation et/ou par durée d’exécution, pour une facturation au plus juste.
Si, par exemple, votre application traite 100 images sur un mois, vous ne payez pas un serveur 24 h/24 : vous payez uniquement le temps de calcul nécessaire au traitement de ces 100 images.
Autre atout majeur : développeurs et entreprises n’ont plus à se préoccuper du provisionnement, de la montée en charge et de la maintenance des serveurs. Ils peuvent se concentrer sur le cœur produit et confier l’infrastructure aux fournisseurs cloud.
Les plateformes serverless peuvent exécuter plusieurs fonctions en parallèle, ce qui les rend rapides et efficaces par rapport aux approches traditionnelles. Si votre fournisseur définit une limite de concurrence par défaut de 100 pour le téléversement d’images, toute requête au-delà de ce seuil est mise en file d’attente et traitée lors de l’exécution suivante.
Contrairement au cloud traditionnel, qui repose sur des serveurs dédiés et engendre des coûts même à l’arrêt, le serverless adopte une logique événementielle de facturation. L’analogie du taxi est parlante : avec un taxi, vous ne payez ni stationnement ni carburant, seulement la distance parcourue. En serverless, c’est pareil : vous payez ce que vous utilisez. À l’inverse, posséder la voiture (l’approche traditionnelle) vous fait supporter tous les coûts, même à l’arrêt.
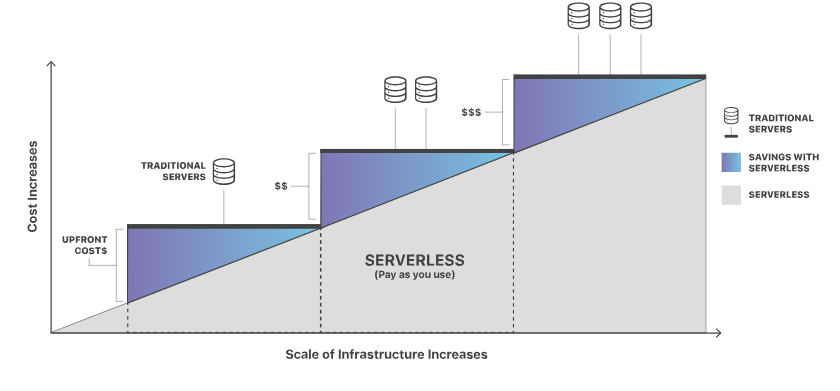
Comparaison d’efficacité des coûts entre types de serveurs. Source : Cloudflare
Le serverless fait gagner un temps précieux : plus besoin d’installer et d’entretenir des serveurs, les équipes se concentrent sur le développement applicatif. Les fonctions étant indépendantes, on peut en mettre à jour une sans perturber les autres ni l’application entière.
C’est l’un des bénéfices majeurs du serverless, qui séduit particulièrement les petites structures et les start-up. Les plateformes serverless facilitent l’augmentation automatique des ressources quand la demande croît. Pour des fonctions soumises à de fortes variations, elles ajustent allocations et capacité pour optimiser l’usage des ressources.
Avec des applications serverless, vous livrez rapidement et recueillez immédiatement les retours utilisateurs. Un avantage clé pour les start-up : moins de temps et de ressources nécessaires pour mettre un produit sur le marché.
À la différence d’applications hébergées sur des serveurs dédiés, une application serverless peut s’exécuter depuis divers emplacements, améliorant les performances et réduisant la latence par rapport au cloud traditionnel.
L’architecture serverless permet de concevoir des applications sans installer ni gérer l’infrastructure d’hébergement. On peut bâtir des applications serverless via deux modèles : le Backend as a Service (BaaS) et le Function as a Service (FaaS).
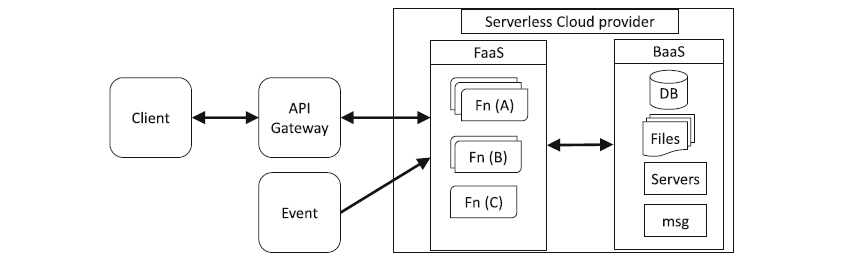
Architectures cloud serverless FaaS et BaaS. Source : Journal of Cloud Computing
L’objectif du serverless est d’abstraire la gestion des serveurs côté développeurs. Voici le fonctionnement type d’une plateforme serverless.
On peut se demander : l’architecture serverless n’est-elle pas équivalente aux conteneurs, puisque toutes deux abstraient le serveur ? En partie, oui. Mais, contrairement aux fonctions serverless qui masquent entièrement le serveur lors du développement et du déploiement, une application en conteneurs doit être mise à l’échelle explicitement lors des pics, avec des outils comme Kubernetes. Cela va à l’encontre de l’esprit FaaS, où la plateforme gère automatiquement ces aspects.
Avec des conteneurs, des instances peuvent tourner longtemps et engendrer des coûts, alors qu’en serverless vous êtes facturé au temps d’exécution des fonctions. Pour des applications modestes, le serverless facilite le découplage en unités indépendantes exécutées comme fonctions.
Avant Google App Engine en 2008, Zimki proposait la première plateforme « pay as you go » pour exécuter du code, avant d’être arrêtée. À ses débuts, Google App Engine ne supportait que Python et facturait les applications à l’usage, dont SnapChat. Vers 2010, PiCloud a également offert du FaaS pour des applications Python.
En 2014, AWS popularise le modèle serverless avec des outils comme AWS Serverless Application Model (AWS SAM) et Amazon CloudWatch. Google lance ensuite Google Cloud Functions, et Azure, Azure Functions, en 2016. Depuis, d’autres plateformes ont vu le jour, comme Function Compute d’AliBaba Cloud et IBM Cloud Functions d’IBM Cloud.
Pour s’affranchir des bases de données physiques ou virtualisées, des bases de données serverless ont également émergé. AWS propose Amazon Aurora, une version serverless compatible MySQL et PostgreSQL. Azure propose Azure Data Lake, et Google Firestore.
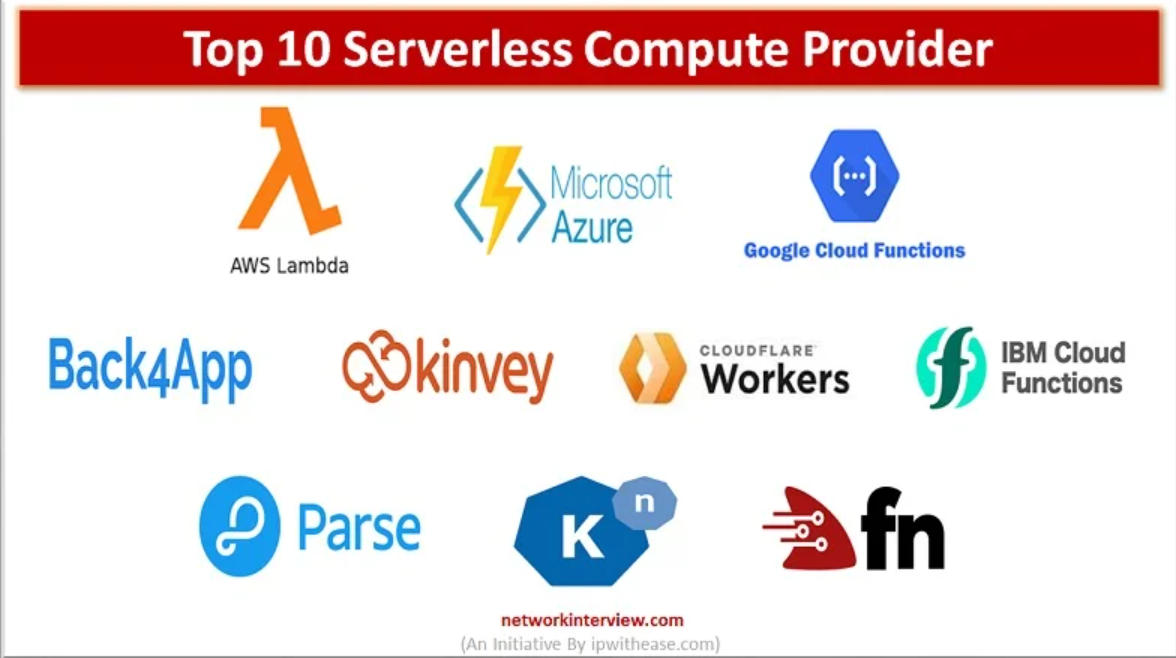
Plateformes cloud serverless. Source : Network Interview
Le serverless sert à construire des applications web et des API REST. Atout clé : l’infrastructure s’adapte automatiquement à la demande des utilisateurs, améliorant l’expérience.
Le serverless simplifie le traitement de contenus multimédias. Les utilisateurs téléversent des médias de tailles et d’appareils variés ; une fonction unique traite chaque besoin sans dégrader les performances. Ex. : téléversement d’une image dans un bucket S3 déclenchant une fonction AWS Lambda pour ajouter un filigrane ou générer une vignette.
Les développeurs peuvent déployer un chatbot pour répondre aux clients via une architecture serverless et ne payer que les ressources consommées. Par exemple, Slack utilise le serverless pour absorber les variations de requêtes des bots et éviter une bande passante sous-utilisée en période creuse.
Vous pouvez utiliser une plateforme serverless pour interagir avec des éditeurs SaaS via un endpoint HTTP de webhook, qui reçoit des notifications et exécute des tâches. Avantages : maintenance minimale, coûts réduits, scaling automatique.
Coca‑Cola utilise des architectures serverless sur ses distributeurs Freestyle afin de permettre la commande, le paiement et les notifications. Coca‑Cola indique avoir réduit les coûts d’exploitation d’environ 13 000 $/an à 4 500 $/an après passage au serverless.
Major League Baseball Advanced Media a conçu Statcast avec une architecture serverless pour fournir des métriques sportives précises en temps réel. Le serverless est utilisé pour traiter les données et offrir des insights sur les matchs de baseball.
Le serverless est idéal pour des applications réactives aux événements : un changement d’état déclenche un service. On peut, par exemple, surveiller des modifications en base et les comparer à des critères de qualité.
Lorsque les données parcourent de longues distances depuis des serveurs centralisés, la livraison de contenu et le traitement des requêtes souffrent de latence et d’engorgements.
Le serverless en périphérie (edge) atténue ce problème en répartissant les ressources de calcul sur plusieurs emplacements pour décharger le serveur central. Il s’agit d’exécuter des fonctions serverless au plus près des utilisateurs finaux. Résultat : compatibilité avec davantage d’appareils, moindre congestion et latence réduite.
Dans ce modèle, des ressources sont dédiées à chaque appareil, qui peut réaliser des tâches complexes sans renvoyer systématiquement les données au centre pour traitement. Exemples d’usages optimisant l’expérience via des fonctions edge :
Malgré ses atouts, le serverless présente certains inconvénients.
Pour les entreprises qui souhaitent créer des applications légères, le serverless est une voie privilégiée. Pour des applications composées de nombreux services aux interactions complexes, un modèle hybride avec des machines virtuelles pour les traitements lourds est recommandé ; les fonctions serverless ne servant alors qu’aux tâches courtes. Les fonctions edge peuvent aussi être envisagées pour réduire la latence en traitant les données localement sans surcharger le serveur central.
Gardez à l’esprit que le serverless évolue rapidement. Par exemple, une approche multi‑cloud permet de combiner des services de plusieurs fournisseurs au sein d’une même application. Des avancées visent également à éliminer les cold starts, comme avec les Cloudflare Workers.
Merci de votre lecture. Pour approfondir et développer vos compétences sur le serverless, découvrez ces ressources DataCamp :
Pour une lecture plus rapide, consultez notre article de blog avec des idées de projets pour tous les niveaux.
Apprenez avec DataCamp
Cours
Cours
Cours