Kurs
Cloud Computing verstehen
2 Std.
252.9K
Die Pflege eines physischen oder virtuellen Servers ist aufwendig – ob wegen hoher Wartungskosten oder fehlender Fachkräfte. Serverless Computing löst dieses Problem, indem es Entwickler:innen eine kostengünstige Möglichkeit bietet, Anwendungen in der Cloud zu entwickeln und auszuführen.
In diesem Artikel schauen wir uns Serverless Computing, seine Anwendungsfälle und die Vorteile für Entwickler:innen und Unternehmen an. Das Thema ist relevant, denn die Marktgröße für Serverless Computing lag 2022 bereits über 9 Mio. US‑Dollar und soll in den nächsten zehn Jahren um weitere 25 % wachsen. Legen wir los.
Stell dir vor, Strom und Wasser in deinem Haushalt würden nach tatsächlichem Verbrauch abgerechnet statt zu einer pauschalen Monatsgebühr. So funktioniert Serverless Computing: Cloud-Anbieter stellen ihre Infrastruktur so bereit, dass du Anwendungen nutzungsbasiert entwickeln und betreiben kannst – ohne dich um Serverwartung zu kümmern.
Im Gegensatz zum klassischen Cloud Computing, bei dem physische oder virtualisierte Server, Speicher und Netzwerke eingerichtet werden, verwaltet beim Serverless Computing der Cloud-Anbieter die Infrastruktur und weist automatisch Ressourcen zu, wenn deine Anwendung skaliert. Anders gesagt: Serverless Computing abstrahiert den Server für Entwickler:innen. So können sie sich auf die Anwendung konzentrieren, statt auf die zugrunde liegende Infrastruktur.
Angenommen, du hast täglich 100 bis 200 Nutzer:innen. Springt die Zahl am nächsten Tag plötzlich auf 1.000.000, skaliert die Plattform automatisch die benötigten Ressourcen. Mit herkömmlichem Cloud Computing ist das kaum möglich: Der Server würde unter der Last ausfallen und bei zu wenig Speicher müsste erst kostspielig und zeitaufwendig aufgerüstet werden.
| Kategorie | Serverless Computing | Traditionelles Computing |
|---|---|---|
| Skalierung | Dynamisch | Fix |
| Abrechnung | Nutzungsbasiert | Laufende Kosten unabhängig von der Nutzung, inklusive Wartungs- und Betriebskosten |
| Infrastrukturmanagement | Von Unternehmen abstrahiert | Erfordert aktive Verwaltung |
Bevor wir uns die Features ansehen, die Serverless Computing von klassischen Cloud-Modellen unterscheiden, klären wir die wichtigsten Fachbegriffe.
Ereignisgesteuerte Ausführung wird auch als Function-as-a-Service (FaaS) bezeichnet. Eine serverlose Anwendung wird in unabhängige Functions zerlegt, die durch Ereignisse wie HTTP-Anfragen, Datenbankänderungen, Nachrichten in Queues oder Datei-Uploads ausgelöst werden.
Angenommen, deine Anwendung verarbeitet automatisch Bilder, sobald sie in einen Amazon-S3-Bucket hochgeladen werden. Lädt ein:e Nutzer:in ein Bild hoch, wird eine Function ausgelöst, die das Bild verarbeitet und in einem anderen S3-Bucket speichert. So läuft die Function nur bei Bedarf – effizient und kostengünstig.
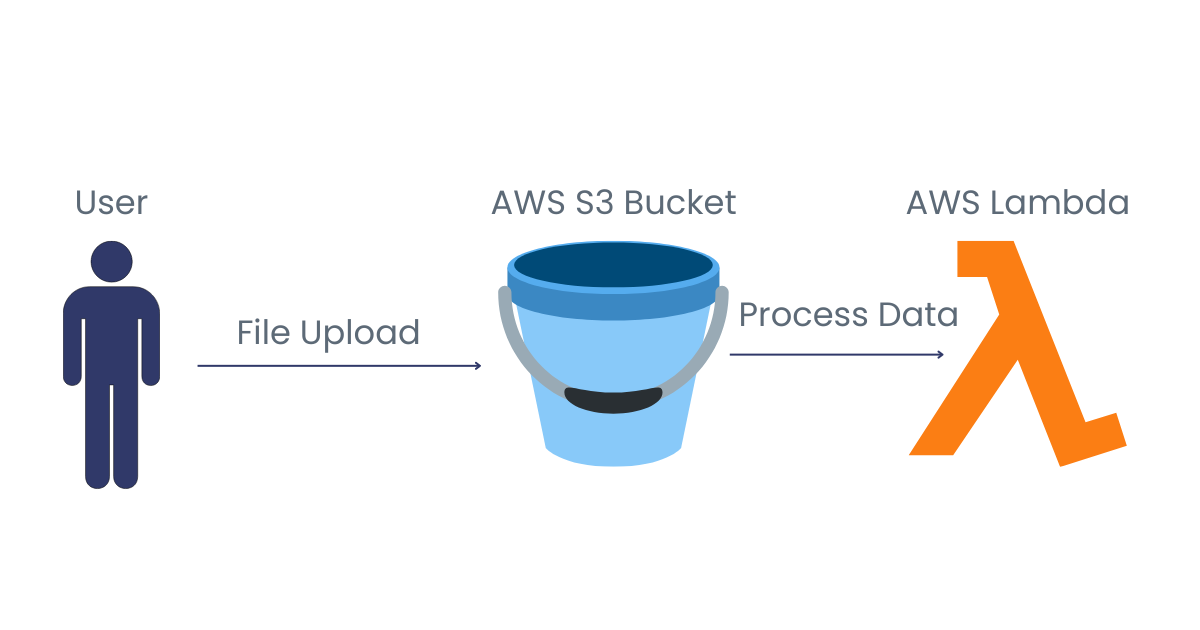
Ereignisgesteuerte Ausführung am Beispiel eines Datei-Uploads. Bild: Autor:in
Auto-Scaling bedeutet, Rechenressourcen je nach Nachfrage oder Workload zuzuweisen. Es ist ein zentrales Merkmal des Serverless Computings: Ressourcen werden nicht verschwendet, wenn wenig Last anliegt, und es gibt keine Ausfälle, wenn die Nachfrage steigt.
Beispiel: Deine Anwendung erlebt einen Traffic-Peak. Statt Ausfällen durch Überlast stellt die Plattform automatisch zusätzliche Instanzen bereit. Sinkt der Traffic, werden die Ressourcen wieder reduziert – das spart Kosten und hält die Anwendung ohne manuelles Eingreifen performant.
Serverless-Plattformen berechnen nach tatsächlich genutzten Ressourcen, nicht nach vorab zugewiesenen. Anders als bei klassischen Modellen, in denen bereitgestellte Ressourcen ungenutzt bleiben können, zahlst du nur für die genutzte Rechenzeit. Die Kosten werden fein gemessen – pro Invocation oder Ausführungsdauer – sodass du exakt das bezahlst, was du verbrauchst.
Verarbeitet deine Anwendung in einem Monat z. B. 100 Bilder, zahlst du nicht für einen Server im 24/7-Betrieb, sondern nur für die Rechenzeit, die für diese 100 Bilder anfiel.
Ein weiteres Kernmerkmal: Entwickler:innen und Unternehmen müssen sich nicht um Bereitstellung, Skalierung und Wartung kümmern. Sie konzentrieren sich auf die Geschäftslogik – die Cloud-Anbieter übernehmen den Rest.
Serverless-Plattformen können mehrere Functions parallel ausführen. Das ist schneller und effizienter als herkömmliche Ansätze. Wenn Nutzer:innen Bilder hochladen möchten und der Anbieter standardmäßig ein Concurrency Limit von 100 vorsieht, werden Anfragen darüber hinaus in die Warteschlange gestellt und in der nächsten Ausführung abgearbeitet.
Im Unterschied zum klassischen Cloud Computing mit dedizierten Servern und Kosten selbst bei Leerlauf berechnen serverlose Plattformen nach Ereignissen. Die passende Analogie ist ein Taxi statt eines eigenen Autos: Mit dem Taxi zahlst du nur die gefahrene Strecke – keine Parkgebühren, kein Kraftstoff, keine Wartung. Genauso zahlst du bei Serverless nur für die tatsächlich genutzten Rechenressourcen. Beim traditionellen Ansatz (eigenes Auto) trägst du alle Kosten – auch wenn das System untätig ist.
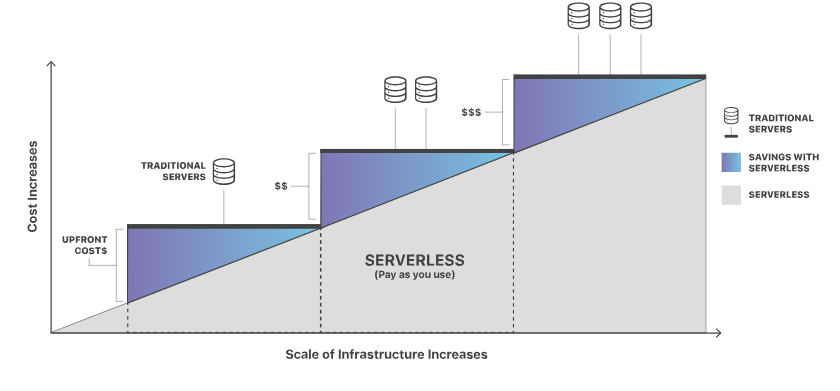
Kostenvergleich zwischen Server-Typen. Quelle: Cloudflare
Serverless spart viel Zeit: Entwickler:innen müssen keine Server installieren oder warten und können sich auf den Ausbau der Anwendung konzentrieren. Da Anwendungen aus unabhängigen Cloud Functions bestehen, lässt sich eine Function aktualisieren, ohne andere oder die gesamte Anwendung zu stören.
Das ist einer der wichtigsten Vorteile und ein Grund für die Beliebtheit bei kleineren Unternehmen und Startups. Serverless-Plattformen skalieren automatisch mit der Nachfrage. Schwankt das Anfragevolumen, passt die Plattform die Ressourcen rauf oder runter an – so werden Rechenressourcen optimal genutzt.
Mit serverlosen Anwendungen kannst du Releases zügig ausrollen und Feedback unmittelbar einholen. Gerade für Startups ist das wertvoll – weniger Zeit- und Personalaufwand bis zum Go-live.
Im Gegensatz zu Anwendungen auf dedizierten Servern lassen sich serverlose Anwendungen praktisch von überall betreiben. Das verbessert die Performance und senkt die Latenz gegenüber klassischen Cloud-Setups.
Eine Serverless-Architektur ermöglicht es, Anwendungen zu bauen, ohne die zugrunde liegende Infrastruktur zu installieren und zu verwalten. Entwickler:innen können serverlose Anwendungen über zwei Modelle aufbauen: Backend as a Service (BaaS) oder Function as a Service (FaaS).
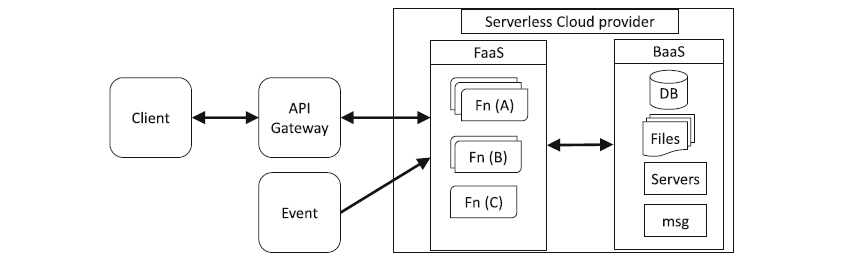
FaaS- und BaaS-Architekturen. Quelle: Journal of Cloud Computing
Das Ziel der Serverless-Architektur ist, das Servermanagement von Entwickler:innen fernzuhalten. So arbeiten serverlose Plattformen im Kern:
Man könnte fragen: Ist Serverless nicht dasselbe wie Container-Architektur, da beide den Server abstrahieren? Teilweise ja. Aber während Serverless Functions das Serverhandling vollständig übernehmen, müssen bei Containern bei hohem Traffic die Container aktiv skaliert werden, etwa mit Kubernetes. Das widerspricht der FaaS-Idee, bei der die Plattform alles automatisch regelt.
In Container-Architekturen können Instanzen lange laufen und Kosten verursachen. Bei Serverless zahlst du nur für die Laufzeit deiner Functions. Für kleinere Anwendungen eignet sich Serverless besonders, weil sich die App leicht in unabhängige Functions aufteilen lässt.
Vor Google App Engine (2008) bot Zimki als erster Anbieter eine „Pay as you go“-Plattform für Codeausführung an, wurde jedoch eingestellt. In der Anfangszeit unterstützte Google App Engine nur Python und rechnete Anwendungen nutzungsbasiert ab – darunter auch SnapChat. Um 2010 bot PiCloud FaaS-Unterstützung für Python-Anwendungen.
2014 popularisierte AWS das Serverless-Modell und veröffentlichte u. a. das AWS Serverless Application Model (AWS SAM) und Amazon CloudWatch. 2016 folgte Google mit Google Cloud Functions und Microsoft mit Azure Functions. Seither kamen weitere Plattformen hinzu, z. B. Function Compute von Alibaba Cloud und IBM Cloud Functions von IBM Cloud.
Um die Abhängigkeit von physischen oder virtualisierten Datenbanken zu reduzieren, entstanden auch serverlose Datenbanken. AWS bietet mit Amazon Aurora eine serverlose Variante auf Basis von MySQL und PostgreSQL. Azure stellt Azure Data Lake bereit, Google bietet Firestore.
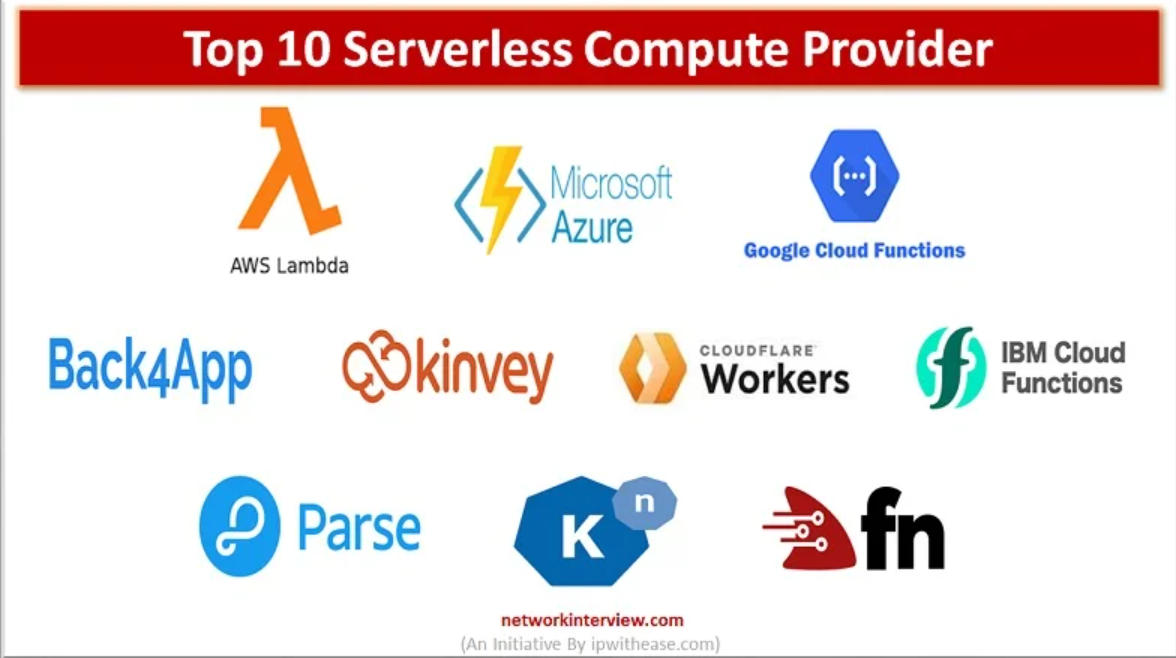
Serverless-Cloud-Plattformen. Quelle: Network Interview
Serverless wird für Webanwendungen und REST-APIs eingesetzt. Der Clou: Die Infrastruktur skaliert automatisch mit der Nachfrage – das verbessert das Nutzungserlebnis.
Mit einer serverlosen Architektur lässt sich Medienverarbeitung elegant lösen. Nutzer:innen laden Inhalte von unterschiedlichen Geräten und in verschiedenen Größen hoch, und die Plattform verarbeitet sie in einer Function, ohne die Performance zu beeinträchtigen. Beispiel: Ein Bild-Upload in einen S3-Bucket triggert eine AWS-Lambda-Function, die ein Wasserzeichen oder Thumbnail hinzufügt.
Chatbots lassen sich serverlos implementieren und verursachen nur Kosten für tatsächlich genutzte Ressourcen. Slack nutzt Serverless, um schwankende Bot-Anfragen effizient zu verarbeiten und Unterauslastung zu vermeiden.
Über einen Webhook-HTTP-Endpunkt kannst du mit SaaS-Anbietern interagieren, Benachrichtigungen empfangen und Aufgaben ausführen – mit minimaler Wartung, niedrigen Kosten und automatischer Skalierung.
Coca-Cola setzt bei seinen Automaten Freestyle auf Serverless, damit Kund:innen bestellen, bezahlen und Zahlungsbenachrichtigungen erhalten können. Laut Coca-Cola sanken die Betriebskosten pro Automat von rund 13.000 US‑Dollar/Jahr auf 4.500 US‑Dollar/Jahr.
Major League Baseball Advanced Media hat Statcast mit einer serverlosen Architektur gebaut, um Nutzer:innen präzise, nahezu in Echtzeit verfügbare Sportmetriken zu liefern. Serverless verarbeitet die Daten und liefert Insights zu Baseballspielen.
Serverless eignet sich für eventgetriebene Anwendungen: Ändert sich ein Zustand oder tritt ein Ereignis ein, wird ein Dienst ausgelöst. So können etwa Datenbankänderungen überwacht und automatisiert gegen Qualitätsstandards geprüft werden.
Weite Datenwege zu zentralen Servern verursachen Latenzen und Engpässe – Anfragen dauern länger, Inhalte werden verzögert ausgeliefert.
Serverless Edge Computing verteilt Rechenressourcen auf viele Standorte und entlastet so den zentralen Server. Gemeint ist, serverlose Functions näher bei den Endnutzer:innen (am „Edge“) auszuführen. Das erweitert die Geräteabdeckung, reduziert Überlastungen und senkt die Latenz.
Beim Serverless Edge werden Ressourcen gerätenah bereitgestellt, sodass komplexe Aufgaben lokal ausgeführt werden können, ohne Daten zur Verarbeitung an die Zentrale zu schicken. Typische Einsatzszenarien zur Optimierung des Nutzungserlebnisses:
Trotz aller Vorteile gibt es auch Schattenseiten.
Für Unternehmen, die schlanke Anwendungen bauen wollen, ist Serverless Computing ein sinnvoller Weg. Bei Anwendungen mit vielen Services und komplexen Abhängigkeiten empfiehlt sich eine hybride Infrastruktur: Große Prozesse laufen auf virtuellen Maschinen, serverlose Functions übernehmen kurze Aufgaben. Auch Edge Functions sind eine Option, um Latenzen zu minimieren, da Daten lokal verarbeitet werden und der zentrale Server entlastet wird.
Behalte im Blick, dass sich Serverless ständig weiterentwickelt. So lassen sich Anwendungen auch im Multi-Cloud-Ansatz aufbauen, also mit Services mehrerer Anbieter. Zudem arbeiten Anbieter an Lösungen gegen Cold Starts – etwa bei den Cloudflare Workers.
Danke fürs Lesen. Wenn du tiefer einsteigen und deine Kompetenzen ausbauen willst, schau dir diese DataCamp-Ressourcen an:
Für eine kurze Lektüre empfehlen wir unseren Blogpost mit Projektideen für jedes Kompetenzniveau.
Lernen mit DataCamp
Kurs
Kurs
Kurs