
ETL क्या है?
ETL डेटा को एकीकृत करने और डेटा स्टैक को संगठित करने का एक सामान्य तरीका है। एक सामान्य ETL प्रक्रिया में निम्नलिखित चरण शामिल होते हैं:
- स्रोतों से डेटा का निष्कर्षण
- डेटा को डेटा मॉडलों में परिवर्तित करना
- डेटा को डेटा वेयरहाउस में लोड करना
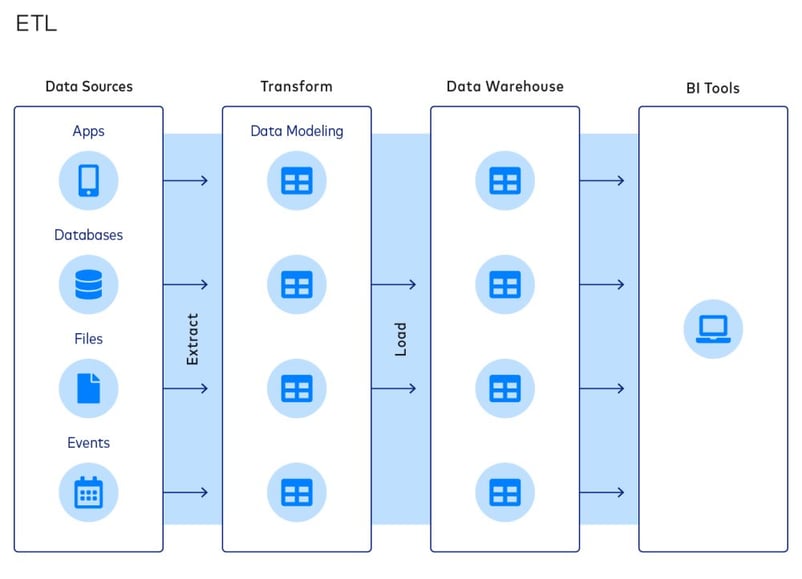
ETL प्रतिमान लोकप्रिय है क्योंकि यह कंपनियों को अपने डेटा वेयरहाउस का आकार कम करने की अनुमति देता है, जिससे कंप्यूटेशन, स्टोरेज और बैंडविड्थ लागत में बचत हो सकती है।
हालांकि, जैसे-जैसे ये बाधाएं कम होती जा रही हैं, ये लागत बचत कम महत्वपूर्ण होती जा रही हैं। परिणामस्वरूप, ELT (Extract, Load, Transform) अधिक लोकप्रिय हो रहा है। ELT प्रक्रिया में, डेटा को निष्कर्षण के बाद गंतव्य पर लोड किया जाता है, और ट्रांसफॉर्मेशन प्रक्रिया का अंतिम चरण होता है। इसके बावजूद, कई कंपनियां अभी भी ETL पर निर्भर हैं।
ETL टूल्स क्या हैं?
जैसा कि नाम से स्पष्ट है, ETL टूल्स सॉफ्टवेयर टूल्स का एक समूह है जो एक या अधिक स्रोतों से डेटा को निष्कर्षित, परिवर्तित और लोड करके किसी लक्ष्य प्रणाली या डेटाबेस में लाते हैं। ETL टूल्स का उद्देश्य विभिन्न स्रोतों से डेटा निकालने, उसे एकसमान और स्वच्छ प्रारूप में बदलने, और उसे समय पर व कुशलता से लक्ष्य प्रणाली में लोड करने की प्रक्रिया को स्वचालित और सरल बनाना है। अगले खंड में, हम देखेंगे कि किसी ETL टूल पर विचार करते समय डेटा टीमों को किन प्रमुख बातों पर ध्यान देना चाहिए।
ETL टूल चुनते समय विचारणीय बातें
ETL टूल चुनते समय ध्यान में रखने के लिए यहां तीन प्रमुख बातें हैं:
- डेटा इंटीग्रेशन की व्यापकता। ETL टूल्स विभिन्न डेटा स्रोतों और डेस्टिनेशंस से कनेक्ट हो सकते हैं। डेटा टीमों को उन ETL टूल्स का चयन करना चाहिए जो व्यापक इंटीग्रेशंस प्रदान करते हों। उदाहरण के लिए, जो टीमें Google Sheets से Amazon Redshift तक डेटा ले जाना चाहती हैं, उन्हें ऐसे कनेक्टर्स सपोर्ट करने वाले ETL टूल्स चुनने चाहिए।
- कस्टमाइज़ेबिलिटी का स्तर। कंपनियों को अपनी कस्टमाइज़ेशन आवश्यकताओं और IT टीम की तकनीकी विशेषज्ञता के आधार पर ETL टूल चुनना चाहिए। एक स्टार्टअप को अधिकांश ETL टूल्स में मौजूद बिल्ट-इन कनेक्टर्स और ट्रांसफॉर्मेशंस पर्याप्त लग सकते हैं; जबकि विशेष डेटा संग्रह वाली बड़ी एंटरप्राइज को सशक्त इंजीनियरिंग टीम की मदद से कस्टम ट्रांसफॉर्मेशन बनाने की लचीलापन चाहिए होगा।
- लागत संरचना। ETL टूल चुनते समय, संगठनों को केवल टूल की लागत ही नहीं बल्कि दीर्घकाल में समाधान को बनाए रखने के लिए आवश्यक अवसंरचना और मानव संसाधनों की लागत पर भी विचार करना चाहिए। कुछ मामलों में, अधिक अग्रिम लागत वाला ETL टूल लेकिन कम डाउनटाइम और रखरखाव आवश्यकताओं के साथ दीर्घकाल में अधिक किफायती साबित हो सकता है। इसके विपरीत, कुछ निःशुल्क, ओपन-सोर्स ETL टूल्स का रखरखाव खर्च अधिक हो सकता है।
अन्य विचारणीय बातें शामिल हैं:
- प्रदान की गई स्वचालन का स्तर
- सुरक्षा और अनुपालन का स्तर
- टूल का प्रदर्शन और विश्वसनीयता
ETL टूल्स के प्रकार
विशिष्ट टूल्स में जाने से पहले, मुख्य श्रेणियों को समझना उपयोगी है। ETL टूल्स कई प्रकारों में आते हैं, जिनमें से प्रत्येक अलग उपयोग मामलों और टीम संरचनाओं के लिए उपयुक्त है:
| प्रकार | विवरण | उदाहरण |
|---|---|---|
| ओपन-सोर्स ETL | उपयोग के लिए निःशुल्क, अत्यधिक कस्टमाइज़ेबल, समुदाय द्वारा समर्थित। परिनियोजन और रखरखाव के लिए अधिक इंजीनियरिंग प्रयास की आवश्यकता होती है। | Apache Airflow, Airbyte, Hadoop, Pentaho PDI |
| क्लाउड-आधारित / SaaS ETL | पूरी तरह मैनेज्ड, किसी अवसंरचना को चलाने की आवश्यकता नहीं। उपयोग-आधारित या सब्सक्रिप्शन मूल्य निर्धारण। कम परिचालन ओवरहेड। | Fivetran, Stitch, Hevo, Matillion |
| एंटरप्राइज ETL | फीचर-समृद्ध, बड़े पैमाने और जटिल परिवेशों के लिए निर्मित। मजबूत गवर्नेंस, मेटाडेटा मैनेजमेंट, और अनुपालन क्षमताएं। | Informatica PowerCenter, IBM Infosphere Datastage, SAP Data Services |
| क्लाउड-नेटिव ETL (ELT) | क्लाउड डेटा वेयरहाउस के लिए डिज़ाइन किया गया। ट्रांसफॉर्मेशन लॉजिक को पाइपलाइन के बीच में करने के बजाय वेयरहाउस इंजन में पुश करता है। | AWS Glue, Azure Data Factory, Google Cloud Dataflow, Databricks DLT |
| नो-कोड / लो-कोड ETL | ड्रैग-एंड-ड्रॉप इंटरफेस जो गैर-इंजीनियरों को पाइपलाइन्स बनाने देते हैं। सेटअप में तेज, लेकिन जटिल ट्रांसफॉर्मेशन के लिए कम लचीला। | Integrate.io, Astera Centerprise, Portable.io, Hevo |
| रीयल-टाइम / स्ट्रीमिंग ETL | डेटा को शेड्यूल्ड बैचों के बजाय आगमन के साथ ही प्रोसेस करता है। समय-संवेदनशील एनालिटिक्स के लिए आवश्यक। | Estuary, Hevo, AWS Glue (स्ट्रीमिंग मोड) |
शीर्ष 24 ETL टूल्स
इन बातों को ध्यान में रखते हुए, हम 2026 में बाजार में उपलब्ध शीर्ष 24 ETL टूल्स प्रस्तुत करते हैं। ध्यान दें कि टूल्स को गुणवत्ता के आधार पर क्रमबद्ध नहीं किया गया है, क्योंकि अलग-अलग टूल्स की अलग-अलग खूबियां और कमियां होती हैं।
1. Apache Airflow
Apache Airflow एक ओपन-सोर्स प्लेटफॉर्म है जो वर्कफ्लोज़ को प्रोग्रामेटिक रूप से लिखने, शेड्यूल करने और मॉनिटर करने की सुविधा देता है। इस प्लेटफॉर्म में वर्कफ्लोज़ को प्रबंधित और ट्रिगर करने के लिए वेब-आधारित यूजर इंटरफेस और कमांड-लाइन इंटरफेस उपलब्ध हैं।
वर्कफ्लोज़ को डायरेक्टेड एसाइक्लिक ग्राफ़ (DAGs) का उपयोग करते हुए परिभाषित किया जाता है, जो कार्यों और निर्भरताओं के स्पष्ट विज़ुअलाइज़ेशन और प्रबंधन की अनुमति देते हैं। Airflow अन्य टूल्स के साथ भी इंटीग्रेट होता है जो सामान्यतः डेटा इंजीनियरिंग और डेटा साइंस में उपयोग होते हैं, जैसे Apache Spark और Pandas।
Airflow का उपयोग करने वाली कंपनियां इसके स्केल करने और जटिल वर्कफ्लोज़ को संभालने की क्षमता, सक्रिय ओपन-सोर्स समुदाय और विस्तृत डॉक्यूमेंटेशन से लाभ उठा सकती हैं। अधिक जानने के लिए हमारा Airflow के साथ ETL पाइपलाइन बनाना ट्यूटोरियल या Python में Apache Airflow का परिचय कोर्स देखें।
2. Databricks Delta Live Tables
Databricks Delta Live Tables (DLT) Apache Spark के ऊपर निर्मित एक ETL फ्रेमवर्क है जो डेटा पाइपलाइन्स को स्वचालित करता है (उन्हें बनाना और प्रबंधित करना)। यह डेटा टीमों को न्यूनतम प्रयास के साथ विश्वसनीय, अनुरक्षित और घोषणात्मक पाइपलाइन्स बनाने देता है।
Delta Live Tables घोषणात्मक दृष्टिकोण से ETL को सरल बनाता है: उपयोगकर्ता क्या (ट्रांसफॉर्मेशन और निर्भरताएं) परिभाषित करते हैं, और सिस्टम कैसे (एग्जिक्यूशन, ऑप्टिमाइज़ेशन, और रिकवरी) को संभालता है।
DLT की एक बड़ी ताकत इसकी डेटा गुणवत्ता और विश्वसनीयता सुनिश्चित करने की क्षमता है। बिल्ट-इन अपेक्षाएं उपयोगकर्ताओं को डेटा क्वालिटी नियम परिभाषित करने देती हैं जो रिकॉर्ड्स को वास्तविक समय में वैलिडेट करते हैं। असफल रिकॉर्ड्स को बाद में समीक्षा के लिए क्वारंटीन किया जा सकता है।
3. Portable.io
Portable.io अपने आप को "डेटा टीमों के लिए ऑन-डिमांड कनेक्टर्स बनाने वाला पहला ELT प्लेटफॉर्म" बताता है। अपने इस मिशन के अनुरूप, Portable की टीम कस्टम नो-कोड इंटीग्रेशंस बनाती है, SaaS प्रदाताओं और अन्य कई डेटा स्रोतों से डेटा इनजेस्ट करती है जिन्हें अन्य ETL प्रदाता अक्सर नज़रअंदाज़ कर देते हैं। संभावित ग्राहक स्वयं उनके 1,300 से अधिक दुर्लभ ETL कनेक्टर्स वाले विस्तृत कनेक्टर कैटलॉग को देख सकते हैं।
Portable का विश्वास है कि कंपनियों को बिना कोड के हर बिज़नेस एप्लिकेशन से डेटा अपनी उंगलियों पर मिलना चाहिए। Portable की टीम ने ऐसा प्रोडक्ट बनाया है जो कुशल और समय पर डेटा प्रबंधन सक्षम करता है, मजबूत स्केलेबिलिटी और उच्च प्रदर्शन प्रदान करता है। इसके अलावा, इसमें सभी आकार के व्यवसायों के लिए किफायती मूल्य निर्धारण और उन्नत सुरक्षा सुविधाएं हैं जो सामान्य मानकों के अनुरूप डेटा सुरक्षा और अनुपालन सुनिश्चित करती हैं।
4. IBM Infosphere Datastage
Infosphere Datastage IBM द्वारा उसके Infosphere Information Server इकोसिस्टम के हिस्से के रूप में पेश किया गया एक ETL टूल है। अपने ग्राफिकल फ्रेमवर्क के साथ, उपयोगकर्ता ऐसी डेटा पाइपलाइन्स डिज़ाइन कर सकते हैं जो कई स्रोतों से डेटा निकालती हैं, जटिल ट्रांसफॉर्मेशन करती हैं, और डेटा को लक्ष्य अनुप्रयोगों तक पहुंचाती हैं।
IBM Infosphere अपनी गति के लिए जाना जाता है, विशेष रूप से लोड बैलेंसिंग और पैरेललाइज़ेशन जैसी विशेषताओं के कारण। यह मेटाडेटा, स्वचालित फेल्योर डिटेक्शन, और डेटा वेयरहाउसिंग से लेकर AI एप्लिकेशंस तक की एक विस्तृत श्रृंखला के डेटा सेवाओं का समर्थन भी करता है।
अन्य एंटरप्राइज ETL टूल्स की तरह, Infosphere Datastage विभिन्न डेटा स्रोतों के इंटीग्रेशन के लिए कई कनेक्टर्स प्रदान करता है। यह IBM Infosphere Information Server के अन्य घटकों के साथ सहजता से इंटीग्रेट होता है, जिससे उपयोगकर्ता ETL जॉब्स को विकसित, परीक्षण, परिनियोजित और मॉनिटर कर सकते हैं।
5. Oracle Data Integrator
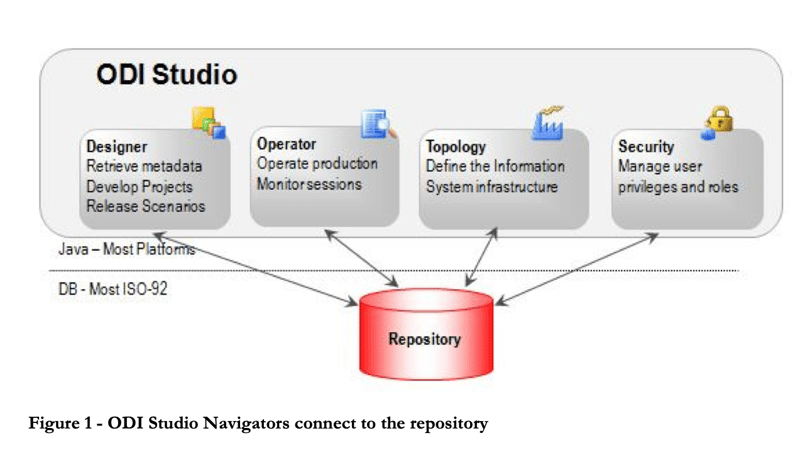
Oracle Data Integrator एक ETL टूल है जो उपयोगकर्ताओं को जटिल डेटा वेयरहाउस बनाने, परिनियोजित करने और प्रबंधित करने में मदद करता है। इसमें कई डेटाबेस के लिए आउट-ऑफ-द-बॉक्स कनेक्टर्स आते हैं, जिनमें Hadoop, EREPs, CRM, XML, JSON, LDAP, JDBC, और ODBC शामिल हैं।
ODI में Data Integrator Studio शामिल है, जो बिज़नेस उपयोगकर्ताओं और डेवलपर्स को ग्राफिकल यूजर इंटरफेस के माध्यम से कई आर्टिफैक्ट्स तक पहुंच प्रदान करता है। ये आर्टिफैक्ट्स डेटा मूवमेंट से लेकर सिंक्रोनाइज़ेशन, क्वालिटी और मैनेजमेंट तक, डेटा इंटीग्रेशन के सभी तत्व प्रदान करते हैं।
6. Microsoft SQL Server Integration Services (SSIS)
SSIS डेटा इंटीग्रेशन और ट्रांसफॉर्मेशन के लिए एंटरप्राइज-स्तरीय प्लेटफॉर्म है। यह XML फाइल्स, फ्लैट फाइल्स, और रिलेशनल डेटाबेस जैसे स्रोतों से डेटा निकालने के लिए कनेक्टर्स के साथ आता है। प्रैक्टिशनर SSIS डिज़ाइनर के ग्राफिकल यूजर इंटरफेस का उपयोग करके डेटा फ्लोज़ और ट्रांसफॉर्मेशन बना सकते हैं।
प्लेटफॉर्म में बिल्ट-इन ट्रांसफॉर्मेशंस की एक लाइब्रेरी शामिल है जो विकास के लिए आवश्यक कोड की मात्रा को कम करती है। SSIS कस्टम वर्कफ्लोज़ बनाने के लिए व्यापक डॉक्यूमेंटेशन भी प्रदान करता है। हालांकि, प्लेटफॉर्म की तीव्र लर्निंग कर्व और जटिलता शुरुआती लोगों को जल्दी से ETL पाइपलाइन्स बनाने से हतोत्साहित कर सकती है।
7. dbt (data build tool)
dbt (data build tool) आधुनिक ELT पाइपलाइन्स में ट्रांसफॉर्मेशन लेयर के लिए उद्योग मानक बन गया है। निष्कर्षण के दौरान बीच में डेटा को ट्रांसफॉर्म करने के बजाय, dbt डेटा वेयरहाउस के अंदर SQL का उपयोग करते हुए डेटा को ट्रांसफॉर्म करता है — यह दृष्टिकोण अब “ELT में T” के रूप में जाना जाता है।
dbt डेटा इंजीनियरों और एनालिटिक्स इंजीनियरों को मॉड्यूलर, वर्शन-कंट्रोल्ड, और टेस्टेड SQL मॉडल लिखने देता है। हर मॉडल डॉक्यूमेंटेड होता है, निर्भरताएं ट्रैक की जाती हैं, और हर रन एक डेटा लिनिएज ग्राफ़ बनाता है जो दिखाता है कि कच्चे स्रोतों से अंतिम टेबल्स तक डेटा ठीक कैसे बहता है। अधिक जानें हमारे dbt परिचय, डेटा इंजीनियरों के लिए dbt कॉन्सेप्ट्स गाइड, और हमारे dbt Cloud गाइड में।
dbt ओपन-सोर्स (dbt Core, निःशुल्क) के रूप में या पूरी तरह मैनेज्ड क्लाउड सेवा (dbt Cloud) के रूप में उपलब्ध है। यह हर प्रमुख क्लाउड डेटा वेयरहाउस — Snowflake, BigQuery, Redshift, और Databricks — के साथ इंटीग्रेट होता है और Fivetran तथा Airbyte जैसे इनजेशन टूल्स के साथ स्वाभाविक रूप से पेयर होकर एक पूर्ण आधुनिक ELT स्टैक बनाता है।
8. Pentaho Data Integration (PDI)
Pentaho Data Integration (PDI) Hitachi द्वारा पेश किया गया एक ETL टूल है। यह विभिन्न स्रोतों से डेटा कैप्चर करता है, उसे साफ करता है, और एक समान और सुसंगत प्रारूप में संग्रहीत करता है।
पहले Kettle के नाम से जाना जाने वाला PDI, डेटा पाइपलाइन्स को परिभाषित करने के लिए कई ग्राफिकल यूजर इंटरफेस प्रदान करता है। उपयोगकर्ता PDI क्लाइंट Spoon का उपयोग करके डेटा जॉब्स और ट्रांसफॉर्मेशंस डिज़ाइन कर सकते हैं और फिर उन्हें Kitchen का उपयोग करके चला सकते हैं। उदाहरण के लिए, PDI क्लाइंट का उपयोग Pentaho Reporting के साथ रीयल-टाइम ETL के लिए किया जा सकता है।
9. Hadoop
Hadoop बड़े डेटा को कंप्यूटर सर्वर्स के क्लस्टर्स में प्रोसेस और स्टोर करने के लिए एक ओपन-सोर्स फ्रेमवर्क है। इसे बिग डेटा की नींव माना जाता है और यह बड़े पैमाने पर डेटा के स्टोरेज और प्रोसेसिंग को सक्षम बनाता है।
Hadoop फ्रेमवर्क कई मॉड्यूल्स से बना है, जिनमें डेटा स्टोर करने के लिए Hadoop Distributed File System (HDFS), डेटा को पढ़ने और ट्रांसफॉर्म करने के लिए MapReduce, और संसाधन प्रबंधन के लिए YARN शामिल हैं। Hive का उपयोग आमतौर पर SQL क्वेरीज़ को MapReduce ऑपरेशंस में बदलने के लिए किया जाता है।
Hadoop पर विचार कर रही कंपनियों को इसकी लागतों के प्रति सचेत रहना चाहिए। Hadoop को लागू करने की लागत का एक महत्वपूर्ण हिस्सा प्रोसेसिंग के लिए आवश्यक कंप्यूटिंग पावर और Hadoop ETL को बनाए रखने के लिए आवश्यक विशेषज्ञता से आता है, न कि स्वयं टूल्स या स्टोरेज से।
10. AWS Glue
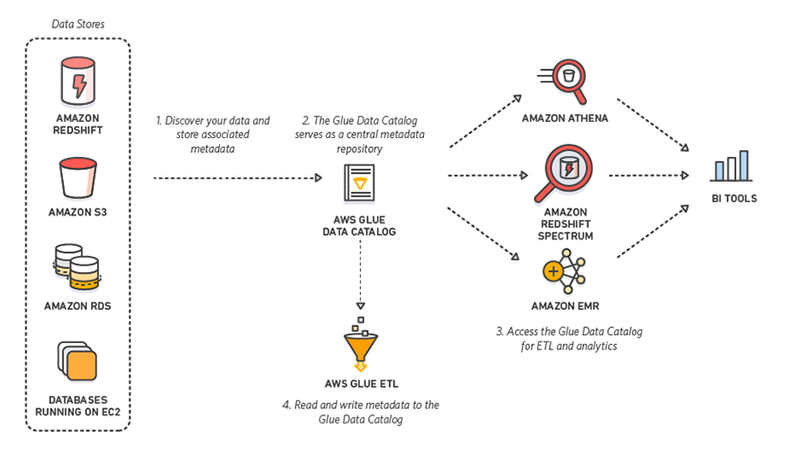
AWS Glue Amazon द्वारा पेश किया गया एक सर्वरलेस ETL टूल है। यह कई स्रोतों से डेटा को डिस्कवर, तैयार, इंटीग्रेट और ट्रांसफॉर्म करता है ताकि एनालिटिक्स उपयोग मामलों के लिए उपयुक्त हो। अवसंरचना को सेट अप या प्रबंधित करने की आवश्यकता न होने के कारण, AWS Glue डेटा इंटीग्रेशन की भारी लागत को कम करने का वादा करता है।
और भी बेहतर, AWS Glue के साथ इंटरैक्ट करते समय, प्रैक्टिशनर ड्रैग-एंड-ड्रॉप GUI, Jupyter नोटबुक, या Python/Scala कोड में से चुन सकते हैं। AWS Glue विभिन्न डेटा प्रोसेसिंग और वर्कलोड्स का भी समर्थन करता है जो अलग-अलग व्यावसायिक आवश्यक्ताओं को पूरा करते हैं, जिनमें ETL, ELT, बैच, और स्ट्रीमिंग शामिल हैं।
11. AWS Data Pipeline
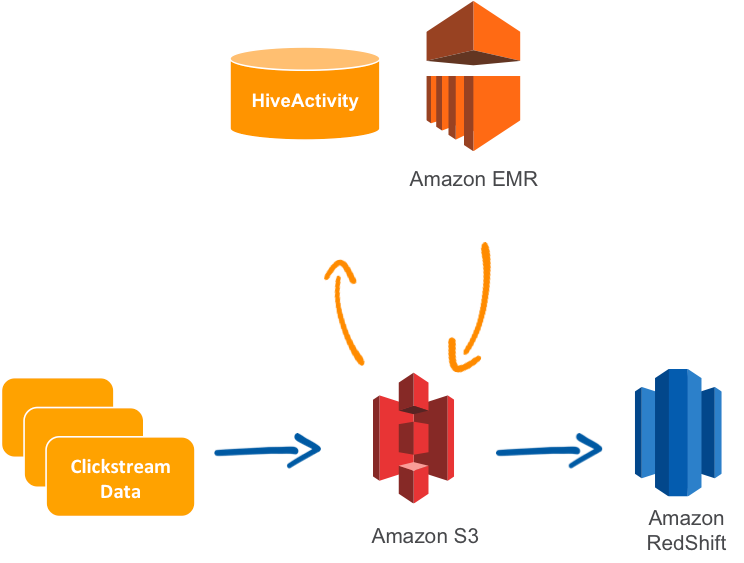
AWS का Data Pipeline एक मैनेज्ड ETL सेवा है जो AWS सेवाओं या ऑन-प्रिमाइसेस संसाधनों के बीच डेटा के मूवमेंट को सक्षम करती है। उपयोगकर्ता मूव किए जाने वाले डेटा, ट्रांसफॉर्मेशन जॉब्स या क्वेरीज़, और ट्रांसफॉर्मेशंस करने के शेड्यूल को निर्दिष्ट कर सकते हैं।
Data Pipeline अपनी विश्वसनीयता, लचीलेपन और स्केलेबिलिटी के लिए जाना जाता है, साथ ही इसकी फॉल्ट-टॉलरेंस और कॉन्फिगरेबिलिटी के लिए भी। प्लेटफॉर्म उपयोग में आसानी के लिए ड्रैग-एंड-ड्रॉप कंसोल भी प्रदान करता है। इसके अलावा, यह अपेक्षाकृत सस्ता है।
AWS Data Pipeline के लिए एक सामान्य उपयोग मामला Relational Database Service (RDS) से डेटा की प्रतिकृति बनाना और उसे Amazon Redshift पर लोड करना है।
हालांकि, यह ध्यान रखना महत्वपूर्ण है कि AWS धीरे-धीरे AWS Data Pipeline से ध्यान हटाकर अधिक आधुनिक समाधानों जैसे AWS Glue पर केंद्रित हो रहा है। AWS Glue बैच और स्ट्रीमिंग दोनों वर्कलोड्स के लिए सपोर्ट के साथ सर्वरलेस, स्वचालित डेटा इंटीग्रेशन प्रदान करता है। इसके अतिरिक्त, AWS ज़ीरो-ETL अवधारणा (और Reverse ETL) का अन्वेषण कर रहा है, जहां Amazon Aurora और Amazon Redshift जैसी सेवाएं पारंपरिक ETL पाइपलाइन्स की आवश्यकता के बिना इंटीग्रेट हो सकती हैं। जैसे-जैसे ये प्रगति जारी रहेगी, AWS Data Pipeline के चरणबद्ध तरीके से समाप्त होने और उपयोगकर्ताओं को AWS इकोसिस्टम के अंदर अधिक नवोन्मेषी और कुशल समाधानों को अपनाने के लिए प्रोत्साहित किए जाने की उम्मीद है।
12. Azure Data Factory
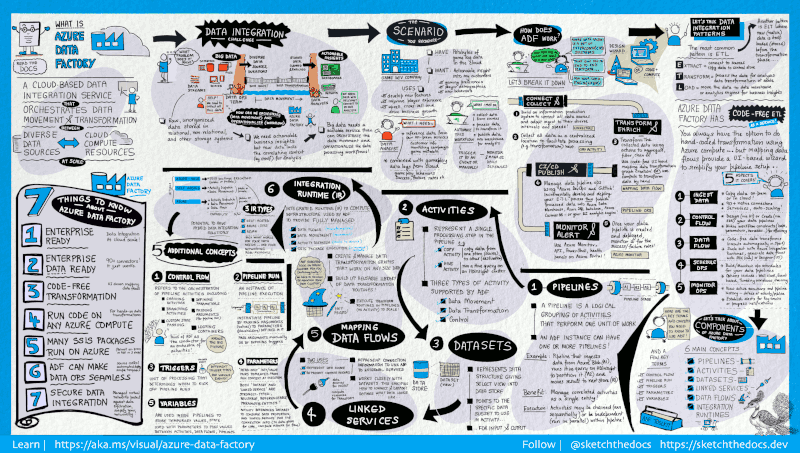
Azure Data Factory Microsoft द्वारा पेश की गई क्लाउड-आधारित ETL सेवा है, जिसका उपयोग बड़े पैमाने पर डेटा को स्थानांतरित और ट्रांसफॉर्म करने वाले वर्कफ्लोज़ बनाने के लिए किया जाता है।
यह आपस में जुड़े कई सिस्टमों से मिलकर बना है। साथ मिलकर, ये सिस्टम इंजीनियरों को न केवल डेटा को इनजेस्ट और ट्रांसफॉर्म करने देते हैं, बल्कि डेटा पाइपलाइन्स को डिजाइन, शेड्यूल और मॉनिटर करने की सुविधा भी देते हैं।
Data Factory की ताकत उसके उपलब्ध कनेक्टर्स की संख्या में निहित है, MySQL से लेकर AWS, MongoDB, Salesforce, और SAP तक। इसे इसकी लचीलेपन के लिए भी सराहा जाता है; उपयोगकर्ता नो-कोड ग्राफिकल यूजर इंटरफेस या कमांड-लाइन इंटरफेस, दोनों में से किसी एक के साथ इंटरैक्ट करना चुन सकते हैं।
13. Google Cloud Dataflow
Dataflow Google Cloud द्वारा पेश किया गया सर्वरलेस ETL सेवा है। यह स्ट्रीम और बैच, दोनों प्रकार की डेटा प्रोसेसिंग की अनुमति देता है और कंपनियों को सर्वर या क्लस्टर का स्वामित्व रखने की आवश्यकता नहीं होती। इसके बजाय, उपयोगकर्ता केवल उपभोग किए गए संसाधनों के लिए भुगतान करते हैं, जो आवश्यकताओं और वर्कलोड के आधार पर स्वचालित रूप से स्केल होते हैं।
Google Dataflow, Google Cloud Platform इकोसिस्टम के भीतर Apache Beam पाइपलाइन्स को निष्पादित करता है। Apache बैच और स्ट्रीमिंग, दोनों प्रकार के डेटा सेट्स को प्रस्तुत और ट्रांसफर करने के लिए Java, Python, और Go SDKs प्रदान करता है। इससे उपयोगकर्ता अपनी डेटा पाइपलाइन्स को परिभाषित करने के लिए उपयुक्त SDK चुन सकते हैं।
14. Stitch
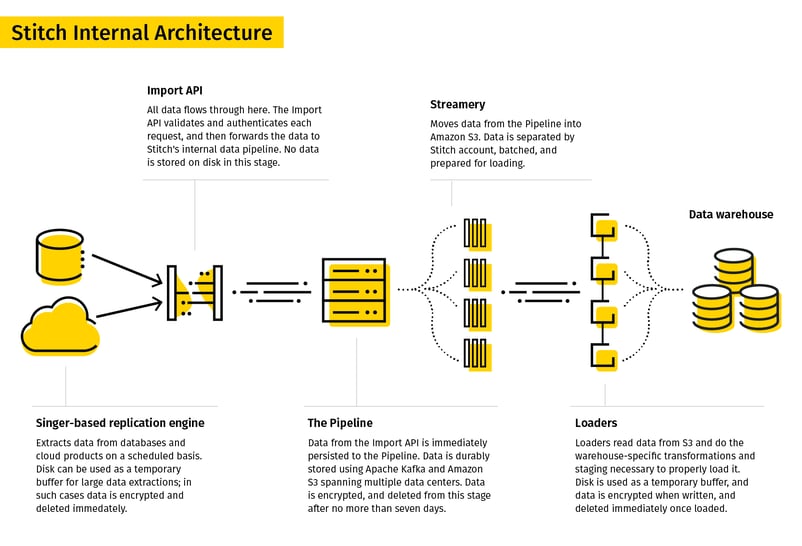
Stitch स्वयं को डेटा टीमों के लिए एक सरल, विस्तार योग्य ETL टूल के रूप में वर्णित करता है।
Stitch की प्रतिकृति प्रक्रिया विभिन्न डेटा स्रोतों से डेटा निकालती है, उसे एक उपयोगी रॉ प्रारूप में ट्रांसफॉर्म करती है, और उसे डेस्टिनेशन में लोड करती है। इसके डेटा कनेक्टर्स में डेटाबेस और SaaS एप्लिकेशंस शामिल हैं। डेस्टिनेशंस में डेटा लेक्स, डेटा वेयरहाउस और स्टोरेज प्लेटफॉर्म शामिल हो सकते हैं।
अपनी सरलता के चलते, Stitch केवल सरल ट्रांसफॉर्मेशंस को सपोर्ट करता है, उपयोगकर्ता-परिभाषित ट्रांसफॉर्मेशंस को नहीं।
15. SAP BusinessObjects Data Services
SAP BusinessObjects Data Services एक एंटरप्राइज ETL टूल है जो उपयोगकर्ताओं को कई प्रणालियों से डेटा निकालने, उसे ट्रांसफॉर्म करने, और डेटा वेयरहाउस में लोड करने की अनुमति देता है।
Data Services Designer डेटा पाइपलाइन्स को परिभाषित करने और डेटा ट्रांसफॉर्मेशंस को निर्दिष्ट करने के लिए ग्राफिकल यूजर इंटरफेस प्रदान करता है। नियम और मेटाडेटा एक रिपॉजिटरी में संग्रहीत किए जाते हैं, और एक जॉब सर्वर जॉब्स को बैच या रियल टाइम में चलाता है।
हालांकि, SAP Data Services महंगा हो सकता है, क्योंकि टूल, सर्वर, हार्डवेयर, और इंजीनियरिंग टीम की लागत जल्दी बढ़ सकती है।
SAP Data Services उन कंपनियों के लिए उपयुक्त है जो अपने एंटरप्राइज रिसोर्स प्लानिंग (ERP) सिस्टम के रूप में SAP का उपयोग करती हैं, क्योंकि यह SAP के साथ सहजता से इंटीग्रेट होता है।
16. Hevo
Hevo ETL और ELT के लिए एक डेटा इंटीग्रेशन प्लेटफॉर्म है, जो कई स्रोतों से डेटा निकालने के लिए 150 से अधिक कनेक्टर्स के साथ आता है। यह एक लो-कोड टूल है, जो उपयोगकर्ताओं के लिए व्यापक कोडिंग अनुभव के बिना डेटा पाइपलाइन्स डिज़ाइन करना आसान बनाता है।
Hevo कई विशेषताएं और फायदे प्रदान करता है, जिनमें रीयल-टाइम डेटा इंटीग्रेशन, स्वचालित स्कीमा डिटेक्शन, और बड़ी मात्रा में डेटा संभालने की क्षमता शामिल है। यह प्लेटफॉर्म उपयोगकर्ता-अनुकूल इंटरफेस और 24/7 ग्राहक सहायता के साथ आता है।
17. Qlik Compose
Qlik Compose एक डेटा वेयरहाउसिंग समाधान है जो स्वचालित रूप से डेटा वेयरहाउस डिजाइन करता है और ETL कोड जेनरेट करता है। यह टूल ETL विकास और रखरखाव के थकाऊ और त्रुटि-प्रवण हिस्सों को स्वचालित करता है। इससे डेटा वेयरहाउसिंग प्रोजेक्ट्स का लीड टाइम कम हो जाता है।
ऐसा करने के लिए, Qlik Compose ऑटो-जनरेटेड कोड चलाता है, जो स्रोतों से डेटा लोड करता है और उन्हें उनके डेटा वेयरहाउस तक ले जाता है। ऐसे वर्कफ्लोज़ को Workflow Designer और Scheduler का उपयोग करके डिज़ाइन और शेड्यूल किया जा सकता है।
Qlik Compose के साथ डेटा को वैलिडेट करने और डेटा गुणवत्ता सुनिश्चित करने की क्षमता भी आती है। जिन्हें रीयल-टाइम में डेटा चाहिए, वे Qlik Replicate के साथ Compose को इंटीग्रेट भी कर सकते हैं।
18. Integrate.io
Integrate.io, जिसे पहले Xplenty के नाम से जाना जाता था, हमारे शीर्ष ETL टूल्स की सूची में एक सही स्थान अर्जित करता है। इसका उपयोगकर्ता-मित्र, सहज इंटरफेस व्यापक डेटा प्रबंधन के द्वार खोलता है, यहां तक कि उन टीम सदस्यों के लिए भी जिनकी तकनीकी समझ कम है। एक क्लाउड-आधारित प्लेटफॉर्म के रूप में, Integrate.io किसी भारी हार्डवेयर या सॉफ्टवेयर इंस्टॉलेशन की आवश्यकता को समाप्त करता है और एक अत्यधिक स्केलेबल समाधान प्रदान करता है जो आपके व्यावसायिक आवश्यकताओं के साथ विकसित होता है।
डेटाबेस से लेकर CRM सिस्टम तक, विभिन्न डेटा स्रोतों से कनेक्ट होने की इसकी क्षमता इसे विविध डेटा इंटीग्रेशन आवश्यकताओं के लिए एक बहुमुखी विकल्प बनाती है। डेटा सुरक्षा को प्राथमिकता देते हुए, यह फील्ड-स्तरीय एन्क्रिप्शन जैसी सुविधाएं प्रदान करता है और GDPR तथा HIPAA जैसे प्रमुख मानकों के अनुरूप है। शक्तिशाली डेटा ट्रांसफॉर्मेशन क्षमताओं के साथ, उपयोगकर्ता ETL प्रक्रिया के हिस्से के रूप में अपने डेटा को आसानी से साफ, फॉर्मेट और समृद्ध कर सकते हैं।
19. Airbyte
Airbyte एक अग्रणी ओपन-सोर्स ELT प्लेटफॉर्म है। Airbyte 400 से अधिक डेटा कनेक्टर्स — और बढ़ते हुए — प्रदान करता है और 40,000 से अधिक डेटा इंजीनियर इसका उपयोग कर रहे हैं।
Airbyte अपने डेटा ट्रांसफॉर्मेशन के लिए dbt और ऑर्केस्ट्रेशन के लिए Airflow / Prefect / Dagster के साथ इंटीग्रेट होता है। इसमें एक उपयोग में आसान यूजर इंटरफेस है और एक API तथा Terraform Provider उपलब्ध है।
Airbyte खुद को अपने ओपन-सोर्स होने से अलग करता है; उनके नो-कोड कनेक्टर बिल्डर के साथ नया कनेक्टर बनाने में 20 मिनट लगते हैं, और यदि आपके पास उनके कोड तक पहुंच है तो आप किसी भी तैयार कनेक्टर को संपादित कर सकते हैं। अपनी ओपन-सोर्स संस्करण के अलावा, Airbyte दोनों, क्लाउड-होस्टेड (Airbyte Cloud) और भुगतान किए गए स्वयं-होस्टेड संस्करण (Airbyte Enterprise) प्रदान करता है, जब आप अपनी पाइपलाइन्स को प्रोडक्शन-ग्रेड बनाना चाहते हैं।
20. Astera Centerprise
Astera Centerprise एक एंटरप्राइज-ग्रेड, 100% कोड-फ्री ETL/ELT टूल है। Astera Data Stack का हिस्सा होने के नाते, Centerprise एक सहज और उपयोगकर्ता-मित्र इंटरफेस प्रदान करता है, जिसकी लर्निंग कर्व छोटी है और यह सभी तकनीकी स्तरों के उपयोगकर्ताओं को मिनटों में डेटा पाइपलाइन्स बनाने देता है।
यह स्वचालित डेटा इंटीग्रेशन टूल कई क्षमताएं प्रदान करता है, जैसे कई डेटा स्रोतों और डेस्टिनेशंस से आउट-ऑफ-द-बॉक्स कनेक्टिविटी, AI-संचालित डेटा एक्सट्रैक्शन, AI ऑटो मैपिंग, बिल्ट-इन एडवांस्ड ट्रांसफॉर्मेशंस, और डेटा क्वालिटी फीचर्स। उपयोगकर्ता आसानी से असंरचित और संरचित डेटा निकाल सकते हैं, उसे ट्रांसफॉर्म कर सकते हैं, और डेटा फ्लोज़ का उपयोग करके अपनी पसंद के डेस्टिनेशन में लोड कर सकते हैं। इन डेटा फ्लोज़ को बिल्ट-इन जॉब शेड्यूलर का उपयोग करके विशिष्ट अंतराल, शर्तों, या फाइल ड्रॉप्स पर चलने के लिए स्वचालित किया जा सकता है।
21. Informatica PowerCenter
Informatica PowerCenter बाजार में सर्वश्रेष्ठ ETL टूल्स में से एक है। इसमें क्लाउड डेटा वेयरहाउस और लेक्स के लिए कनेक्टर्स की एक विस्तृत श्रृंखला है, जिनमें AWS, Azure, Google Cloud और Salesforce शामिल हैं। इसके लो- और नो-कोड टूल्स समय बचाने और वर्कफ्लोज़ को सरल बनाने के लिए डिज़ाइन किए गए हैं।
Informatica PowerCenter में कई सेवाएं शामिल हैं जो उपयोगकर्ताओं को डेटा पाइपलाइन्स को डिज़ाइन, परिनियोजित और मॉनिटर करने की अनुमति देती हैं। उदाहरण के लिए, Repository Manager यूजर मैनेजमेंट में मदद करता है, Designer उपयोगकर्ताओं को स्रोत से लक्ष्य तक डेटा के प्रवाह को निर्दिष्ट करने देता है, और Workflow Manager कार्यों के क्रम को परिभाषित करता है।
22. Estuary
Estuary एक अत्याधुनिक रीयल-टाइम डेटा इंटीग्रेशन प्लेटफॉर्म है जो डेटा पाइपलाइन्स के निर्माण और प्रबंधन को सरल बनाता है। बैच और स्ट्रीमिंग, दोनों प्रकार के डेटा को संभालने के लिए डिज़ाइन किया गया, Estuary आपको मजबूत ETL वर्कफ्लोज़ बनाने देता है। इसका सहज यूजर इंटरफेस तकनीकी और गैर-तकनीकी दोनों उपयोगकर्ताओं के लिए सुलभ है, जिससे टीमें जटिल कॉन्फ़िगरेशन से जूझने के बजाय अपने डेटा से मूल्य निकालने पर ध्यान केंद्रित कर सकें।
प्लेटफॉर्म की स्वचालन क्षमताएं अलग दिखती हैं, जो स्कीमा इवॉल्यूशन को स्वचालित रूप से प्रबंधित करती हैं और बदलती डेटा संरचनाओं के अनुरूप आसानी से अनुकूलित होती हैं। विभिन्न डेटा स्रोतों और डेस्टिनेशंस के साथ इंटीग्रेशन के साथ, Estuary उन टीमों की जरूरतों को पूरा करता है जो रीयल-टाइम एनालिटिक्स चाहती हैं, चाहे वह ई-कॉमर्स में बिक्री रुझानों की निगरानी हो या IoT एप्लिकेशंस में सेंसर डेटा का विश्लेषण।
23. Fivetran
Fivetran पूरी तरह स्वचालित डेटा इंटीग्रेशन के लिए एक अग्रणी ETL समाधान के रूप में उभरा है, जो कंपनियों को अपना डेटा केंद्रीकृत करने में सक्षम बनाता है। प्री-बिल्ट कनेक्टर्स की लाइब्रेरी का लाभ उठाकर, Fivetran सेटअप समय को कम करता है, डेटाबेस, SaaS एप्लिकेशंस, और इवेंट स्ट्रीम्स को क्लाउड डेटा वेयरहाउस से जोड़ता है। प्लेटफॉर्म अपनी स्कीमा परिवर्तनों को स्वचालित रूप से संभालने की क्षमता में चमकता है, जिससे स्रोत सिस्टम विकसित होने पर भी डेटा का प्रवाह सुचारू बना रहता है।
रीयल-टाइम प्रतिकृति क्षमताओं के साथ, Fivetran लगभग-तत्काल डेटा उपलब्धता का समर्थन करता है। Snowflake, BigQuery, और Redshift जैसी क्लाउड-नेटिव परिवेशों के लिए अनुकूलित, Fivetran उन टीमों के लिए एक पसंदीदा विकल्प है जो स्केलेबिलिटी बनाए रखते हुए डेटा पाइपलाइन्स को सरल बनाना चाहती हैं। यह विशेष रूप से मार्केटिंग और सेल्स टीमों के लिए मूल्यवान है जिन्हें विविध डेटा स्रोतों को एकीकृत एनालिटिक्स डैशबोर्ड्स में इंटीग्रेट करने की आवश्यकता होती है।
24. Matillion
Matillion एक क्लाउड-नेटिव ETL टूल है जिसे क्लाउड डेटा वेयरहाउस के भीतर सीधे डेटा ट्रांसफॉर्म करने के लिए डिज़ाइन किया गया है। Snowflake, AWS Redshift, Google BigQuery और Azure Synapse जैसे प्लेटफॉर्म्स के लिए अनुकूलित, Matillion बड़े पैमाने पर डेटा ट्रांसफॉर्मेशन करने का तरीका प्रदान करता है। इसका विजुअल इंटरफेस उपयोगकर्ताओं को ड्रैग-एंड-ड्रॉप वातावरण के माध्यम से वर्कफ्लोज़ डिज़ाइन करना आसान बनाता है, जबकि उन्नत उपयोगकर्ता जटिल डेटा कार्यों को संभालने के लिए SQL-आधारित ट्रांसफॉर्मेशंस का लाभ उठा सकते हैं।
स्केलेबिलिटी और प्रदर्शन पर इसके फोकस के साथ, Matillion उन टीमों के लिए उपयुक्त है जिन्हें बड़े पैमाने के ट्रांसफॉर्मेशंस को कुशलता से प्रोसेस करने की आवश्यकता है। विस्तृत कस्टमर 360 व्यू बनाने से लेकर सप्लाई चेन एनालिटिक्स को ऑप्टिमाइज़ करने तक, Matillion डेटा प्रोफेशनल्स को पारंपरिक ETL प्रक्रियाओं की सामान्य बाधाओं के बिना अपनी क्लाउड-आधारित डेटा अवसंरचना की पूरी क्षमता को अनलॉक करने में सक्षम बनाता है।
शीर्ष ETL टूल्स की तुलना
निम्न तालिका विभिन्न श्रेणियों पर उल्लेखित ETL टूल्स की साथ-साथ तुलना करती है:
| ETL टूल | ओपन-सोर्स उपलब्धता | क्लाउड अनुकूलता | उपयोग में सरलता | इंटीग्रेशंस की संख्या | विशेषताएं और विचार | आदर्श उपयोग मामला |
|---|---|---|---|---|---|---|
| Apache Airflow | हाँ | हाँ | मध्यम | उच्च | DAG-आधारित वर्कफ़्लो, स्केलेबिलिटी, व्यापक समुदाय समर्थन | जटिल वर्कफ्लोज़ और बड़े पैमाने, बहु-चरणीय डेटा पाइपलाइन्स का ऑर्केस्ट्रेशन |
| Databricks Delta Live Tables | नहीं | हाँ | उच्च | उच्च | घोषणात्मक पाइपलाइन डिज़ाइन, स्वचालित निर्भरता प्रबंधन, बिल्ट-इन डेटा गुणवत्ता जांच | Databricks Lakehouse का उपयोग करने वाले एंटरप्राइज जो एकीकृत डेटा क्वालिटी और रीयल-टाइम प्रोसेसिंग के साथ स्वचालित, विश्वसनीय ETL चाहते हैं |
| Portable.io | नहीं | हाँ | उच्च | बहुत उच्च | ऑन-डिमांड कनेक्टर्स, नो-कोड, किफायती मूल्य | कम प्रचलित डेटा स्रोतों के लिए कस्टम कनेक्टर्स की आवश्यकता वाली छोटी से मध्यम कंपनियां |
| IBM Infosphere Datastage | नहीं | हाँ | मध्यम | उच्च | हाई-स्पीड प्रोसेसिंग, मेटाडेटा सपोर्ट, एंटरप्राइज-ग्रेड | विविध और उच्च-वॉल्यूम डेटा पाइपलाइन्स वाले एंटरप्राइज जिन्हें मजबूत मेटाडेटा प्रबंधन चाहिए |
| Oracle Data Integrator | नहीं | हाँ | मध्यम | उच्च | विस्तृत कनेक्टर्स, ग्राफिकल इंटरफेस, मजबूत प्रबंधन | Oracle इकोसिस्टम का उपयोग करने वाली कंपनियां या जिन्हें व्यापक डेटाबेस सपोर्ट चाहिए |
| Microsoft SSIS | नहीं | सीमित | मध्यम | मध्यम | बिल्ट-इन ट्रांसफॉर्मेशंस, व्यापक डॉक्यूमेंटेशन | वे संगठन जो पहले से Microsoft SQL Server में निवेशित हैं |
| dbt (data build tool) | हाँ | हाँ | उच्च | उच्च | SQL-आधारित इन-वेयरहाउस ट्रांसफॉर्मेशन, वर्शन-कंट्रोल्ड मॉडल्स, डेटा लिनिएज, dbt Core (निःशुल्क) + dbt Cloud (मैनेज्ड) | क्लाउड डेटा वेयरहाउस के अंदर टेस्टेबल, डॉक्यूमेंटेड ट्रांसफॉर्मेशन लेयर चाहने वाली टीमें (Fivetran या Airbyte के साथ पेयर) |
| Pentaho Data Integration | हाँ | हाँ | मध्यम | उच्च | रीयल-टाइम ETL, ग्राफिकल इंटरफेस, Spoon/Kitchen क्लाइंट्स | लचीले, GUI-आधारित वर्कफ्लोज़ की जरूरत वाली कंपनियों के लिए रीयल-टाइम ETL प्रोसेसिंग |
| Hadoop | हाँ | हाँ | निम्न | उच्च | बिग डेटा प्रोसेसिंग, HDFS, MapReduce, उच्च कार्यान्वयन लागत | वे बड़े एंटरप्राइज जो विशाल डेटा सेट्स संभालते हैं और वितरित डेटा स्टोरेज तथा प्रोसेसिंग की आवश्यकता है |
| AWS Glue | नहीं | हाँ | उच्च | उच्च | सर्वरलेस, Python/Scala सपोर्ट, लचीले प्रोसेसिंग वर्कलोड्स | क्लाउड-नेटिव कंपनियां जिन्हें संरचित और असंरचित डेटा के लिए सर्वरलेस ETL चाहिए |
| AWS Data Pipeline | नहीं | हाँ | उच्च | मध्यम | मैनेज्ड सेवा, फॉल्ट-टॉलरेंट, सस्ती | AWS के भीतर बुनियादी ETL प्रक्रियाएं (लेकिन ट्रांज़िशन कर रहे उपयोगकर्ताओं को AWS Glue या ज़ीरो-ETL समाधानों की जांच करनी चाहिए) |
| Azure Data Factory | नहीं | हाँ | उच्च | बहुत उच्च | अनेक कनेक्टर्स, लचीले इंटरफेस, क्लाउड-आधारित | Microsoft के Azure इकोसिस्टम का उपयोग करने वाले विविध डेटा स्रोतों वाले एंटरप्राइज |
| Google Cloud Dataflow | नहीं | हाँ | उच्च | उच्च | सर्वरलेस, Apache Beam इंटीग्रेशन, किफायती | Google Cloud इकोसिस्टम के भीतर स्ट्रीम या बैच डेटा प्रोसेसिंग |
| Stitch | नहीं | हाँ | उच्च | मध्यम | सरल ट्रांसफॉर्मेशंस, SaaS कनेक्टर्स, उपयोगकर्ता-मित्र | स्टार्टअप्स और छोटी टीमें जो डेटा वेयरहाउस में सरल डेटा प्रतिकृति पर ध्यान देती हैं |
| SAP BusinessObjects | नहीं | हाँ | मध्यम | उच्च | एंटरप्राइज-ग्रेड, SAP के साथ इंटीग्रेशन, महंगा | SAP ERP सिस्टम उपयोगकर्ता जो सहज इंटीग्रेशन चाहते हैं |
| Hevo | नहीं | हाँ | उच्च | उच्च | लो-कोड, रीयल-टाइम इंटीग्रेशन, स्वचालित स्कीमा डिटेक्शन | रीयल-टाइम एनालिटिक्स की जरूरत वाली छोटी से मध्यम कंपनियां |
| Qlik Compose | नहीं | हाँ | मध्यम | उच्च | ETL विकास का स्वचालन, Qlik Replicate के साथ रीयल-टाइम इंटीग्रेशन | स्वचालित ETL पाइपलाइन्स और Qlik Replicate के साथ इंटीग्रेशन चाहने वाले व्यवसाय |
| Integrate.io | नहीं | हाँ | उच्च | उच्च | सहज इंटरफेस, हार्डवेयर की आवश्यकता नहीं, मजबूत सुरक्षा सुविधाएं | उपयोग में सरलता और डेटा सुरक्षा को प्राथमिकता देने वाली कंपनियां |
| Airbyte | हाँ | हाँ | उच्च | बहुत उच्च | ओपन-सोर्स, आसान कनेक्टर निर्माण, dbt के साथ इंटीग्रेशन | ओपन-सोर्स, कस्टमाइज़ेबल ELT समाधानों की तलाश करने वाले संगठन |
| Astera Centerprise | नहीं | हाँ | उच्च | उच्च | कोड-फ्री, AI-संचालित डेटा एक्सट्रैक्शन, उपयोगकर्ता-मित्र | AI-संचालित स्वचालन के साथ नो-कोड ETL टूल्स की तलाश करने वाले एंटरप्राइज |
| Informatica PowerCenter | नहीं | हाँ | उच्च | बहुत उच्च | लो/नो-कोड टूल्स, कनेक्टर्स की विस्तृत श्रेणी, एंटरप्राइज-ग्रेड | विस्तृत कनेक्टर आवश्यकताओं के साथ जटिल डेटा पाइपलाइन्स संभालने वाले एंटरप्राइज |
| Estuary | नहीं | हाँ | उच्च | मध्यम | रीयल-टाइम डेटा इंटीग्रेशन, स्वचालन, स्कीमा इवॉल्यूशन, बैच और स्ट्रीमिंग सपोर्ट | IoT या ई-कॉमर्स डेटा के लिए रीयल-टाइम एनालिटिक्स चाहने वाले व्यवसाय |
| Fivetran | नहीं | हाँ | उच्च | बहुत उच्च | स्वचालित स्कीमा अपडेट, प्री-बिल्ट कनेक्टर्स, रीयल-टाइम प्रतिकृति, क्लाउड के लिए अनुकूलित | कम से कम मैन्युअल हस्तक्षेप के साथ स्वचालित, विश्वसनीय डेटा प्रतिकृति चाहने वाली कंपनियां |
| Matillion | नहीं | हाँ | उच्च | उच्च | क्लाउड-नेटिव, ड्रैग-एंड-ड्रॉप इंटरफेस, जटिल SQL ट्रांसफॉर्मेशंस, क्लाउड इन्फ्रास्ट्रक्चर के साथ स्केल | क्लाउड-आधारित डेटा ट्रांसफॉर्मेशन वर्कफ्लोज़ को अधिकतम करने वाली टीमें |
उचित ETL टूल कैसे चुनें
इस सूची में 24 टूल्स होने के साथ, अपने विकल्पों को संकीर्ण करना भारी लग सकता है। यहां सबसे आम टीम प्रोफाइल्स के आधार पर एक निर्णय ढांचा प्रस्तुत है:
- शुरुआत / छोटी टीम: इनजेशन के लिए Stitch या Airbyte और ट्रांसफॉर्मेशन के लिए dbt Core से शुरू करें। दोनों को स्वयं-होस्ट करना निःशुल्क है और इनमें न्यूनतम परिचालन ओवरहेड है।
- स्केलिंग / मध्यम आकार की कंपनी: Fivetran + dbt Cloud 2026 में सबसे लोकप्रिय प्रोडक्शन स्टैक है। ऑर्केस्ट्रेशन के लिए Apache Airflow जोड़ें।
- एंटरप्राइज / जटिल परिवेश: Informatica PowerCenter, IBM Infosphere Datastage, या Azure Data Factory — उन संगठनों के लिए जिनके पास लेगेसी सिस्टम, सख्त अनुपालन, और बड़ी इंजीनियरिंग टीमें हैं।
- AWS इकोसिस्टम: सर्वरलेस ETL के लिए AWS Glue; पाइपलाइन्स को पूरी तरह समाप्त करने के लिए Amazon Aurora और Redshift के बीच ज़ीरो-ETL इंटीग्रेशंस का मूल्यांकन करें।
- Google Cloud इकोसिस्टम: GCP के भीतर स्ट्रीम और बैच प्रोसेसिंग के लिए Google Cloud Dataflow।
- Microsoft / Azure इकोसिस्टम: ऑर्केस्ट्रेशन और मूवमेंट के लिए Azure Data Factory, और ट्रांसफॉर्मेशंस के लिए Azure Synapse के साथ पेयर करें।
- गैर-तकनीकी / नो-कोड उपयोगकर्ता: Hevo, Integrate.io, या Astera Centerprise ड्रैग-एंड-ड्रॉप इंटरफेस प्रदान करते हैं जिनमें न्यूनतम कोडिंग की आवश्यकता होती है।
अपनी टीम की ETL विशेषज्ञता बढ़ाना
जैसे-जैसे डेटा व्यवसाय संचालन का केंद्र बनता जा रहा है, प्रभावी ETL प्रक्रियाएं महत्वपूर्ण हैं। प्रतिस्पर्धी बने रहने के लिए, आपकी टीम के डेटा इंजीनियरिंग और प्रबंधन कौशल को लगातार बढ़ाना आवश्यक है। DataCamp for Business संगठनों को अपने कर्मचारियों को अपस्किल करने में मदद करने के लिए अनुकूलित समाधान प्रदान करता है, यह सुनिश्चित करते हुए कि वे आधुनिक डेटा एनालिटिक्स की जटिलताओं को संभालने के लिए अच्छी तरह से सुसज्जित हैं। DataCamp for Business के साथ, आपकी टीम एक्सेस कर सकती है:
- फोकस्ड लर्निंग पाथ्स: अपनी टीम को Apache Airflow, AWS और अन्य जैसे ETL टूल्स पर लक्षित प्रशिक्षण दें ताकि वे कुशल डेटा पाइपलाइन्स डिजाइन और प्रबंधित करने की अपनी क्षमता में सुधार कर सकें।
- व्यावहारिक अनुभव: ऐसे हैंड्स-ऑन प्रोजेक्ट्स को प्रोत्साहित करें जो आपके संगठन की डेटा चुनौतियों को प्रतिबिंबित करते हों, जिससे आपकी टीम को जटिल डेटा कार्यों को संभालने के लिए आवश्यक आत्मविश्वास और विशेषज्ञता का निर्माण करने में मदद मिले।
- स्केलेबल प्रशिक्षण समाधान: ऐसे स्केलेबल प्रशिक्षण प्लेटफॉर्म चुनें जो ETL और डेटा प्रबंधन में संसाधनों की एक श्रृंखला प्रदान करें, यह सुनिश्चित करते हुए कि आपकी टीम आपके संगठन के बढ़ने के साथ अनुकूल हो सके।
- प्रगति ट्रैकिंग: अपनी टीम के विकास की निगरानी करने के लिए टूल्स का उपयोग करें, निरंतर सुधार सुनिश्चित करने के लिए नियमित फीडबैक प्रदान करें।
अपनी डेटा टीम के कौशल में निवेश करना न केवल ETL दक्षता को बढ़ाता है बल्कि बेहतर डेटा रणनीतियों को भी आगे बढ़ाता है, जो आपके संगठन की सफलता में योगदान करता है। अधिक जानने के लिए आज ही डेमो का अनुरोध करें।
अतिरिक्त संसाधन
निष्कर्षतः, कई अलग-अलग ETL और डेटा इंटीग्रेशन टूल्स उपलब्ध हैं, जिनमें से प्रत्येक की अपनी अनूठी विशेषताएं और क्षमताएं हैं। कुछ लोकप्रिय विकल्पों में SSIS, Talend Open Studio, Pentaho Data Integration, Hadoop, Airflow, AWS Data Pipeline, Google Dataflow, SAP BusinessObjects Data Services, और Hevo शामिल हैं। इन टूल्स पर विचार कर रही कंपनियों को अपनी विशिष्ट आवश्यकताओं और बजट का सावधानीपूर्वक मूल्यांकन करना चाहिए ताकि अपनी जरूरतों के लिए सही समाधान चुन सकें। ETL टूल्स और अन्य विषयों पर अधिक संसाधनों के लिए, निम्न लिंक देखें:
- ETL बनाम ELT: अंतर समझें और सही विकल्प चुनें
- ELT समझाया गया: क्लाउड युग के लिए डेटा इंटीग्रेशन
- Reverse ETL क्या है? एक सहायक गाइड
- Zero-ETL क्या है? डेटा इंटीग्रेशन के नए दृष्टिकोण
- डेटा वेयरहाउस आर्किटेक्चर: रुझान, टूल्स, और तकनीकें
- शीर्ष 17 ETL इंटरव्यू प्रश्न और उत्तर
- Airflow के साथ ETL पाइपलाइन बनाना
FAQs
ETL क्या है?
ETL का अर्थ है Extract, Transform, Load। यह विभिन्न स्रोतों से डेटा निकालने, उसे उपयोगी प्रारूप में परिवर्तित करने, और डेटा वेयरहाउस जैसे डेस्टिनेशन सिस्टम में लोड करने की प्रक्रिया है।
ETL टूल्स का उपयोग करने के क्या लाभ हैं?
ETL टूल्स डेटा इंटीग्रेशन प्रक्रिया को स्वचालित करते हैं, जिससे डेटा पाइपलाइन्स को बनाने और बनाए रखने में लगने वाला समय और प्रयास कम होता है। वे डेटा की शुद्धता और सुसंगतता सुनिश्चित करने, डेटा गुणवत्ता में सुधार करने, और तेज़ निर्णय लेने में सक्षम बनाने में भी मदद करते हैं।
ETL के कुछ सामान्य उपयोग मामले क्या हैं?
ETL के सामान्य उपयोग मामलों में डेटा वेयरहाउसिंग, बिज़नेस इंटेलिजेंस, डेटा माइग्रेशन, डेटा इंटीग्रेशन, और डेटा कंसोलिडेशन शामिल हैं।
कुछ लोकप्रिय ETL टूल्स कौन से हैं?
कुछ लोकप्रिय ETL टूल्स में IBM Infosphere Information Server, Oracle Data Integrator, Microsoft SQL Server Integration Services (SSIS), Talend Open Studio, Pentaho Data Integration (PDI), Hadoop, AWS Glue, AWS Data Pipeline, Azure Data Factory, Google Cloud Dataflow, Stitch, SAP BusinessObjects Data Services, और Hevo शामिल हैं।
ETL टूल चुनते समय मुझे किन बातों पर विचार करना चाहिए?
ETL टूल चुनते समय, अपने विशिष्ट आवश्यकताओं, बजट, डेटा स्रोतों और डेस्टिनेशंस, स्केलेबिलिटी, उपयोग में सरलता, और उपलब्ध समर्थन व डॉक्यूमेंटेशन जैसे कारकों पर विचार करें।
क्या कोई ओपन-सोर्स ETL टूल्स उपलब्ध हैं?
हाँ, कई ओपन-सोर्स ETL टूल्स उपलब्ध हैं, जिनमें Talend Open Studio, Pentaho Data Integration (PDI), और Apache NiFi शामिल हैं।
ETL और ELT में क्या अंतर है?
ETL का अर्थ है Extract, Transform, Load, जबकि ELT का अर्थ है Extract, Load, Transform। ETL में, डेटा को डेस्टिनेशन सिस्टम में लोड करने से पहले ट्रांसफॉर्म किया जाता है, जबकि ELT में, डेटा पहले डेस्टिनेशन सिस्टम में लोड किया जाता है और फिर ट्रांसफॉर्म किया जाता है।
क्या मैं रीयल-टाइम डेटा इंटीग्रेशन के लिए ETL टूल्स का उपयोग कर सकता/सकती हूँ?
हाँ, कुछ ETL टूल्स, जैसे AWS Glue और Hevo, रीयल-टाइम डेटा इंटीग्रेशन का समर्थन करते हैं।
ETL विकास के कुछ सर्वोत्तम अभ्यास क्या हैं?
ETL विकास के कुछ सर्वोत्तम अभ्यासों में स्केलेबिलिटी के लिए डिजाइन करना, डेटा गुणवत्ता और प्रदर्शन का अनुकूलन करना, पूरी तरह से परीक्षण और डीबगिंग करना, और ETL प्रक्रिया व डेटा लिनिएज का डॉक्यूमेंटेशन करना शामिल है।
आज कई संगठन अपने निर्णयों को डेटा के आधार पर लेना चाहते हैं, लेकिन अपनी बढ़ती डेटा स्रोतों का प्रबंधन करने में सहायता की आवश्यकता होती है। और अधिक महत्वपूर्ण यह है कि जब वे अपने कच्चे डेटा को उपयोगी प्रारूपों में परिवर्तित नहीं कर पाते, तो उनकी डेटा उपलब्धता कमजोर हो सकती है, जिससे डेटा संस्कृति के विकास में बाधा आती है।
ETL (Extract, Transform, Load) टूल्स इन समस्याओं के समाधान का एक महत्वपूर्ण हिस्सा हैं। चुनने के लिए कई अलग-अलग ETL टूल्स हैं, जो कंपनियों को सर्वोत्तम विकल्प चुनने की शक्ति देते हैं। हालांकि, उपलब्ध सभी विकल्पों की समीक्षा करना समय लेने वाला हो सकता है।
इस पोस्ट में, हमने शीर्ष 24 ETL टूल्स की सूची तैयार की है और बाजार में उपलब्ध कुछ बेहतरीन विकल्पों का विस्तृत विवरण दिया है।
TL;DR
ETL का संरचित परिचय पाने के लिए, Python में ETL और ELT पर यह कोर्स देखें।