Kurs
Einführung in KI im Beruf
2 Std.
127.2K
OpenAI hat GPT-6 Astra vorgestellt und nennt es das weltweit intelligenteste und am besten ausgerichtete Modell.
Astra tritt in einem dicht besetzten Spitzenfeld an, in dem Anthropics Claude Fable 5.1 (veröffentlicht am 1. September 2026) und Claude Opus 5 bei Coding und agentischer Arbeit die Referenzen sind.
Die Schlagzeilen sind selbstbewusst.
Astra erreicht im FrontierMath Tier 4 eine Sättigung mit 97,6%, sättigt ARC-AGI-3 mit 99,9% unter OpenAIs Provider-Adapter-Harness und erzielt 100% auf dem ExploitBench. Zudem setzt es bei Computer- und Browserbedienung eine neue Marke, mit 72,6% auf OSWorld 2.0 und rund 47% weniger Zeit pro Aufgabe als der Vorgänger GPT-5.6 Sol.
Sowohl ARC-AGI-3 als auch FrontierMath Tier 4 wurden speziell dafür entwickelt, der KI-Entwicklung voraus zu bleiben. Sie zu „sättigen“ ist qualitativ etwas anderes, als eine übliche Bestenliste anzuführen.
In diesem Artikel zeige ich alles Neue an GPT-6 Astra: die Funktionen, die Benchmarks und ein paar Beispielanwendungen.
Wenn du das Modell in Aktion sehen willst, folge unserem GPT-6 Astra API-Tutorial und sieh dir einige GPT-6 Astra Projekte zum Ausprobieren an. Wie es gegen die Konkurrenz abschneidet, erfährst du in unserem Vergleich GPT-6 Astra vs Claude Fable 5.1. Außerdem empfehle ich unseren Leitfaden zum Lernen mit Claude sowie unsere Berichterstattung zum neuen Jev System One und den Vergleich Jev vs GPT-6 Astra.
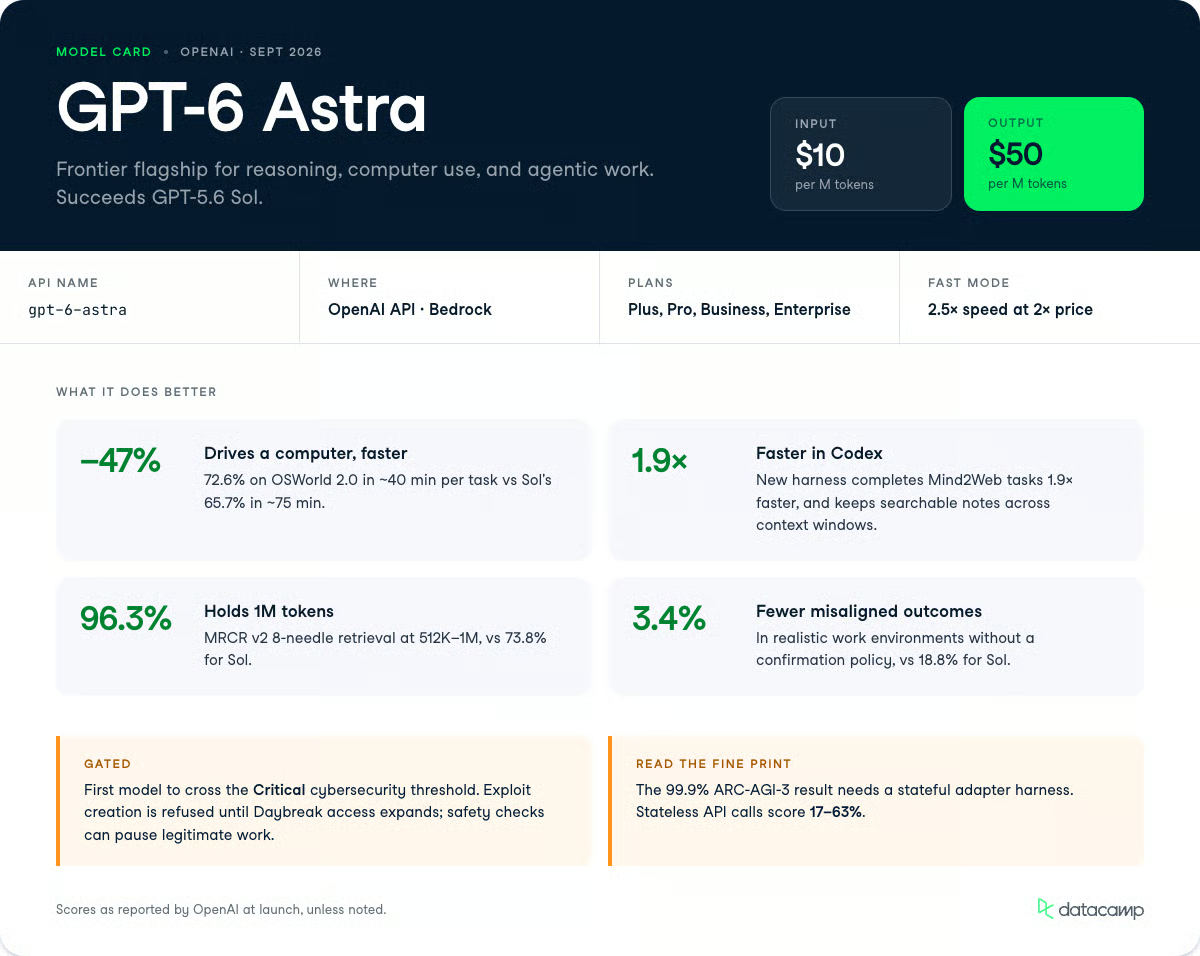
GPT-6 Astra ist OpenAIs neues Spitzenmodell und löst GPT-5.6 Sol als Top-Modell für Reasoning, Computerbedienung und agentische Arbeit ab.
OpenAI positioniert es entlang dreier Achsen:
Für Praktiker ist OSWorld 2.0 die aussagekräftigste Zahl: Astra erzielt 72,6% in etwa 40 Minuten pro Aufgabe, gegenüber 65,7% bei GPT-5.6 Sol mit rund 75 Minuten.
Die Kombination aus höherer Genauigkeit und kürzerer Laufzeit ist der Unterschied zwischen einem Agenten, den du beaufsichtigst, und einem, dem du Aufgaben einfach übergibst.
Astra kommt mit einem aktualisierten Codex-Harness, das laut OpenAI Aufgaben auf dem Mind2Web-Benchmark 1,9-mal schneller abschließt als die aktuelle GPT-5.6 Sol-Erfahrung.
Es ist als gpt-6-astra in der OpenAI API und über Amazon Bedrock verfügbar, mit einer GPT-6 Astra Pro-Stufe für Pro-, Business- und Enterprise-Pläne.
Wenn dich auch die neuen Modelle der unteren Stufen von OpenAI interessieren, lies unseren Leitfaden zu GPT-6 Sol und Luna.
Die Neuerungen von Astra konzentrieren sich auf agentische Ausführung: Computerbedienung, fertige professionelle Artefakte, Kontexthaltung über lange Codingsessions hinweg und Handeln innerhalb autorisierter Grenzen.
Das sind die auffälligsten Fähigkeiten.
Astra kann einen Computer direkt steuern und die Art von mühsamer Mehrschrittarbeit übernehmen, die sonst einen Nachmittag frisst.
Gute Beispiele sind:
In Latenzsimulationen auf OSWorld 2.0 erreicht Astra 72,6% in rund 40 Minuten pro Aufgabe, gegenüber 65,7% bei GPT-5.6 Sol in etwa 75 Minuten – eine Zeitersparnis von 47%.
OSWorld 2.0 misst, ob ein Modell einen Computer tatsächlich bedienen kann – also echte Oberflächen navigieren, klicken, tippen und Mehrschrittaufgaben wie ein Mensch abschließen.
Die 47% weniger Zeit pro Aufgabe sind genauso wichtig wie die höhere Genauigkeit, denn Agentenkosten skalieren mit der Echtzeit. Ein Modell, das in 40 statt 75 Minuten fertig ist, ist nicht nur schneller, sondern kostet für denselben Workload ungefähr die Hälfte.
Allerdings zeigen unabhängige ARC-Prize-Tests, dass Astras Spitzenwerte bei Computerbedienung und Reasoning stark vom Harness abhängen.
Auf ARC-AGI-3 erzielte das standardmäßige zustandslose Harness je nach Reasoning-Stufe Werte von etwa 17% bis 63%, während das Provider-Adapter-Harness mit Zustandsbeibehaltung die beworbenen ~99,9% erreichte.
Wenn du das Modell zustandslos aufrufst, rechne mit niedrigeren Werten als in den Launch-Charts.
Astra ist darauf trainiert, polierte, professionelle Artefakte zu erzeugen, die deinen Vorlagen folgen, statt generischer Erstentwürfe.
Es erstellt Dokumente, Präsentationen, Tabellen und Analysen, die zu deinem Schreib- und Bildstil passen, und zieht nur den relevanten Kontext in die Ausgabe, statt alles Bekannte aufzublähen.
In OpenAIs eigenem Demo baut Astra aus wenigen Templateslides ein komplettes Folienset zu einem fiktiven Modell und hält Tonalität und Layout durchgehend konsistent.
Wer schon einmal eine Stunde damit verbracht hat, den Markdown-Dump eines LLM in eine Corporate-Vorlage zu zwängen, weiß: Die Vorlagentreue ist genau der Punkt, den ich als Erstes testen würde.
Mit Sites in ChatGPT kann Astra Websites, Web-Apps und Spiele direkt aus einem Prompt erstellen, hosten und teilen – mit besserem visuellen Urteilsvermögen als frühere Modelle.
Astra entscheidet, wann es nachfragt und wann es mit sinnvollen Annahmen fortfährt.
Wenn Anweisungen Interpretationsspielraum lassen, füllt es Routinelücken eigenständig und stellt nur dann präzise Fragen, wenn die Antwort das Ergebnis wirklich verändern kann.
Im Side-by-Side von OpenAI baute GPT-5.6 Sol in 13 Minuten 15 Sekunden autonom eine persönliche Karriere-Website, während Astra nach 20 Sekunden stoppte, um zu fragen, in welche Karriere der Nutzer wechseln will.
In Codex kann Astra asynchron fragen, arbeitet also an Teilen weiter, die nicht von deiner Antwort abhängen, und wartet nur bei entscheidenden Punkten.
Astra bleibt zudem orientiert, wenn sich eine Aufgabe verändert.
Frühere Modelle interpretierten eine Kurskorrektur mitten in der Aufgabe manchmal als völlig neues Ziel und vergaßen die ursprünglichen Constraints. Astra integriert neue Anforderungen und beantwortet Nebenfragen, ohne den übergeordneten Job fallen zu lassen.
GPT-6 Astra führt eine neue Methode ein, mit der Codex Kontext bewahrt und wiederfindet, wenn das Kontextfenster voll ist – statt ständiger Zusammenfassungen nutzt es durchsuchbare Notizen.
Historisch komprimieren Modelle lange Debug-Sessions oder große Refactorings zu einer einzigen Zusammenfassung, die Details verlieren kann – etwa, warum ein Fix scheiterte oder wie sich eine Komponente verhält.
Mit Astra hält Codex Notizen über Fenster hinweg und lässt frühere Fenster durchsuchbar, sodass es Anforderungen oder Testergebnisse aus früheren Nachrichten findet, selbst wenn sie nicht in den Notizen landeten.
Du aktivierst dieses experimentelle Feature in deiner Codex-config.toml. OpenAI sagt, es werde in den kommenden Wochen Standard für Astra.
Astra erreicht unter OpenAIs Preparedness Framework die „Critical“-Schwelle in der Cybersicherheit – die stärkste neue Fähigkeit, aber zugleich die am stärksten beschränkte.
Zum Start hilft es bei sicherem Code-Review und Patching, verweigert jedoch fortgeschrittene Aufgaben wie das Erstellen von Proof-of-Concept-Exploits.
OpenAI plant, den Zugang über das Daybreak-Programm mit weniger restriktiven Schutzmechanismen zu erweitern – für Schwachstellen- und PoC-Validierung, Malware-Analyse und Detection Engineering.
Wegen des höheren Risikos können zusätzliche Sicherheitsprüfungen legitime Arbeit pausieren oder stoppen: In ChatGPT oder Codex wirst du ggf. um eine Bestätigung gebeten, und in der API wird die Aufgabe direkt beendet.
Astra setzt in OpenAIs eigenen Auswertungen neue Bestwerte bei Computerbedienung, Mathematik, Coding und Cybersicherheit – oft mit weniger Ausgabetokens als GPT-5.6 Sol oder Claude-Modelle.
Die folgenden Werte stammen aus OpenAIs Launch-Tabellen. Lies sie als Anbieterangaben und beachte die Harness-Einschränkungen, wo sie relevant sind.
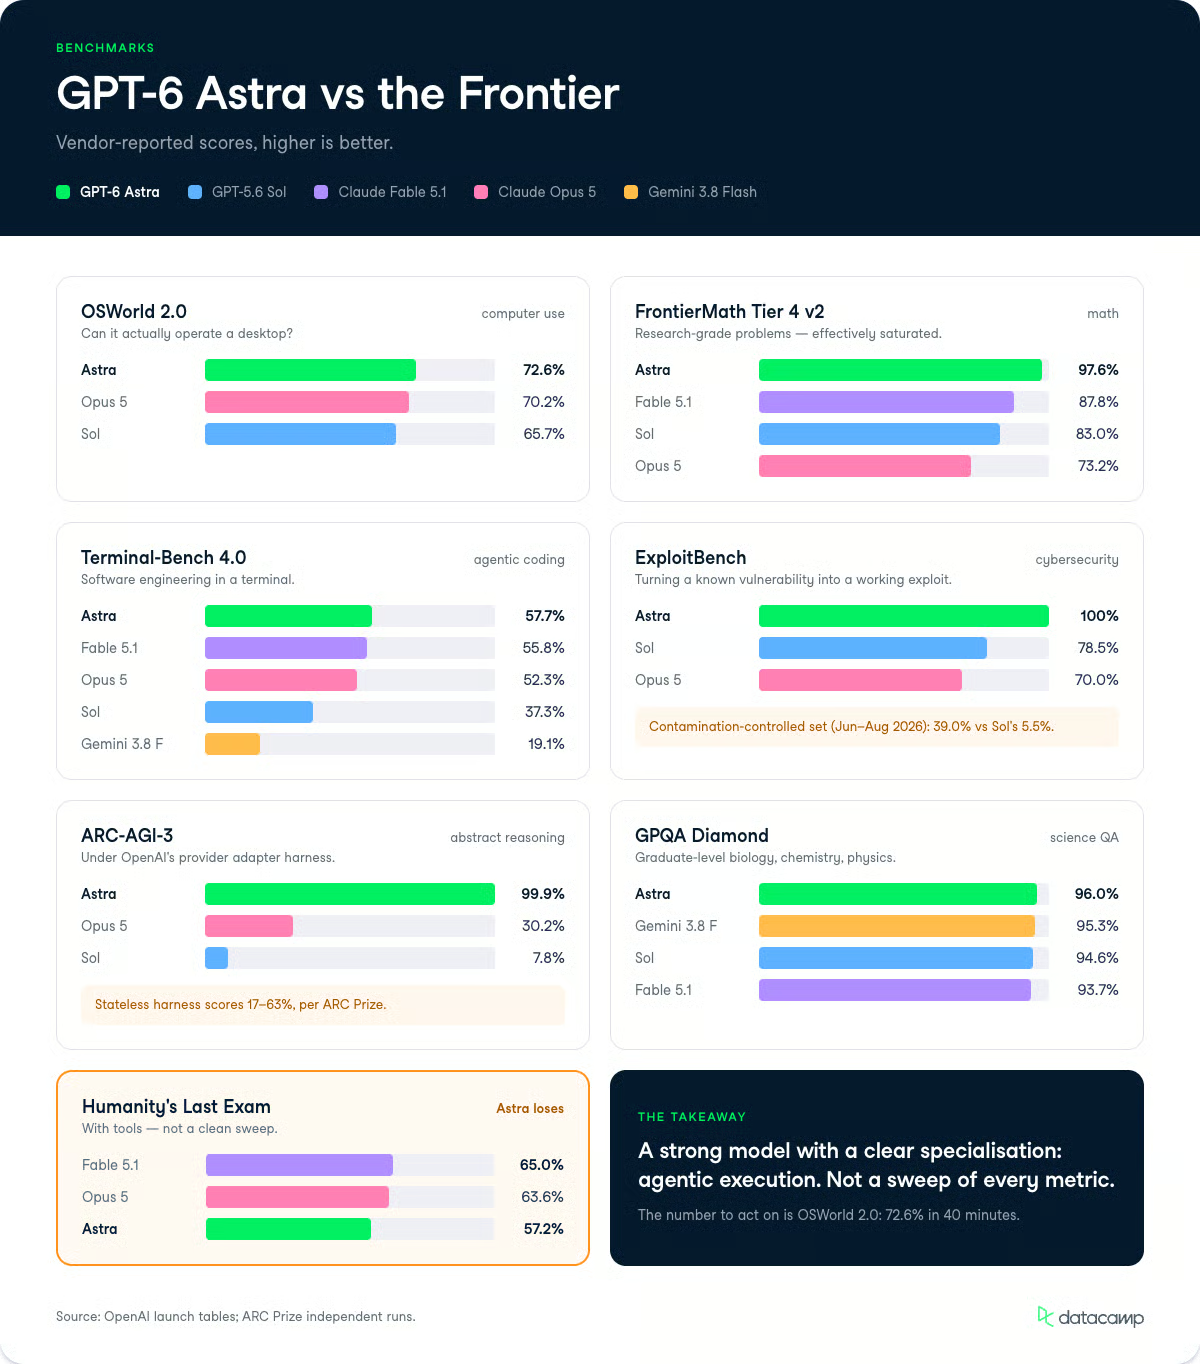
Astra erzielt 72,6% auf dem OSWorld 2.0 Offline-Set, gegenüber 65,7% für GPT-5.6 Sol und 70,2% für Claude Opus 5.
OSWorld misst, ob ein Agent reale Desktop-Aufgaben erledigen kann – Apps navigieren, Dateien manipulieren –, also am nächsten dran an „Kann das Ding wirklich meinen Computer für mich bedienen?"
Auf ScreenSpot-Pro, das das Erkennen von UI-Elementen auf dem Bildschirm ohne Tools testet, erreicht Astra 92,7% gegenüber 76,9% bei GPT-5.6 Sol und 87,3% bei Claude Fable 5.
Auf Agents' Last Exam kommt es auf 59,3% und liegt damit vor Claude Opus 5 (55,5%) und GPT-5.6 Sol (53,6%), während es rund 65% weniger Ausgabetokens als Opus 5 nutzt.
Astra erzielt 97,6% auf FrontierMath Tier 4 v2, der härtesten Stufe eines forschungsnahen Mathe-Benchmarks, gegenüber 87,8% bei Claude Fable 5.1 und Fable 5 sowie 73,2% bei Claude Opus 5.
OpenAI spricht von Sättigung, und angesichts der Decke ist das plausibel.
Auf GPQA Diamond, einem Set von Fragen auf Master- bis Promotionsniveau in Biologie, Chemie und Physik, erreicht Astra 96,0% gegenüber 95,3% bei Gemini 3.8 Flash und 94,6% bei GPT-5.6 Sol.
Nicht alle Metriken führt es an. Bei Humanity's Last Exam mit Tools erzielt Astra 57,2% und liegt hinter Claude Fable 5.1 (65,0%) und Opus 5 (63,6%). Es gewinnt also nicht jede Reasoning-Eval.
Auf Terminal-Bench 4.0, der Agenten in Software Engineering, Systemkonfiguration und Datenanalyse im Terminal testet, erzielt Astra 57,7% gegenüber 37,3% bei GPT-5.6 Sol, 55,8% bei Claude Fable 5.1 und 19,1% bei Gemini 3.8 Flash.
Das ist ein deutlicher Vorsprung vor Gemini Flash und ein moderater vor Fable 5.1.
Beim Coding ist das Bild anderswo knapper.
Auf FrontierCode 1.1 Main kommt Astra auf 53,3% gegenüber 53,5% bei Fable 5 und 53,4% bei Opus 5 – faktisch ein Gleichstand. Auf DeepSWE v1.1 erreicht es 74,1% gegenüber 73,8% bei Gemini 3.8 Flash und 69,9% bei Fable 5.
Als wir GPT-5.6 Terra im Vergleich Terra vs Claude Sonnet 5 betrachtet haben, erzielte Terra 87,4% auf Terminal-Bench 2.1 – eine andere Version. Ein Direktvergleich ist also nicht 1:1 möglich.
Astra erzielt 100% auf ExploitBench gegenüber 78,5% bei GPT-5.6 Sol und 70% bei Claude Opus 5 sowie 42,4% auf ExploitGym gegenüber 30,3% bei Sol.
ExploitBench misst, ob ein Modell eine bekannte Schwachstelle in einen funktionierenden Exploit umsetzen kann. Eine perfekte Punktzahl ist genau der Grund, warum OpenAI diese Fähigkeit zum Start absichert.
Auf dem kontaminationskontrollierten ExploitBench (Juni–August 2026), aufgebaut aus Schwachstellen der vorangegangenen drei Monate, erzielt Astra 39,0% gegenüber 5,5% bei Sol.
Auf SRE-Bench, das Reverse Engineering von Binärdateien ohne Quellcode misst, löst Astra 88,0% im ersten Versuch gegenüber 55,9% bei Sol.
Das unabhängige Labor Irregular meldete, dass Astra 86 von 226 FrontierCyber-Herausforderungen löste, gegenüber 34 bei Sol – darunter Zero-Day-Funde in Browsern und einer Clouddatenbank.
Astra erzielt 99,9% auf ARC-AGI-3 unter OpenAIs Provider-Adapter-Harness, gegenüber 7,8% bei GPT-5.6 Sol und 30,2% bei Claude Opus 5.
Diese Zahl solltest du mit Vorsicht lesen: Unabhängige Runs des ARC Prize zeigen beim standardmäßigen zustandslosen Harness etwa 17% bis 63% – die ~99,9% erfordern den zustandsbehafteten Adapter und einen umfassenden, sehr teuren Durchlauf.
Bei langem Kontext erreicht Astra 100% auf OpenAI MRCR v2 8-needle im Bereich 256K–512K und 96,3% im Bereich 512K–1M, gegenüber 91,5% und 73,8% bei GPT-5.6 Sol.
Diese Abrufzuverlässigkeit bei 1M Tokens ist für dokumentenlastige Pipelines ein echter Schritt nach vorn gegenüber Sol.
Astra liegt bei 2,4% auf OpenAIs internem Sicherheitsbenchmark zur Computerbedienung (niedriger ist besser), gegenüber 22,0% bei GPT-5.6 Sol, 9,5% bei Fable 5.1 und 11,5% bei Opus 5.
In realistischen Arbeitsumgebungen beträgt seine Rate fehlgerichteter Ergebnisse ohne Bestätigungsrichtlinie 3,4%, gegenüber 18,8% bei Sol und 13,5% bei GPT-5.6 Terra.
Die eine Regression, die OpenAI hervorhebt, betrifft die Überwachbarkeit der Chain-of-Thought.
Astra produziert kürzeres, weniger ausschweifendes Reasoning und kontrolliert seine CoT deutlich besser als Sol; auf CoT-Control zwischen 750 und 1.250 Tokens hielt es Vorgaben in 60,9% der Fälle ein, gegenüber 16,1% bei Sol.
Das UK AISI fand, dass Astra sich unter adversarialem Prompting der Überwachung entziehen konnte. OpenAI nimmt den Rückgang ernst und nennt das Thema eine Forschungspiorität.
So ordnen sich Astras gemeldete Werte gegenüber den direkten Rivalen auf einigen Kernbenchmarks ein.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72,6% | 65,7% | - | 70,2% | - |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | 73,2% | - |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 93,7% | 95,3% |
| Terminal-Bench 4,0 | 57,7% | 37,3% | 55,8% | 52,3% | 19,1% |
| ExploitBench | 100,0% | 78,5% | - | 70,0% | - |
| ARC-AGI-3 (Adapter-Harness) | 99,9% | 7,8% | - | 30,2% | - |
GPT-6 Astra rollt zunächst für eine begrenzte Zahl von Organisationen aus und in den nächsten Tagen für alle ChatGPT Plus-, Pro-, Business- und Enterprise-Nutzer sowie über die OpenAI API und AWS.
Enterprise-Admins können es pro Workspace aktivieren; zum Start ist es standardmäßig deaktiviert. Pro-, Business- und Enterprise-Pläne erhalten außerdem GPT-6 Astra Pro.
Für Entwickler ist das Modell als gpt-6-astra in der OpenAI API und in Amazon Bedrock verfügbar.
Die Standardpreise für die API sind:
Zum Vergleich: Das liegt deutlich über den 2/12 US-Dollar von GPT-5.6 Terra aus unserer früheren Berichterstattung und über den 5/25 US-Dollar von Claude Opus 5.
Astra ist als Spitzenmodell für Reasoning und Automatisierung bepreist, nicht als Massen-Textarbeiter.
Es unterstützt Zero Data Retention für berechtigte API-Kunden. Die Nutzung ist in bestehenden Abonnements enthalten, mit der Option, zusätzliche Credits zu kaufen.
Meine Social-Feeds sind voll mit Beispielen für GPT-6 Astra. Auch wenn ich selbst noch nicht damit gearbeitet habe, gibt es spannende Demos, die ich hier hervorheben möchte:
Viele Posts zeigen, wie GPT-6 Astra in Blender äußerst detaillierte und realistische 3D-Modelle erzeugt.
Im Clip unten gab X-Nutzer Tom Krcha GPT-6 „ein Bild eines Hauses und bat, es in 3D mit allen Details – inklusive Spielzeug, Geräten und Möbeln – zu erstellen. Das ist eine vollständige 3D-Modellrekonstruktion in Blender mit Geometrie, die du manuell anpassen kannst und die mit 60 fps als lokal gerendertes \"Spiel\" auf dem Gerät läuft."
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Josef Waples
3 Min.