Cours
Introduction à l’IA pour le travail
2 h
126.9K
OpenAI a lancé GPT-6 Astra, présenté comme le modèle le plus intelligent et le mieux aligné au monde.
Astra arrive sur un segment de pointe très concurrentiel, où les repères pour le code et le travail agentique sont les modèles Claude Fable 5.1 (publié le 1er septembre 2026) et Claude Opus 5 d'Anthropic.
Les promesses mises en avant sont ambitieuses.
Astra « sature » FrontierMath Tier 4 avec un score de 97,6 %, atteint 99,9 % sur ARC-AGI-3 avec l'adapter harness d'OpenAI, et décroche 100 % sur ExploitBench. Il établit aussi un nouveau standard d'usage de l'ordinateur et du navigateur, avec 72,6 % sur OSWorld 2.0 tout en prenant environ 47 % de temps en moins par tâche que son prédécesseur GPT-5.6 Sol.
ARC-AGI-3 et FrontierMath Tier 4 ont été conçus pour garder une longueur d'avance sur les capacités de l'IA ; les « saturer » indique donc autre chose que de simplement grimper dans un classement.
Dans cet article, je passe en revue tout ce qu'apporte GPT-6 Astra : nouvelles fonctionnalités, benchmarks, et cas d'usage.
Pour voir le modèle à l'œuvre, suivez notre tutoriel API GPT-6 Astra et découvrez des projets GPT-6 Astra à essayer. Pour le comparer à la concurrence, lisez notre comparatif GPT-6 Astra vs Claude Fable 5.1. Je vous recommande aussi notre guide pour apprendre à utiliser Claude, ainsi que notre couverture du nouveau modèle Jev System One et notre comparatif Jev vs GPT-6 Astra.
GPT-6 Astra est le nouveau modèle phare d'OpenAI pour le raisonnement, l'usage de l'ordinateur et le travail agentique, succédant à GPT-5.6 Sol.
OpenAI le positionne autour de trois axes :
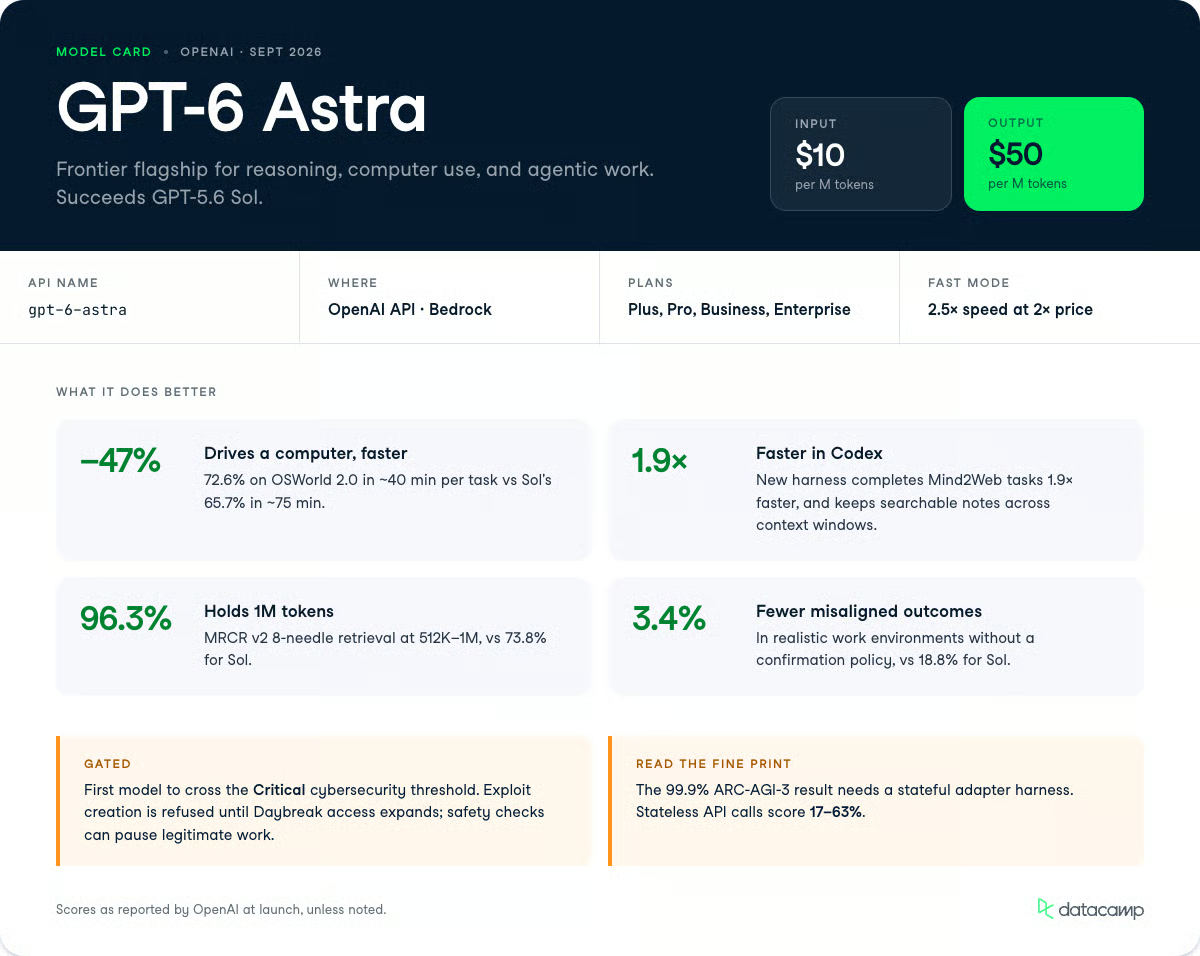
Le benchmark le plus parlant pour les praticiens est OSWorld 2.0, où Astra marque 72,6 % en environ 40 minutes par tâche, contre 65,7 % pour GPT-5.6 Sol à environ 75 minutes.
Cette combinaison de meilleure précision et de temps mur réduit fait la différence entre un agent à surveiller et un agent à qui vous confiez une tâche.
Astra est livré avec un harness Codex mis à jour qu'OpenAI annonce 1,9 fois plus rapide que l'expérience actuelle de GPT-5.6 Sol sur le benchmark Mind2Web.
Il est disponible sous gpt-6-astra dans l'API OpenAI et via Amazon Bedrock, avec un niveau GPT-6 Astra Pro pour les offres Pro, Business et Enterprise.
Si les nouveaux modèles de gamme inférieure d'OpenAI vous intéressent aussi, consultez notre guide GPT-6 Sol et Luna.
Les nouveautés d'Astra se concentrent sur l'exécution agentique : pilotage de l'ordinateur, production de livrables professionnels finalisés, maintien du contexte sur de longues sessions de code, et respect des limites d'autorisation.
Voici les capacités qui se démarquent.
Astra peut utiliser un ordinateur directement, en prenant en charge ces travaux fastidieux en plusieurs étapes qui mangent un après-midi.
Quelques exemples parlants :
Dans les simulations de latence sur OSWorld 2.0, Astra atteint 72,6 % en environ 40 minutes par tâche, contre 65,7 % pour GPT-5.6 Sol à environ 75 minutes, soit 47 % de temps en moins par tâche.
OSWorld 2.0 mesure la capacité d'un modèle à réellement utiliser un ordinateur : navigation dans de vraies interfaces, clic, saisie, réalisation de tâches multi-étapes comme un humain.
La réduction de 47 % du temps par tâche compte autant que le gain de précision, car le coût d'un agent croît avec le temps mur ; finir en 40 minutes au lieu de 75, ce n'est pas seulement plus rapide, c'est aussi environ deux fois moins cher sur une même charge.
Cela dit, des tests indépendants de l'ARC Prize montrent que les scores phares d'Astra en usage de l'ordinateur et en raisonnement dépendent fortement du harness.
Sur ARC-AGI-3, le harness standard sans état a produit des scores d'environ 17 % à 63 % selon le niveau de raisonnement, tandis que le provider adapter harness, qui conserve l'état de raisonnement, atteint les ~99,9 % annoncés.
Si vous appelez le modèle sans état, attendez-vous à des scores inférieurs aux graphiques de lancement.
Astra est entraîné pour générer des livrables professionnels soignés qui respectent vos modèles, plutôt que des brouillons génériques.
Il crée des documents, présentations, feuilles de calcul et analyses qui reflètent votre style rédactionnel et visuel, et il n'extrait que le contexte pertinent au lieu de gonfler la sortie avec tout ce qu'il sait.
Dans la démo d'OpenAI, Astra construit un diaporama sur un modèle fictif à partir de quelques slides modèles, en gardant un ton et une mise en page cohérents.
Pour quiconque a passé une heure à reformater un export markdown d'un LLM dans un template d'entreprise, le respect du modèle est le premier point à tester.
Avec Sites dans ChatGPT, Astra peut créer, héberger et partager des sites, des applications web et des jeux directement à partir d'un prompt, avec un meilleur jugement visuel que les modèles précédents.
Astra décide quand vous poser une question et quand avancer sur des hypothèses raisonnables.
Lorsque les instructions laissent une marge d'interprétation, il comble seul les lacunes de routine et ne pose des questions ciblées que lorsque la réponse pourrait changer l'issue.
Dans la comparaison d'OpenAI, GPT-5.6 Sol a construit de manière autonome un site de carrière personnel en 13 minutes 15, tandis qu'Astra s'est arrêté après 20 secondes pour demander vers quel métier l'utilisateur se réorientait.
Dans Codex, Astra peut poser des questions de façon asynchrone, en poursuivant le travail qui ne dépend pas de votre réponse et n'attendant que pour les décisions conséquentes.
Astra reste aussi orienté quand la tâche évolue.
Les modèles précédents prenaient parfois un message de recadrage en cours de route pour un nouvel objectif et perdaient les contraintes initiales ; Astra intègre les nouvelles exigences et répond aux questions annexes sans lâcher le travail principal.
GPT-6 Astra introduit une nouvelle façon pour Codex de conserver et retrouver le contexte lorsque la fenêtre se remplit, en remplaçant les résumés répétés par des notes interrogeables.
Traditionnellement, les modèles compactent de longues sessions de débogage ou de gros refactors en un résumé unique, qui peut faire perdre des détails sur la cause d'un échec ou le comportement d'un composant.
Avec Astra, Codex conserve des notes entre fenêtres et laisse les fenêtres antérieures interrogeables, ce qui lui permet de retrouver une exigence ou un résultat de test d'un message précédent même si la note ne l'avait pas capturé.
Vous activez cette fonctionnalité expérimentale dans votre config.toml Codex, et OpenAI indique qu'elle deviendra le comportement par défaut d'Astra dans les prochaines semaines.
Astra atteint le seuil Critique en cybersécurité selon le Preparedness Framework d'OpenAI : c'est à la fois sa nouvelle capacité la plus forte et la plus contrainte.
Au lancement, il aide à la revue de code sécurisé et au patching, mais refuse des tâches plus avancées comme la création d'exploits de preuve de concept.
OpenAI prévoit d'élargir l'accès via son programme Daybreak avec des garde-fous moins restrictifs, permettant la validation de vulnérabilités et de POC, l'analyse de malwares et l'ingénierie de détection.
En raison du risque accru, des contrôles de sécurité supplémentaires peuvent mettre en pause ou stopper un travail légitime : dans ChatGPT ou Codex, il se peut qu'on vous demande de valider une action, et dans l'API, la tâche s'arrêtera purement et simplement.
Astra établit de nouveaux records en usage de l'ordinateur, mathématiques, code et cybersécurité dans les évaluations rapportées par OpenAI, souvent avec moins de tokens de sortie que GPT-5.6 Sol ou les modèles Claude.
Les scores ci-dessous proviennent des tableaux de lancement d'OpenAI ; considérez-les comme des chiffres fournisseur et gardez à l'esprit les réserves liées aux harness là où elles s'appliquent.
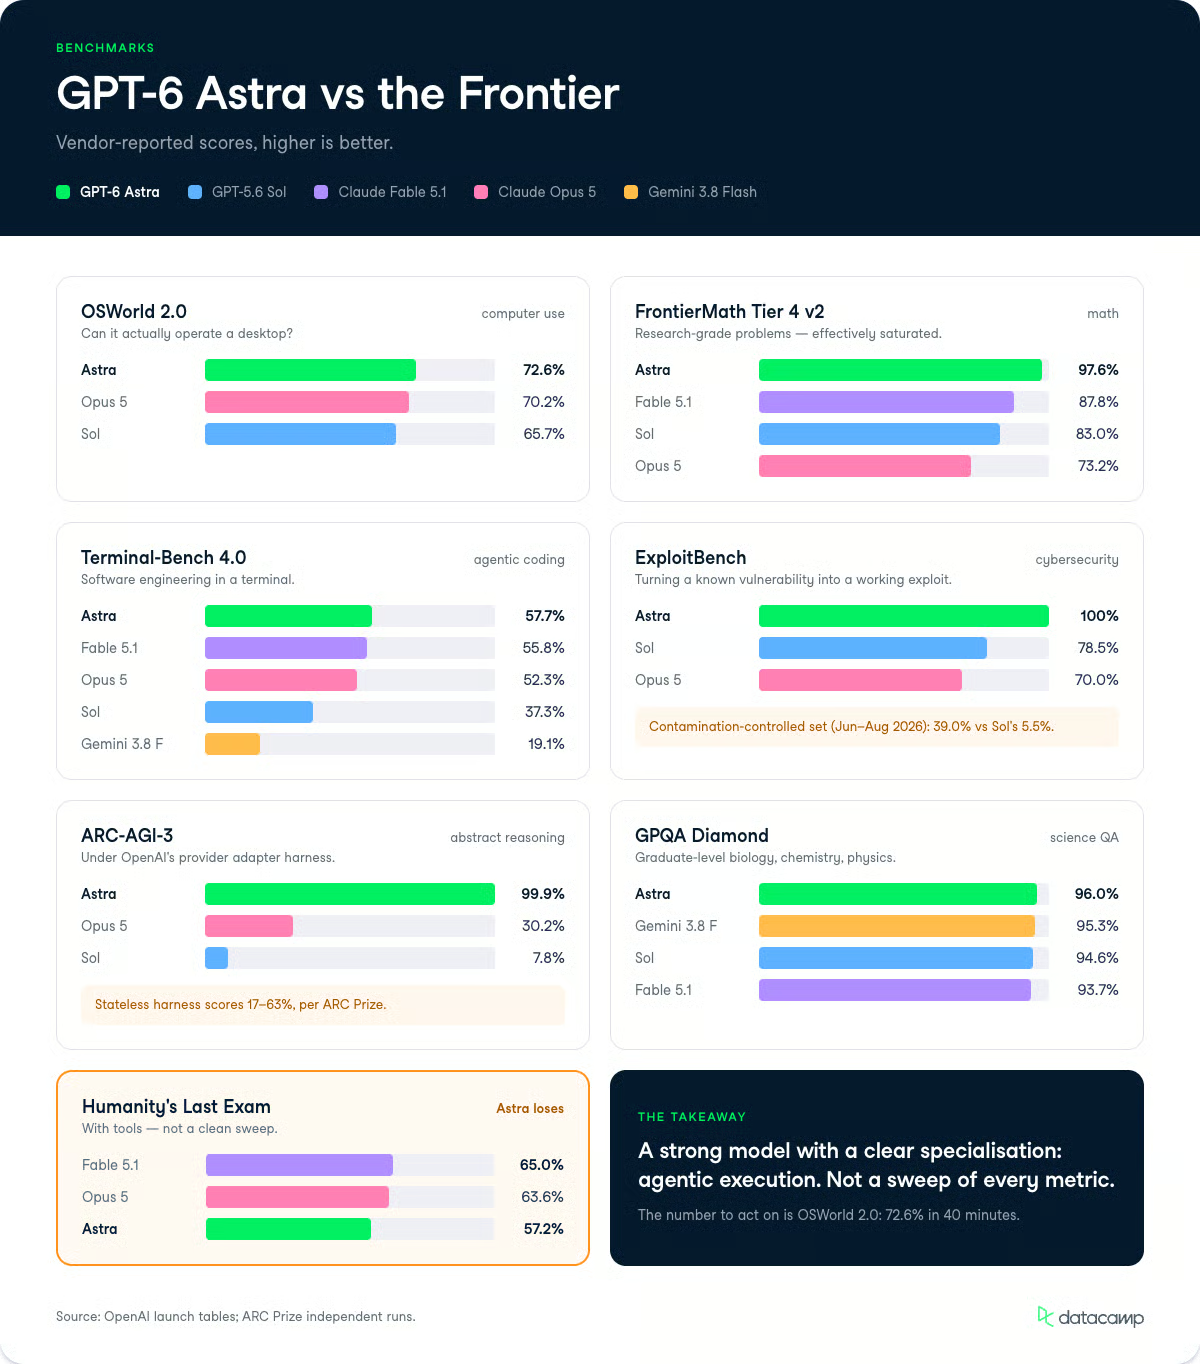
Astra obtient 72,6 % sur l'ensemble hors ligne d'OSWorld 2.0, contre 65,7 % pour GPT-5.6 Sol et 70,2 % pour Claude Opus 5.
OSWorld mesure si un agent peut réaliser de vraies tâches desktop comme naviguer dans des apps et manipuler des fichiers, c'est donc le meilleur proxy de « est-ce que ce modèle peut vraiment utiliser un ordinateur à ma place ».
Sur ScreenSpot-Pro, qui teste l'ancrage d'éléments d'UI à l'écran sans outils, Astra atteint 92,7 % contre 76,9 % pour GPT-5.6 Sol et 87,3 % pour Claude Fable 5.
Sur Agents' Last Exam, il atteint 59,3 %, devant les 55,5 % de Claude Opus 5 et les 53,6 % de GPT-5.6 Sol, tout en utilisant environ 65 % de tokens de sortie en moins qu'Opus 5.
Astra marque 97,6 % sur FrontierMath Tier 4 v2, le niveau le plus difficile d'un benchmark mathématique de recherche, contre 87,8 % pour Claude Fable 5.1 et Fable 5, et 73,2 % pour Claude Opus 5.
OpenAI parle de saturation ; vu le plafond, la lecture est cohérente.
Sur GPQA Diamond, un ensemble de questions de niveau master en biologie, chimie et physique, Astra atteint 96,0 % contre 95,3 % pour Gemini 3.8 Flash et 94,6 % pour GPT-5.6 Sol.
Il ne domine pas tous les indicateurs toutefois. Sur Humanity's Last Exam avec outils, Astra obtient 57,2 %, derrière les 65,0 % de Claude Fable 5.1 et les 63,6 % d'Opus 5 ; il ne rafle donc pas toutes les évaluations de raisonnement.
Sur Terminal-Bench 4.0, qui évalue des agents en génie logiciel, configuration système et analyse de données en terminal, Astra obtient 57,7 % contre 37,3 % pour GPT-5.6 Sol, 55,8 % pour Claude Fable 5.1 et 19,1 % pour Gemini 3.8 Flash.
C'est un large avantage sur Gemini Flash et un léger sur Fable 5.1.
Le tableau est plus serré ailleurs.
Sur FrontierCode 1.1 Main, Astra obtient 53,3 % contre 53,5 % pour Fable 5 et 53,4 % pour Opus 5, à quasi-égalité, et sur DeepSWE v1.1, il atteint 74,1 % contre 73,8 % pour Gemini 3.8 Flash et 69,9 % pour Fable 5.
Lorsque nous avons évalué GPT-5.6 Terra dans notre comparatif Terra vs Claude Sonnet 5, Terra affichait 87,4 % sur Terminal-Bench 2.1, une autre version ; les comparaisons interversions ne sont donc pas strictly comparables.
Astra marque 100 % sur ExploitBench contre 78,5 % pour GPT-5.6 Sol et 70 % pour Claude Opus 5, et 42,4 % sur ExploitGym contre 30,3 % pour Sol.
ExploitBench mesure la capacité à transformer une vulnérabilité connue en exploit fonctionnel ; un score parfait explique pourquoi OpenAI restreint cette capacité au lancement.
Sur la version d'ExploitBench contrôlée contre la contamination (juin-août 2026), bâtie à partir de vulnérabilités des trois mois précédents, Astra marque 39,0 % contre 5,5 % pour Sol.
Sur SRE-Bench, qui mesure la rétro-ingénierie de binaires sans code source, Astra résout 88,0 % en une tentative, contre 55,9 % pour Sol.
Le laboratoire indépendant Irregular a rapporté qu'Astra a résolu 86 défis sur 226 sur FrontierCyber, contre 34 pour Sol, incluant des zero-days dans des navigateurs et une base de données cloud.
Astra atteint 99,9 % sur ARC-AGI-3 avec l'adapter harness d'OpenAI, contre 7,8 % pour GPT-5.6 Sol et 30,2 % pour Claude Opus 5.
C'est le chiffre à lire avec précaution : des exécutions indépendantes de l'ARC Prize montrent que le harness standard sans état score plutôt entre ~17 % et 63 % selon le niveau de raisonnement, tandis que ~99,9 % requiert l'harness avec état et un run exhaustif coûtant des dizaines de milliers de dollars.
Sur le long contexte, Astra atteint 100 % sur OpenAI MRCR v2 8-needle dans la plage 256K-512K et 96,3 % dans la plage 512K-1M, contre 91,5 % et 73,8 % pour GPT-5.6 Sol.
Cette fiabilité de récupération à 1 million de tokens est un vrai progrès par rapport à Sol pour les pipelines riches en documents.
Astra affiche 2,4 % sur le benchmark interne de sécurité d'usage de l'ordinateur d'OpenAI (plus bas est mieux), contre 22,0 % pour GPT-5.6 Sol, 9,5 % pour Fable 5.1 et 11,5 % pour Opus 5.
En environnements de travail réalistes, son taux global de résultats non alignés sans politique de confirmation est de 3,4 %, contre 18,8 % pour Sol et 13,5 % pour GPT-5.6 Terra.
La seule régression signalée par OpenAI concerne la « monitorabilité » du chain-of-thought.
Astra produit un raisonnement plus court, moins verbeux, et contrôle bien mieux son CoT ; sur CoT-Control entre 750 et 1 250 tokens, il a respecté les contraintes 60,9 % du temps, contre 16,1 % pour Sol.
L'AISI britannique a constaté qu'Astra pouvait contourner la surveillance sous des prompts adversariaux, et OpenAI prend ce recul suffisamment au sérieux pour en faire une priorité de recherche.
Voici comment les scores rapportés d'Astra se positionnent face aux rivaux visés sur quelques benchmarks clés.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72,6 % | 65,7 % | - | 70,2 % | - |
| FrontierMath Tier 4 v2 | 97,6 % | 83,0 % | 87,8 % | 73,2 % | - |
| GPQA Diamond | 96,0 % | 94,6 % | 93,7 % | 93,7 % | 95,3 % |
| Terminal-Bench 4.0 | 57,7 % | 37,3 % | 55,8 % | 52,3 % | 19,1 % |
| ExploitBench | 100,0 % | 78,5 % | - | 70,0 % | - |
| ARC-AGI-3 (adapter harness) | 99,9 % | 7,8 % | - | 30,2 % | - |
GPT-6 Astra est d'abord déployé auprès d'un nombre limité d'organisations, puis auprès de tous les utilisateurs ChatGPT Plus, Pro, Business et Enterprise dans les prochains jours, ainsi que via l'API OpenAI et AWS.
Les administrateurs Enterprise peuvent l'activer par espace de travail, et il est désactivé par défaut au lancement. Les offres Pro, Business et Enterprise incluent aussi GPT-6 Astra Pro.
Pour les développeurs, le modèle est disponible sous gpt-6-astra dans l'API OpenAI et dans Amazon Bedrock.
La tarification API Standard est :
Pour situer, c'est nettement au-dessus des 2 $/12 $ de GPT-5.6 Terra évoqués précédemment, et au-dessus des 5 $/25 $ de Claude Opus 5.
Astra est tarifé comme un modèle de pointe pour le raisonnement et l'automatisation, pas comme un cheval de trait pour du texte en volume.
Il prend en charge la Zero Data Retention pour les clients API éligibles, et l'usage est inclus dans les forfaits d'abonnement existants avec option d'achat de crédits supplémentaires.
Tous mes fils sur les réseaux sociaux fourmillent d'exemples d'usages de GPT-6 Astra. Même si je n'ai pas encore pu le tester moi-même, plusieurs cas intrigants méritent d'être soulignés ici :
J'ai vu de nombreux posts où GPT-6 Astra est utilisé dans Blender pour créer des modèles 3D très détaillés et réalistes.
Dans le clip ci-dessous, l'utilisateur X Tom Krcha a donné à GPT-6 « une image d'une maison et demandé de la recréer en 3D avec tous les détails, y compris les jouets, appareils et meubles. Il s'agit d'une reconstruction 3D complète dans Blender avec une géométrie que vous pouvez ajuster manuellement et faire tourner à 60 ips comme un “jeu” rendu localement sur l'appareil. »
Meilleures formations DataCamp
Cours
Cours
Cursus
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
blog
Zoumana Keita
15 min
blog
Kurtis Pykes
15 min
Tutoriel