Curso
Introdução à IA no Trabalho
2 h
126.9K
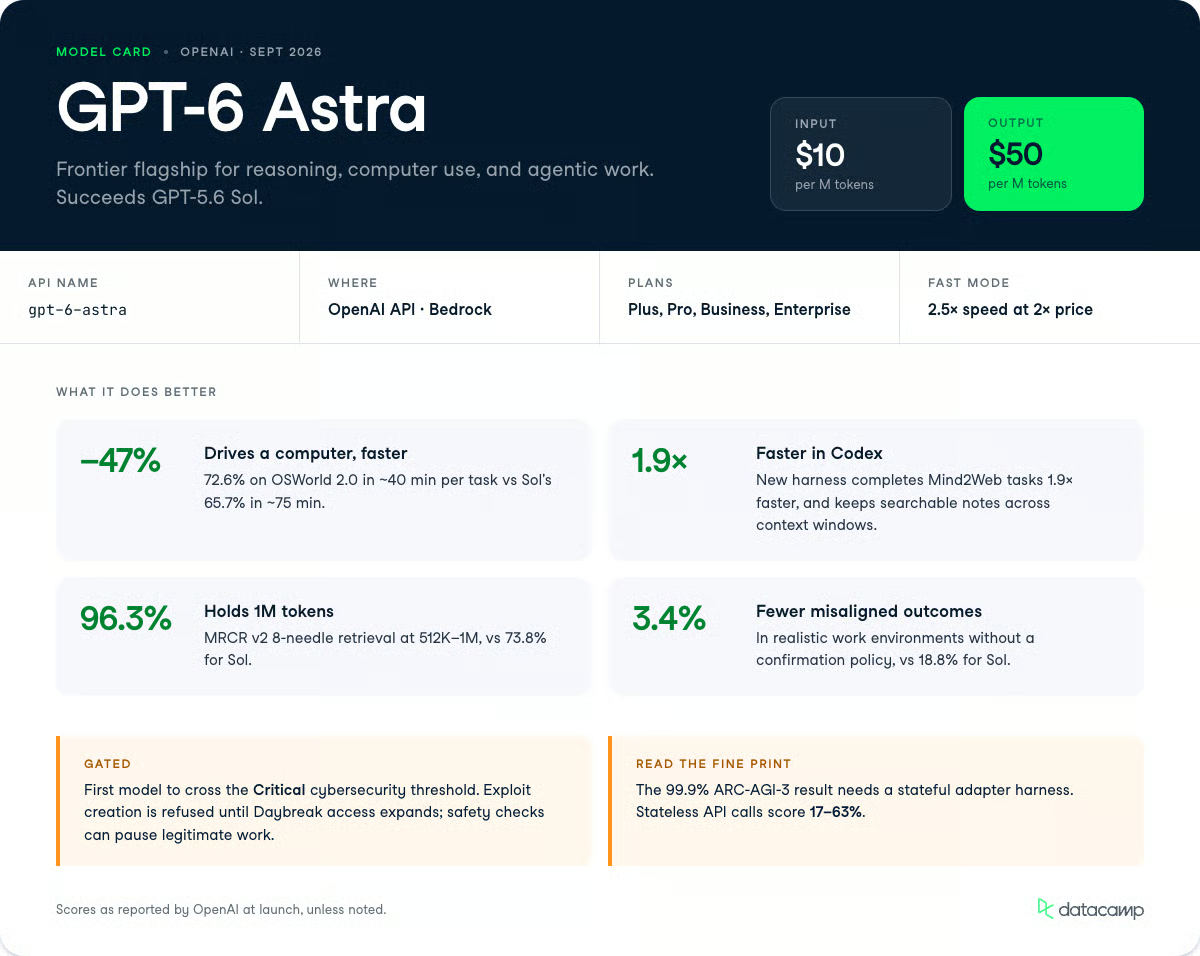
A OpenAI lançou o GPT-6 Astra, que a empresa chama de seu modelo mais inteligente e alinhado até agora.
O Astra chega a um patamar de fronteira já disputado, onde o Claude Fable 5.1 (lançado em 1º de setembro de 2026) e o Claude Opus 5, da Anthropic, são as referências para tarefas de código e agentes.
As promessas de destaque são ousadas.
O Astra "satura" o FrontierMath Tier 4 com 97,6%, o ARC-AGI-3 com 99,9% sob o provider adapter harness da OpenAI, e crava 100% no ExploitBench. Também estabelece uma nova fronteira em uso de computador e navegador, marcando 72,6% no OSWorld 2.0 e levando cerca de 47% menos tempo por tarefa do que seu antecessor, o GPT-5.6 Sol.
ARC-AGI-3 e FrontierMath Tier 4 foram projetados especificamente para se manterem à frente da evolução da IA; por isso, saturá-los sinaliza algo qualitativamente diferente de apenas liderar um ranking padrão.
Neste artigo, vou detalhar tudo que há de novo no GPT-6 Astra: os novos recursos, os benchmarks e alguns exemplos de uso.
Se quiser ver o modelo em ação, acompanhe nosso tutorial da API do GPT-6 Astra e confira alguns projetos com GPT-6 Astra para você testar. Para ver como ele se compara à concorrência, dê uma olhada na nossa comparação entre GPT-6 Astra e Claude Fable 5.1. Recomendo também nosso guia de como aprender Claude, nossa cobertura do novo Jev System One e a comparação entre Jev e GPT-6 Astra.
O GPT-6 Astra é o novo modelo de fronteira da OpenAI, que sucede o GPT-5.6 Sol como o topo para raciocínio, uso de computador e trabalho com agentes.
A OpenAI o posiciona em três frentes:
Para quem pratica no dia a dia, o benchmark mais útil é o OSWorld 2.0, onde o Astra marca 72,6% em cerca de 40 minutos por tarefa, contra 65,7% do GPT-5.6 Sol em aproximadamente 75 minutos.
Essa combinação de maior acurácia e menor tempo de execução é a diferença entre um agente que você precisa vigiar e outro a quem você pode delegar a tarefa.
O Astra chega junto com um harness atualizado do Codex que, segundo a OpenAI, entrega 1,9x mais rapidez na conclusão de tarefas em relação à experiência atual do GPT-5.6 Sol no benchmark Mind2Web.
Ele está disponível como gpt-6-astra na API da OpenAI e via Amazon Bedrock, com um nível GPT-6 Astra Pro para planos Pro, Business e Enterprise.
Se você também se interessa pelos modelos mais acessíveis da OpenAI, confira nosso guia do GPT-6 Sol e Luna.
As mudanças do Astra se concentram na execução por agentes: usar um computador, produzir artefatos profissionais prontos, manter contexto em longas sessões de código e operar dentro de limites autorizados.
Aqui vão os recursos que mais se destacam.
O Astra consegue operar um computador diretamente, lidando com aquele trabalho repetitivo e de múltiplas etapas que costuma consumir a tarde inteira.
Alguns bons exemplos incluem:
Em simulações de latência no OSWorld 2.0, o Astra atinge 72,6% em cerca de 40 minutos por tarefa, contra 65,7% do GPT-5.6 Sol em aproximadamente 75 minutos — um corte de 47% no tempo por tarefa.
O OSWorld 2.0 mede se um modelo consegue de fato operar um computador, navegando por interfaces reais, clicando, digitando e concluindo tarefas de múltiplas etapas como um humano faria.
O corte de 47% no tempo por tarefa é tão importante quanto o ganho de acurácia porque o custo do agente escala com o tempo de relógio; um modelo que termina em 40 minutos em vez de 75 não é só mais rápido — ele custa aproximadamente metade para rodar a mesma carga.
Dito isso, testes independentes do ARC Prize mostram que os números de destaque do Astra em uso de computador e raciocínio são altamente dependentes do harness.
No ARC-AGI-3, o harness padrão sem estado produziu notas entre ~17% e 63% dependendo do nível de raciocínio, enquanto o provider adapter harness, que preserva o estado, chegou aos ~99,9% divulgados.
Se você chamar o modelo sem estado, espere números menores do que os dos gráficos de lançamento.
O Astra foi treinado para gerar artefatos profissionais polidos que seguem seus templates, em vez de rascunhos genéricos.
Ele cria documentos, apresentações, planilhas e análises que combinam com seu estilo de escrita e visual, puxando apenas o contexto que importa para a saída — sem encher linguiça com tudo que sabe.
No demo da própria OpenAI, o Astra monta um slide deck sobre um modelo fictício a partir de alguns slides de template, mantendo o tom e o layout consistentes do começo ao fim.
Para quem já passou uma hora retrabalhando um dump de markdown de um LLM para caber no template da empresa, essa aderência ao template é o primeiro ponto que eu testaria.
Com Sites no ChatGPT, o Astra pode criar, hospedar e compartilhar sites, web apps e jogos direto de um prompt, aplicando um julgamento visual mais forte que os modelos anteriores.
O Astra decide quando te perguntar algo e quando seguir com suposições razoáveis.
Quando as instruções deixam margem para interpretação, ele preenche lacunas rotineiras por conta própria e só faz perguntas objetivas quando a resposta pode mudar o resultado.
No comparativo da OpenAI, o GPT-5.6 Sol construiu um site pessoal de carreira de forma autônoma em 13 minutos e 15 segundos, enquanto o Astra pausou após 20 segundos para perguntar para qual carreira o usuário estava migrando.
No Codex, o Astra pode perguntar de forma assíncrona, continuando o que não depende da sua resposta e aguardando apenas decisões consequentes.
O Astra também mantém o rumo conforme a tarefa muda.
Modelos anteriores às vezes tratavam uma mensagem de ajuste no meio do caminho como um novo objetivo e perdiam as restrições originais; o Astra incorpora novos requisitos e responde a perguntas laterais sem largar o job principal.
O GPT-6 Astra introduz uma nova forma de o Codex preservar e recuperar contexto quando a janela enche, trocando resumos repetidos por notas pesquisáveis.
Historicamente, os modelos usam compactação para comprimir longas sessões de depuração ou grandes refatorações em um único resumo, o que pode apagar detalhes sobre por que uma correção falhou ou como um componente se comporta.
Com o Astra, o Codex mantém notas entre janelas e deixa as janelas anteriores pesquisáveis, de modo que consegue achar um requisito ou resultado de teste de uma mensagem antiga mesmo se a nota não o tiver capturado.
Você ativa esse recurso experimental no seu config.toml do Codex, e a OpenAI diz que ele se tornará o padrão do Astra nas próximas semanas.
O Astra atinge o limiar Critical em cibersegurança segundo o Preparedness Framework da OpenAI — seu avanço mais forte e também o mais restrito.
No lançamento, ele ajuda com revisão de código seguro e aplicação de patches, mas recusa tarefas mais avançadas como criar exploits de prova de conceito.
A OpenAI planeja ampliar o acesso via programa Daybreak, com salvaguardas menos restritivas, habilitando validação de vulnerabilidades e POCs, análise de malware e engenharia de detecção.
Por conta do risco elevado, checagens extras de segurança podem pausar ou interromper trabalho legítimo: no ChatGPT ou no Codex você pode ser convidado a revisar uma ação e, na API, a tarefa pode ser interrompida.
Nos testes reportados pela OpenAI, o Astra estabelece novas marcas em uso de computador, matemática, código e cibersegurança — muitas vezes usando menos tokens de saída do que o GPT-5.6 Sol ou os modelos Claude.
As notas abaixo vêm das tabelas de lançamento da OpenAI; considere-as como reportadas pelo fornecedor e observe as ressalvas de harness onde aplicável.
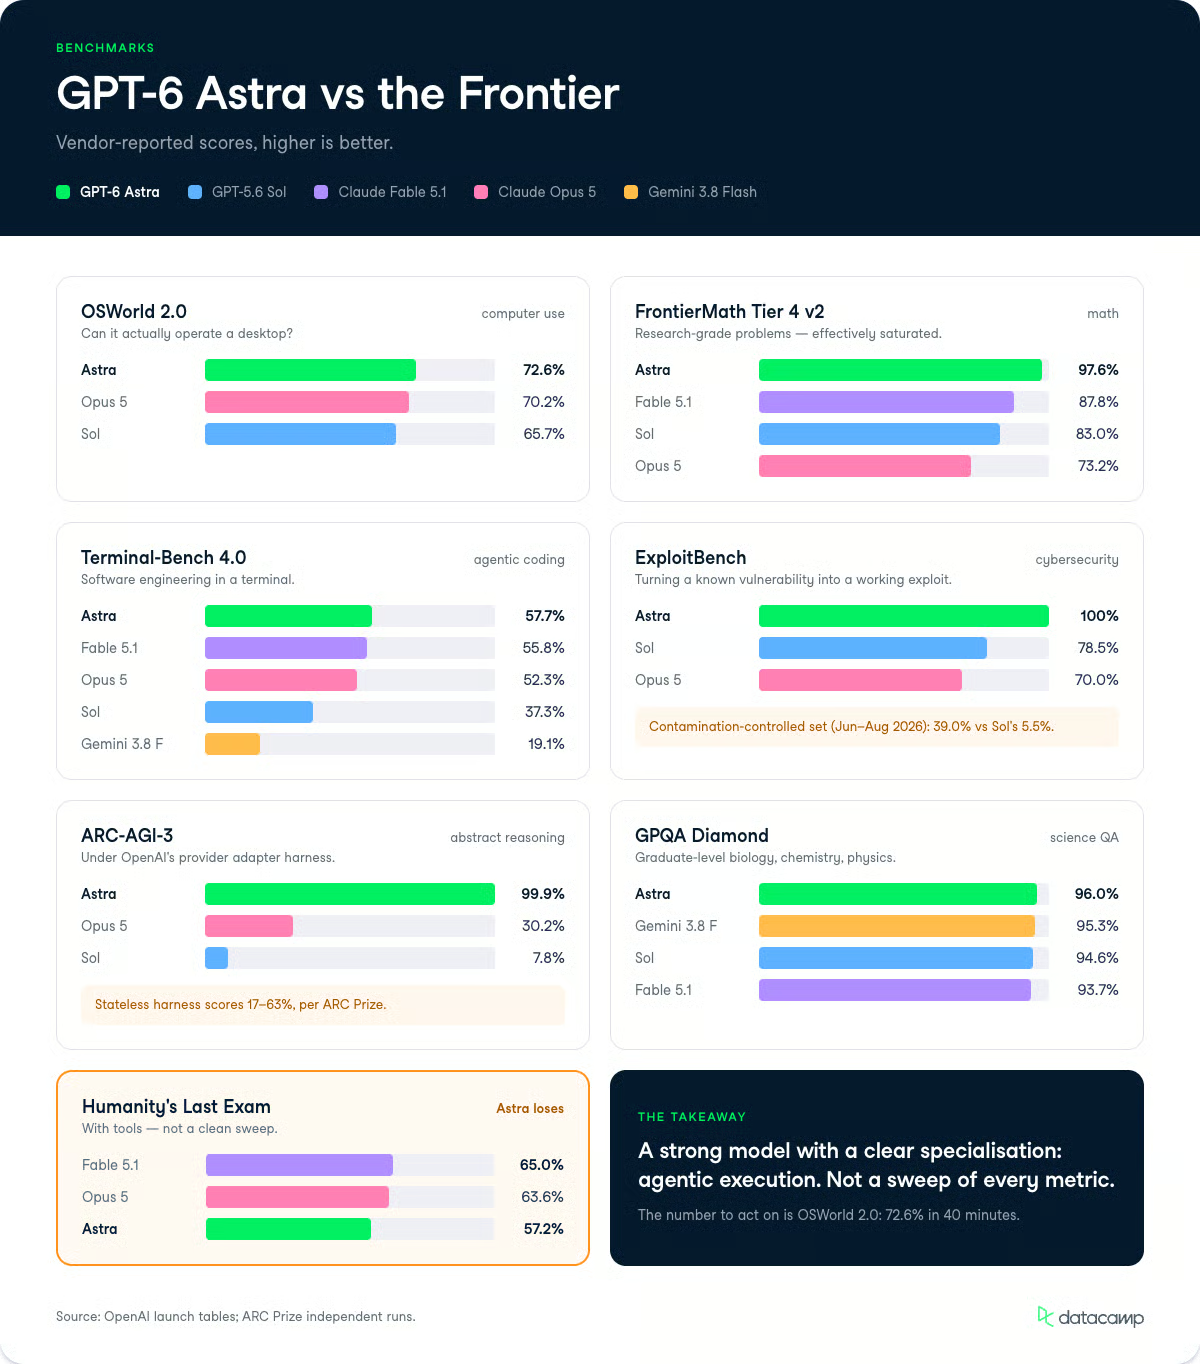
O Astra marca 72,6% no conjunto offline do OSWorld 2.0, contra 65,7% do GPT-5.6 Sol e 70,2% do Claude Opus 5.
O OSWorld mede se um agente completa tarefas reais de desktop, como navegar em apps e manipular arquivos — é o melhor proxy para "isso realmente usa um computador por mim".
No ScreenSpot-Pro, que testa a ancoragem de elementos de UI na tela sem ferramentas, o Astra atinge 92,7% contra 76,9% do GPT-5.6 Sol e 87,3% do Claude Fable 5.
No Agents' Last Exam, chega a 59,3%, à frente dos 55,5% do Claude Opus 5 e 53,6% do GPT-5.6 Sol, usando cerca de 65% menos tokens de saída que o Opus 5.
O Astra marca 97,6% no FrontierMath Tier 4 v2, o nível mais difícil de um benchmark de matemática de pesquisa, contra 87,8% do Claude Fable 5.1 e do Fable 5, e 73,2% do Claude Opus 5.
A OpenAI descreve isso como saturação — e, dado o teto, é uma leitura justa.
No GPQA Diamond, um conjunto de questões de nível de pós-graduação em biologia, química e física, o Astra chega a 96,0% contra 95,3% do Gemini 3.8 Flash e 94,6% do GPT-5.6 Sol.
Nem todos os métricos são liderados por ele. No Humanity's Last Exam com ferramentas, o Astra marca 57,2%, atrás dos 65,0% do Claude Fable 5.1 e 63,6% do Opus 5; não varre todas as avaliações de raciocínio.
No Terminal-Bench 4.0, que testa agentes em engenharia de software, configuração de sistemas e análise de dados no terminal, o Astra marca 57,7% contra 37,3% do GPT-5.6 Sol, 55,8% do Claude Fable 5.1 e 19,1% do Gemini 3.8 Flash.
É uma vantagem ampla sobre o Gemini Flash e moderada sobre o Fable 5.1.
No restante, o quadro de código é mais equilibrado.
No FrontierCode 1.1 Main, o Astra marca 53,3% contra 53,5% do Fable 5 e 53,4% do Opus 5 — praticamente um empate — e no DeepSWE v1.1 chega a 74,1% contra 73,8% do Gemini 3.8 Flash e 69,9% do Fable 5.
Quando analisamos o GPT-5.6 Terra na comparação Terra vs Claude Sonnet 5, o Terra fez 87,4% no Terminal-Bench 2.1, uma versão diferente; então, comparações entre versões não são equivalentes.
O Astra crava 100% no ExploitBench, contra 78,5% do GPT-5.6 Sol e 70% do Claude Opus 5, e 42,4% no ExploitGym, frente a 30,3% do Sol.
O ExploitBench mede se um modelo consegue transformar uma vulnerabilidade conhecida em um exploit funcional — um placar perfeito é justamente o motivo para a OpenAI limitar essa capacidade no lançamento.
No ExploitBench com controle de contaminação (junho–agosto de 2026), construído a partir de vulnerabilidades dos três meses anteriores, o Astra marca 39,0% contra 5,5% do Sol.
No SRE-Bench, que mede engenharia reversa de binários sem acesso ao código-fonte, o Astra resolve 88,0% em uma tentativa, contra 55,9% do Sol.
O laboratório independente Irregular reportou que o Astra resolveu 86 de 226 desafios do FrontierCyber, contra 34 do Sol, incluindo descobertas de zero-day em navegadores e um banco de dados em nuvem.
O Astra marca 99,9% no ARC-AGI-3 sob o provider adapter harness da OpenAI, contra 7,8% do GPT-5.6 Sol e 30,2% do Claude Opus 5.
Este é o número para ler com cuidado: as execuções independentes do ARC Prize mostram o harness padrão sem estado marcando de ~17% a 63% dependendo do nível de raciocínio, enquanto os ~99,9% exigem o adapter com estado e uma execução completa que pode custar dezenas de milhares de dólares.
Em longo contexto, o Astra atinge 100% no OpenAI MRCR v2 8-needle na faixa de 256K–512K e 96,3% na faixa de 512K–1M, contra 91,5% e 73,8% do GPT-5.6 Sol.
Essa confiabilidade de recuperação em 1M tokens é um salto real sobre o Sol para pipelines pesados em documentos.
O Astra registra 2,4% no benchmark interno da OpenAI de segurança em uso de computador (quanto menor, melhor), contra 22,0% do GPT-5.6 Sol, 9,5% do Fable 5.1 e 11,5% do Opus 5.
Em ambientes de trabalho realistas, sua taxa geral de resultados desalinhados sem política de confirmação é de 3,4%, contra 18,8% do Sol e 13,5% do GPT-5.6 Terra.
A regressão que a OpenAI sinaliza fica na monitorabilidade do chain-of-thought.
O Astra produz raciocínios mais curtos e menos verborrágicos e controla o CoT muito melhor do que o Sol; no CoT-Control entre 750 e 1.250 tokens, seguiu as restrições em 60,9% dos casos, contra 16,1% do Sol.
O UK AISI constatou que o Astra pode driblar monitoramento sob prompts adversariais, e a OpenAI leva a queda a sério o suficiente para tratá-la como prioridade de pesquisa.
Veja como as notas reportadas do Astra se alinham com os rivais a que ele mira em alguns benchmarks-chave.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72,6% | 65,7% | - | 70,2% | - |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | 73,2% | - |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 93,7% | 95,3% |
| Terminal-Bench 4.0 | 57,7% | 37,3% | 55,8% | 52,3% | 19,1% |
| ExploitBench | 100,0% | 78,5% | - | 70,0% | - |
| ARC-AGI-3 (adapter harness) | 99,9% | 7,8% | - | 30,2% | - |
O GPT-6 Astra está sendo liberado primeiro para um conjunto limitado de organizações e, nos próximos dias, para todos os usuários do ChatGPT Plus, Pro, Business e Enterprise, além da API da OpenAI e da AWS.
Admins do Enterprise podem habilitá-lo por workspace, e ele vem desativado por padrão no lançamento. Planos Pro, Business e Enterprise também recebem o GPT-6 Astra Pro.
Para desenvolvedores, o modelo está disponível como gpt-6-astra na API da OpenAI e no Amazon Bedrock.
Os preços padrão da API são:
Para contextualizar, isso fica bem acima das tarifas de $2/$12 do GPT-5.6 Terra que já cobrimos, e acima dos $5/$25 do Claude Opus 5.
O Astra é precificado como um modelo de fronteira para raciocínio e automação — não como um cavalo de batalha para texto em massa.
Ele oferece Zero Data Retention para clientes elegíveis da API, e o uso está incluso nas franquias das assinaturas existentes, com opção de comprar créditos adicionais.
Minhas redes sociais estão cheias de exemplos de usos do GPT-6 Astra. Embora eu ainda não tenha colocado as mãos nele, há casos interessantes que valem destaque:
Vi muitos posts de gente usando o GPT-6 Astra no Blender para criar modelos 3D altamente detalhados e realistas.
No clipe abaixo, o usuário do X, Tom Krcha, deu ao GPT-6 "uma imagem de uma casa e pediu para criá-la em 3D com todos os detalhes, incluindo brinquedos, eletrodomésticos e móveis. É uma reconstrução 3D completa no Blender, com geometria que você pode ajustar manualmente e rodar a 60fps como um 'jogo' renderizado localmente no dispositivo."
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
blog
Nisha Arya Ahmed
10 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Moez Ali
11 min