
कोर्स
इंटरमीडिएट SQL
4 घंटा
527.3K
यदि आप असंगत, दोहराए हुए डेटा से हमेशा के लिए छुटकारा चाहते हैं, तो डेटाबेस नॉर्मलाइज़ेशन सही रास्ता है।
आप उस झुंझलाहट को जानते हैं जब एक तालिका में ग्राहक जानकारी अपडेट करते हैं और पाते हैं कि पुराना संस्करण पाँच अन्य तालिकाओं में फैला हुआ है। आपकी क्वेरीज़ परस्पर-विरोधी परिणाम देती हैं, आपकी रिपोर्टें इस पर निर्भर अलग-अलग संख्या दिखाती हैं कि किस तालिका से डेटा लिया गया है, और आप उन डेटा अखंडता समस्याओं को डिबग करने में घंटे बिता देते हैं जो होनी ही नहीं चाहिए थीं। जैसे-जैसे आपका डेटाबेस बढ़ता है, ये समस्याएँ बढ़ती जाती हैं।
डेटाबेस नॉर्मलाइज़ेशन इन समस्याओं को सिद्ध गणितीय सिद्धांतों के अनुसार डेटा व्यवस्थित करके समाप्त कर देता है। यह प्रक्रिया नॉर्मल फ़ॉर्म्स का उपयोग करती है ताकि हर जानकारी एक ही स्थान पर मौजूद हो—जिससे आपका डेटाबेस भरोसेमंद और कुशल बनता है।
मैं आपको संपूर्ण नॉर्मलाइज़ेशन प्रक्रिया दिखाऊँगा—बुनियादी अवधारणाओं से लेकर उन्नत नॉर्मल फ़ॉर्म्स तक—ऐसे हाथों-हाथ उदाहरणों के साथ जो बिखरे हुए डेटा को साफ़, अनुरक्षणीय डेटाबेस संरचनाओं में बदल देते हैं।
नॉर्मलाइज़ेशन ही वह चीज़ है जो आपके डेटाबेस को रखरखाव के डरावने सपने में बदलने से बचाती है। आइए देखें कि वास्तविक दुनिया के अनुप्रयोगों के लिए सही नॉर्मलाइज़ेशन क्यों मायने रखता है।
पुनरावृत्ति डेटाबेस प्रदर्शन की मूक हत्यारी है। जब आप एक ही जानकारी को कई जगह सहेजते हैं, तो आप केवल स्टोरेज नहीं बर्बाद कर रहे—आप असंगतियों के लिए मंच तैयार कर रहे हैं जो आपकी एप्लिकेशन लॉजिक को तोड़ देती हैं।
नॉर्मलाइज़ेशन के बिना, किसी ग्राहक का पता अपडेट करना मतलब हर उस तालिका की खोज करना जो पता डेटा सहेजती है। यदि एक भी छूट गया, तो आपकी रिपोर्टें परस्पर-विरोधी जानकारी दिखाएँगी। आपके उपयोगकर्ता अलग-अलग स्क्रीन पर अलग पते देखेंगे। आपका एनालिटिक्स अविश्वसनीय हो जाएगा।
नॉर्मलाइज़ेशन इसे ठीक करता है यह सुनिश्चित करके कि हर डेटा केवल एक ही जगह रहता है। जब आप उस ग्राहक का पता अपडेट करते हैं, तो वह हर जगह अपने-आप बदल जाता है क्योंकि सब एक ही स्रोत को संदर्भित करते हैं।
सही नॉर्मलाइज़ेशन के साथ अखंडता अभेद्य हो जाती है। फॉरेन की कॉन्स्ट्रेंट्स अनाथ रिकॉर्ड्स को रोकते हैं। आप गलती से किसी ऐसे ग्राहक को नहीं हटा सकते जिसके सक्रिय ऑर्डर अभी भी हैं। आपका डेटाबेस व्यापार नियमों को डेटा स्तर पर लागू करता है, केवल एप्लिकेशन कोड में नहीं।
इसका मतलब कम बग्स, स्वच्छ कोड, और ऐसी एप्लिकेशन जो तब भी पूर्वानुमेय ढंग से काम करें जब कई सिस्टम एक ही डेटा तक पहुँचें।
उचित नॉर्मलाइज़ेशन के साथ संशोधन संबंधी ऐनोमलीज़ गायब हो जाती हैं। ये तब होती हैं जब आप डेटा इन्सर्ट, अपडेट, या डिलीट करते हैं और असंगतियाँ पैदा करते हैं या जटिल वर्कअराउंड्स की आवश्यकता होती है।
इन्सर्ट ऐनोमलीज़ आपको केवल एक रिकॉर्ड बनाने के लिए डमी डेटा जोड़ने पर मजबूर करती हैं। अपडेट ऐनोमलीज़ आपको वही जानकारी कई पंक्तियों में बदलने की आवश्यकता होती है। डिलीट ऐनोमलीज़ एक रिकॉर्ड हटाते समय इच्छित से अधिक जानकारी हटा देती हैं।
नॉर्मलाइज़्ड डेटाबेस इन समस्याओं को डेटा को इस तरह व्यवस्थित करके समाप्त कर देते हैं कि हर तथ्य एक ही बार और केवल एक ही बार दिखाई दे।
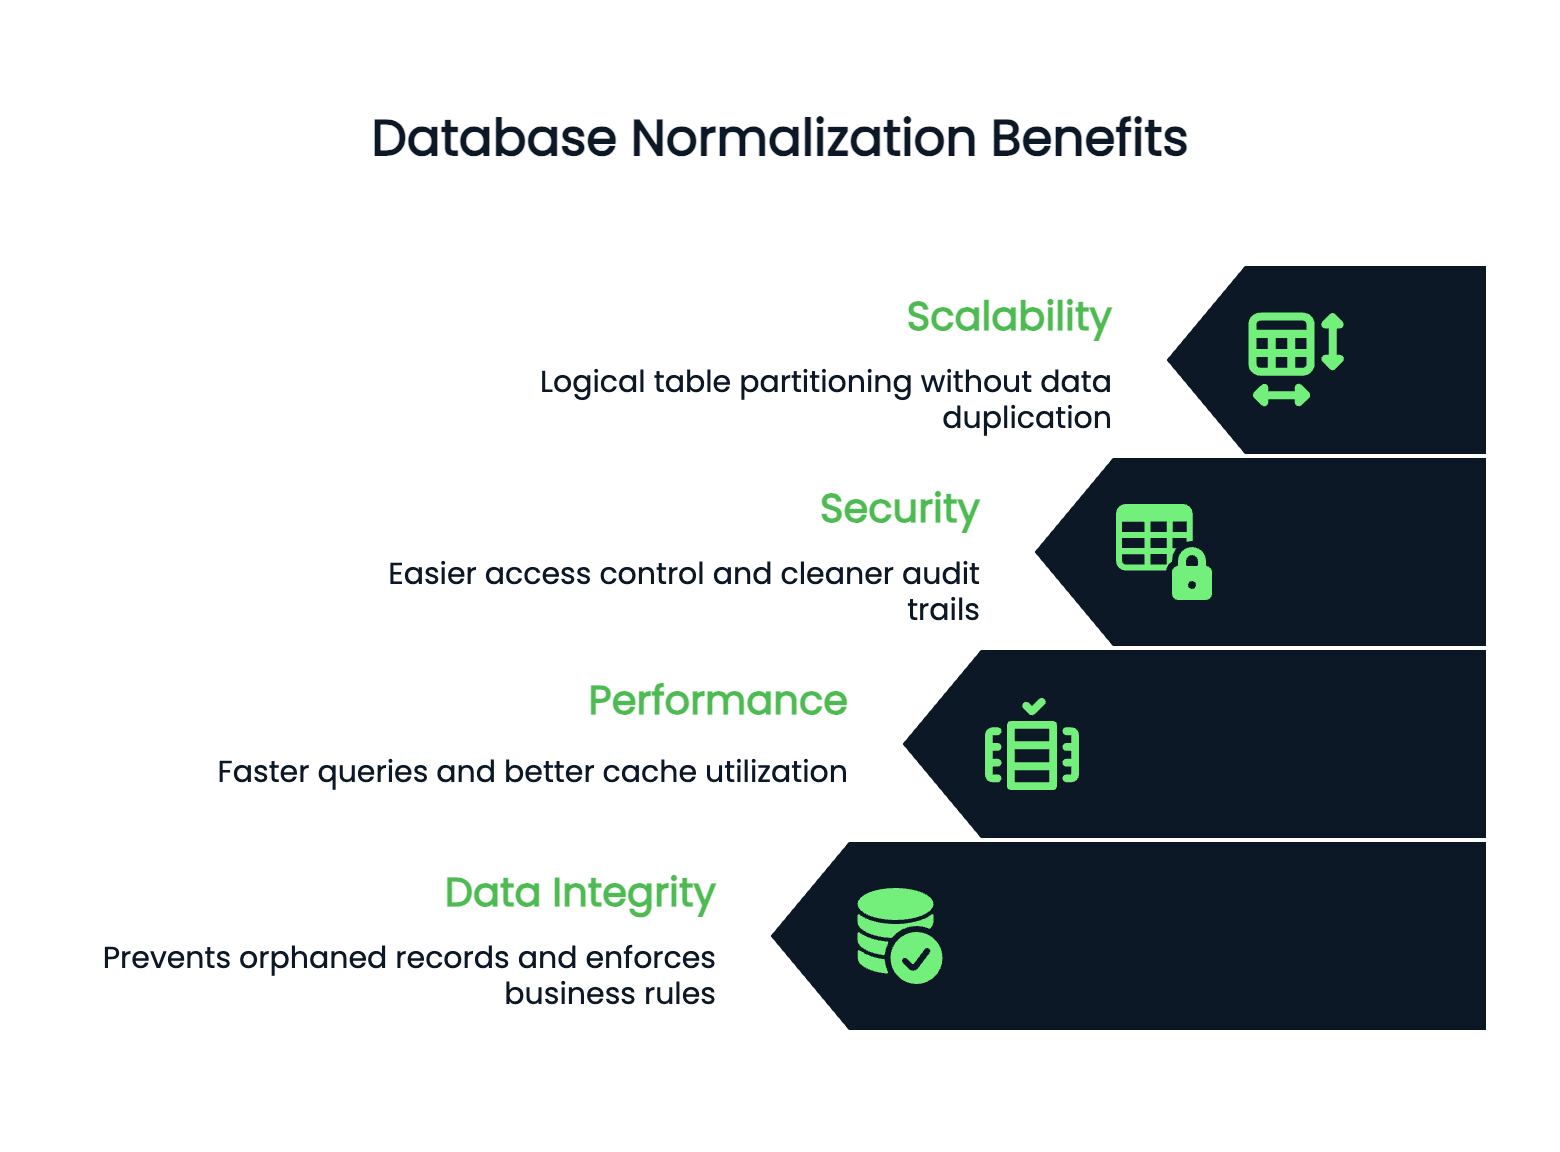
जब आपकी डेटाबेस संरचना साफ़-सुथरी होती है तो प्रदर्शन और स्केलेबिलिटी बेहतर होती है। नॉर्मलाइज़्ड तालिकाएँ आम तौर पर छोटी होती हैं, जिसका मतलब है तेज़ क्वेरीज़ और बेहतर कैश उपयोग। छोटे, फोकस्ड टेबल्स पर इंडेक्स अधिक प्रभावी ढंग से काम करते हैं।
आपका डेटाबेस क्षैतिज रूप से स्केल कर सकता है क्योंकि नॉर्मलाइज़्ड डेटा की स्पष्ट सीमाएँ होती हैं। आप जानकारी को शार्ड्स में डुप्लिकेट किए बिना तालिकाओं का तार्किक विभाजन कर सकते हैं।
नॉर्मलाइज़्ड डेटाबेस में सुरक्षा प्रबंधन आसान हो जाता है। आप भरोसे के साथ टेबल-लेवल एक्सेस नियंत्रित कर सकते हैं क्योंकि संवेदनशील डेटा विशिष्ट, स्पष्ट परिभाषित स्थानों में रहता है। अप्रत्याशित तालिकाओं में छिपे ग्राहक क्रेडिट कार्ड नंबरों की चिंता करने की ज़रूरत नहीं।
ऑडिट ट्रेल भी अधिक साफ़ होते हैं—आपको ठीक-ठीक पता होता है कि बदलाव कहाँ हुए और आप उन्हें ट्रैक कर सकते हैं, बिना अपने स्कीमा में बिखरे पुनरावृत्त डेटा की खाक छाने।
संक्षेप में, नॉर्मलाइज़ेशन अराजक डेटा को एक भरोसेमंद नींव में बदल देता है जो आपकी एप्लिकेशन के साथ बढ़ती है।
आइए आगे देखें कि नॉर्मलाइज़ेशन के लिए पूर्वापेक्षाएँ क्या हैं।
तालिकाएँ नॉर्मलाइज़ करने से पहले, आपको समझना होगा कि नॉर्मलाइज़ेशन को प्रभावी क्या बनाता है। आइए उन आवश्यक अवधारणाओं को कवर करें जो पूरी प्रक्रिया में आपके निर्णयों का मार्गदर्शन करेंगी।
कीज़ रिलेशनल डेटाबेस डिज़ाइन की नींव हैं—वे रिकॉर्ड्स की पहचान करती हैं और तालिकाओं को आपस में जोड़ती हैं।
एक प्राइमरी की तालिका की हर पंक्ति की विशिष्ट पहचान करती है। दो पंक्तियों में एक जैसी प्राइमरी की वैल्यू नहीं हो सकती, और यह null नहीं हो सकती। इसे अपने डेटा के लिए सामाजिक सुरक्षा नंबर जैसा समझें—हर रिकॉर्ड को ठीक एक मिलता है, और कोई डुप्लीकेट नहीं होता।
CREATE TABLE customers (
    customer_id INT PRIMARY KEY,
    email VARCHAR(255),
    name VARCHAR(100)
);
यहाँ customer_id प्राइमरी की है। हर ग्राहक को एक यूनिक ID मिलती है जिसका उपयोग आप अन्य तालिकाओं से उसी ग्राहक को संदर्भित करने के लिए करेंगे।
किसी भी कॉलम (या कॉलमों के संयोजन) को जो प्राइमरी की के रूप में काम कर सकता है, कैंडिडेट की कहते हैं। आपकी customers तालिका में customer_id और email दोनों कैंडिडेट की हो सकते हैं, क्योंकि दोनों ग्राहक की विशिष्ट पहचान करते हैं। आप इनमें से एक को प्राइमरी की चुनते हैं, और बाकी कैंडिडेट की बने रहते हैं।
फॉरेन कीज़ तालिकाओं के बीच संबंध बनाती हैं। वे दूसरी तालिका की प्राइमरी की को संदर्भित करती हैं और ऐसे कनेक्शन स्थापित करती हैं जो डेटा अखंडता बनाए रखते हैं।
CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    customer_id INT,
    order_date DATE,
    FOREIGN KEY (customer_id) REFERENCES customers(customer_id)
);
orders तालिका में customer_id एक फॉरेन की है। यह customers तालिका में मौजूद किसी customer_id से मेल खाना चाहिए। यह अनाथ ऑर्डर को रोकता है और सुनिश्चित करता है कि हर ऑर्डर किसी वास्तविक ग्राहक से संबंधित हो।
कीज़ व्यापार नियमों को डेटाबेस स्तर पर लागू करती हैं, जिससे आपका डेटा केवल एप्लिकेशन-स्तरीय वैलिडेशन की तुलना में अधिक भरोसेमंद बनता है।
फंक्शनल डिपेंडेंसीज़ बताती हैं कि एक तालिका में कॉलम एक-दूसरे से कैसे संबंधित हैं। यही गणितीय आधार है जो नॉर्मलाइज़ेशन के निर्णयों को संचालित करता है।
एक फंक्शनल डिपेंडेंसी तब मौजूद होती है जब एक कॉलम का मान दूसरे कॉलम के मान को निर्धारित करता है। हम इसे A → B के रूप में लिखते हैं, जिसका अर्थ है "A B को निर्धारित करता है" या "B A पर निर्भर है"।
एक customers तालिका में, customer_id → email होता है क्योंकि हर ग्राहक ID ठीक एक ईमेल पते से मैप होती है। यदि आपको ग्राहक ID पता है, तो आप निश्चित रूप से ईमेल निर्धारित कर सकते हैं।
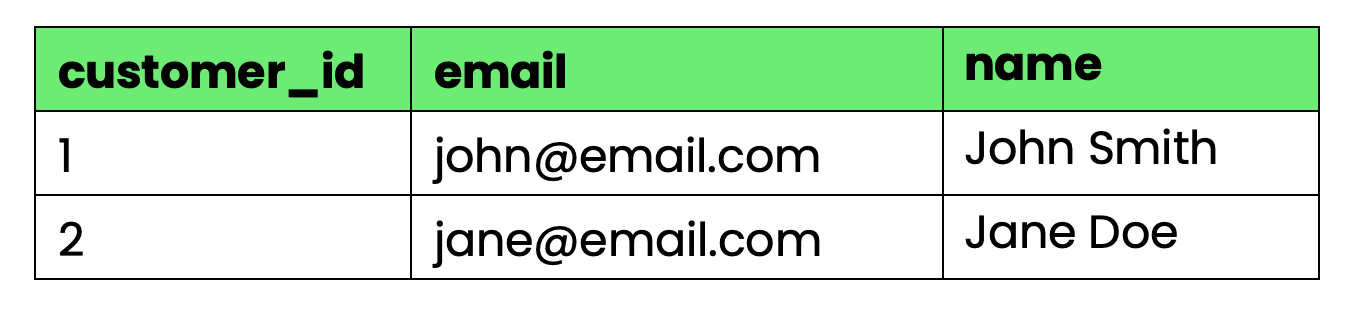
छवि 1 - फंक्शनल डिपेंडेंसी उदाहरण
यहाँ customer_id → email और customer_id → name हैं क्योंकि ग्राहक ID ईमेल और नाम दोनों को निर्धारित करती है।
फंक्शनल डिपेंडेंसीज़ पुनरावृत्ति की समस्याएँ उजागर करती हैं।
यदि आपके पास ऐसी तालिका है जहाँ order_id → customer_name है, लेकिन आप हर ऑर्डर पंक्ति में ग्राहक का नाम सहेज रहे हैं, तो आपके पास पुनरावृत्ति है। ग्राहक का नाम उनके ID पर निर्भर करता है, न कि ऑर्डर ID पर।
डिपेंडेंसी प्रिज़र्वेशन का मतलब है कि आपकी नॉर्मलाइज़्ड तालिकाएँ मूल फंक्शनल डिपेंडेंसीज़ को बनाए रखती हैं। नॉर्मलाइज़ेशन के दौरान जब आप किसी तालिका को विभाजित करते हैं, तो आपको मूल तालिका के व्यापार नियम लागू करने की क्षमता नहीं खोनी चाहिए।
लॉसलैस डीकंपोज़िशन यह सुनिश्चित करता है कि आप नॉर्मलाइज़्ड तालिकाओं को जोड़कर मूल तालिका का पुनर्निर्माण कर सकते हैं। जब आप तालिकाएँ विभाजित करते हैं तो कोई जानकारी नहीं खोती—जॉइन्स बिल्कुल वही डेटा वापस लाते हैं जिससे आपने शुरुआत की थी।
ये अवधारणाएँ साथ काम करती हैं: फंक्शनल डिपेंडेंसीज़ बताती हैं कि क्या अलग करना आवश्यक है, जबकि डिपेंडेंसी प्रिज़र्वेशन और लॉसलैस डीकंपोज़िशन यह सुनिश्चित करते हैं कि प्रक्रिया में कुछ भी न टूटे।
इन संबंधों को समझकर आप समझदारी से नॉर्मलाइज़ेशन के निर्णय ले पाते हैं जो कार्यक्षमता खोए बिना आपके डेटाबेस को बेहतर बनाते हैं।
अब आइए वास्तविक नॉर्मलाइज़ेशन प्रक्रिया से गुजरते हैं—गंदे डेटा से शुरू करके उसे चरण-दर-चरण बदलते हुए। हर नॉर्मल फ़ॉर्म पिछले पर आधारित होता है, इसलिए आप बिना नॉर्मलाइज़्ड डेटा से सीधे 3NF पर नहीं जा सकते।
पहला नॉर्मल फ़ॉर्म दोहराए हुए समूहों को हटाता है और सुनिश्चित करता है कि हर कॉलम में एटॉमिक मान हों। इसके बारे में और जानें First Normal Form (1NF) इन-डेप्थ गाइड में।
एटॉमिक मानों का अर्थ है कि प्रत्येक सेल में केवल एक ही जानकारी हो—न कोई सूची, न कॉमा-सेपरेटेड वैल्यू, न ही एक फ़ील्ड में कई डेटा पॉइंट्स। यही वह नींव है जो बाकी सबकुछ संभव बनाती है।
1NF का उल्लंघन यहाँ होता है:
CREATE TABLE orders_bad (
    order_id INT,
    customer_name VARCHAR(100),
    products VARCHAR(500),
    quantities VARCHAR(50)
);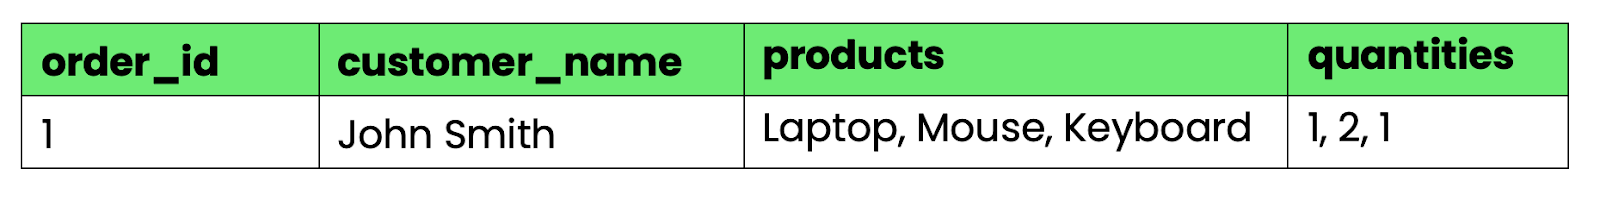
छवि 2 - 1NF का उल्लंघन करने वाली तालिका
products और quantities कॉलम में कॉमा से अलग कई मान हैं। आप "सभी ऑर्डर जिनमें लैपटॉप हों" जैसी क्वेरी आसानी से नहीं चला सकते या स्ट्रिंग पार्सिंग के बिना कुल मात्रा नहीं निकाल सकते।
इसे 1NF में बदलने के लिए, दोहराए हुए समूहों को अलग पंक्तियों में बाँटें:
-- First normal form (1NF)
CREATE TABLE orders_1nf (
    order_id INT,
    customer_name VARCHAR(100),
    product VARCHAR(100),
    quantity INT
);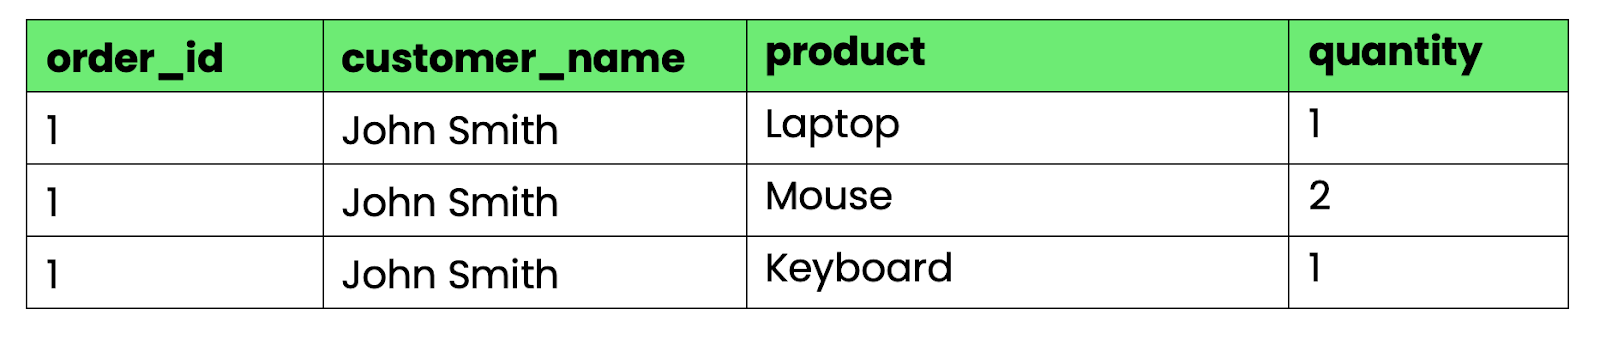
छवि 3 - 1NF का पालन करने वाली तालिका
अब हर सेल में ठीक एक मान है। आप मानक SQL ऑपरेशंस से डेटा को क्वेरी, सॉर्ट और एग्रीगेट कर सकते हैं।
दूसरा नॉर्मल फ़ॉर्म आंशिक निर्भरताएँ हटाता है—जब नॉन-की कॉलम, कॉम्पोज़िट प्राइमरी की के केवल एक हिस्से पर निर्भर होते हैं।
सेकंड नॉर्मल फ़ॉर्म (2NF) में दिखने से अधिक बातें हैं। इसके बारे में और जानें हमारे इन-डेप्थ गाइड में।
कोई तालिका 1NF में हो और हर नॉन-की कॉलम पूरी प्राइमरी की पर निर्भर हो, न कि उसके किसी हिस्से पर—तो वह 2NF में है।
हमारी 1NF तालिका में समस्या है। यदि हम order_id और product को कॉम्पोज़िट प्राइमरी की मानें, तो customer_name केवल order_id पर निर्भर है, प्रोडक्ट पर नहीं। इससे पुनरावृत्ति बनती है—एक ऑर्डर में हर प्रोडक्ट के लिए ग्राहक का नाम दोहरता है।
-- Still has partial dependencies
-- customer_name depends only on order_id, not on (order_id, product)
CREATE TABLE orders_1nf (
    order_id INT,
    customer_name VARCHAR(100), -- Partial dependency!
    product VARCHAR(100),
    quantity INT,
    PRIMARY KEY (order_id, product)
);
2NF पाने के लिए, निर्भरताओं के आधार पर तालिका को विभाजित करें:
-- Orders table (customer info depends on order_id)
CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    customer_name VARCHAR(100)
);

-- Order items table (quantity depends on both order_id and product)
CREATE TABLE order_items (
    order_id INT,
    product VARCHAR(100),
    quantity INT,
    PRIMARY KEY (order_id, product),
    FOREIGN KEY (order_id) REFERENCES orders(order_id)
);
अब customer_name प्रति ऑर्डर केवल एक बार आता है, और पुनरावृत्ति खत्म हो जाती है। हर तालिका में कॉलम पूरी प्राइमरी की पर निर्भर हैं।
तीसरा नॉर्मल फ़ॉर्म ट्रांज़िटिव डिपेंडेंसीज़ हटाता है, जो तब होती हैं जब नॉन-की कॉलम प्राइमरी की के बजाय अन्य नॉन-की कॉलम पर निर्भर होते हैं। Third Normal Form (3NF) में और गहराई से जाएँ।
ट्रांज़िटिव डिपेंडेंसी तब मौजूद होती है जब “कॉलम A” “कॉलम B” को निर्धारित करता है, और “कॉलम B” “कॉलम C” को—यानी A से C तक अप्रत्यक्ष निर्भरता बन जाती है।
आइए अपने ऑर्डर्स टेबल में ग्राहक का पता संबंधी जानकारी जोड़ते हैं:
-- Has transitive dependencies
CREATE TABLE orders_2nf (
    order_id INT PRIMARY KEY,
    customer_name VARCHAR(100),
    customer_city VARCHAR(50),
    customer_state VARCHAR(50),
    customer_zip VARCHAR(10)
);
समस्या यह है: customer_name → customer_city, और customer_city → customer_state। स्टेट सिटी पर निर्भर है, सीधे ऑर्डर पर नहीं। इससे पुनरावृत्ति बनती है—एक ही शहर के हर ऑर्डर में स्टेट जानकारी दोहरती है।
3NF पाने के लिए, ट्रांज़िटिव डिपेंडेंसीज़ हटाकर अलग तालिकाएँ बनाएँ:
-- Customers table (removes transitive dependencies)
CREATE TABLE customers (
    customer_id INT PRIMARY KEY,
    customer_name VARCHAR(100),
    city_id INT,
    FOREIGN KEY (city_id) REFERENCES cities(city_id)
);

-- Cities table
CREATE TABLE cities (
    city_id INT PRIMARY KEY,
    city_name VARCHAR(50),
    state VARCHAR(50),
    zip VARCHAR(10)
);

-- Orders table (now references customer, not customer details)
CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    customer_id INT,
    order_date DATE,
    FOREIGN KEY (customer_id) REFERENCES customers(customer_id)
);
अब भौगोलिक जानकारी एक ही जगह रहती है। यदि कोई शहर स्टेट बदलता है (दुर्लभ पर संभव), तो आप हर उस शहर के ऑर्डर्स में खोजने के बजाय एक ही पंक्ति अपडेट करेंगे।
हर नॉर्मल फ़ॉर्म विशिष्ट पुनरावृत्ति समस्याएँ हल करता है, जबकि जॉइन्स के माध्यम से आपके मूल डेटा को पुनर्निर्मित करने की क्षमता बनाए रखता है।
पहले तीन नॉर्मल फ़ॉर्म अधिकतर वास्तविक दुनिया की डेटाबेस समस्याएँ संभाल लेते हैं, लेकिन कुछ किनारी स्थितियों के लिए गहरे नॉर्मलाइज़ेशन की आवश्यकता होती है। ये उन्नत फ़ॉर्म उन विशिष्ट निर्भरता समस्याओं से निपटते हैं जिन्हें 3NF हल नहीं कर सकता।
BCNF उस सूक्ष्म समस्या को ठीक करता है जिसे 3NF छोड़ देता है: जब किसी तालिका में ओवरलैपिंग कैंडिडेट कीज़ होती हैं।
3NF नॉन-की कॉलम को कैंडिडेट कीज़ पर निर्भर होने देता है, लेकिन BCNF अधिक सख्त है। BCNF में हर डिटरमिनेंट (वह कॉलम जो किसी अन्य कॉलम को निर्धारित करता है) सुपरकी होना चाहिए—या तो प्राइमरी या कैंडिडेट की।
यहाँ 3NF विफल होता है:
-- Table in 3NF but violates BCNF
CREATE TABLE course_instructors (
    student_id INT,
    course VARCHAR(50),
    instructor VARCHAR(50),
    PRIMARY KEY (student_id, course)
);
व्यापार नियम हैं:
इससे course → instructor और instructor → course निर्भरताएँ बनती हैं। (student_id, course) और (student_id, instructor) दोनों कैंडिडेट की हैं, लेकिन course और instructor बिना स्वयं सुपरकी हुए एक-दूसरे को निर्धारित करते हैं।
समस्या तब दिखती है जब आप बिना छात्रों के नया प्रशिक्षक जोड़ना चाहते हैं। आप "प्रोफेसर स्मिथ डेटाबेस डिज़ाइन पढ़ाते हैं" तब तक इन्सर्ट नहीं कर सकते जब तक उस कोर्स में कोई छात्र न जोड़ें।
BCNF पाने के लिए, समस्याग्रस्त निर्भरता के आधार पर डीकंपोज़ करें:
-- BCNF solution
CREATE TABLE course_assignments (
    course VARCHAR(50) PRIMARY KEY,
    instructor VARCHAR(50) UNIQUE
);

CREATE TABLE student_enrollments (
    student_id INT,
    course VARCHAR(50),
    PRIMARY KEY (student_id, course),
    FOREIGN KEY (course) REFERENCES course_assignments(course)
);
अब आप बिना छात्रों के प्रशिक्षकों को जोड़ सकते हैं, और डेटाबेस संरचना व्यापार नियमों से पूरी तरह मेल खाती है।
4NF मल्टी-वैल्यूड डिपेंडेंसीज़ हटाता है—जब एक कॉलम, मानों के दूसरे स्वतंत्र सेटों को निर्धारित करता है।
मल्टी-वैल्यूड डिपेंडेंसी तब होती है जब “कॉलम A” “कॉलम B” में कई मान निर्धारित करता है, और ये मान तालिका के अन्य कॉलमों से स्वतंत्र होते हैं।
इस तालिका पर विचार करें जो छात्र के कौशल और शौक़ ट्रैक करती है:
-- Violates 4NF due to multi-valued dependencies
CREATE TABLE student_info (
    student_id INT,
    skill VARCHAR(50),
    hobby VARCHAR(50),
    PRIMARY KEY (student_id, skill, hobby)
);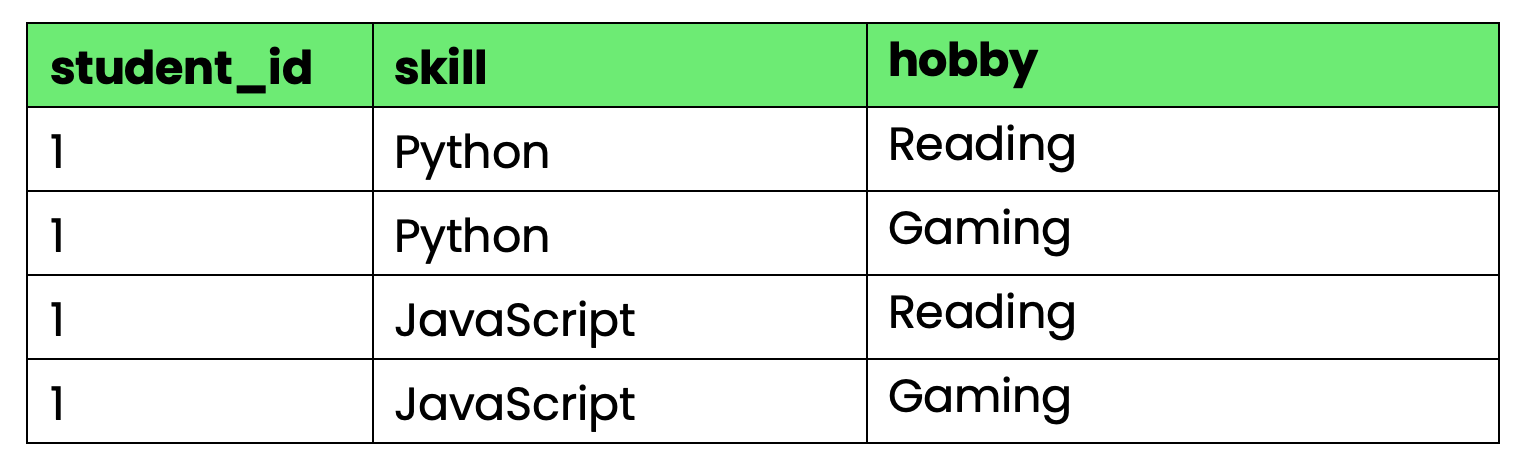
छवि 4 - 4NF का उल्लंघन करने वाली तालिका
समस्या: student_id कौशल और शौक़ दोनों को निर्धारित करता है, लेकिन कौशल और शौक़ एक-दूसरे से स्वतंत्र हैं। जब छात्र 1 नया कौशल सीखता है, तो आपको हर शौक़ संयोजन के लिए पंक्तियाँ बनानी होती हैं। जब वह नया शौक़ अपनाता है, तो हर कौशल संयोजन के लिए पंक्तियाँ चाहिए होती हैं।
कौशल और शौक़ की संख्या बढ़ने पर यह विस्फोटक पुनरावृत्ति पैदा करता है।
4NF पाने के लिए, स्वतंत्र मल्टी-वैल्यूड डिपेंडेंसीज़ को अलग करें:
-- 4NF solution
CREATE TABLE student_skills (
    student_id INT,
    skill VARCHAR(50),
    PRIMARY KEY (student_id, skill)
);

CREATE TABLE student_hobbies (
    student_id INT,
    hobby VARCHAR(50),
    PRIMARY KEY (student_id, hobby)
);
अब आप कौशल और शौक़ को स्वतंत्र रूप से जोड़ सकते हैं, बिना कार्टेशियन प्रोडक्ट विस्फोट बनाए।
5NF (Project-Join Normal Form) जॉइन डिपेंडेंसीज़ को हटाता है: जटिल संबंध जो बिना सूचना हानि के डेटा को पुनर्निर्मित करने के लिए तीन या अधिक तालिकाओं की आवश्यकता रखते हैं।
जॉइन डिपेंडेंसी तब मौजूद होती है जब आप दो डीकंपोज़्ड तालिकाओं को जोड़कर मूल तालिका का पुनर्निर्माण नहीं कर सकते, लेकिन तीन या अधिक तालिकाओं को जोड़कर कर सकते हैं।
सप्लायर्स, पार्ट्स और प्रोजेक्ट्स पर यह नियम मानें: "कोई सप्लायर किसी प्रोजेक्ट को कोई पार्ट तभी सप्लाई कर सकता है जब वह सप्लायर वह पार्ट सप्लाई करता हो और उस प्रोजेक्ट पर काम भी करता हो।"
-- Original table with join dependency
CREATE TABLE supplier_part_project (
    supplier_id INT,
    part_id INT,
    project_id INT,
    PRIMARY KEY (supplier_id, part_id, project_id)
);
5NF पाने के लिए, इसे तीन बाइनरी संबंधों में डीकंपोज़ करें:
-- 5NF decomposition
CREATE TABLE supplier_parts (supplier_id INT, part_id INT);
CREATE TABLE supplier_projects (supplier_id INT, project_id INT);
CREATE TABLE project_parts (project_id INT, part_id INT);
आप केवल तीनों तालिकाओं को जोड़कर वैध supplier-part-project संयोजनों का पुनर्निर्माण कर सकते हैं, जो स्कीमा स्तर पर व्यापार नियम लागू करता है।
6NF नॉर्मलाइज़ेशन को चरम तक ले जाता है—प्रत्येक एट्रिब्यूट को उसके अपने टेबल में समय-संबंधी कीज़ के साथ रखकर।
6NF डेटा वेयरहाउस और टेम्पोरल डेटाबेस के लिए बनाया गया है, जहाँ आपको हर एट्रिब्यूट में समय के साथ स्वतंत्र रूप से होने वाले बदलाव ट्रैक करने होते हैं।
-- 6NF example for temporal data
CREATE TABLE customer_names (
    customer_id INT,
    name VARCHAR(100),
    valid_from DATE,
    valid_to DATE
);

CREATE TABLE customer_addresses (
    customer_id INT,
    address VARCHAR(200),
    valid_from DATE,
    valid_to DATE
);
यह आपको यह ट्रैक करने देता है कि प्रत्येक एट्रिब्यूट कब बदला, बिना अन्य को प्रभावित किए—लेकिन इससे क्वेरीज़ जटिल हो जाती हैं और यह आम तौर पर विशेष टेम्पोरल डेटाबेस सिस्टम्स के बाहर कम उपयोग होता है।
अधिकांश एप्लिकेशन 3NF या BCNF पर रुकते हैं। ये उन्नत फ़ॉर्म विशेष किनारी मामलों को हल करते हैं, लेकिन सामान्य व्यावसायिक अनुप्रयोगों के लिए इनकी जटिलता अक्सर सार्थक नहीं होती।
इन कोर्सेज़ के साथ डेटाबेस और SQL के बारे में और जानें!
कोर्स
कोर्स
कोर्स