

SAM2 क्या है?
SAM2 एक फाउंडेशन मॉडल है जिसे Meta ने छवियों और वीडियो में प्रॉम्प्ट-आधारित विजुअल सेगमेंटेशन के लिए विकसित किया है। अपने पूर्ववर्ती SAM के विपरीत, जो मुख्य रूप से स्थिर छवियों पर केंद्रित था, SAM2 को वीडियो सेगमेंटेशन की जटिलताओं को भी संभालने के लिए डिज़ाइन किया गया है।
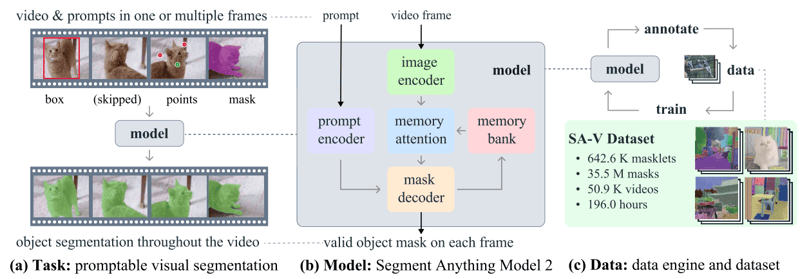
SAM2 - कार्य, मॉडल और डेटा (स्रोत: Ravi et al., 2024)
यह ट्रांसफॉर्मर आर्किटेक्चर का उपयोग करता है जिसमें स्ट्रीमिंग मेमोरी होती है, जो रीयल-टाइम वीडियो प्रोसेसिंग सक्षम करती है। SAM 2 का प्रशिक्षण एक विशाल और विविध डेटासेट पर किया गया है, जिसमें नया SA-V डेटासेट शामिल है जिसमें 51,000 वीडियो में 600,000 से अधिक मास्कलेट एनोटेशन हैं।
इसका डेटा इंजन, जो इंटरेक्टिव डेटा कलेक्शन और मॉडल सुधार की अनुमति देता है, मॉडल को किसी भी चीज़ को सेगमेंट करने की क्षमता देता है। यह इंजन SAM 2 को लगातार सीखने और अनुकूलित होने में सक्षम बनाता है, जिससे यह नए और चुनौतीपूर्ण डेटा को संभालने में अधिक कुशल बनता है। हालाँकि, डोमेन-विशिष्ट कार्यों या दुर्लभ वस्तुओं के लिए, सर्वोत्तम प्रदर्शन प्राप्त करने के लिए फाइन-ट्यूनिंग आवश्यक है।
SAM2 को फाइन-ट्यून क्यों करें?
SAM 2 के संदर्भ में, फाइन-ट्यूनिंग का अर्थ है पूर्व-प्रशिक्षित SAM 2 मॉडल को किसी विशिष्ट डेटासेट पर आगे प्रशिक्षित करना ताकि किसी खास कार्य या डोमेन के लिए इसका प्रदर्शन बेहतर हो सके। यद्यपि SAM 2 को एक व्यापक और विविध डेटासेट पर प्रशिक्षित किया गया एक शक्तिशाली टूल माना जाता है, इसका सामान्य-उद्देश्य स्वभाव विशेषीकृत या दुर्लभ कार्यों के लिए हमेशा इष्टतम परिणाम नहीं देता।
उदाहरण के लिए, यदि आप किसी मेडिकल इमेजिंग प्रोजेक्ट पर काम कर रहे हैं जिसमें विशिष्ट ट्यूमर प्रकारों की पहचान की आवश्यकता होती है, तो सामान्यीकृत प्रशिक्षण के कारण मॉडल का प्रदर्शन कम पड़ सकता है।
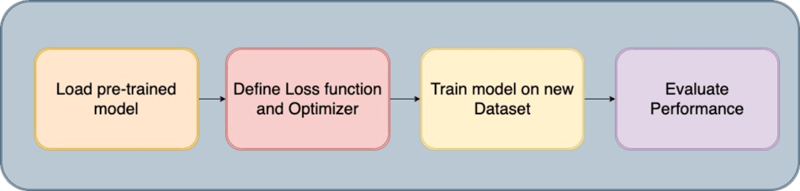
फाइन-ट्यूनिंग की प्रक्रिया
SAM 2 को फाइन-ट्यून करना इस सीमा का समाधान करता है क्योंकि यह आपको अपने विशिष्ट डेटासेट के अनुरूप मॉडल को ढालने देता है। यह प्रक्रिया मॉडल की शुद्धता में सुधार करती है और आपके विशिष्ट उपयोग-केस के लिए इसे अधिक प्रभावी बनाती है।
यहाँ SAM 2 को फाइन-ट्यून करने के प्रमुख लाभ हैं:
- बेहतर शुद्धता: अपने विशिष्ट डेटासेट पर मॉडल को फाइन-ट्यून करके, आप इसकी शुद्धता में उल्लेखनीय वृद्धि कर सकते हैं, जिससे आपके लक्षित अनुप्रयोग में बेहतर प्रदर्शन सुनिश्चित होता है।
- विशेषीकृत सेगमेंटेशन: फाइन-ट्यूनिंग मॉडल को आपके प्रोजेक्ट से संबंधित विशिष्ट वस्तु प्रकारों, विजुअल शैलियों या परिवेशों का कुशलता से सेगमेंट करने में सक्षम बनाती है, जो सामान्य-उद्देश्य मॉडल से संभव नहीं हो सकता।
- दक्षता: फाइन-ट्यूनिंग अक्सर शुरू से मॉडल ट्रेन करने की तुलना में अधिक कुशल होती है। आमतौर पर इसमें कम डेटा और समय लगता है, जिससे नए या निच कार्यों के लिए मॉडल को जल्दी अनुकूलित करना व्यावहारिक हो जाता है।
SAM 2 को फाइन-ट्यून करना शुरू करें: पूर्वापेक्षाएँ
SAM 2 को फाइन-ट्यून करना शुरू करने के लिए, आपके पास निम्नलिखित पूर्वापेक्षाएँ होनी चाहिए:
- SAM 2 मॉडल और कोडबेस तक पहुँच: SAM 2 मॉडल और उसके कोडबेस तक पहुँच रखें। आप पूर्व-प्रशिक्षित SAM 2 मॉडल Meta के GitHub रिपॉजिटरी से डाउनलोड कर सकते हैं।
- उपयुक्त डेटासेट: आपको ऐसे डेटासेट की आवश्यकता होगी जिसमें ग्राउंड ट्रुथ सेगमेंटेशन मास्क शामिल हों। इस ट्यूटोरियल के लिए, हम Chest CT Segmentation डेटासेट का उपयोग करेंगे, जिसे आप डाउनलोड करके प्रशिक्षण के लिए तैयार कर सकते हैं।
- कम्प्यूटेशनल संसाधन: SAM 2 को फाइन-ट्यून करने के लिए पर्याप्त कम्प्यूटेशनल क्षमता वाला हार्डवेयर आवश्यक है। प्रक्रिया को कुशल और प्रबंधनीय रखने के लिए GPU की काफ़ी सिफारिश की जाती है, खासकर जब बड़े डेटासेट या जटिल मॉडलों के साथ काम कर रहे हों। इस उदाहरण में, Google Colab पर A100 GPU का उपयोग किया गया है।
सॉफ्टवेयर और अन्य आवश्यकताएँ:
- Python 3.11 या उससे ऊपर
- PyTorch
- OpenCV: इसे इस कमांड से इंस्टॉल करें !pip install opencv-python
SAM 2 को फाइन-ट्यून करने के लिए डेटासेट तैयार करना
आपके डेटासेट की गुणवत्ता SAM 2 मॉडल को फाइन-ट्यून करने के लिए अत्यंत महत्वपूर्ण है। सटीक सेगमेंटेशन मास्क के साथ उच्च-गुणवत्ता वाली एनोटेटेड छवियाँ या वीडियो इष्टतम प्रदर्शन प्राप्त करने के लिए आवश्यक हैं। सटीक एनोटेशन मॉडल को सही फीचर सीखने में सक्षम बनाते हैं, जिससे वास्तविक दुनिया के अनुप्रयोगों में बेहतर सेगमेंटेशन शुद्धता और मजबूती मिलती है।
1. डेटा अधिग्रहण
पहला चरण डेटासेट प्राप्त करने का है, जो प्रशिक्षण प्रक्रिया की रीढ़ बनता है। हमने अपना डेटा Kaggle से लिया, जो विभिन्न प्रकार के डेटासेट प्रदान करने वाला एक विश्वसनीय प्लेटफ़ॉर्म है। Kaggle API का उपयोग करके, हमने आवश्यक फ़ॉर्मेट में डेटा डाउनलोड किया, यह सुनिश्चित करते हुए कि छवियाँ और उनके संबंधित सेगमेंटेशन मास्क आगे की प्रोसेसिंग के लिए आसानी से उपलब्ध हों।
2. डेटा निष्कर्षण और सफाई
डेटासेट डाउनलोड करने के बाद, हमने निम्नलिखित चरण किए:
- अनज़िप करना और सफाई करना: डाउनलोड की गई ज़िप फ़ाइलों से डेटा निकालें और डिस्क स्पेस बचाने के लिए गैर-ज़रूरी फ़ाइलें हटा दें।
- ID निष्कर्षण: प्रशिक्षण के दौरान छवियों और मास्क के बीच सही मैपिंग सुनिश्चित करने के लिए छवियों और मास्क के लिए यूनिक आइडेंटिफ़ायर (ID) निकाले जाते हैं।
- गैर-ज़रूरी फ़ाइलें हटाना: डेटासेट की अखंडता बनाए रखने के लिए शोरयुक्त या अप्रासंगिक फ़ाइलें, जैसे ज्ञात समस्याओं वाली कुछ छवियाँ, हटा दें।
3. उपयोगी फ़ॉर्मेट में रूपांतरण
चूँकि SAM2 मॉडल को विशिष्ट फ़ॉर्मेट में इनपुट की आवश्यकता होती है, हमने डेटा को इस प्रकार रूपांतरित किया:
- DICOM से NumPy तक: DICOM छवियों को पढ़कर NumPy ऐरे के रूप में संग्रहीत किया गया, जिन्हें फिर 512x512 पिक्सेल के मानक आकार में री-साइज़ किया गया।
- मास्क के लिए NRRD से NumPy: इसी तरह, फेफड़ों, हृदय और श्वासनली के मास्क वाले NRRD फ़ाइलों को प्रोसेस करके NumPy ऐरे के रूप में सहेजा गया। इन मास्क को फिर संबंधित छवियों से मिलान करने के लिए पुनःआकारित किया गया।
- JPG/PNG में रूपांतरण: बेहतर विज़ुअलाइज़ेशन और अनुकूलता के लिए, NumPy ऐरे को JPG/PNG फ़ॉर्मेट में बदला गया। इसमें इमेज इंटेंसिटी मानों का नॉर्मलाइज़ेशन और मास्क की सही ओरिएंटेशन सुनिश्चित करना शामिल था।
4. डेटा सहेजना और व्यवस्थित करना
प्रोसेस की गई छवियों और मास्क को फाइन-ट्यूनिंग प्रक्रिया के दौरान आसान एक्सेस के लिए संबंधित फ़ोल्डरों में व्यवस्थित किया जाता है। इसके अतिरिक्त, इन छवियों और मास्क के पाथ एक CSV फ़ाइल (train.csv) में लिखे जाते हैं ताकि प्रशिक्षण के दौरान डेटा लोडिंग में सुविधा हो।
5. विज़ुअलाइज़ेशन और सत्यापन
अंतिम चरण में डेटासेट का सत्यापन शामिल है ताकि इसकी सटीकता सुनिश्चित की जा सके:
- विज़ुअलाइज़ेशन: हमने छवियों पर मास्क ओवरले करके इमेज-मास्क युग्मों को देखा। इससे मास्क के एलाइनमेंट और शुद्धता की जाँच करने में मदद मिली।
- इंस्पेक्शन: कुछ नमूनों का निरीक्षण करके, हम यह सुनिश्चित कर सके कि डेटासेट सही ढंग से तैयार है और फाइन-ट्यूनिंग में उपयोग के लिए तैयार है।
यहाँ एक त्वरित नोटबुक है जो आपको डेटासेट क्रिएशन के कोड से गुज़ारेगी। आप या तो इस डेटा क्रिएशन पथ से जा सकते हैं या सीधे प्री-रिक्विज़िट्स में बताई गई फॉर्मेट वाले किसी भी ऑनलाइन उपलब्ध डेटासेट का उपयोग कर सकते हैं।
SAM2 का फाइन-ट्यूनिंग
Segment Anything Model 2 में कई कॉम्पोनेंट होते हैं, लेकिन तेज़ फाइन-ट्यूनिंग के लिए यहाँ मुख्य बात यह है कि पूरे मॉडल के बजाय केवल हल्के कॉम्पोनेंट, जैसे मास्क डिकोडर और प्रॉम्प्ट एन्कोडर, को ट्रेन किया जाए। इस मॉडल को फाइन-ट्यून करने के चरण इस प्रकार हैं:
चरण 1: SAM-2 इंस्टॉल करें
फाइन-ट्यूनिंग प्रक्रिया शुरू करने के लिए, हमें SAM-2 लाइब्रेरी इंस्टॉल करनी होगी, जो Segment Anything Model (SAM2) के लिए महत्वपूर्ण है। यह मॉडल विभिन्न सेगमेंटेशन कार्यों को प्रभावी ढंग से संभालने के लिए डिज़ाइन किया गया है। इंस्टॉलेशन में GitHub से SAM-2 रिपॉजिटरी क्लोन करना और आवश्यक डिपेंडेंसीज़ इंस्टॉल करना शामिल है।
!git clone https://github.com/facebookresearch/segment-anything-2
%cd /content/segment-anything-2
!pip install -q -e .यह कोड स्निपेट सुनिश्चित करता है कि SAM2 लाइब्रेरी सही तरीके से इंस्टॉल हो गई है और हमारे फाइन-ट्यूनिंग वर्कफ़्लो में उपयोग के लिए तैयार है।
चरण 2: डेटासेट डाउनलोड करें
SAM-2 लाइब्रेरी इंस्टॉल होने के बाद, अगला चरण उस डेटासेट को प्राप्त करना है जिसका हम फाइन-ट्यूनिंग के लिए उपयोग करेंगे। हम Kaggle पर उपलब्ध एक डेटासेट का उपयोग करते हैं, विशेष रूप से एक चेस्ट CT सेगमेंटेशन डेटासेट जिसमें फेफड़ों, हृदय और श्वासनली की छवियाँ और मास्क शामिल हैं।
डेटासेट में शामिल हैं:
- images.zip: RGB फ़ॉर्मेट में छवियाँ
- masks.zip: RGB फ़ॉर्मेट में सेगमेंटेशन मास्क
- train.csv: छवि नामों वाली CSV फ़ाइल
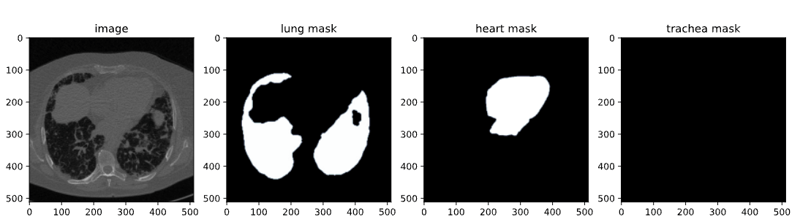
CT स्कैन डेटासेट से छवि
इस ब्लॉग में, हम सेगमेंटेशन के लिए केवल फेफड़ों की छवियाँ और मास्क का उपयोग करेंगे। Kaggle API हमें डेटासेट सीधे अपने वातावरण में डाउनलोड करने देता है। हम kaggle.json फ़ाइल अपलोड करके शुरू करते हैं ताकि किसी भी डेटासेट तक आसानी से पहुँचा जा सके।
kaggle.json प्राप्त करने के लिए, अपने यूज़र प्रोफ़ाइल के Settings टैब पर जाएँ और Create New Token चुनें। इससे Kaggle डाउनलोड ट्रिगर होगा—json, जो आपकी API क्रेडेंशियल्स वाली फ़ाइल है।
# get dataset from Kaggle
from google.colab import files
files.upload() # This will prompt you to upload the kaggle.json file
!mkdir -p ~/.kaggle
!mv kaggle.json ~/.kaggle/
!chmod 600 ~/.kaggle/kaggle.json
!kaggle datasets download -d polomarco/chest-ct-segmentationडेटा अनज़िप करें:
!unzip chest-ct-segmentation.zip -d chest-ct-segmentationडेटासेट तैयार होने के साथ, आइए फाइन-ट्यूनिंग प्रक्रिया शुरू करें। जैसा कि मैंने पहले उल्लेख किया, यहाँ कुंजी यह है कि SAM2 के केवल हल्के कॉम्पोनेंट, जैसे मास्क डिकोडर और प्रॉम्प्ट एन्कोडर, को ही फाइन-ट्यून किया जाए, न कि पूरे मॉडल को। यह तरीका अधिक कुशल है और कम संसाधन मांगता है।
चरण 3: SAM-2 चेकपॉइंट डाउनलोड करें
फाइन-ट्यूनिंग प्रक्रिया के लिए, हमें पूर्व-प्रशिक्षित SAM2 मॉडल वज़न से शुरू करना होगा। इन वज़नों को "चेकपॉइंट" कहा जाता है और ये आगे के प्रशिक्षण के लिए शुरुआती बिंदु होते हैं। चेकपॉइंट विभिन्न प्रकार की छवियों पर प्रशिक्षित किए गए हैं, और उन्हें हमारे विशिष्ट डेटासेट पर फाइन-ट्यून करके, हम अपने लक्षित कार्यों पर बेहतर प्रदर्शन हासिल कर सकते हैं।
!wget -O sam2_hiera_tiny.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_tiny.pt"
!wget -O sam2_hiera_small.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_small.pt"
!wget -O sam2_hiera_base_plus.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_base_plus.pt"
!wget -O sam2_hiera_large.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_large.pt"इस चरण में, हम विभिन्न SAM-2 चेकपॉइंट डाउनलोड करते हैं जो अलग-अलग मॉडल आकारों (जैसे tiny, small, base_plus, large) से मेल खाते हैं। चेकपॉइंट का चयन उपलब्ध कम्प्यूटेशनल संसाधनों और विशेष कार्य के आधार पर समायोजित किया जा सकता है।
चरण 4: डेटा तैयारी
डेटासेट डाउनलोड होने के बाद, अगला चरण इसे प्रशिक्षण के लिए तैयार करना है। इसमें डेटासेट को प्रशिक्षण और परीक्षण सेट में विभाजित करना और ऐसी डेटा संरचनाएँ बनाना शामिल है जिन्हें फाइन-ट्यूनिंग के दौरान SAM 2 मॉडल को फ़ीड किया जा सके।
%cd /content/segment-anything-2
import os
import pandas as pd
import cv2
import torch
import torch.nn.utils
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.colors as mcolors
from sklearn.model_selection import train_test_split
from sam2.build_sam import build_sam2
from sam2.sam2_image_predictor import SAM2ImagePredictor
# Path to the chest-ct-segmentation dataset folder
data_dir = "/content/segment-anything-2/chest-ct-segmentation"
images_dir = os.path.join(data_dir, "images/images")
masks_dir = os.path.join(data_dir, "masks/masks")
# Load the train.csv file
train_df = pd.read_csv(os.path.join(data_dir, "train.csv"))
# Split the data into two halves: one for training and one for testing
train_df, test_df = train_test_split(train_df, test_size=0.2, random_state=42)
# Prepare the training data list
train_data = []
for index, row in train_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
train_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
# Prepare the testing data list (if needed for inference or evaluation later)
test_data = []
for index, row in test_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
test_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
हमने मॉडल के प्रशिक्षण के बाद उसके प्रदर्शन का मूल्यांकन सुनिश्चित करने के लिए डेटासेट को प्रशिक्षण सेट (80%) और परीक्षण सेट (20%) में विभाजित किया। प्रशिक्षण डेटा SAM 2 मॉडल को फाइन-ट्यून करने के लिए उपयोग किया जाएगा, जबकि परीक्षण डेटा इन्फरेंस और मूल्यांकन के लिए उपयोग होगा।
अपने डेटासेट को प्रशिक्षण और परीक्षण सेट में विभाजित करने के बाद, अगला चरण बाइनरी मास्क बनाना, इन मास्क के भीतर प्रमुख बिंदुओं का चयन करना और यह सुनिश्चित करने के लिए इन तत्वों का विज़ुअलाइज़ेशन करना शामिल है कि डेटा सही ढंग से प्रोसेस हुआ है।
1. छवियों को पढ़ना और आकार बदलना: प्रक्रिया डेटासेट से यादृच्छिक रूप से एक छवि और उसके संबंधित मास्क का चयन करके शुरू होती है। छवि को BGR से RGB फॉर्मेट में बदला जाता है, जो अधिकांश डीप लर्निंग मॉडलों के लिए मानक रंग फॉर्मेट है। संबंधित एनोटेशन (मास्क) को ग्रेस्केल मोड में पढ़ा जाता है। फिर, छवि और एनोटेशन मास्क दोनों का आकार बदलकर अधिकतम 1024 पिक्सेल किया जाता है, आस्पेक्ट रेशियो बनाए रखते हुए ताकि डेटा मॉडल की इनपुट आवश्यकताओं में फिट हो और कम्प्यूटेशनल लोड कम हो।
def read_batch(data, visualize_data=False):
# Select a random entry
ent = data[np.random.randint(len(data))]
# Get full paths
Img = cv2.imread(ent["image"])[..., ::-1] # Convert BGR to RGB
ann_map = cv2.imread(ent["annotation"], cv2.IMREAD_GRAYSCALE) # Read annotation as grayscale
if Img is None or ann_map is None:
print(f"Error: Could not read image or mask from path {ent['image']} or {ent['annotation']}")
return None, None, None, 0
# Resize image and mask
r = np.min([1024 / Img.shape[1], 1024 / Img.shape[0]]) # Scaling factor
Img = cv2.resize(Img, (int(Img.shape[1] * r), int(Img.shape[0] * r)))
ann_map = cv2.resize(ann_map, (int(ann_map.shape[1] * r), int(ann_map.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
2. सेगमेंटेशन मास्क का बाइनरीकरण: मल्टी-क्लास एनोटेशन मास्क (जिसमें विभिन्न ऑब्जेक्ट क्लास अलग-अलग पिक्सेल मानों से लेबल किए जा सकते हैं) को बाइनरी मास्क में बदला जाता है। यह मास्क छवि में सभी रुचि वाले क्षेत्रों को हाइलाइट करता है, जिससे सेगमेंटेशन कार्य एक बाइनरी वर्गीकरण समस्या में सरल हो जाता है: ऑब्जेक्ट बनाम बैकग्राउंड। इसके बाद बाइनरी मास्क को 5x5 कर्नेल का उपयोग करके इरोड किया जाता है।
इरोशन मास्क के आकार को थोड़ा कम करता है, जो बिंदु चयन करते समय बॉर्डरी इफ़ेक्ट से बचने में मदद करता है। यह सुनिश्चित करता है कि चयनित बिंदु वस्तु के किनारों के पास होने के बजाय उसके अंदरूनी भाग में अच्छी तरह स्थित हों, जो शोरयुक्त या अस्पष्ट हो सकते हैं।
मुख्य बिंदु इरोड किए गए मास्क के भीतर से चुने जाते हैं। ये बिंदु फाइन-ट्यूनिंग प्रक्रिया के दौरान प्रॉम्प्ट के रूप में कार्य करते हैं, मॉडल को यह बताने में मार्गदर्शन करते हैं कि उसे अपना ध्यान कहाँ केंद्रित करना है। बिंदुओं को वस्तुओं के अंदरूनी भाग से यादृच्छिक रूप से चुना जाता है ताकि वे प्रतिनिधिक हों और शोरयुक्त बॉर्डरी से प्रभावित न हों।
### Continuation of read_batch() ###
# Initialize a single binary mask
binary_mask = np.zeros_like(ann_map, dtype=np.uint8)
points = []
# Get binary masks and combine them into a single mask
inds = np.unique(ann_map)[1:] # Skip the background (index 0)
for ind in inds:
mask = (ann_map == ind).astype(np.uint8) # Create binary mask for each unique index
binary_mask = np.maximum(binary_mask, mask) # Combine with the existing binary mask
# Erode the combined binary mask to avoid boundary points
eroded_mask = cv2.erode(binary_mask, np.ones((5, 5), np.uint8), iterations=1)
# Get all coordinates inside the eroded mask and choose a random point
coords = np.argwhere(eroded_mask > 0)
if len(coords) > 0:
for _ in inds: # Select as many points as there are unique labels
yx = np.array(coords[np.random.randint(len(coords))])
points.append([yx[1], yx[0]])
points = np.array(points)
3. विज़ुअलाइज़ेशन: यह चरण यह सत्यापित करने के लिए महत्वपूर्ण है कि डेटा प्रीप्रोसेसिंग चरण सही ढंग से निष्पादित किए गए हैं। बाइनरीकृत मास्क पर बिंदुओं का नेत्रीकरण करके, आप सुनिश्चित कर सकते हैं कि प्रशिक्षण के दौरान मॉडल को उपयुक्त इनपुट प्राप्त होगा। अंत में, बाइनरी मास्क को सही ढंग से रेशेप और फॉर्मेट किया जाता है (डाइमेंशन मॉडल इनपुट के अनुकूल), और बिंदुओं को भी प्रशिक्षण प्रक्रिया में आगे उपयोग के लिए रेशेप किया जाता है। फ़ंक्शन प्रोसेस की गई छवि, बाइनरी मास्क, चयनित बिंदु और पाए गए मास्कों की संख्या लौटाता है।
### Continuation of read_batch() ###
if visualize_data:
# Plotting the images and points
plt.figure(figsize=(15, 5))
# Original Image
plt.subplot(1, 3, 1)
plt.title('Original Image')
plt.imshow(img)
plt.axis('off')
# Segmentation Mask (binary_mask)
plt.subplot(1, 3, 2)
plt.title('Binarized Mask')
plt.imshow(binary_mask, cmap='gray')
plt.axis('off')
# Mask with Points in Different Colors
plt.subplot(1, 3, 3)
plt.title('Binarized Mask with Points')
plt.imshow(binary_mask, cmap='gray')
# Plot points in different colors
colors = list(mcolors.TABLEAU_COLORS.values())
for i, point in enumerate(points):
plt.scatter(point[0], point[1], c=colors[i % len(colors)], s=100, label=f'Point {i+1}') # Corrected to plot y, x order
# plt.legend()
plt.axis('off')
plt.tight_layout()
plt.show()
binary_mask = np.expand_dims(binary_mask, axis=-1) # Now shape is (1024, 1024, 1)
binary_mask = binary_mask.transpose((2, 0, 1))
points = np.expand_dims(points, axis=1)
# Return the image, binarized mask, points, and number of masks
return img, binary_mask, points, len(inds)
# Visualize the data
Img1, masks1, points1, num_masks = read_batch(train_data, visualize_data=True)
उपरोक्त कोड डेटासेट से मूल छवि के साथ उसका बाइनरीकृत मास्क और बाइनरीकृत मास्क विद पॉइंट्स वाली निम्न फ़िगर लौटाता है।
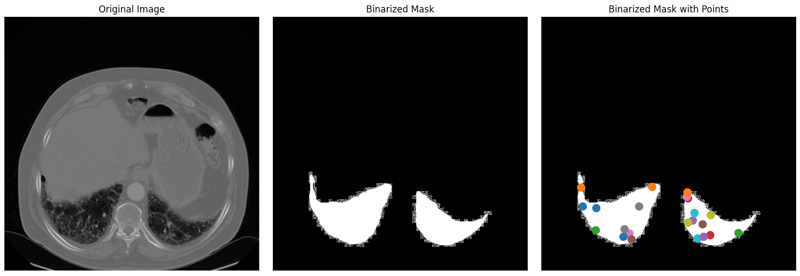
डेटासेट के लिए मूल छवि, बाइनरीकृत मास्क, और बाइनरीकृत मास्क विद पॉइंट्स।
चरण 5: SAM2 मॉडल का फाइन-ट्यूनिंग
SAM2 मॉडल को फाइन-ट्यून करने में कई चरण शामिल हैं, जिनमें मॉडल लोड करना, ऑप्टिमाइज़र और शेड्यूलर सेट करना, और प्रशिक्षण डेटा के आधार पर मॉडल वज़न को आवर्तक रूप से अपडेट करना शामिल है।
मॉडल चेकपॉइंट लोड करें:
sam2_checkpoint = "sam2_hiera_small.pt" # @param ["sam2_hiera_tiny.pt", "sam2_hiera_small.pt", "sam2_hiera_base_plus.pt", "sam2_hiera_large.pt"]
model_cfg = "sam2_hiera_s.yaml" # @param ["sam2_hiera_t.yaml", "sam2_hiera_s.yaml", "sam2_hiera_b+.yaml", "sam2_hiera_l.yaml"]
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
predictor = SAM2ImagePredictor(sam2_model)
हम पूर्व-प्रशिक्षित चेकपॉइंट का उपयोग करके SAM2 मॉडल बनाकर शुरू करते हैं। इसके बाद मॉडल को एक प्रेडिक्टर क्लास में रैप किया जाता है, जो छवियाँ सेट करने, प्रॉम्प्ट एन्कोड करने और मास्क डिकोड करने की प्रक्रिया को सरल बनाता है।
हाइपरपैरामीटर कॉन्फ़िगर करें
हम मॉडल के प्रभावी ढंग से सीखने के लिए कई हाइपरपैरामीटर कॉन्फ़िगर करते हैं, जैसे लर्निंग रेट, वेट डिके और ग्रेडिएंट एक्यूम्यूलेशन स्टेप्स। ये हाइपरपैरामीटर सीखने की प्रक्रिया को नियंत्रित करते हैं, जिनमें यह भी शामिल है कि मॉडल अपने वज़न कितनी तेज़ी से अपडेट करता है और ओवरफ़िटिंग से कैसे बचता है। आप इनके साथ प्रयोग कर सकते हैं।
# Train mask decoder.
predictor.model.sam_mask_decoder.train(True)
# Train prompt encoder.
predictor.model.sam_prompt_encoder.train(True)
# Configure optimizer.
optimizer=torch.optim.AdamW(params=predictor.model.parameters(),lr=0.0001,weight_decay=1e-4) #1e-5, weight_decay = 4e-5
# Mix precision.
scaler = torch.cuda.amp.GradScaler()
# No. of steps to train the model.
NO_OF_STEPS = 3000 # @param
# Fine-tuned model name.
FINE_TUNED_MODEL_NAME = "fine_tuned_sam2"
ऑप्टिमाइज़र मॉडल वज़न अपडेट करने के लिए ज़िम्मेदार होता है, जबकि शेड्यूलर प्रशिक्षण के दौरान लर्निंग रेट को समायोजित करता है ताकि कन्वर्जेन्स में सुधार हो सके। इन पैरामीटरों को फाइन-ट्यून करके, हम बेहतर सेगमेंटेशन शुद्धता प्राप्त कर सकते हैं।
ट्रेनिंग शुरू करें
वास्तविक फाइन-ट्यूनिंग प्रक्रिया आवर्तक होती है, जहाँ प्रत्येक स्टेप में केवल फेफड़ों की छवियों और मास्क का एक बैच मॉडल से गुज़ारा जाता है, और लॉस की गणना करके मॉडल वज़न को अपडेट करने के लिए उपयोग किया जाता है।
# Initialize scheduler
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=500, gamma=0.2) # 500 , 250, gamma = 0.1
accumulation_steps = 4 # Number of steps to accumulate gradients before updating
for step in range(1, NO_OF_STEPS + 1):
with torch.cuda.amp.autocast():
image, mask, input_point, num_masks = read_batch(train_data, visualize_data=False)
if image is None or mask is None or num_masks == 0:
continue
input_label = np.ones((num_masks, 1))
if not isinstance(input_point, np.ndarray) or not isinstance(input_label, np.ndarray):
continue
if input_point.size == 0 or input_label.size == 0:
continue
predictor.set_image(image)
mask_input, unnorm_coords, labels, unnorm_box = predictor._prep_prompts(input_point, input_label, box=None, mask_logits=None, normalize_coords=True)
if unnorm_coords is None or labels is None or unnorm_coords.shape[0] == 0 or labels.shape[0] == 0:
continue
sparse_embeddings, dense_embeddings = predictor.model.sam_prompt_encoder(
points=(unnorm_coords, labels), boxes=None, masks=None,
)
batched_mode = unnorm_coords.shape[0] > 1
high_res_features = [feat_level[-1].unsqueeze(0) for feat_level in predictor._features["high_res_feats"]]
low_res_masks, prd_scores, _, _ = predictor.model.sam_mask_decoder(
image_embeddings=predictor._features["image_embed"][-1].unsqueeze(0),
image_pe=predictor.model.sam_prompt_encoder.get_dense_pe(),
sparse_prompt_embeddings=sparse_embeddings,
dense_prompt_embeddings=dense_embeddings,
multimask_output=True,
repeat_image=batched_mode,
high_res_features=high_res_features,
)
prd_masks = predictor._transforms.postprocess_masks(low_res_masks, predictor._orig_hw[-1])
gt_mask = torch.tensor(mask.astype(np.float32)).cuda()
prd_mask = torch.sigmoid(prd_masks[:, 0])
seg_loss = (-gt_mask * torch.log(prd_mask + 0.000001) - (1 - gt_mask) * torch.log((1 - prd_mask) + 0.00001)).mean()
inter = (gt_mask * (prd_mask > 0.5)).sum(1).sum(1)
iou = inter / (gt_mask.sum(1).sum(1) + (prd_mask > 0.5).sum(1).sum(1) - inter)
score_loss = torch.abs(prd_scores[:, 0] - iou).mean()
loss = seg_loss + score_loss * 0.05
# Apply gradient accumulation
loss = loss / accumulation_steps
scaler.scale(loss).backward()
# Clip gradients
torch.nn.utils.clip_grad_norm_(predictor.model.parameters(), max_norm=1.0)
if step % accumulation_steps == 0:
scaler.step(optimizer)
scaler.update()
predictor.model.zero_grad()
# Update scheduler
scheduler.step()
if step % 500 == 0:
FINE_TUNED_MODEL = FINE_TUNED_MODEL_NAME + "_" + str(step) + ".torch"
torch.save(predictor.model.state_dict(), FINE_TUNED_MODEL)
if step == 1:
mean_iou = 0
mean_iou = mean_iou * 0.99 + 0.01 * np.mean(iou.cpu().detach().numpy())
if step % 100 == 0:
print("Step " + str(step) + ":\t", "Accuracy (IoU) = ", mean_iou)
प्रत्येक इटरेशन के दौरान, मॉडल छवियों के एक बैच को प्रोसेस करता है, सेगमेंटेशन मास्क की गणना करता है और उन्हें ग्राउंड ट्रुथ से तुलना करके लॉस निकालता है। फिर इस लॉस का उपयोग मॉडल वज़न को समायोजित करने के लिए किया जाता है, जिससे मॉडल का प्रदर्शन धीरे-धीरे बेहतर होता है। लगभग 3000 epochs तक प्रशिक्षण के बाद, हमें लगभग 72% की शुद्धता (IoU - Intersection over Union) मिलती है।
चरण 6: फाइन-ट्यून किए गए मॉडल के साथ इन्फरेंस
इसके बाद मॉडल का उपयोग इन्फरेंस के लिए किया जा सकता है, जहाँ यह नई, अनदेखी छवियों पर सेगमेंटेशन मास्क का पूर्वानुमान लगाता है। read_images और get_points हेल्पर फ़ंक्शन से शुरू करें ताकि इन्फरेंस इमेज और उसके मास्क के साथ प्रमुख बिंदु प्राप्त किए जा सकें।
def read_image(image_path, mask_path): # read and resize image and mask
img = cv2.imread(image_path)[..., ::-1] # Convert BGR to RGB
mask = cv2.imread(mask_path, 0)
r = np.min([1024 / img.shape[1], 1024 / img.shape[0]])
img = cv2.resize(img, (int(img.shape[1] * r), int(img.shape[0] * r)))
mask = cv2.resize(mask, (int(mask.shape[1] * r), int(mask.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
return img, mask
def get_points(mask, num_points): # Sample points inside the input mask
points = []
coords = np.argwhere(mask > 0)
for i in range(num_points):
yx = np.array(coords[np.random.randint(len(coords))])
points.append([[yx[1], yx[0]]])
return np.array(points)इसके बाद जिन सैंपल छवियों पर आप इन्फरेंस करना चाहते हैं उन्हें नए फाइन-ट्यून किए गए वज़नों के साथ लोड करें, और torch.no_grad() सेट करके इन्फरेंस करें।
# Randomly select a test image from the test_data
selected_entry = random.choice(test_data)
image_path = selected_entry['image']
mask_path = selected_entry['annotation']
# Load the selected image and mask
image, mask = read_image(image_path, mask_path)
# Generate random points for the input
num_samples = 30 # Number of points per segment to sample
input_points = get_points(mask, num_samples)
# Load the fine-tuned model
FINE_TUNED_MODEL_WEIGHTS = "fine_tuned_sam2_1000.torch"
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
# Build net and load weights
predictor = SAM2ImagePredictor(sam2_model)
predictor.model.load_state_dict(torch.load(FINE_TUNED_MODEL_WEIGHTS))
# Perform inference and predict masks
with torch.no_grad():
predictor.set_image(image)
masks, scores, logits = predictor.predict(
point_coords=input_points,
point_labels=np.ones([input_points.shape[0], 1])
)
# Process the predicted masks and sort by scores
np_masks = np.array(masks[:, 0])
np_scores = scores[:, 0]
sorted_masks = np_masks[np.argsort(np_scores)][::-1]
# Initialize segmentation map and occupancy mask
seg_map = np.zeros_like(sorted_masks[0], dtype=np.uint8)
occupancy_mask = np.zeros_like(sorted_masks[0], dtype=bool)
# Combine masks to create the final segmentation map
for i in range(sorted_masks.shape[0]):
mask = sorted_masks[i]
if (mask * occupancy_mask).sum() / mask.sum() > 0.15:
continue
mask_bool = mask.astype(bool)
mask_bool[occupancy_mask] = False # Set overlapping areas to False in the mask
seg_map[mask_bool] = i + 1 # Use boolean mask to index seg_map
occupancy_mask[mask_bool] = True # Update occupancy_mask
# Visualization: Show the original image, mask, and final segmentation side by side
plt.figure(figsize=(18, 6))
plt.subplot(1, 3, 1)
plt.title('Test Image')
plt.imshow(image)
plt.axis('off')
plt.subplot(1, 3, 2)
plt.title('Original Mask')
plt.imshow(mask, cmap='gray')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.title('Final Segmentation')
plt.imshow(seg_map, cmap='jet')
plt.axis('off')
plt.tight_layout()
plt.show()इस चरण में, हम टेस्ट छवियों के लिए सेगमेंटेशन मास्क उत्पन्न करने हेतु फाइन-ट्यून किए गए मॉडल का उपयोग करते हैं। पूर्वानुमानित मास्क को मूल छवियों और ग्राउंड ट्रुथ मास्क के साथ साथ दिखाकर मॉडल के प्रदर्शन का मूल्यांकन किया जाता है।
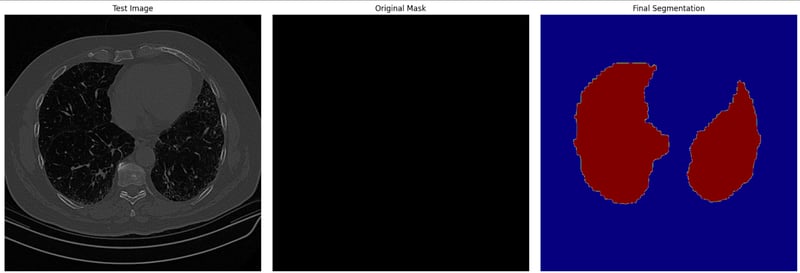
टेस्ट डेटा पर अंतिम सेगमेंटेशन छवि
निष्कर्ष
SAM2 का फाइन-ट्यूनिंग इसके विशिष्ट कार्यों के लिए क्षमताओं को बढ़ाने का एक व्यावहारिक तरीका प्रदान करता है। चाहे आप मेडिकल इमेजिंग, स्वचालित वाहन, या वीडियो एडिटिंग पर काम कर रहे हों, फाइन-ट्यूनिंग आपको अपनी अनूठी आवश्यकताओं के लिए SAM2 का लाभ उठाने देती है। इस गाइड का पालन करके, आप अपने प्रोजेक्ट्स के लिए SAM2 को अनुकूलित कर सकते हैं और अत्याधुनिक सेगमेंटेशन परिणाम प्राप्त कर सकते हैं।
अधिक उन्नत उपयोग मामलों के लिए, SAM2 के अतिरिक्त कॉम्पोनेंट, जैसे इमेज एन्कोडर, को फाइन-ट्यून करने पर विचार करें। यद्यपि इसके लिए अधिक संसाधनों की आवश्यकता होती है, यह अधिक लचीलापन और प्रदर्शन में सुधार प्रदान करता है।

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
Meta का Segment Anything Model 2 (SAM 2) Meta का पहला एकीकृत मॉडल था जो वास्तविक समय में छवियों और वीडियो दोनों में वस्तुओं को सेगमेंट कर सकता है। इसके बाद इसे SAM3 ने प्रतिस्थापित कर दिया है, जिसके बारे में आप हमारे SAM3 ट्यूटोरियल में पढ़ सकते हैं।
लेकिन जब यह पहले से ही कुछ भी सेगमेंट कर सकता है तो SAM 2 को फाइन-ट्यून क्यों करें?
हालाँकि SAM 2 बॉक्स से बाहर ही शक्तिशाली है, लेकिन दुर्लभ या डोमेन-विशिष्ट कार्यों पर इसका प्रदर्शन हमेशा अपेक्षाओं पर खरा नहीं उतरता। फाइन-ट्यूनिंग आपको SAM2 को अपनी विशिष्ट आवश्यकताओं के अनुरूप ढालने देती है, जिससे आपके उपयोग-केस के लिए इसकी शुद्धता और दक्षता में सुधार होता है।
इस लेख में, मैं आपको SAM 2 के फाइन-ट्यूनिंग की प्रक्रिया को चरण-दर-चरण समझाऊंगा।