कोर्स
LangChain के साथ Agentic Systems डिज़ाइन करना
3 घंटा
14.8K
आप इस डेमो का पूरा कोड यहाँ देख सकते हैं।
Nemotron 3 Super एजेंटिक और लंबे कॉन्टेक्स्ट वर्कफ़्लो के लिए NVIDIA का ओपन रीजनिंग मॉडल है। यह एक हाइब्रिड Mamba-Transformer Latent MoE आर्किटेक्चर का उपयोग करता है, जिसमें कुल 120B पैरामीटर्स और 12B सक्रिय पैरामीटर्स हैं, मल्टी-टोकन प्रेडिक्शन (MTP) शामिल है, और इसे कोडिंग, टूल उपयोग, और लंबे कॉन्टेक्स्ट विश्लेषण जैसे रीजनिंग-हैवी कार्यों के लिए डिज़ाइन किया गया है।
NVIDIA इसे विशेष रूप से जटिल मल्टी-एजेंट एप्लिकेशंस और पूरे कोडबेस पर रीजनिंग के लिए पोज़िशन करता है।
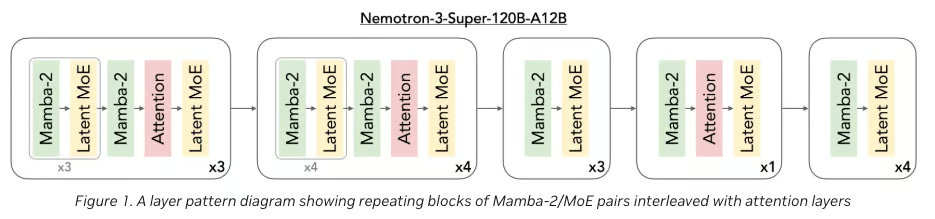
चित्र 1: Nemotron 3 Super आर्किटेक्चर (NVIDIA ब्लॉग)
Nemotron 3 Super के पीछे कुछ मुख्य विचार:
इस ट्यूटोरियल के लिए, हम OpenRouter के होस्टेड फ्री एंडपॉइंट का उपयोग करेंगे, क्योंकि मॉडल के फुल और क्वांटाइज़्ड दोनों वेरिएंट आमतौर पर व्यवहारिक इन्फरेंस के लिए कम-से-कम H100 GPU की मांग करते हैं। होस्टेड एंडपॉइंट फिलहाल 262K टोकन कॉन्टेक्स्ट विंडो सपोर्ट करता है (पूरा 1M नहीं), जो इस डेमो में मीडियम-साइज़ रिपॉज़िटरीज़ का विश्लेषण करने के लिए पर्याप्त है।
NVIDIA का Nemotron 3 परिवार एजेंटिक AI सिस्टम्स के लिए एक ओपन मॉडल फैमिली के रूप में पेश किया गया था, जिसमें अलग-अलग आकार डिप्लॉयमेंट और रीजनिंग आवश्यकताओं के अनुसार हैं—जिन्हें Nemotron Nano, Super, और Ultra टियर नाम दिए गए हैं।
व्यावहारिक रूप से, आप इस परिवार को यूँ समझ सकते हैं:
तो, Nemotron 3 Super यहाँ सही विकल्प है क्योंकि हमें ऐसा मॉडल चाहिए जो एक ही बार में पूरे रिपॉज़िटरी पर रीजन कर सके—सिर्फ अलग-थलग कोडिंग सबटास्क्स नहीं।
इस सेक्शन में, हम Gradio इंटरफ़ेस में रैप किए गए Nemotron 3 Super का उपयोग करके एक repo analyzer बनाएँगे। उच्च स्तर पर, अंतिम ऐप यह करता है:
आइए इसे चरण-दर-चरण बनाते हैं।
Repo analyzer बनाने से पहले, हमें न्यूनतम ऐसा वातावरण चाहिए जो तीन मुख्य जिम्मेदारियाँ संभाल सके—UI रेंडरिंग, रिपॉज़िटरी प्रोसेसिंग, और मॉडल इंटरैक्शन। चूँकि हम Nemotron को लोकली नहीं चला रहे, सेटअप हल्का और केंद्रित रहता है।
सब कुछ इंस्टॉल करने के लिए यह चलाएँ:
!pip -q install gradio openai tiktoken gitpython orjson pandasइस प्रोजेक्ट में हम उपयोग करेंगे:
openai OpenRouter के API (Nemotron एंडपॉइंट) से इंटरैक्ट करने के लिएgradio इंटरैक्टिव UI बनाने के लिएtiktoken प्रॉम्प्ट भेजने से पहले टोकन उपयोग का अनुमान लगाने के लिएorjson मॉडल आउटपुट से तेज JSON पार्सिंग के लिएpandas संरचित परिणामों को तालिकाओं के रूप में रेंडर करने के लिएgitpython रिपॉज़िटरी क्लोन और उन पर काम करने के लिएलोकल LLM सेटअप्स (जिन्हें CUDA, vLLM, या क्वांटाइज़ेशन चाहिए) के विपरीत, यह तरीका GPU निर्भरता पूरी तरह टालता है और वातावरण को Colab-फ्रेंडली रखता है।
इस चरण में, हम OpenRouter के जरिए Nemotron 3 Super सेटअप करेंगे और कुछ मुख्य कॉन्स्टेंट्स परिभाषित करेंगे जो तय करेंगे कि रिपॉज़िटरीज़ कैसे प्रोसेस हों। चूँकि हम मॉडल को लोकली नहीं चला रहे, यह क्लाइंट बड़े, पैक्ड प्रॉम्प्ट भेजने और संरचित विश्लेषण आउटपुट प्राप्त करने के लिए केंद्रीय इंटरफ़ेस बन जाता है।
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
इस स्तर पर, एप्लिकेशन openai Python क्लाइंट के जरिए कस्टम base_url और OPENROUTER_API_KEY में संग्रहीत API कुंजी के साथ OpenRouter से होकर Nemotron 3 Super से संचार करता है।
चुना गया मॉडल OpenRouter के होस्टेड एंडपॉइंट की ओर इशारा करता है, जिससे हम बिना लोकल GPU इन्फ्रास्ट्रक्चर के बहुत बड़े मॉडल को चला सकते हैं।
कॉन्टेक्स्ट आकार प्रबंधित करने के लिए, हम एक टोकनाइज़र (tiktoken के साथ cl100k_base) इनिशियलाइज़ करते हैं ताकि मॉडल को भेजने से पहले अंदाज़ा लगा सकें कि पैक की गई रिपॉज़िटरी कितने टोकन लेगी। क्योंकि मॉडल की कॉन्टेक्स्ट विंडो सीमित होती है।
यहाँ कुछ व्यावहारिक विचार:
अब हमें दो सेफ़गार्ड्स की जरूरत है, यानी फाइल फ़िल्टरिंग और प्रॉम्प्ट ग्राउंडिंग।
पहला हमें बिल्ड आउटपुट, नोटबुक्स, इमेजेज़, या बाइनरी फाइलों जैसी अप्रासंगिक कलाकृतियों पर कॉन्टेक्स्ट बर्बाद करने से रोकता है।
दूसरा सुनिश्चित करता है कि एक बार रिपॉज़िटरी पैक हो जाने के बाद, मॉडल वास्तविक कोड पर अँकर रहे—सामान्य सॉफ्टवेयर सलाह में न भटके।
मिलकर, ये नियम रिपो विश्लेषण को अधिक कुशल बनाते हैं।
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
निम्नलिखित तीन फ़िल्टरिंग वेरिएबल्स रिपॉज़िटरी प्रीप्रोसेसिंग को नियंत्रित करते हैं:
BASE_IGNORE_DIRS ऐसी डायरेक्ट्रीज़ को बाहर रखता है जो कोड विश्लेषण के लिए अप्रासंगिक हैं या बहुत शोर करती हैं, जैसे .git, node_modules, बिल्ड फोल्डर्स, और एडिटर-विशिष्ट कैशेज़। IGNORE_SUFFIXES ऐसे फाइल प्रकारों को फ़िल्टर करता है जो आम तौर पर repo रीजनिंग में सहायक नहीं होते—जैसे इमेजेज़, आर्काइव्स, वीडियो, मॉडल चेकपॉइंट्स, और अन्य आर्टिफैक्ट्स। MAX_FILE_BYTES एक अतिरिक्त सुरक्षा जांच देता है—बहुत बड़ी फाइलों को स्किप करके—ताकि पैक की गई रिपॉज़िटरी व्यवहारिक कॉन्टेक्स्ट बजट में रहे।फाइल फ़िल्टर्स जितना ही SYSTEM_PROMPT भी महत्वपूर्ण है।
क्योंकि मॉडल पूरी रिपॉज़िटरी को एक लंबे प्रॉम्प्ट के रूप में देखता है, हमें स्पष्ट व्यवहारिक सीमाएँ देनी होंगी ताकि यह मॉड्यूल गढ़ने, अमूर्तताओं को गलत पढ़ने, या अत्यधिक सामान्य सिफारिशें देने से बचे।
ये निर्देश मॉडल को प्रदत्त रिपॉज़िटरी में ग्राउंडेड रहने, महत्वपूर्ण दावों के लिए फाइल पथ उद्धृत करने, और प्रत्यक्ष साक्ष्यों को सामान्य निर्णय से अलग करने के लिए बाध्य करते हैं।
अब जबकि हमारे पास फाइल फ़िल्टरिंग और एक सिस्टम प्रॉम्प्ट मौजूद है, अगला कदम है रिपॉज़िटरी-स्तरीय कार्यों का सेट परिभाषित करना—प्रत्येक के साथ एक संरचित JSON स्कीमा।
इससे दो बड़े फायदे मिलते हैं: मॉडल को ठीक-ठीक पता रहता है कि किस तरह का आउटपुट देना है, और ऐप परिणामों को भरोसेमंद ढंग से पार्स कर टास्क-विशिष्ट तालिकाओं में रेंडर कर सकता है।
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
TASK_DEFS डिक्शनरी ऐप द्वारा सपोर्ट किए गए सभी विश्लेषण मोड्स के लिए केंद्रीय रजिस्ट्री का काम करती है।
हर टास्क में एक प्राकृतिक-भाषा विवरण होता है जो मॉडल को बताता है कि क्या करना है, और एक सख्त स्कीमा जो अपेक्षित JSON आउटपुट को परिभाषित करता है।
यही वह चीज़ है जो एक ही पैक्ड रिपॉज़िटरी को बहुत अलग तरह की रीजनिंग—जैसे आर्किटेक्चर मैपिंग, डुप्लिकेशन विश्लेषण, ऑनबोर्डिंग गाइडेंस, या टेस्टिंग गैप डिटेक्शन—का समर्थन करने देती है।
उदाहरण के लिए, Architecture Overview मॉडल से निम्नलिखित पहचानने के लिए कहता है:
पूर्ण कोड में अन्य टास्क्स विस्तार से कवर करते हैं:
Code Duplication जो दोहराए गए लॉजिक और संबंधित रिफैक्टर अवसरों पर केंद्रित है,Improvement Opportunities जो मेंटेनबिलिटी और मॉड्यूलैरिटी में सुधार पहचानता है,Testing Gaps जो कम-टेस्टेड क्षेत्रों को हाइलाइट करता है,Onboarding Guide जो बताता है कि नया इंजीनियर कोडबेस को कैसे एप्रोच करे,Library Modernization जो आउटडेटेड या ओवरलैपिंग लाइब्रेरियों को उजागर करता है,Code Quality Hotspots जो भंगुर या बग-प्रवण क्षेत्रों की ओर इशारा करता है,Security या Config Hygiene जो जोखिमपूर्ण डिफॉल्ट्स या ऑपरेशनल मुद्दों को फ़्लैग करता है।FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()FULL_REVIEW_TASKS सूची एक बंडल्ड मल्टी-स्टेप रिव्यू को परिभाषित करती है।
हर संभावित टास्क चलाने के बजाय, यह एक क्यूरेटेड सबसेट चलाता है जो रिपॉज़िटरी का व्यापक इंजीनियरिंग व्यू देता है। इसके बाद TASK_CHOICES सीधे Gradio के ड्रॉपडाउन में उपयोग होता है ताकि यूज़र एकल टास्क या बंडल्ड रिव्यू चुन सके।
आख़िरी भाग, safe_str(), एक हैरान करने वाली महत्वपूर्ण स्थिरता समस्या हल करता है। विकास के दौरान एक सामान्य फेल्यर मोड था:
'NoneType' object has no attribute 'strip'यह तब हो सकता है जब:
None लौटाए,ऐसे सभी मानों को safe_str() फ़ंक्शन से नॉर्मलाइज़ करके, हम ऐप को कहीं अधिक मज़बूत बनाते हैं।
मॉडल को कुछ भेजने से पहले, हमें GitHub रिपॉज़िटरी को एकल संरचित प्रॉम्प्ट में बदलना होगा।
यह चरण पूरी इन्गेशन पाइपलाइन संभालता है—रिपो क्लोन करना, अप्रासंगिक फाइलें फ़िल्टर करना, केवल प्रयोज्य टेक्स्ट निकालना, और सब कुछ ऐसे फ़ॉर्मैट में पैक करना जिसे मॉडल एक ही बार में कंज़्यूम कर सके।
पारंपरिक RAG पाइपलाइंस के विपरीत, हम चंकिंग या एम्बेडिंग नहीं कर रहे। इसके बजाय, हम पूरी रिपॉज़िटरी को एकल लंबे-कॉन्टेक्स्ट इनपुट में संकुचित कर रहे हैं, इसलिए यहाँ चयनात्मक और संरचित होना प्रदर्शन और गुणवत्ता दोनों के लिए महत्वपूर्ण है।
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
यह चरण पूरी रिपॉज़िटरी इन्गेशन और पैकिंग पाइपलाइन परिभाषित करता है, लेकिन हर फ़ंक्शन की एक खास ज़िम्मेदारी है:
clone_repo() फ़ंक्शन: यह फ़ंक्शन शैलो क्लोन (--depth 1) का उपयोग करके GitHub रिपॉज़िटरी को अस्थायी वर्किंग डायरेक्ट्री में क्लोन करता है ताकि पूरा इतिहास न खिंचे। Repo URL और ब्रांच जैसे इनपुट्स को safe_str() से नॉर्मलाइज़ किया जाता है ताकि रनटाइम एरर न हों। आउटपुट एक लोकल पाथ (WORKDIR) है जिस पर पाइपलाइन का बाकी हिस्सा काम करता है।iter_repo_files() फ़ंक्शन: यह मुख्य फ़िल्टरिंग लेयर की तरह काम करता है। यह रिपॉज़िटरी को रेकर्सिवली स्कैन करता है और केवल उच्च-सिग्नल फाइलें यील्ड करता है। यह सिस्टम डायरेक्ट्रीज़, असमर्थित फाइल प्रकार, ओवरसाइज़्ड फाइलें बाहर रखता है और वैकल्पिक रूप से टेस्ट्स, डॉक्स, और नोटबुक्स को फ़िल्टर करता है। is_probably_text() फ़ंक्शन: यह फ़िल्टरिंग के दौरान उपयोग की जाने वाली एक हल्की सुरक्षा जाँच है। यह हर फाइल का छोटा सा हिस्सा पढ़ता है और null बाइट्स की अनुपस्थिति (जो आमतौर पर बाइनरी कंटेंट का संकेत है) और सफल UTF-8 डिकोडिंग की पुष्टि करता है। केवल वे फाइलें जो यह जाँच पास करती हैं, वैध टेक्स्ट मानी जाती हैं और अंतिम डेटासेट में शामिल होती हैं।repo_tree_string() फ़ंक्शन: यह रिपॉज़िटरी संरचना का स्ट्रिंग प्रतिनिधित्व बनाता है। यह डायरेक्ट्री ट्री बनाता है (उसी फ़िल्टरिंग नियमों को लागू करते हुए) और डायरेक्ट्रीज़ व फाइलों की सूची आउटपुट करता है, जिसे प्रॉम्प्ट में उपयोग किया जाता है ताकि मॉडल फाइल कंटेंट पढ़ने से पहले कोडबेस लेआउट का उच्च-स्तरीय समझ पा ले।pack_repo() फ़ंक्शन: यह कोर पैकिंग फ़ंक्शन है। यह सभी फ़िल्टर्ड फाइलों पर इटरेट करता है, उनका कंटेंट पढ़ता है, और हर फाइल को === FILE START === और === FILE END === जैसे स्पष्ट मार्कर्स के भीतर रैप करता है। यह tiktoken से टोकन उपयोग का अनुमान भी लगाता है और कुल टोकन काउंट जोड़ता है। build_repo_context() फ़ंक्शन: यह सब कुछ एकल संरचित प्रॉम्प्ट में जोड़ता है। यह पहले रिपो ट्री रखता है, उसके बाद सभी फाइल कंटेंट्स। मॉडल पहले संरचना समझता है, फिर वास्तविक इम्प्लीमेंटेशन डिटेल्स पढ़ता है।कुल मिलाकर, एक कच्ची GitHub रिपॉज़िटरी को एकल, संरचित लंबे-कॉन्टेक्स्ट इनपुट में बदल दिया जाता है।
अब जब रिपॉज़िटरी को फ़िल्टर और पैक कर एकल लंबे-कॉन्टेक्स्ट इनपुट बना लिया गया है, अगला कदम है मॉडल को बताना कि किस तरह का विश्लेषण करना है और परिणाम किस फ़ॉर्मैट में देना है।
हर उपयोग-परिदृश्य के लिए एक जैसा सामान्य निर्देश भेजने के बजाय, हम एक टास्क-विशिष्ट प्रॉम्प्ट जनरेट करते हैं जिसमें चुने गए टास्क का नाम, उसका विवरण, और रिस्पॉन्स में अपेक्षित सटीक JSON स्कीमा शामिल होता है।
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("")
        end = text.rfind("")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
उपरोक्त कोड स्निपेट दो क़रीबी संबंधित फ़ंक्शंस परिभाषित करता है जो पैक्ड रिपॉज़िटरी और टास्क-विशिष्ट विश्लेषण आउटपुट के बीच पुल का काम करते हैं।
build_task_prompt() फ़ंक्शन: यह वह अंतिम प्रॉम्प्ट बनाता है जो मॉडल को भेजा जाता है। यह पहले safe_str() से टास्क नाम नॉर्मलाइज़ करता है ताकि खाली इनपुट पाइपलाइन न तोड़े। फिर यह जाँचता है कि टास्क TASK_DEFS में मौजूद है, जिससे असमर्थित या गलत-स्पेल किए गए टास्क नाम भेजने से बचाव होता है। टास्क वैध होने पर, फ़ंक्शन उसका विवरण और JSON स्कीमा प्राप्त करता है, और दोनों को पूरे पैक्ड रिपॉज़िटरी कॉन्टेक्स्ट के साथ अंतिम प्रॉम्प्ट में एम्बेड कर देता है।try_parse_json() फ़ंक्शन: यह इन्फरेंस के बाद मॉडल के आउटपुट को संभालता है। व्यवहार में, लंबे-कॉन्टेक्स्ट वाले मॉडल कभी-कभी JSON को अतिरिक्त टेक्स्ट, फ़ॉर्मैटिंग आर्टिफेक्ट्स, या आंशिक व्याख्यात्मक कंटेंट के साथ रैप कर देते हैं। ऐप को अधिक मज़बूत बनाने के लिए, try_parse_json() पहले orjson.loads() से डायरेक्ट पार्सिंग की कोशिश करता है। सख्त प्रॉम्प्टिंग और सहिष्णु पार्सिंग के संयोजन से ऐप कहीं अधिक स्थिर रहता है।अगले चरण में, हम इस प्रॉम्प्टिंग लॉजिक को मॉडल कॉल से जोड़ेंगे और संरचित रिपॉज़िटरी विश्लेषण परिणाम जनरेट करना शुरू करेंगे।
इस स्तर पर, हम OpenRouter के जरिए Nemotron 3 Super को प्रॉम्प्ट भेजकर विश्लेषण चलाते हैं।
रिपो के हिस्सों को चंक या रिट्रीव करने के बजाय, हम पूरी फ़िल्टर्ड कोडबेस को एक ही रिक्वेस्ट में भेजते हैं और मॉडल को फाइलों, मॉड्यूल्स, और डिपेंडेंसीज़ पर वैश्विक रूप से रीजन करने देते हैं।
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
call_model() फ़ंक्शन वास्तविक मॉडल कॉल को निष्पादित करने और रिस्पॉन्स निकालने के लिए ज़िम्मेदार है। पूरी पाइपलाइन इस प्रकार है:
0.2 सेट है, जो आउटपुट्स को निर्धारक रखता है, और max_tokens रिस्पॉन्स साइज़ सीमित करता है ताकि मॉडल संरचित आउटपुट पर केंद्रित रहे।अंत में, हम अगला मॉडल इन्फरेंस भाग पर बढ़ सकते हैं और समझ सकते हैं कि OpenRouter होस्टेड मॉडल के माध्यम से विश्लेषण कैसे चलाते हैं।
अब हमें कुछ छोटे सहायक फ़ंक्शंस चाहिए जो UI और आउटपुट हैंडलिंग को आसान बनाते हैं।
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
यह चरण सहायक फ़ंक्शनों का एक छोटा सेट परिभाषित करता है, जो मिलकर ऐप की प्रस्तुति लॉजिक के अधिकांश हिस्से को संभालते हैं।
to_df() फ़ंक्शन: यह फ़ंक्शन मॉडल के आउटपुट को pandas DataFrame में बदलता है ताकि उन्हें Gradio तालिकाओं में साफ़-सुथरे तरीके से प्रदर्शित किया जा सके। get_tasks_to_run() फ़ंक्शन: यह फ़ंक्शन तय करता है कि ऐप एकल टास्क चलाए या बंडल किया हुआ Full Review। यदि चयनित टास्क "Full Review" है, तो यह पूर्वनिर्धारित समीक्षा टास्कों की सूची में विस्तार करता है। अन्यथा, यह चयनित टास्क के साथ एक-आइटम सूची लौटाता है। visible_for_task() फ़ंक्शन: यह फ़ंक्शन नियंत्रित करता है कि UI में कौन-सी रिपोर्ट तालिकाएँ वास्तव में दिखाई जानी चाहिएँ। उदाहरण के लिए, यदि उपयोगकर्ता Onboarding Guide चुनता है, तो डुप्लीकेशन या सुरक्षा तालिकाएँ दिखाने का कोई लाभ नहीं है। render_markdown_summary() फ़ंक्शन: कच्चा JSON सीधे प्रस्तुत करने के बजाय, यह फ़ंक्शन रिपॉज़िटरी मेटाडेटा, टोकन गिनती और टास्क-विशिष्ट मुख्य बिंदुओं के साथ एक पठनीय सारांश बनाता है।hidden_update() और visible_update() फ़ंक्शन्स: ये छोटे Gradio सहायक हैं जो कॉम्पोनेंट की स्थिति को नियंत्रित करने के लिए उपयोग होते हैं। hidden_update() फ़ंक्शन तालिका को साफ़ करता है और छुपा देता है, जबकि visible_update() डेटा से तालिका भरता है और उसे दृश्य बनाता है। यह पैटर्न महत्वपूर्ण है क्योंकि Gradio प्रत्येक आउटपुट कॉम्पोनेंट के लिए एक रिटर्न वैल्यू की अपेक्षा करता है, और बिना स्पष्ट रीसेट के समस्याएँ हो सकती हैं।empty_outputs() फ़ंक्शन: यह फ़ंक्शन शुरुआती निकास और त्रुटि स्थितियों को संभालता है। यदि रिपॉज़िटरी बहुत बड़ी है, टास्क अमान्य है, या कुछ और विफल हो जाता है, तब भी ऐप को हर UI कॉम्पोनेंट के लिए वैध आउटपुट लौटाने की आवश्यकता होती है। मिलकर, ये सहायक फ़ंक्शन कोर मॉडल लॉजिक को नहीं बदलते, लेकिन वे एक उपयोगी एप्लिकेशन बना देते हैं।
यह फ़ंक्शन पूरे वर्कफ़्लो का समन्वय करता है। यह इनपुट मान्य करता है, रिपॉज़िटरी तैयार करता है, एक या अधिक विश्लेषण टास्क चलाता है, और Gradio UI को संरचित आउटपुट वापस करता है।
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
यह फ़ंक्शन कच्ची रिपॉज़िटरी से लेकर संरचित आउटपुट तक पूरे पाइपलाइन का संचालन करता है।
results डिक्शनरी में संग्रहीत किया जाता है।to_df() का उपयोग करके DataFrame में बदला जाता है और UI कॉम्पोनेंट्स से मैप किया जाता है। दृश्यता visible_for_task() के माध्यम से नियंत्रित की जाती है, ताकि चयनित टास्क के लिए केवल प्रासंगिक तालिकाएँ दिखाई दें।empty_outputs() के माध्यम से सुरक्षित रूप से संभाली जाती हैं ताकि UI स्थिर रहे।अंत में, हम अब सब कुछ एक साधारण Gradio इंटरफ़ेस में लपेटते हैं।
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
gr.Blocks() कंटेनर ऐप का समग्र लेआउट परिभाषित करता है, जबकि शीर्ष-स्तरीय Markdown शीर्षक और संदर्भ सेट करता है। इंटरफ़ेस को वर्कफ़्लो को संरचित रखने के लिए तीन टैब्स में विभाजित किया गया है।
यह उपयोगकर्ता इनपुट्स को सीधे analyze_repo() फ़ंक्शन से जोड़ता है और उसके आउटपुट को वापस UI कॉम्पोनेंट्स पर मैप करता है। यहाँ आउटपुट्स का क्रम अत्यंत महत्वपूर्ण है, क्योंकि प्रत्येक लौटाई गई वैल्यू किसी विशिष्ट UI एलिमेंट तक रूट होती है।
अंत में, ऐप को इस प्रकार लॉन्च किया जाता है:
demo.launch(debug=True, share=True)debug=True फ़्लैग विकास के दौरान रनटाइम त्रुटियों को सतह पर लाने में मदद करता है, जबकि share=True एक सार्वजनिक लिंक बनाता है, जिससे बिना डिप्लॉयमेंट के ऐप साझा करना आसान हो जाता है।
इस ट्यूटोरियल में, मैंने NVIDIA Nemotron 3 Super, OpenRouter, और Gradio का उपयोग करके एक रिपॉज़िटरी कोडबेस विश्लेषक बनाना दिखाया।
चंकिंग, एम्बेडिंग्स और रिट्रीवल पर निर्भर होने के बजाय, ऐप एक सार्वजनिक GitHub रिपॉज़िटरी को क्लोन करता है, कोडबेस को फ़िल्टर करके एक ही प्रॉम्प्ट में पैक करता है, और मॉडल से पूरी रिपॉज़िटरी पर एक साथ विवेचना करने के लिए कहता है।
यह सम्पूर्ण-संदर्भ दृष्टिकोण उन कार्यों के लिए उपयोगी है जिन्हें कोडबेस का वैश्विक दृश्य चाहिए, जैसे आर्किटेक्चर समझाना, ऑनबोर्डिंग मार्गदर्शन, टेस्टिंग गैप विश्लेषण, सुधार के अवसर, और रिफैक्टर योजना।
यहाँ से, आप कई तरीकों से प्रोजेक्ट का विस्तार कर सकते हैं:
Top DataCamp Courses
कोर्स
कोर्स
कोर्स