

{count, plural, one {Lộ trình} other {Lộ trình}}
Trí tuệ nhân tạo trong Kỹ thuật phần mềm
{hours} giờ
Anthropic đã phát hành Claude Opus 4.7, phiên bản mới nhất thuộc cấp độ mẫu chủ lực của hãng. Điểm cải tiến nổi bật là tính tự chủ: Anthropic định vị đây là mẫu bạn có thể giao các công việc mã hoá và tác tử khó nhất, chạy lâu nhất mà không cần giám sát sát sao.
Trong bản phát hành này, chúng ta cũng biết rằng có một trần hiệu năng phía trên Opus 4.7. Mythos Preview nội bộ của Anthropic đạt điểm cao hơn ở một số bộ chuẩn, nhưng bị hoãn phát hành rộng rãi trong khi Anthropic kiểm thử các biện pháp bảo vệ an ninh mạng. Với bất kỳ ai không phải nhà nghiên cứu nội bộ của Anthropic, Opus 4.7 là trần hiện tại.
Trong bài viết này, chúng tôi sẽ cùng xem có gì thực sự mới ở Opus 4.7, đi sâu vào kết quả benchmark và chia sẻ các bài kiểm thử thực tế bạn có thể tự chạy. Bạn cũng có thể xem các hướng dẫn của chúng tôi về những mẫu đối thủ mới công bố, như Muse Spark của Meta, GPT-5.5 của OpenAI GPT-5.5, và Gemini 3.1 của Google.
Cập nhật: Ngày 28 tháng 5 năm 2026, Anthropic đã phát hành mẫu kế nhiệm. Đọc tất cả trong hướng dẫn Claude Opus 4.8 của chúng tôi.
Claude Opus 4.7 là mẫu ngôn ngữ lớn chủ lực mới nhất của Anthropic, đứng đầu họ mẫu Claude, trên Sonnet và Haiku. Mẫu này kế tiếp Claude Opus 4.6 và được thiết kế cho các tác vụ đòi hỏi khắt khe nhất, như quy trình tác tử phức tạp và các bài toán suy luận nhiều bước yêu cầu duy trì hiệu năng trong các phiên làm việc dài.
So với Opus 4.6, bản 4.7 tập trung vào ba lĩnh vực:
Mythos Preview nội bộ của Anthropic, như đã đề cập và chúng tôi cũng có phần Hỏi đáp, dẫn đầu ở một số benchmark, nhưng chưa được phát hành rộng rãi. Về bản chất, Opus 4.7 là một mẫu “anh em” được huấn luyện với các năng lực an ninh mạng cố ý giảm bớt.
Anthropic cho biết một số mảng năng lực đã được cải thiện đáng kể ở Opus 4.7.
Opus 4.7 tuân thủ hướng dẫn sát hơn so với các mẫu trước. Dĩ nhiên đây là một đặc tính hữu ích cho bất kỳ quy trình nào phụ thuộc vào độ tin cậy, nhưng cũng có thể gây hệ quả ngoài ý muốn: Anthropic khuyên người dùng tinh chỉnh lại prompt và khung chạy, vì các chỉ dẫn mà các mẫu trước đây bỏ qua hoặc diễn giải lỏng lẻo nay sẽ được hiểu theo nghĩa đen.
Khả năng thị giác độ phân giải cao được cải thiện để hỗ trợ ảnh lên đến 3,75 megapixel, tức hơn gấp ba lần so với các mẫu cũ. Các tác tử sử dụng máy tính và quy trình trích xuất dữ liệu có thể hưởng lợi lớn từ độ chi tiết tăng lên này, vì chúng phụ thuộc vào khả năng đọc và độ chính xác, đôi khi tới mức từng điểm ảnh.
Opus 4.7 giỏi hơn với bộ nhớ dựa trên hệ thống tệp, tức là mô thức khi mẫu viết ghi chú vào tệp trong lúc làm việc và đọc lại ở các lần chạy sau.
Claude Code là bối cảnh rõ ràng nhất: một tệp CLAUDE.md ở thư mục gốc dự án mà Claude đọc khi phiên bắt đầu, cập nhật khi ra quyết định và sử dụng khi bạn quay lại làm việc.
“Tốt hơn” ở đây nghĩa là có phán đoán tốt hơn về những gì đáng để ghi lại và khả năng hồi tưởng tin cậy hơn ở các lượt sau. Anthropic nói điều này giúp các tác vụ mới “cần ít ngữ cảnh ban đầu hơn” — nếu bạn từng phải giải thích lại quy ước dự án cho mẫu đến lần thứ năm như chúng tôi, bạn sẽ thấy đáng giá.
Vậy, kết luận thực tế: Nếu bạn dùng Opus 4.7 cho công việc đa phiên, hãy để nó ghi chú. Nó sẽ làm tốt việc đó hơn Opus 4.6, dù chúng tôi thấy Opus 4.6 cũng đã ghi chú khá ổn.
Anthropic cho biết Claude Opus 4.7 đã có những cải tiến đáng kể ở các mảng sau.
Chúng tôi tạo một số bài kiểm thử riêng để “soi” các tuyên bố này.
Để kiểm thử khả năng tuân thủ hướng dẫn của Opus 4.7, chúng tôi dùng prompt chi tiết sau để “stress-test”. Nó có 12 ràng buộc riêng biệt mà chúng ta có thể kiểm tra ở cuối.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Và đây là kết quả:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Giờ là lúc chấm điểm. Đây là thang chấm của chúng tôi:
|
# |
Ràng buộc |
Cách kiểm tra |
|
1 |
Đúng 4 đoạn (cộng dòng kết) |
Đếm ngắt đoạn |
|
2 |
Đoạn 2 bắt đầu bằng "Historically" |
Xem từ đầu tiên |
|
3 |
Mỗi đoạn có 3–5 câu |
Đếm câu mỗi đoạn |
|
4 |
Không có từ bị cấm |
Ctrl+F từng từ |
|
5 |
Đúng 2 câu trích dẫn, đều có gán nguồn, không có trích dẫn nào khác |
Đếm dấu ngoặc kép |
|
6 |
Một đối tác có họ bắt đầu bằng chữ M |
Kiểm tra phần gán nguồn |
|
7 |
Dòng kết tách bằng một dòng trống |
Kiểm tra trực quan |
|
8 |
Dòng kết là một câu hỏi |
Kết thúc bằng "?" |
|
9 |
Chính tả Anh-Anh |
Ctrl+F "organization", "color", "realize", v.v. |
|
10 |
Không có gạch đầu dòng, đánh số, tiêu đề |
Kiểm tra trực quan |
|
11 |
Tên khách hàng hư cấu xuất hiện một lần, in nghiêng |
Ctrl+F ký tự hoa thị |
|
12 |
Độ dài 280–320 từ |
Dán vào bộ đếm từ |
Chúng tôi sẽ giúp bạn khỏi phải rà từng mục. Mẫu đạt 11/12.
Mọi thứ đều hoàn hảo cho đến cuối cùng, nó vượt giới hạn số từ một chút (325 từ, trong khi giới hạn là 320).
Chúng tôi áp dụng cùng bài test cho Claude Sonnet 4.6, và mẫu đó cũng thực hiện đúng 11/12 chỉ dẫn, thất bại ở cùng chỗ (đếm từ). Nhưng chúng tôi vẫn coi Opus 4.7 là cải tiến vì Sonnet 4.6 vượt giới hạn rất nhiều (400 từ).
Ở bài kiểm thử thứ hai, chúng tôi đưa cho Opus 4.7 một hình ảnh khó đọc:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
Kèm theo chỉ dẫn này, chúng tôi đưa cho Opus 4.7 một ảnh chụp màn hình xuống cấp của biểu đồ thương mại Scotland năm 1786 của Playfair, lấy từ bài viết về Ví dụ trực quan hoá dữ liệu của chúng tôi.
Chúng tôi biết có thể kiểm chứng đầu ra vì có phiên bản độ phân giải cao từ Wikipedia. Đây là hình ảnh Opus 4.7 nhìn thấy:
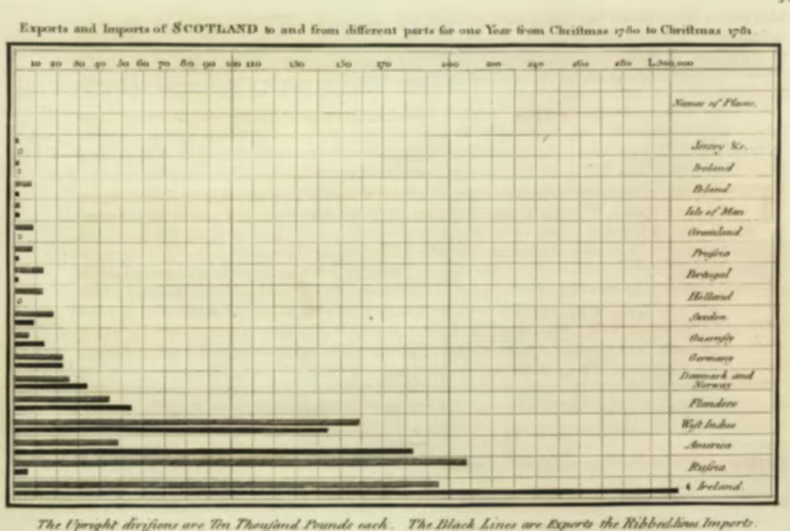
Đây là phần đọc của Opus 4.7:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
Chúng tôi biết bài test này có thể khó, vì trục x của biểu đồ Playfair thực sự thay đổi cách đếm giữa chừng (mỗi 10 đến 110, rồi các chục lẻ 130/150/170, rồi các chục chẵn 200/220/240/260/280). Nhưng Opus 4.7 đã đọc đúng trục ngay ở lần đầu dù cách đếm khá “lạ”.
Một điều vẫn khiến chúng tôi thấy vui vui: chúng tôi thích khi các mẫu AI thể hiện mức độ không chắc chắn, nhưng “[?]oland” lẽ ra phải được đọc tự tin là “Poland” và “Gr[oe]nland” là “Greenland.” Dù chúng tôi không có thang chấm chính thức cho bài này, chấm công bằng thì khoảng 9/10.
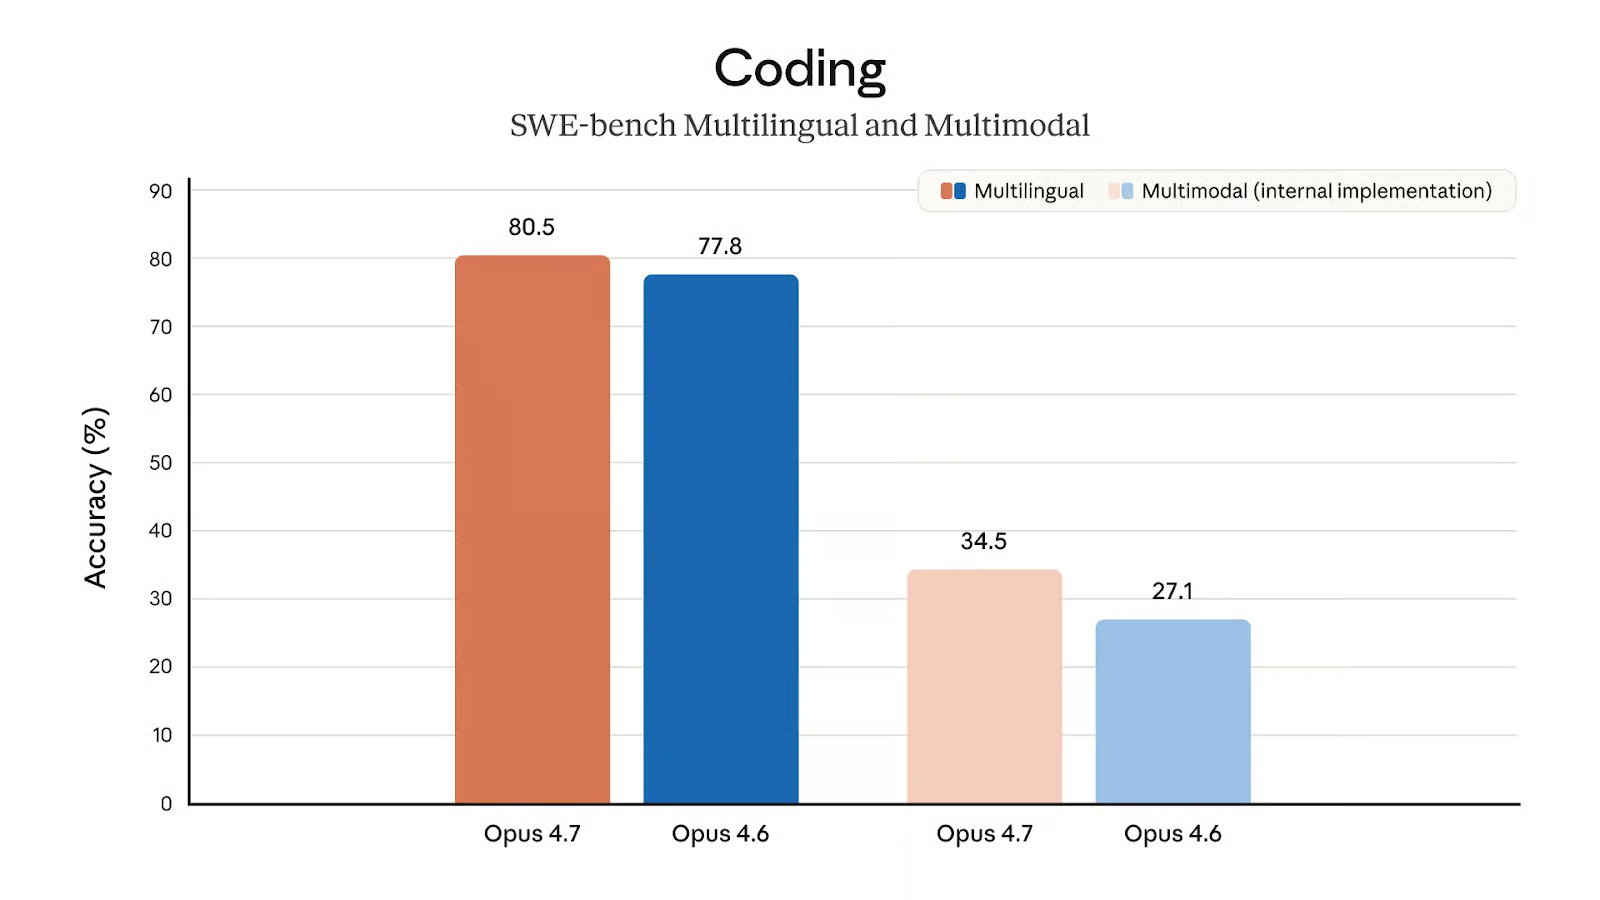
Opus 4.7 được đánh giá qua 14 benchmark bao phủ mã hoá, suy luận, dùng công cụ, dùng máy tính và suy luận thị giác. Bảng dưới cho thấy so sánh đầy đủ với Opus 4.6, GPT 5.4, Gemini 3.1 Pro và Mythos Preview (chưa phát hành).
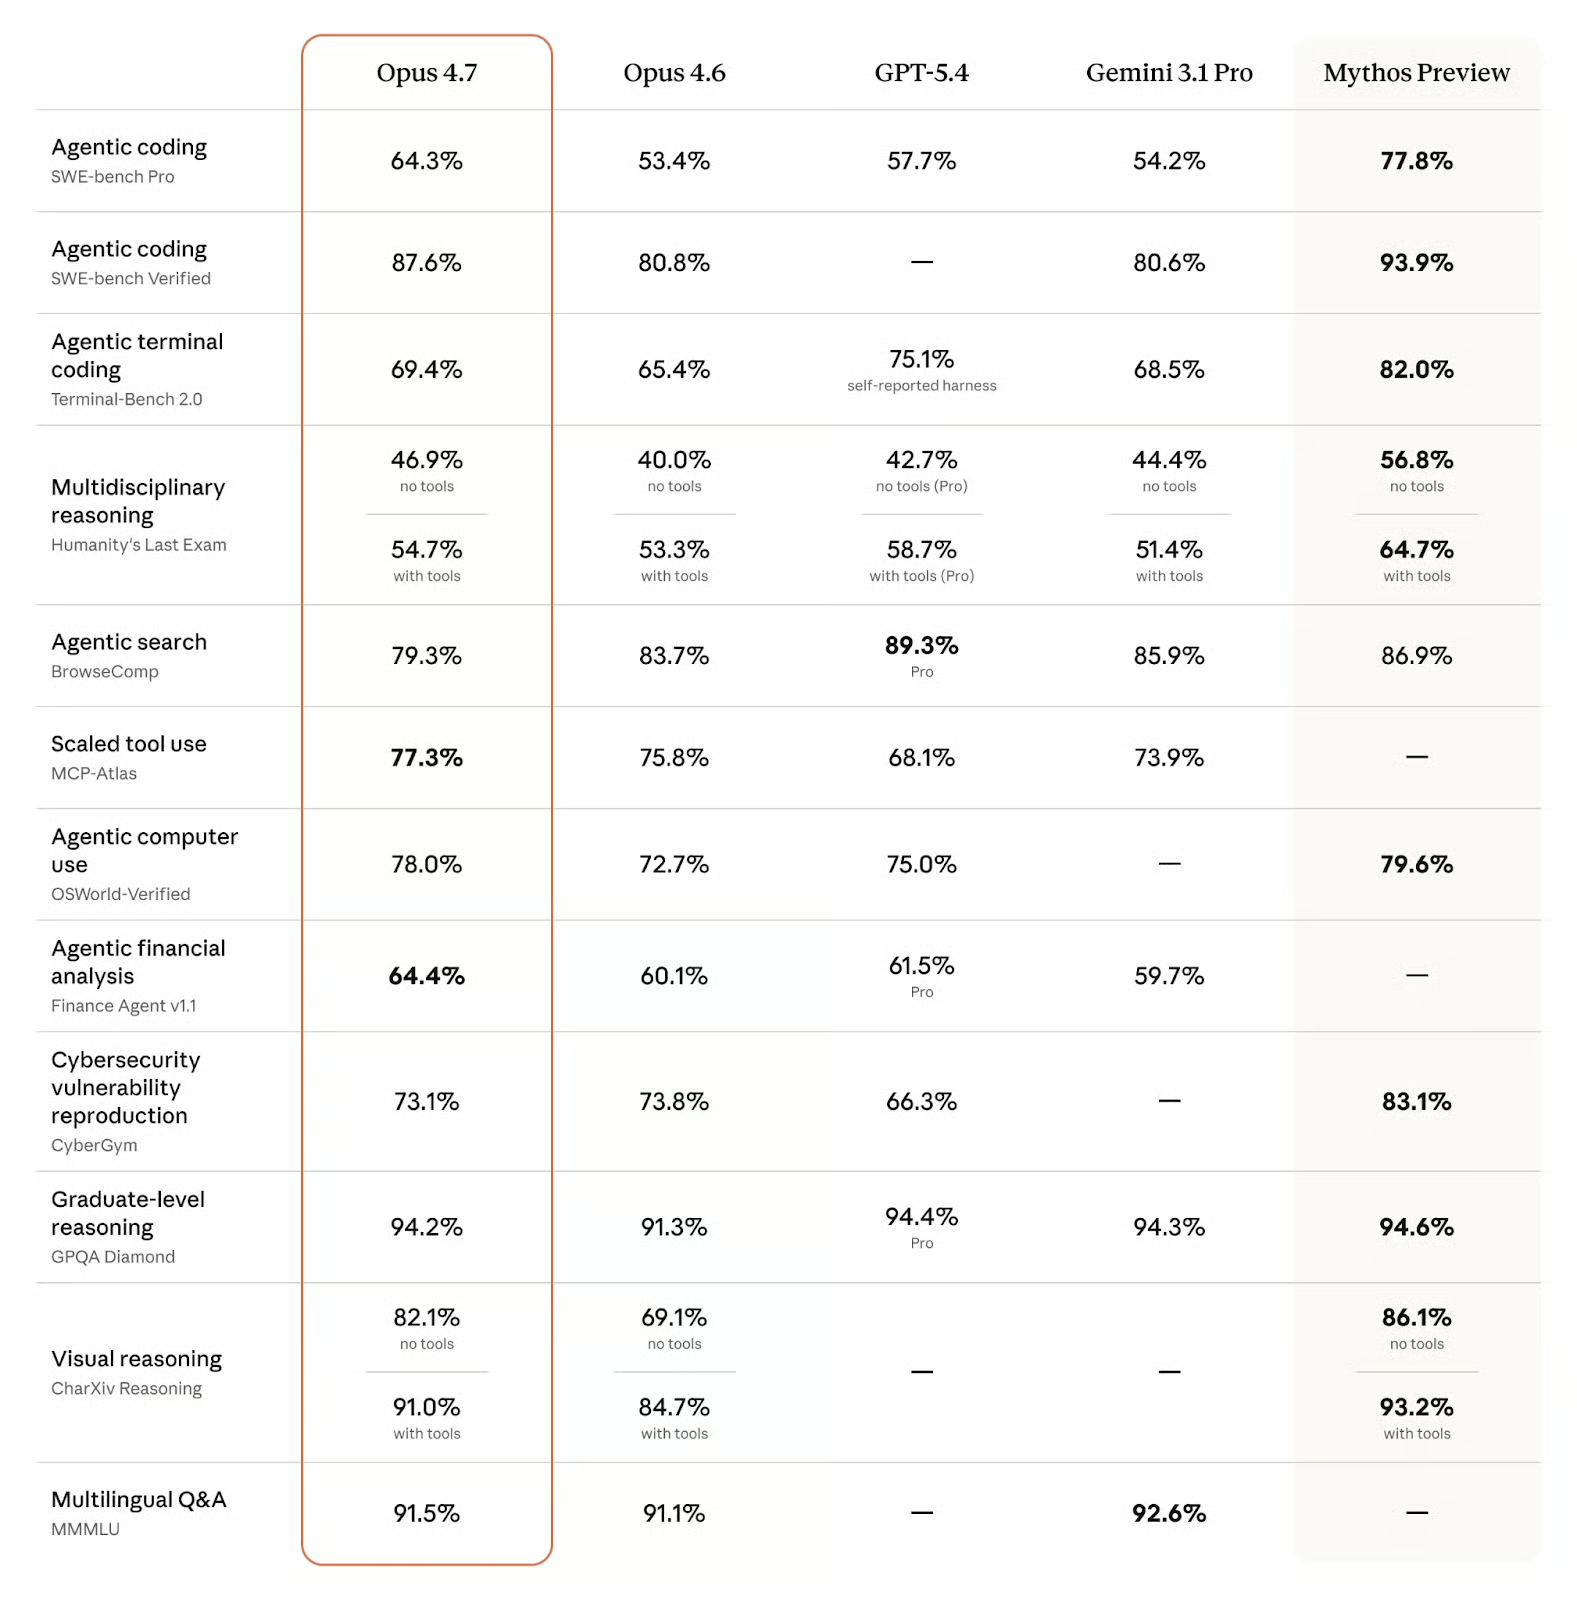
Trên SWE-bench Pro, Opus 4.7 đạt 64,3%, vượt GPT-5.4 ở mức 57,7%, Gemini 3.1 Pro ở mức 54,2% và Opus 4.6 ở mức 53,4%. Trên SWE-bench Verified, Opus 4.7 đạt 87,6% so với 80,6% của Gemini 3.1 Pro và 80,8% của Opus 4.6. GPT-5.4 không có điểm công bố trên SWE-bench Verified trong so sánh này.
SWE-bench kiểm tra khả năng của mẫu trong việc giải quyết các issue thực trên GitHub trong các kho mã Python nguồn mở. Bản Pro khó hơn với các issue phức tạp hơn. Mức tăng 10,9 điểm so với Opus 4.6 trên SWE-bench Pro là cải thiện lớn nhất trong bản phát hành này (tính theo điểm phần trăm) và đưa Opus 4.7 vượt rõ rệt cả hai đối thủ lớn ở tác vụ này.
Chỉ có Mythos Preview nội bộ của Anthropic đạt 77,8% trên SWE-bench Pro và 93,9% trên SWE-bench Verified, cho thấy vẫn còn khoảng trống phía trên Opus 4.7. Dẫu vậy, Mythos chưa phát hành rộng rãi, nên cho mục đích sản xuất, Opus 4.7 là trần hiện tại.
Kết quả với Terminal-Bench 2.0, benchmark tiêu chuẩn cho mã hoá tác tử trong terminal, khá thú vị. Opus 4.7 cải thiện nhẹ so với tiền nhiệm (69,4% so với 65,4%) và vượt Gemini 3.1 Pro (68,5%).
Tuy nhiên, ở khía cạnh này, nó không thể cạnh tranh với GPT-5.4 (75,1%), dù lưu ý tự báo cáo về điểm của GPT-5.4 cũng đáng cân nhắc khi so sánh. Dẫu vậy, có thể Anthropic sẽ đôi chút thất vọng khi mẫu chủ lực mới (đã phát hành) của họ không đứng đầu một benchmark trọng yếu cho phát triển phần mềm theo hướng tác tử.
Humanity's Last Exam là tập hợp các câu hỏi trình độ sau đại học về khoa học, toán học và nhân văn, được thiết kế để làm khó các mẫu tiên phong hiện tại. Opus 4.7 dẫn đầu biến thể không dùng công cụ, kiểm tra khả năng suy luận thuần tuý không truy xuất bên ngoài. Khoảng cách ở biến thể có công cụ nghiêng về GPT-5.4 (58,7%) là khu vực rõ ràng nhất nơi Opus 4.7 (54,7%) không dẫn đầu.
Suy luận trình độ sau đại học thường được đo bằng GPQA-Diamond, vốn đã “bão hoà” dạo gần đây: Tương tự các mẫu tiên phong hiện tại, cả bốn mẫu so sánh đều đạt trên 90% và gần như ngang nhau.
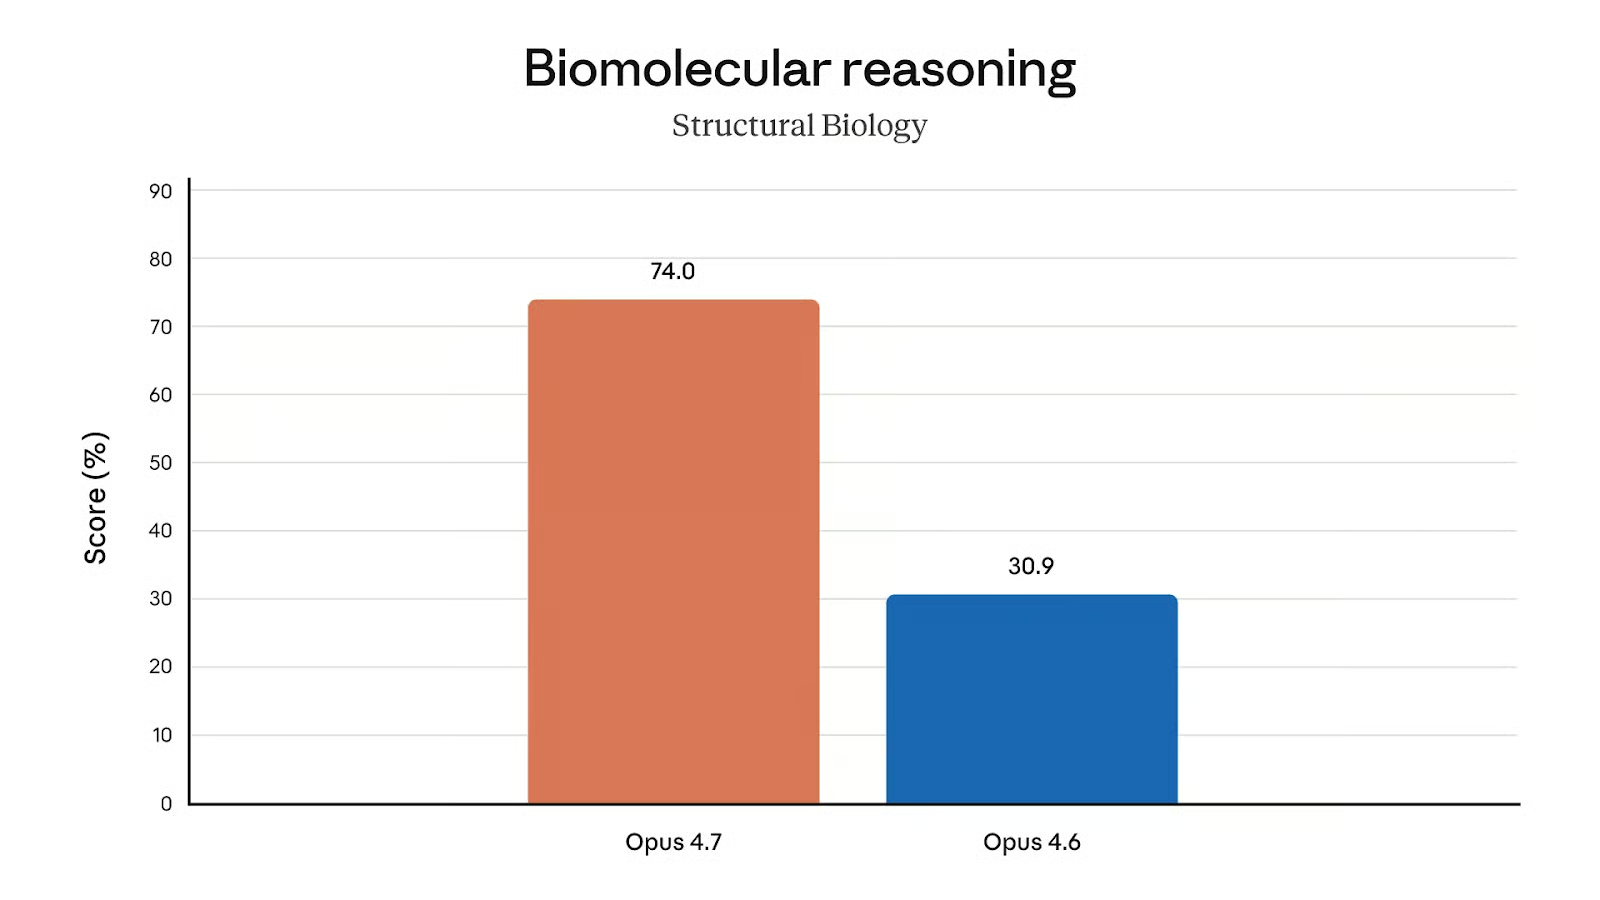
Một kết quả benchmark thú vị hơn nhắm vào sinh học, một trong các lĩnh vực cũng được GPQA-Diamond kiểm tra. Dù không so với đối thủ, cú nhảy từ Opus 4.6 (30,9%) lên Opus 4.7 (74,0%) chắc chắn đáng chú ý!
Kết quả trên CharXiv, bộ đo suy luận thị giác về biểu đồ và hình ảnh khoa học, phản ánh đây là một trong những trọng tâm phát triển của Opus 4.7.
Mức tăng 13 điểm ở biến thể không dùng công cụ là cải thiện tương đối lớn nhất trong bản phát hành này. Không có điểm của đối thủ để so, khó nói vị trí của Opus 4.7 trong toàn cảnh ở tác vụ này, nhưng mức cải thiện so với Opus 4.6 là đáng kể.
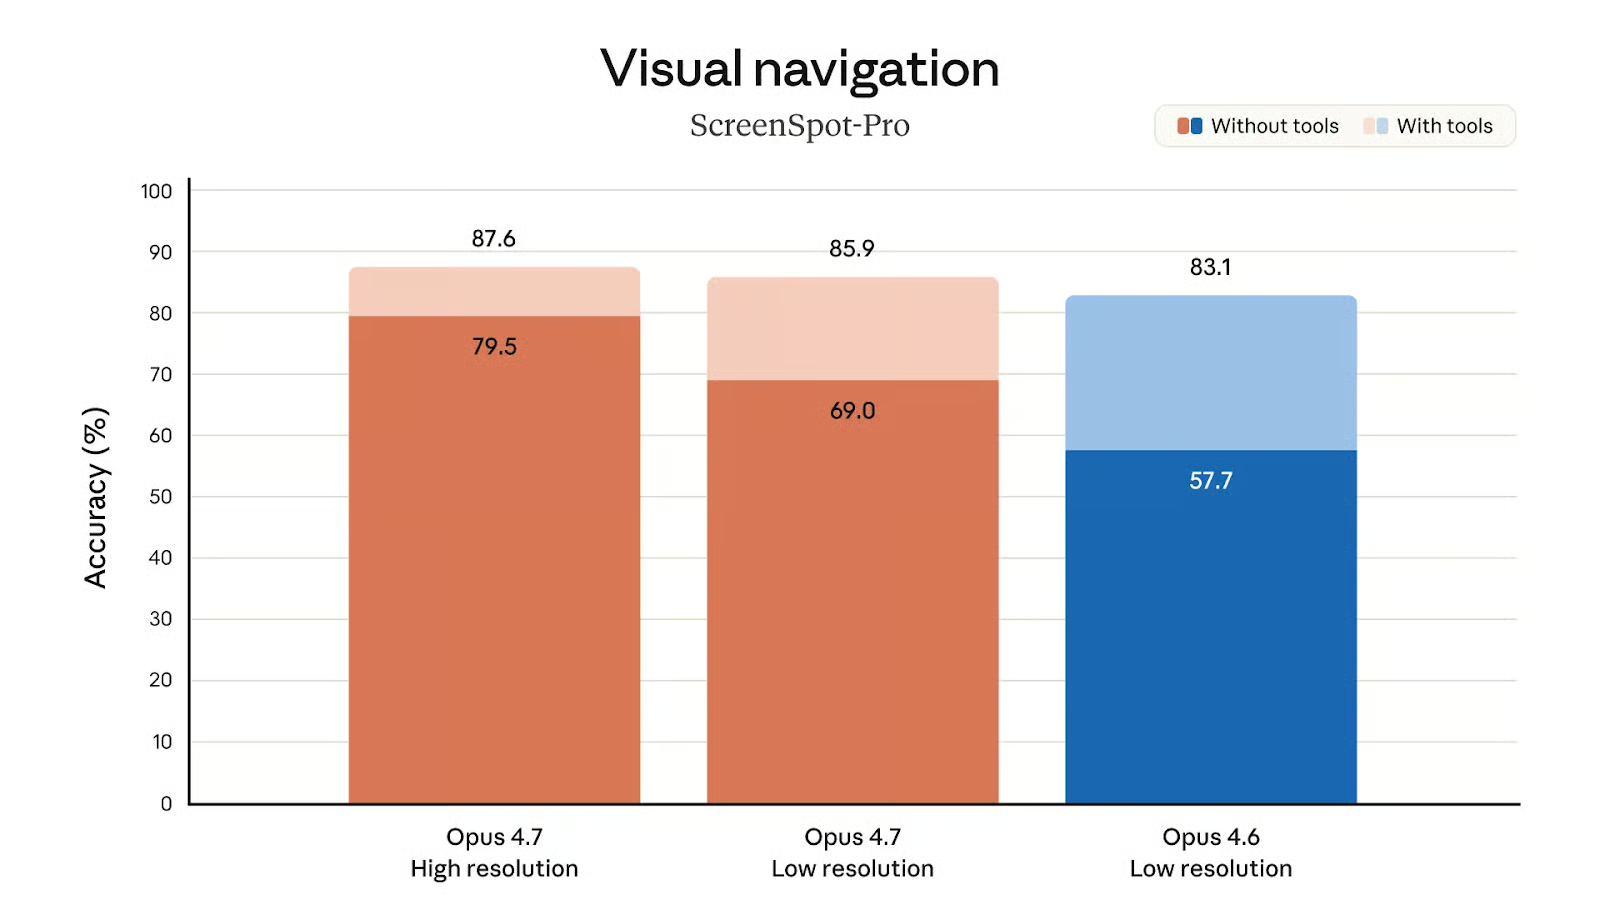
Hỗ trợ ảnh độ phân giải cao hơn có lẽ là một lý do cho việc cải thiện suy luận thị giác. Biểu đồ điểm Screenspot-Pro ở các độ phân giải khác nhau cho thấy cú tăng độ chính xác lớn mà Opus 4.7 có được từ độ phân giải cao hơn, đặc biệt khi không dùng công cụ (79,5% so với 69,0%).
MCP-Atlas kiểm tra hiệu năng qua các quy trình phức tạp, đa công cụ. Opus 4.7 đạt 77,3%, cao nhất trong các mẫu so sánh. Mẫu duy nhất nhỉnh hơn Opus 4.7 một chút ở MCP-Atlas là Muse Spark, được báo cáo ở mức 78,3%.
OSWorld kiểm tra khả năng của mẫu trong việc hoàn thành tác vụ bằng cách điều khiển giao diện máy tính, nhấp, gõ và điều hướng ứng dụng. Opus 4.7 đạt 78,0%, tăng từ 72,7% của Opus 4.6. GPT-5.4 đạt 75,0%, còn Gemini 3.1 Pro không có điểm công bố cho benchmark này. Mythos Preview đạt 79,6%, nhỉnh hơn Opus 4.7 một chút.
Đây chắc chắn là mảng Opus 4.7 xuất sắc: Mẫu dẫn đầu cả MCP-Atlas và OSWorld-Verified với khoảng cách đáng kể so với các mẫu chủ lực của Google và OpenAI — một kết quả mạnh mẽ cho những ai xây dựng hệ thống tác tử sản xuất dựa vào điều phối công cụ và tác tử dùng máy tính.
Kỹ năng phân tích tài chính của mẫu xứng đáng được nhắc đến: Opus 4.7 đứng đầu bảng xếp hạng Finance Agent v1.1 (64,4%), vượt đáng kể GPT-5.4 (61,5%) và Gemini 3.1 Pro (59,7%).
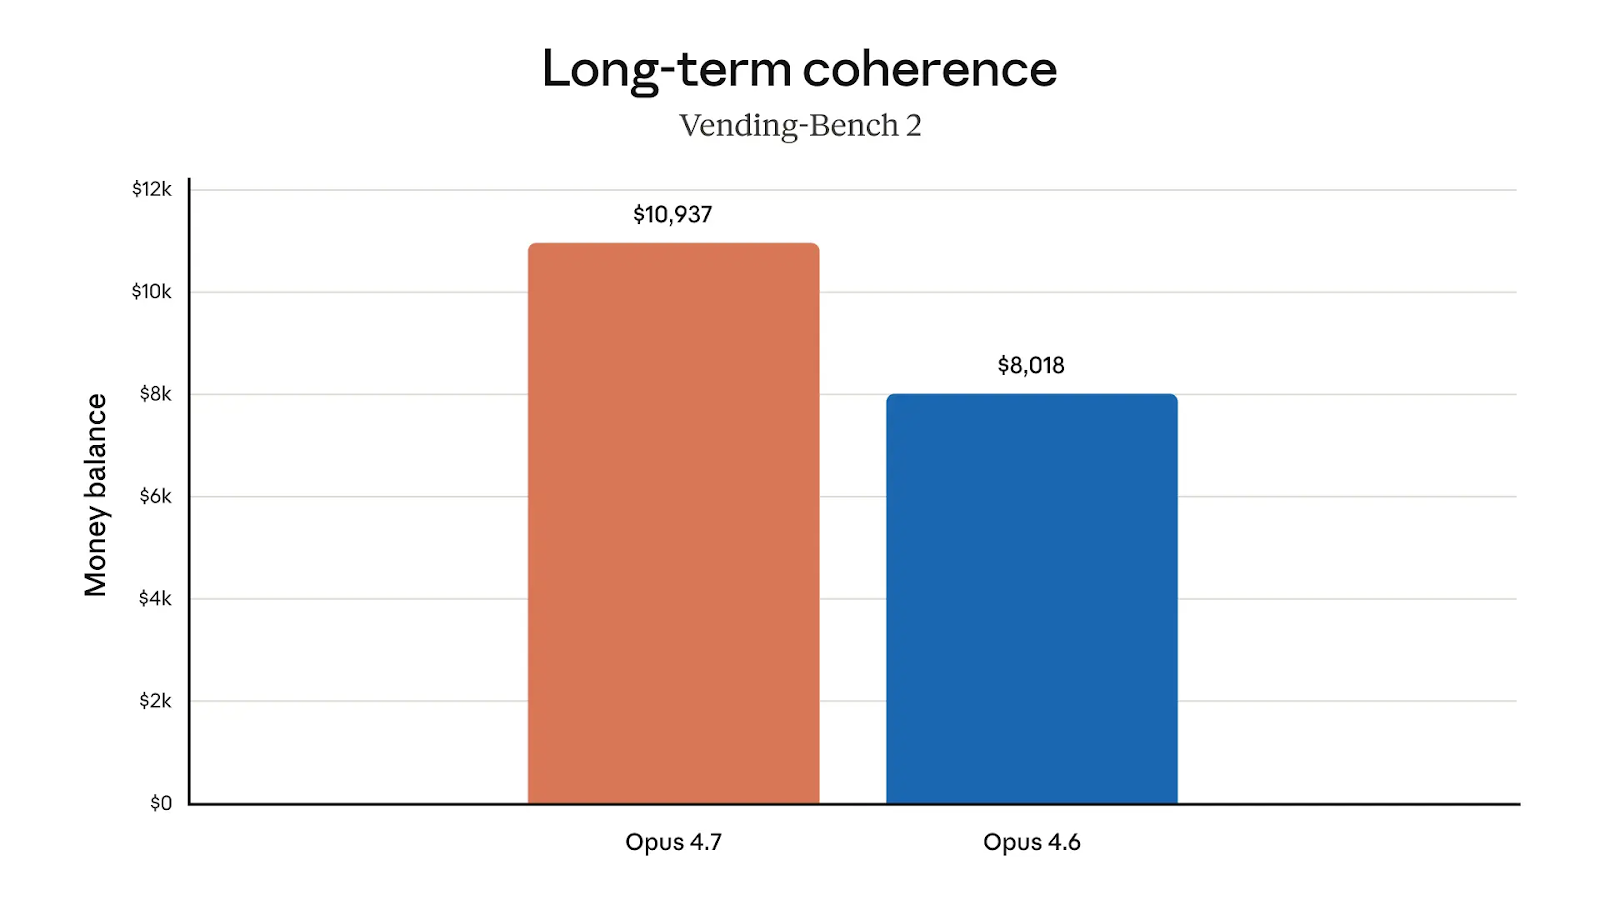
Trong Vending-Bench 2 thiên về thực tiễn, chúng ta thấy Opus 4.7 cũng “giỏi tiền” hơn. Trung bình, mẫu kết thúc với 10.937 đô la, so với 8.018 đô la ở Opus 4.6.
Anthropic không để chúng ta phải chờ. Opus 4.7 hiện có mặt
Trong tất cả sản phẩm Claude
Claude API (claude-opus-4-7)
Vertex AI, và
Microsoft Foundry
Ai cũng lo — nhất là bây giờ — về lạm phát. Nhưng may mắn thay, giá vẫn như Opus 4.6: 5 đô la cho mỗi triệu token đầu vào và 25 đô la cho mỗi triệu token đầu ra. (Giữa Opus 4.6 và Opus 4.7 cũng không tăng giá.)
Nhắc chung: nếu bạn dùng Opus trong Claude.ai: Mỗi tin nhắn bạn gửi bao gồm toàn bộ cuộc trò chuyện đến thời điểm đó (câu hỏi mới của bạn + tất cả trao đổi trước đó) cộng với phản hồi của mẫu. Tất cả đều được tính bằng token. Gói của bạn, dù là gì, có ngân sách token nạp lại theo cửa sổ luân phiên.
Các mẫu khác nhau trừ vào ngân sách đó với mức khác nhau. Opus là đắt nhất vì mạnh nhất. Một tỷ lệ công bố sơ bộ: Opus tốn khoảng gấp 5 lần Sonnet trên mỗi token.
Anthropic phát hành kèm nhiều cập nhật cùng với mẫu, đáng quan tâm nếu bạn dùng Claude Code hoặc xây dựng trên API.
Một mức nỗ lực xhigh ("cực cao") mới nay nằm giữa high và max. Điều này cho bạn thêm một lựa chọn khi cân bằng giữa độ sâu suy luận và độ trễ. Trong Claude Code, mức nỗ lực mặc định đã được nâng lên xhigh trên mọi gói, và Anthropic khuyến nghị bắt đầu với high hoặc xhigh khi thử Opus 4.7 cho các tác vụ mã hoá và tác tử.
Claude Code có lệnh gạch chéo mới /ultrareview, chạy một lượt rà soát chuyên biệt trên thay đổi của bạn và gắn cờ lỗi hoặc vấn đề thiết kế mà một người rà soát cẩn thận sẽ phát hiện. Người dùng Pro và Max được ba lượt ultrareview miễn phí để dùng thử.
Người dùng Max nay có quyền truy cập auto mode, một cài đặt quyền nơi Claude đưa ra quyết định thay bạn. Đây là điểm trung gian giữa việc phê duyệt từng bước và bỏ qua quyền hoàn toàn.
Ngân sách tác vụ hiện ở giai đoạn beta công khai trên Claude API. Tính năng này cho phép nhà phát triển đặt trần chi tiêu token của Claude trong một lần chạy, đặc biệt hữu ích cho các quy trình tác tử dài, nơi bạn muốn mẫu tự điều tiết thay vì đốt sạch ngân sách.
Chúng tôi xem xét kỹ các kết quả benchmark, và trong đó có so sánh với các mẫu khác. Ở mức cao, hãy so Opus 4.7 với GPT-5.4 trực tiếp.
Kết luận cơ bản: Opus 4.7 tối ưu cho tính tự chủ đường dài. GPT-5.4 là mẫu mục đích chung hợp nhất, có hỗ trợ công cụ rộng hơn và giá rẻ hơn cho ngữ cảnh ngắn.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| Giỏi nhất ở | Chạy mã dài, dùng máy tính để bàn, thị giác dày đặc |
Nghiên cứu trình duyệt, tác vụ ngữ cảnh ngắn, điều khiển giữa bài |
| SWE-bench Pro | 64,3% | 57,7% |
| BrowseComp | 79,3% | 89,3% |
| Giá | Giá phẳng cho cửa sổ 1M | Rẻ hơn dưới 272K, cả phiên được tính lại phía trên |
| Cửa sổ ngữ cảnh | ~1M token | ~1M token |
Để xem so sánh đầy đủ với mẫu kế nhiệm của OpenAI, GPT-5.5, hãy đọc bài Claude Opus 4.7 vs. GPT-5.5.
Một số người dùng báo cáo quy trình của họ gặp trục trặc vì Opus 4.7 tuân thủ hướng dẫn theo nghĩa đen hơn trước. Anthropic đã cảnh báo về nhu cầu tinh chỉnh lại prompt.
Những người dùng khác lo ngại về mức dùng token. Trong đợt phát hành này, Anthropic đã tăng hạn mức tốc độ cho tất cả người dùng để bù cho mức dùng token cao hơn, nhưng chưa rõ đó có phải là sự bù trừ thực sự hay không.
Claude Opus 4.7 là mẫu mạnh mẽ nhất mà hầu hết mọi người hiện có thể thực sự sử dụng. Các cải tiến đều hướng về cùng một phía: công việc tác tử chạy lâu hơn, cần ít giám sát hơn, với khả năng mã hoá mạnh hơn, thị giác sắc nét hơn và bộ nhớ xuyên phiên tốt hơn hậu thuẫn.
Điều làm bản phát hành này thú vị là khung tham chiếu Mythos. Opus 4.7 là phương tiện thử nghiệm bị ràng buộc an ninh mạng trên đường đến một phát hành rộng rãi lớp Mythos, nghĩa là nay có một trần rõ ràng phía trên mà bạn không thể chạm tới — nhưng cũng có nghĩa các biện pháp bảo vệ đi kèm 4.7 là bản xem trước cách Anthropic dự định xử lý các phát hành tiên phong trong tương lai.
Học với DataCamp
{count, plural, one {Lộ trình} other {Lộ trình}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
