{count, plural, one {Programa} other {Programas}}
IA para Engenharia de Software
{hours} h
A Anthropic lançou o Claude Opus 4.7, a versão mais recente do seu nível de modelo carro-chefe. O destaque é a autonomia: a Anthropic está posicionando este como o modelo para o qual você pode delegar seus trabalhos de código e de agentes mais complexos e demorados, sem precisar supervisionar de perto.
Nesta versão, também ficamos sabendo que há um teto acima do Opus 4.7. O Mythos Preview interno da Anthropic marca mais pontos em vários benchmarks, mas está sendo retido de um lançamento amplo enquanto a empresa testa proteções cibernéticas. Para quem não é pesquisador interno da Anthropic, o Opus 4.7 é o teto atual.
Neste artigo, vamos percorrer o que realmente há de novo no Opus 4.7, analisar os resultados de benchmarks e compartilhar testes práticos que você mesmo pode rodar. Você também pode conferir nossos guias de modelos concorrentes publicados recentemente, como o Muse Spark da Meta, o GPT-5.5 da OpenAI, e o Gemini 3.1 do Google.
Atualização: em 28 de maio de 2026, a Anthropic lançou o modelo sucessor. Saiba tudo no nosso guia do Claude Opus 4.8.
O Claude Opus 4.7 é o mais novo grande modelo de linguagem carro-chefe da Anthropic, no topo da família Claude acima de Sonnet e Haiku. Ele sucede o Claude Opus 4.6 e foi projetado para as tarefas mais exigentes, como fluxos de trabalho agentivos complexos e raciocínio em múltiplas etapas que exigem desempenho sustentado ao longo de longas sessões.
Em comparação com o Opus 4.6, a versão 4.7 foca em três frentes:
O Mythos Preview interno da Anthropic, que mencionamos antes e sobre o qual também temos um FAQ, lidera em vários benchmarks, mas não está amplamente disponível. O Opus 4.7 é essencialmente um modelo-irmão treinado com capacidades de cibersegurança deliberadamente reduzidas.
A Anthropic relatou melhorias notáveis em várias áreas de capacidade no Opus 4.7.
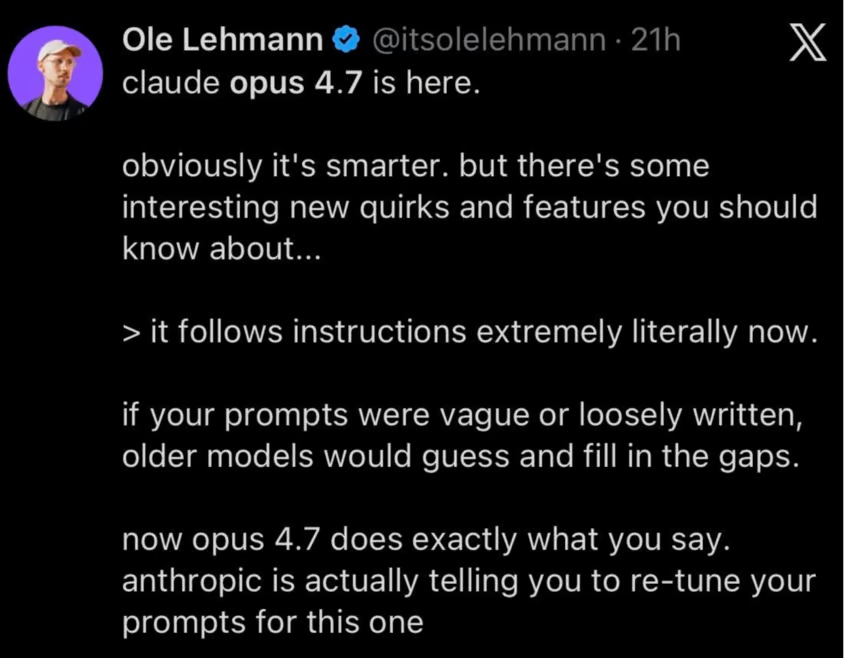
O Opus 4.7 segue instruções com mais fidelidade do que modelos anteriores. Isso, claro, é útil para qualquer fluxo que dependa de confiabilidade, mas pode ter efeitos colaterais: a Anthropic recomenda retreinar seus prompts e mecanismos, já que instruções que modelos anteriores pulavam ou interpretavam de forma flexível agora serão seguidas à risca.
A visão para alta resolução foi aprimorada para aceitar imagens de até 3,75 megapixels, mais de três vezes o que os modelos antigos suportavam. Agentes de uso de computador e fluxos de extração de dados podem se beneficiar muito desse nível extra de detalhamento, pois dependem de legibilidade e precisão, às vezes no nível de pixels.
O Opus 4.7 está melhor em memória baseada em sistema de arquivos, um padrão em que o modelo escreve anotações em arquivos conforme trabalha e as relê em execuções futuras.
O Claude Code é o cenário mais óbvio para isso: um arquivo CLAUDE.md na raiz do projeto que o Claude lê quando a sessão começa, atualiza conforme as decisões são tomadas e usa quando você volta ao trabalho.
“Melhor” aqui significa melhor julgamento sobre o que vale a pena registrar e lembrança mais confiável em rodadas futuras. A Anthropic diz que isso permite que novas tarefas “precisem de menos contexto inicial” — o que, se você já explicou suas convenções de projeto a um modelo pela quinta vez, como nós, vai valorizar.
Em resumo: se você usa o Opus 4.7 para trabalho em múltiplas sessões, deixe-o tirar notas. Ele fará isso melhor do que o Opus 4.6, embora já achássemos que o 4.6 anotava bem.
A Anthropic nos informou que o Claude Opus 4.7 trouxe melhorias significativas nestas áreas.
Criamos alguns testes próprios para confrontar essas afirmações.
Para testar o seguimento de instruções do Opus 4.7, usamos o prompt detalhado abaixo para estressá-lo. Ele tem 12 restrições distintas que podemos verificar ao final.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
E aqui está o resultado:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Hora de dar a nota. Aqui está nossa rúbrica:
|
# |
Restrição |
Como checar |
|
1 |
Exatamente 4 parágrafos (mais a linha final) |
Contar quebras de parágrafo |
|
2 |
O 2º parágrafo começa com "Historically" |
Olhar a primeira palavra |
|
3 |
Cada parágrafo tem 3–5 frases |
Contar frases por parágrafo |
|
4 |
Sem palavras banidas |
Ctrl+F para cada uma |
|
5 |
Exatamente 2 citações, ambas atribuídas, sem outro material citado |
Contar aspas |
|
6 |
Um dos sobrenomes citados começa com M |
Checar atribuições |
|
7 |
Linha final separada por linha em branco |
Verificação visual |
|
8 |
Linha final é uma pergunta |
Termina com "?" |
|
9 |
Ortografia britânica |
Ctrl+F para "organization", "color", "realize", etc. |
|
10 |
Sem bullets, números, headings |
Verificação visual |
|
11 |
Cliente fictício citado uma vez, em itálico |
Ctrl+F por asteriscos |
|
12 |
Contagem de palavras 280–320 |
Colar em um contador |
Vamos poupar seu trabalho de checar tudo. O modelo marcou 11/12.
Fez tudo perfeitamente, mas no fim passou um pouquinho da contagem de palavras (325 palavras, com limite de 320).
Aplicamos o mesmo teste ao Claude Sonnet 4.6, e ele também acertou 11/12 instruções, falhando no mesmo ponto (contagem de palavras). Ainda assim, consideramos o Opus 4.7 um avanço porque o Sonnet 4.6 passou bem mais do limite (400 palavras).
Para o segundo teste, passamos ao Opus 4.7 uma imagem difícil de ler:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
Junto com essas instruções, passamos ao Opus 4.7 uma captura degradada do gráfico de comércio da Escócia de 1786, de Playfair, que tiramos do nosso artigo sobre exemplos de visualização de dados.
Sabíamos que poderíamos validar a saída porque tínhamos uma versão em resolução mais alta na Wikipedia. Esta foi a imagem que o Opus 4.7 viu:
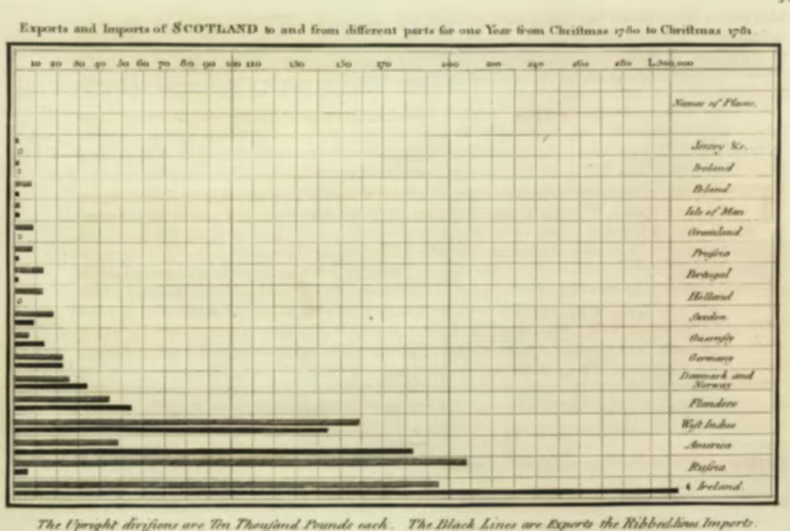
Aqui está a leitura do Opus 4.7:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
Sabíamos que este teste seria traiçoeiro, já que o eixo x do gráfico de Playfair realmente muda a contagem no meio do caminho (de 10 em 10 até 110, depois dezenas ímpares 130/150/170, depois pares 200/220/240/260/280). Mas o Opus 4.7 leu o eixo corretamente de primeira, mesmo sendo estranho.
Uma coisa curiosa: é ótimo quando modelos de IA mostram incerteza, mas “[?]oland” deveria ter sido lido com segurança como “Poland” e “Gr[oe]nland” como “Greenland”. Embora não tivéssemos uma rúbrica oficial aqui, dá para dar uma nota justa de 9/10.
O Opus 4.7 foi avaliado em 14 benchmarks cobrindo código, raciocínio, uso de ferramentas, uso de computador e raciocínio visual. A tabela abaixo mostra a comparação completa com o Opus 4.6, GPT 5.4, Gemini 3.1 Pro e o ainda não publicado Mythos Preview.
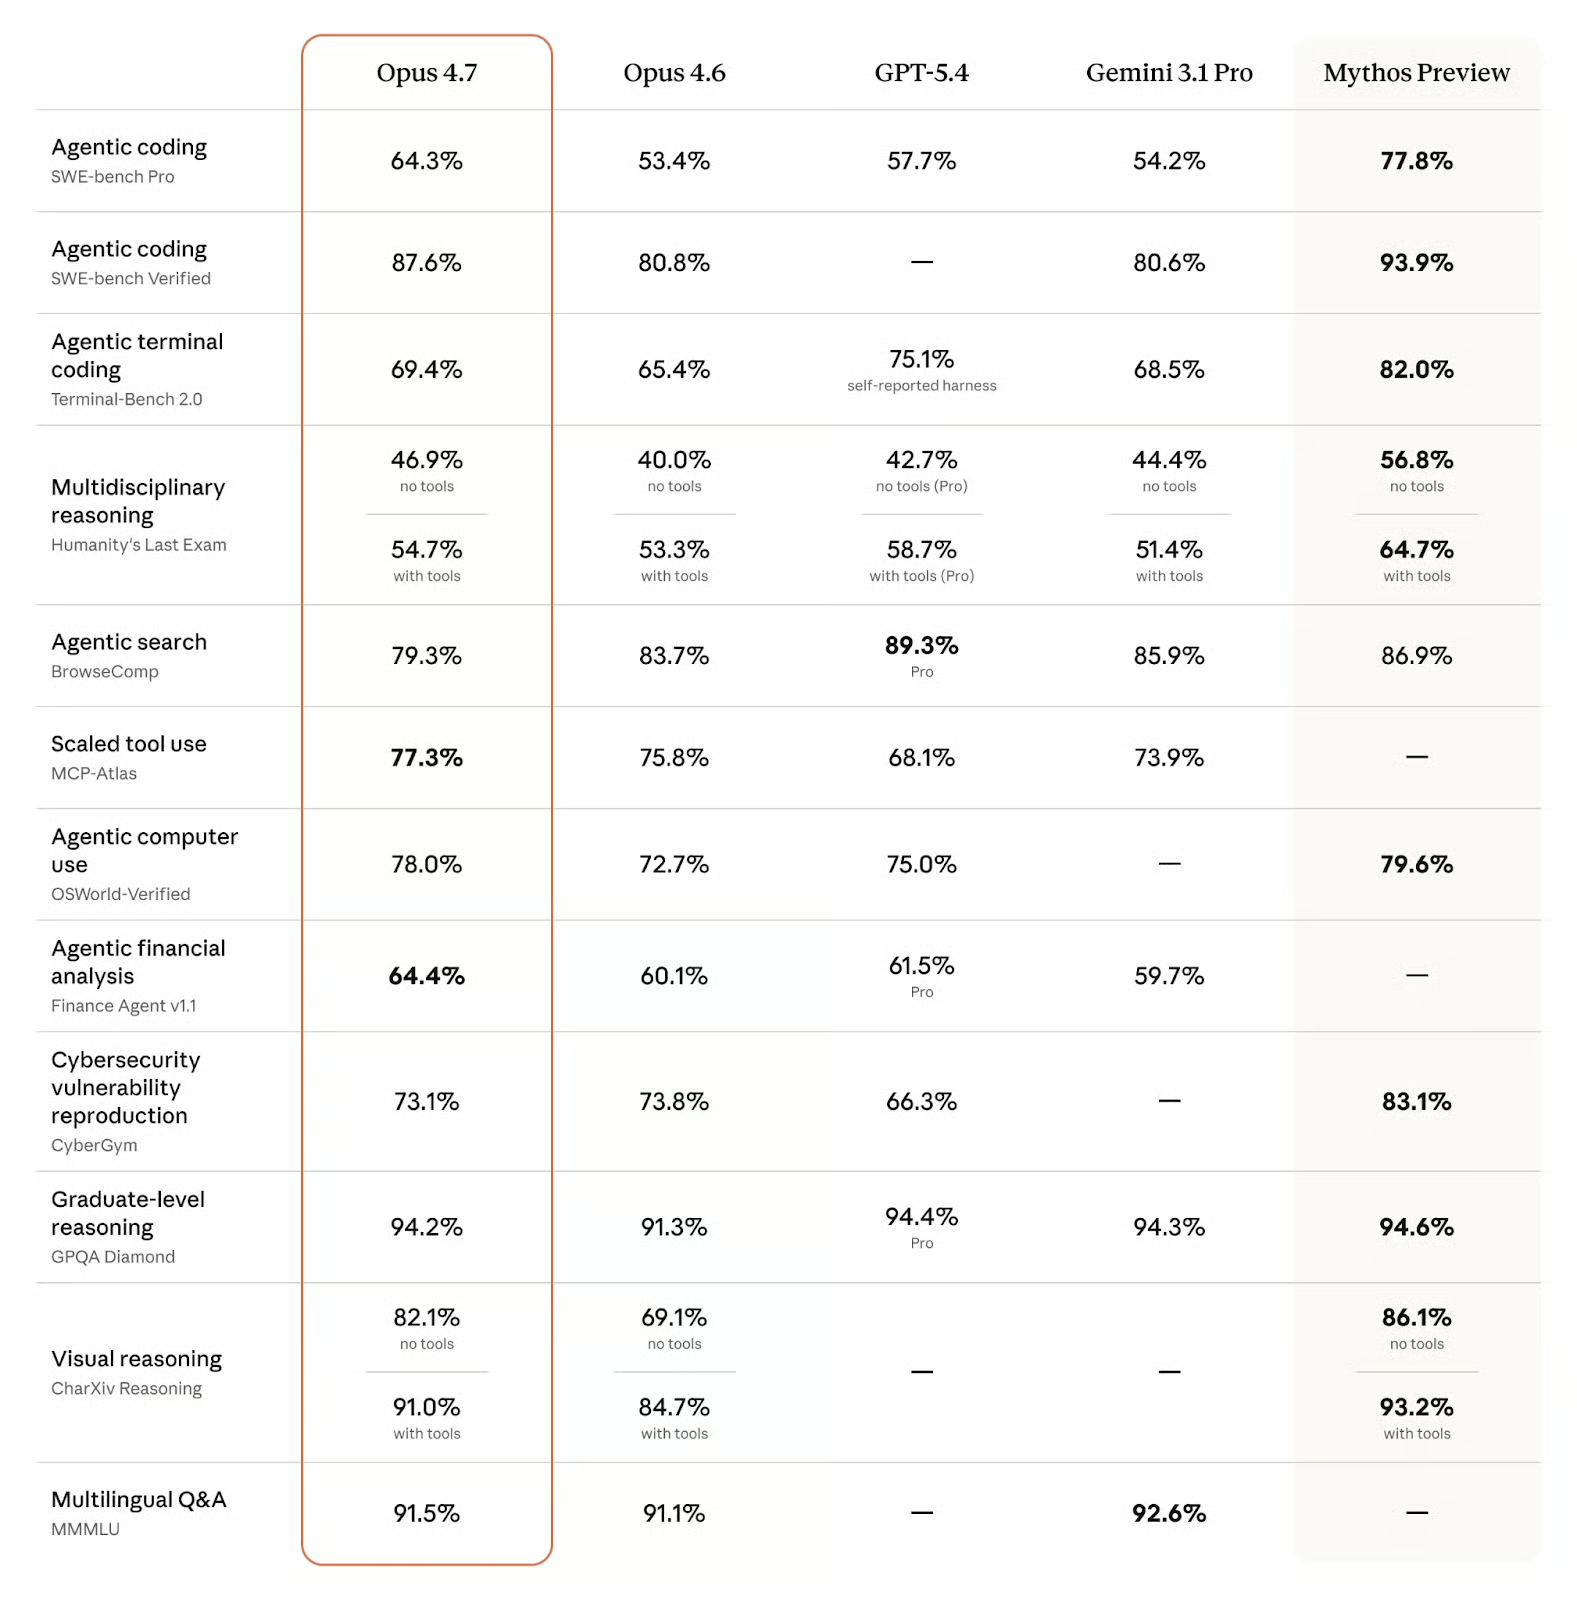
No SWE-bench Pro, o Opus 4.7 marca 64,3%, à frente do GPT-5.4 com 57,7%, do Gemini 3.1 Pro com 54,2% e do Opus 4.6 com 53,4%. No SWE-bench Verified, o Opus 4.7 atinge 87,6% contra 80,6% do Gemini 3.1 Pro e 80,8% do Opus 4.6. O GPT-5.4 não tem pontuação publicada no SWE-bench Verified nesta comparação.
O SWE-bench testa a capacidade do modelo de resolver issues reais do GitHub em repositórios Python de código aberto. A versão Pro é mais difícil, com problemas mais complexos. O ganho de 10,9 pontos sobre o Opus 4.6 no SWE-bench Pro é a maior melhoria desta versão (em pontos percentuais) e coloca o Opus 4.7 claramente à frente dos dois concorrentes principais nessa tarefa.
Apenas o Mythos Preview interno da Anthropic marca 77,8% no SWE-bench Pro e 93,9% no SWE-bench Verified, mostrando que ainda há espaço acima do Opus 4.7. Ainda assim, como o Mythos não está amplamente disponível, para uso em produção o Opus 4.7 é o teto atual.
Os resultados no Terminal-Bench 2.0, benchmark referência para codificação agentiva no terminal, são interessantes. O Opus 4.7 melhora um pouco em relação ao antecessor (69,4% vs. 65,4%) e ultrapassa o Gemini 3.1 Pro, que marca 68,5%.
Dito isso, ele não consegue competir com o GPT-5.4 (75,1%) nesse quesito, embora valha lembrar a ressalva auto-reportada na pontuação do GPT-5.4 ao comparar. Ainda assim, pode ser frustrante para a Anthropic que seu novo carro-chefe (disponível) não lidere um benchmark central para desenvolvimento agentivo de software.
Humanity's Last Exam é um conjunto de questões de nível de pós-graduação em ciências, matemática e humanidades, projetado para ser difícil aos modelos de fronteira atuais. O Opus 4.7 lidera a variante sem ferramentas, que testa o raciocínio bruto sem recuperação externa. A vantagem do GPT-5.4 (58,7%) na versão com ferramentas é a área mais clara em que o Opus 4.7 (54,7%) não lidera.
O raciocínio de nível de pós-graduação costuma ser medido no GPQA-Diamond, que hoje está bem saturado: como todos os modelos de fronteira atuais, os quatro modelos comparados passam de 90% e estão essencialmente empatados.
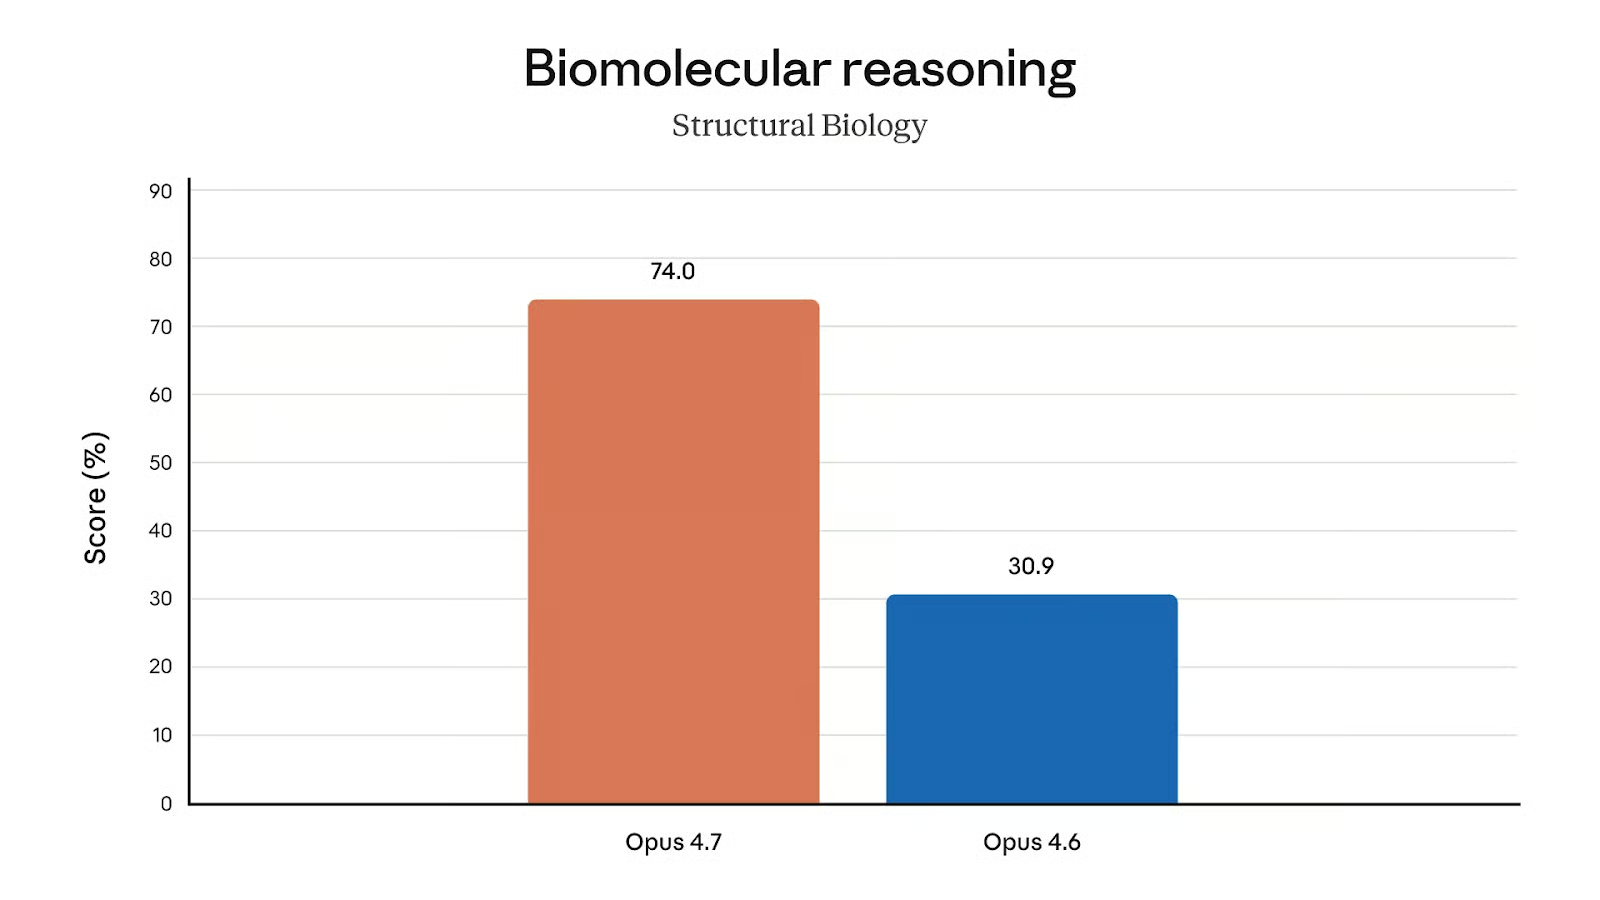
Um resultado mais interessante mira biologia, uma das áreas também testadas no GPQA-Diamond. Embora não possamos comparar com os concorrentes, o salto entre o Opus 4.6 (30,9%) e o Opus 4.7 (74,0%) definitivamente chama atenção!
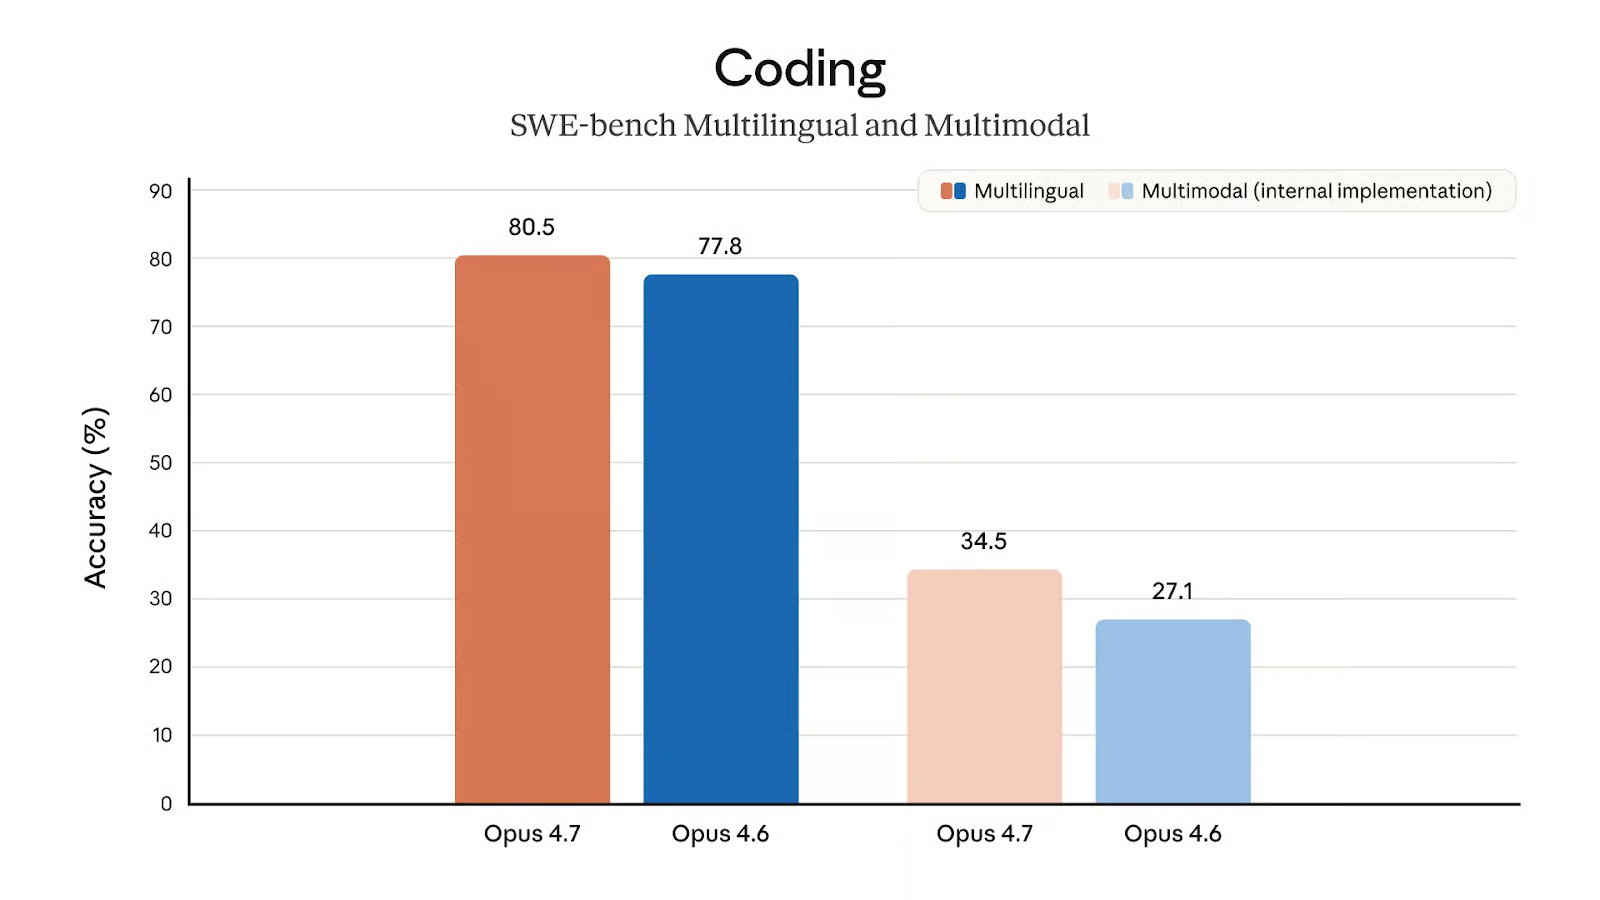
Os resultados no benchmark CharXiv, que mede raciocínio visual sobre gráficos e figuras científicas, refletem que essa foi uma das áreas de foco no desenvolvimento do Opus 4.7.
A melhoria de 13 pontos sem ferramentas é o maior ganho relativo desta versão. Sem pontuações de concorrentes para comparar, é difícil dizer onde o Opus 4.7 se posiciona no campo mais amplo nessa tarefa, mas a melhora sobre o Opus 4.6 é substancial.
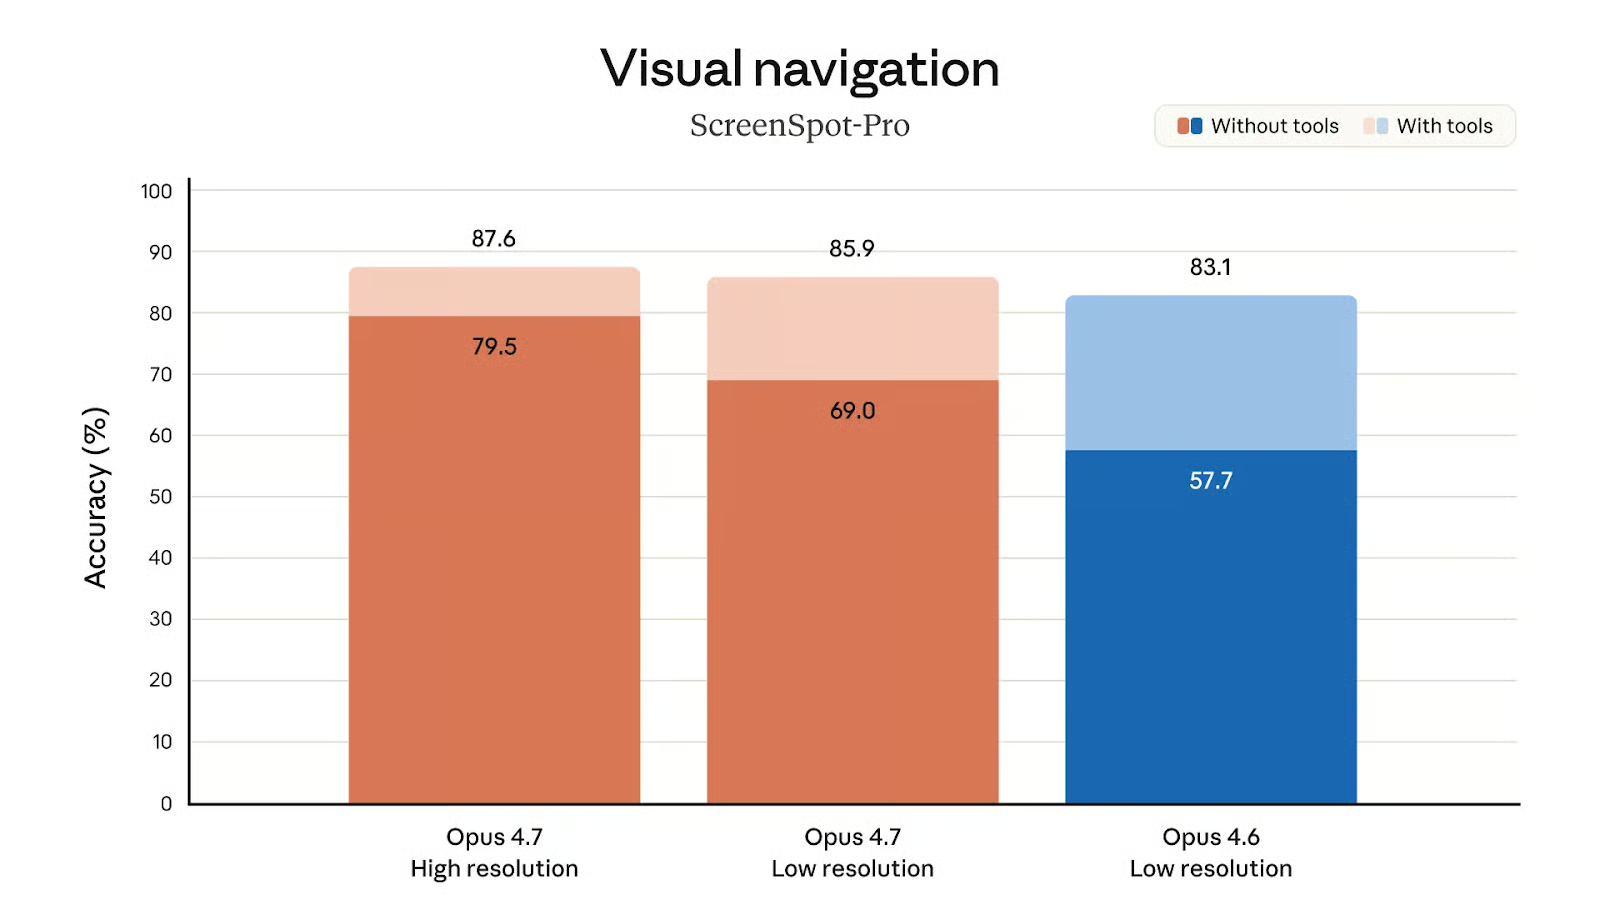
O suporte a imagens de maior resolução provavelmente é um dos motivos da melhoria no raciocínio visual. O gráfico de pontuações do Screenspot-Pro em diferentes resoluções mostra o enorme ganho de acurácia que o Opus 4.7 tem com resolução mais alta, especialmente sem uso de ferramentas (79,5% vs. 69,0%).
O MCP-Atlas testa o desempenho em fluxos complexos com múltiplas ferramentas. O Opus 4.7 marca 77,3% aqui, a maior pontuação entre os modelos na comparação. O único modelo que supera muito ligeiramente o MCP-Atlas do Opus 4.7 é o Muse Spark, com 78,3%.
O OSWorld testa a capacidade do modelo de completar tarefas controlando uma interface de computador — clicando, digitando e navegando por aplicativos. O Opus 4.7 marca 78,0%, acima dos 72,7% do Opus 4.6. O GPT-5.4 marca 75,0%, e o Gemini 3.1 Pro não tem pontuação publicada neste benchmark. O Mythos Preview marca 79,6%, ligeiramente acima do Opus 4.7.
Esta é definitivamente uma área em que o Opus 4.7 se destaca: ele lidera tanto o MCP-Atlas quanto o OSWorld-Verified com margem significativa sobre os carros-chefe de Google e OpenAI, o que é um ótimo sinal para quem constrói sistemas de agentes em produção que dependem de orquestração de ferramentas e agentes de uso de computador.
As habilidades de análise financeira do modelo merecem menção honrosa: o Opus 4.7 lidera o ranking do Finance Agent v1.1 (64,4%), bem à frente de GPT-5.4 (61,5%) e Gemini 3.1 Pro (59,7%).
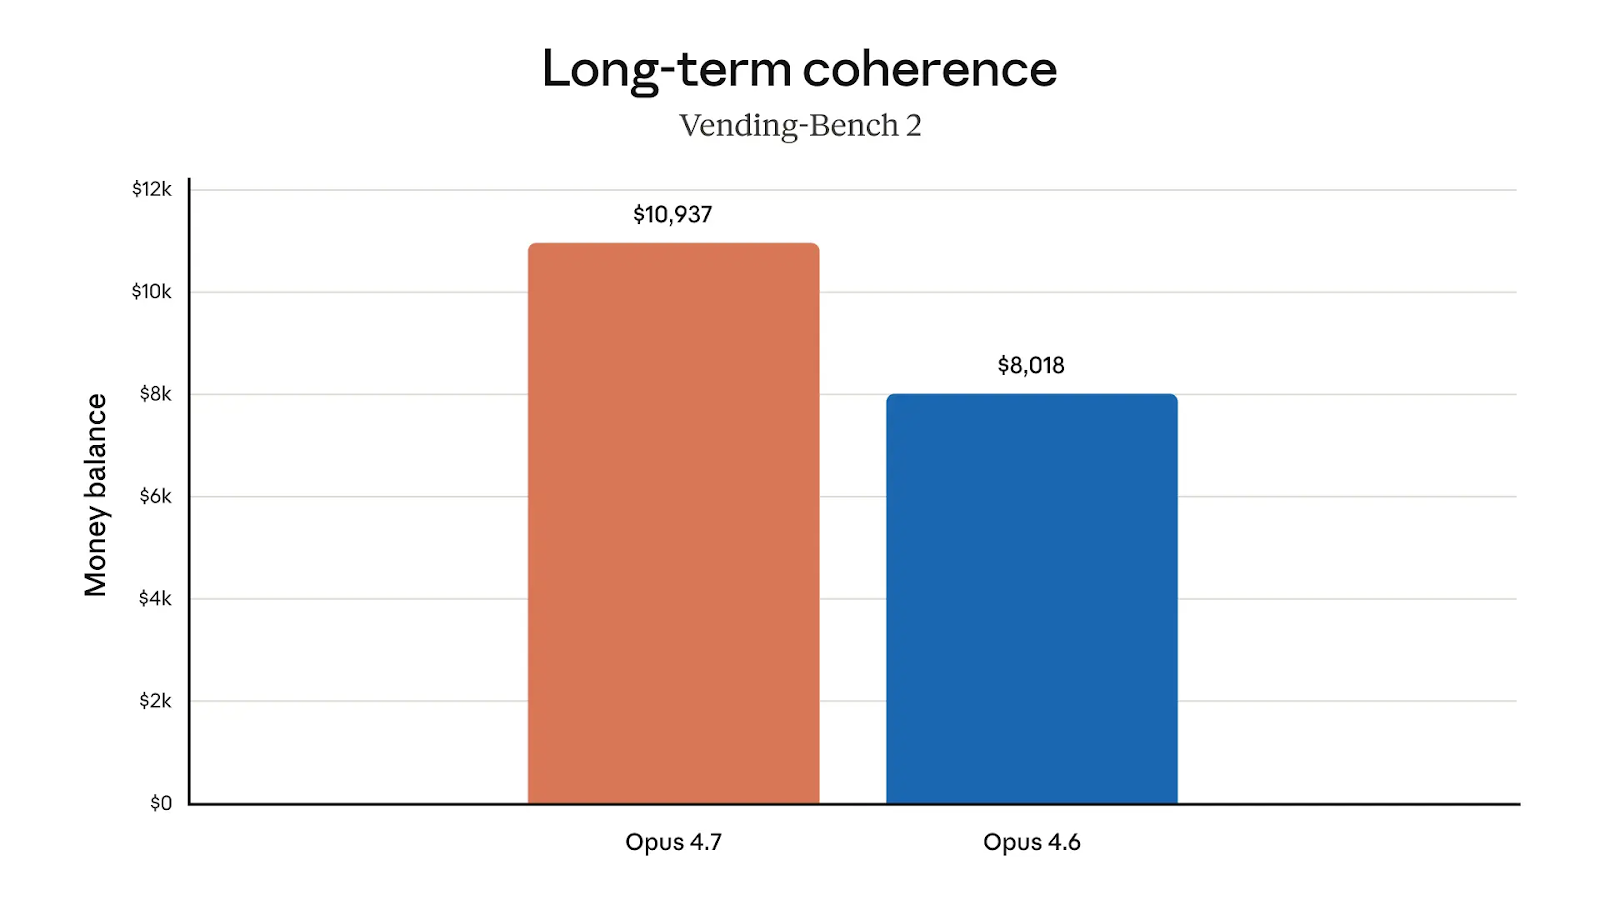
No Vending-Bench 2, mais prático, dá para ver que o Opus 4.7 também “lida melhor com dinheiro”. Em média, o modelo terminou com US$ 10.937, contra US$ 8.018 do Opus 4.6.
A Anthropic não nos fez esperar. O Opus 4.7 já está disponível
Em todos os produtos Claude
Na Claude API (claude-opus-4-7)
Vertex AI, e
Microsoft Foundry
A gente sempre se preocupa — ainda mais agora — com inflação. Mas, felizmente, o preço é o mesmo do Opus 4.6: US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída. (Também não houve aumento entre o Opus 4.6 e o Opus 4.7.)
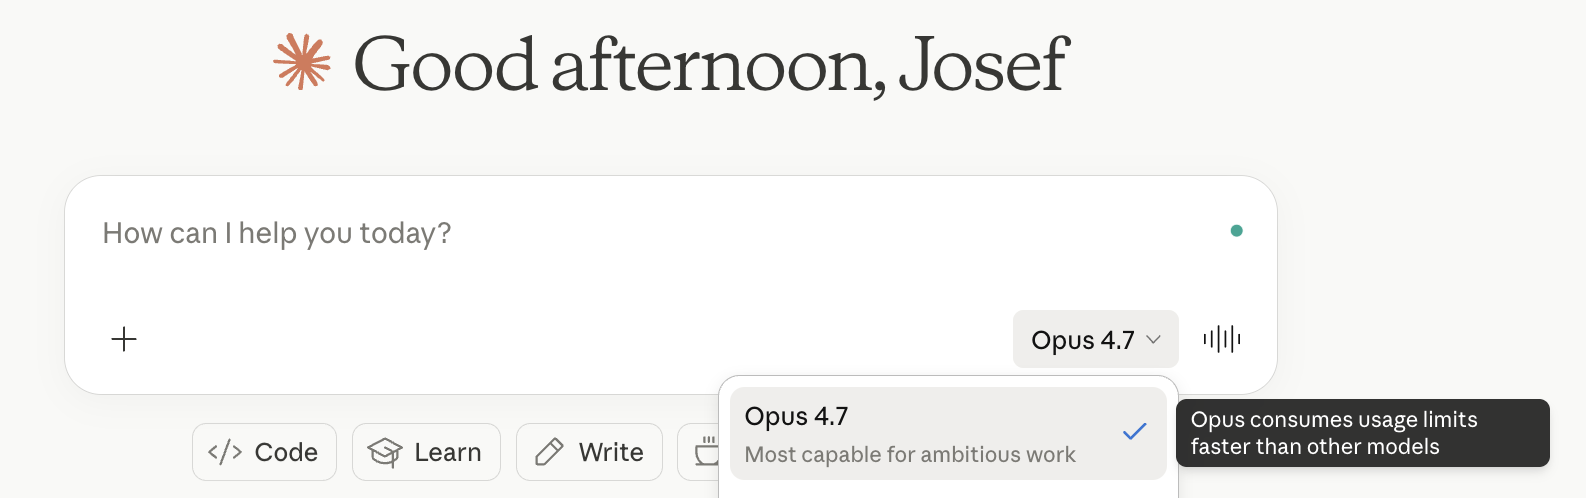
Lembrando, se você usa o Opus no Claude.ai: toda mensagem que você envia inclui a conversa inteira até ali (sua nova pergunta + todo o histórico) mais a resposta do modelo. Tudo isso é medido em tokens. Seu plano, seja qual for, tem um orçamento de tokens que se renova em janela contínua.
Modelos diferentes descontam esse orçamento a taxas diferentes. O Opus é o mais caro porque é o mais potente. Uma proporção divulgada de forma aproximada: o Opus custa cerca de 5× o Sonnet por token.
A Anthropic trouxe várias atualizações junto com o modelo em si que valem a pena conhecer, especialmente se você usa o Claude Code ou constrói na API.
Um novo nível de esforço xhigh ("extra alto") agora fica entre high e max. Isso dá mais uma opção ao escolher entre profundidade de raciocínio e latência. No Claude Code, o nível de esforço padrão foi elevado para xhigh em todos os planos, e a Anthropic recomenda começar com high ou xhigh ao testar o Opus 4.7 em tarefas de código e de agentes.
O Claude Code ganhou o novo comando /ultrareview, que roda uma passada dedicada de revisão nas suas mudanças e sinaliza bugs ou problemas de design que um revisor humano criterioso notaria. Usuários Pro e Max ganham três ultrareviews grátis para experimentar.
Usuários Max agora têm acesso ao modo auto, uma configuração de permissões em que o Claude toma decisões por você. É um meio-termo entre aprovar cada etapa e pular permissões por completo.
Os orçamentos de tarefa estão em beta público na Claude API. Eles permitem limitar o gasto de tokens do Claude ao longo de uma execução, especialmente útil para fluxos de agentes mais longos, em que você quer que o modelo administre o ritmo em vez de torrar o orçamento.
Analisamos de perto os resultados de benchmark, que já trazem comparações com outros modelos. Em alto nível, vamos comparar diretamente o Opus 4.7 com o GPT-5.4.
A essência é: o Opus 4.7 otimiza para autonomia em horizontes longos. O GPT-5.4 é um modelo unificado de uso geral, com suporte a ferramentas mais amplo e preço mais barato para contextos curtos.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| Melhor em | Execuções longas de código, uso de desktop, visão densa |
Pesquisa em navegador, tarefas de contexto curto, ajustes durante a resposta |
| SWE-bench Pro | 64,3% | 57,7% |
| BrowseComp | 79,3% | 89,3% |
| Preço | Taxa fixa em contexto de 1M | Mais barato abaixo de 272K, sessão inteira reprecificada acima |
| Janela de contexto | ~1M tokens | ~1M tokens |
Para a comparação completa com o modelo sucessor da OpenAI, GPT-5.5, veja nosso post Claude Opus 4.7 vs. GPT-5.5.
Alguns usuários relatam que seus pipelines estão dando trabalho porque o Opus 4.7 está seguindo instruções de forma mais literal do que antes. A Anthropic alertou sobre a necessidade de retunar prompts.
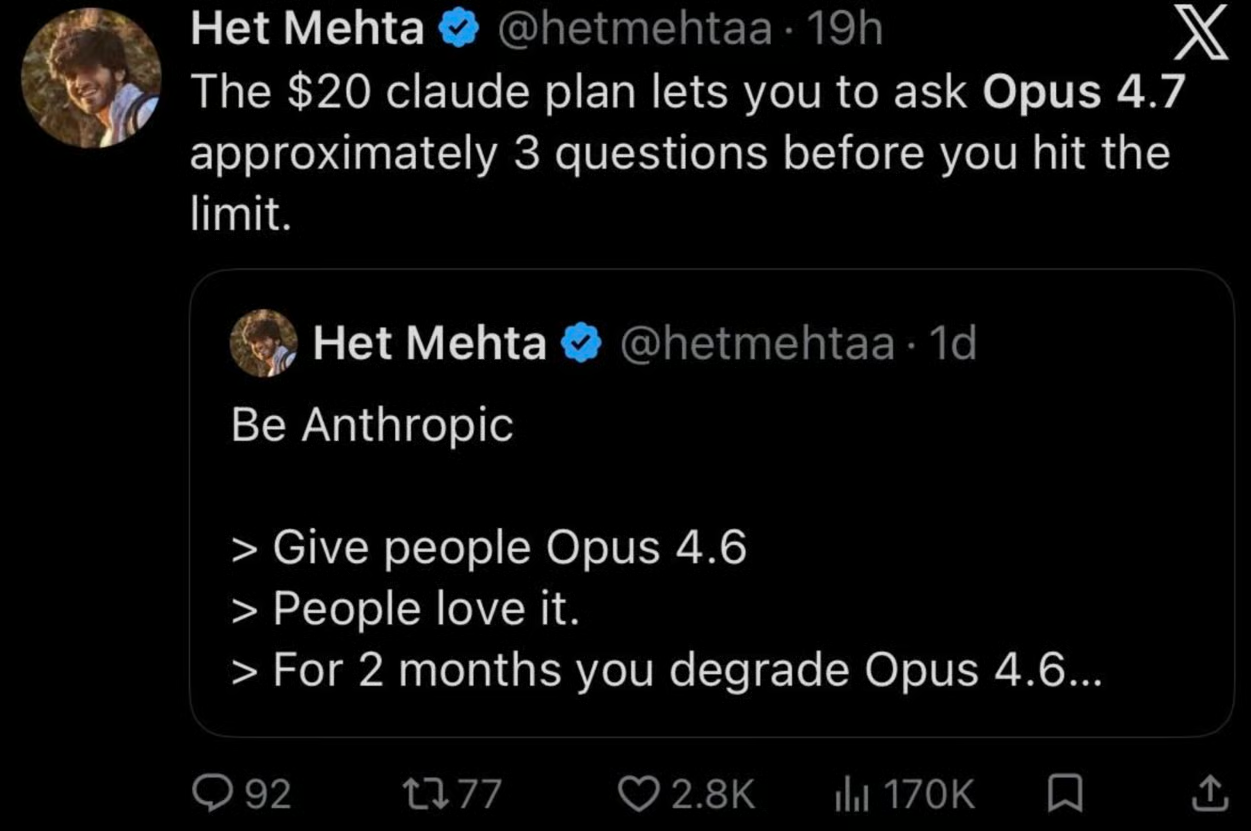
Outros usuários ficaram preocupados com o uso de tokens. Como parte do lançamento, a Anthropic aumentou os limites de taxa para todos os usuários para compensar o uso maior de tokens, mas não está totalmente claro se a compensação é real.
O Claude Opus 4.7 é o modelo mais capaz que a maioria das pessoas consegue realmente usar hoje. As melhorias apontam todas para a mesma direção: trabalhos de agentes mais longos e com menos supervisão, com código mais forte, visão mais nítida e melhor memória entre sessões sustentando tudo isso.
O que torna este lançamento interessante é o enquadramento do Mythos. O Opus 4.7 é um veículo de teste com restrições cibernéticas a caminho de um lançamento mais amplo da classe Mythos — o que significa que agora há um teto claro acima dele ao qual você não tem acesso —, mas também que as proteções embarcadas no 4.7 são um prévia de como a Anthropic planeja lidar com lançamentos de fronteira daqui para frente.
Aprenda com a DataCamp
{count, plural, one {Programa} other {Programas}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Richie Cotton
7 min
{count, plural, one {blog} other {blogs}}
Khalid Abdelaty
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
9 min
{count, plural, one {Tutorial} other {Tutoriais}}
Moez Ali
11 min
{count, plural, one {Tutorial} other {Tutoriais}}
Dimitri Didmanidze
8 min
{count, plural, one {Tutorial} other {Tutoriais}}
Arunn Thevapalan
12 min