

{count, plural, one {Cursus} other {Cursus}}
Anthropic a lancé Claude Opus 4.7, la toute dernière évolution de sa gamme de modèles phares. Le principal progrès ? L’autonomie : Anthropic présente Opus 4.7 comme le modèle à qui vous pouvez confier vos tâches de code et d’agents les plus ardues et les plus longues sans supervision serrée.
On apprend aussi avec cette version qu’il existe un plafond au-dessus d’Opus 4.7. Le Mythos Preview interne d’Anthropic obtient de meilleurs scores sur plusieurs benchmarks, mais sa diffusion large est retardée le temps de tester des garde-fous cybersécurité. Pour toute personne extérieure à l’équipe R&D d’Anthropic, Opus 4.7 constitue donc le plafond actuel.
Dans cet article, nous passons en revue les vraies nouveautés d’Opus 4.7, examinons les résultats de benchmark et partageons des tests pratiques à reproduire. Consultez aussi nos guides des modèles concurrents récemment publiés, comme le Muse Spark de Meta, OpenAI's GPT-5.5, and Google's Gemini 3.1.
Mise à jour : le 28 mai 2026, Anthropic a publié le modèle successeur. Découvrez tout dans notre guide Claude Opus 4.8.
Qu’est-ce que Claude Opus 4.7 ?
Claude Opus 4.7 est le dernier grand modèle de langage phare d’Anthropic, au sommet de la famille Claude, au-dessus de Sonnet et Haiku. Il succède à Claude Opus 4.6 et vise les tâches les plus exigeantes, comme des workflows agentiques complexes et des raisonnements multi-étapes nécessitant une performance soutenue sur de longues sessions.
Par rapport à Opus 4.6, la version 4.7 se concentre sur trois axes :
- Un codage agentique plus robuste
- Un meilleur raisonnement visuel
- Des performances accrues avec l’usage d’outils à grande échelle
Le Mythos Preview interne d’Anthropic, évoqué plus haut et détaillé dans notre FAQ, mène plusieurs benchmarks, mais n’est pas disponible largement. Opus 4.7 est en quelque sorte un modèle jumeau, entraîné avec des capacités cybersécurité volontairement réduites.
Quoi de neuf avec Claude Opus 4.7 ?
Anthropic indique des progrès notables dans plusieurs domaines de compétences avec Opus 4.7.
Respect des instructions
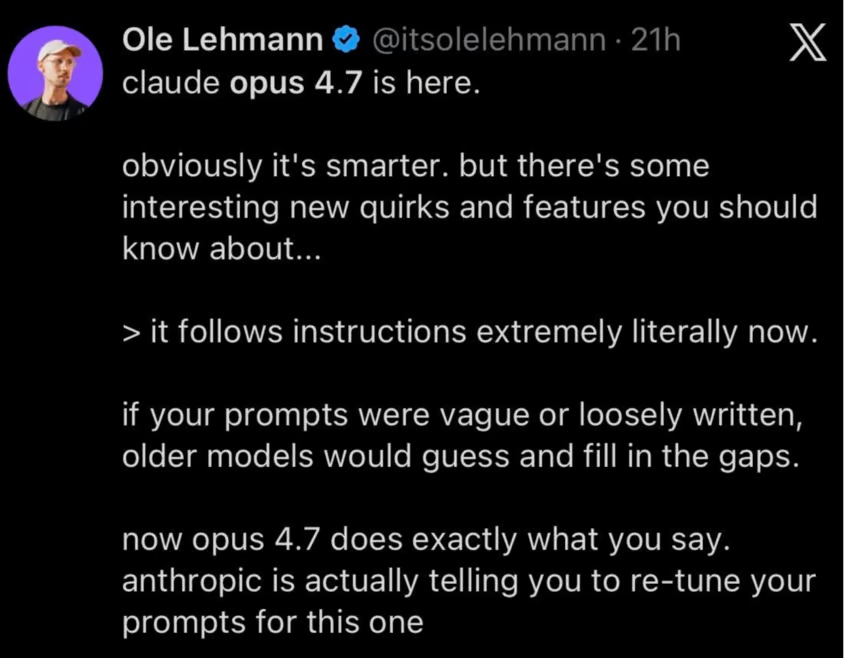
Opus 4.7 suit les consignes de façon plus littérale que les versions précédentes. C’est très utile pour tout workflow exigeant de la fiabilité, mais cela peut aussi avoir des effets de bord : Anthropic recommande d’ajuster vos prompts et harnais, car des instructions que les anciens modèles ignoraient ou interprétaient librement seront désormais prises à la lettre.
Prise en charge multimodale
La vision haute résolution a été améliorée pour prendre en charge des images jusqu’à 3,75 mégapixels, soit plus de trois fois la limite des anciens modèles. Les agents d’usage d’ordinateur et les workflows d’extraction de données tirent un grand bénéfice de cette granularité accrue, car ils dépendent de la lisibilité et de la précision, parfois au niveau du pixel.
Mémoire
Opus 4.7 gère mieux la mémoire basée sur le système de fichiers, un schéma où le modèle écrit des notes dans des fichiers pendant qu’il travaille, puis les relit lors de sessions suivantes.
Claude Code est le terrain idéal pour cela : un fichier CLAUDE.md à la racine du projet, que Claude lit au démarrage d’une session, met à jour au fil des décisions et réutilise quand vous reprenez le travail.
« Meilleure » signifie ici un meilleur jugement sur ce qui mérite d’être noté et un rappel plus fiable aux tours suivants. Anthropic explique que cela permet aux nouvelles tâches d’« exiger moins de contexte initial » — si vous avez déjà réexpliqué cinq fois les conventions de votre projet à un modèle, comme nous, vous apprécierez.
La conclusion pratique : si vous utilisez Opus 4.7 pour des travaux multi-sessions, laissez-le prendre des notes. Il s’en sortira mieux qu’Opus 4.6, qui était déjà plutôt bon à cet exercice.
Tester Claude Opus 4.7
Anthropic nous indique des progrès significatifs dans ces domaines.
- Respect des instructions
- Prise en charge multimodale améliorée
- Tâches réelles
- Mémoire
Nous avons conçu nos propres tests pour challenger ces affirmations.
Respect des instructions
Pour évaluer le suivi des consignes par Opus 4.7, nous avons utilisé le prompt détaillé ci-dessous pour le pousser dans ses retranchements. Il contient 12 contraintes distinctes, vérifiables à la fin.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Voici le résultat :
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Passons au score. Voici notre grille :
|
# |
Contrainte |
Comment vérifier |
|
1 |
Exactement 4 paragraphes (plus la ligne de conclusion) |
Compter les sauts de paragraphe |
|
2 |
Le 2e paragraphe commence par « Historically » |
Regarder le premier mot |
|
3 |
Chaque paragraphe contient 3–5 phrases |
Compter les phrases par paragraphe |
|
4 |
Aucun mot interdit |
Ctrl+F pour chacun |
|
5 |
Exactement 2 citations, toutes deux attribuées, pas d’autre contenu entre guillemets |
Compter les guillemets |
|
6 |
Un partenaire cité a un nom commençant par M |
Vérifier les attributions |
|
7 |
Ligne de conclusion séparée par une ligne vide |
Vérification visuelle |
|
8 |
La conclusion est une question |
Se termine par « ? » |
|
9 |
Orthographe britannique |
Ctrl+F pour « organization », « color », « realize », etc. |
|
10 |
Aucune puce, numérotation ni titre |
Vérification visuelle |
|
11 |
Client fictif nommé une seule fois, en italiques |
Ctrl+F sur les astérisques |
|
12 |
Nombre de mots 280–320 |
Coller dans un compteur de mots |
Nous vous épargnons le décompte : le modèle a obtenu 11/12.
Il était parfait jusque dans la dernière ligne, mais a légèrement dépassé la limite de mots (325 pour un maximum de 320).
Nous avons appliqué le même test à Claude Sonnet 4.6 : 11/12 également, avec un échec au même endroit (le compte de mots). Mais nous considérons tout de même Opus 4.7 en progrès, car Sonnet 4.6 avait largement explosé le plafond (400 mots).
Multimodal
Pour notre deuxième test, nous avons donné à Opus 4.7 une image difficile à lire :
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
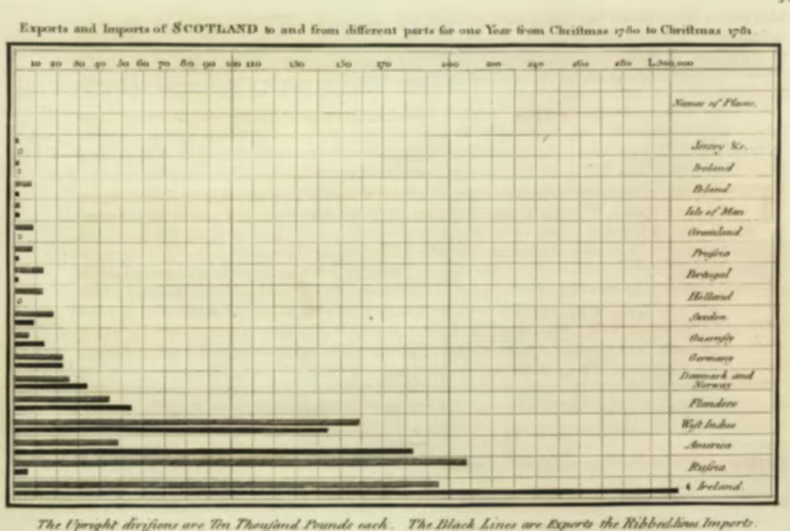
Avec ces consignes, nous avons fourni à Opus 4.7 une capture d’écran dégradée du graphique sur le commerce de l’Écosse de Playfair (1786), extraite de notre article sur des exemples de datavisualisation.
Nous pouvions valider la sortie car nous disposions d’une version plus haute définition sur Wikipedia. Voici l’image vue par Opus 4.7 :
Voici la lecture d’Opus 4.7 :
Type: diagramme à barres horizontales, gravure ancienne. Confiance: Élevée.

Nombres: graduations de l'axe X: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (Élevée, mais 130/220 incertains).

Années "1780" et "1781" dans le titre (Élevée). "Ten Thousand Pounds" par division (Élevée).

Titre: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

En-tête: "Names of Places"

Lieux: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Note de bas de page: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Mise en page: panneau unique — titre, zone de tracé avec ~16 paires de barres, colonne des lieux à droite, note en dessous.

Sujet: un graphique commercial 1780–81 montrant les exportations et importations de l'Écosse par partenaire. Confiance: Élevée.

Illisible: marque en haut à droite; valeurs exactes des barres; première lettre de "[?]oland"; si le "Ireland" du bas est un doublon.
Nous savions que ce test serait piège : l’axe des x du graphique de Playfair change vraiment de pas en cours de route (tous les 10 jusqu’à 110, puis dizaines impaires 130/150/170, puis paires 200/220/240/260/280). Opus 4.7 a néanmoins lu correctement l’axe du premier coup, malgré cette bizarrerie.
Un point amusant toutefois : nous apprécions que les modèles affichent leur incertitude, mais « [?]oland » aurait dû être reconnu sans peine comme « Poland » et « Gr[oe]nland » comme « Greenland ». Même sans grille officielle, on peut équitablement lui attribuer 9/10.
Benchmarks de Claude Opus 4.7
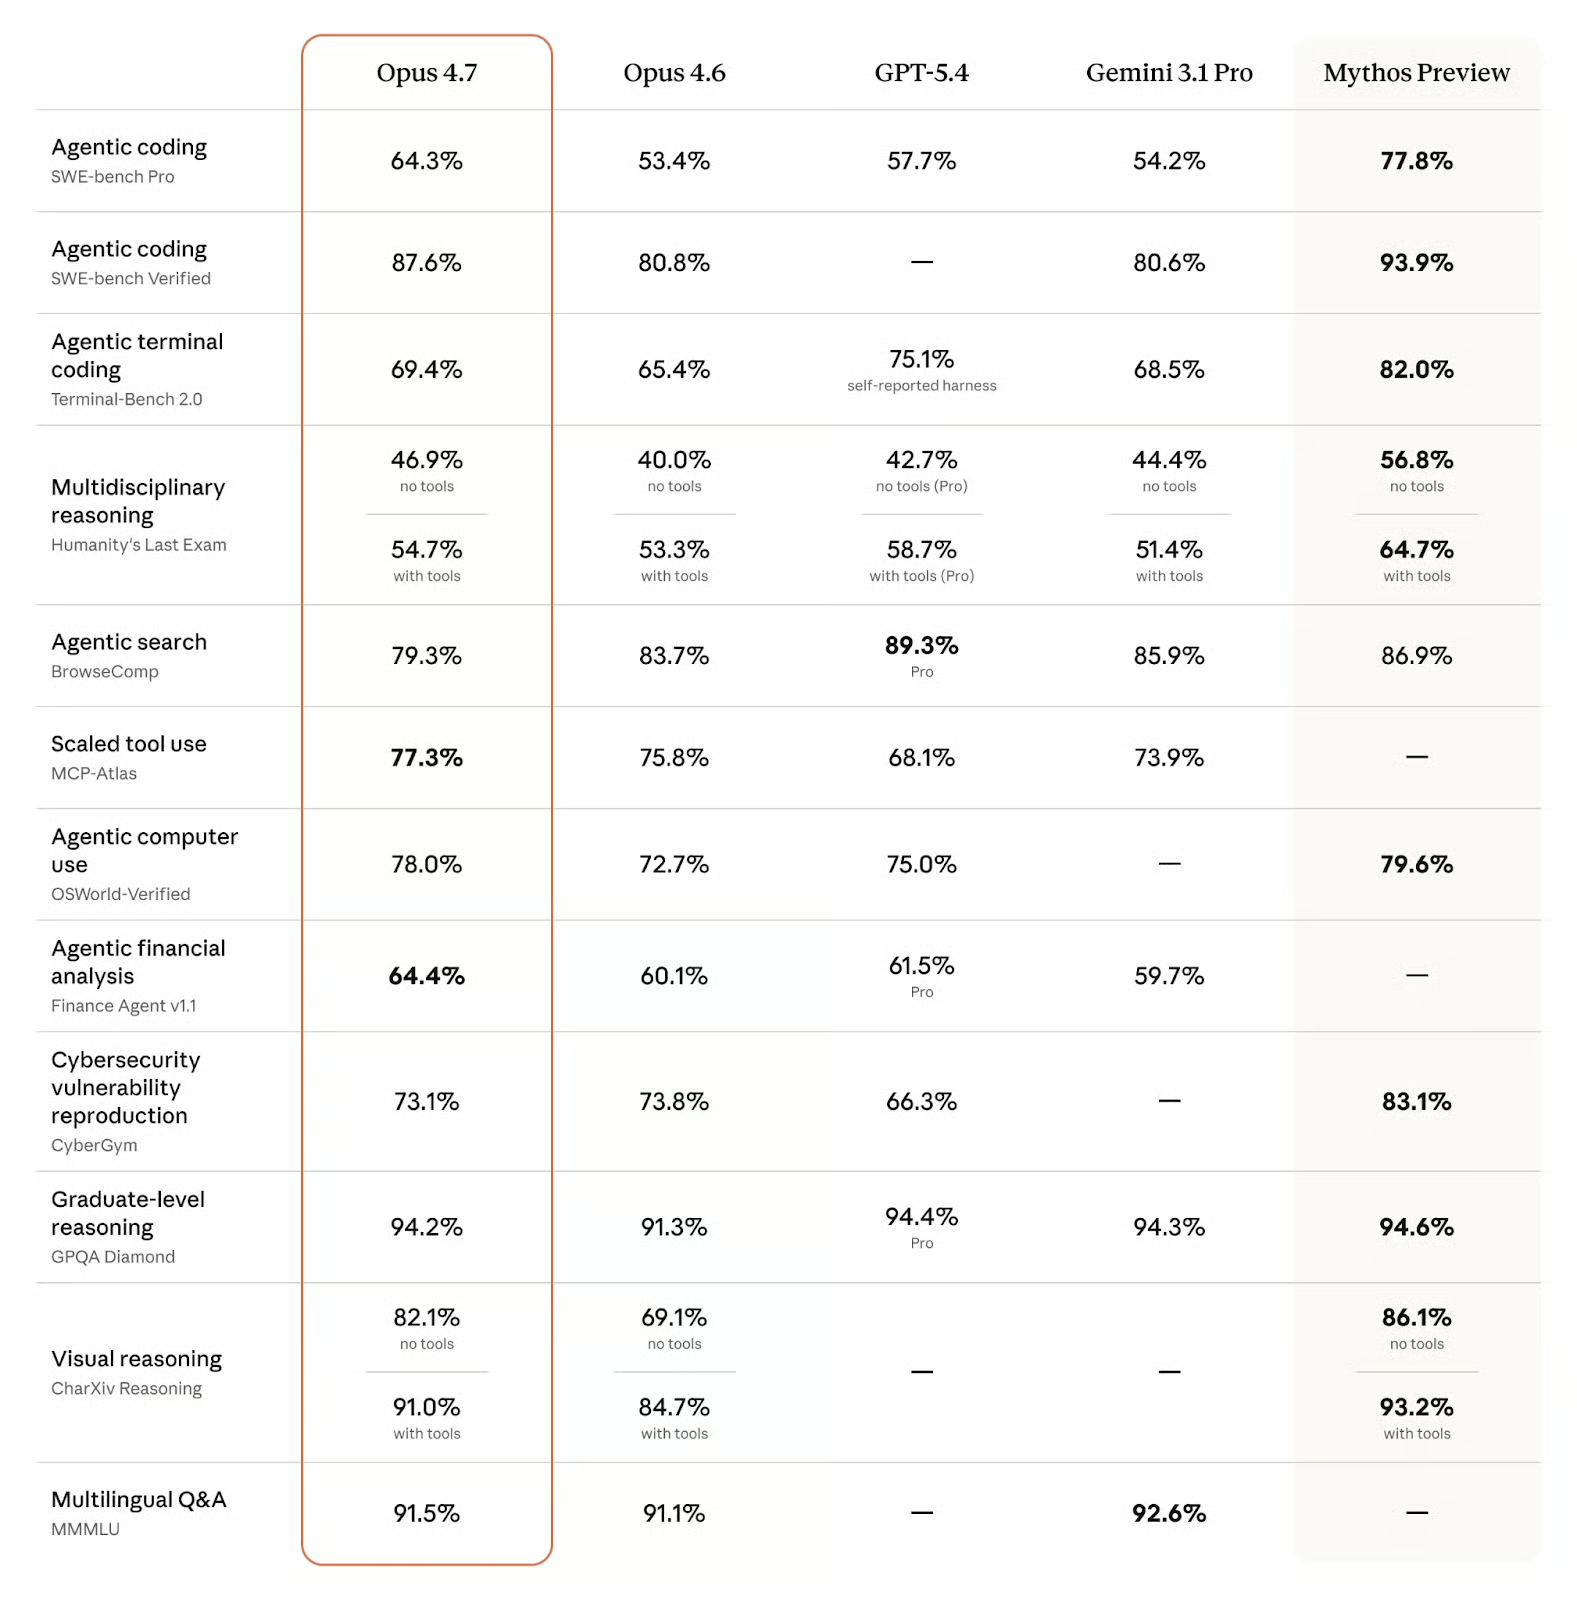
Opus 4.7 a été évalué sur 14 benchmarks couvrant le code, le raisonnement, l’usage d’outils, l’utilisation d’ordinateur et le raisonnement visuel. Le tableau ci-dessous présente la comparaison complète avec Opus 4.6, GPT 5.4, Gemini 3.1 Pro et le Mythos Preview (non publié).
Codage agentique
Sur SWE-bench Pro, Opus 4.7 atteint 64,3 %, devant GPT 5.4 (57,7 %), Gemini 3.1 Pro (54,2 %) et Opus 4.6 (53,4 %). Sur SWE-bench Verified, Opus 4.7 monte à 87,6 % contre 80,6 % pour Gemini 3.1 Pro et 80,8 % pour Opus 4.6. GPT 5.4 n’a pas de score publié sur SWE-bench Verified dans cette comparaison.
SWE-bench évalue la capacité d’un modèle à résoudre de véritables issues GitHub dans des dépôts Python open source. La variante Pro est plus difficile. Le gain de 10,9 points par rapport à Opus 4.6 sur SWE-bench Pro est le plus important de cette version et place Opus 4.7 nettement devant les deux principaux concurrents sur cette tâche.
Seul le Mythos Preview interne d’Anthropic fait mieux (77,8 % sur SWE-bench Pro et 93,9 % sur SWE-bench Verified), preuve qu’il reste de la marge au-dessus d’Opus 4.7. Mais Mythos n’étant pas disponible largement, Opus 4.7 constitue le plafond actuel pour la production.
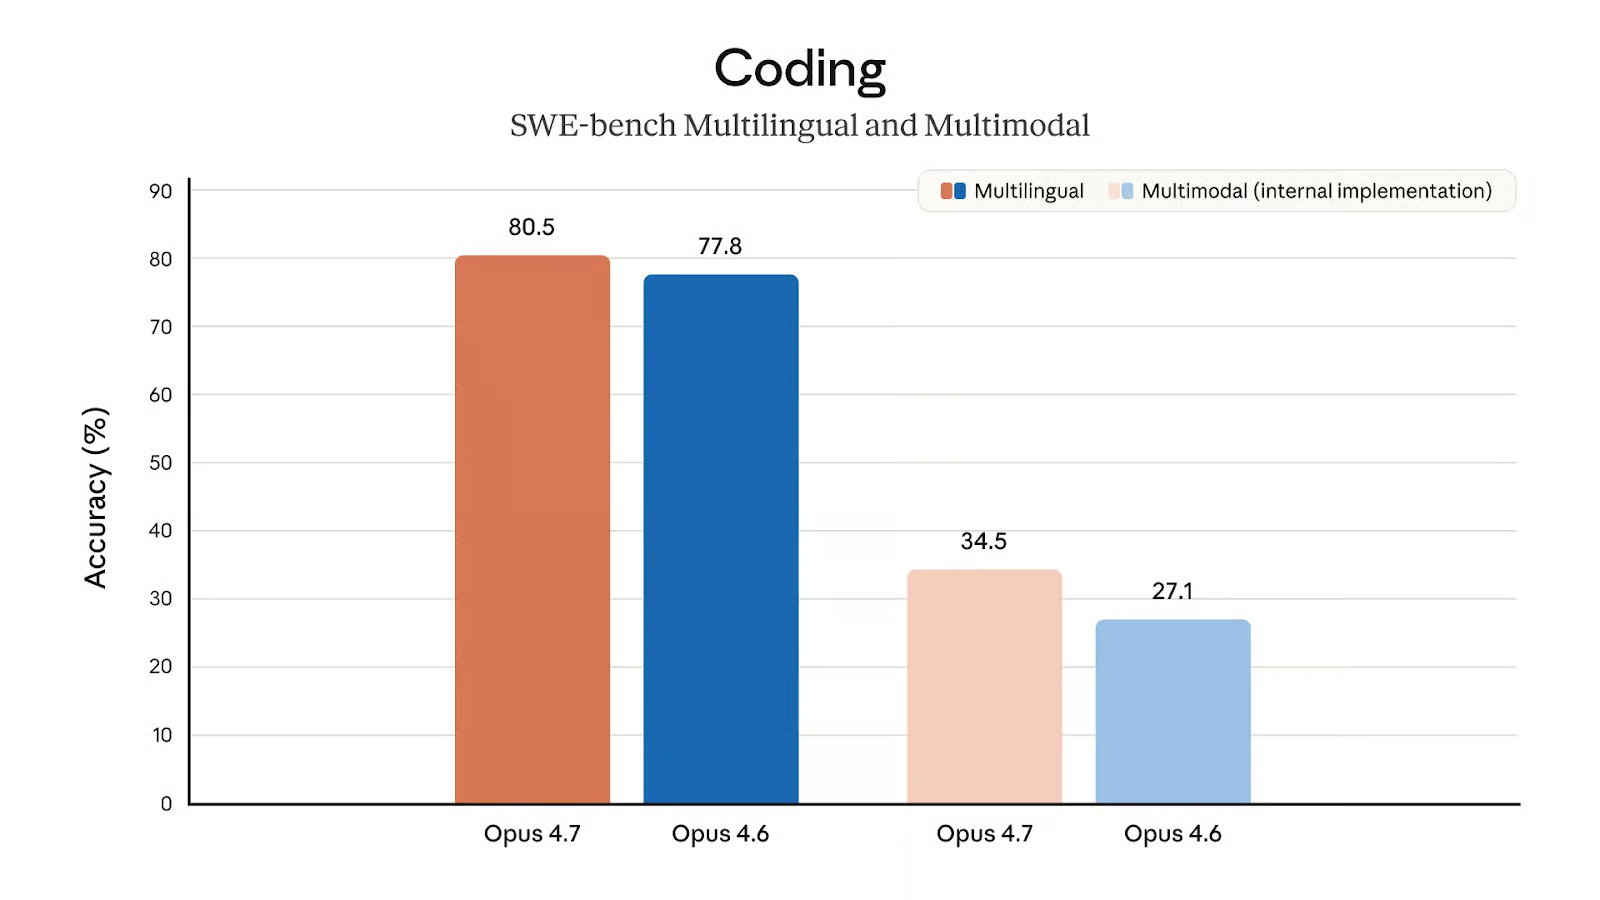
Les résultats sur Terminal-Bench 2.0, benchmark référence pour le codage agentique en terminal, sont intéressants : Opus 4.7 progresse légèrement face à son prédécesseur (69,4 % vs 65,4 %) et dépasse Gemini 3.1 Pro (68,5 %).
Cela dit, il ne rattrape pas GPT 5.4 (75,1 %) sur ce point, même si la mise en garde auto-reportée sur le score de GPT 5.4 doit être gardée à l’esprit. Ça peut rester décevant pour Anthropic que son nouveau modèle phare (publié) ne domine pas un benchmark au cœur du développement logiciel agentique.
Raisonnement
Humanity's Last Exam est un ensemble de questions de niveau master en sciences, mathématiques et sciences humaines, conçu pour être difficile pour les modèles de pointe actuels. Opus 4.7 mène la variante sans outils, qui teste le raisonnement « brut » sans recherche externe. L’écart en faveur de GPT 5.4 (58,7 %) dans la variante avec outils est la zone la plus nette où Opus 4.7 (54,7 %) ne mène pas.
Le raisonnement de niveau master est généralement mesuré par GPQA-Diamond, aujourd’hui quasi saturé : comme les autres modèles de pointe actuels, les quatre modèles comparés dépassent 90 % et sont pour l’essentiel à égalité.
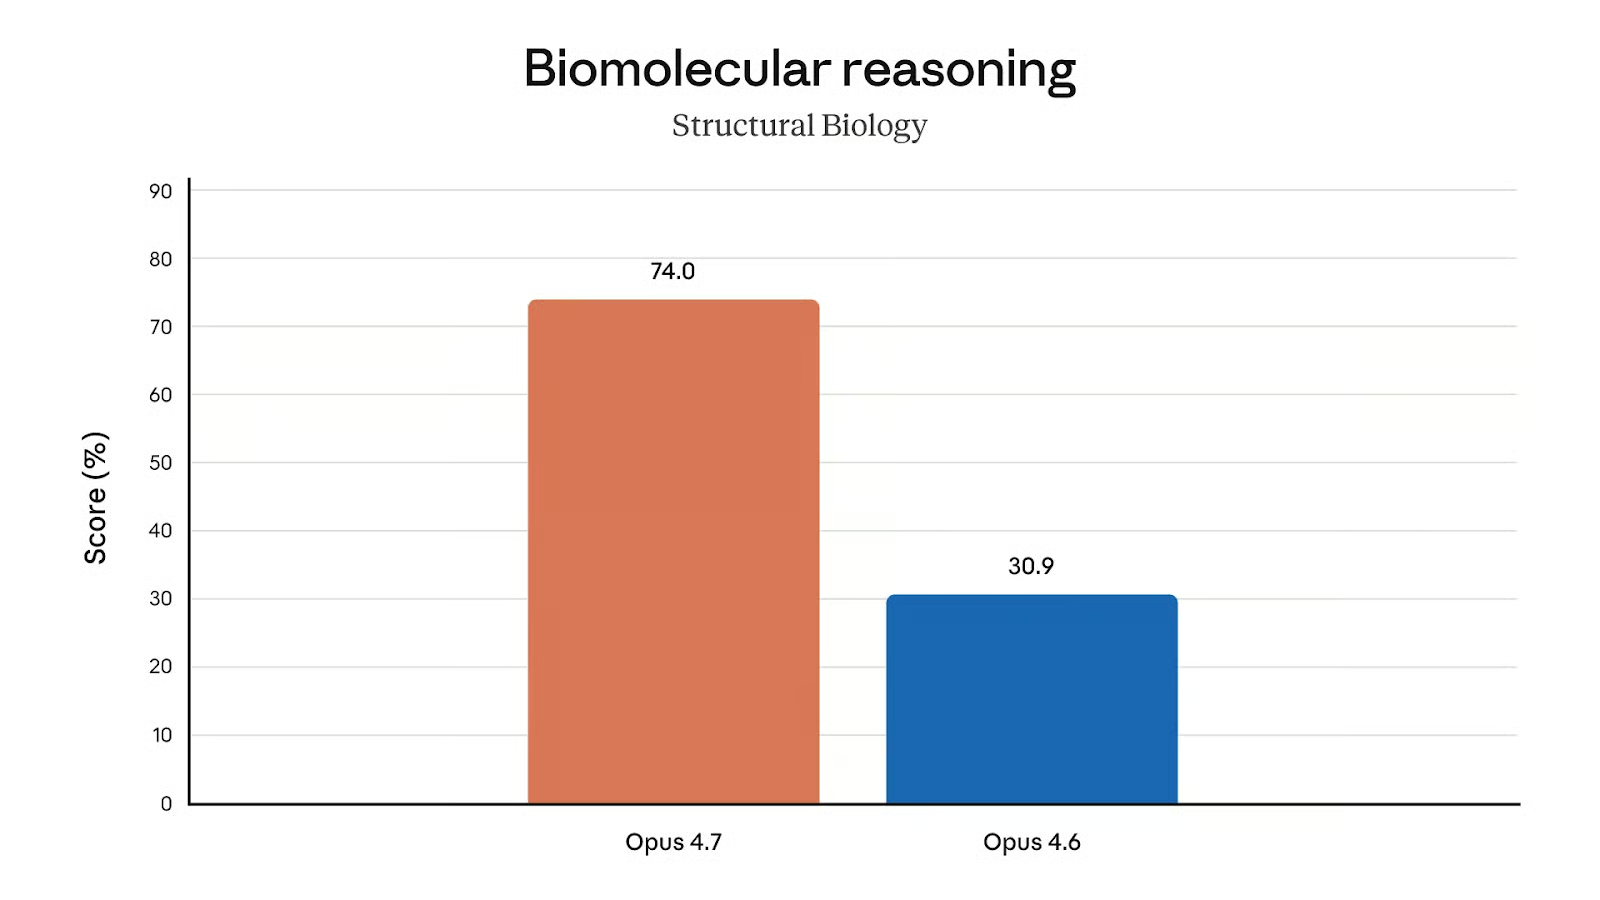
Un résultat plus intéressant cible la biologie, aussi couverte par GPQA-Diamond. Sans comparaison possible avec les concurrents ici, le bond entre Opus 4.6 (30,9 %) et Opus 4.7 (74,0 %) vaut clairement le coup d’œil !
Raisonnement visuel
Les résultats sur CharXiv, qui mesure le raisonnement visuel sur graphiques et figures scientifiques, confirment que c’était un axe majeur de développement d’Opus 4.7.
Le gain de 13 points sans outils est le plus fort de cette version (en relatif). Sans scores concurrents pour se situer, difficile de dire où Opus 4.7 se place sur ce terrain, mais le progrès face à Opus 4.6 est substantiel.
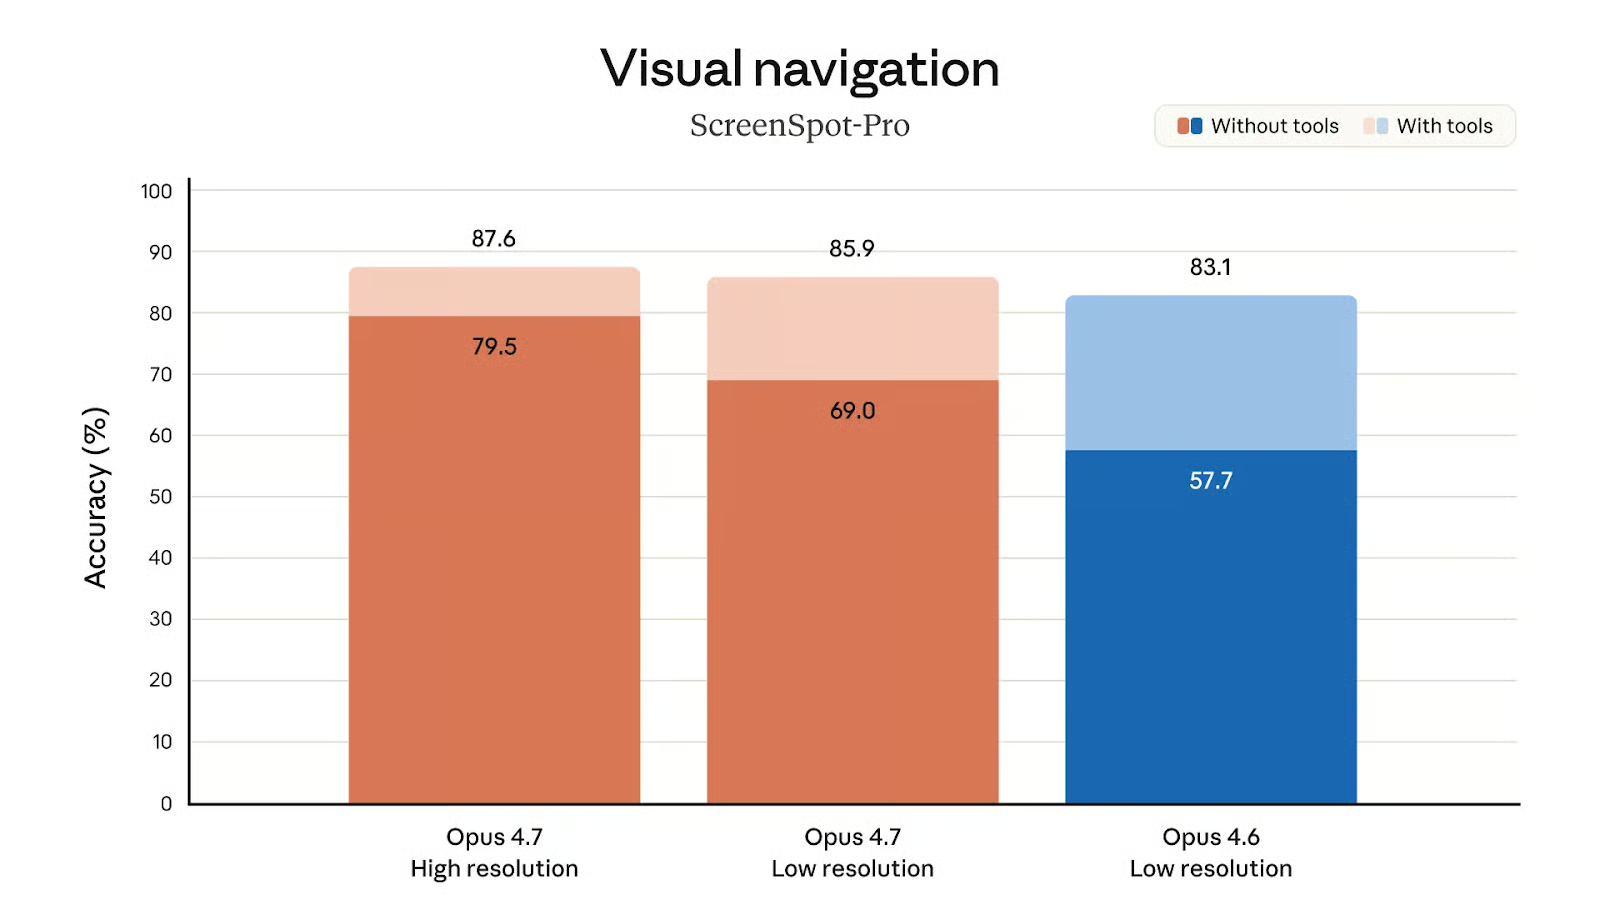
La prise en charge d’images de plus haute définition explique sans doute une partie du gain en raisonnement visuel. Le graphique des scores Screenspot-Pro selon la résolution montre la forte hausse de précision d’Opus 4.7 avec une résolution supérieure, surtout sans outils (79,5 % vs 69,0 %).
Usage agentique d’outils et de l’ordinateur
MCP-Atlas évalue des workflows complexes à outils multiples. Opus 4.7 y obtient 77,3 %, le meilleur score des modèles comparés. Le seul à le dépasser très légèrement est Muse Spark, reporté à 78,3 %.
OSWorld mesure la capacité d’un modèle à accomplir des tâches en contrôlant une interface : clics, saisie, navigation applicative. Opus 4.7 atteint 78,0 %, en hausse par rapport à Opus 4.6 (72,7 %). GPT 5.4 affiche 75,0 %, et Gemini 3.1 Pro n’a pas de score publié. Mythos Preview grimpe à 79,6 %, légèrement au-dessus d’Opus 4.7.
C’est clairement un point fort d’Opus 4.7 : il mène sur MCP-Atlas et OSWorld-Verified avec une avance significative sur les fleurons de Google et d’OpenAI — une excellente nouvelle pour celles et ceux qui conçoivent des systèmes d’agents en production reposant sur l’orchestration d’outils et l’usage de l’ordinateur.
Analyse financière
Les compétences du modèle en analyse financière méritent une mention : Opus 4.7 caracole en tête du leaderboard Finance Agent v1.1 (64,4 %), nettement devant GPT 5.4 (61,5 %) et Gemini 3.1 Pro (59,7 %).
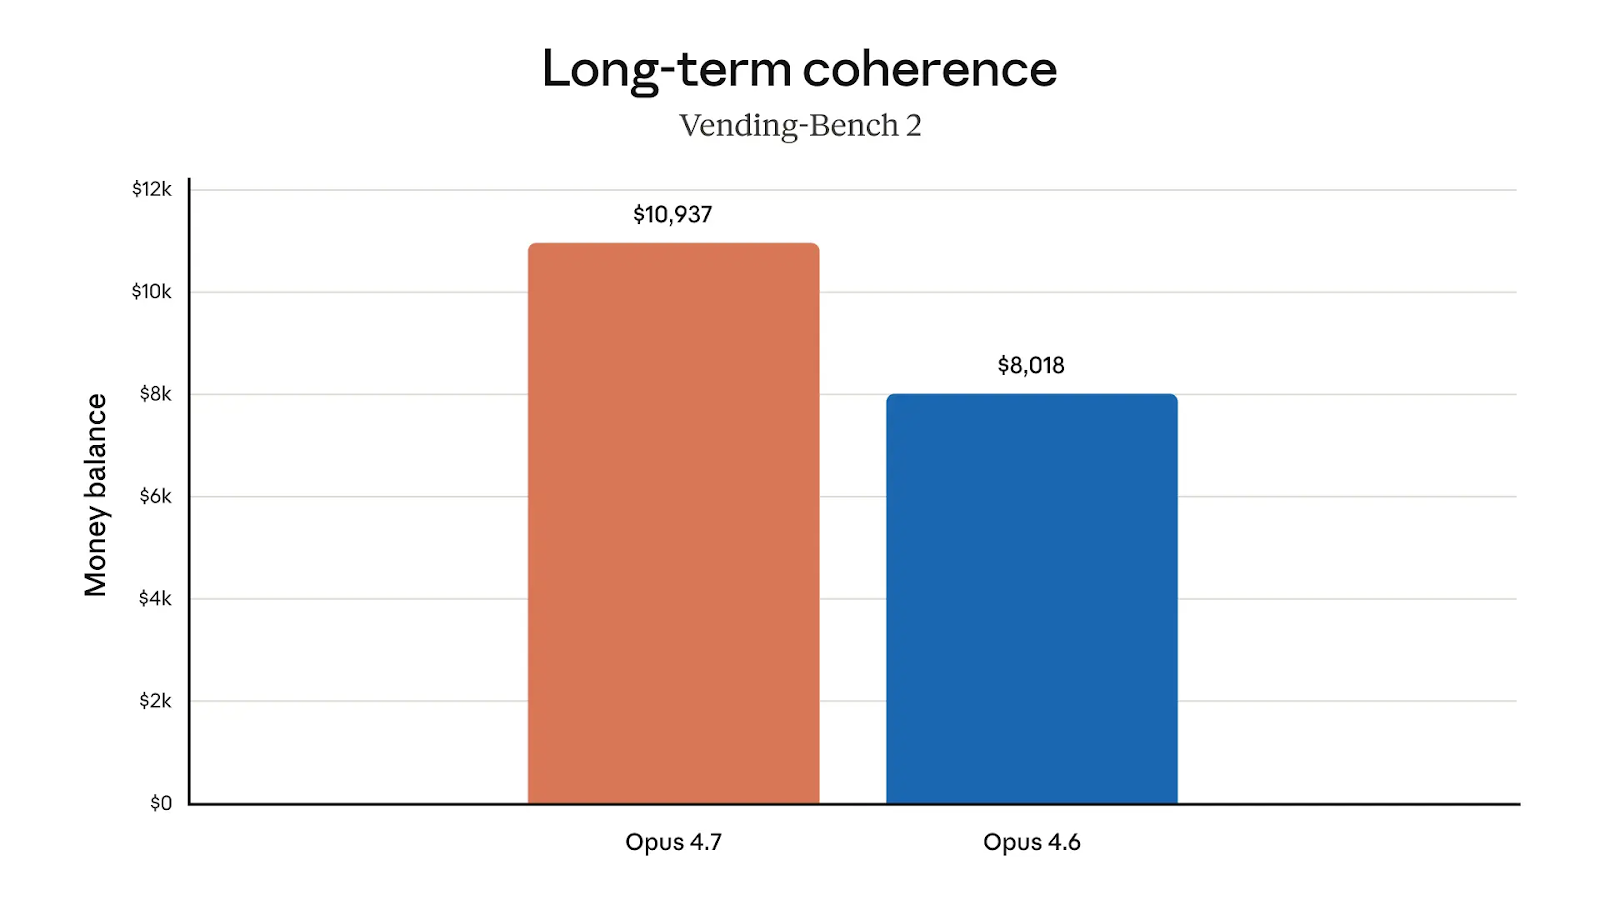
Sur Vending-Bench 2, plus orienté pratique, on constate aussi qu’Opus 4.7 gère mieux l’argent : en moyenne, le modèle termine avec 10 937 $, contre 8 018 $ pour Opus 4.6.
Comment accéder à Claude Opus 4.7
Anthropic ne nous fait pas attendre. Opus 4.7 est désormais disponible :
-
Dans tous les produits Claude
-
Via l’API Claude (
claude-opus-4-7) -
Vertex AI, et
-
Microsoft Foundry
Quid du prix de Claude Opus 4.7 ?
En ces temps, on craint toujours l’inflation ; heureusement, le tarif reste identique à Opus 4.6 : 5 $ par million de tokens en entrée et 25 $ par million de tokens en sortie. (Aucune hausse entre Opus 4.6 et 4.7 non plus.)
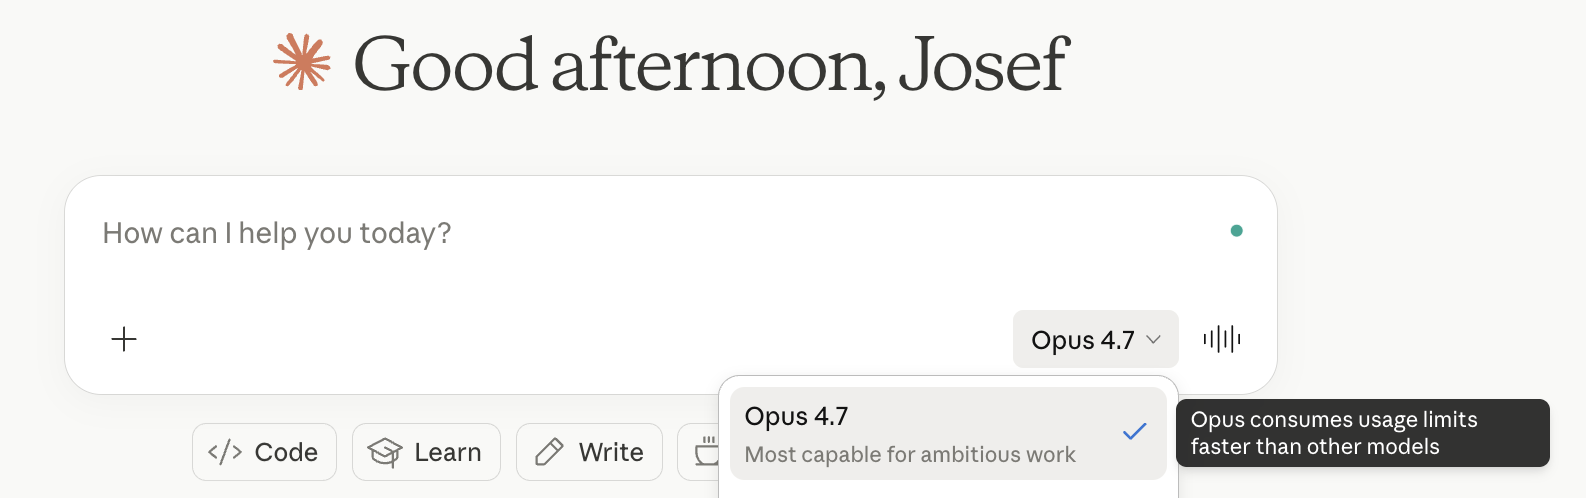
Rappel général si vous utilisez Opus dans Claude.ai : chaque message inclut toute la conversation à ce stade (votre nouvelle question + tous les échanges précédents) ainsi que la réponse du modèle. Tout cela est comptabilisé en tokens. Votre offre, quelle qu’elle soit, dispose d’un budget de tokens qui se reconstitue en fenêtre glissante.
Les modèles ne débitent pas tous ce budget au même rythme. Opus est le plus onéreux car c’est le plus puissant. Ordre de grandeur publié : Opus coûte environ 5 fois plus que Sonnet par token.
Quoi d’autre a été lancé avec Opus 4.7 ?
Anthropic a également livré plusieurs mises à jour utiles, notamment si vous utilisez Claude Code ou que vous construisez sur l’API.
Nouvel effort xhigh
Un nouveau niveau d’effort xhigh (« extra high ») s’intercale entre high et max. Il offre une option supplémentaire pour arbitrer entre profondeur de raisonnement et latence. Dans Claude Code, le niveau par défaut passe à xhigh pour tous les forfaits, et Anthropic recommande de démarrer en high ou xhigh pour tester Opus 4.7 sur les tâches de code et d’agents.
/ultrareview dans Claude Code
Claude Code gagne une nouvelle commande barre oblique /ultrareview, qui exécute une passe de revue dédiée sur vos changements et signale des bugs ou problèmes de conception qu’un relecteur humain méticuleux détecterait. Les utilisateurs Pro et Max disposent de trois ultrareviews gratuites pour l’essayer.
Mode auto pour les utilisateurs Max
Les utilisateurs Max accèdent désormais au mode auto, un réglage d’autorisations où Claude prend certaines décisions pour vous. C’est un juste milieu entre valider chaque étape et supprimer les permissions.
Budgets de tâche sur l’API
Les budgets de tâche sont en bêta publique sur l’API Claude. Ils permettent de plafonner la dépense de tokens sur une exécution, très utile pour des workflows d’agents longs, afin d’inciter le modèle à gérer son rythme plutôt que de brûler le budget.
Claude Opus 4.7 vs GPT-5.4
Nous avons examiné de près les résultats, qui incluent une comparaison avec d’autres modèles. En synthèse, comparons directement Opus 4.7 à GPT 5.4.
L’idée clé : Opus 4.7 est optimisé pour l’autonomie sur le long cours. GPT 5.4 est un modèle généraliste unifié, avec un écosystème d’outils plus large et un tarif plus avantageux en court contexte.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| Excellence | Longues sessions de code, usage de l’ordinateur de bureau, vision dense |
Recherche web, tâches court contexte, pilotage en cours de réponse |
| SWE-bench Pro | 64,3 % | 57,7 % |
| BrowseComp | 79,3 % | 89,3 % |
| Tarification | Forfait plat jusqu’à 1 M de contexte | Moins cher sous 272 K, toute la session est re-tarifée au-delà |
| Fenêtre de contexte | ~1 M de tokens | ~1 M de tokens |
Pour la comparaison complète avec le modèle successeur d’OpenAI, GPT-5.5, consultez notre article Claude Opus 4.7 vs GPT-5.5.
Ce que l’on dit de Claude Opus 4.7
Certains utilisateurs constatent des perturbations dans leurs pipelines, Opus 4.7 suivant les consignes plus littéralement qu’avant. Anthropic avait prévenu de la nécessité de réaccorder les prompts.
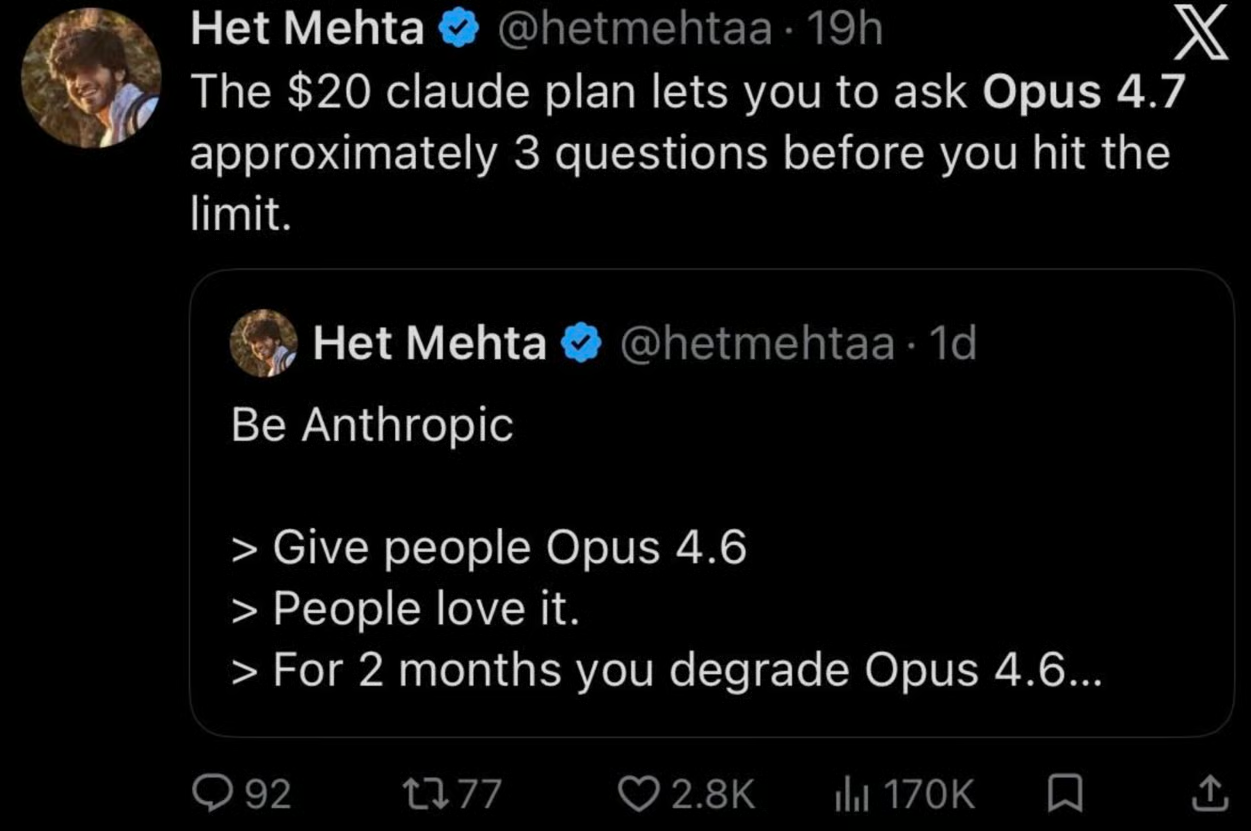
D’autres s’inquiètent de l’usage de tokens. Avec cette sortie, Anthropic a relevé les limites de débit pour tous afin de compenser l’utilisation accrue, mais il n’est pas évident que cela neutralise totalement l’impact.
Conclusion
Claude Opus 4.7 est le modèle le plus capable auquel la plupart peuvent réellement accéder aujourd’hui. Tous les progrès vont dans le même sens : des agents qui tournent plus longtemps avec moins de supervision, soutenus par de meilleures capacités de codage, une vision plus fine et une mémoire inter-sessions renforcée.
Ce qui rend cette version particulière, c’est le cadrage par Mythos. Opus 4.7 est un véhicule d’essai avec contraintes cyber sur la route vers une sortie plus large de classe Mythos : il y a un plafond au-dessus, inaccessible pour l’instant — mais les garde-fous livrés avec 4.7 préfigurent la façon dont Anthropic abordera ses futures sorties de pointe.
Author
Josef Waples