Qwen3 अब तक जारी किए गए सबसे व्यापक ओपन-वेट मॉडल सूट्स में से एक है।
यह Alibaba की Qwen टीम से आता है और इसमें ऐसे मॉडल शामिल हैं जो रिसर्च-ग्रेड प्रदर्शन तक स्केल करते हैं, साथ ही छोटे वर्ज़न भी हैं जिन्हें साधारण हार्डवेयर पर लोकल रूप से चलाया जा सकता है।
इस ब्लॉग में, मैं आपको पूरे Qwen3 सूट का एक त्वरित ओवरव्यू दूंगा, बताऊंगा कि मॉडल कैसे विकसित किए गए, बेंचमार्क परिणामों पर चलूंगा, और दिखाऊंगा कि आप इन्हें कैसे एक्सेस कर सकते हैं और उपयोग शुरू कर सकते हैं।
हमने Ollama के साथ Qwen3 को लोकल रूप से चलाने और Qwen3 को फाइन-ट्यून करने पर भी ट्यूटोरियल प्रकाशित किए हैं।
हम अपने पाठकों को The Median, हमारे मुफ्त शुक्रवार न्यूज़लेटर के माध्यम से AI की ताज़ा खबरों से अपडेट रखते हैं, जो हफ्ते की प्रमुख खबरों को सरलता से समझाता है। सदस्यता लें और हर हफ्ते कुछ ही मिनटों में अपडेट रहें:
Qwen 3 क्या है?
Qwen3, Alibaba की Qwen टीम का नवीनतम बड़े भाषा मॉडल परिवार है। इस लाइनअप के सभी मॉडल Apache 2.0 लाइसेंस के तहत ओपन-वेटेड हैं।
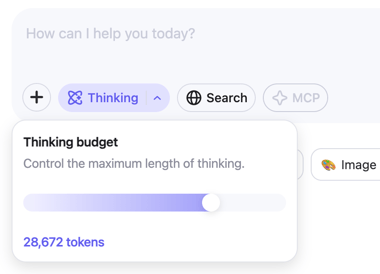
जिसने मेरा ध्यान तुरंत खींचा, वह था Qwen ऐप के अंदर सीधे उपयोगकर्ता-नियंत्रित “थिंकिंग बजट” का परिचय। यह सामान्य उपयोगकर्ताओं को तर्क-प्रक्रिया पर सूक्ष्म नियंत्रण देता है—जो पहले केवल प्रोग्रामेटिक रूप से ही संभव था।
जैसा कि हम नीचे दिए गए ग्राफ़ में देख सकते हैं, थिंकिंग बजट बढ़ाने से प्रदर्शन में महत्वपूर्ण सुधार होता है, खासकर गणित, कोडिंग, और विज्ञान के लिए।
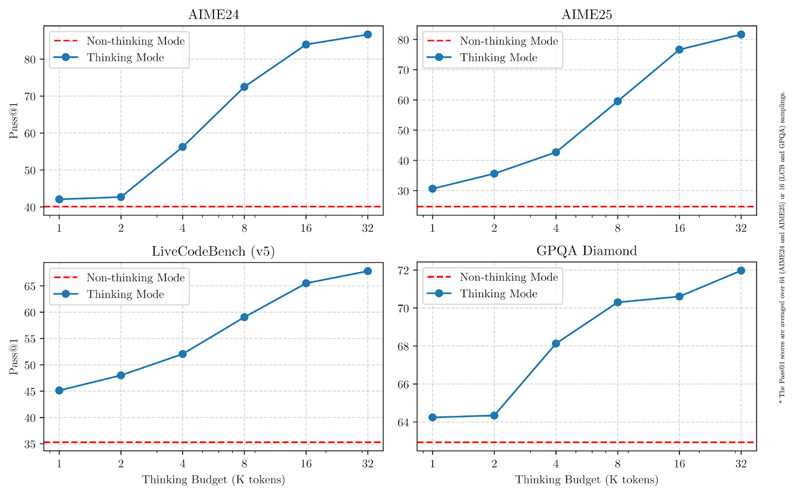
स्रोत: Qwen
बेंचमार्क टेस्ट में, फ्लैगशिप Qwen3-235B-A22B अन्य टॉप-टियर मॉडलों के मुकाबले प्रतिस्पर्धी प्रदर्शन करता है और DeepSeek-R1 को कोडिंग, गणित और सामान्य तर्क में पीछे छोड़ता है। आइए हर मॉडल पर संक्षेप में नज़र डालें और समझें कि इन्हें किस उद्देश्य के लिए डिज़ाइन किया गया है।
Qwen3-235B-A22B
यह Qwen3 लाइनअप का सबसे बड़ा मॉडल है। यह mixture-of-experts (MoE) आर्किटेक्चर का उपयोग करता है, जिसमें कुल 235 बिलियन पैरामीटर हैं और प्रत्येक जनरेशन स्टेप पर 22 बिलियन सक्रिय रहते हैं।
MoE मॉडल में, हर स्टेप पर केवल पैरामीटरों का एक छोटा सबसेट सक्रिय होता है, जिससे यह डेंस मॉडलों (जैसे GPT-4o) की तुलना में तेज़ और सस्ता हो जाता है, जहाँ सभी पैरामीटर हमेशा उपयोग होते हैं।
यह मॉडल गणित, तर्क, और कोडिंग कार्यों में अच्छा प्रदर्शन करता है, और बेंचमार्क तुलना में DeepSeek-R1 जैसे मॉडलों से आगे निकलता है।
Qwen3-30B-A3B
Qwen3-30B-A3B एक छोटा MoE मॉडल है, जिसमें कुल 30 बिलियन पैरामीटर हैं और हर स्टेप पर केवल 3 बिलियन सक्रिय होते हैं। कम सक्रिय काउंट के बावजूद, यह कहीं बड़े डेंस मॉडलों जैसे QwQ-32B के बराबर प्रदर्शन करता है। यह उन उपयोगकर्ताओं के लिए व्यावहारिक विकल्प है जो तर्क क्षमता और कम इन्फरेंस लागत के बीच संतुलन चाहते हैं। 235B मॉडल की तरह, यह 128K कॉन्टेक्स्ट विंडो सपोर्ट करता है और Apache 2.0 के तहत उपलब्ध है।
डेंस मॉडल: 32B, 14B, 8B, 4B, 1.7B, 0.6B
Qwen3 रिलीज़ के छह डेंस मॉडल पारंपरिक आर्किटेक्चर का पालन करते हैं जिसमें हर स्टेप पर सभी पैरामीटर सक्रिय होते हैं। ये व्यापक उपयोग मामलों को कवर करते हैं:
Qwen3-32B, 14B, 8B 128K कॉन्टेक्स्ट विंडो सपोर्ट करते हैं, जबकि Qwen3-4B, 1.7B, 0.6B 32K सपोर्ट करते हैं। सभी ओपन-वेटेड हैं और Apache 2.0 के तहत लाइसेंस प्राप्त हैं। इस समूह के छोटे मॉडल हल्के डिप्लॉयमेंट के लिए उपयुक्त हैं, जबकि बड़े मॉडल सामान्य-उद्देश्य LLMs के करीब हैं।
आप किस मॉडल का चयन करें?
Qwen3 तर्क की गहराई, गति और कम्प्यूटेशनल लागत की आपकी आवश्यकता के अनुसार अलग-अलग मॉडल प्रदान करता है। यहाँ एक त्वरित ओवरव्यू है:
|
Model
|
Type
|
Context Length
|
Best For
|
|
Qwen3-235B-A22B
|
MoE
|
128K
|
रिसर्च कार्य, एजेंट वर्कफ़्लो, लंबी तर्क-श्रृंखलाएँ
|
|
Qwen3-30B-A3B
|
MoE
|
128K
|
कम इन्फरेंस लागत पर संतुलित तर्क
|
|
Qwen3-32B
|
Dense
|
128K
|
हाई-एंड जनरल-पर्पस डिप्लॉयमेंट
|
|
Qwen3-14B
|
Dense
|
128K
|
मिड-रेंज ऐप्स जिन्हें मजबूत तर्क चाहिए
|
|
Qwen3-8B
|
Dense
|
128K
|
हल्के तर्क कार्य
|
|
Qwen3-4B
|
Dense
|
32K
|
छोटे अनुप्रयोग, तेज़ इन्फरेंस
|
|
Qwen3-1.7B
|
Dense
|
32K
|
मोबाइल और एम्बेडेड उपयोग
|
|
Qwen3-0.6B
|
Dense
|
32K
|
अत्यंत हल्के या सीमित वातावरण
|
यदि आप ऐसे कार्यों पर काम कर रहे हैं जिन्हें गहरी तर्क-क्षमता, एजेंट टूल उपयोग, या लंबा कॉन्टेक्स्ट हैंडलिंग चाहिए, तो Qwen3-235B-A22B आपको सबसे अधिक लचीलापन देगा।
ऐसे मामलों में जहाँ आप इन्फरेंस को तेज़ और सस्ता रखना चाहते हैं, जबकि मध्यम जटिल कार्यों को भी संभालना है, Qwen3-30B-A3B मज़बूत विकल्प है।
डेंस मॉडल सरल डिप्लॉयमेंट और पूर्वानुमेय लेटेंसी प्रदान करते हैं, जिससे वे छोटे पैमाने के अनुप्रयोगों के लिए बेहतर फिट होते हैं।
Qwen3 कैसे विकसित किया गया
Qwen3 मॉडल तीन-चरणीय प्रीट्रेनिंग फेज़ और फिर चार-चरणीय पोस्ट-ट्रेनिंग पाइपलाइन से होकर बनाए गए।
प्रीट्रेनिंग में मॉडल विशाल मात्रा में डेटा (भाषा, तर्क, गणित, कोड) से सामान्य पैटर्न सीखता है, बिना यह बताए कि ठीक-ठीक क्या करना है। पोस्ट-ट्रेनिंग में मॉडल को विशेष तरीकों से व्यवहार करने के लिए फाइन-ट्यून किया जाता है, जैसे सावधानी से तर्क करना या निर्देशों का पालन करना।
मैं दोनों हिस्सों को सरल शब्दों में समझाऊंगा, बिना बहुत तकनीकी विवरण में गए।
प्रीट्रेनिंग
Qwen2.5 की तुलना में, Qwen3 के लिए प्रीट्रेनिंग डेटासेट को काफी बढ़ाया गया। लगभग 36 ट्रिलियन टोकन उपयोग हुए—पिछली पीढ़ी की तुलना में दोगुने। डेटा में वेब सामग्री, दस्तावेज़ों से निकला पाठ, और Qwen2.5 मॉडलों द्वारा जनरेट किए गए सिंथेटिक गणित और कोड उदाहरण शामिल थे।
प्रीट्रेनिंग प्रक्रिया तीन चरणों में चली:
- चरण 1: 4K कॉन्टेक्स्ट लंबाई के साथ 30 ट्रिलियन से अधिक टोकनों से बुनियादी भाषा और ज्ञान कौशल सीखे गए।
- चरण 2: डेटासेट को परिष्कृत कर STEM, कोडिंग और तर्क डेटा का हिस्सा बढ़ाया गया, और अतिरिक्त 5 ट्रिलियन टोकन जोड़े गए।
- चरण 3: उच्च-गुणवत्ता वाले लंबे कॉन्टेक्स्ट डेटा का उपयोग कर मॉडलों को 32K कॉन्टेक्स्ट विंडो तक विस्तारित किया गया।
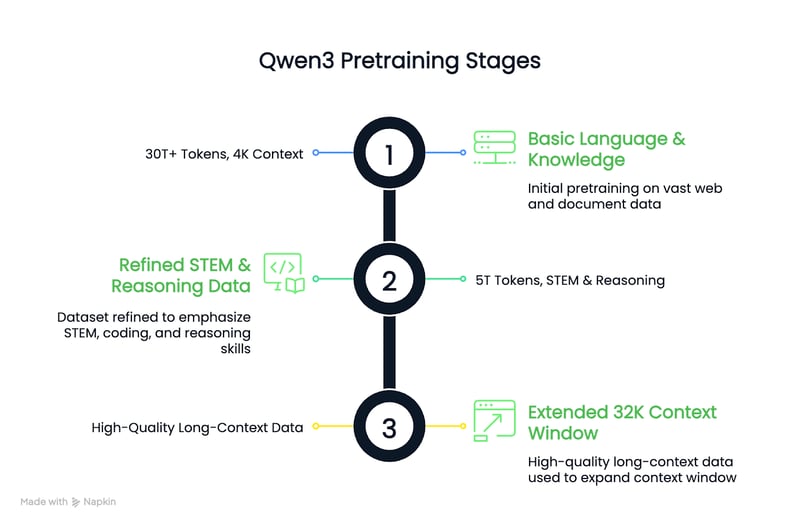
परिणाम यह है कि डेंस Qwen3 बेस मॉडल, कम पैरामीटरों का उपयोग करते हुए भी, बड़े Qwen2.5 बेस मॉडलों के बराबर या बेहतर हैं—खासकर STEM और तर्क कार्यों में।
पोस्ट-ट्रेनिंग
Qwen3 की पोस्ट-ट्रेनिंग पाइपलाइन ने गहरे तर्क और तेज़ प्रतिक्रिया क्षमताओं को एक ही मॉडल में एकीकृत करने पर ध्यान केंद्रित किया। पहले नीचे दिए गए आरेख पर नज़र डालते हैं, फिर मैं इसे चरण-दर-चरण समझाऊंगा:
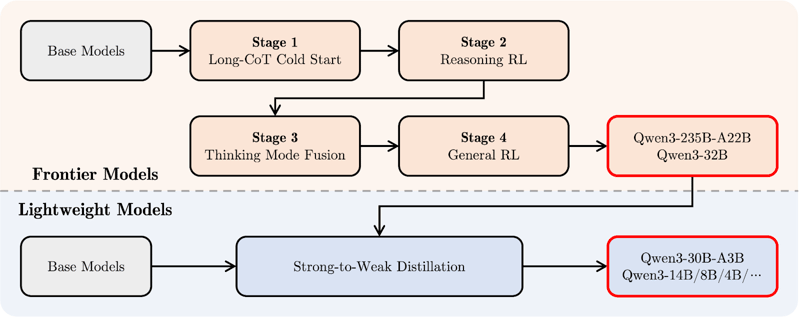
Qwen 3 पोस्ट-ट्रेनिंग पाइपलाइन। स्रोत: Qwen
ऊपर (नारंगी में) आप बड़े “Frontier Models” जैसे Qwen3-235B-A22B और Qwen3-32B की विकास-रेखा देख सकते हैं। यह Long Chain-of-Thought Cold Start (चरण 1) से शुरू होता है, जहाँ मॉडल कठिन कार्यों पर चरण-दर-चरण तर्क करना सीखता है।
इसके बाद Reasoning Reinforcement Learning (RL) (चरण 2) आता है ताकि बेहतर समस्या-समाधान रणनीतियाँ प्रोत्साहित हों। चरण 3, जिसे Thinking Mode Fusion कहते हैं, में Qwen3 धीमे, सावधानीपूर्वक तर्क और तेज़ प्रतिक्रियाओं के बीच संतुलन बनाना सीखता है। अंत में, एक General RL चरण इसके व्यवहार को निर्देश-पालन और एजेंटिक उपयोग मामलों जैसे विस्तृत कार्यों में सुधारता है।
इसके नीचे (हल्के नीले में) आप “Lightweight Models” जैसे Qwen3-30B-A3B और छोटे डेंस मॉडलों की राह देखेंगे। इन मॉडलों को स्ट्रॉन्ग-टू-वीक डिस्टिलेशन से प्रशिक्षित किया गया है—एक प्रक्रिया जिसमें बड़े मॉडलों का ज्ञान छोटे, तेज़ मॉडलों में संपीडित किया जाता है, बिना अधिक तर्क-क्षमता खोए।
सरल शब्दों में: पहले बड़े मॉडल प्रशिक्षित किए गए, और फिर उनसे लाइटवेट मॉडल डिस्टिल किए गए। इस तरह, बहुत अलग आकारों के बावजूद, पूरा Qwen3 परिवार एक समान सोचने की शैली साझा करता है।
Qwen 3 बेंचमार्क
Qwen3 मॉडलों का विभिन्न तर्क, कोडिंग, और सामान्य ज्ञान बेंचमार्क पर मूल्यांकन किया गया। परिणाम दिखाते हैं कि Qwen3-235B-A22B अधिकांश कार्यों में आगे है, लेकिन छोटे Qwen3-30B-A3B और Qwen3-4B मॉडल भी अच्छा प्रदर्शन देते हैं।
Qwen3-235B-A22B और Qwen3-32B
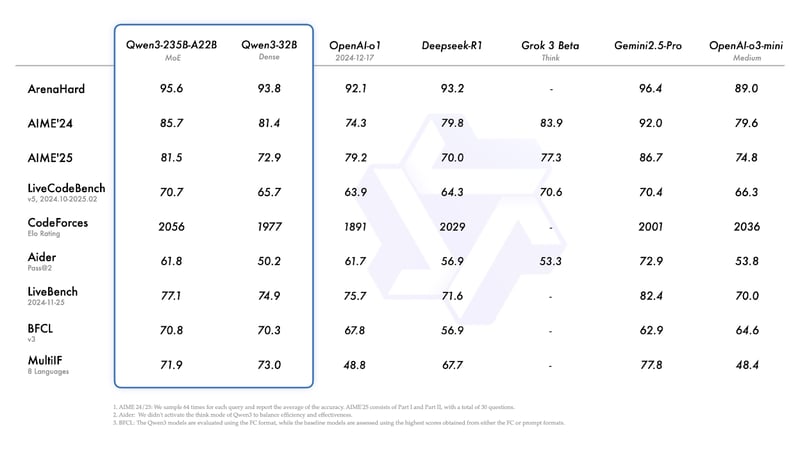
अधिकांश बेंचमार्क पर, Qwen3-235B-A22B शीर्ष-प्रदर्शन करने वाले मॉडलों में है, भले ही हमेशा लीडर न हो।
स्रोत: Qwen
आइए ऊपर दिए परिणामों को संक्षेप में समझें:
- ArenaHard (समग्र तर्क): Gemini 2.5 Pro 96.4 के साथ अग्रणी है। Qwen3-235B 95.6 पर ठीक पीछे है, o1 और DeepSeek-R1 से आगे। (ध्यान दें कि Gemini 3 अब उपलब्ध है)
- AIME’24 / AIME’25 (गणित): स्कोर 85.7 और 81.4। Gemini 2.5 Pro फिर से ऊँचा है, लेकिन Qwen3-235B अभी भी DeepSeek-R1, Grok 3, और o3-mini से बेहतर है।
- LiveCodeBench (कोड जनरेशन): 235B मॉडल के लिए 70.7—अधिकांश मॉडलों से बेहतर, Gemini को छोड़कर।
- CodeForces Elo (कम्पेटिटिव प्रोग्रामिंग): 2056, सूचीबद्ध सभी अन्य मॉडलों से ऊँचा, जिसमें DeepSeek-R1 और Gemini 2.5 Pro शामिल हैं।
- LiveBench (वास्तविक-जीवन सामान्य कार्य): 77.1, फिर से केवल Gemini 2.5 Pro से पीछे।
- MultiIF (बहुभाषी तर्क): छोटा Qwen3-32B यहाँ बेहतर स्कोर करता है (73.0), लेकिन फिर भी Gemini (77.8) से पीछे है।
Qwen3-30B-A3B और Qwen3-4B
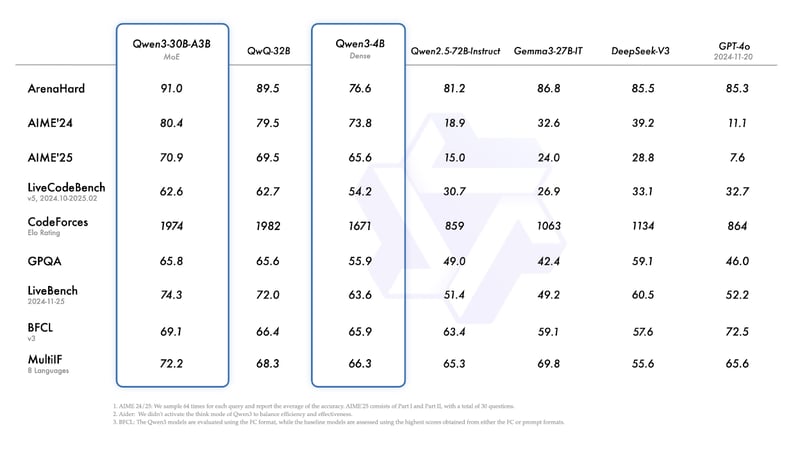
Qwen3-30B-A3B (छोटा MoE मॉडल) लगभग सभी बेंचमार्क पर अच्छा प्रदर्शन करता है, और समान आकार के डेंस मॉडलों की बराबरी या उन्हें पीछे छोड़ता है।
- ArenaHard: 91.0—QwQ-32B (89.5), DeepSeek-V3 (85.5), और GPT-4o (85.3) से ऊपर।
- AIME’24 / AIME’25: 80.4—QwQ-32B से थोड़ा आगे, और अन्य मॉडलों से बहुत आगे।
- CodeForces Elo: 1974—QwQ-32B (1982) से थोड़ा कम।
- GPQA (ग्रेजुएट-स्तरीय QA): 65.8—लगभग QwQ-32B के बराबर।
- MultiIF: 72.2—QwQ-32B (68.3) से अधिक।
स्रोत: Qwen
Qwen3-4B अपने आकार के अनुसार ठोस प्रदर्शन दिखाता है:
- ArenaHard: 76.6
- AIME’24 / AIME’25: 73.8 और 65.6—स्पष्ट रूप से पहले के और कहीं बड़े Qwen2.5 मॉडलों तथा Gemma-27B-IT जैसे मॉडलों से मज़बूत।
- CodeForces Elo: 1671—बड़े मॉडलों के साथ प्रतिस्पर्धी नहीं, लेकिन अपने वेट क्लास के अनुरूप।
- MultiIF: 66.3—4B डेंस मॉडल के लिए सराहनीय, और समान आकार के कई बेसलाइनों से आगे।
Qwen3 को कैसे एक्सेस करें
Qwen3 मॉडल सार्वजनिक रूप से उपलब्ध हैं और चैट ऐप पर, API के माध्यम से, लोकल डिप्लॉयमेंट के लिए डाउनलोड करके, या कस्टम सेटअप में एकीकृत करके उपयोग किए जा सकते हैं।
चैट इंटरफेस
आप सीधे यहाँ Qwen3 आज़मा सकते हैं chat.qwen.ai।
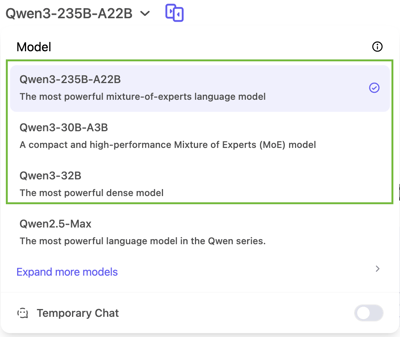
चैट ऐप में आप Qwen 3 परिवार के केवल तीन मॉडल एक्सेस कर पाएँगे: Qwen3-235B, Qwen3-30B, और Qwen3-32B:
Qwen 3 API एक्सेस
Qwen3, ModelScope या DashScope जैसे प्रदाताओं के माध्यम से OpenAI-संगत API फ़ॉर्मैट्स के साथ काम करता है। vLLM और SGLang जैसे टूल लोकल या सेल्फ-होस्टेड डिप्लॉयमेंट के लिए कुशल सर्विंग प्रदान करते हैं। आधिकारिक Qwen 3 ब्लॉग में इस बारे में अधिक विवरण हैं।
ओपन वेट्स
सभी Qwen3 मॉडल—MoE और डेंस दोनों—Apache 2.0 लाइसेंस के तहत जारी किए गए हैं। ये यहाँ उपलब्ध हैं:
लोकल डिप्लॉयमेंट
आप Qwen3 को लोकल रूप से इनका उपयोग करके भी चला सकते हैं:
- Ollama
- LM Studio
- llama.cpp
- KTransformers
निष्कर्ष
Qwen3 अब तक जारी किए गए सबसे व्यापक ओपन-वेट मॉडल सूट्स में से एक है।
फ्लैगशिप 235B MoE मॉडल तर्क, गणित, और कोडिंग कार्यों में अच्छा प्रदर्शन करता है, जबकि 30B और 4B वर्ज़न छोटे पैमाने या बजट-संवेदी डिप्लॉयमेंट के लिए व्यावहारिक विकल्प देते हैं। मॉडल के “थिंकिंग बजट” को समायोजित करने की क्षमता सामान्य उपयोगकर्ताओं के लिए अतिरिक्त लचीलापन जोड़ती है।
वर्तमान रूप में, Qwen3 एक संतुलित रिलीज़ है जो व्यापक उपयोग मामलों को कवर करता है और रिसर्च तथा प्रोडक्शन—दोनों सेटिंग्स में उपयोग के लिए तैयार है।


Qwen3 अब तक जारी किए गए सबसे व्यापक ओपन-वेट मॉडल सूट्स में से एक है।
यह Alibaba की Qwen टीम से आता है और इसमें ऐसे मॉडल शामिल हैं जो रिसर्च-ग्रेड प्रदर्शन तक स्केल करते हैं, साथ ही छोटे वर्ज़न भी हैं जिन्हें साधारण हार्डवेयर पर लोकल रूप से चलाया जा सकता है।
इस ब्लॉग में, मैं आपको पूरे Qwen3 सूट का एक त्वरित ओवरव्यू दूंगा, बताऊंगा कि मॉडल कैसे विकसित किए गए, बेंचमार्क परिणामों पर चलूंगा, और दिखाऊंगा कि आप इन्हें कैसे एक्सेस कर सकते हैं और उपयोग शुरू कर सकते हैं।
हमने Ollama के साथ Qwen3 को लोकल रूप से चलाने और Qwen3 को फाइन-ट्यून करने पर भी ट्यूटोरियल प्रकाशित किए हैं।
हम अपने पाठकों को The Median, हमारे मुफ्त शुक्रवार न्यूज़लेटर के माध्यम से AI की ताज़ा खबरों से अपडेट रखते हैं, जो हफ्ते की प्रमुख खबरों को सरलता से समझाता है। सदस्यता लें और हर हफ्ते कुछ ही मिनटों में अपडेट रहें:
Qwen 3 क्या है?
Qwen3, Alibaba की Qwen टीम का नवीनतम बड़े भाषा मॉडल परिवार है। इस लाइनअप के सभी मॉडल Apache 2.0 लाइसेंस के तहत ओपन-वेटेड हैं।
जिसने मेरा ध्यान तुरंत खींचा, वह था Qwen ऐप के अंदर सीधे उपयोगकर्ता-नियंत्रित “थिंकिंग बजट” का परिचय। यह सामान्य उपयोगकर्ताओं को तर्क-प्रक्रिया पर सूक्ष्म नियंत्रण देता है—जो पहले केवल प्रोग्रामेटिक रूप से ही संभव था।
जैसा कि हम नीचे दिए गए ग्राफ़ में देख सकते हैं, थिंकिंग बजट बढ़ाने से प्रदर्शन में महत्वपूर्ण सुधार होता है, खासकर गणित, कोडिंग, और विज्ञान के लिए।
स्रोत: Qwen
बेंचमार्क टेस्ट में, फ्लैगशिप Qwen3-235B-A22B अन्य टॉप-टियर मॉडलों के मुकाबले प्रतिस्पर्धी प्रदर्शन करता है और DeepSeek-R1 को कोडिंग, गणित और सामान्य तर्क में पीछे छोड़ता है। आइए हर मॉडल पर संक्षेप में नज़र डालें और समझें कि इन्हें किस उद्देश्य के लिए डिज़ाइन किया गया है।
Qwen3-235B-A22B
यह Qwen3 लाइनअप का सबसे बड़ा मॉडल है। यह mixture-of-experts (MoE) आर्किटेक्चर का उपयोग करता है, जिसमें कुल 235 बिलियन पैरामीटर हैं और प्रत्येक जनरेशन स्टेप पर 22 बिलियन सक्रिय रहते हैं।
MoE मॉडल में, हर स्टेप पर केवल पैरामीटरों का एक छोटा सबसेट सक्रिय होता है, जिससे यह डेंस मॉडलों (जैसे GPT-4o) की तुलना में तेज़ और सस्ता हो जाता है, जहाँ सभी पैरामीटर हमेशा उपयोग होते हैं।
यह मॉडल गणित, तर्क, और कोडिंग कार्यों में अच्छा प्रदर्शन करता है, और बेंचमार्क तुलना में DeepSeek-R1 जैसे मॉडलों से आगे निकलता है।
Qwen3-30B-A3B
Qwen3-30B-A3B एक छोटा MoE मॉडल है, जिसमें कुल 30 बिलियन पैरामीटर हैं और हर स्टेप पर केवल 3 बिलियन सक्रिय होते हैं। कम सक्रिय काउंट के बावजूद, यह कहीं बड़े डेंस मॉडलों जैसे QwQ-32B के बराबर प्रदर्शन करता है। यह उन उपयोगकर्ताओं के लिए व्यावहारिक विकल्प है जो तर्क क्षमता और कम इन्फरेंस लागत के बीच संतुलन चाहते हैं। 235B मॉडल की तरह, यह 128K कॉन्टेक्स्ट विंडो सपोर्ट करता है और Apache 2.0 के तहत उपलब्ध है।
डेंस मॉडल: 32B, 14B, 8B, 4B, 1.7B, 0.6B
Qwen3 रिलीज़ के छह डेंस मॉडल पारंपरिक आर्किटेक्चर का पालन करते हैं जिसमें हर स्टेप पर सभी पैरामीटर सक्रिय होते हैं। ये व्यापक उपयोग मामलों को कवर करते हैं:
Qwen3-32B, 14B, 8B 128K कॉन्टेक्स्ट विंडो सपोर्ट करते हैं, जबकि Qwen3-4B, 1.7B, 0.6B 32K सपोर्ट करते हैं। सभी ओपन-वेटेड हैं और Apache 2.0 के तहत लाइसेंस प्राप्त हैं। इस समूह के छोटे मॉडल हल्के डिप्लॉयमेंट के लिए उपयुक्त हैं, जबकि बड़े मॉडल सामान्य-उद्देश्य LLMs के करीब हैं।
आप किस मॉडल का चयन करें?
Qwen3 तर्क की गहराई, गति और कम्प्यूटेशनल लागत की आपकी आवश्यकता के अनुसार अलग-अलग मॉडल प्रदान करता है। यहाँ एक त्वरित ओवरव्यू है:
Model
Type
Context Length
Best For
Qwen3-235B-A22B
MoE
128K
रिसर्च कार्य, एजेंट वर्कफ़्लो, लंबी तर्क-श्रृंखलाएँ
Qwen3-30B-A3B
MoE
128K
कम इन्फरेंस लागत पर संतुलित तर्क
Qwen3-32B
Dense
128K
हाई-एंड जनरल-पर्पस डिप्लॉयमेंट
Qwen3-14B
Dense
128K
मिड-रेंज ऐप्स जिन्हें मजबूत तर्क चाहिए
Qwen3-8B
Dense
128K
हल्के तर्क कार्य
Qwen3-4B
Dense
32K
छोटे अनुप्रयोग, तेज़ इन्फरेंस
Qwen3-1.7B
Dense
32K
मोबाइल और एम्बेडेड उपयोग
Qwen3-0.6B
Dense
32K
अत्यंत हल्के या सीमित वातावरण
यदि आप ऐसे कार्यों पर काम कर रहे हैं जिन्हें गहरी तर्क-क्षमता, एजेंट टूल उपयोग, या लंबा कॉन्टेक्स्ट हैंडलिंग चाहिए, तो Qwen3-235B-A22B आपको सबसे अधिक लचीलापन देगा।
ऐसे मामलों में जहाँ आप इन्फरेंस को तेज़ और सस्ता रखना चाहते हैं, जबकि मध्यम जटिल कार्यों को भी संभालना है, Qwen3-30B-A3B मज़बूत विकल्प है।
डेंस मॉडल सरल डिप्लॉयमेंट और पूर्वानुमेय लेटेंसी प्रदान करते हैं, जिससे वे छोटे पैमाने के अनुप्रयोगों के लिए बेहतर फिट होते हैं।
Qwen3 कैसे विकसित किया गया
Qwen3 मॉडल तीन-चरणीय प्रीट्रेनिंग फेज़ और फिर चार-चरणीय पोस्ट-ट्रेनिंग पाइपलाइन से होकर बनाए गए।
प्रीट्रेनिंग में मॉडल विशाल मात्रा में डेटा (भाषा, तर्क, गणित, कोड) से सामान्य पैटर्न सीखता है, बिना यह बताए कि ठीक-ठीक क्या करना है। पोस्ट-ट्रेनिंग में मॉडल को विशेष तरीकों से व्यवहार करने के लिए फाइन-ट्यून किया जाता है, जैसे सावधानी से तर्क करना या निर्देशों का पालन करना।
मैं दोनों हिस्सों को सरल शब्दों में समझाऊंगा, बिना बहुत तकनीकी विवरण में गए।
प्रीट्रेनिंग
Qwen2.5 की तुलना में, Qwen3 के लिए प्रीट्रेनिंग डेटासेट को काफी बढ़ाया गया। लगभग 36 ट्रिलियन टोकन उपयोग हुए—पिछली पीढ़ी की तुलना में दोगुने। डेटा में वेब सामग्री, दस्तावेज़ों से निकला पाठ, और Qwen2.5 मॉडलों द्वारा जनरेट किए गए सिंथेटिक गणित और कोड उदाहरण शामिल थे।
प्रीट्रेनिंग प्रक्रिया तीन चरणों में चली:
परिणाम यह है कि डेंस Qwen3 बेस मॉडल, कम पैरामीटरों का उपयोग करते हुए भी, बड़े Qwen2.5 बेस मॉडलों के बराबर या बेहतर हैं—खासकर STEM और तर्क कार्यों में।
पोस्ट-ट्रेनिंग
Qwen3 की पोस्ट-ट्रेनिंग पाइपलाइन ने गहरे तर्क और तेज़ प्रतिक्रिया क्षमताओं को एक ही मॉडल में एकीकृत करने पर ध्यान केंद्रित किया। पहले नीचे दिए गए आरेख पर नज़र डालते हैं, फिर मैं इसे चरण-दर-चरण समझाऊंगा:
Qwen 3 पोस्ट-ट्रेनिंग पाइपलाइन। स्रोत: Qwen
ऊपर (नारंगी में) आप बड़े “Frontier Models” जैसे Qwen3-235B-A22B और Qwen3-32B की विकास-रेखा देख सकते हैं। यह Long Chain-of-Thought Cold Start (चरण 1) से शुरू होता है, जहाँ मॉडल कठिन कार्यों पर चरण-दर-चरण तर्क करना सीखता है।
इसके बाद Reasoning Reinforcement Learning (RL) (चरण 2) आता है ताकि बेहतर समस्या-समाधान रणनीतियाँ प्रोत्साहित हों। चरण 3, जिसे Thinking Mode Fusion कहते हैं, में Qwen3 धीमे, सावधानीपूर्वक तर्क और तेज़ प्रतिक्रियाओं के बीच संतुलन बनाना सीखता है। अंत में, एक General RL चरण इसके व्यवहार को निर्देश-पालन और एजेंटिक उपयोग मामलों जैसे विस्तृत कार्यों में सुधारता है।
इसके नीचे (हल्के नीले में) आप “Lightweight Models” जैसे Qwen3-30B-A3B और छोटे डेंस मॉडलों की राह देखेंगे। इन मॉडलों को स्ट्रॉन्ग-टू-वीक डिस्टिलेशन से प्रशिक्षित किया गया है—एक प्रक्रिया जिसमें बड़े मॉडलों का ज्ञान छोटे, तेज़ मॉडलों में संपीडित किया जाता है, बिना अधिक तर्क-क्षमता खोए।
सरल शब्दों में: पहले बड़े मॉडल प्रशिक्षित किए गए, और फिर उनसे लाइटवेट मॉडल डिस्टिल किए गए। इस तरह, बहुत अलग आकारों के बावजूद, पूरा Qwen3 परिवार एक समान सोचने की शैली साझा करता है।
Qwen 3 बेंचमार्क
Qwen3 मॉडलों का विभिन्न तर्क, कोडिंग, और सामान्य ज्ञान बेंचमार्क पर मूल्यांकन किया गया। परिणाम दिखाते हैं कि Qwen3-235B-A22B अधिकांश कार्यों में आगे है, लेकिन छोटे Qwen3-30B-A3B और Qwen3-4B मॉडल भी अच्छा प्रदर्शन देते हैं।
Qwen3-235B-A22B और Qwen3-32B
अधिकांश बेंचमार्क पर, Qwen3-235B-A22B शीर्ष-प्रदर्शन करने वाले मॉडलों में है, भले ही हमेशा लीडर न हो।
स्रोत: Qwen
आइए ऊपर दिए परिणामों को संक्षेप में समझें:
Qwen3-30B-A3B और Qwen3-4B
Qwen3-30B-A3B (छोटा MoE मॉडल) लगभग सभी बेंचमार्क पर अच्छा प्रदर्शन करता है, और समान आकार के डेंस मॉडलों की बराबरी या उन्हें पीछे छोड़ता है।
स्रोत: Qwen
Qwen3-4B अपने आकार के अनुसार ठोस प्रदर्शन दिखाता है:
Qwen3 को कैसे एक्सेस करें
Qwen3 मॉडल सार्वजनिक रूप से उपलब्ध हैं और चैट ऐप पर, API के माध्यम से, लोकल डिप्लॉयमेंट के लिए डाउनलोड करके, या कस्टम सेटअप में एकीकृत करके उपयोग किए जा सकते हैं।
चैट इंटरफेस
आप सीधे यहाँ Qwen3 आज़मा सकते हैं chat.qwen.ai।
चैट ऐप में आप Qwen 3 परिवार के केवल तीन मॉडल एक्सेस कर पाएँगे: Qwen3-235B, Qwen3-30B, और Qwen3-32B:
Qwen 3 API एक्सेस
Qwen3, ModelScope या DashScope जैसे प्रदाताओं के माध्यम से OpenAI-संगत API फ़ॉर्मैट्स के साथ काम करता है। vLLM और SGLang जैसे टूल लोकल या सेल्फ-होस्टेड डिप्लॉयमेंट के लिए कुशल सर्विंग प्रदान करते हैं। आधिकारिक Qwen 3 ब्लॉग में इस बारे में अधिक विवरण हैं।
ओपन वेट्स
सभी Qwen3 मॉडल—MoE और डेंस दोनों—Apache 2.0 लाइसेंस के तहत जारी किए गए हैं। ये यहाँ उपलब्ध हैं:
लोकल डिप्लॉयमेंट
आप Qwen3 को लोकल रूप से इनका उपयोग करके भी चला सकते हैं:
निष्कर्ष
Qwen3 अब तक जारी किए गए सबसे व्यापक ओपन-वेट मॉडल सूट्स में से एक है।
फ्लैगशिप 235B MoE मॉडल तर्क, गणित, और कोडिंग कार्यों में अच्छा प्रदर्शन करता है, जबकि 30B और 4B वर्ज़न छोटे पैमाने या बजट-संवेदी डिप्लॉयमेंट के लिए व्यावहारिक विकल्प देते हैं। मॉडल के “थिंकिंग बजट” को समायोजित करने की क्षमता सामान्य उपयोगकर्ताओं के लिए अतिरिक्त लचीलापन जोड़ती है।
वर्तमान रूप में, Qwen3 एक संतुलित रिलीज़ है जो व्यापक उपयोग मामलों को कवर करता है और रिसर्च तथा प्रोडक्शन—दोनों सेटिंग्स में उपयोग के लिए तैयार है।