

Leerpad
AI-basisprincipes
10 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleQwen3 is een van de meest complete open‑weight modelsuites die tot nu toe zijn uitgebracht.
Het is afkomstig van Alibaba’s Qwen-team en omvat modellen die opschalen tot onderzoeksniveau, maar ook kleinere versies die je lokaal kunt draaien op bescheidener hardware.
In deze blog geef ik je een snel overzicht van de volledige Qwen3-suite, leg ik uit hoe de modellen zijn ontwikkeld, loop ik door de benchmarkresultaten heen en laat ik zien hoe je er toegang toe krijgt en ermee aan de slag gaat.
We hebben ook tutorials gepubliceerd over Qwen3 lokaal draaien met Ollama en over Qwen3 fine-tunen.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagse nieuwsbrief met de belangrijkste verhalen van de week. Abonneer je en blijf scherp in een paar minuten per week:
Qwen3 is de nieuwste familie van large language models van Alibaba’s Qwen-team. Alle modellen in de line-up zijn open-weight onder de Apache 2.0-licentie.
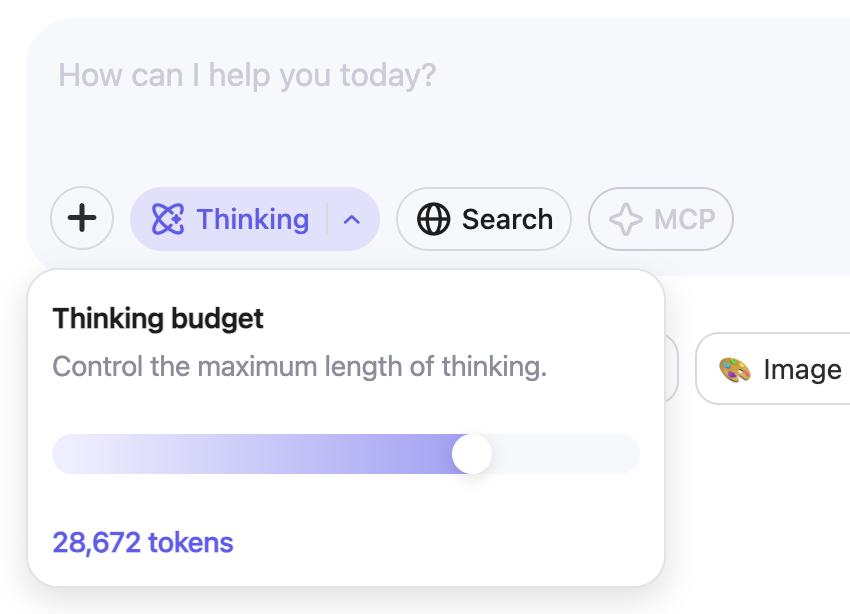
Wat mij meteen opviel, is de introductie van een thinking budget dat gebruikers direct in de Qwen-app kunnen instellen. Daarmee krijg je als gebruiker fijnmazige controle over het redeneerproces, iets wat eerder alleen programmatisch kon.
Zoals we in de grafieken hieronder zien, verbetert een hoger thinking budget de prestaties aanzienlijk, vooral voor wiskunde, programmeren en wetenschap.
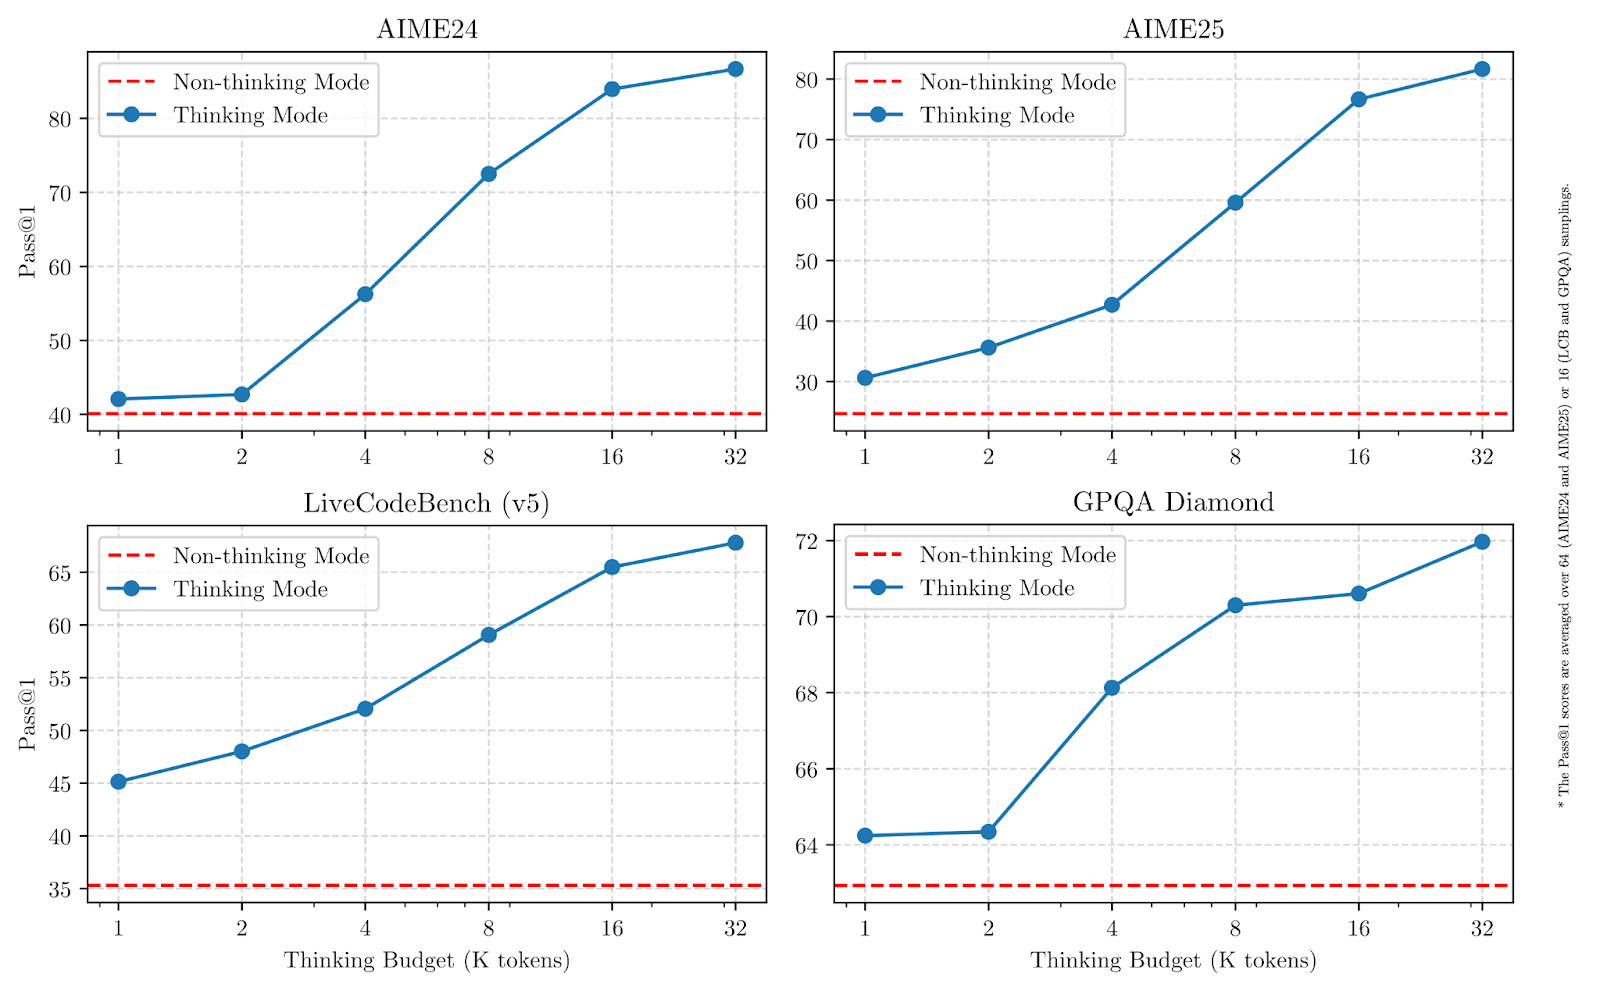
Bron: Qwen
In benchmarks presteert de vlaggenschip Qwen3-235B-A22B concurrerend met andere topmodellen en laat het sterkere resultaten zien dan DeepSeek‑R1 op het gebied van coderen, wiskunde en algemeen redeneren. Laten we de modellen kort verkennen en begrijpen waar ze voor bedoeld zijn.
Dit is het grootste model in de Qwen3-line-up. Het gebruikt een mixture‑of‑experts (MoE)‑architectuur met in totaal 235 miljard parameters en 22 miljard actief per generatie‑stap.
In een MoE‑model wordt bij elke stap slechts een kleine subset van parameters geactiveerd, waardoor het sneller en goedkoper draait dan dichte modellen (zoals GPT‑4o), waarbij altijd alle parameters worden gebruikt.
Het model presteert goed op wiskunde-, redeneer- en codeeropdrachten en is in benchmarks sneller dan modellen zoals DeepSeek‑R1.
Qwen3-30B-A3B is een kleiner MoE‑model met in totaal 30 miljard parameters en slechts 3 miljard actief per stap. Ondanks het lage actieve aantal presteert het vergelijkbaar met veel grotere dichte modellen zoals QwQ‑32B. Het is een praktische keuze voor wie redeneringsvermogen wil combineren met lagere inference‑kosten. Net als het 235B‑model ondersteunt het een contextvenster van 128K en is het beschikbaar onder Apache 2.0.
De zes dichte modellen in de Qwen3-release volgen een traditionelere architectuur waarbij alle parameters bij elke stap actief zijn. Ze dekken een breed scala aan use-cases:
Qwen3-32B, 14B, 8B ondersteunen 128K contextvensters, terwijl Qwen3-4B, 1.7B, 0.6B 32K ondersteunen. Allemaal zijn ze open‑weight en gelicenseerd onder Apache 2.0. De kleinere modellen in deze groep zijn geschikt voor lichte deployments, terwijl de grotere dichter in de buurt komen van general‑purpose LLM’s.
Qwen3 biedt verschillende modellen, afhankelijk van hoeveel redeneerdiepte, snelheid en rekenkosten je nodig hebt. Hier is een snelle overzicht:
|
Model |
Type |
Contextlengte |
Beste voor |
|
Qwen3-235B-A22B |
MoE |
128K |
Onderzoekstaken, agent-workflows, lange redeneerketens |
|
Qwen3-30B-A3B |
MoE |
128K |
Gebalanceerd redeneren tegen lagere inference‑kosten |
|
Qwen3-32B |
Dicht |
128K |
High‑end general‑purpose deployments |
|
Qwen3-14B |
Dicht |
128K |
Middenklasse-apps die sterk redeneren vereisen |
|
Qwen3-8B |
Dicht |
128K |
Lichte redeneertaken |
|
Qwen3-4B |
Dicht |
32K |
Kleinere toepassingen, snellere inference |
|
Qwen3-1.7B |
Dicht |
32K |
Mobiele en embedded use‑cases |
|
Qwen3-0.6B |
Dicht |
32K |
Zeer lichte of beperkte omgevingen |
Als je werkt aan taken die dieper redeneren vereisen, agent‑tooling of lange contexten, dan geeft Qwen3‑235B‑A22B je de meeste flexibiliteit.
Voor situaties waarin je inference sneller en goedkoper wilt houden en toch matig complexe taken wilt afhandelen, is Qwen3‑30B‑A3B een sterke optie.
De dichte modellen bieden eenvoudigere deployments en voorspelbare latency, waardoor ze beter passen bij toepassingen op kleinere schaal.
Qwen3‑modellen zijn gebouwd via een pretrainingsfase in drie stappen, gevolgd door een post‑training pipeline in vier stappen.
Pretraining is waar het model algemene patronen leert uit enorme hoeveelheden data (taal, logica, wiskunde, code) zonder expliciete instructies. Post‑training is waar het model wordt fijn‑afgesteld om zich op specifieke manieren te gedragen, zoals zorgvuldig redeneren of instructies volgen.
Ik loop beide onderdelen langs in eenvoudige bewoordingen, zonder al te diep de techniek in te gaan.
Vergeleken met Qwen2.5 is de pretrainingdataset voor Qwen3 aanzienlijk uitgebreid. Er zijn ongeveer 36 biljoen tokens gebruikt, een verdubbeling ten opzichte van de vorige generatie. De data bestonden uit webcontent, geëxtraheerde tekst uit documenten en synthetische wiskunde‑ en codevoorbeelden die door Qwen2.5‑modellen zijn gegenereerd.
Het pretrainingproces kende drie fasen:
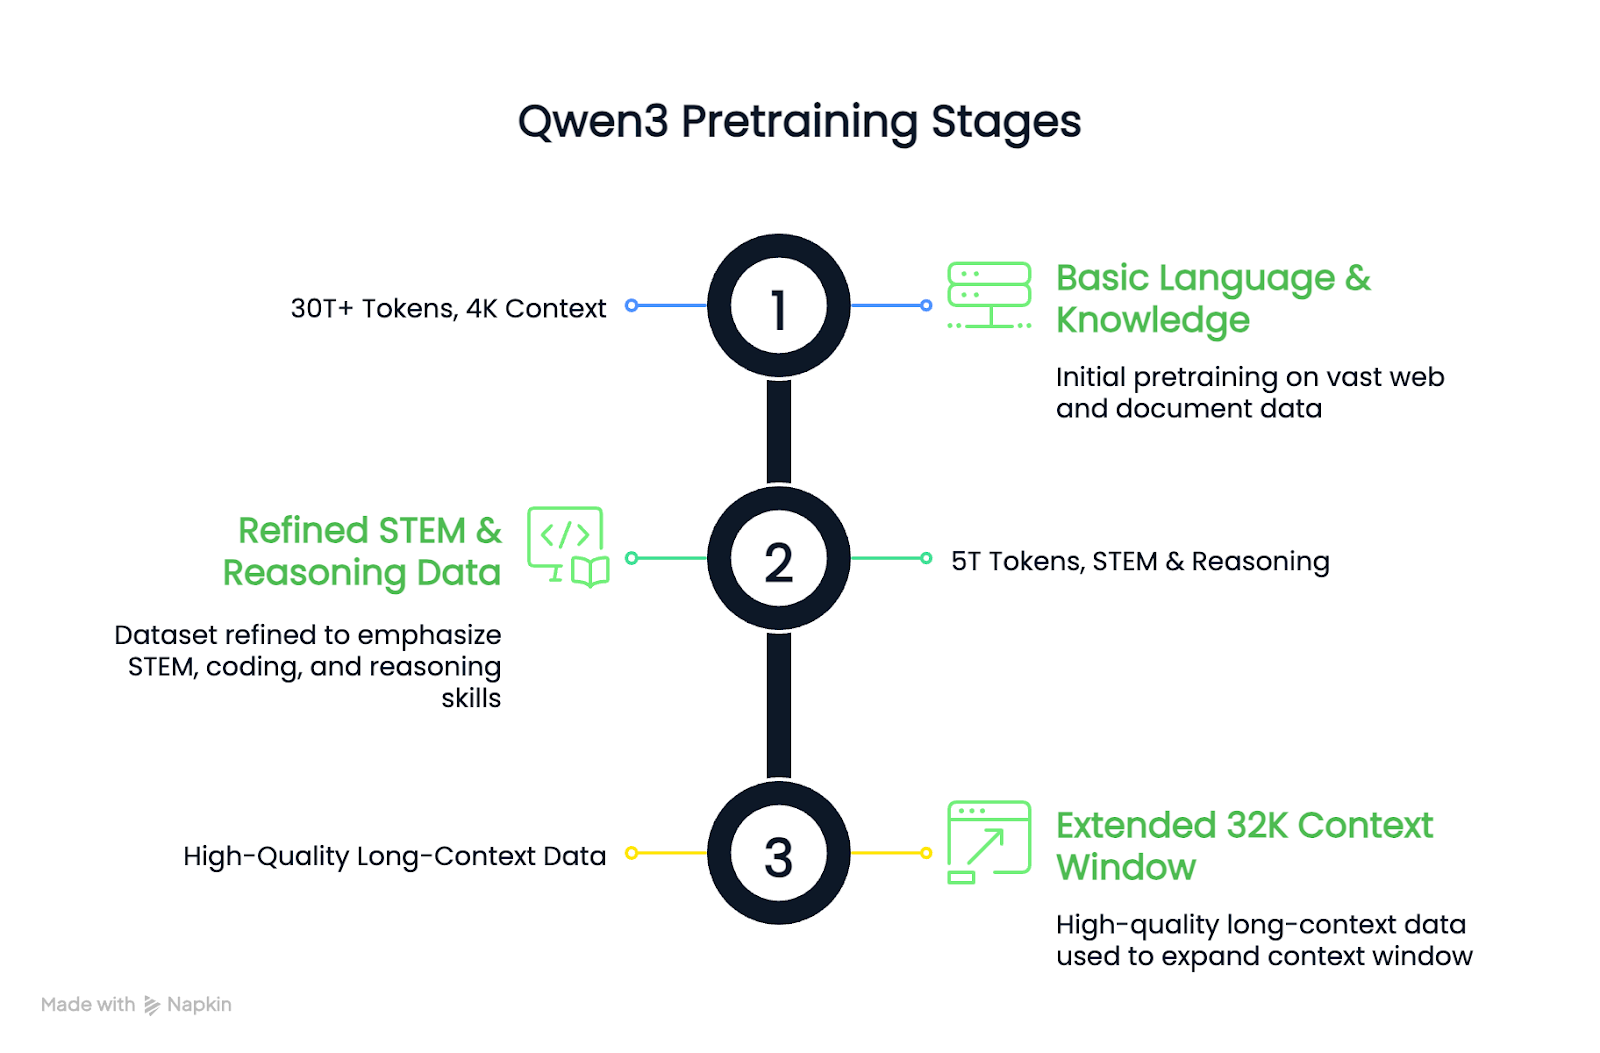
Het resultaat is dat dichte Qwen3‑basismodellen evenaren of beter presteren dan grotere Qwen2.5‑basismodellen, terwijl ze minder parameters gebruiken, vooral bij STEM‑ en redeneertaken.
De post‑training pipeline van Qwen3 richtte zich op het samenbrengen van diep redeneren en snel reageren in één model. Kijk eerst even naar het onderstaande diagram, daarna leg ik het stap voor stap uit:
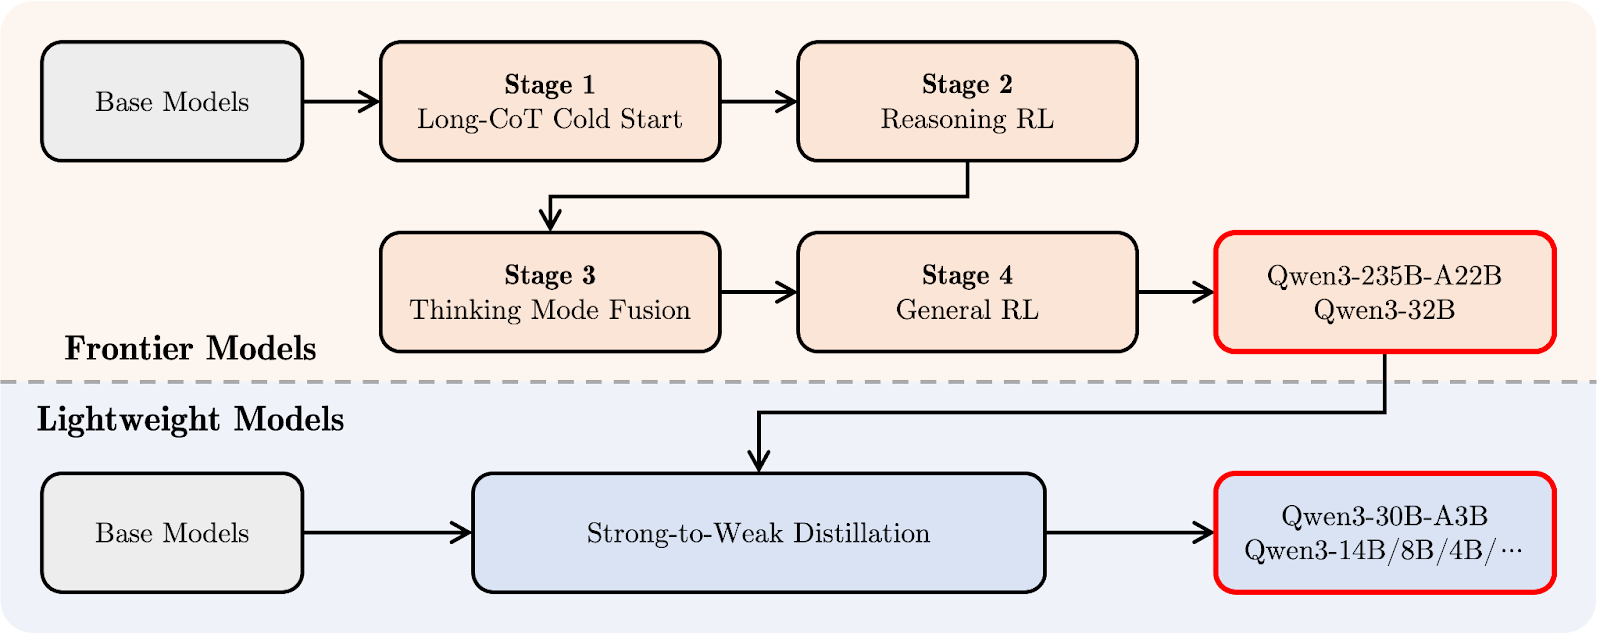
Qwen 3 post‑training pipeline. Bron: Qwen
Bovenaan (in oranje) zie je het ontwikkelpad voor de grotere “Frontier Models”, zoals Qwen3‑235B‑A22B en Qwen3‑32B. Het begint met een Long Chain‑of‑Thought Cold Start (fase 1), waar het model leert stap voor stap te redeneren bij lastigere taken.
Daarna volgt Reasoning Reinforcement Learning (RL) (fase 2) om betere probleemoplossingsstrategieën te stimuleren. In fase 3, Thinking Mode Fusion genoemd, leert Qwen3 langzaam, zorgvuldig redeneren te balanceren met snellere reacties. Tot slot verbetert een fase General RL het gedrag over een breed scala aan taken, zoals instructies volgen en agentische use‑cases.
Daaronder (in lichtblauw) zie je het pad voor de “Lightweight Models”, zoals Qwen3‑30B‑A3B en de kleinere dichte modellen. Deze worden getraind via strong‑to‑weak distillation, een proces waarbij kennis van de grotere modellen wordt gecomprimeerd in kleinere, snellere modellen zonder al te veel redeneercapaciteit te verliezen.
Kort gezegd: de grote modellen zijn eerst getraind en daarna zijn de lichte modellen daarvan gedistilleerd. Zo deelt de hele Qwen3‑familie een vergelijkbare denkwijze, zelfs over zeer uiteenlopende modelgroottes.
Qwen3‑modellen zijn geëvalueerd op uiteenlopende benchmarks voor redeneren, coderen en algemene kennis. De resultaten tonen aan dat Qwen3‑235B‑A22B in de meeste taken aan kop gaat binnen de line‑up, maar dat ook de kleinere Qwen3‑30B‑A3B en Qwen3‑4B goed presteren.
Op de meeste benchmarks behoort Qwen3‑235B‑A22B tot de best presterende modellen, al niet altijd de absolute nummer één.
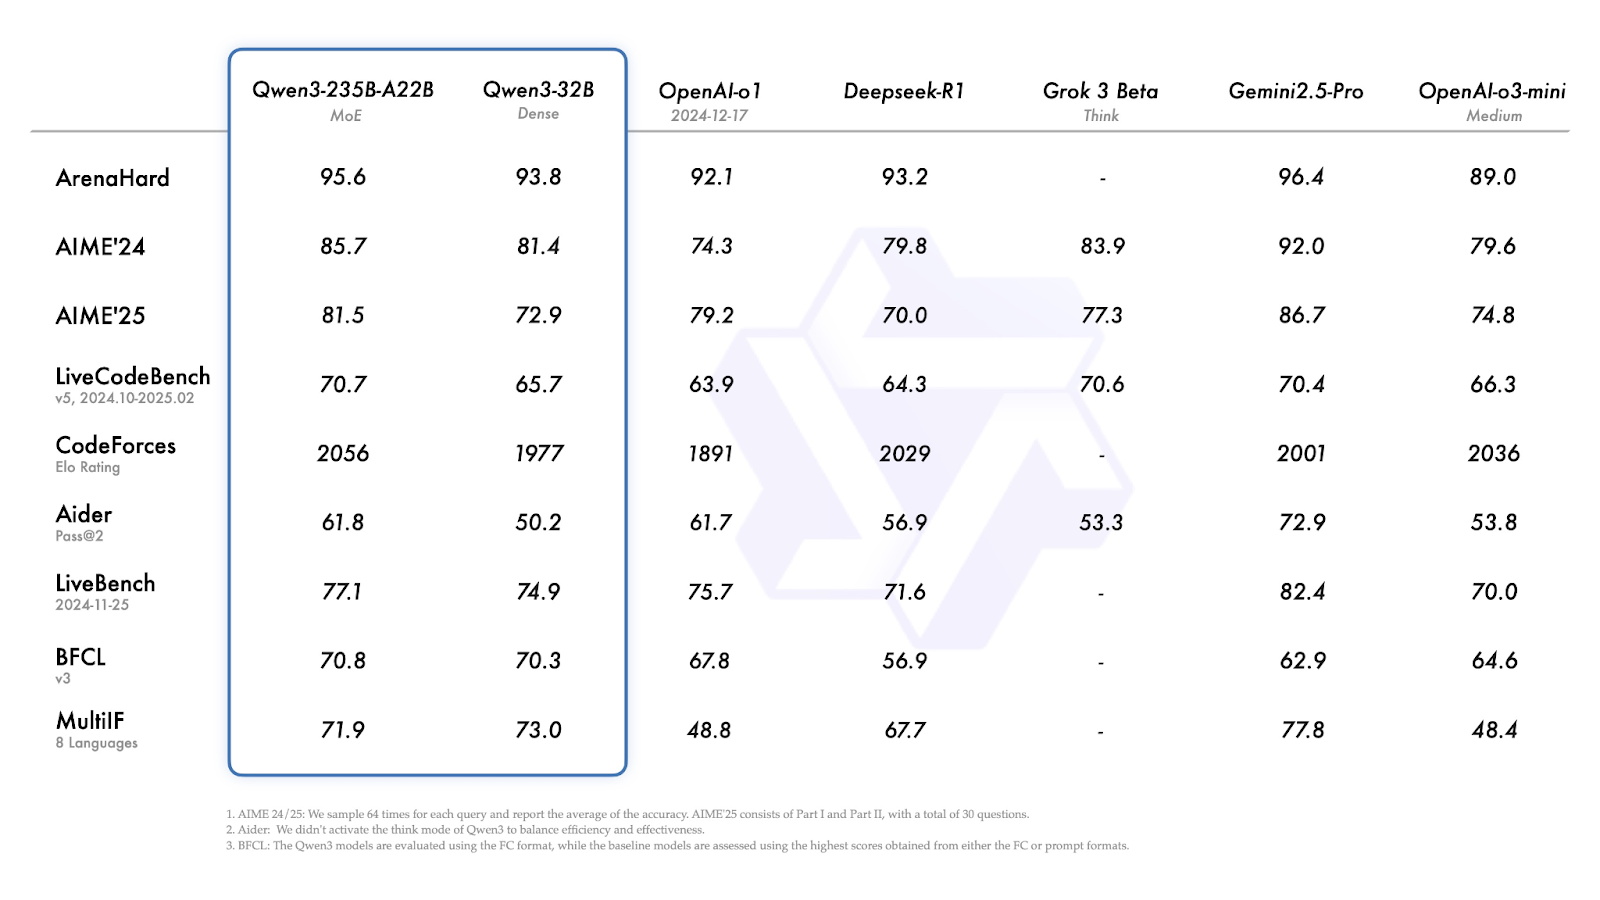
Bron: Qwen
Laten we de bovenstaande resultaten kort doornemen:
Qwen3‑30B‑A3B (het kleinere MoE‑model) presteert goed op vrijwel alle benchmarks en evenaart of verslaat consequent dichte modellen van vergelijkbare omvang.
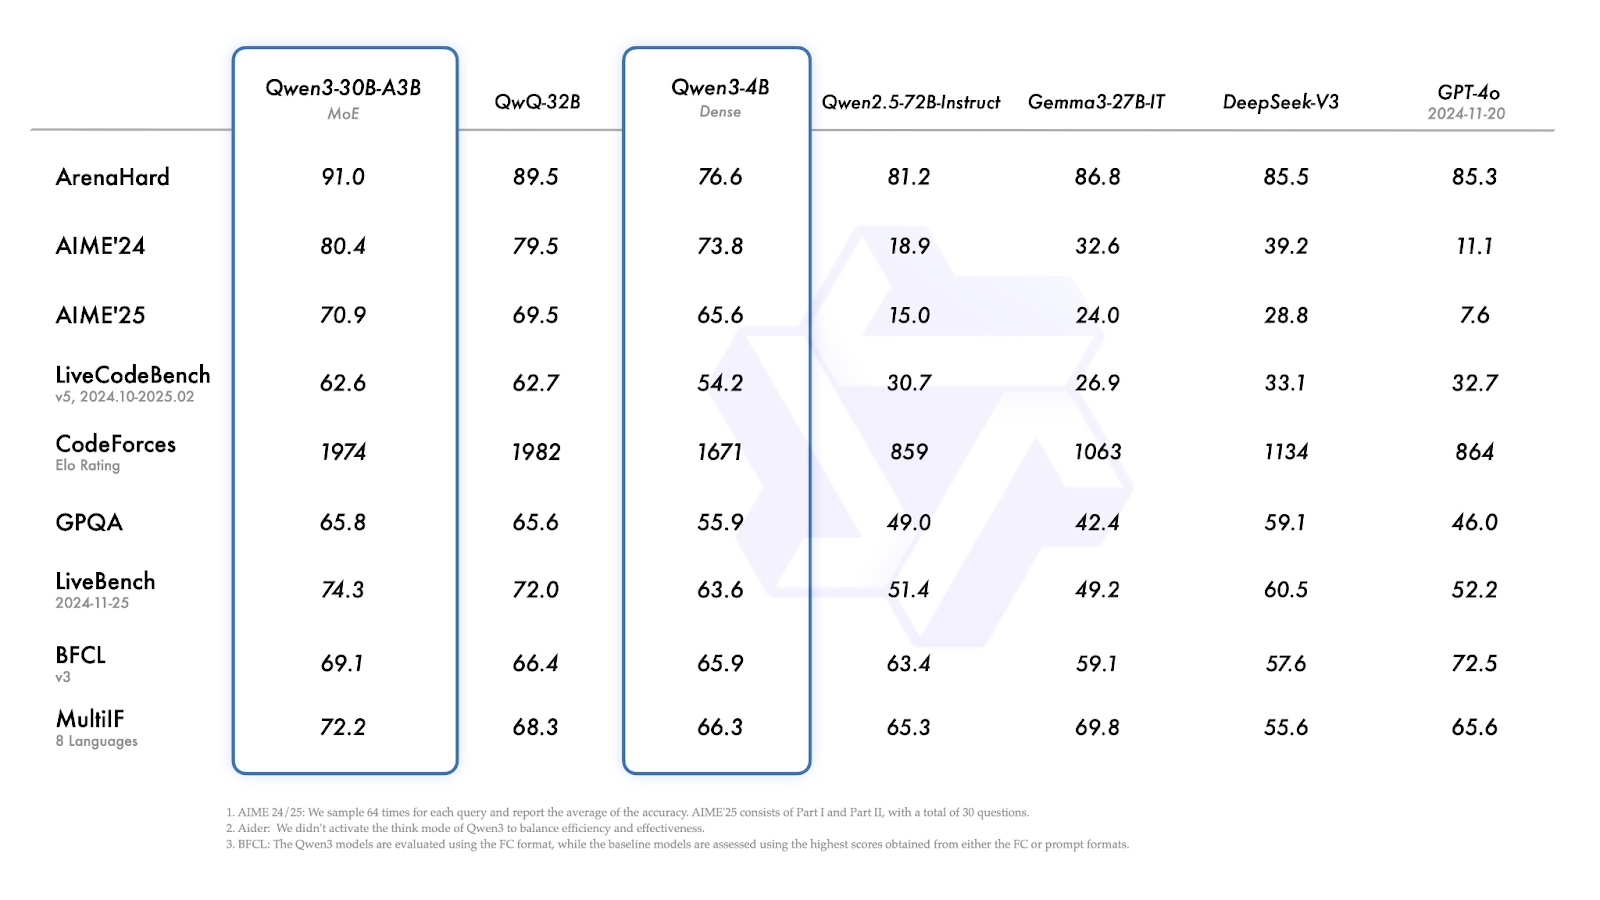
Bron: Qwen
Qwen3‑4B toont solide prestaties voor zijn formaat:
Qwen3‑modellen zijn openbaar beschikbaar en kun je gebruiken in de chatapp, via API, downloaden voor lokale deployment of integreren in eigen setups.
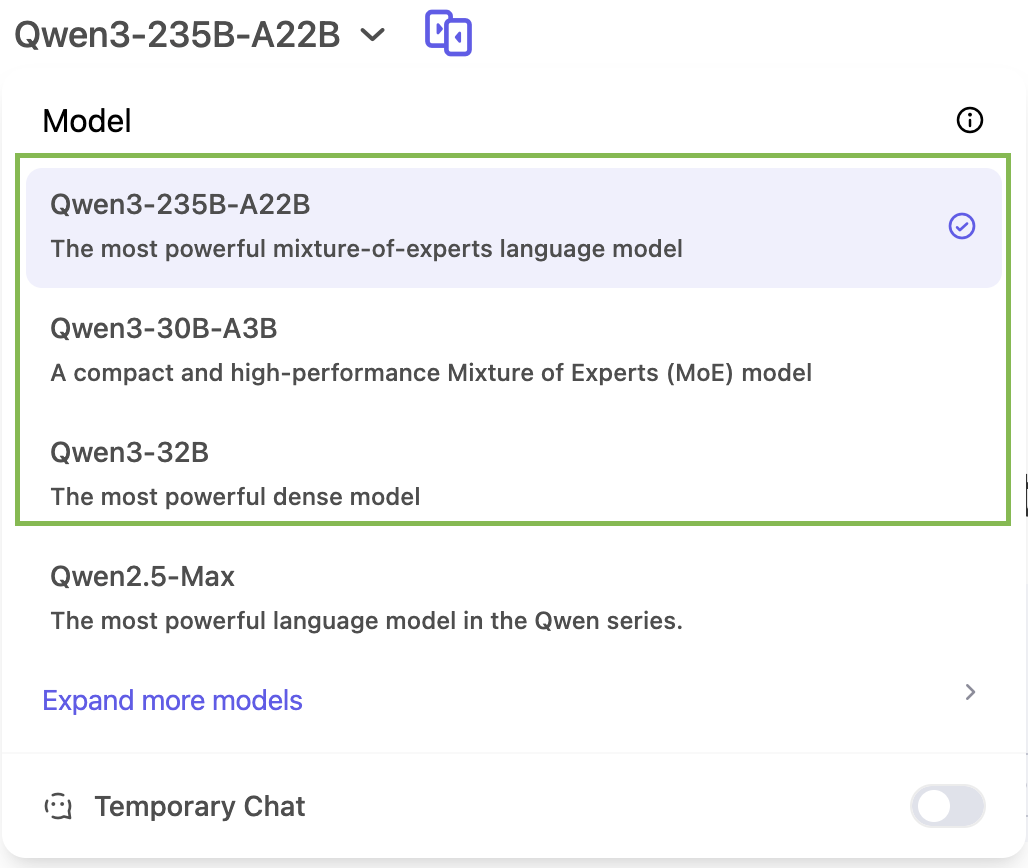
Je kunt Qwen3 direct uitproberen op chat.qwen.ai.
In de chatapp heb je toegang tot drie modellen uit de Qwen 3‑familie: Qwen3‑235B, Qwen3‑30B en Qwen3‑32B:
Qwen3 werkt met OpenAI‑compatibele API‑formaten via aanbieders zoals ModelScope of DashScope. Tools zoals vLLM en SGLang bieden efficiënte serving voor lokale of zelfgehoste deployment. De officiële Qwen 3‑blog heeft hier meer details over.
Alle Qwen3‑modellen—zowel MoE als dicht—zijn uitgebracht onder de Apache 2.0‑licentie. Ze zijn beschikbaar op:
Je kunt Qwen3 ook lokaal draaien met:
Qwen3 is een van de meest complete open‑weight modelsuites die tot nu toe zijn uitgebracht.
Het vlaggenschip 235B‑MoE‑model presteert goed op redeneren, wiskunde en programmeren, terwijl de 30B‑ en 4B‑versies praktische alternatieven bieden voor deployments op kleinere schaal of met een kleiner budget. De mogelijkheid om het thinking budget aan te passen, geeft gewone gebruikers extra flexibiliteit.
Al met al is Qwen3 een uitgebalanceerde release die een breed scala aan use‑cases dekt en klaar is voor gebruik in zowel onderzoek als productie.
Leer AI met deze cursussen!
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

