Qwen3 是迄今发布的最完整的开源权重模型套件之一。
它出自阿里巴巴的通义千问团队,既包含能达到科研级性能的模型,也有可在较为普通的本地硬件上运行的小型版本。
在这篇博客中,我将快速概览完整的 Qwen3 套件,介绍模型的开发方式,带您浏览基准测试结果,并展示如何获取并开始使用它们。
我们还发布了关于使用 Ollama 在本地运行 Qwen3以及微调 Qwen3的教程。
我们通过每周五免费的时事通讯 The Median 为读者带来 AI 最新动态,精炼解读本周重点新闻。订阅即可每周用几分钟保持敏锐:
What Is Qwen 3?
Qwen3 是阿里巴巴通义千问团队最新推出的大语言模型家族。该系列所有模型均以 Apache 2.0 许可证开源权重形式提供。
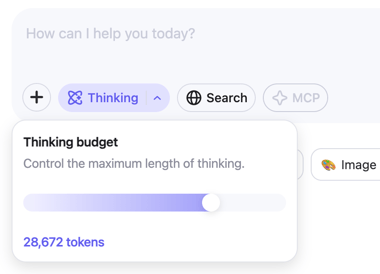
最吸引我的是,Qwen 应用中新增了用户可直接控制的“思考预算”。这使普通用户也能对推理过程进行精细调节,而此前这通常只能通过编程实现。
从下方图表可以看到,提高思考预算能显著提升表现,尤其体现在数学、编程和科学领域。
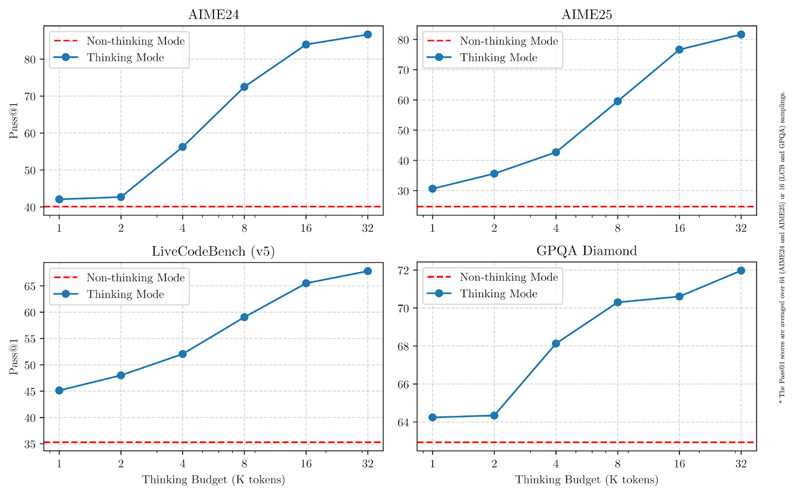
来源:Qwen
在基准测试中,旗舰模型 Qwen3-235B-A22B 的表现与其他顶级模型不相上下,并且在编程、数学和通用推理方面强于DeepSeek-R1。下面我们快速了解每个模型的定位。
Qwen3-235B-A22B
这是 Qwen3 系列中体量最大的模型。它采用专家混合(MoE)架构,总参数为 2350 亿,每个生成步激活 220 亿参数。
在 MoE 模型中,每一步仅有一小部分参数被激活,与稠密模型(如 GPT-4o,步步全参激活)相比,运行更快、成本更低。
该模型在数学、推理和编程任务上表现出色,在基准对比中领先于诸如 DeepSeek-R1 等模型。
Qwen3-30B-A3B
Qwen3-30B-A3B 是较小的 MoE 模型,总参数 300 亿,每步仅激活 30 亿。尽管激活参数较少,其性能可与更大的稠密模型(如QwQ-32B)相当。对于既需要一定推理能力又希望降低推理成本的用户,这是颇具实用性的选择。与 235B 模型一样,它支持 128K 上下文窗口,并以 Apache 2.0 授权提供。
稠密模型:32B、14B、8B、4B、1.7B、0.6B
Qwen3 发布的这六个稠密模型采用更传统的架构,每一步都会激活全部参数,覆盖广泛的使用场景:
Qwen3-32B、14B、8B 支持 128K 上下文窗口,而 Qwen3-4B、1.7B、0.6B 支持 32K。全部为开源权重,许可证为 Apache 2.0。此组中的小模型适合轻量级部署,较大的模型更接近通用型 LLM。
您该选哪款模型?
Qwen3 提供多种模型,以满足不同的推理深度、速度和算力成本需求。以下是快速概览:
|
模型
|
类型
|
上下文长度
|
最佳适用场景
|
|
Qwen3-235B-A22B
|
MoE
|
128K
|
科研任务、智能体工作流、长链式推理
|
|
Qwen3-30B-A3B
|
MoE
|
128K
|
在较低推理成本下实现均衡推理表现
|
|
Qwen3-32B
|
稠密
|
128K
|
高端通用型部署
|
|
Qwen3-14B
|
稠密
|
128K
|
需要较强推理能力的中端应用
|
|
Qwen3-8B
|
稠密
|
128K
|
轻量级推理任务
|
|
Qwen3-4B
|
稠密
|
32K
|
小型应用,更快推理
|
|
Qwen3-1.7B
|
稠密
|
32K
|
移动端与嵌入式场景
|
|
Qwen3-0.6B
|
稠密
|
32K
|
极轻量或受限环境
|
如果您在需要更深层推理、智能体工具使用或长上下文处理的任务上工作,Qwen3-235B-A22B 将为您提供最大的灵活性。
在希望保持更快、更低成本推理,同时处理中等复杂任务的场景下,Qwen3-30B-A3B 是强有力的选择。
稠密模型便于部署、时延可预期,更适合小规模应用。
Qwen3 的开发过程
Qwen3 模型先经过三阶段预训练,再进入四阶段后训练流水线。
预训练阶段让模型从海量数据(语言、逻辑、数学、代码)中自行学习一般模式,而无需明确指令。后训练阶段则将模型微调为特定行为,比如更严谨地推理或更好地遵循指令。
我会用浅显的方式分别介绍两部分,而不过多深入技术细节。
预训练
与 Qwen2.5 相比,Qwen3 的预训练数据集显著扩充。共使用约 36 万亿 token,是上一代的两倍。数据来源包括网页内容、文档抽取文本,以及由 Qwen2.5 模型生成的合成数学与代码示例。
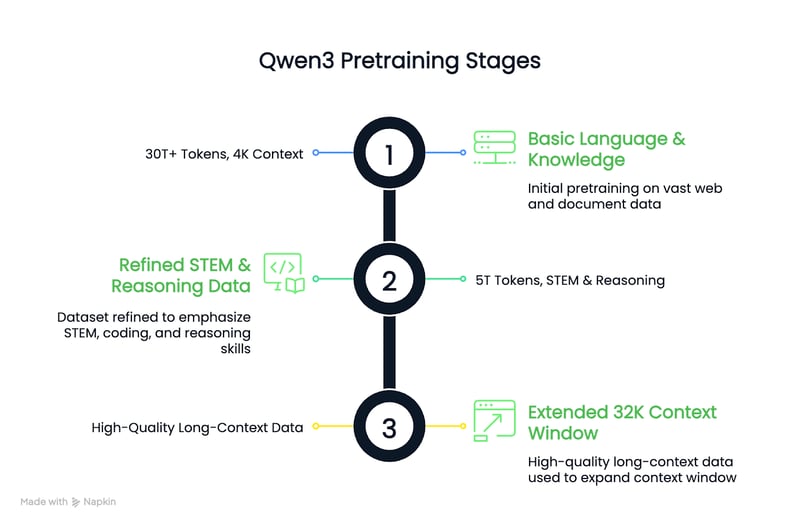
预训练过程分三个阶段:
- 阶段 1:用逾 30 万亿 token 学习基础语言与知识能力,上下文长度为 4K。
- 阶段 2:精炼数据集,提高 STEM、编程与推理数据占比,追加 5 万亿 token 训练。
- 阶段 3:使用高质量长上下文数据,将模型扩展至 32K 上下文窗口。
结果是:Qwen3 的稠密基座模型在 STEM 和推理任务上,使用更少的参数即可与更大的 Qwen2.5 基座模型持平或更优。
后训练
Qwen3 的后训练流水线聚焦于将深度推理与快速响应能力整合进同一个模型。我们先看下图,然后逐步解释:
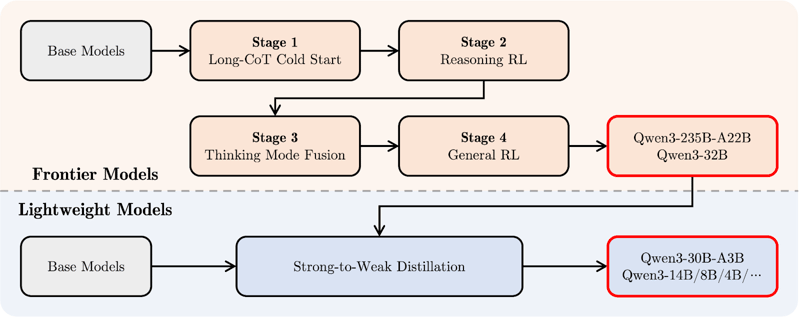
Qwen 3 后训练流水线。来源:Qwen
上方(橙色)展示了“大型前沿模型”的开发路径,如 Qwen3-235B-A22B 和 Qwen3-32B。首先是长思维链(Chain-of-Thought)冷启动(阶段 1),让模型在更难的任务上学会步步推理。
随后进入推理强化学习(RL)(阶段 2),以鼓励更优的问题求解策略。阶段 3 称为思考模式融合,让 Qwen3 学会在慢而谨慎的推理与更快响应之间取得平衡。最后通过通用 RL阶段,提升其在更广泛任务(如指令跟随与智能体场景)上的行为表现。
下方(浅蓝色)展示了“轻量模型”的路径,如 Qwen3-30B-A3B 以及更小的稠密模型。它们通过强到弱的蒸馏训练,从更大的模型中压缩并迁移知识,尽量保留推理能力,同时变得更小更快。
简单说:先训练大模型,再从中蒸馏出轻量模型。由此,尽管体量差异很大,整个 Qwen3 家族在“思考风格”上仍较为一致。
Qwen 3 基准测试
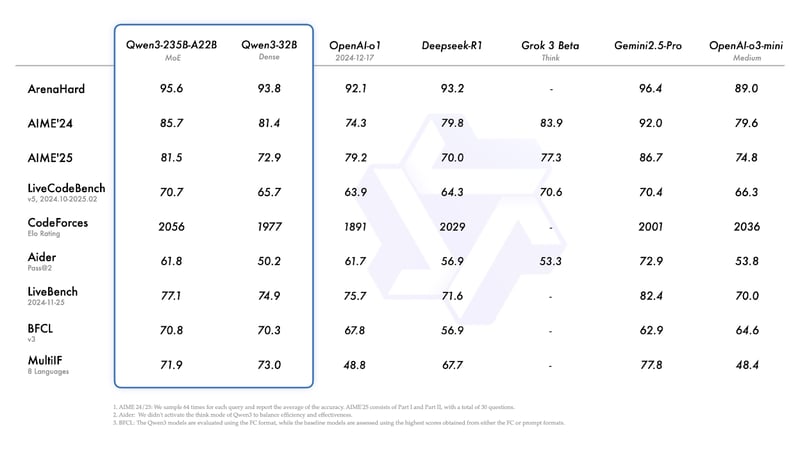
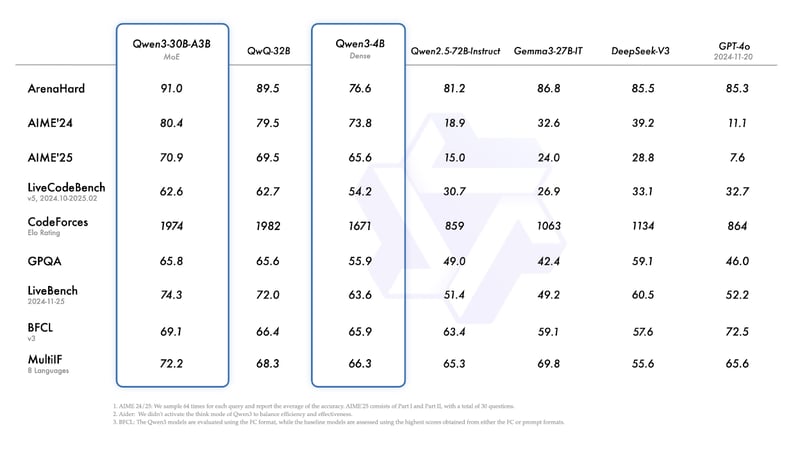
Qwen3 模型在多项推理、编程和通识类基准上进行了评估。结果显示,Qwen3-235B-A22B 在大多数任务中领跑全系,而较小的 Qwen3-30B-A3B 和 Qwen3-4B 也展现了不错的表现。
Qwen3-235B-A22B 与 Qwen3-32B
在多数基准上,Qwen3-235B-A22B 处于顶尖行列,尽管不总是第一名。
来源:Qwen
我们快速浏览上述结果:
- ArenaHard(整体推理):Gemini 2.5 Pro 以 96.4 领先。Qwen3-235B 以 95.6 紧随其后,领先 o1 和 DeepSeek-R1。(注意:Gemini 3 已可用)
- AIME’24 / AIME’25(数学):得分 85.7 与 81.4。Gemini 2.5 Pro 仍更高,但 Qwen3-235B 依旧优于 DeepSeek-R1、Grok 3 和 o3-mini。
- LiveCodeBench(代码生成):235B 模型为 70.7——除 Gemini 外优于多数模型。
- CodeForces Elo(竞赛编程):2056,高于包括 DeepSeek-R1 与 Gemini 2.5 Pro 在内的所有对比模型。
- LiveBench(真实世界通用任务):77.1,仅次于 Gemini 2.5 Pro。
- MultiIF(多语言推理):较小的 Qwen3-32B 在此更佳(73.0),但仍落后于 Gemini(77.8)。
Qwen3-30B-A3B 与 Qwen3-4B
Qwen3-30B-A3B(较小的 MoE 模型)在几乎所有基准上表现良好,稳定持平或胜过相近规模的稠密模型。
- ArenaHard:91.0——高于 QwQ-32B(89.5)、DeepSeek-V3(85.5)和 GPT-4o(85.3)。
- AIME’24 / AIME’25:80.4——略高于 QwQ-32B,但远超其他模型。
- CodeForces Elo:1974——略低于 QwQ-32B(1982)。
- GPQA(研究生水平问答):65.8——与 QwQ-32B 大致持平。
- MultiIF:72.2——高于 QwQ-32B(68.3)。
来源:Qwen
Qwen3-4B 在其体量下表现稳健:
- ArenaHard:76.6
- AIME’24 / AIME’25:73.8 与 65.6——明显强于早期且更大的 Qwen2.5 模型及 Gemma-27B-IT 等模型。
- CodeForces Elo:1671——虽不及更大的模型,但与同量级持平。
- MultiIF:66.3——以 4B 稠密模型而言可圈可点,且显著领先于许多同量级基线。
如何使用 Qwen3
Qwen3 模型已公开,您可以在聊天应用中使用,通过 API 调用,下载至本地部署,或集成进自定义方案。
聊天界面
您可以直接在 chat.qwen.ai 体验 Qwen3。
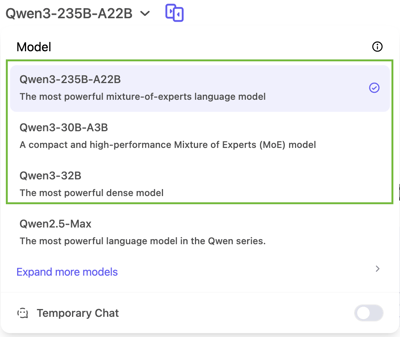
在聊天应用中,您只能访问 Qwen 3 家族中的三款模型:Qwen3-235B、Qwen3-30B 和 Qwen3-32B:
Qwen 3 API 访问
Qwen3 可通过 ModelScope 或 DashScope 等提供方,使用与 OpenAI 兼容的 API 格式。诸如vLLM 和 SGLang 等工具为本地或自托管部署提供高效服务。官方Qwen 3 博客有更多详情。
开源权重
所有 Qwen3 模型——无论 MoE 还是稠密——均以 Apache 2.0 许可证发布开源权重。可在以下平台获取:
本地部署
您也可以通过以下方式在本地运行 Qwen3:
- Ollama
- LM Studio
- llama.cpp
- KTransformers
结语
Qwen3 是目前最完整的开源权重模型套件之一。
旗舰 235B MoE 模型在推理、数学与编程任务上表现优异,而 30B 与 4B 版本为小规模或预算敏感型部署提供了务实替代方案。可调节的思考预算也为普通用户增添了一层灵活性。
整体而言,Qwen3 覆盖面广,既适用于科研,也可直接用于生产环境。


Qwen3 是迄今发布的最完整的开源权重模型套件之一。
它出自阿里巴巴的通义千问团队,既包含能达到科研级性能的模型,也有可在较为普通的本地硬件上运行的小型版本。
在这篇博客中,我将快速概览完整的 Qwen3 套件,介绍模型的开发方式,带您浏览基准测试结果,并展示如何获取并开始使用它们。
我们还发布了关于使用 Ollama 在本地运行 Qwen3以及微调 Qwen3的教程。
我们通过每周五免费的时事通讯 The Median 为读者带来 AI 最新动态,精炼解读本周重点新闻。订阅即可每周用几分钟保持敏锐:
What Is Qwen 3?
Qwen3 是阿里巴巴通义千问团队最新推出的大语言模型家族。该系列所有模型均以 Apache 2.0 许可证开源权重形式提供。
最吸引我的是,Qwen 应用中新增了用户可直接控制的“思考预算”。这使普通用户也能对推理过程进行精细调节,而此前这通常只能通过编程实现。
从下方图表可以看到,提高思考预算能显著提升表现,尤其体现在数学、编程和科学领域。
来源:Qwen
在基准测试中,旗舰模型 Qwen3-235B-A22B 的表现与其他顶级模型不相上下,并且在编程、数学和通用推理方面强于DeepSeek-R1。下面我们快速了解每个模型的定位。
Qwen3-235B-A22B
这是 Qwen3 系列中体量最大的模型。它采用专家混合(MoE)架构,总参数为 2350 亿,每个生成步激活 220 亿参数。
在 MoE 模型中,每一步仅有一小部分参数被激活,与稠密模型(如 GPT-4o,步步全参激活)相比,运行更快、成本更低。
该模型在数学、推理和编程任务上表现出色,在基准对比中领先于诸如 DeepSeek-R1 等模型。
Qwen3-30B-A3B
Qwen3-30B-A3B 是较小的 MoE 模型,总参数 300 亿,每步仅激活 30 亿。尽管激活参数较少,其性能可与更大的稠密模型(如QwQ-32B)相当。对于既需要一定推理能力又希望降低推理成本的用户,这是颇具实用性的选择。与 235B 模型一样,它支持 128K 上下文窗口,并以 Apache 2.0 授权提供。
稠密模型:32B、14B、8B、4B、1.7B、0.6B
Qwen3 发布的这六个稠密模型采用更传统的架构,每一步都会激活全部参数,覆盖广泛的使用场景:
Qwen3-32B、14B、8B 支持 128K 上下文窗口,而 Qwen3-4B、1.7B、0.6B 支持 32K。全部为开源权重,许可证为 Apache 2.0。此组中的小模型适合轻量级部署,较大的模型更接近通用型 LLM。
您该选哪款模型?
Qwen3 提供多种模型,以满足不同的推理深度、速度和算力成本需求。以下是快速概览:
模型
类型
上下文长度
最佳适用场景
Qwen3-235B-A22B
MoE
128K
科研任务、智能体工作流、长链式推理
Qwen3-30B-A3B
MoE
128K
在较低推理成本下实现均衡推理表现
Qwen3-32B
稠密
128K
高端通用型部署
Qwen3-14B
稠密
128K
需要较强推理能力的中端应用
Qwen3-8B
稠密
128K
轻量级推理任务
Qwen3-4B
稠密
32K
小型应用,更快推理
Qwen3-1.7B
稠密
32K
移动端与嵌入式场景
Qwen3-0.6B
稠密
32K
极轻量或受限环境
如果您在需要更深层推理、智能体工具使用或长上下文处理的任务上工作,Qwen3-235B-A22B 将为您提供最大的灵活性。
在希望保持更快、更低成本推理,同时处理中等复杂任务的场景下,Qwen3-30B-A3B 是强有力的选择。
稠密模型便于部署、时延可预期,更适合小规模应用。
Qwen3 的开发过程
Qwen3 模型先经过三阶段预训练,再进入四阶段后训练流水线。
预训练阶段让模型从海量数据(语言、逻辑、数学、代码)中自行学习一般模式,而无需明确指令。后训练阶段则将模型微调为特定行为,比如更严谨地推理或更好地遵循指令。
我会用浅显的方式分别介绍两部分,而不过多深入技术细节。
预训练
与 Qwen2.5 相比,Qwen3 的预训练数据集显著扩充。共使用约 36 万亿 token,是上一代的两倍。数据来源包括网页内容、文档抽取文本,以及由 Qwen2.5 模型生成的合成数学与代码示例。
预训练过程分三个阶段:
结果是:Qwen3 的稠密基座模型在 STEM 和推理任务上,使用更少的参数即可与更大的 Qwen2.5 基座模型持平或更优。
后训练
Qwen3 的后训练流水线聚焦于将深度推理与快速响应能力整合进同一个模型。我们先看下图,然后逐步解释:
Qwen 3 后训练流水线。来源:Qwen
上方(橙色)展示了“大型前沿模型”的开发路径,如 Qwen3-235B-A22B 和 Qwen3-32B。首先是长思维链(Chain-of-Thought)冷启动(阶段 1),让模型在更难的任务上学会步步推理。
随后进入推理强化学习(RL)(阶段 2),以鼓励更优的问题求解策略。阶段 3 称为思考模式融合,让 Qwen3 学会在慢而谨慎的推理与更快响应之间取得平衡。最后通过通用 RL阶段,提升其在更广泛任务(如指令跟随与智能体场景)上的行为表现。
下方(浅蓝色)展示了“轻量模型”的路径,如 Qwen3-30B-A3B 以及更小的稠密模型。它们通过强到弱的蒸馏训练,从更大的模型中压缩并迁移知识,尽量保留推理能力,同时变得更小更快。
简单说:先训练大模型,再从中蒸馏出轻量模型。由此,尽管体量差异很大,整个 Qwen3 家族在“思考风格”上仍较为一致。
Qwen 3 基准测试
Qwen3 模型在多项推理、编程和通识类基准上进行了评估。结果显示,Qwen3-235B-A22B 在大多数任务中领跑全系,而较小的 Qwen3-30B-A3B 和 Qwen3-4B 也展现了不错的表现。
Qwen3-235B-A22B 与 Qwen3-32B
在多数基准上,Qwen3-235B-A22B 处于顶尖行列,尽管不总是第一名。
来源:Qwen
我们快速浏览上述结果:
Qwen3-30B-A3B 与 Qwen3-4B
Qwen3-30B-A3B(较小的 MoE 模型)在几乎所有基准上表现良好,稳定持平或胜过相近规模的稠密模型。
来源:Qwen
Qwen3-4B 在其体量下表现稳健:
如何使用 Qwen3
Qwen3 模型已公开,您可以在聊天应用中使用,通过 API 调用,下载至本地部署,或集成进自定义方案。
聊天界面
您可以直接在 chat.qwen.ai 体验 Qwen3。
在聊天应用中,您只能访问 Qwen 3 家族中的三款模型:Qwen3-235B、Qwen3-30B 和 Qwen3-32B:
Qwen 3 API 访问
Qwen3 可通过 ModelScope 或 DashScope 等提供方,使用与 OpenAI 兼容的 API 格式。诸如vLLM 和 SGLang 等工具为本地或自托管部署提供高效服务。官方Qwen 3 博客有更多详情。
开源权重
所有 Qwen3 模型——无论 MoE 还是稠密——均以 Apache 2.0 许可证发布开源权重。可在以下平台获取:
本地部署
您也可以通过以下方式在本地运行 Qwen3:
结语
Qwen3 是目前最完整的开源权重模型套件之一。
旗舰 235B MoE 模型在推理、数学与编程任务上表现优异,而 30B 与 4B 版本为小规模或预算敏感型部署提供了务实替代方案。可调节的思考预算也为普通用户增添了一层灵活性。
整体而言,Qwen3 覆盖面广,既适用于科研,也可直接用于生产环境。