Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Qwen3 adalah salah satu rangkaian model open-weight paling lengkap yang dirilis sejauh ini.
Model ini berasal dari tim Qwen milik Alibaba dan mencakup model yang skalanya hingga performa tingkat riset serta versi lebih kecil yang dapat dijalankan secara lokal pada perangkat keras yang lebih sederhana.
Di blog ini, saya akan memberi Anda gambaran singkat tentang seluruh rangkaian Qwen3, menjelaskan bagaimana model dikembangkan, menelusuri hasil benchmark, dan menunjukkan cara mengakses serta mulai menggunakannya.
Kami juga menerbitkan tutorial tentang menjalankan Qwen3 secara lokal dengan Ollama dan tentang fine-tuning Qwen3.
Kami terus memberi pembaca pembaruan terbaru tentang AI melalui The Median, buletin gratis setiap Jumat yang mengulas kisah-kisah kunci pekan ini. Berlangganan dan tetap terinformasi hanya dalam beberapa menit setiap minggu:
Qwen3 adalah keluarga terbaru model bahasa besar dari tim Qwen milik Alibaba. Semua model dalam jajaran ini bersifat open-weight di bawah lisensi Apache 2.0.
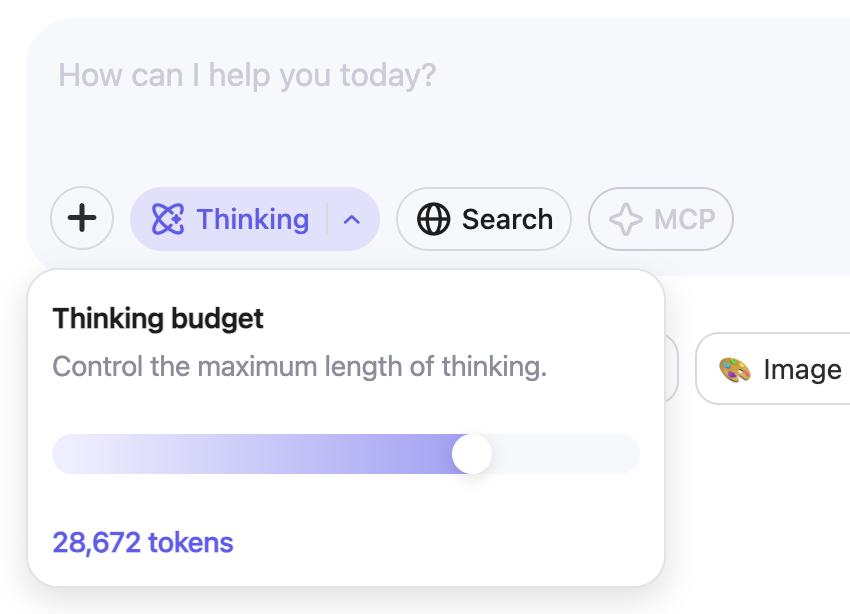
Hal yang langsung menarik perhatian saya adalah pengenalan thinking budget yang dapat dikendalikan pengguna langsung di dalam aplikasi Qwen. Ini memberi pengguna biasa kendali yang lebih terperinci atas proses penalaran, sesuatu yang sebelumnya hanya bisa dilakukan secara terprogram.
Seperti terlihat pada grafik di bawah, peningkatan thinking budget secara signifikan meningkatkan performa, terutama untuk matematika, pengkodean, dan sains.
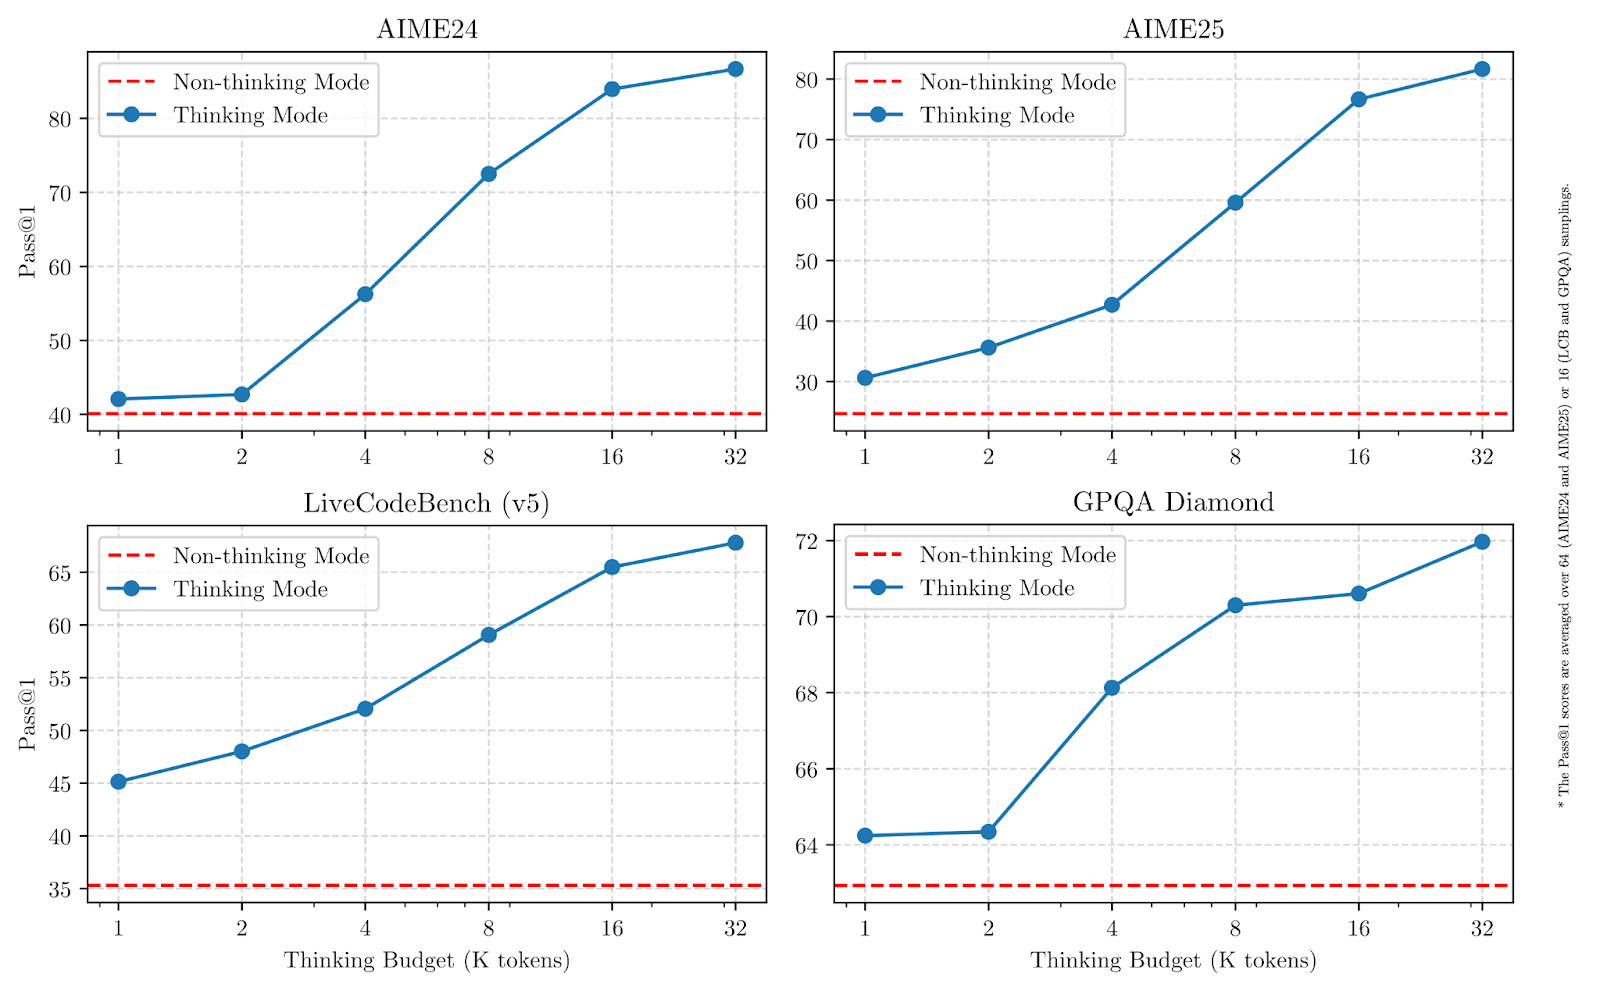
Sumber: Qwen
Dalam pengujian benchmark, model andalan Qwen3-235B-A22B berkinerja kompetitif dibandingkan model papan atas lainnya dan menunjukkan hasil lebih kuat daripada DeepSeek-R1 pada pengkodean, matematika, dan penalaran umum. Mari kita telusuri masing-masing model dan pahami kegunaannya.
Ini adalah model terbesar dalam jajaran Qwen3. Model ini menggunakan arsitektur mixture-of-experts (MoE) dengan total 235 miliar parameter dan 22 miliar parameter aktif per langkah generasi.
Dalam model MoE, hanya sebagian kecil parameter yang diaktifkan pada setiap langkah, sehingga lebih cepat dan lebih murah dijalankan dibanding model dense (seperti GPT-4o), di mana semua parameter selalu digunakan.
Model ini berkinerja baik pada tugas matematika, penalaran, dan pengkodean, dan dalam perbandingan benchmark melampaui model seperti DeepSeek-R1.
Qwen3-30B-A3B adalah model MoE yang lebih kecil dengan total 30 miliar parameter dan hanya 3 miliar parameter aktif pada setiap langkah. Meski jumlah parameter aktifnya rendah, performanya sebanding dengan model dense yang jauh lebih besar seperti QwQ-32B. Ini adalah pilihan praktis bagi pengguna yang menginginkan kombinasi kemampuan penalaran dan biaya inferensi yang lebih rendah. Seperti model 235B, model ini mendukung jendela konteks 128K dan tersedia di bawah Apache 2.0.
Enam model dense dalam rilis Qwen3 mengikuti arsitektur yang lebih tradisional di mana semua parameter aktif pada setiap langkah. Model-model ini mencakup berbagai kasus penggunaan:
Qwen3-32B, 14B, 8B mendukung jendela konteks 128K, sementara Qwen3-4B, 1.7B, 0.6B mendukung 32K. Semuanya bersifat open-weight dan berlisensi Apache 2.0. Model yang lebih kecil cocok untuk penerapan ringan, sedangkan yang lebih besar mendekati LLM serbaguna.
Qwen3 menawarkan model berbeda bergantung pada kedalaman penalaran, kecepatan, dan biaya komputasi yang Anda perlukan. Berikut gambaran singkatnya:
|
Model |
Tipe |
Panjang Konteks |
Terbaik Untuk |
|
Qwen3-235B-A22B |
MoE |
128K |
Tugas riset, alur kerja agen, rantai penalaran panjang |
|
Qwen3-30B-A3B |
MoE |
128K |
Penalaran seimbang dengan biaya inferensi lebih rendah |
|
Qwen3-32B |
Dense |
128K |
Penerapan serbaguna kelas atas |
|
Qwen3-14B |
Dense |
128K |
Aplikasi kelas menengah yang butuh penalaran kuat |
|
Qwen3-8B |
Dense |
128K |
Tugas penalaran ringan |
|
Qwen3-4B |
Dense |
32K |
Aplikasi lebih kecil, inferensi lebih cepat |
|
Qwen3-1.7B |
Dense |
32K |
Kasus penggunaan seluler dan tertanam |
|
Qwen3-0.6B |
Dense |
32K |
Lingkungan sangat ringan atau terbatas |
Jika Anda mengerjakan tugas yang membutuhkan penalaran lebih dalam, penggunaan alat oleh agen, atau penanganan konteks panjang, Qwen3-235B-A22B akan memberi fleksibilitas terbesar.
Untuk kasus ketika Anda ingin menjaga inferensi tetap cepat dan murah sambil tetap menangani tugas yang cukup kompleks, Qwen3-30B-A3B adalah opsi yang kuat.
Model dense menawarkan penerapan yang lebih sederhana dan latensi yang dapat diprediksi, sehingga lebih cocok untuk aplikasi skala lebih kecil.
Model Qwen3 dibangun melalui fase pretraining tiga tahap yang diikuti pipeline pascapelatihan empat tahap.
Pretraining adalah saat model mempelajari pola umum dari data dalam jumlah besar (bahasa, logika, matematika, kode) tanpa diberi tahu secara spesifik apa yang harus dilakukan. Pascapelatihan adalah saat model dihaluskan agar berperilaku dengan cara tertentu, seperti menalar dengan cermat atau mengikuti instruksi.
Saya akan menjelaskan kedua bagian ini dengan sederhana, tanpa terlalu dalam ke detail teknis.
Dibandingkan Qwen2.5, dataset pretraining untuk Qwen3 diperluas secara signifikan. Sekitar 36 triliun token digunakan, dua kali lipat dari generasi sebelumnya. Datanya mencakup konten web, teks yang diekstrak dari dokumen, serta contoh matematika dan kode sintetis yang dihasilkan oleh model Qwen2.5.
Proses pretraining mengikuti tiga tahap:
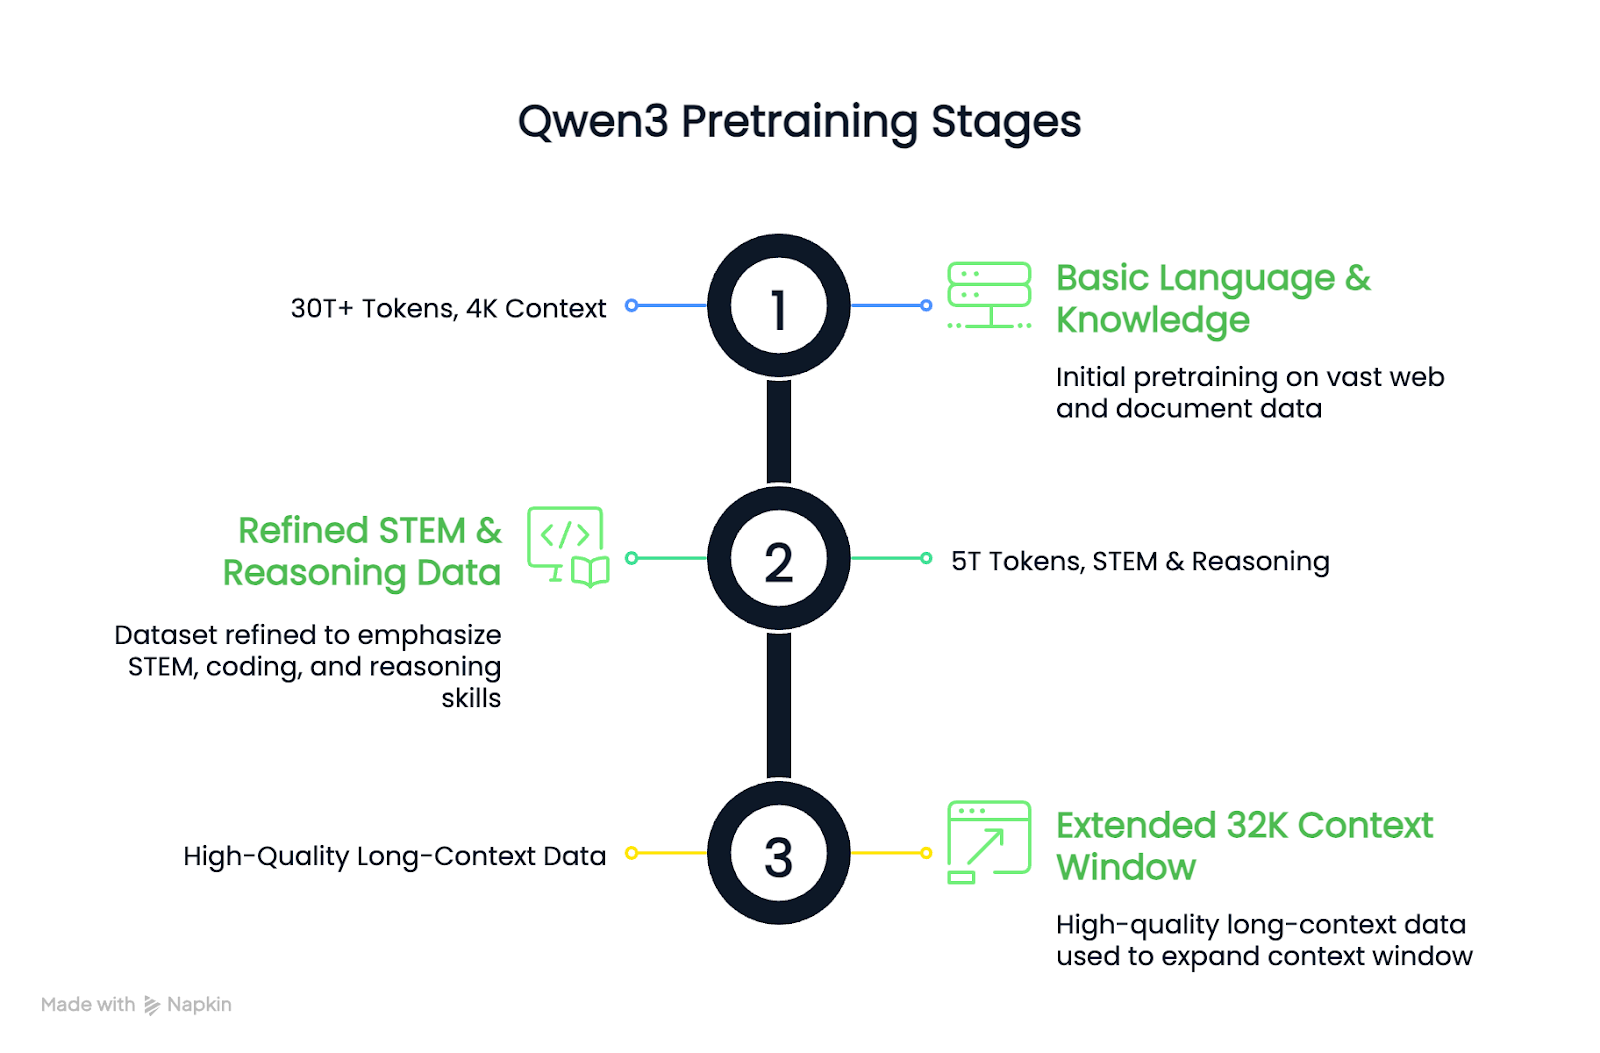
Hasilnya, model dasar Qwen3 yang dense mampu menyamai atau melampaui model dasar Qwen2.5 yang lebih besar dengan penggunaan parameter lebih sedikit, terutama pada tugas STEM dan penalaran.
Pipeline pascapelatihan Qwen3 berfokus pada pengintegrasian kemampuan penalaran mendalam dan respons cepat dalam satu model. Mari lihat diagram di bawah ini, lalu saya jelaskan langkah demi langkah:
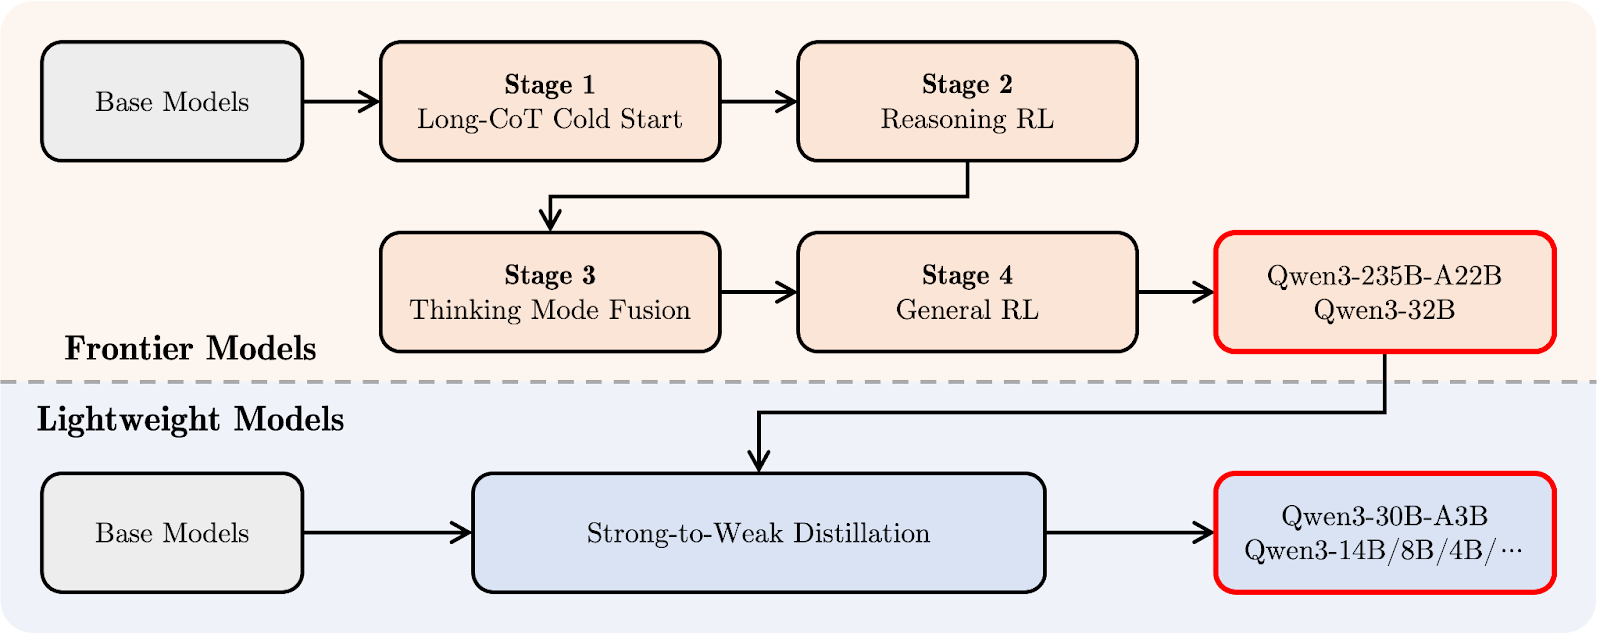
Pipeline pascapelatihan Qwen 3. Sumber: Qwen
Di bagian atas (oranye), Anda dapat melihat jalur pengembangan untuk “Frontier Models” yang lebih besar, seperti Qwen3-235B-A22B dan Qwen3-32B. Ini dimulai dengan Long Chain-of-Thought Cold Start (tahap 1), di mana model belajar menalar selangkah demi selangkah pada tugas yang lebih sulit.
Selanjutnya diikuti Reasoning Reinforcement Learning (RL) (tahap 2) untuk mendorong strategi pemecahan masalah yang lebih baik. Pada tahap 3, yang disebut Thinking Mode Fusion, Qwen3 belajar menyeimbangkan penalaran yang lambat dan cermat dengan respons yang lebih cepat. Terakhir, tahap General RL meningkatkan perilakunya di berbagai tugas, seperti mengikuti instruksi dan kasus penggunaan agen.
Di bawahnya (biru muda), Anda akan melihat jalur untuk “Lightweight Models”, seperti Qwen3-30B-A3B dan model dense yang lebih kecil. Model-model ini dilatih menggunakan distilasi kuat-ke-lemah, sebuah proses di mana pengetahuan dari model yang lebih besar dikompresi ke dalam model yang lebih kecil dan lebih cepat tanpa terlalu banyak kehilangan kemampuan penalaran.
Sederhananya: model besar dilatih terlebih dahulu, lalu model ringan didistilasi darinya. Dengan cara ini, seluruh keluarga Qwen3 berbagi gaya berpikir yang serupa, bahkan di berbagai ukuran model yang sangat berbeda.
Model Qwen3 dievaluasi pada berbagai tolok ukur penalaran, pengkodean, dan pengetahuan umum. Hasilnya menunjukkan bahwa Qwen3-235B-A22B memimpin jajaran pada sebagian besar tugas, tetapi model yang lebih kecil seperti Qwen3-30B-A3B dan Qwen3-4B juga memberikan performa yang baik.
Pada sebagian besar benchmark, Qwen3-235B-A22B termasuk model dengan performa terbaik, meski tidak selalu menjadi yang teratas.
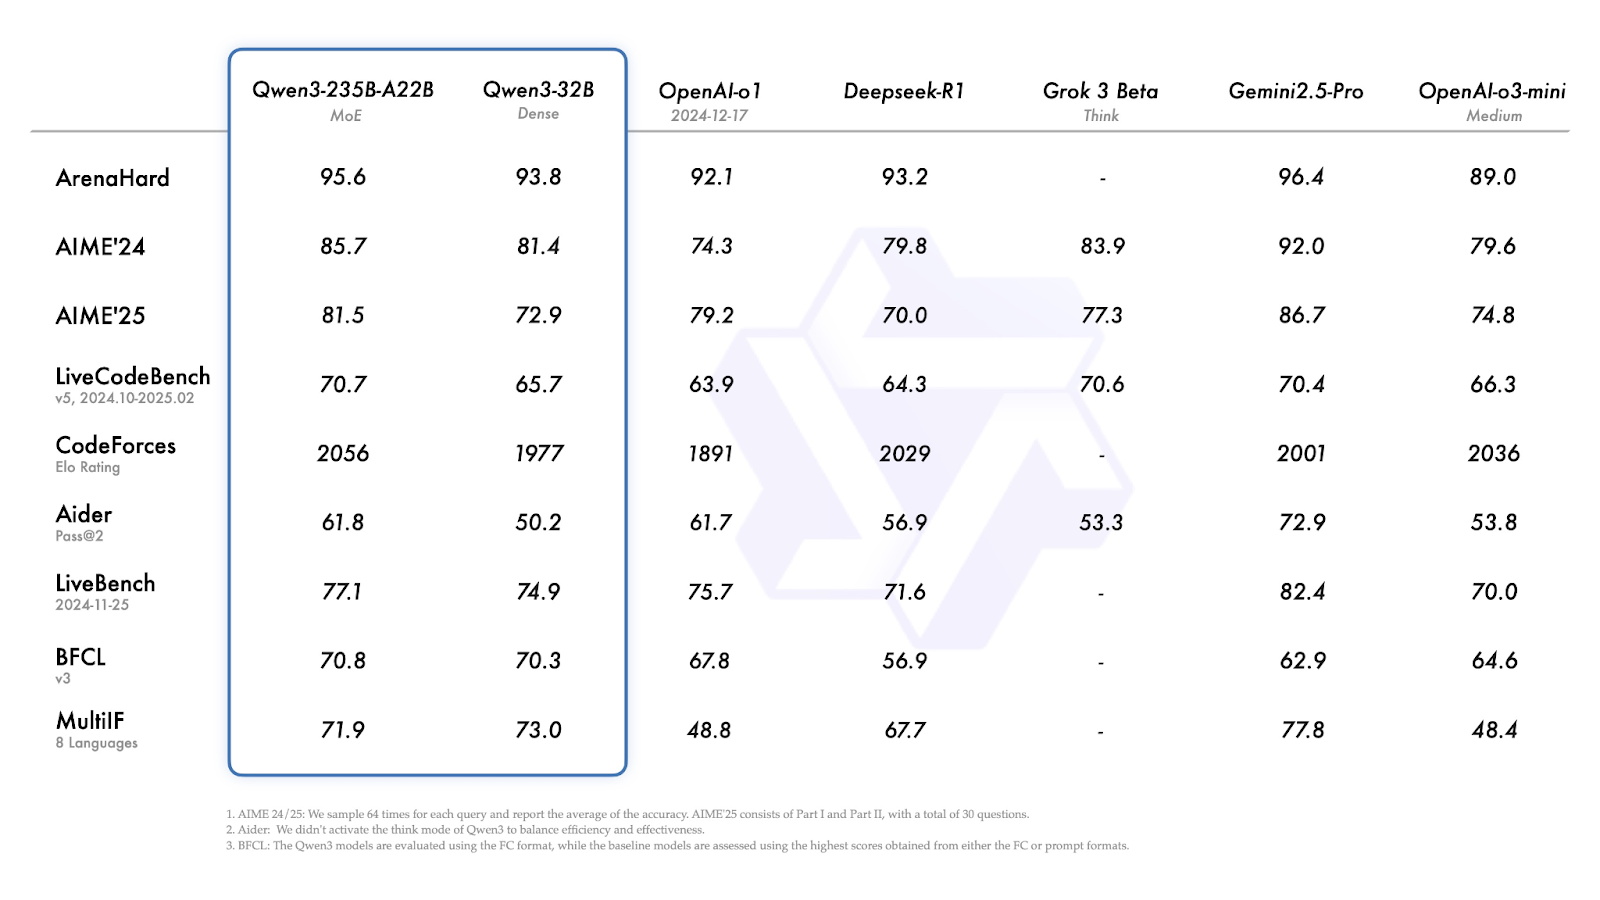
Sumber: Qwen
Mari kita telusuri cepat hasil di atas:
Qwen3-30B-A3B (model MoE yang lebih kecil) berkinerja baik di hampir semua benchmark, secara konsisten menyamai atau mengungguli model dense berukuran serupa.
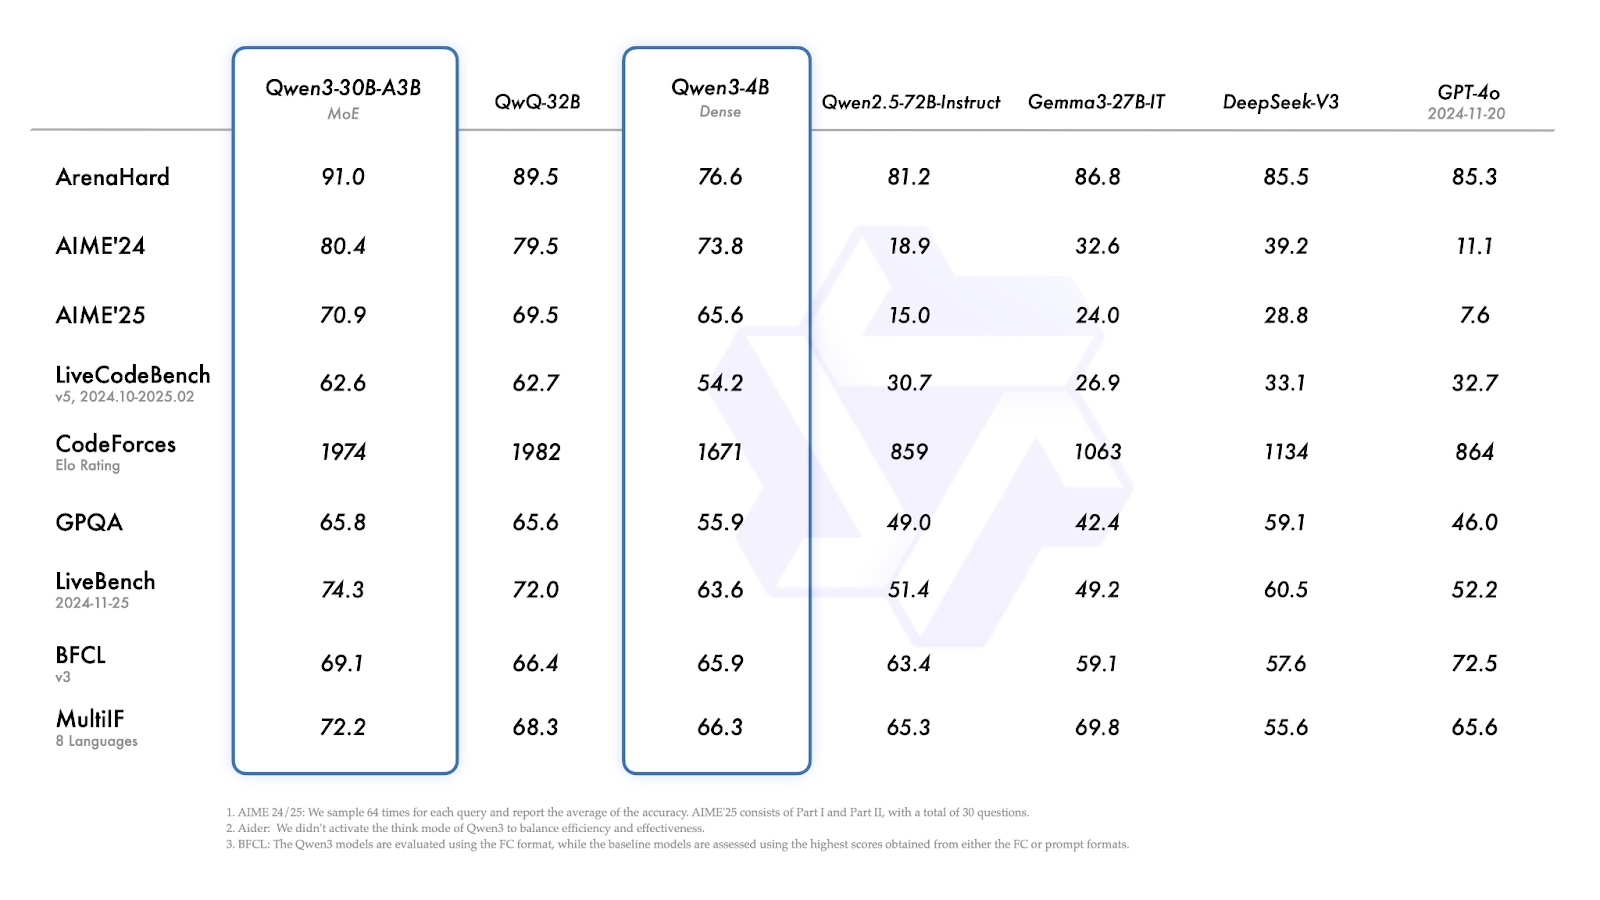
Sumber: Qwen
Qwen3-4B menunjukkan performa solid untuk ukurannya:
Model Qwen3 tersedia untuk publik dan dapat digunakan di aplikasi chat, melalui API, diunduh untuk penerapan lokal, atau diintegrasikan ke dalam setelan khusus.
Anda dapat mencoba Qwen3 langsung di chat.qwen.ai.
Anda hanya akan dapat mengakses tiga model dari keluarga Qwen 3 di aplikasi chat: Qwen3-235B, Qwen3-30B, dan Qwen3-32B:
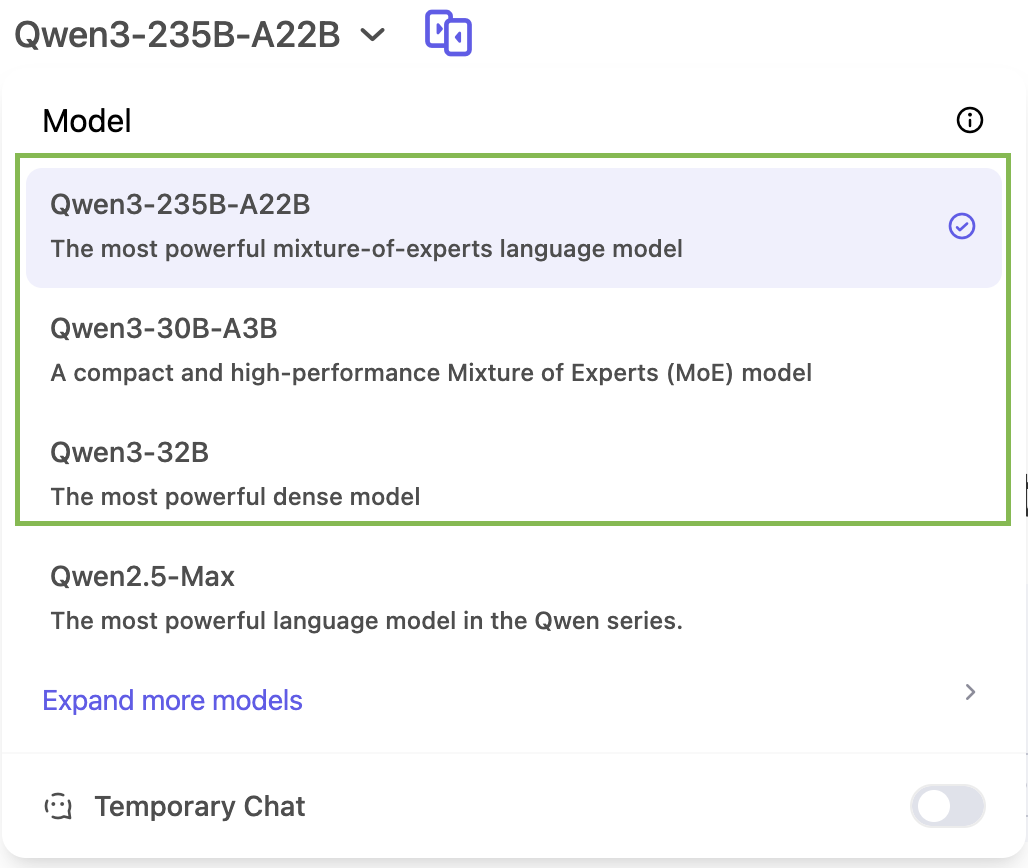
Qwen3 bekerja dengan format API yang kompatibel dengan OpenAI melalui penyedia seperti ModelScope atau DashScope. Alat seperti vLLM dan SGLang menawarkan penyajian yang efisien untuk penerapan lokal atau self-hosted. Blog Qwen 3 resmi memiliki detail lebih lanjut tentang hal ini.
Semua model Qwen3—baik MoE maupun dense—dirilis di bawah lisensi Apache 2.0. Model-model ini tersedia di:
Anda juga dapat menjalankan Qwen3 secara lokal menggunakan:
Qwen3 adalah salah satu rangkaian model open-weight paling lengkap yang dirilis sejauh ini.
Model andalan 235B MoE berkinerja baik pada tugas penalaran, matematika, dan pengkodean, sementara versi 30B dan 4B menawarkan alternatif praktis untuk penerapan berskala lebih kecil atau dengan anggaran terbatas. Kemampuan untuk menyesuaikan thinking budget menambah lapisan fleksibilitas bagi pengguna biasa.
Sejauh ini, Qwen3 merupakan rilis yang matang, mencakup beragam kasus penggunaan dan siap dipakai dalam lingkungan riset maupun produksi.
Pelajari AI dengan kursus-kursus ini!
Program
Program
Program
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




